
Llm Gpu Idp Segmentfault

人工智能 - 面向 LLM 的 GPU 系统工程方法论 - IDP技术干货 - SegmentFault 思否

人工智能 - 面向 LLM 的 GPU 系统工程方法论 - IDP技术干货 - SegmentFault 思否

人工智能 - 面向 LLM 的 GPU 系统工程方法论 - IDP技术干货 - SegmentFault 思否

人工智能 - 面向 LLM 的 GPU 系统工程方法论 - IDP技术干货 - SegmentFault 思否

人工智能 - 面向国产 DCU 加速卡的 LLM Agent 驱动 GPU 内核优化框架适配与验证 - 个人文章 - SegmentFault 思否

人工智能 - 相同的 LLM 在「不同 GPU 上」会产生不同输出?为什么? - IDP技术干货 - SegmentFault 思否

人工智能 - 相同的 LLM 在「不同 GPU 上」会产生不同输出?为什么? - IDP技术干货 - SegmentFault 思否

人工智能 - 面向 LLM 的 GPU 系统工程方法论 - IDP技术干货 - SegmentFault 思否

人工智能 - 相同的 LLM 在「不同 GPU 上」会产生不同输出?为什么? - IDP技术干货 - SegmentFault 思否

人工智能 - 相同的 LLM 在「不同 GPU 上」会产生不同输出?为什么? - IDP技术干货 - SegmentFault 思否
Advertisement Space (300x250)

人工智能 - 相同的 LLM 在「不同 GPU 上」会产生不同输出?为什么? - IDP技术干货 - SegmentFault 思否

人工智能 - 相同的 LLM 在「不同 GPU 上」会产生不同输出?为什么? - IDP技术干货 - SegmentFault 思否

人工智能 - 相同的 LLM 在「不同 GPU 上」会产生不同输出?为什么? - IDP技术干货 - SegmentFault 思否

难以置信!使用这项新技术可以在单个 4GB GPU 上运行 70B LLM 推理 - 人工智能Momodel - SegmentFault 思否

人工智能 - 相同的 LLM 在「不同 GPU 上」会产生不同输出?为什么? - IDP技术干货 - SegmentFault 思否

程序员 - 大语言模型推理优化技术综述(The Art of LLM Inference) - IDP技术干货 - SegmentFault 思否

程序员 - 大语言模型推理优化技术综述(The Art of LLM Inference) - IDP技术干货 - SegmentFault 思否

程序员 - 大语言模型推理优化技术综述(The Art of LLM Inference) - IDP技术干货 - SegmentFault 思否

程序员 - 大语言模型推理优化技术综述(The Art of LLM Inference) - IDP技术干货 - SegmentFault 思否

人工智能 - 以 Nano-vLLM 为例,深入理解 LLM 推理引擎(Part 1) - IDP技术干货 - SegmentFault 思否
Advertisement Space (336x280)

人工智能 - 以 Nano-vLLM 为例,深入理解 LLM 推理引擎(Part 2) - IDP技术干货 - SegmentFault 思否

人工智能 - 部署 LLMs 前如何计算与优化 GPU 内存需求? - IDP技术干货 - SegmentFault 思否

人工智能 - 以 Nano-vLLM 为例,深入理解 LLM 推理引擎(Part 2) - IDP技术干货 - SegmentFault 思否

人工智能 - 以 Nano-vLLM 为例,深入理解 LLM 推理引擎(Part 1) - IDP技术干货 - SegmentFault 思否

人工智能 - MCP 是为开发者设计的工具,而非为 LLM 而设 - IDP技术干货 - SegmentFault 思否

人工智能 - 以 Nano-vLLM 为例,深入理解 LLM 推理引擎(Part 1) - IDP技术干货 - SegmentFault 思否

程序员 - 大语言模型推理优化技术综述(The Art of LLM Inference) - IDP技术干货 - SegmentFault 思否

人工智能 - 以 Nano-vLLM 为例,深入理解 LLM 推理引擎(Part 1) - IDP技术干货 - SegmentFault 思否

程序员 - 大语言模型推理优化技术综述(The Art of LLM Inference) - IDP技术干货 - SegmentFault 思否

人工智能 - 以 Nano-vLLM 为例,深入理解 LLM 推理引擎(Part 2) - IDP技术干货 - SegmentFault 思否
Advertisement Space (336x280)

[논문 리뷰] SLO-aware GPU Frequency Scaling for Energy Efficient LLM ...

人工智能 - 以 Nano-vLLM 为例,深入理解 LLM 推理引擎(Part 1) - IDP技术干货 - SegmentFault 思否

人工智能 - LLM 推理优化探微 (4) :模型性能瓶颈分类及优化策略 - IDP技术干货 - SegmentFault 思否
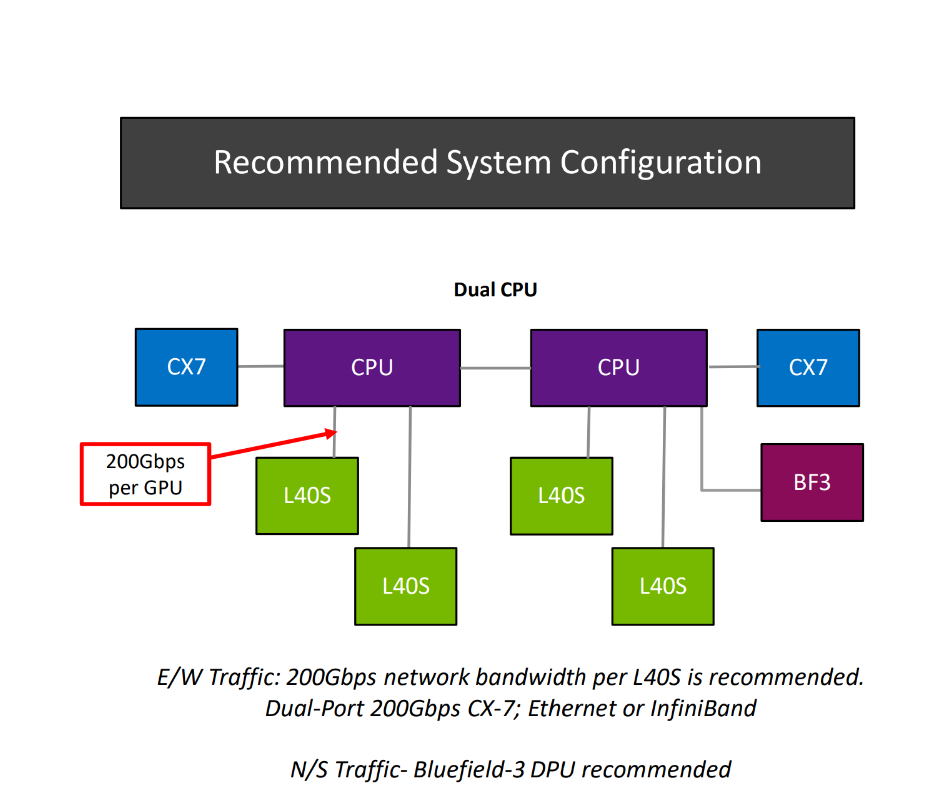
Choosing the Right GPU for LLM Inference and Training
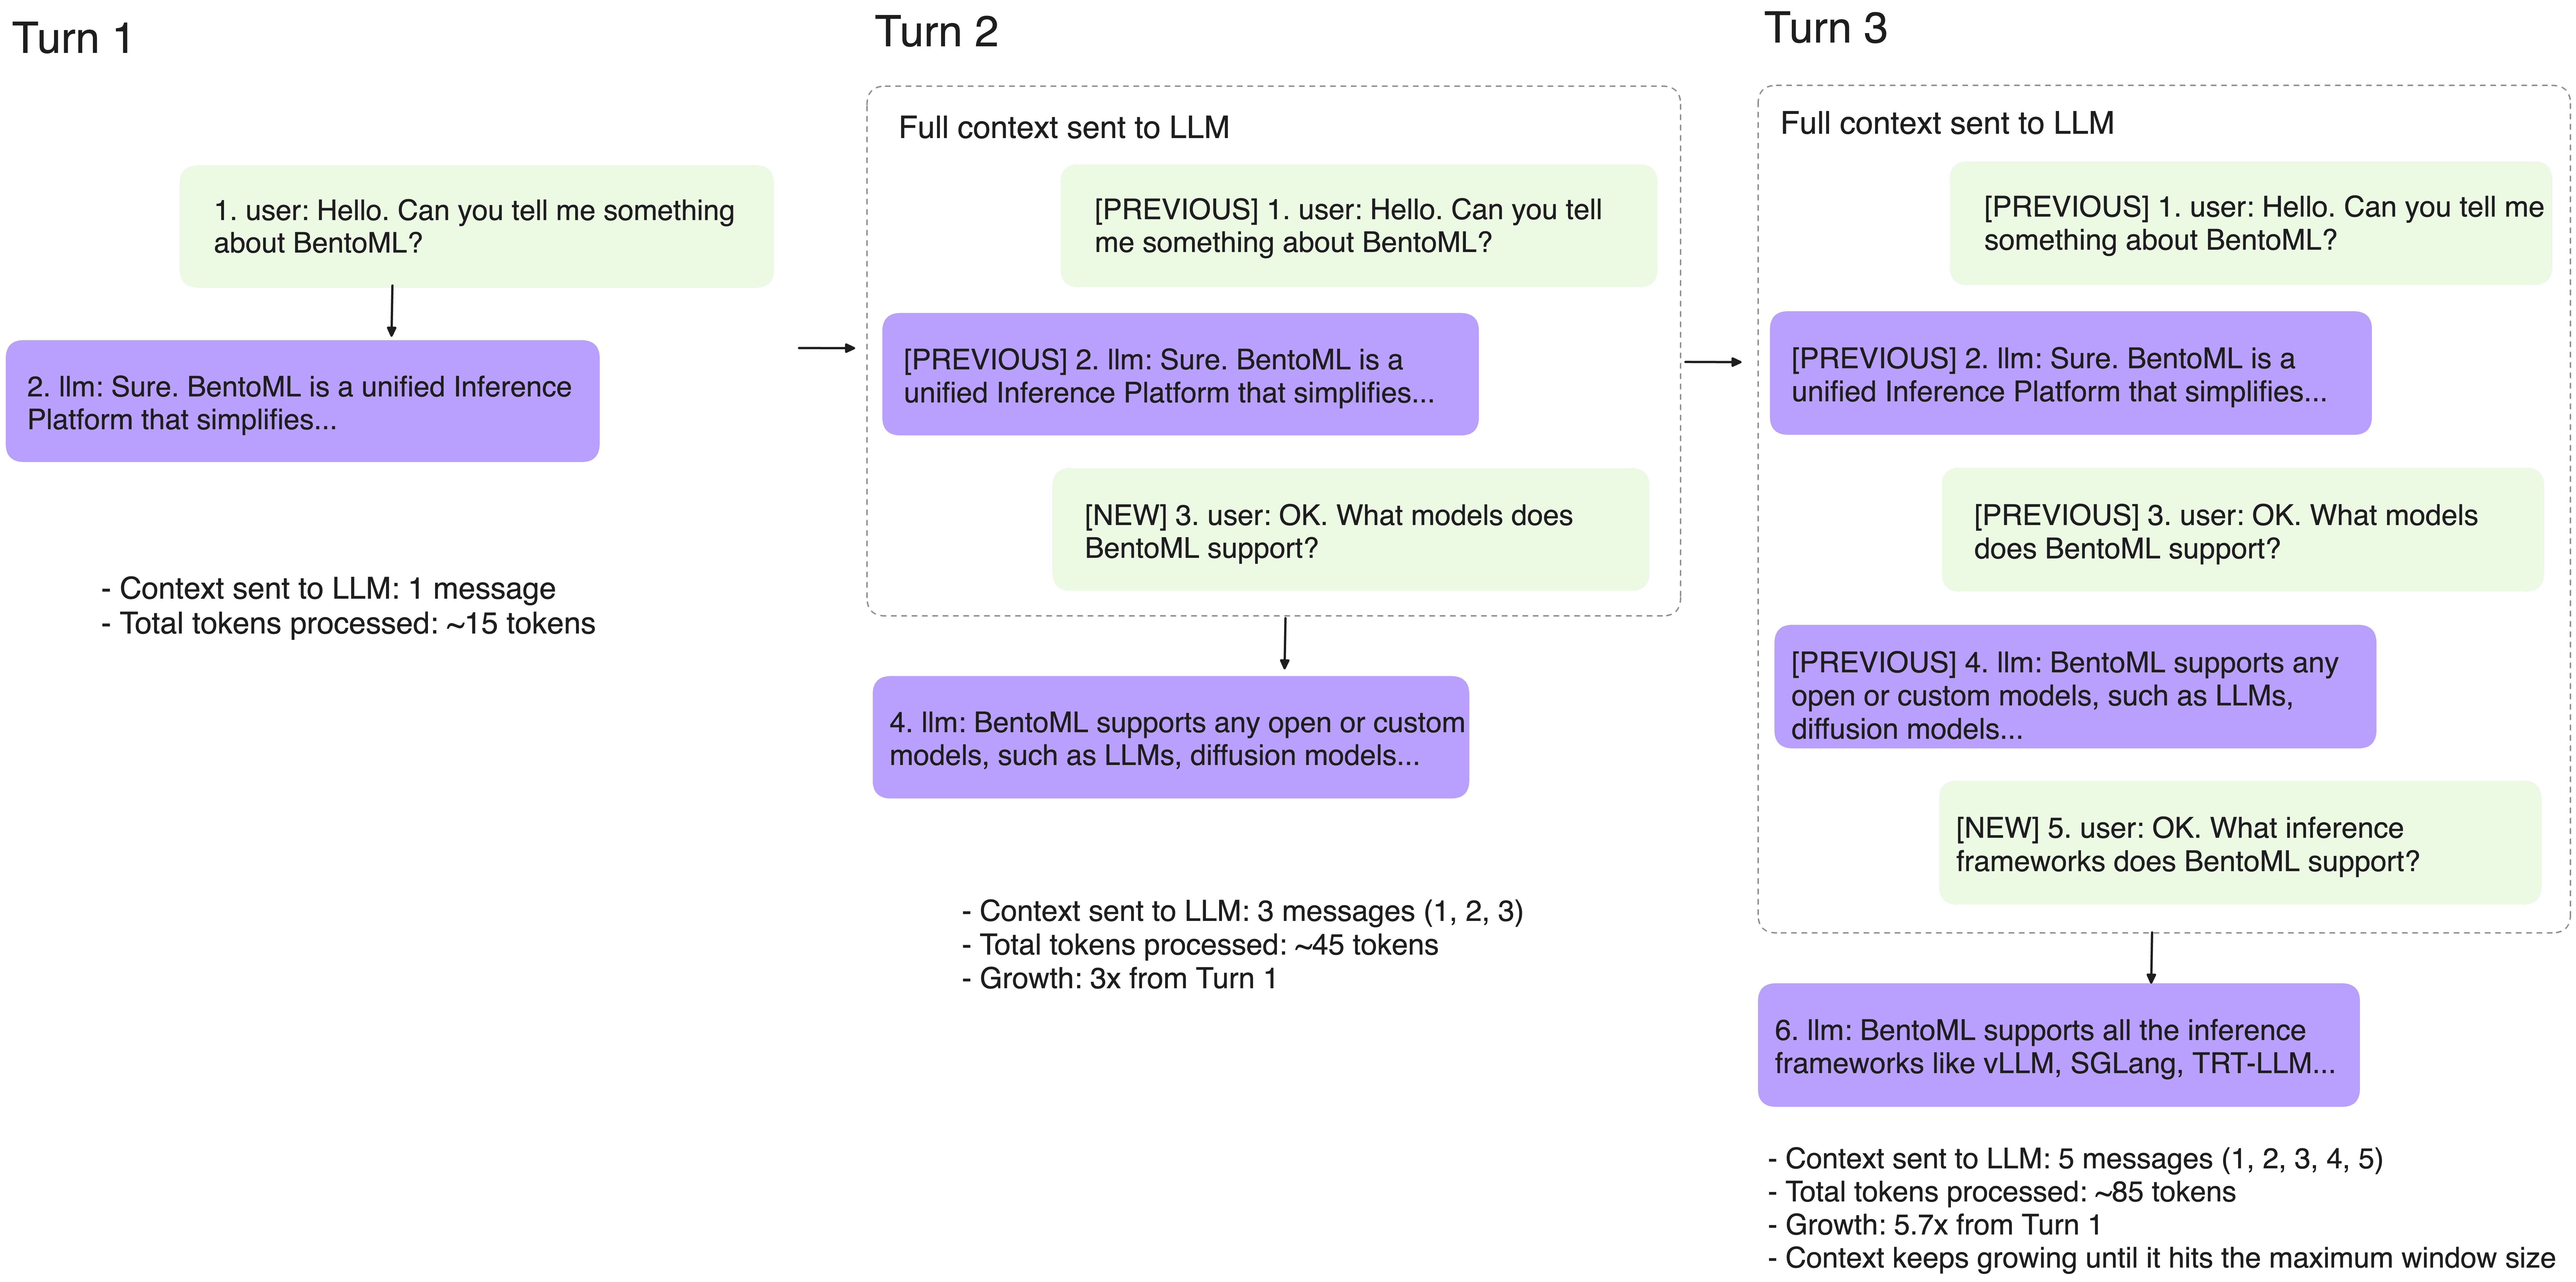
What is GPU Memory and Why it Matters for LLM Inference

Predictable LLM Serving on GPU Clusters | AI Research Paper Details