
Dcu Llm Agent Gpu Segmentfault

人工智能 - 面向国产 DCU 加速卡的 LLM Agent 驱动 GPU 内核优化框架适配与验证 - 个人文章 - SegmentFault 思否

人工智能 - 面向国产 DCU 加速卡的 LLM Agent 驱动 GPU 内核优化框架适配与验证 - 个人文章 - SegmentFault 思否

人工智能 - 面向国产 DCU 加速卡的 LLM Agent 驱动 GPU 内核优化框架适配与验证 - 个人文章 - SegmentFault 思否

人工智能 - 面向国产 DCU 加速卡的 LLM Agent 驱动 GPU 内核优化框架适配与验证 - 个人文章 - SegmentFault 思否

人工智能 - 面向 LLM 的 GPU 系统工程方法论 - IDP技术干货 - SegmentFault 思否

难以置信!使用这项新技术可以在单个 4GB GPU 上运行 70B LLM 推理 - 人工智能Momodel - SegmentFault 思否

人工智能 - 面向 LLM 的 GPU 系统工程方法论 - IDP技术干货 - SegmentFault 思否

人工智能 - 面向 LLM 的 GPU 系统工程方法论 - IDP技术干货 - SegmentFault 思否

人工智能 - 面向 LLM 的 GPU 系统工程方法论 - IDP技术干货 - SegmentFault 思否

java - 用 LLM Agent 重构告警排查流程|得物技术 - 个人文章 - SegmentFault 思否
Advertisement Space (300x250)

人工智能 - 面向 LLM 的 GPU 系统工程方法论 - IDP技术干货 - SegmentFault 思否

人工智能 - 相同的 LLM 在「不同 GPU 上」会产生不同输出?为什么? - IDP技术干货 - SegmentFault 思否
WebRTC LLM Streaming: Real-Time Voice Agent Infrastructure on GPU Cloud ...

人工智能 - 拒绝 GPU 集群资源浪费:教你打造自动化降本的 AI 运维 Agent - DigitalOcean ...

人工智能 - LLM Serving有效吞吐量的最大化实现 - 业界观点 - SegmentFault 思否
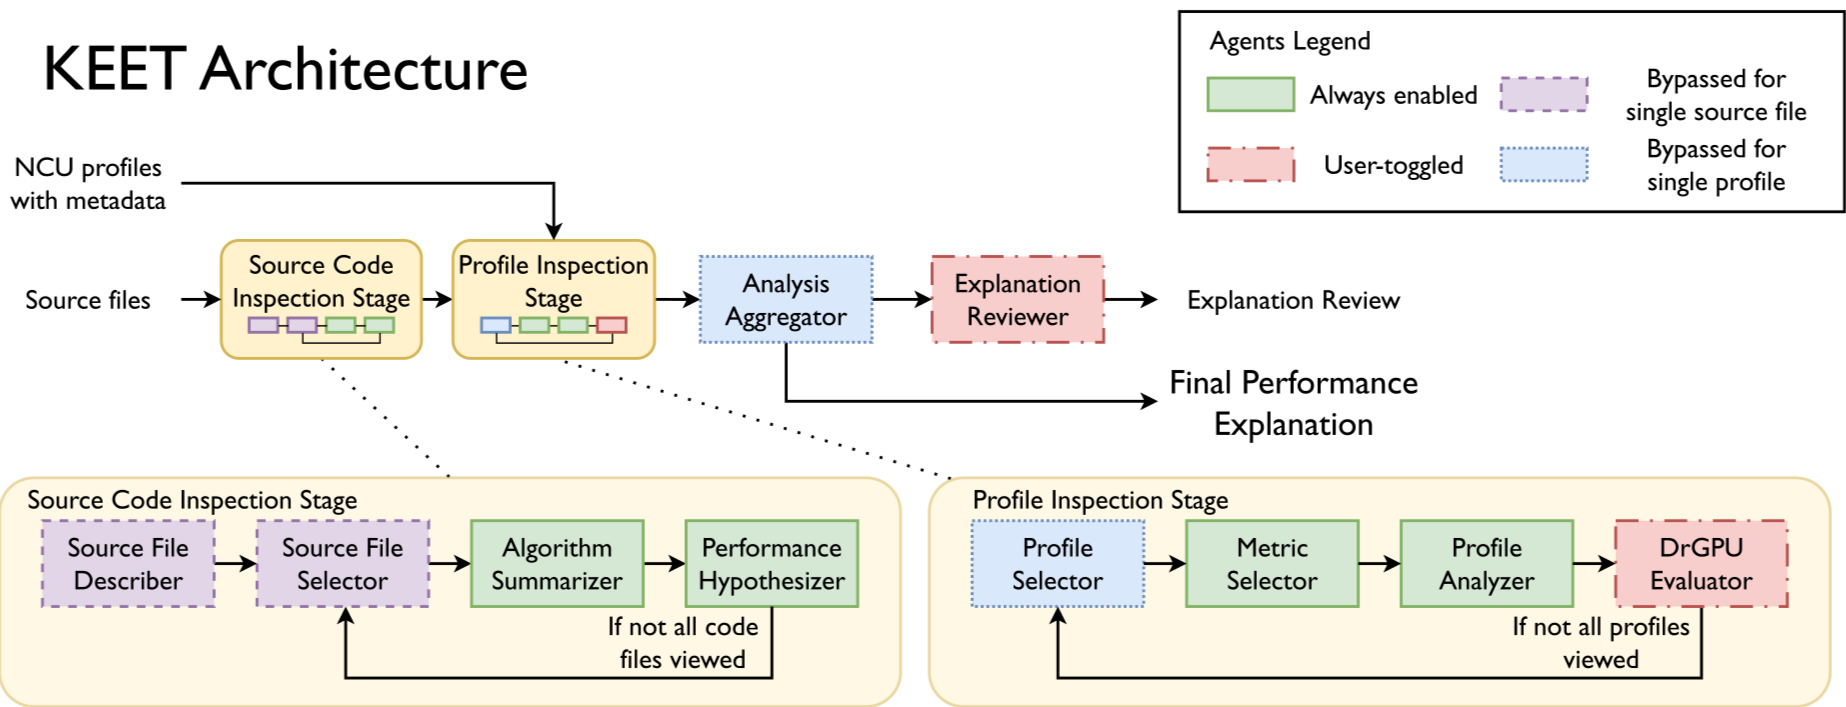
[論文レビュー] KEET: Explaining Performance of GPU Kernels Using LLM Agents

一文详尽之LLM-Based Agent - Datawhale - SegmentFault 思否

IR-01: GPU OOM Causing Cascading Latency in LLM Inference | by Gaurav ...

llm - Transformer 从零开始 - GoCoding - SegmentFault 思否

Parallelizing Tool Execution and LLM Generation for Low-Latency Agent ...
Advertisement Space (336x280)

llm - 如何估算不同大小的大模型需要多大的GPU? - 个人文章 - SegmentFault 思否

NEO: Saving GPU Memory Crisis with CPU Offloading for Online LLM Inference

KEET: Explaining Performance of GPU Kernels Using LLM Agents | AI ...

How NVIDIA improves GPU Cluster Utilization with LLM Agents - YouTube
LLM Inference - NVIDIA RTX GPU Performance | Puget Systems

一文详尽之LLM-Based Agent - Datawhale - SegmentFault 思否

ai开发 - Event-Driven Agent 实战:Prometheus 告警 → LLM → Tool Calling → 自动恢复 ...
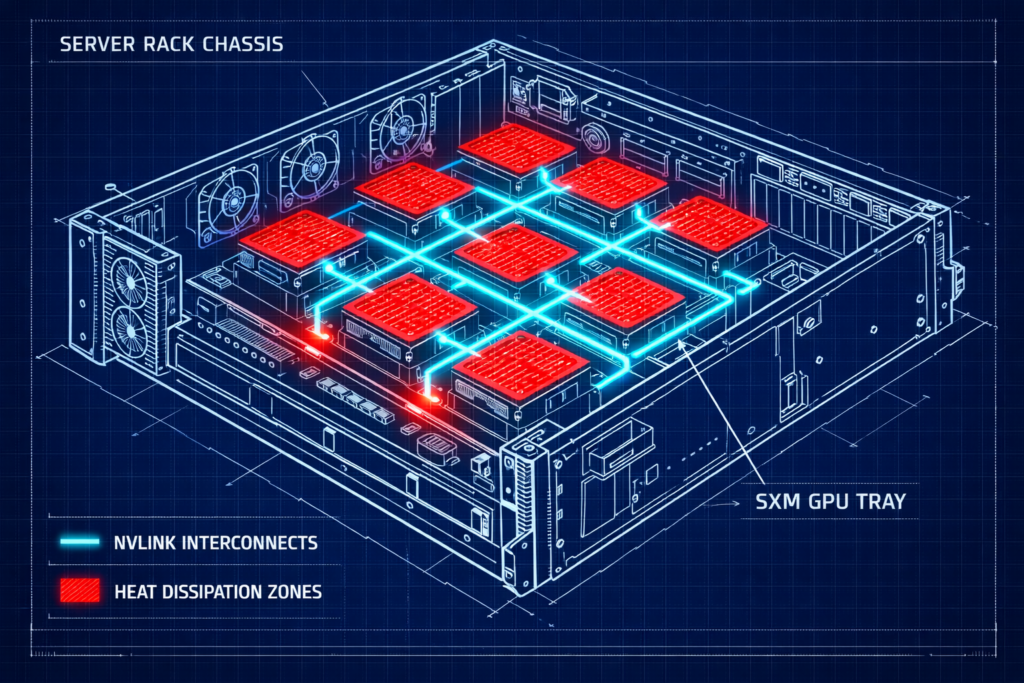
Private LLM Training Hardware: GPU Cluster Architecture Guide (2026)

How to Build a General-Purpose LLM Agent | Towards Data Science

llm - 使用 Amazon Bedrock Agents 加速生物标志物的分析和发现 - 亚马逊云开发者 - SegmentFault 思否
Advertisement Space (336x280)
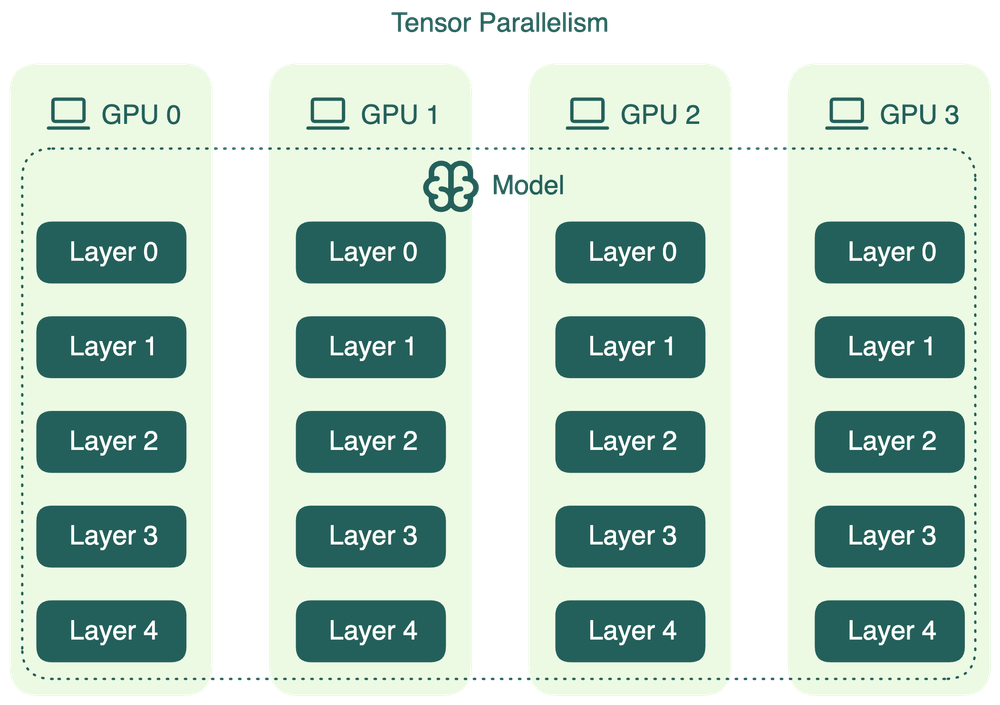
What is GPU Memory and Why it Matters for LLM Inference

Efficiently Scale LLM Training Across a Large GPU Cluster with Alpa and ...
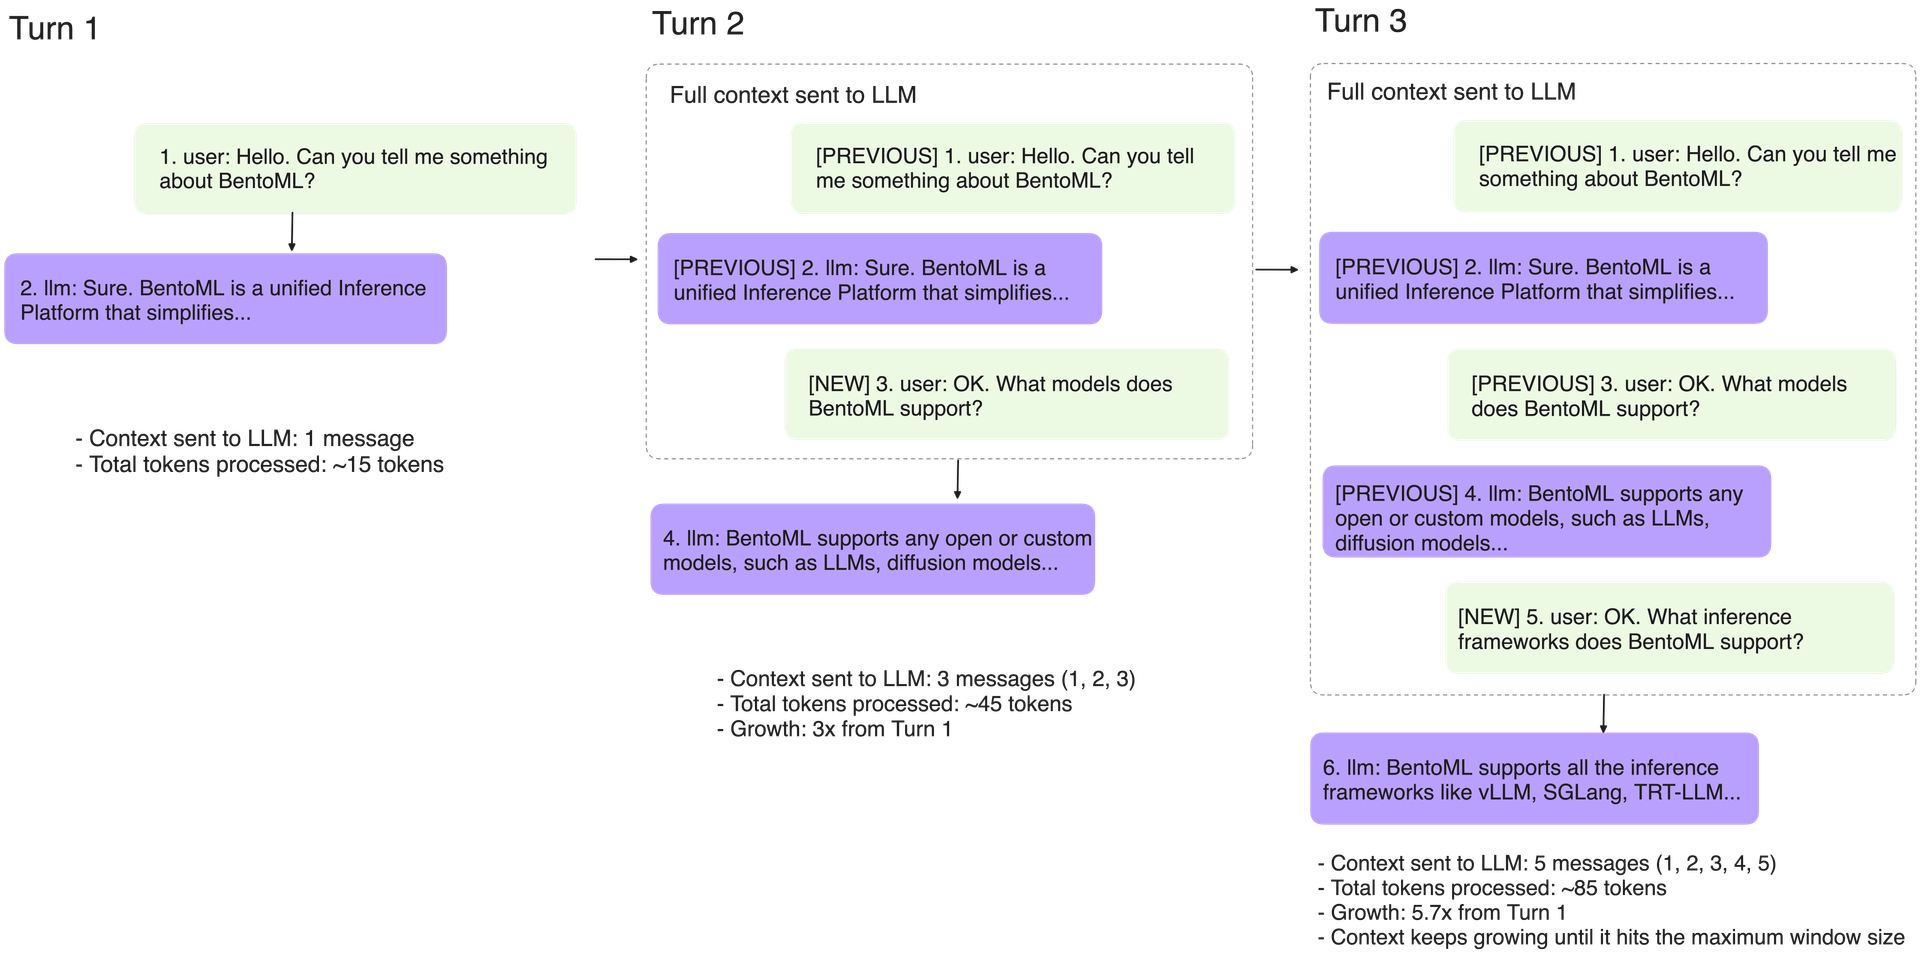
What is GPU Memory and Why it Matters for LLM Inference

人工智能 - LLM 大模型学习必知必会系列(十二):VLLM性能飞跃部署实践:从推理加速到高效部署 - 汀NLP - SegmentFault 思否

Efficiently Scale LLM Training Across a Large GPU Cluster with Alpa and ...
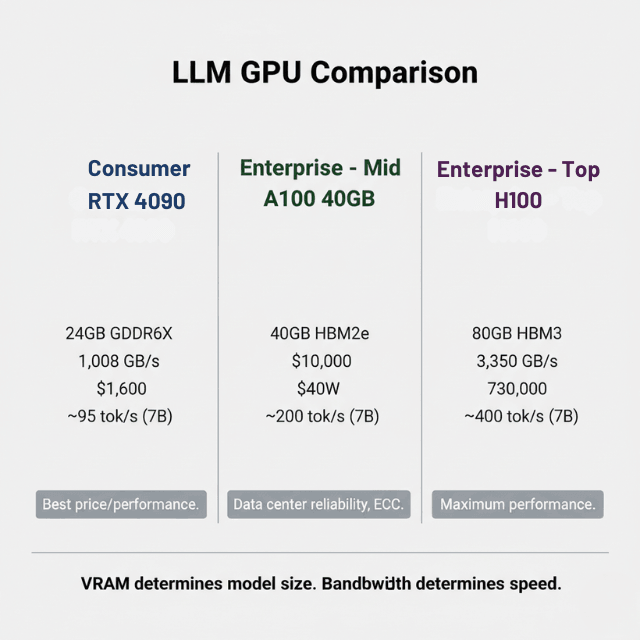
GPU Guide for LLM Deployment - RTX 4090 to A100 Benchmarks (2026)