
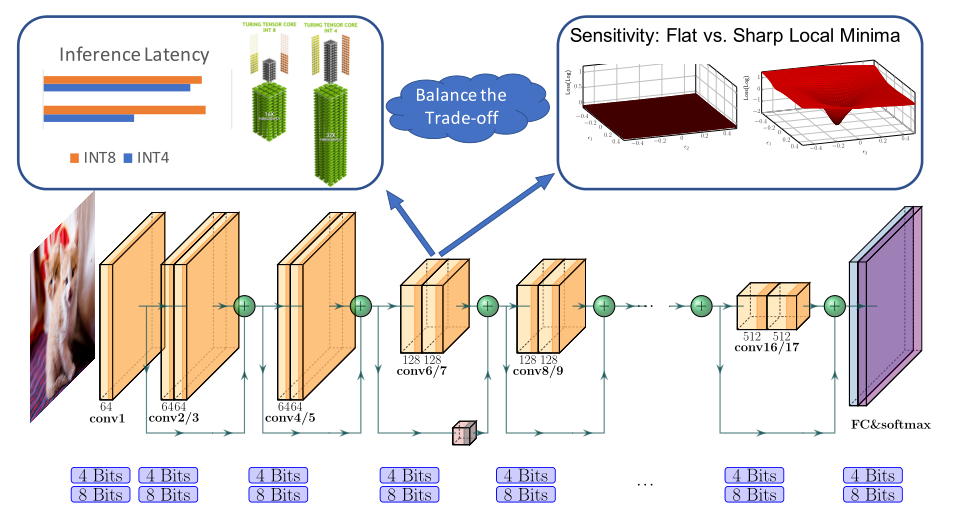
Memory Driven Mixed Low Precision Quantization For Enabling Deep

Memory-Driven Mixed Low Precision Quantization For Enabling Deep ...
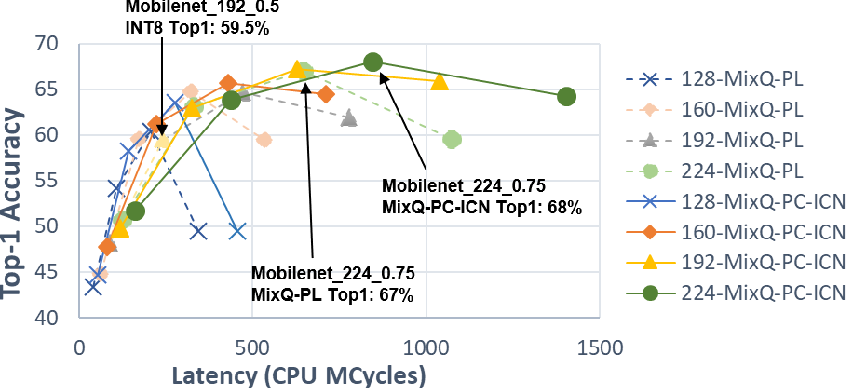
Memory-Driven Mixed Low Precision Quantization For Enabling Deep ...

(PDF) Memory-Driven Mixed Low Precision Quantization For Enabling Deep ...

MPQ-DM: Mixed Precision Quantization for Extremely Low Bit Diffusion Models
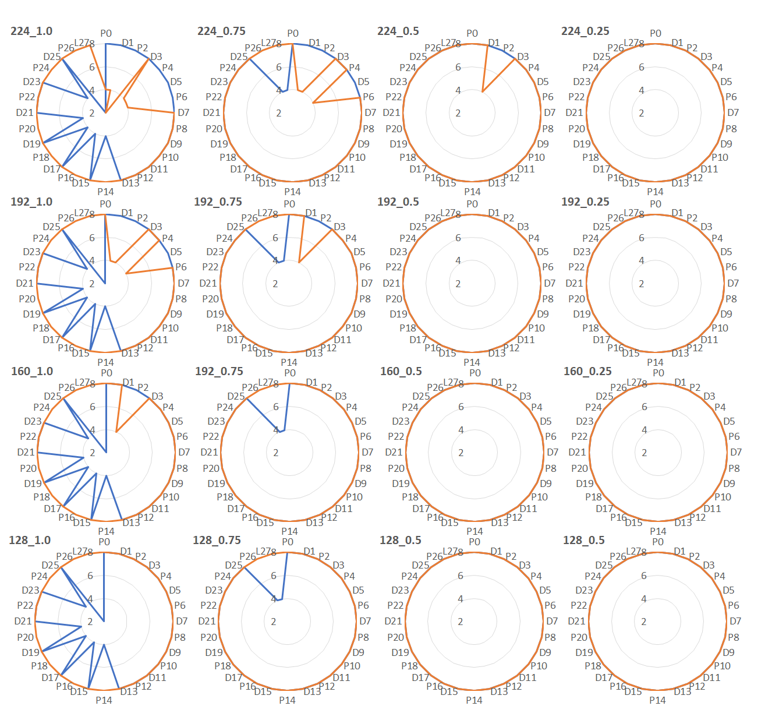
[1905.13082] Memory-Driven Mixed Low Precision Quantization For ...

[论文评述] MPQ-DM: Mixed Precision Quantization for Extremely Low Bit ...

Figure 1 from Mixed Precision Quantization for ReRAM-based DNN ...

Figure 1 from Mixed Precision Quantization for ReRAM-based DNN ...

Figure 1 from Mixed Precision Quantization for ReRAM-based DNN ...

Mixed Precision Quantization For ReRAM-based DNN Inference Accelerators ...
Advertisement Space (300x250)

On-Chip Hardware-Aware Quantization for Mixed Precision Neural Networks ...
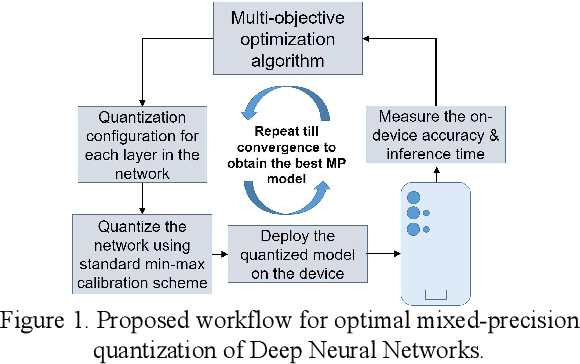
Figure 1 from Mixed Precision Neural Quantization with Multi-Objective ...
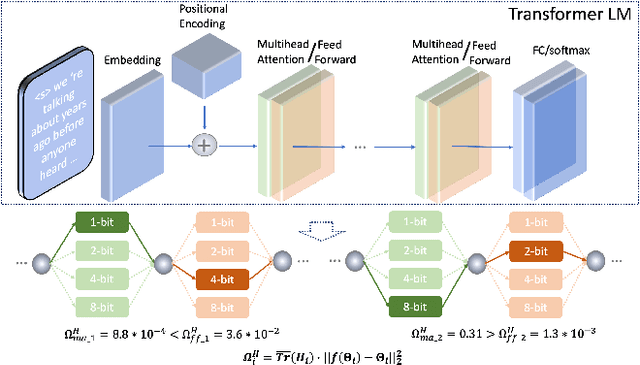
Mixed Precision Low-bit Quantization of Neural Network Language Models ...
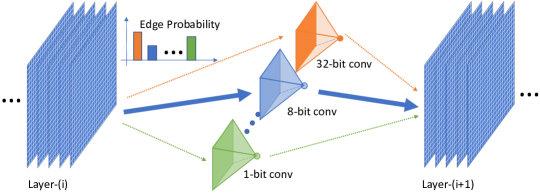
[1812.00090] Mixed Precision Quantization of ConvNets via ...

Mixed-Precision Graph Neural Quantization for Low Bit Large Language Models
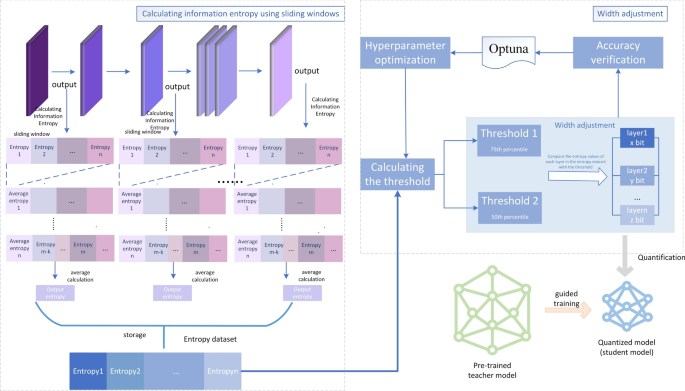
Mixed precision quantization based on information entropy | Scientific ...

Figure 1 from Network Compression via Mixed Precision Quantization ...

[논문 리뷰] Effective and Efficient Mixed Precision Quantization of Speech ...
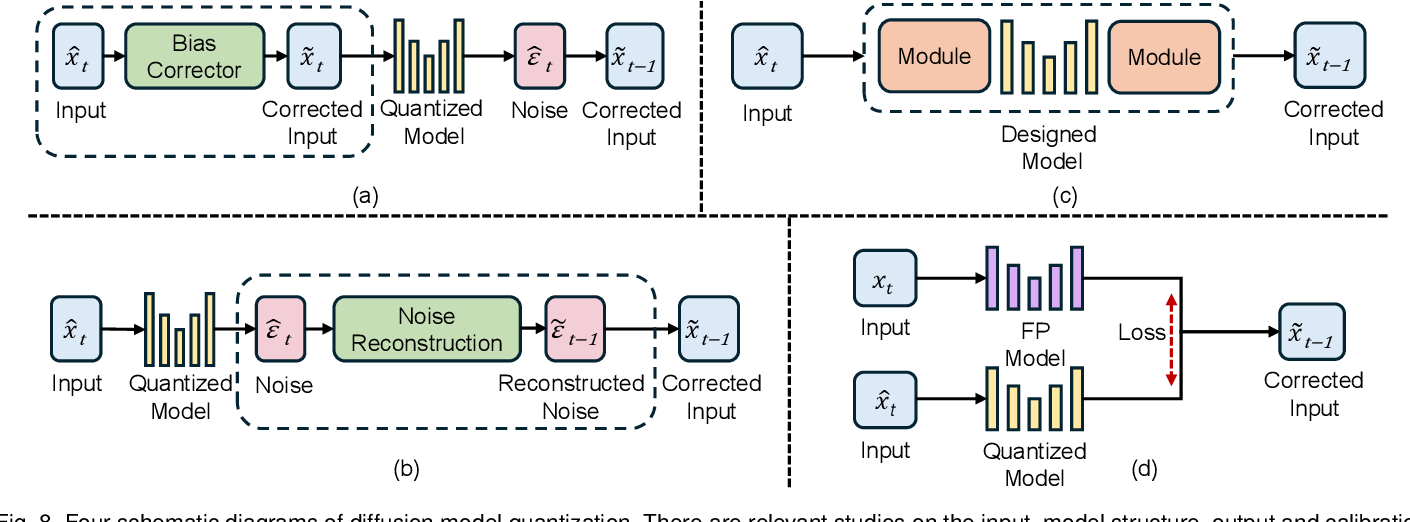
Figure 8 from Low-bit Model Quantization for Deep Neural Networks: A ...
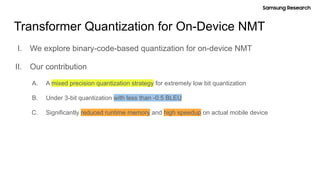
Extremely Low Bit Transformer Quantization for On-Device NMT | PDF
Advertisement Space (336x280)

[논문 리뷰] Mixed-Precision Graph Neural Quantization for Low Bit Large ...

Mixed Precision Low-bit Quantization of Neural Network Language Models ...
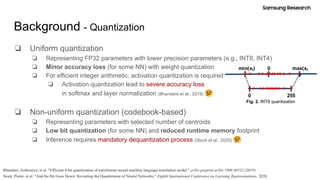
Extremely Low Bit Transformer Quantization for On-Device NMT | PDF

Paper Reading||Differentiable Dynamic Quantization with Mixed Precision ...
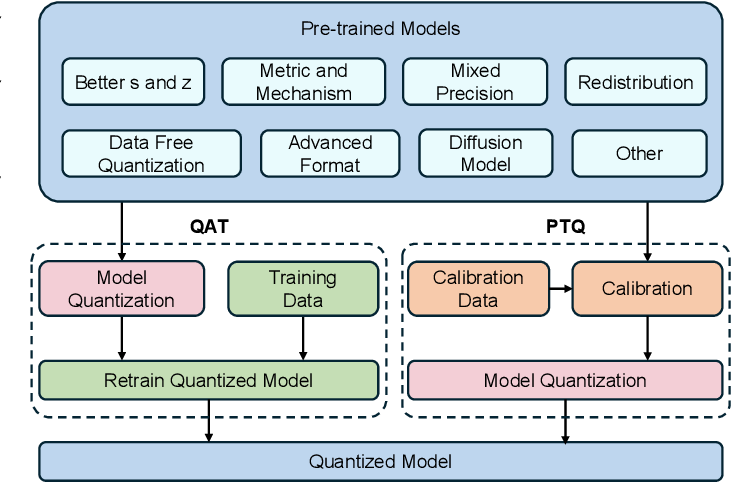
Figure 2 from Low-bit Model Quantization for Deep Neural Networks: A ...

Low-bit Model Quantization for Deep Neural Networks: A Survey | AI ...

Figure 1 from Efficient and Effective Methods for Mixed Precision ...

[PDF] Post Training Mixed Precision Quantization of Neural Networks ...

(PDF) Low-bit Model Quantization for Deep Neural Networks: A Survey
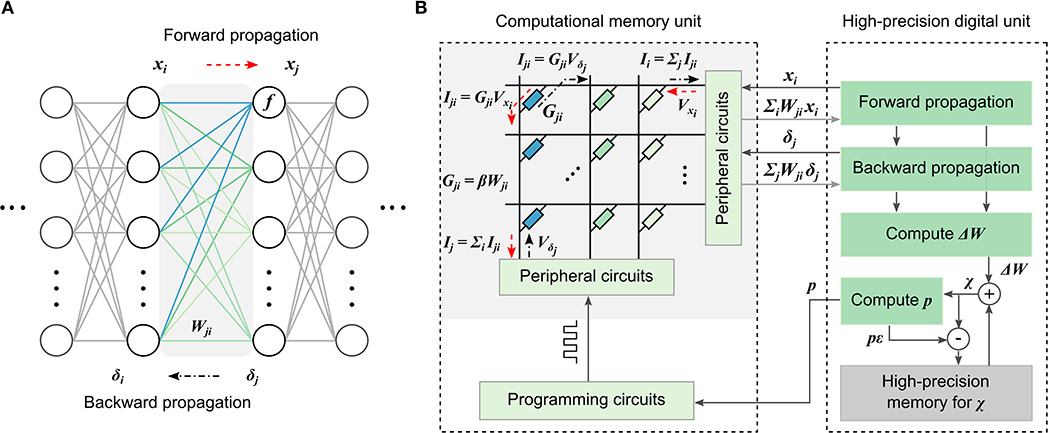
Frontiers | Mixed-Precision Deep Learning Based on Computational Memory
Advertisement Space (336x280)
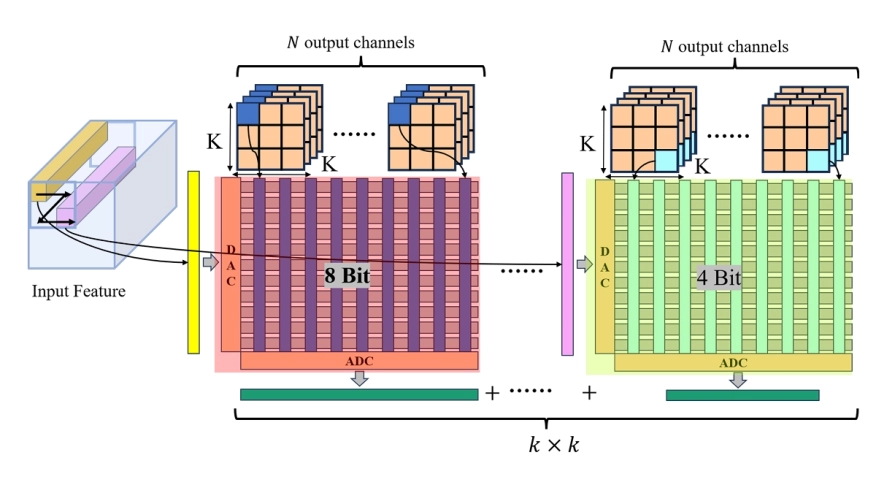
Sensitivity-Aware Mixed-Precision Quantization for ReRAM-based ...
【读点论文】A Survey of Quantization Methods for Efficient Neural Network ...
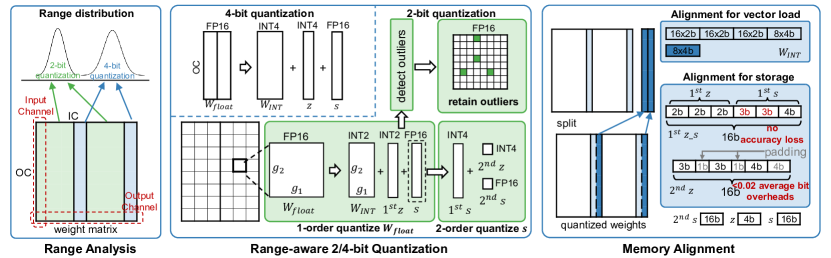
[2311.16442] Enabling Fast 2-bit LLM on GPUs: Memory Alignment and ...
Layer-wise quantization sensitivity analysis for mixedprecision ...

Sensitivity-Aware Mixed-Precision Quantization for ReRAM-based ...

Hierarchical Mixed-Precision Post-Training Quantization for SAR Ship ...