
Mpq Dm Mixed Precision Quantization For Extremely Low Bit
MPQ-DM: Mixed Precision Quantization for Extremely Low Bit Diffusion ...

[论文评述] MPQ-DM: Mixed Precision Quantization for Extremely Low Bit ...

(PDF) Memory-Driven Mixed Low Precision Quantization For Enabling Deep ...

Extremely Low Bit Transformer Quantization for On-Device NMT | PDF
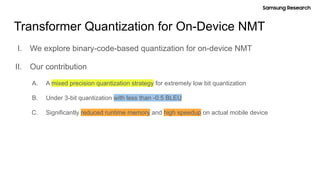
Extremely Low Bit Transformer Quantization for On-Device NMT | PDF
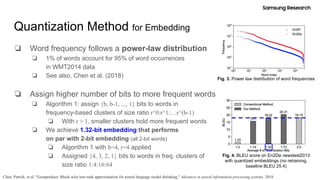
Extremely Low Bit Transformer Quantization for On-Device NMT | PDF
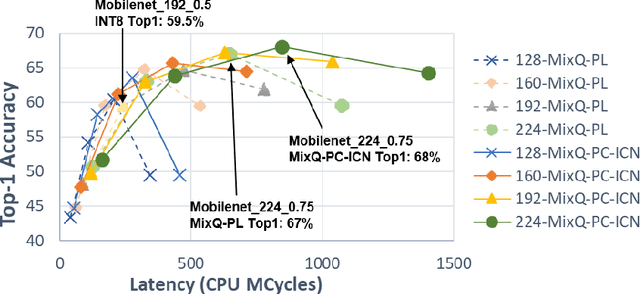
Memory-Driven Mixed Low Precision Quantization For Enabling Deep ...
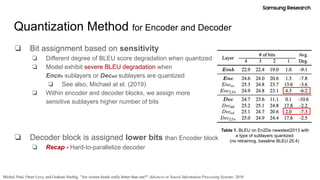
Extremely Low Bit Transformer Quantization for On-Device NMT | PDF
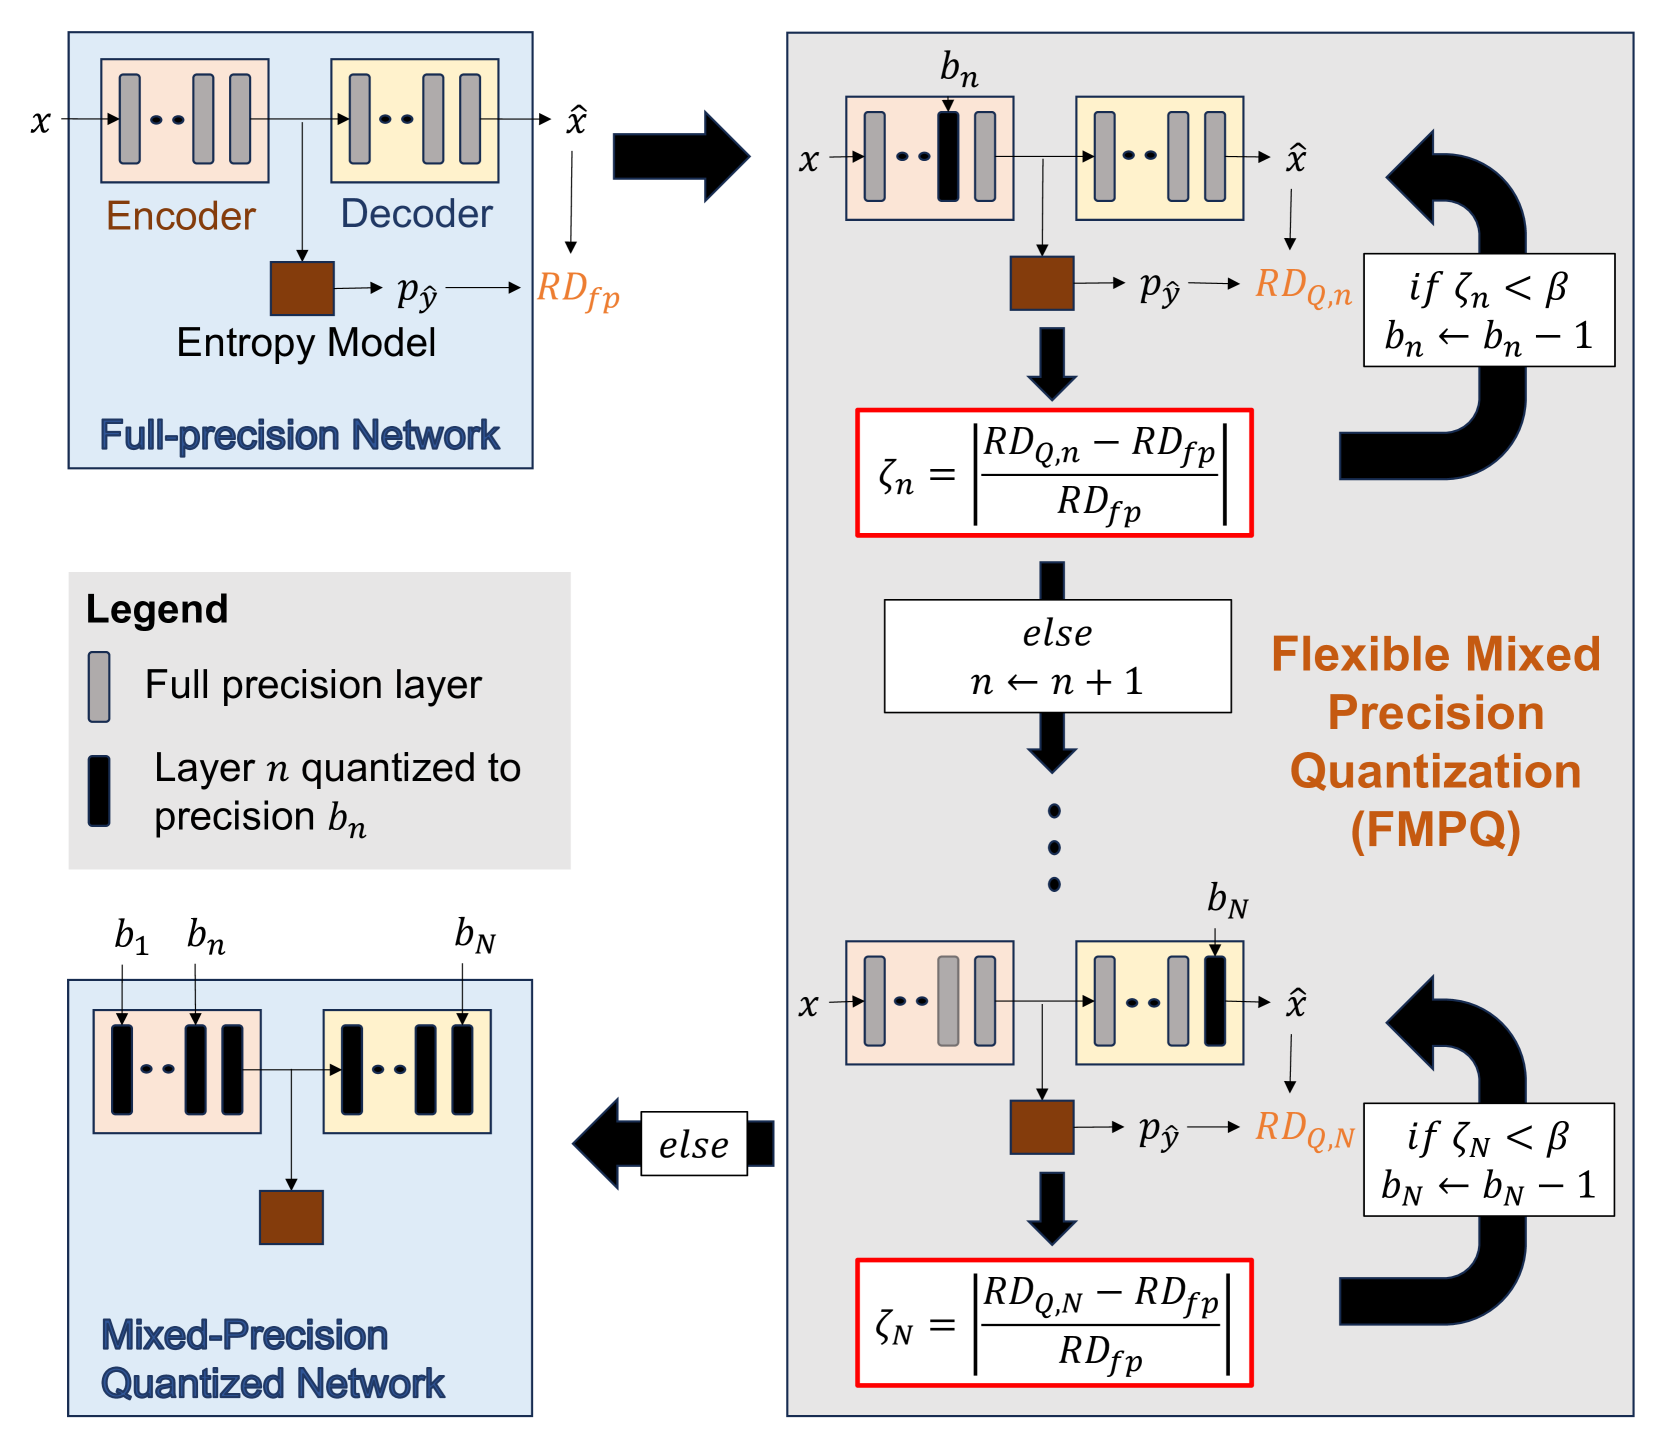
Flexible Mixed Precision Quantization for Learned Image Compression ...

Mixed-Precision Graph Neural Quantization for Low Bit Large Language Models
Advertisement Space (300x250)

Figure 1 from Mixed Precision Quantization for ReRAM-based DNN ...

[論文レビュー] Mixed-Precision Graph Neural Quantization for Low Bit Large ...
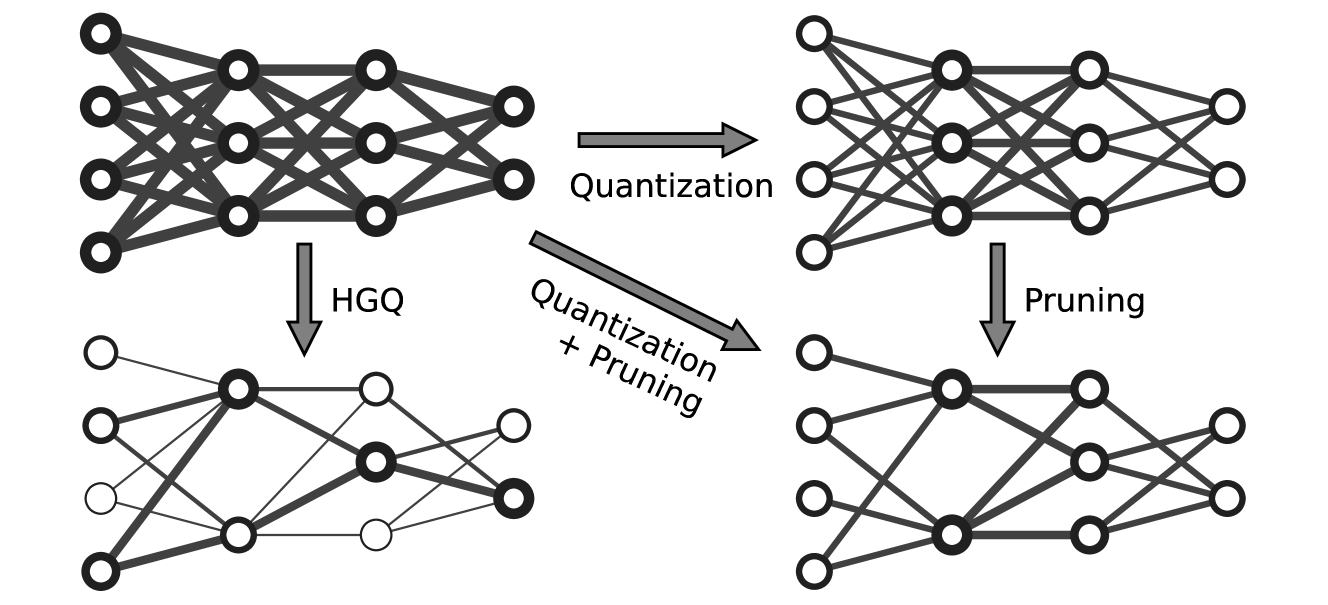
On-Chip Hardware-Aware Quantization for Mixed Precision Neural Networks ...

Figure 1 from Mixed Precision Quantization for ReRAM-based DNN ...
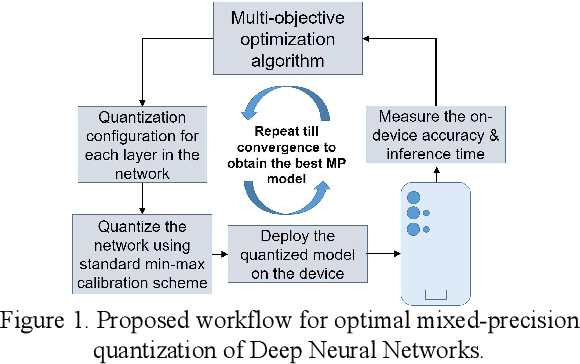
Figure 1 from Mixed Precision Neural Quantization with Multi-Objective ...

OMPQ: Orthogonal Mixed Precision Quantization | DeepAI

MBCQ: Mixed-bias compensation quantization for extremely low-bit post ...
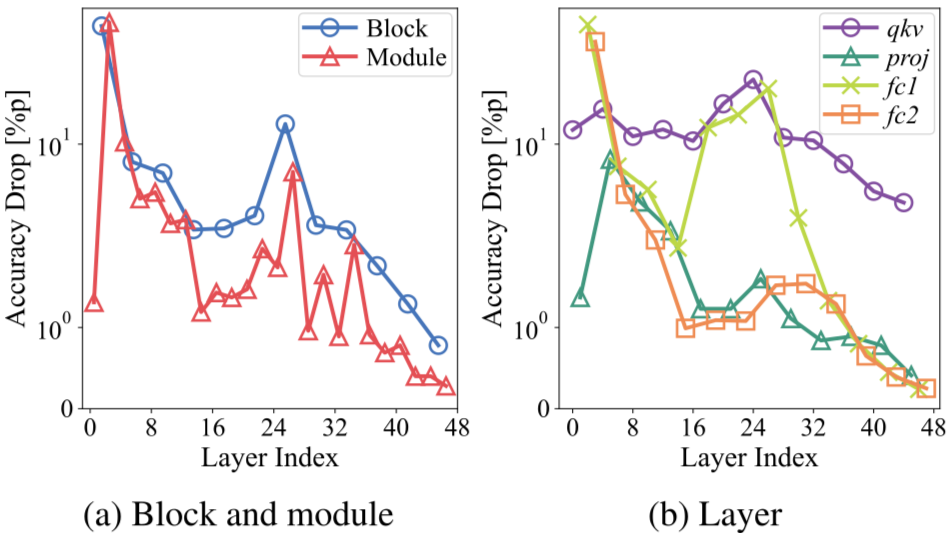
[论文评述] LampQ: Towards Accurate Layer-wise Mixed Precision Quantization ...

Figure 1 from Network Compression via Mixed Precision Quantization ...
Underline | OMPQ: Orthogonal Mixed Precision Quantization
Advertisement Space (336x280)
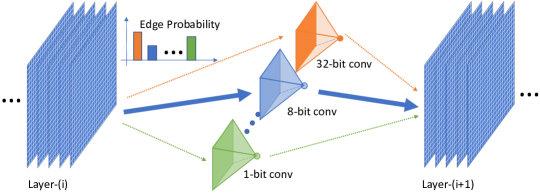
[1812.00090] Mixed Precision Quantization of ConvNets via ...
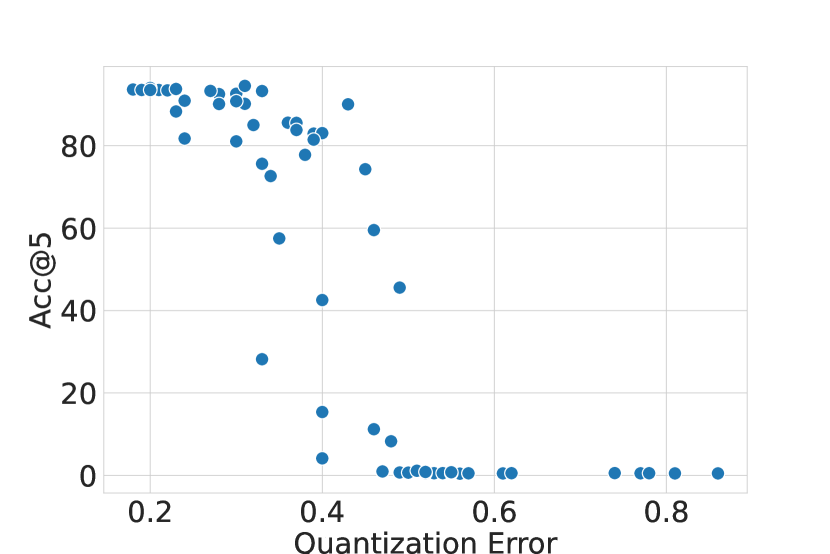
[2309.17341] MixQuant: Mixed Precision Quantization with a Bit-width ...
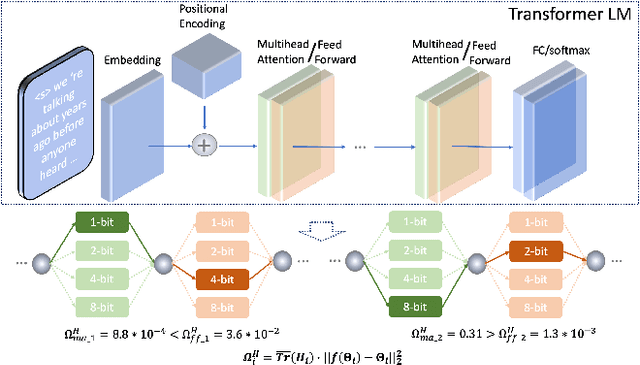
Mixed Precision Low-bit Quantization of Neural Network Language Models ...
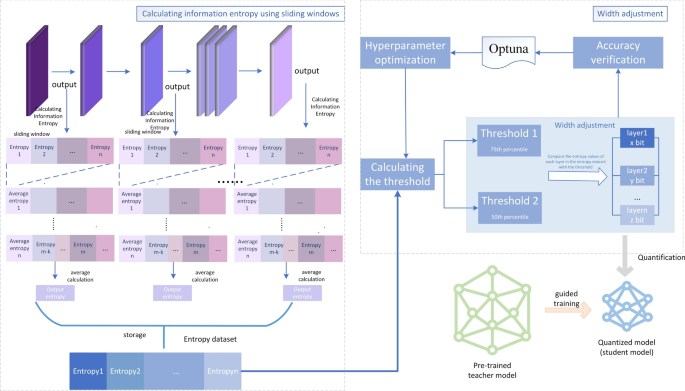
Mixed precision quantization based on information entropy | Scientific ...

Comparison of mixed precision quantization (denoted as 'mixed') v.s ...

MUXQ: Mixed-to-Uniform Precision MatriX Quantization via Low-Rank ...

Learn about MSQ, a new framework for mixed-precision quantization at ...

Hierarchical Mixed-Precision Post-Training Quantization for SAR Ship ...

MoQAE: Mixed-Precision Quantization for Long-Context LLM Inference via ...

MUXQ: Mixed-to-Uniform Precision MatriX Quantization via Low-Rank ...
Advertisement Space (336x280)

MUXQ: Mixed-to-Uniform Precision MatriX Quantization via Low-Rank ...

Mixed-Precision Quantization for Language Models: Techniques and ...
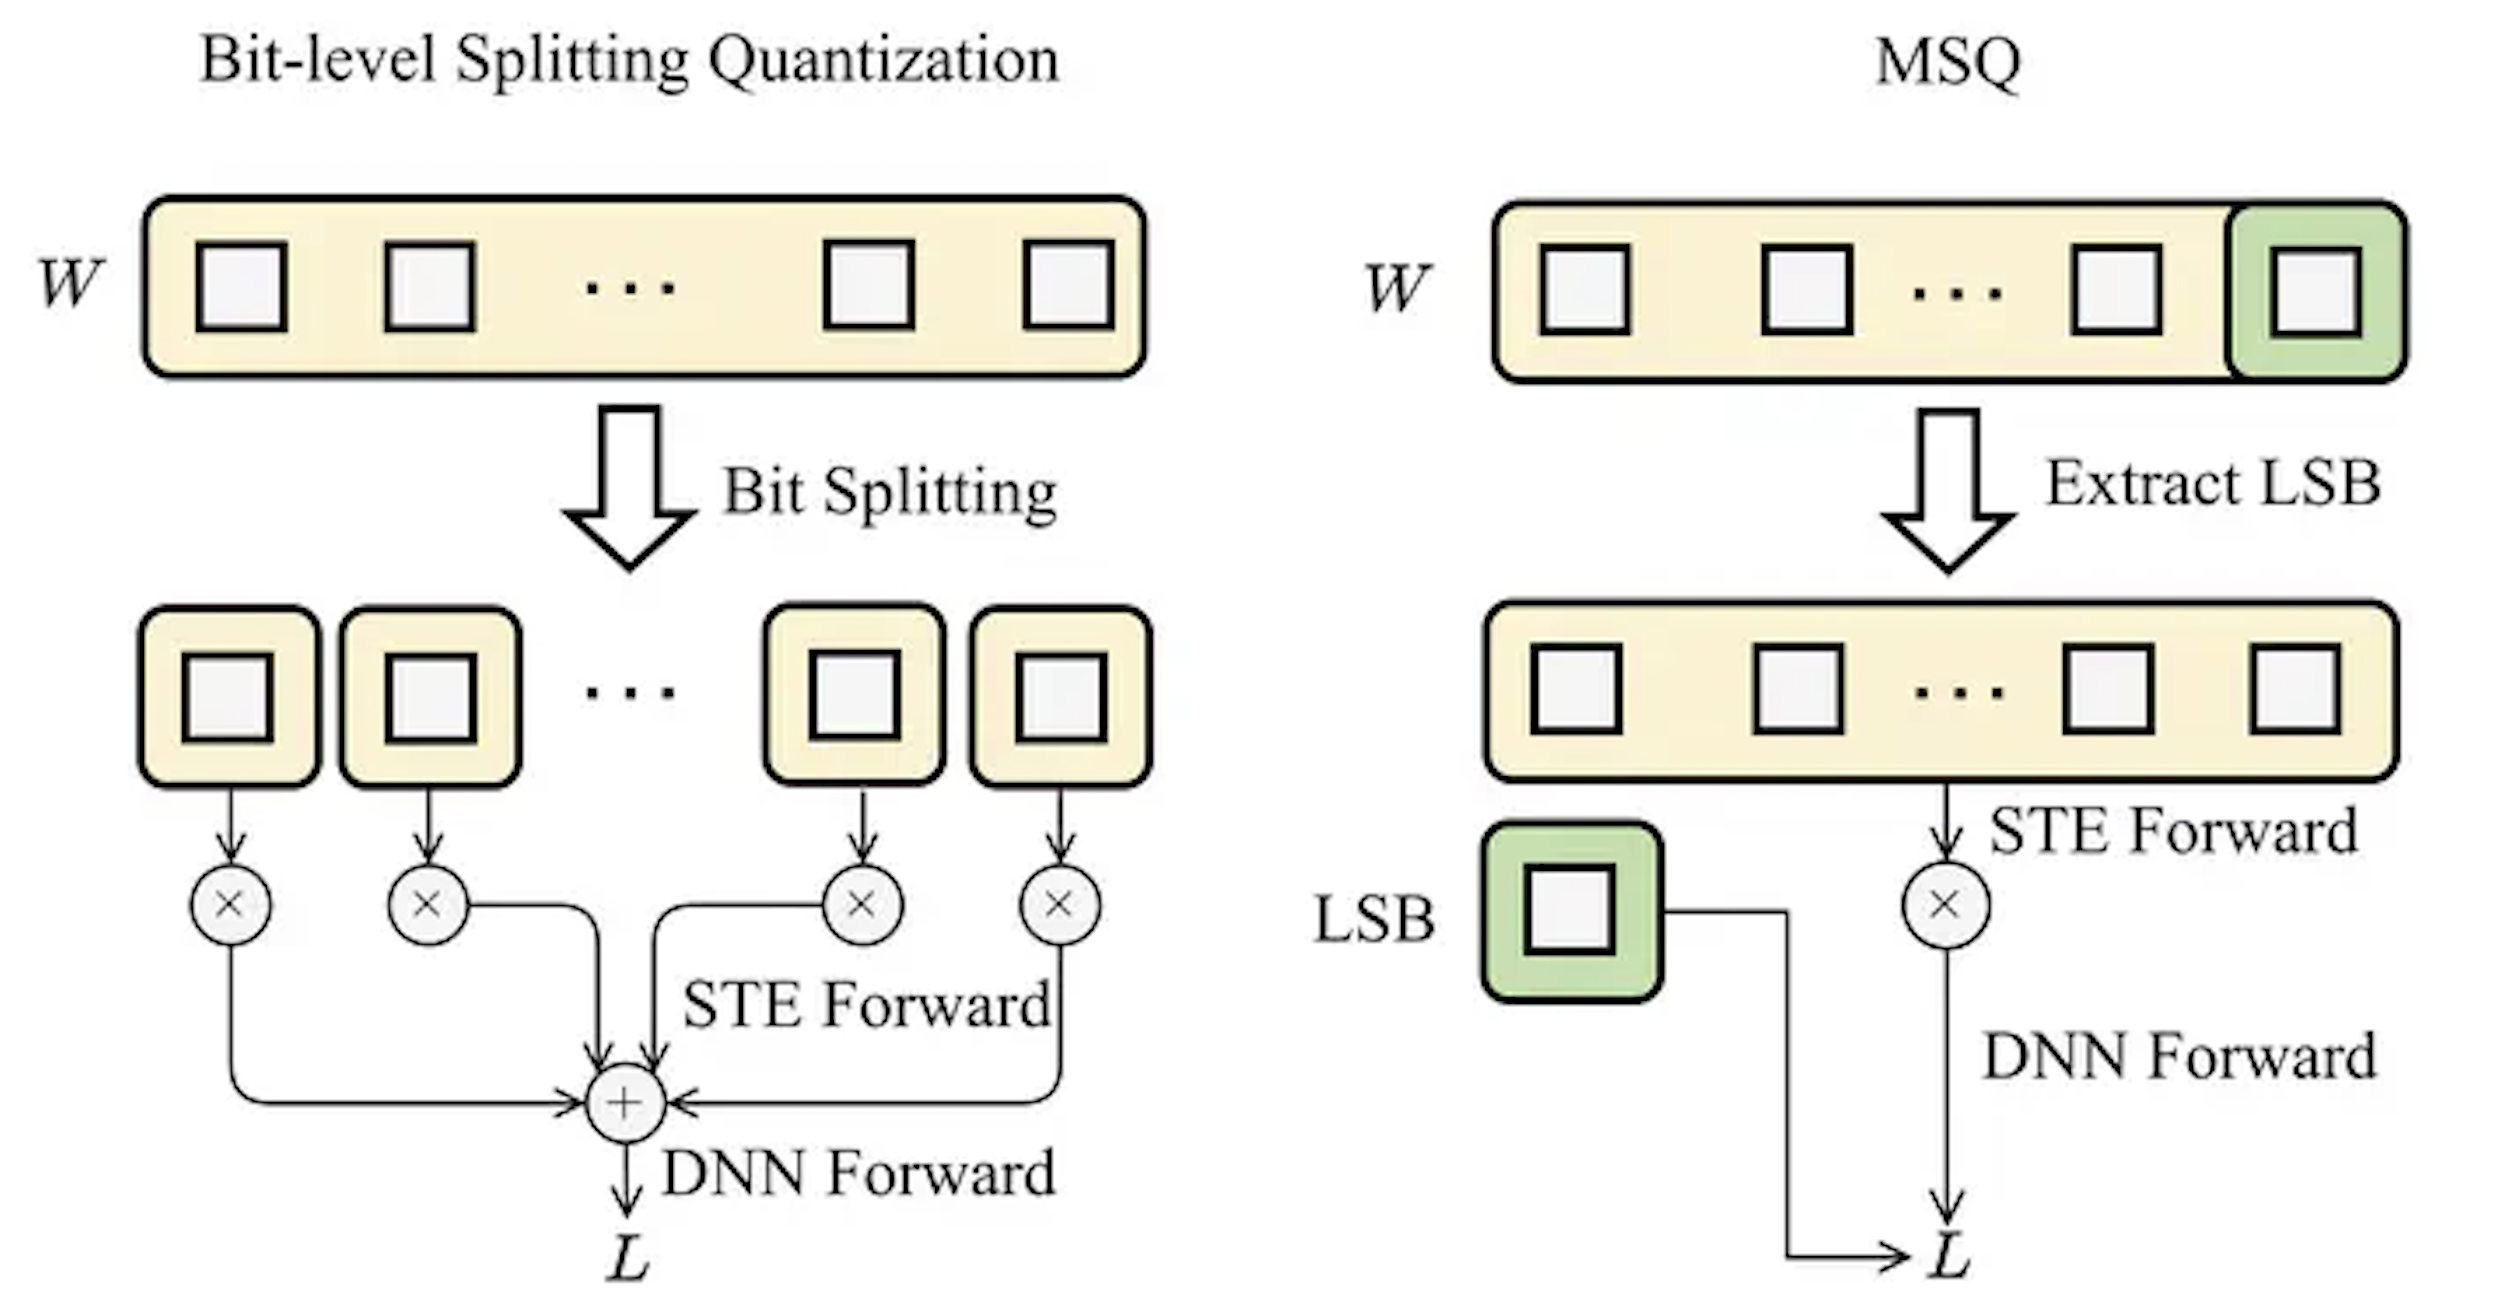
MSQ: Memory-Efficient Bit Sparsification Quantization - Seokho Han

MUXQ: Mixed-to-Uniform Precision MatriX Quantization via Low-Rank ...

Dpq: Dynamic Pseudo-Mean Mixed-Precision Quantization For – TUBEQ
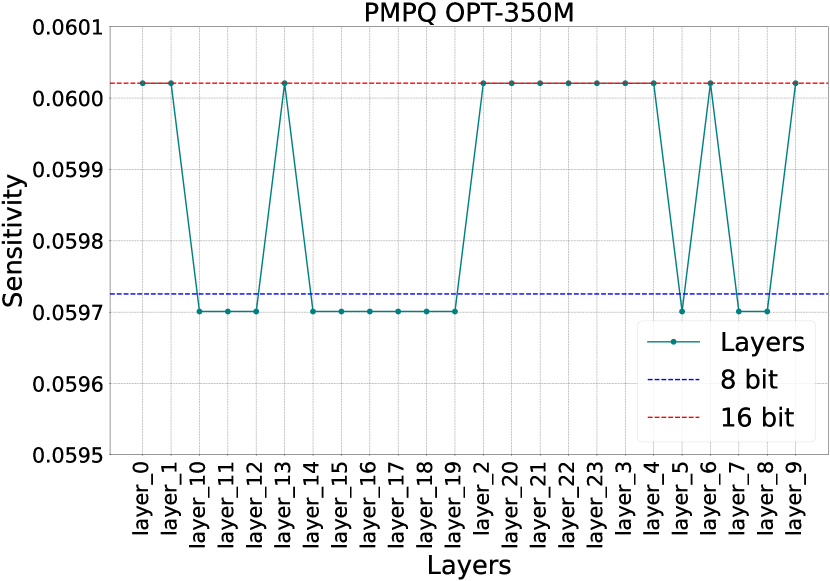
[2412.03599] CPTQuant - A Novel Mixed Precision Post-Training ...