
Optimizing Deployment And Inference For Large Scale Transformer Models

Optimizing Deployment and Inference for Large-Scale Transformer Models ...

(PDF) Optimizing Transformer Models for Edge Deployment in Autonomous ...

(PDF) Optimizing Transformer Models for Low-Latency Inference ...

Accelerated Inference for Large Transformer Models Using NVIDIA Triton ...
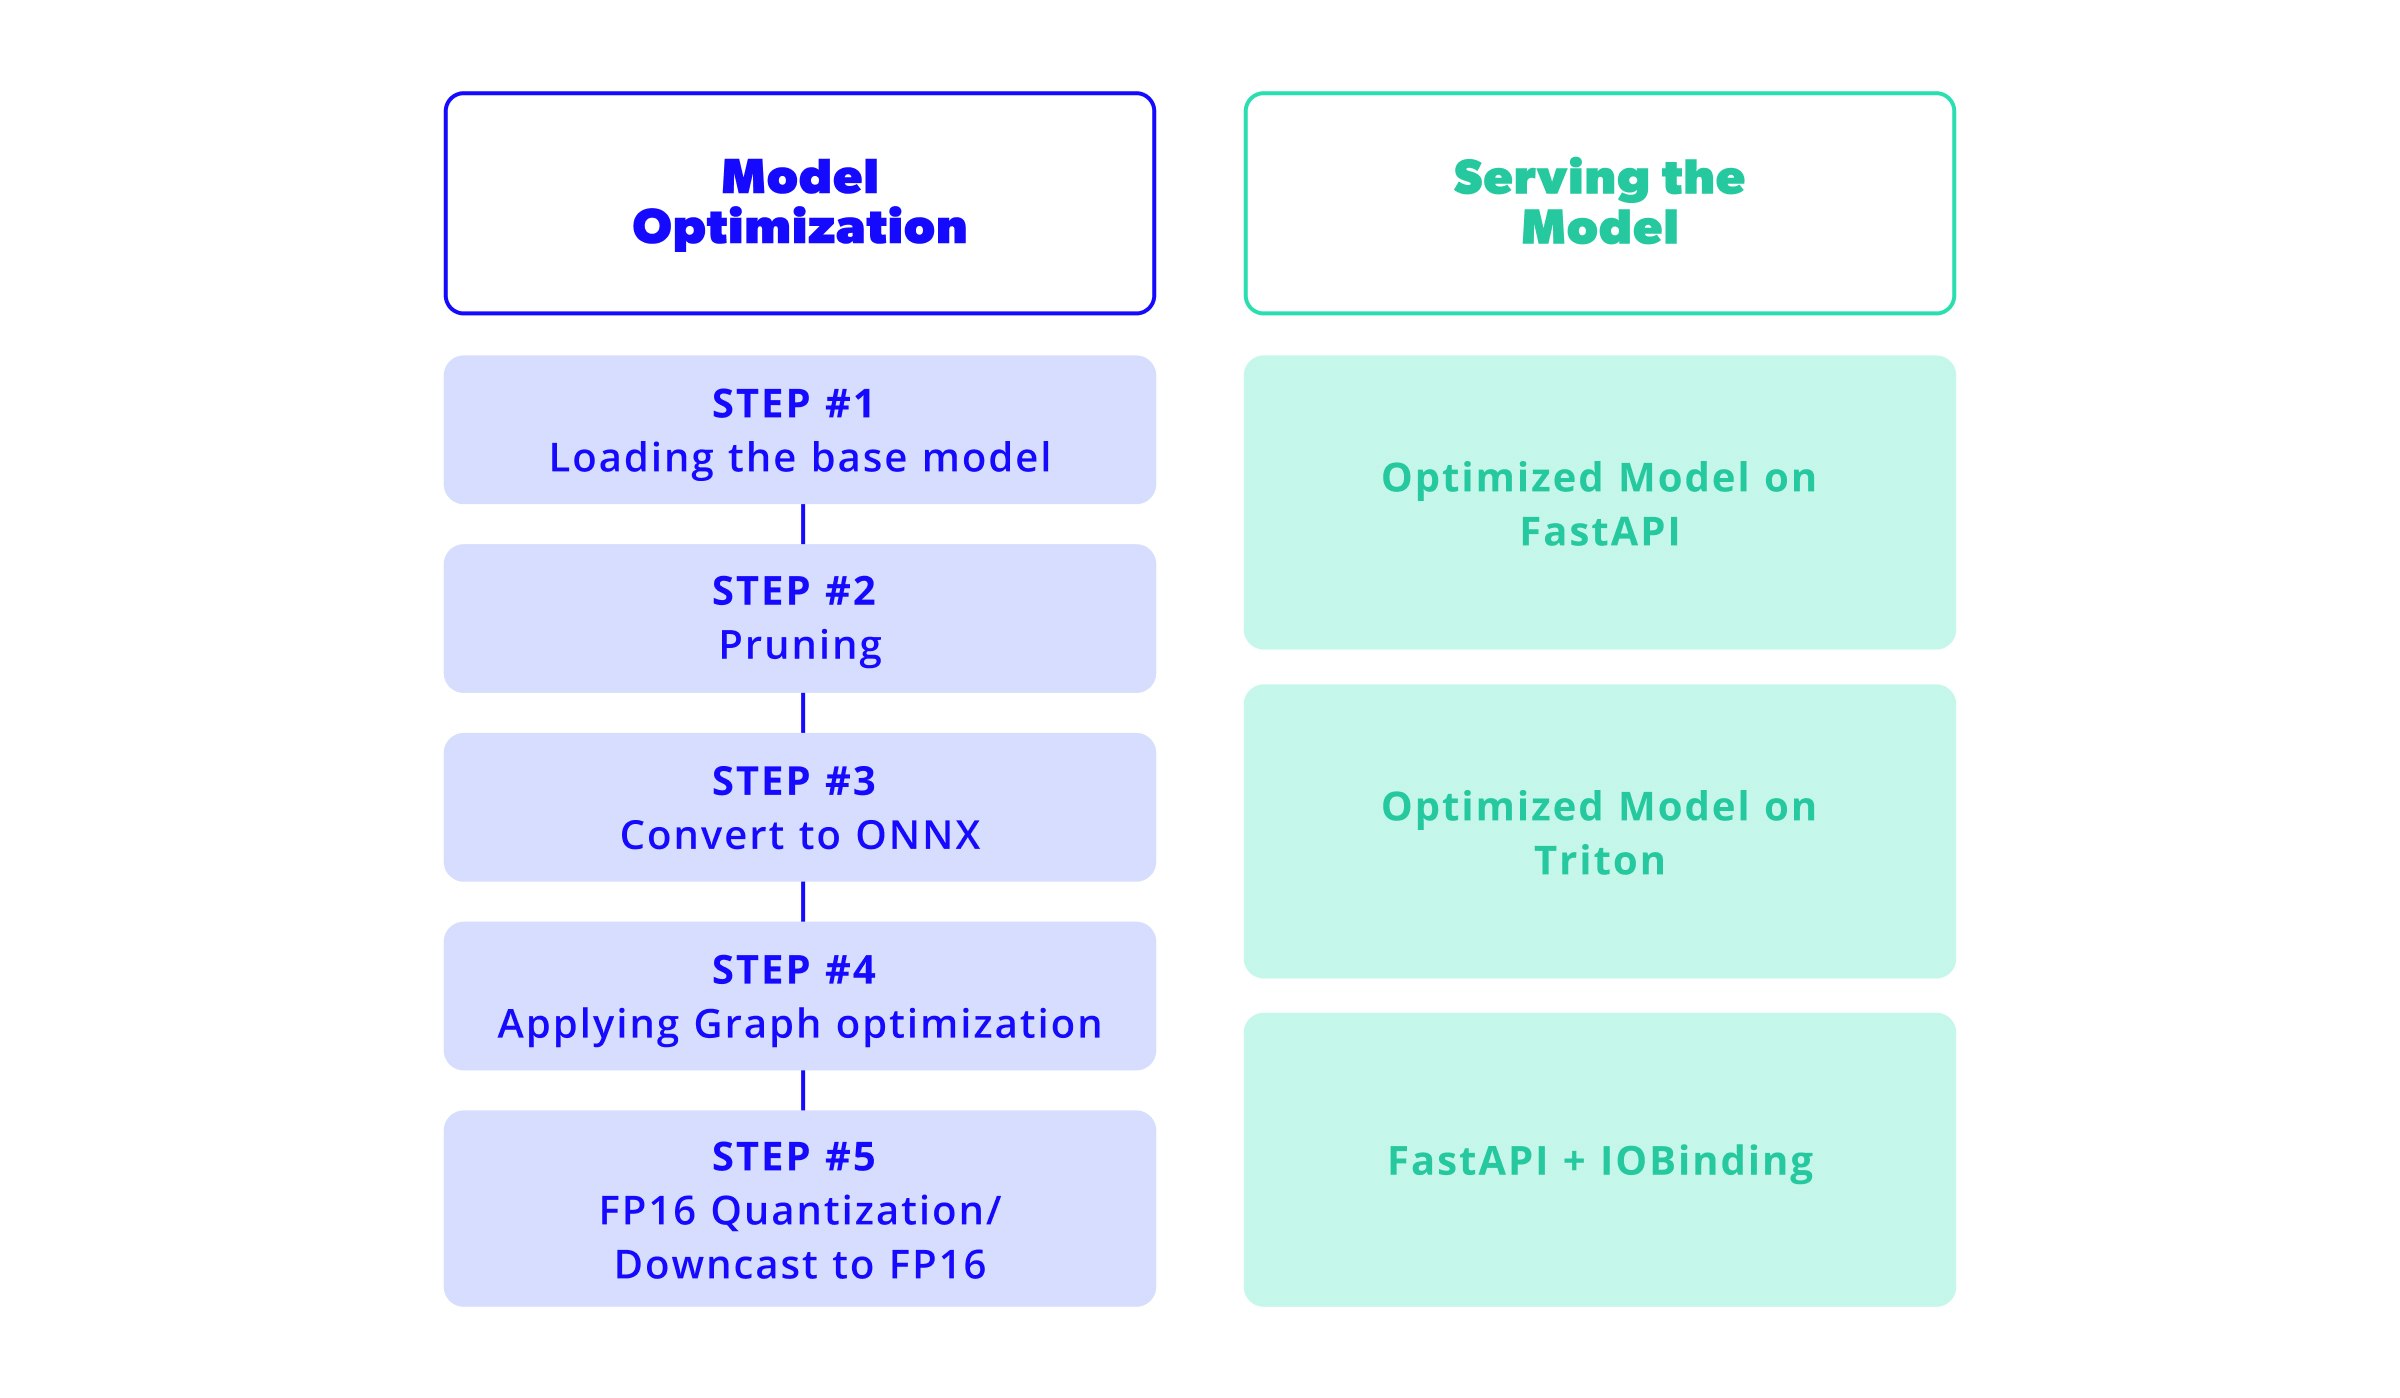
A guide to optimizing Transformer-based models for faster inference ...
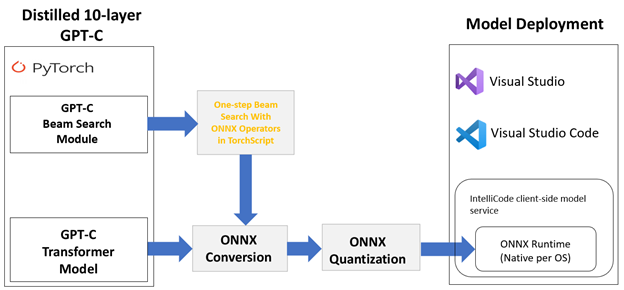
optimize large scale transformer model inference – RxHarun
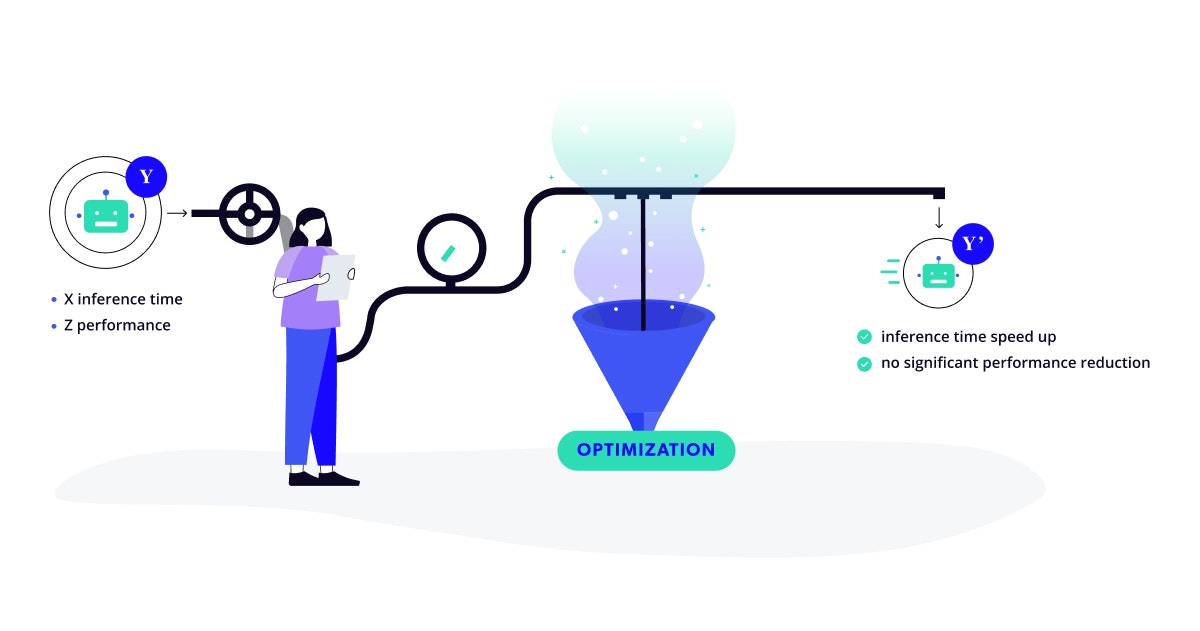
A guide to optimizing Transformer-based models for faster inference ...
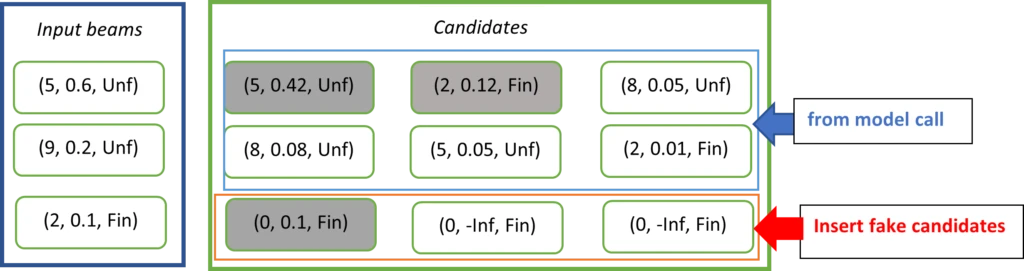
optimize large scale transformer model inference – RxHarun
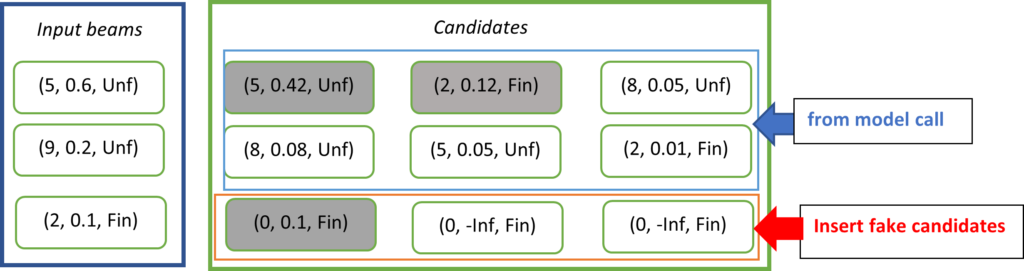
optimize large scale transformer model inference – RxHarun
Ithy - Understanding and Optimizing Large Language Model Inference
Advertisement Space (300x250)

Optimizing Vision Transformer Model For Deployment – BXEZAV

Optimizing inference for massive scale models: A guide for MLOps ...

Optimizing Vision Transformer Model For Deployment – PXAFI
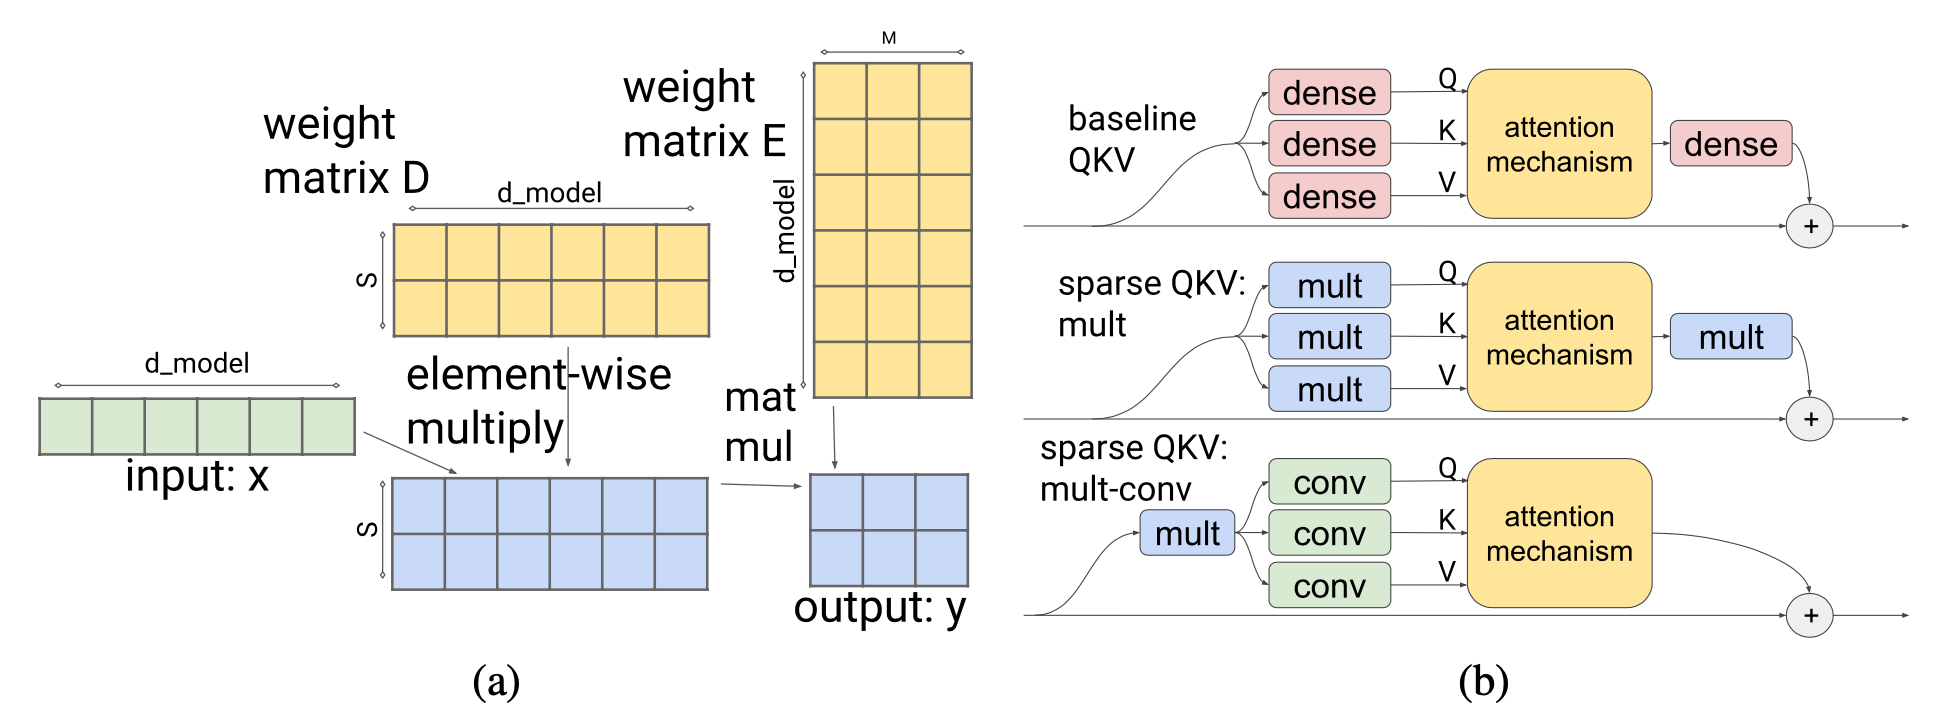
Large Transformer Model Inference Optimization | Lil'Log

Figure 2 from Efficient Deployment of Transformer Models on Edge TPU ...
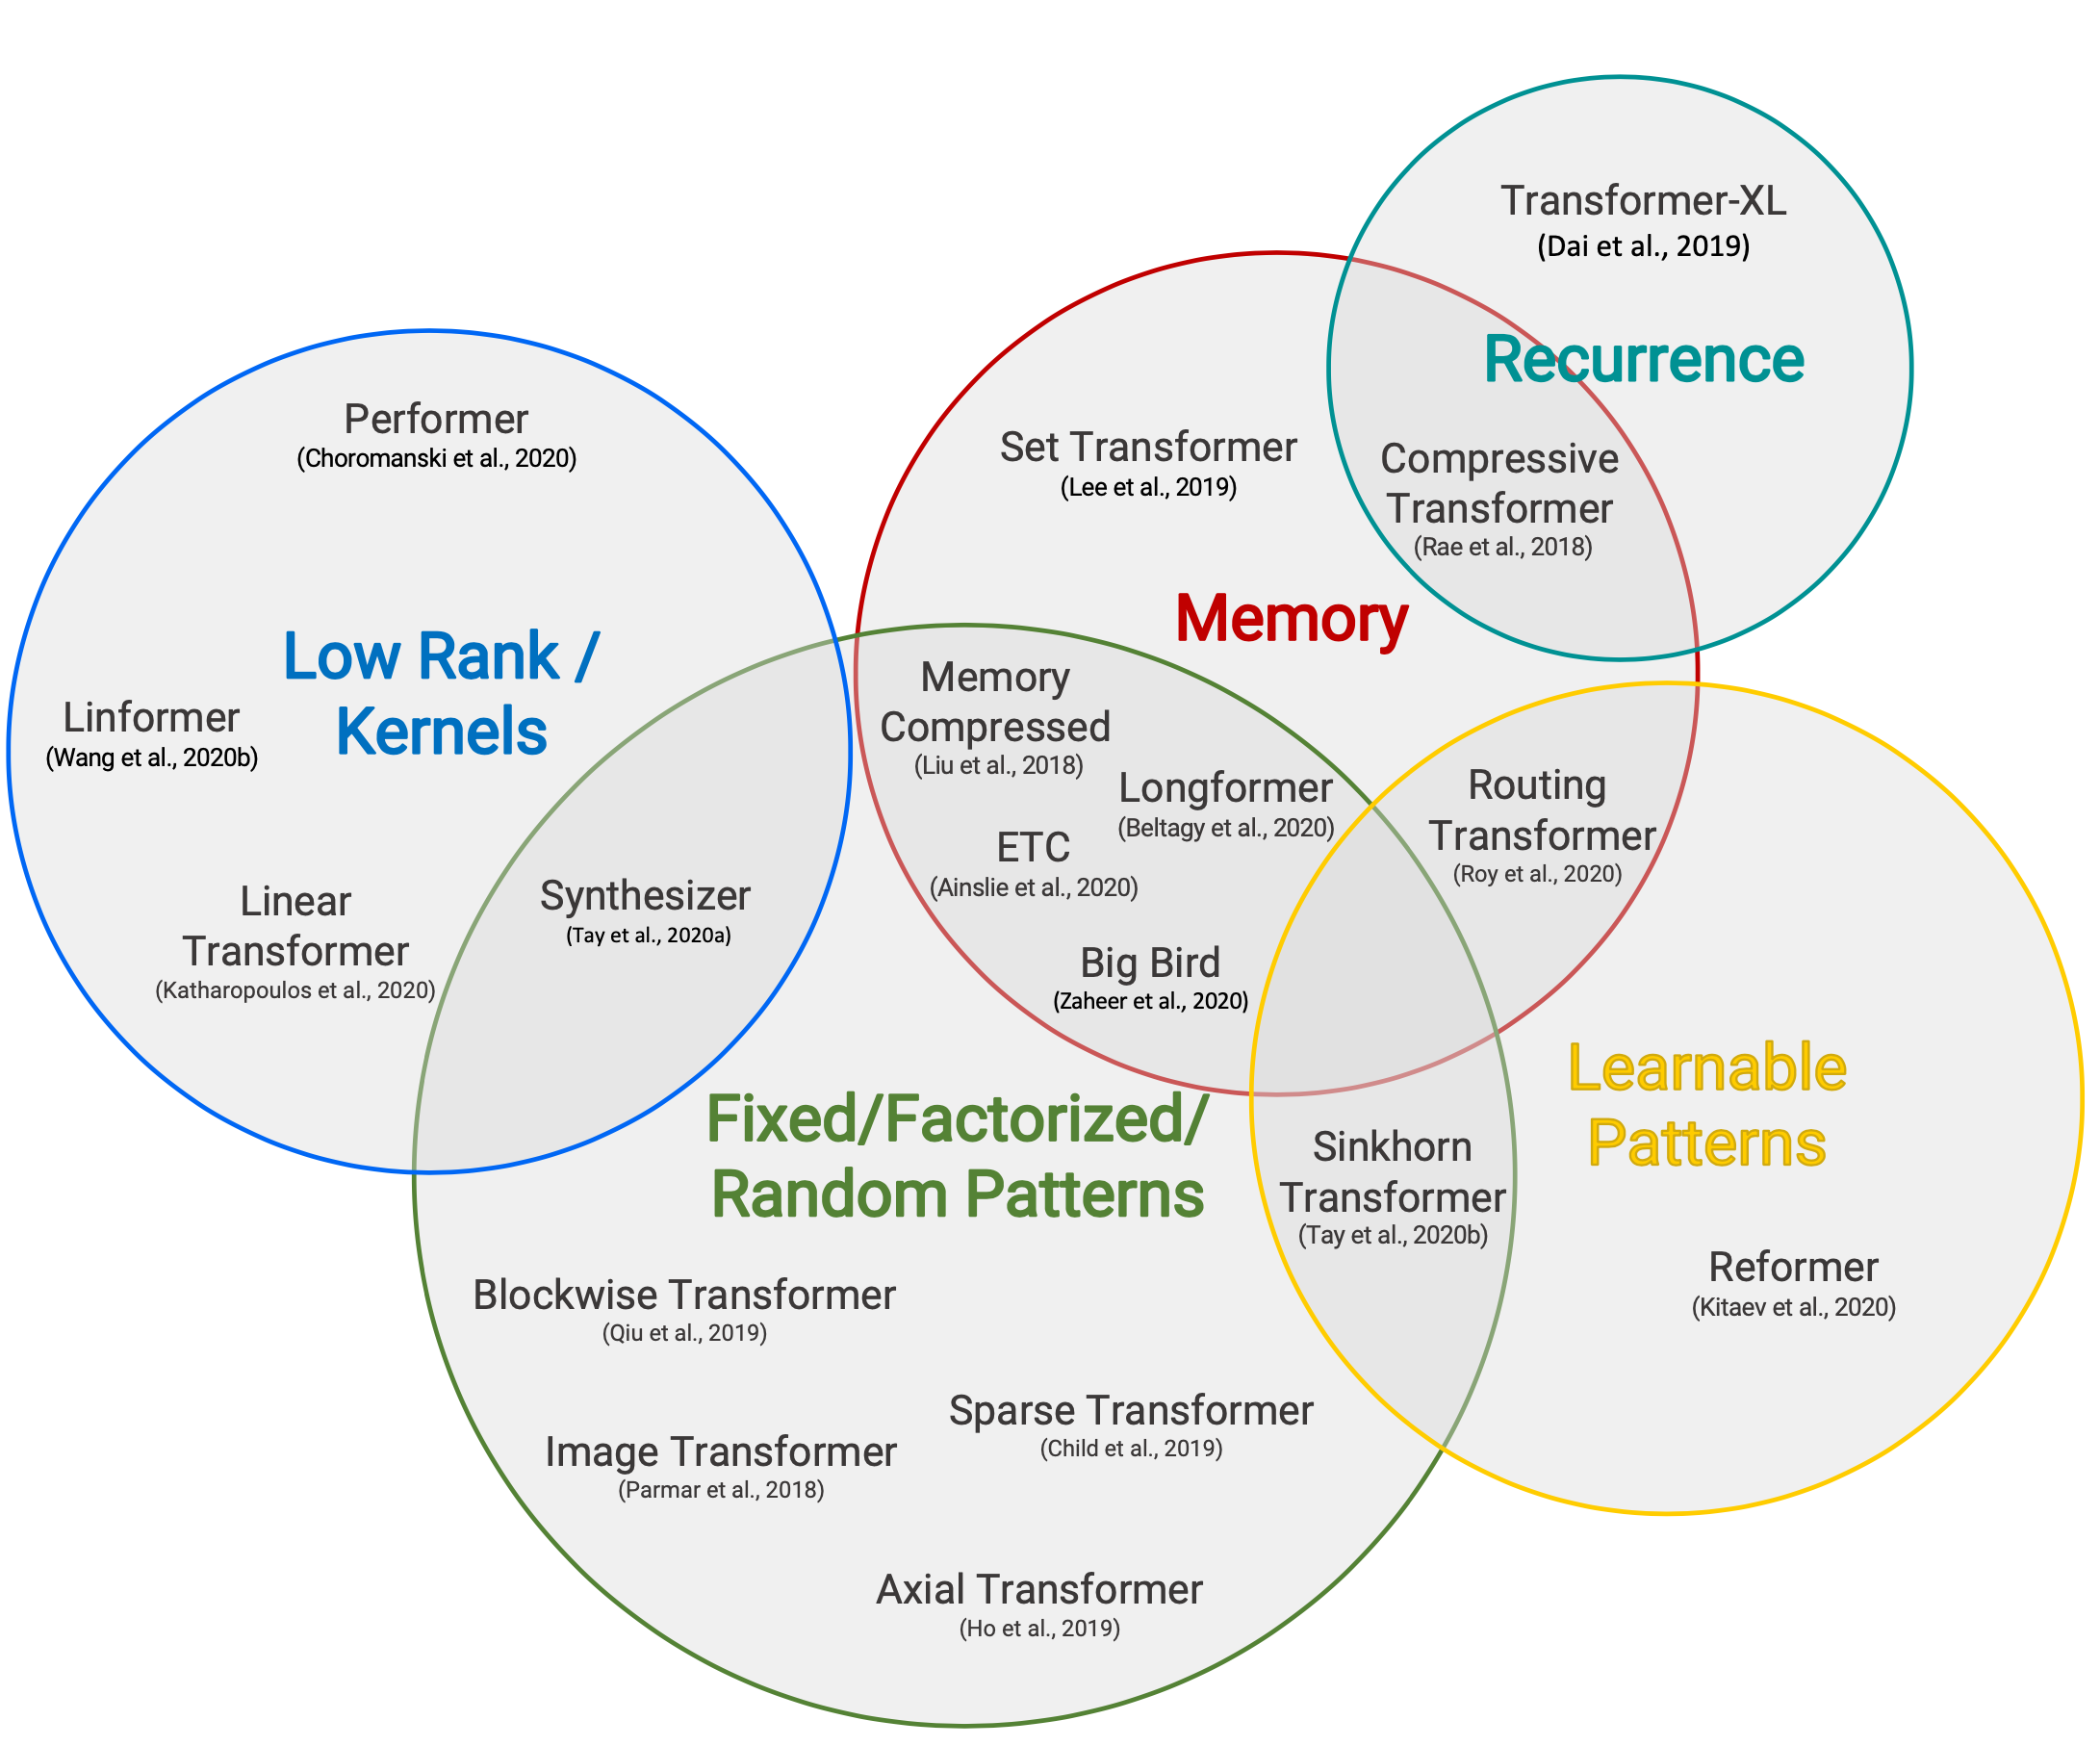
Large Transformer Model Inference Optimization | Lil'Log
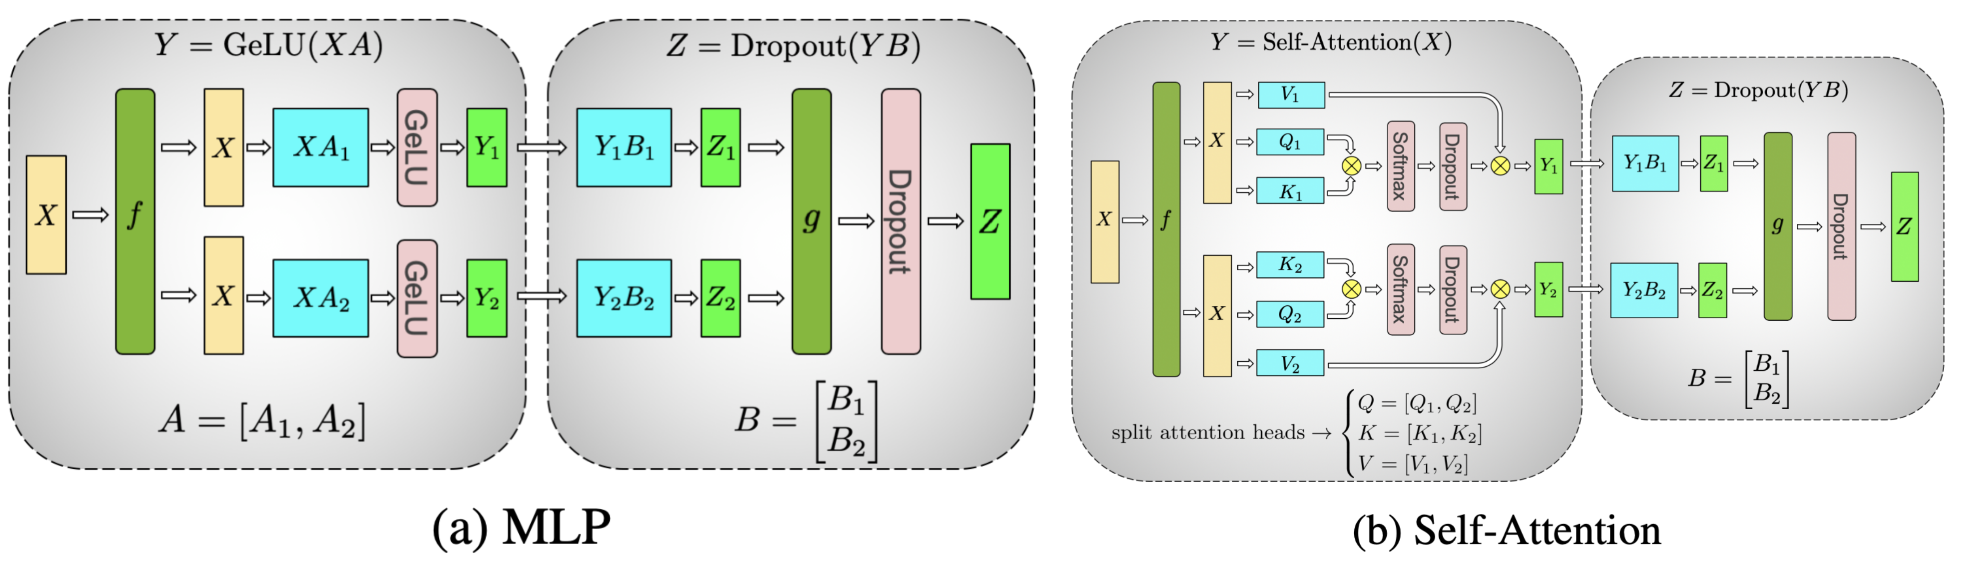
Large Scale Transformer model training with Tensor Parallel (TP ...
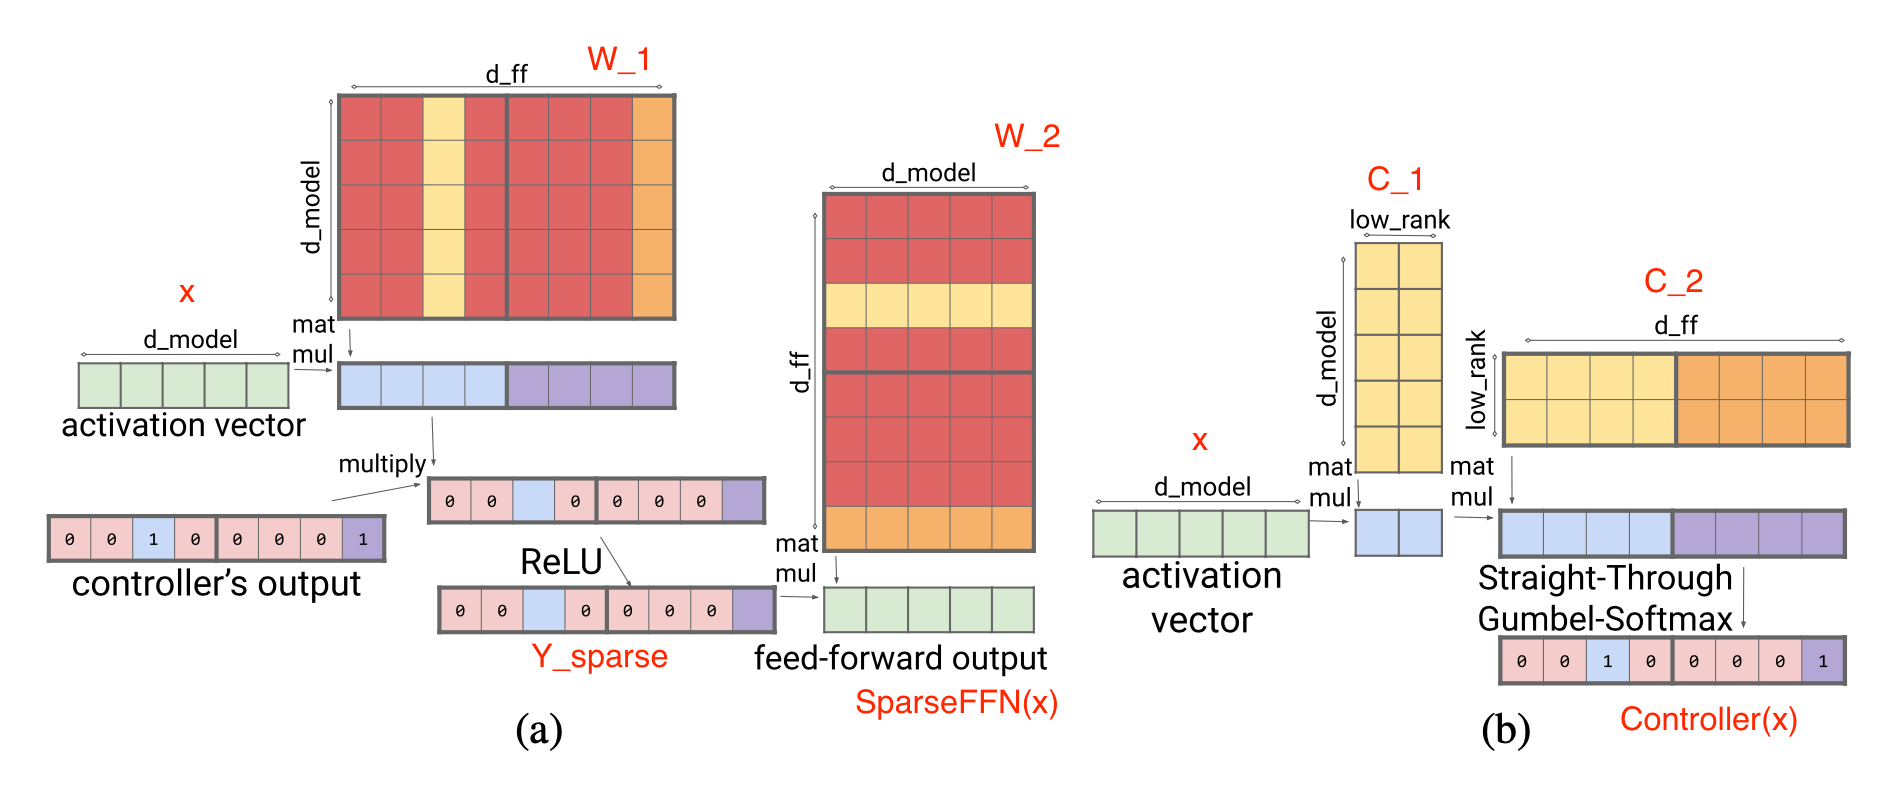
Large Transformer Model Inference Optimization | Lil'Log
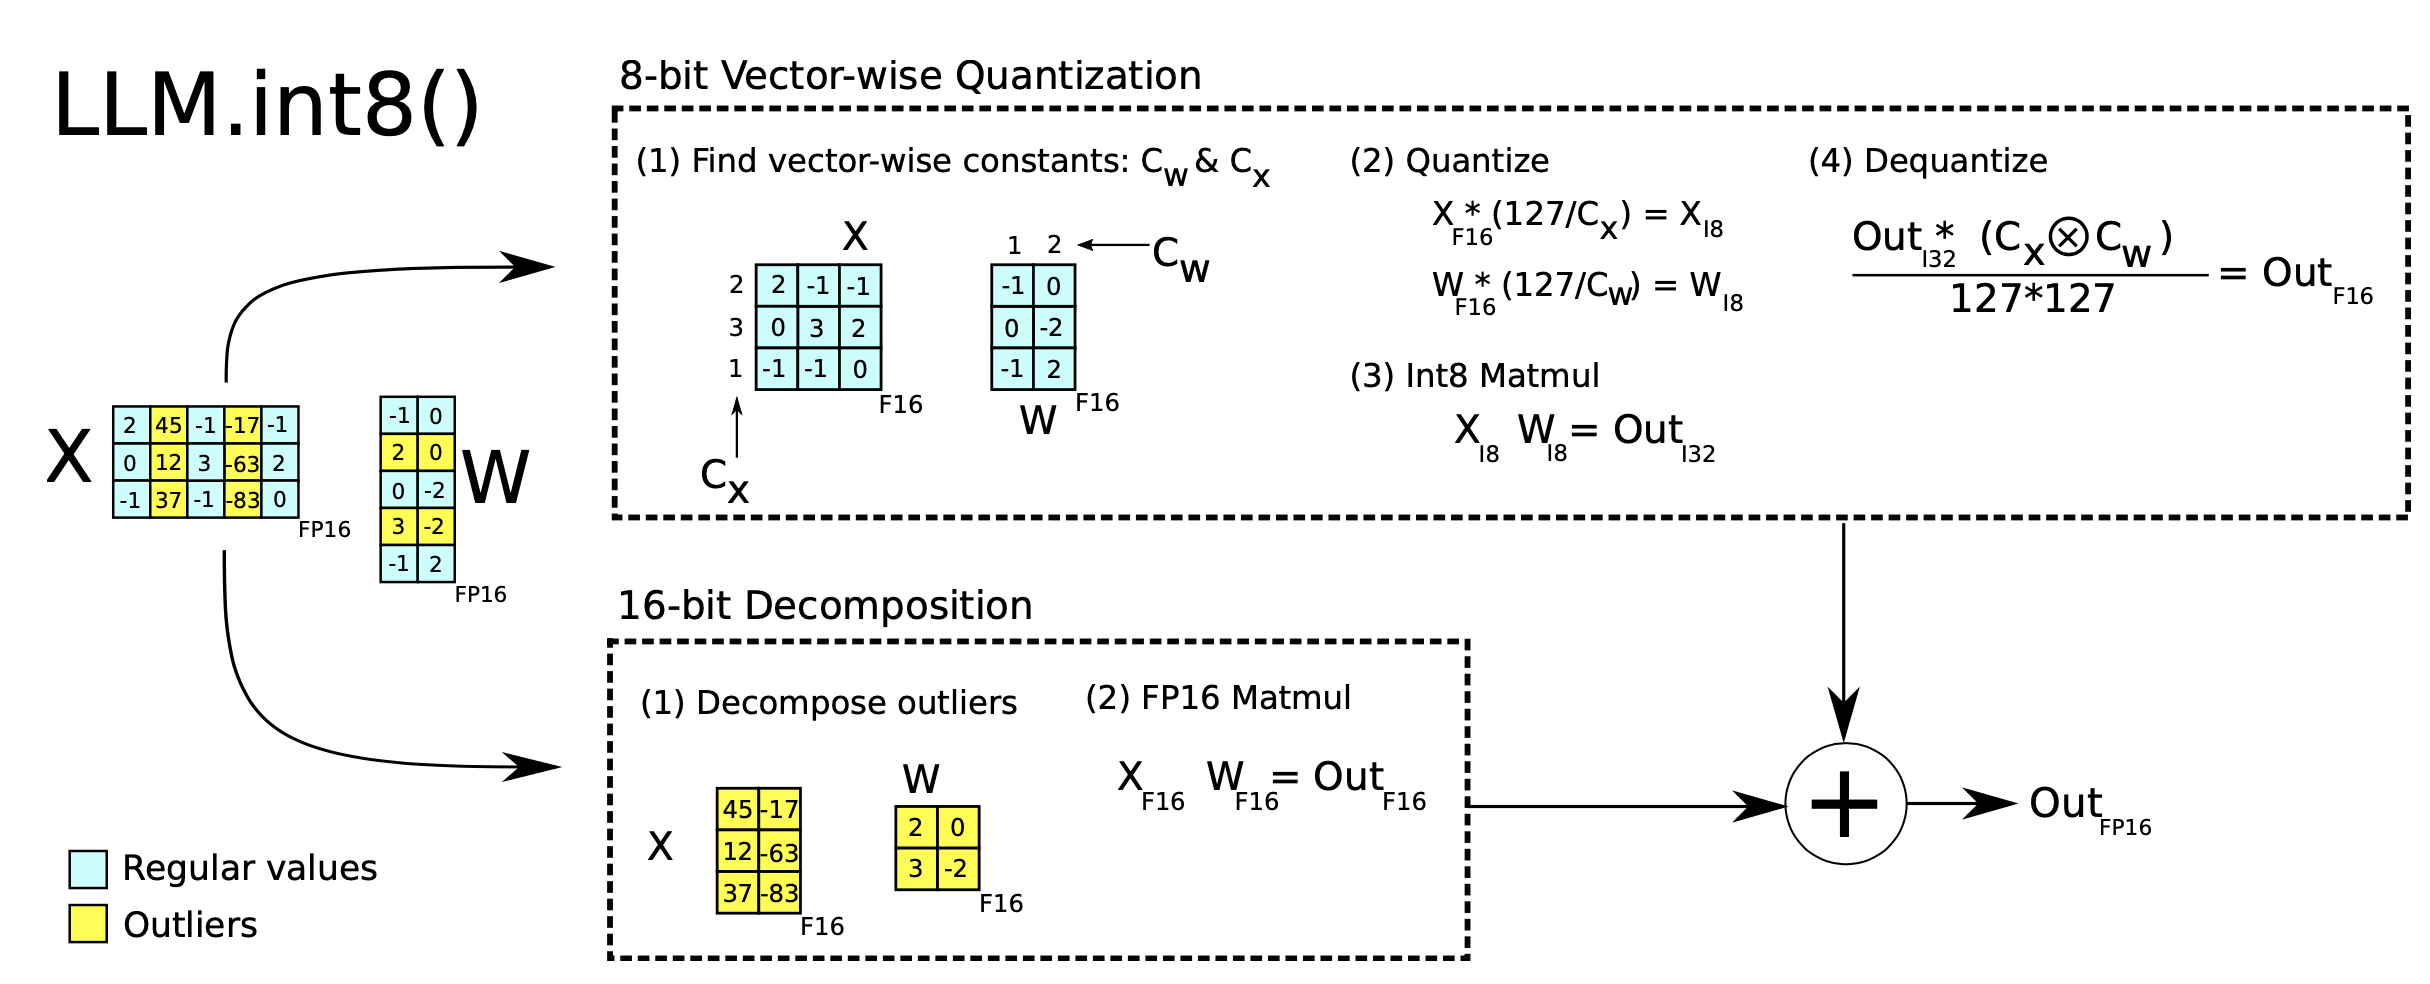
Large Transformer Model Inference Optimization | Lil'Log

Efficient Deployment of Large-Scale Transformer Models: Strategies for ...
Advertisement Space (336x280)

Figure 3 from Efficient Deployment of Transformer Models on Edge TPU ...
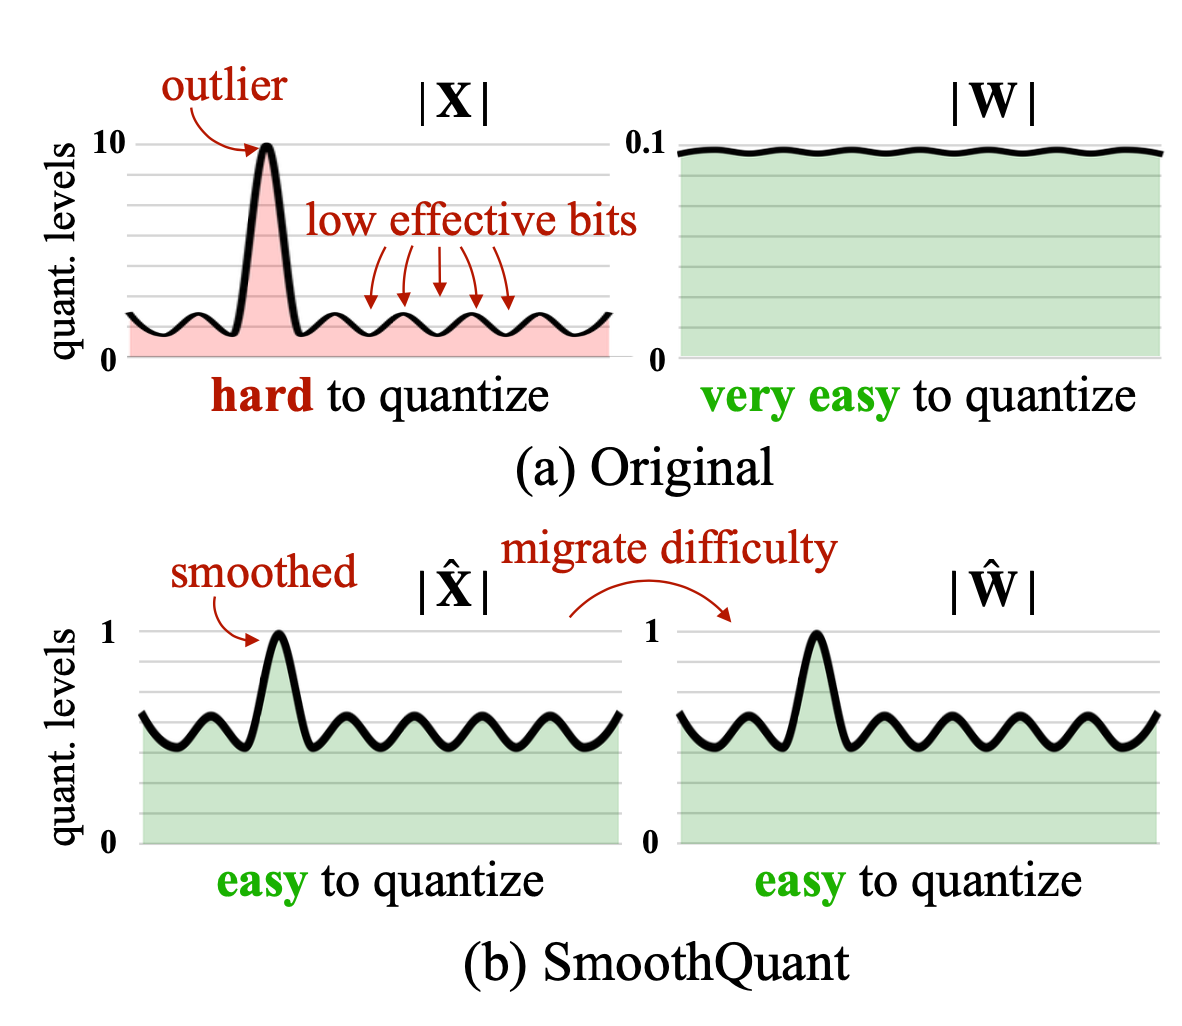
Large Transformer Model Inference Optimization | Lil'Log
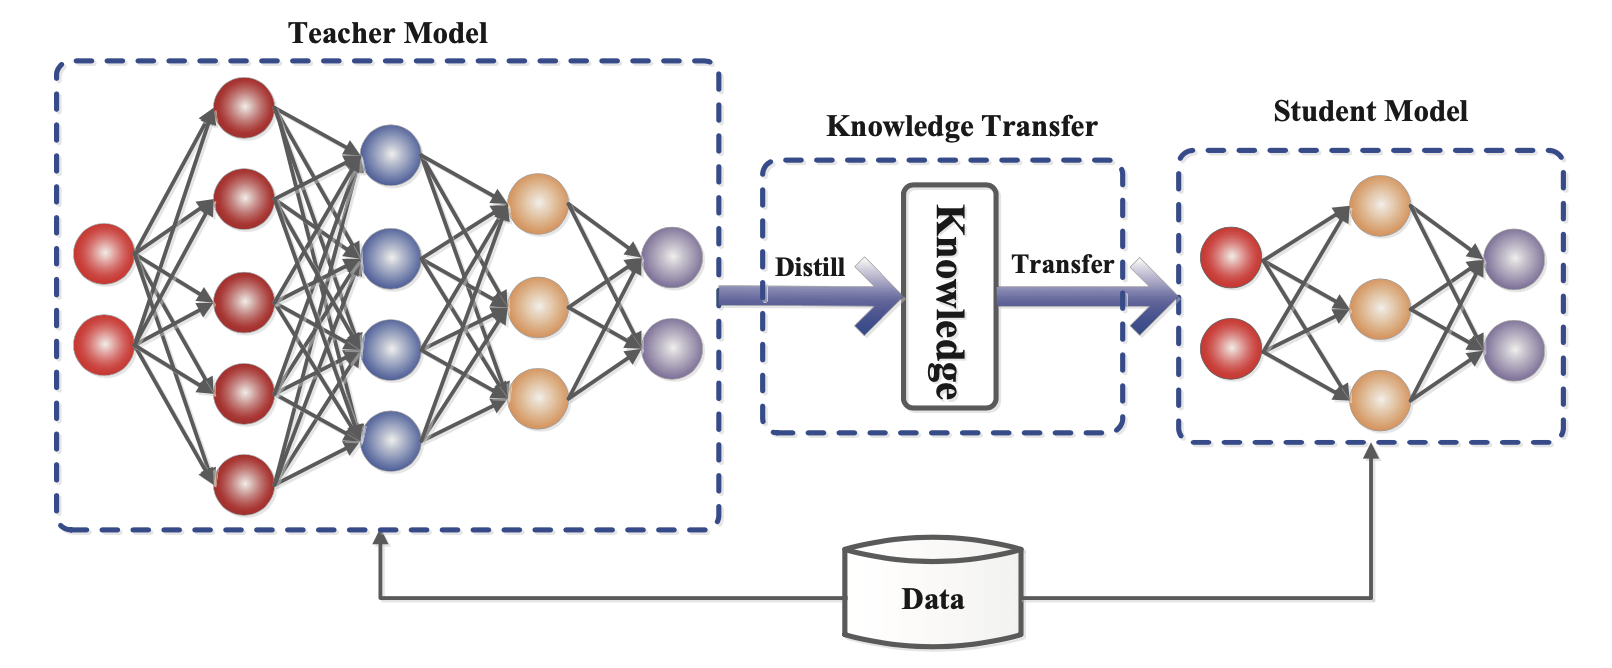
Large Transformer Model Inference Optimization | Lil'Log
Optimize Cloud Spend for Model Inference at Scale

Paper page - Easy and Efficient Transformer : Scalable Inference ...

Figure 1 from Efficient Deployment of Transformer Models on Edge TPU ...
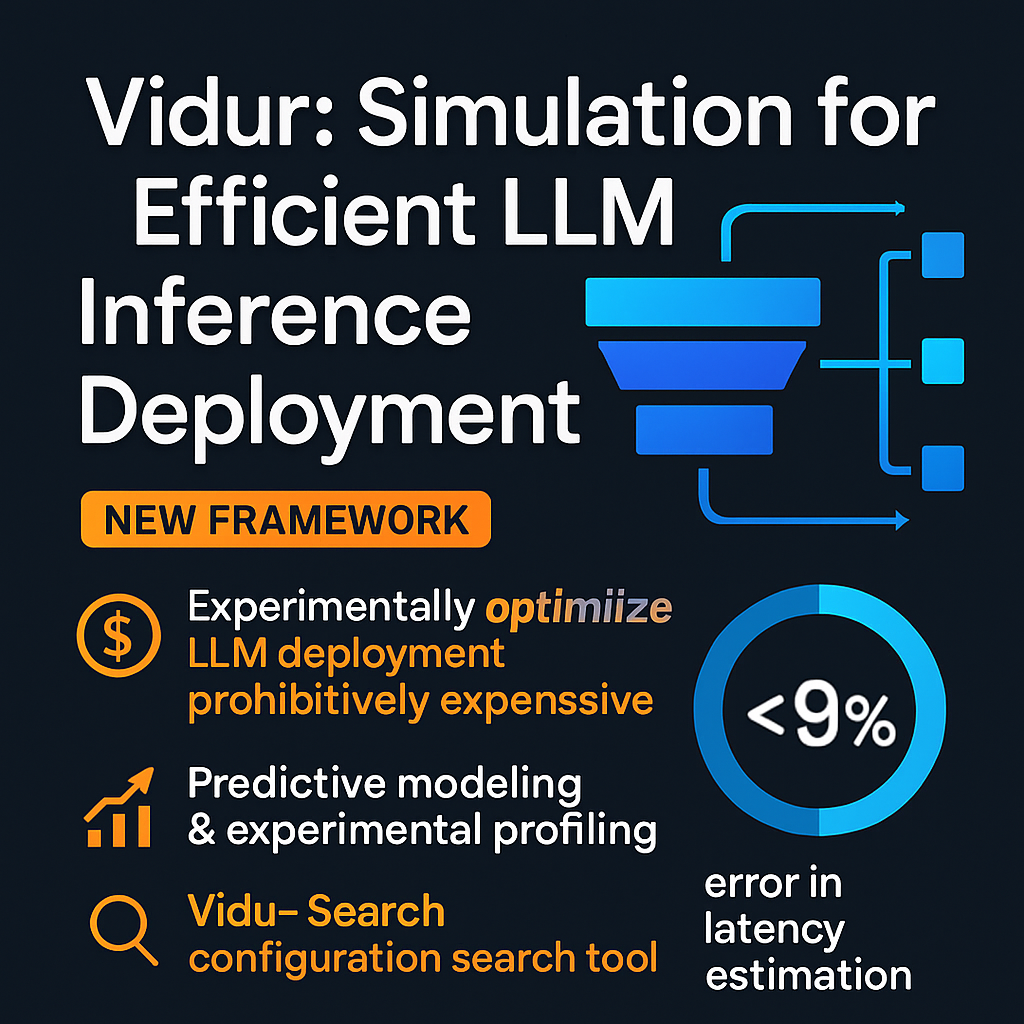
Vidur: Simulation for Efficient LLM Inference Deployment — AI Post ...

TinyFormer: Efficient Transformer Design and Deployment on Tiny Devices ...
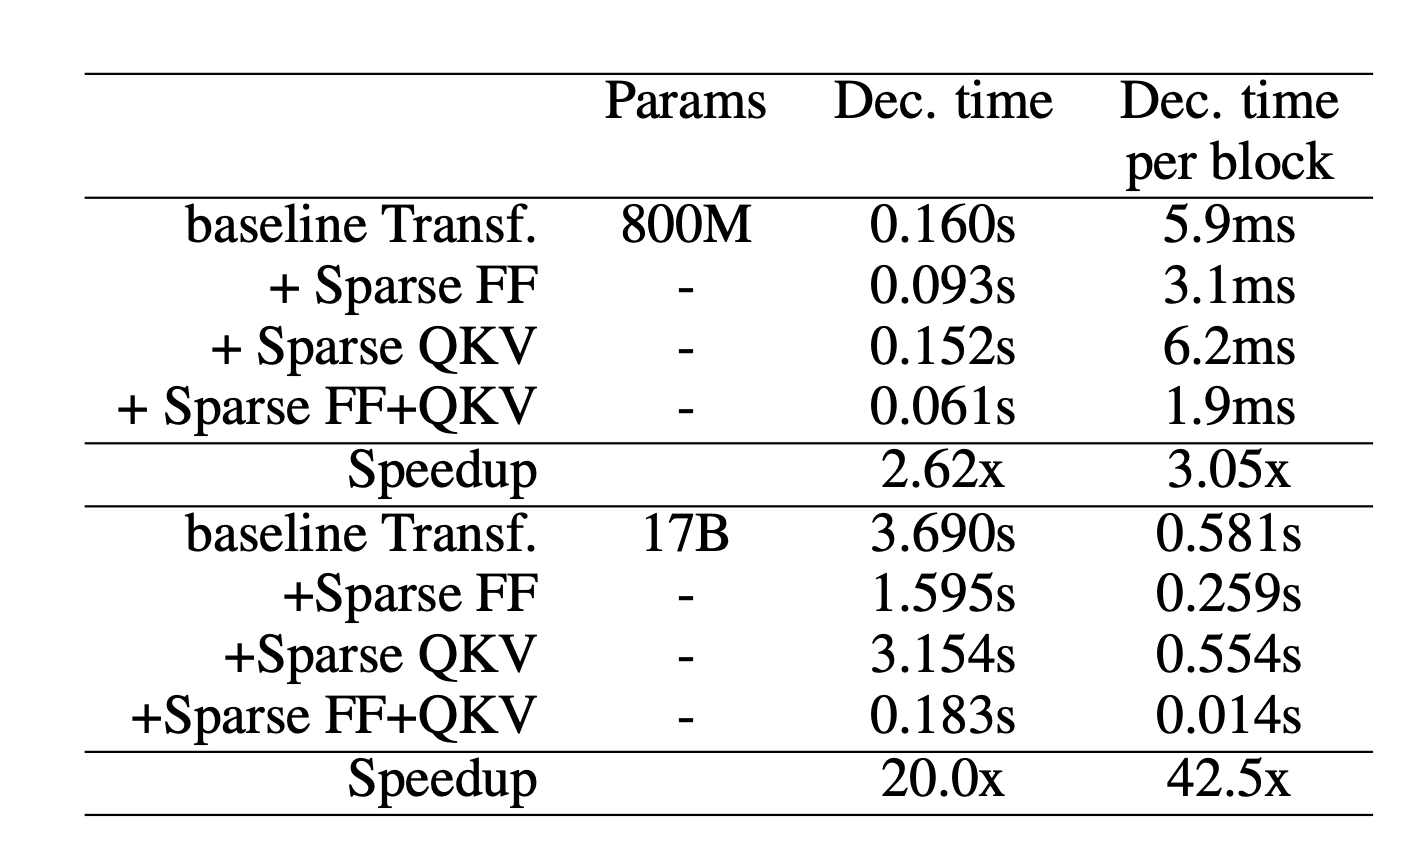
Large Transformer Model Inference Optimization | Yue'Log
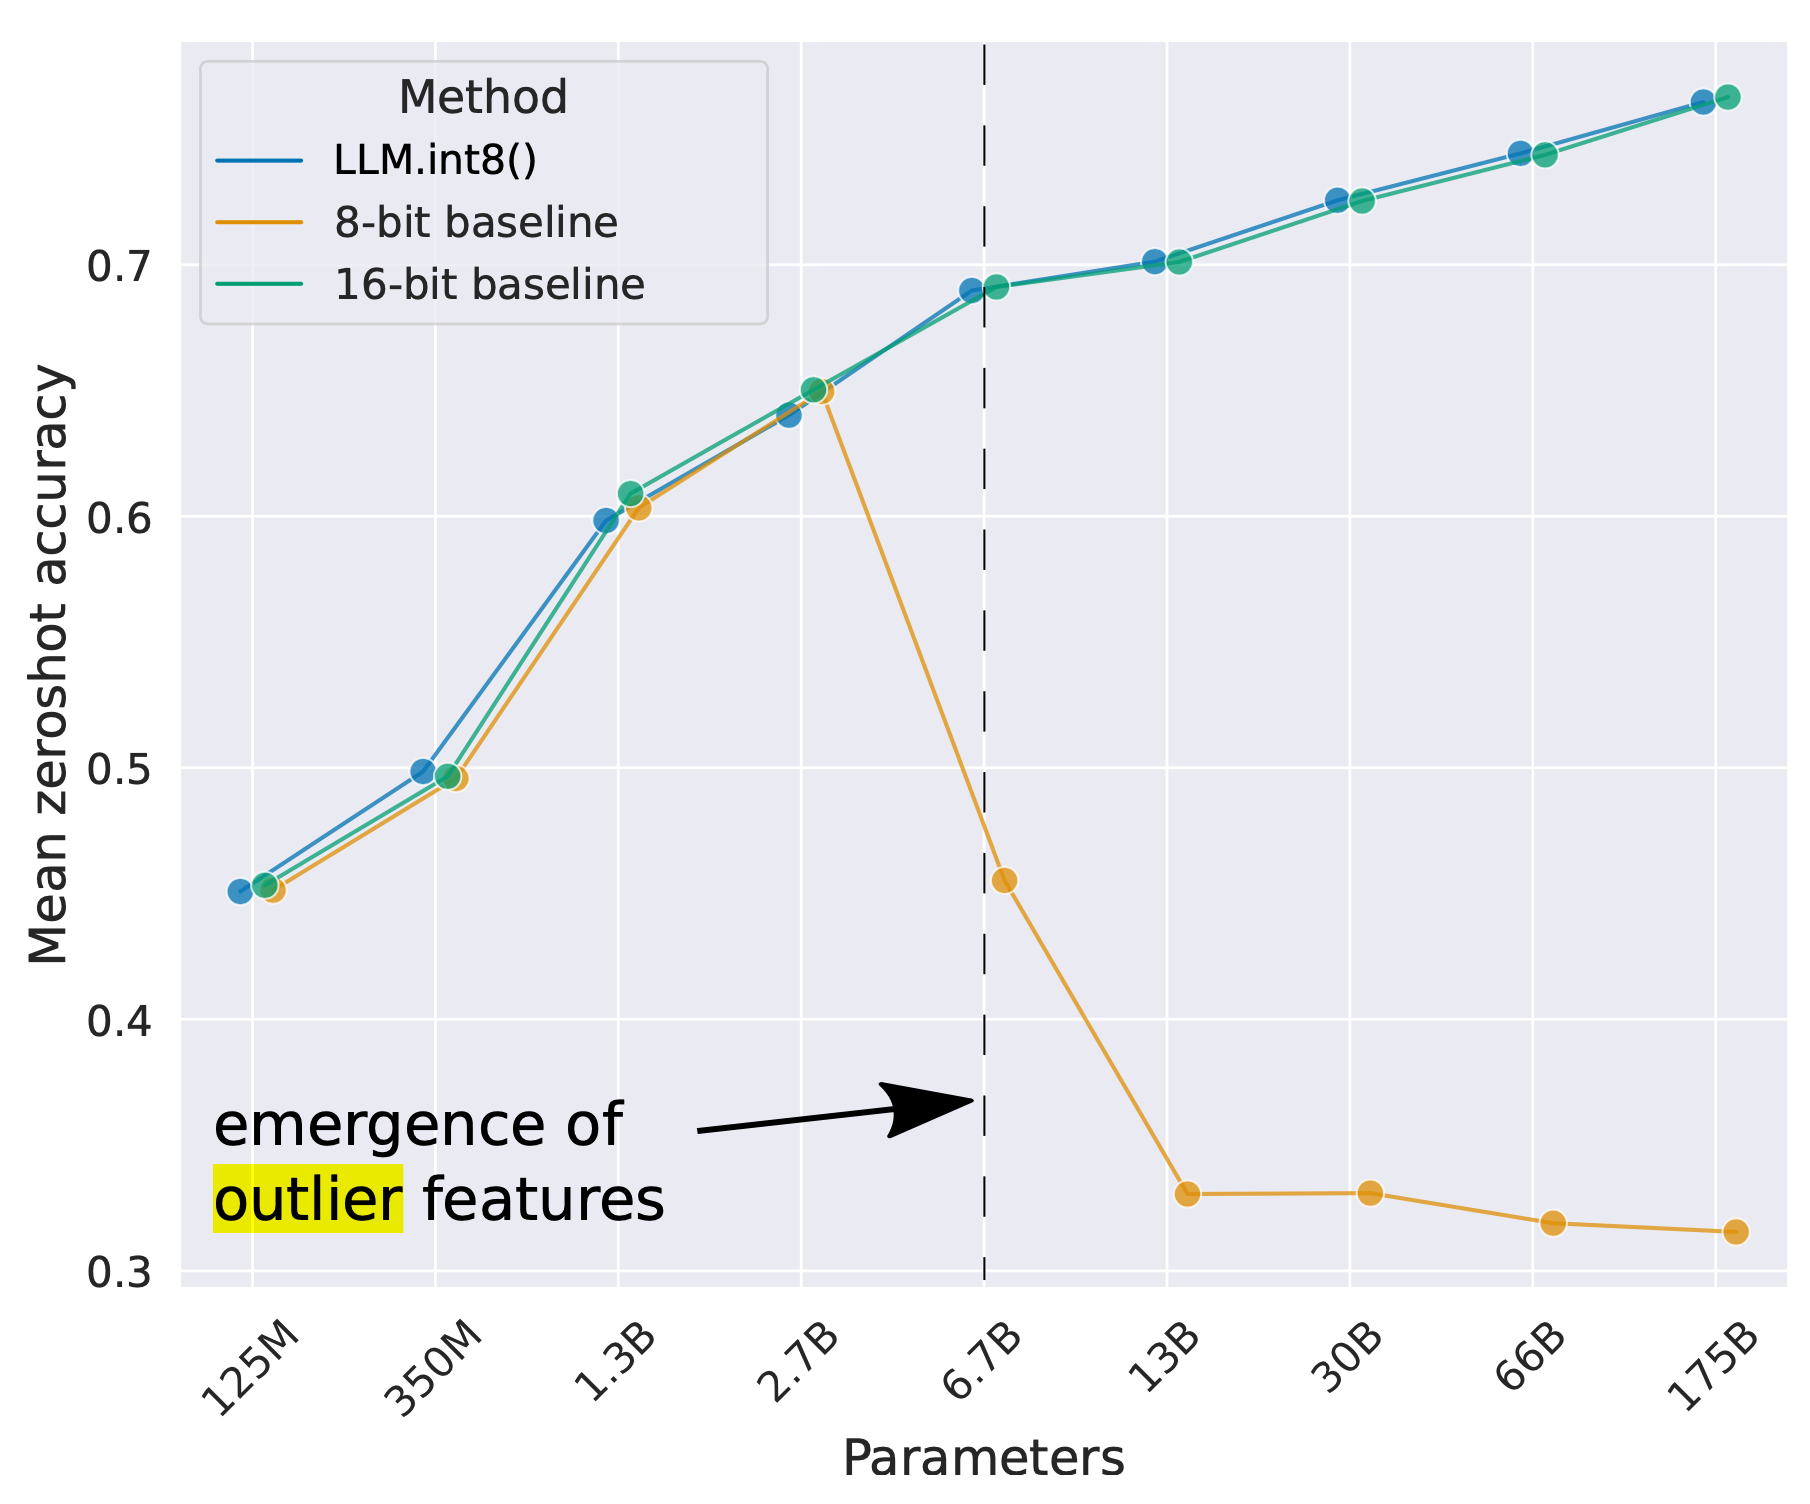
Large Transformer Model Inference Optimization | Lil'Log
Advertisement Space (336x280)
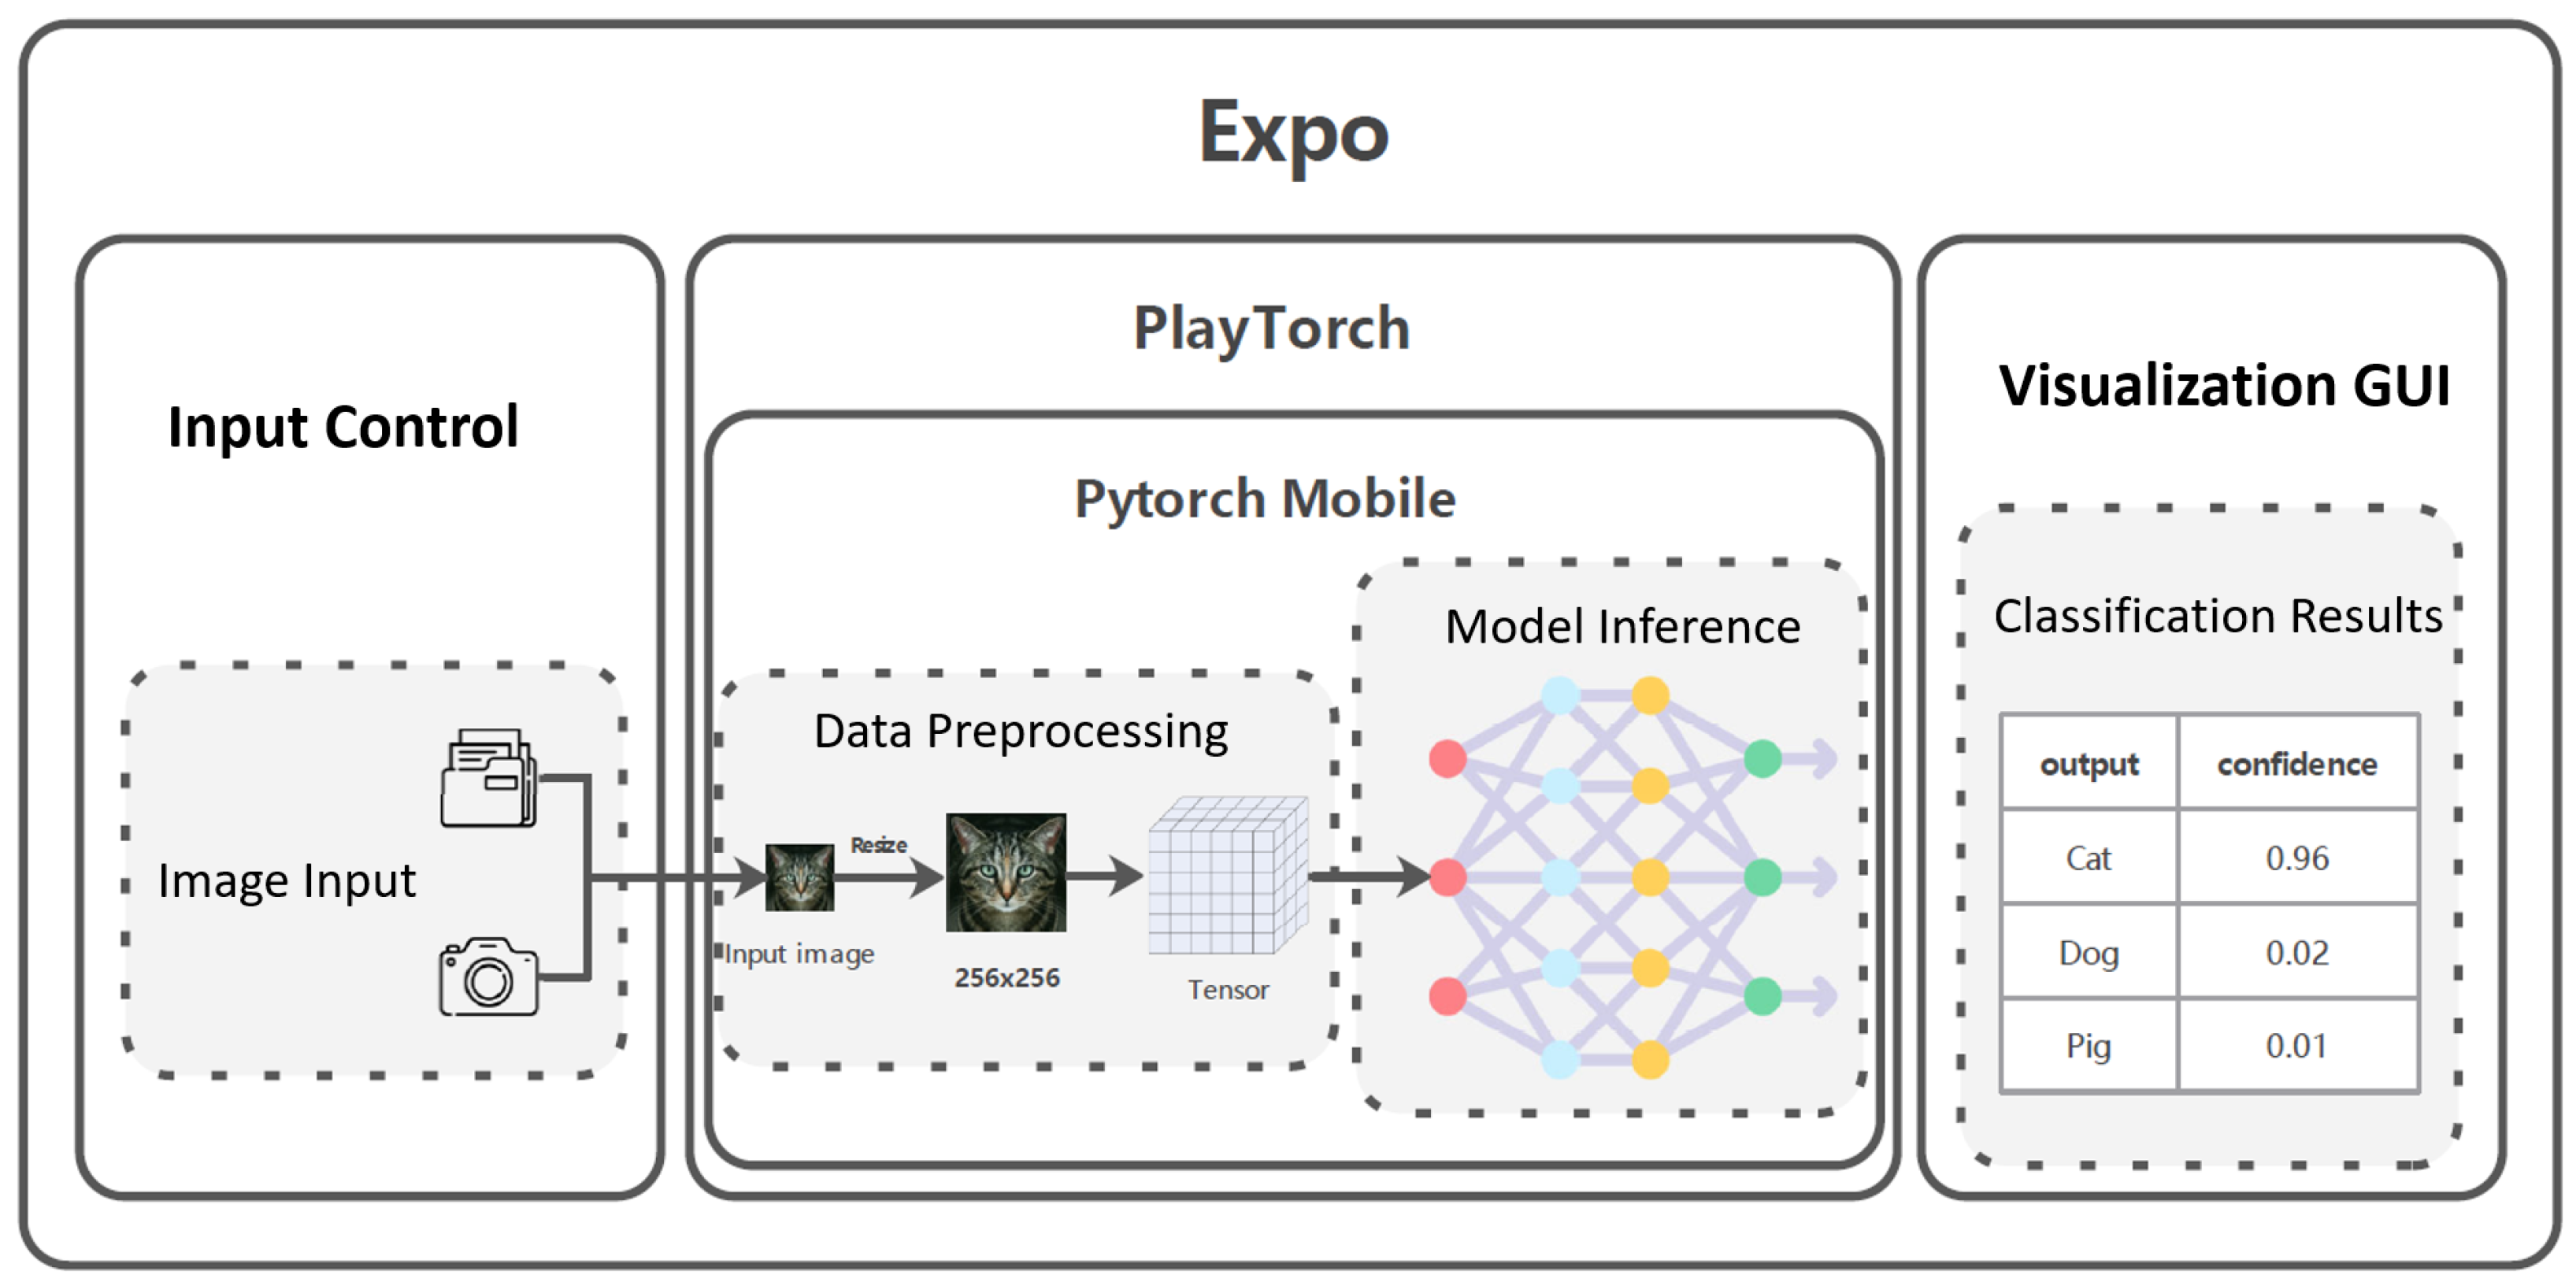
Integrated Robust Optimization for Lightweight Transformer Models in ...

Optimizing Mixture-of-Experts Inference Time Combining Model Deployment ...
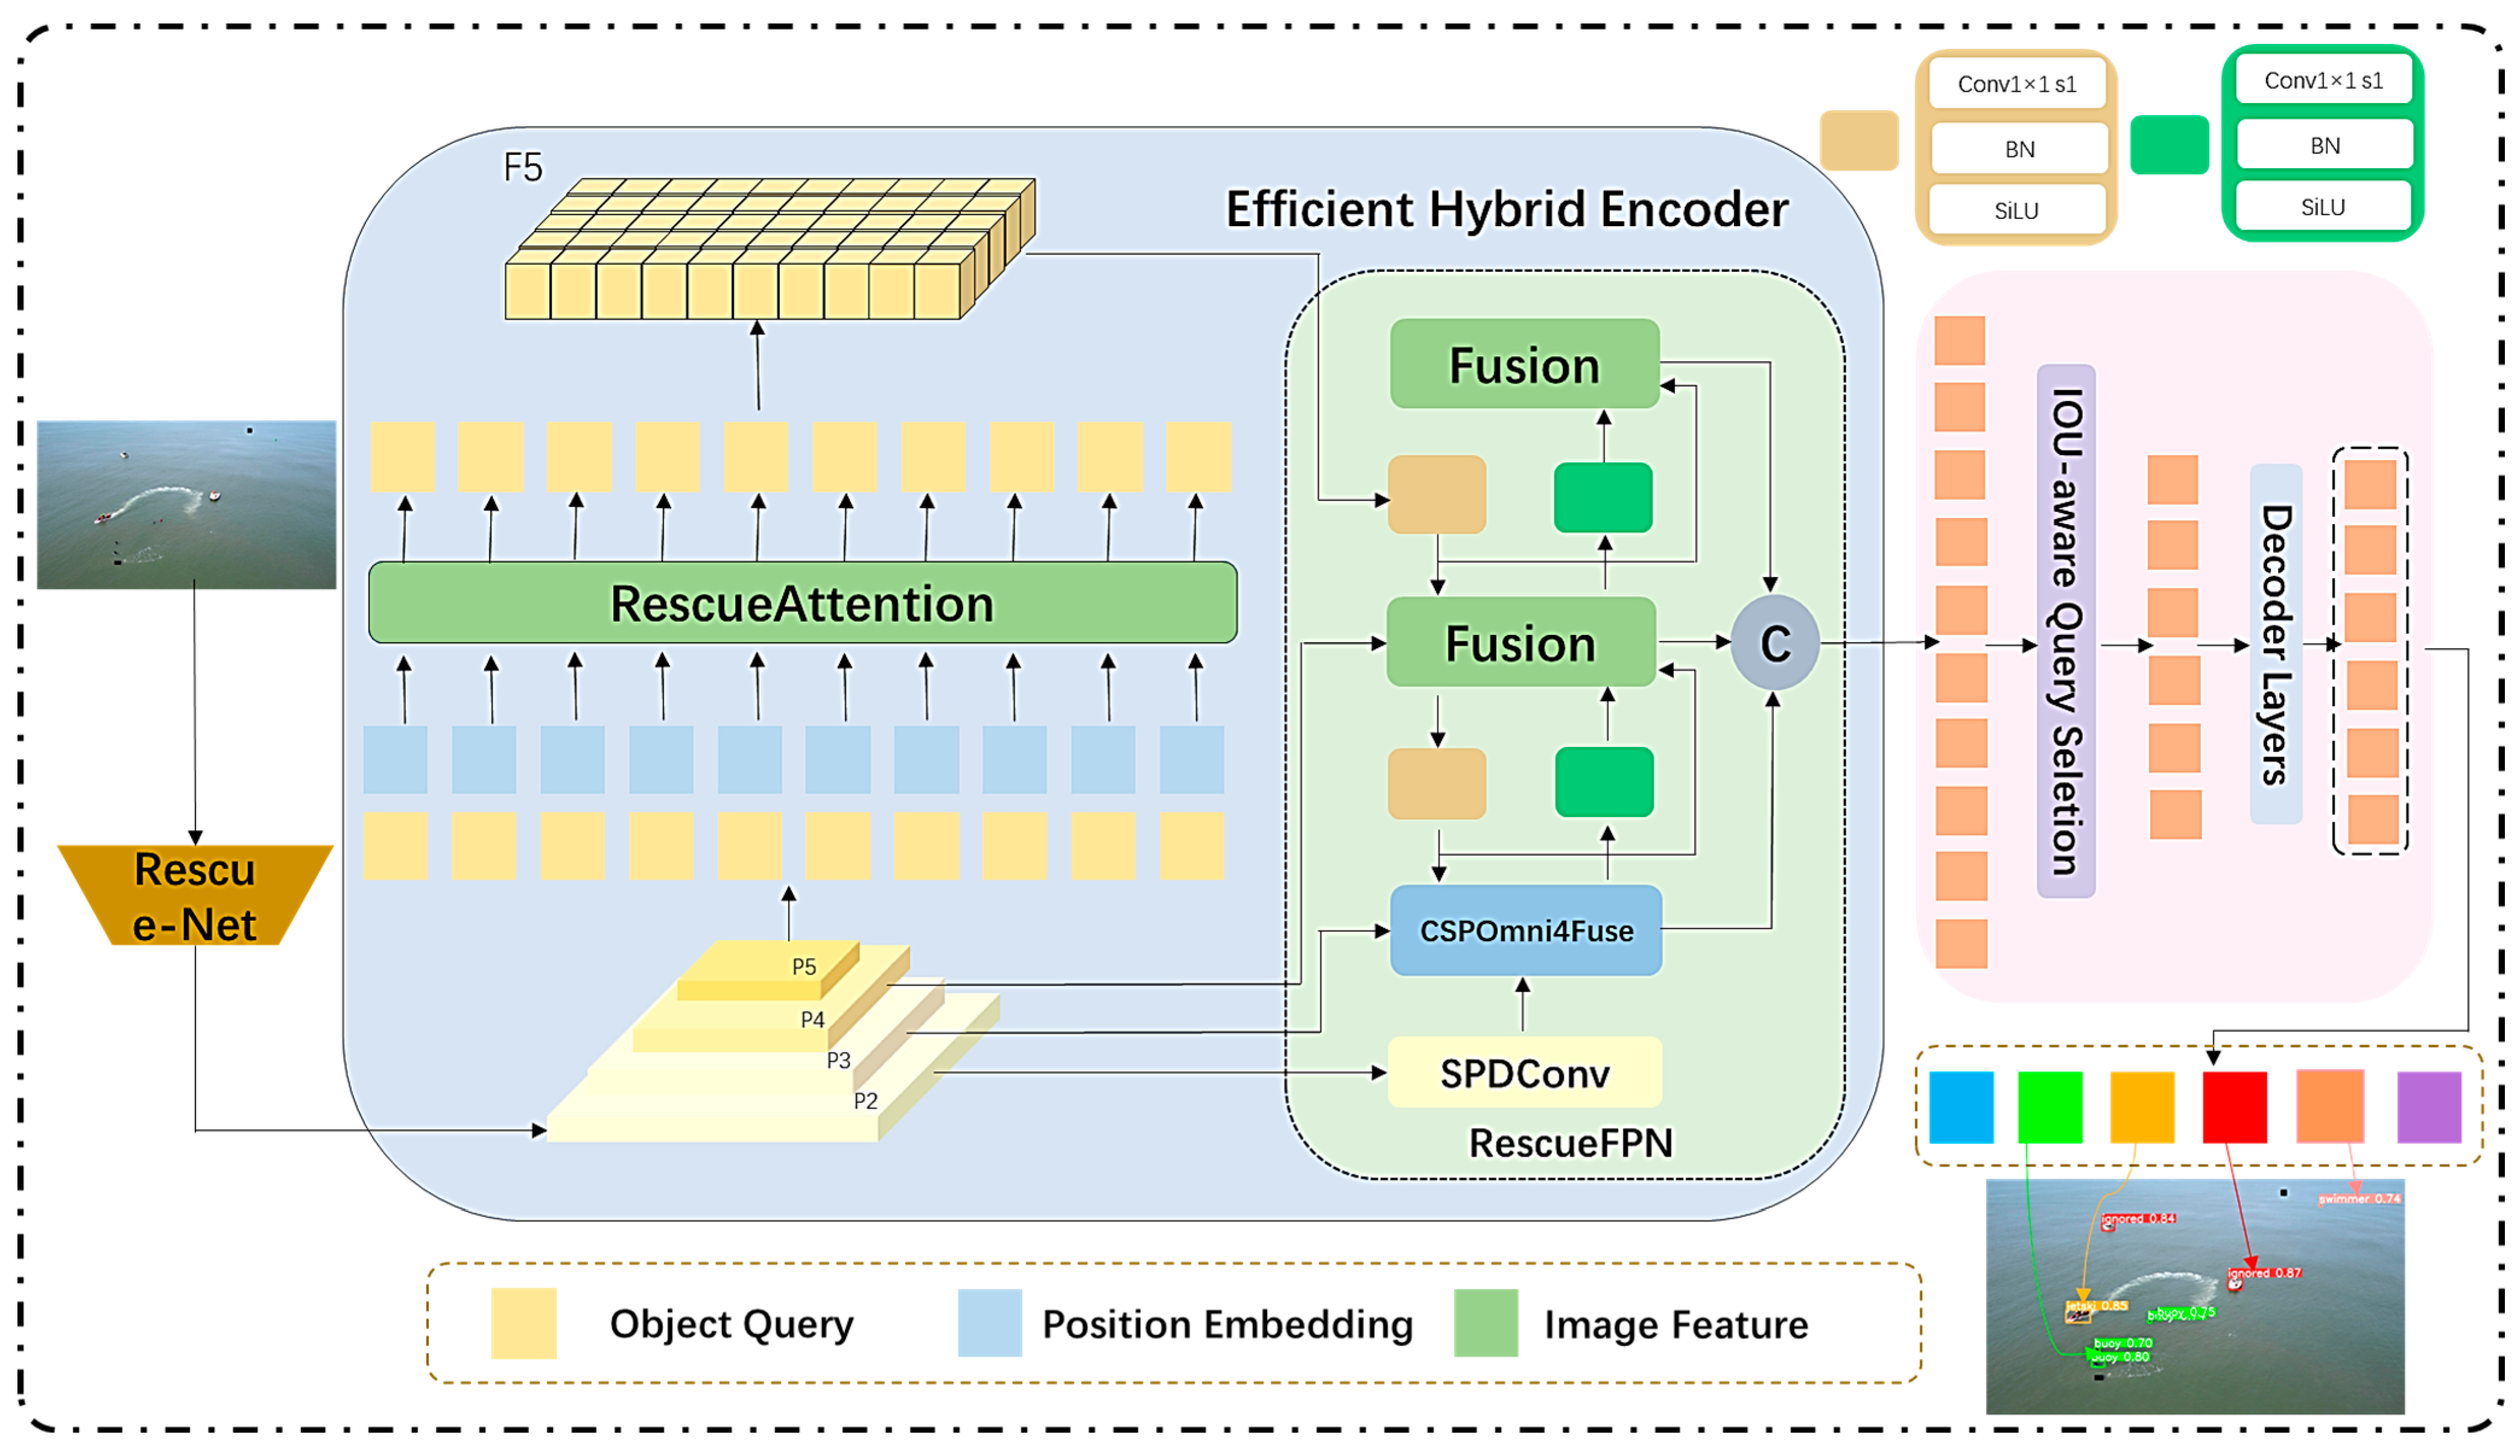
A Deployment-Oriented Real-Time Transformer Detector and Benchmark for ...
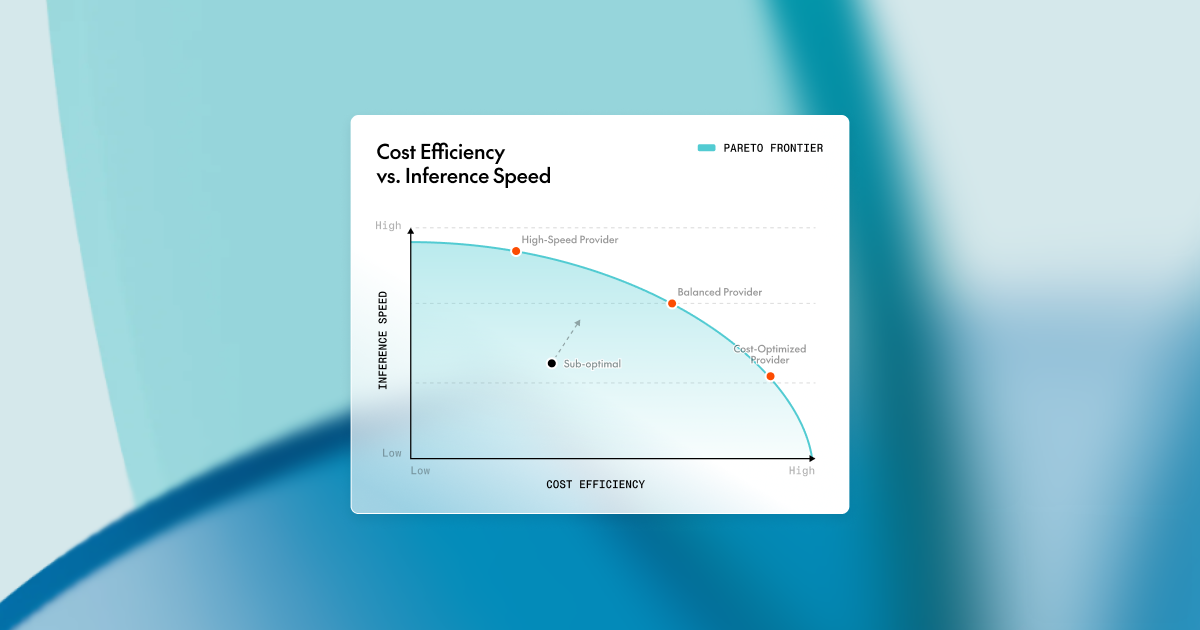
Optimizing inference speed and costs: Lessons learned from large-scale ...

Large Scale Transformer Model Training With Tensor Parallel – ACMMB
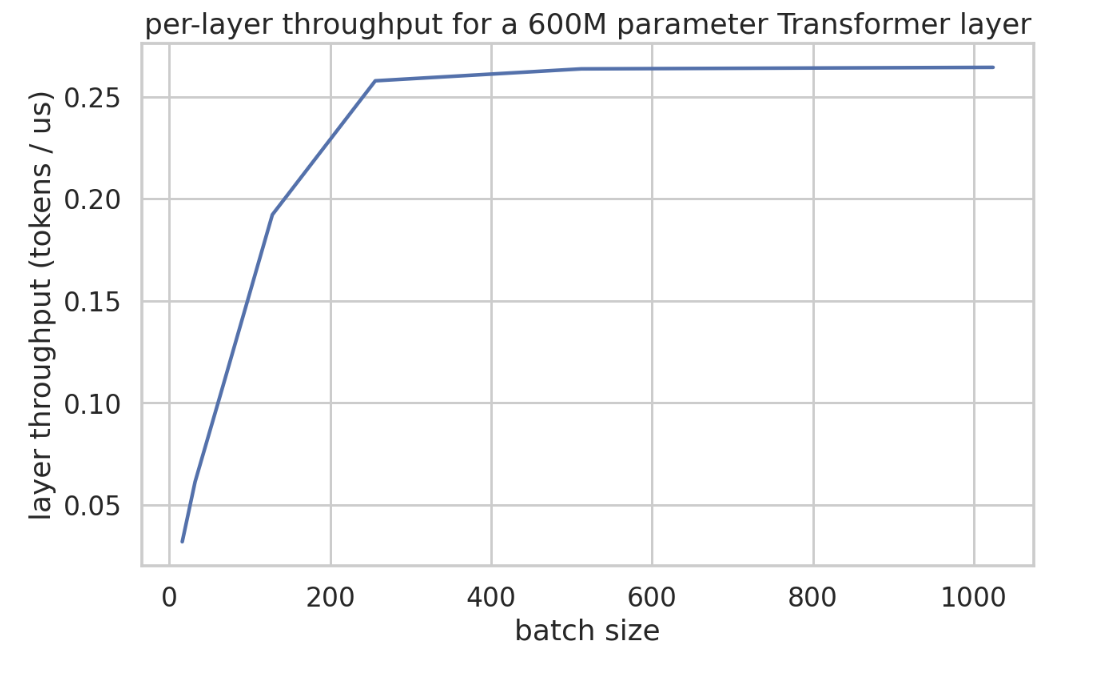
All About Transformer Inference | How To Scale Your Model