
Optimizing Llm Inference Throughput Via Memory Aware And Sla

Optimizing LLM Inference Throughput via Memory-aware and SLA ...
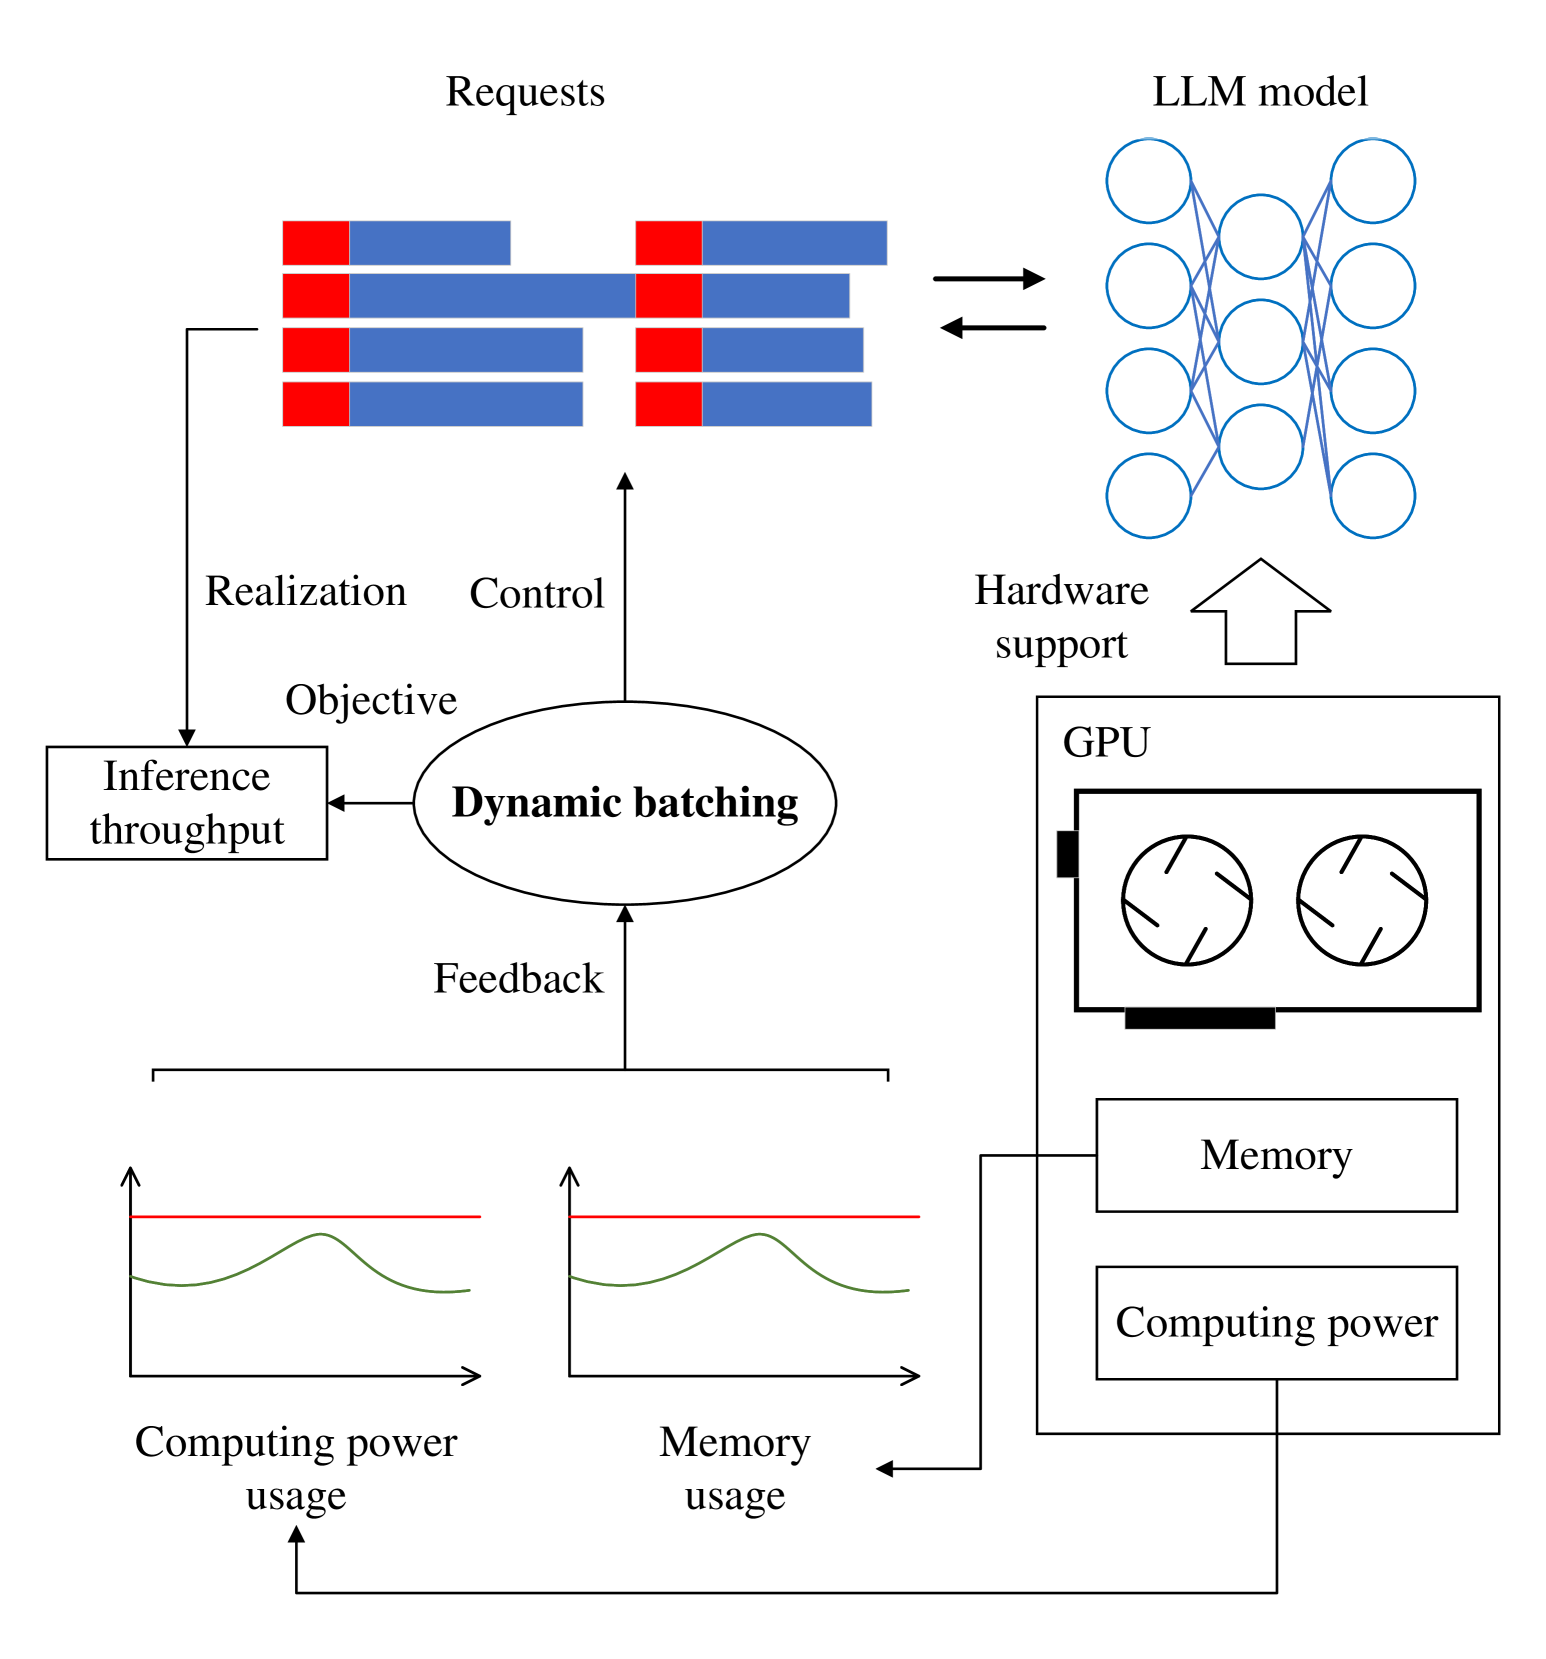
[2503.05248] Optimizing LLM Inference Throughput via Memory-aware and ...

[2503.05248] Optimizing LLM Inference Throughput via Memory-aware and ...

[2503.05248] Optimizing LLM Inference Throughput via Memory-aware and ...

[2503.05248] Optimizing LLM Inference Throughput via Memory-aware and ...
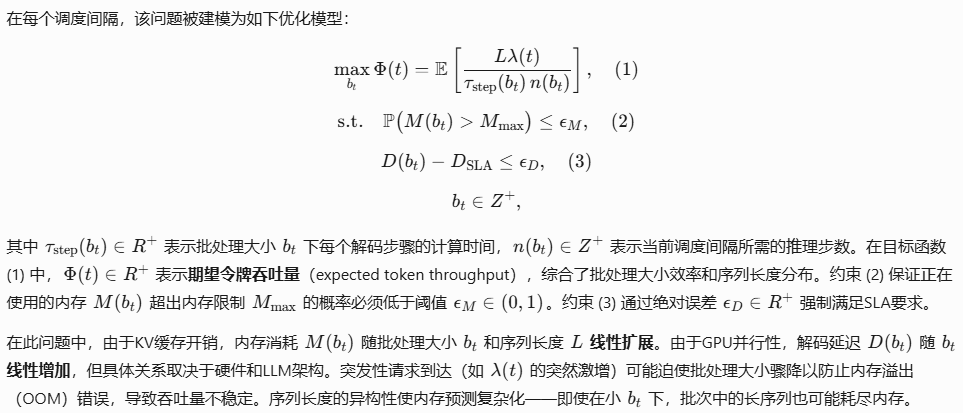
【大模型推理】Optimizing LLM Inference Throughput via Memory-aware and SLA ...
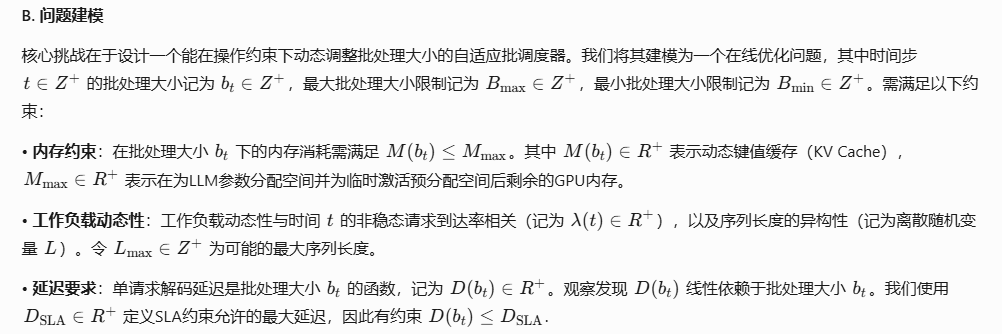
【大模型推理】Optimizing LLM Inference Throughput via Memory-aware and SLA ...
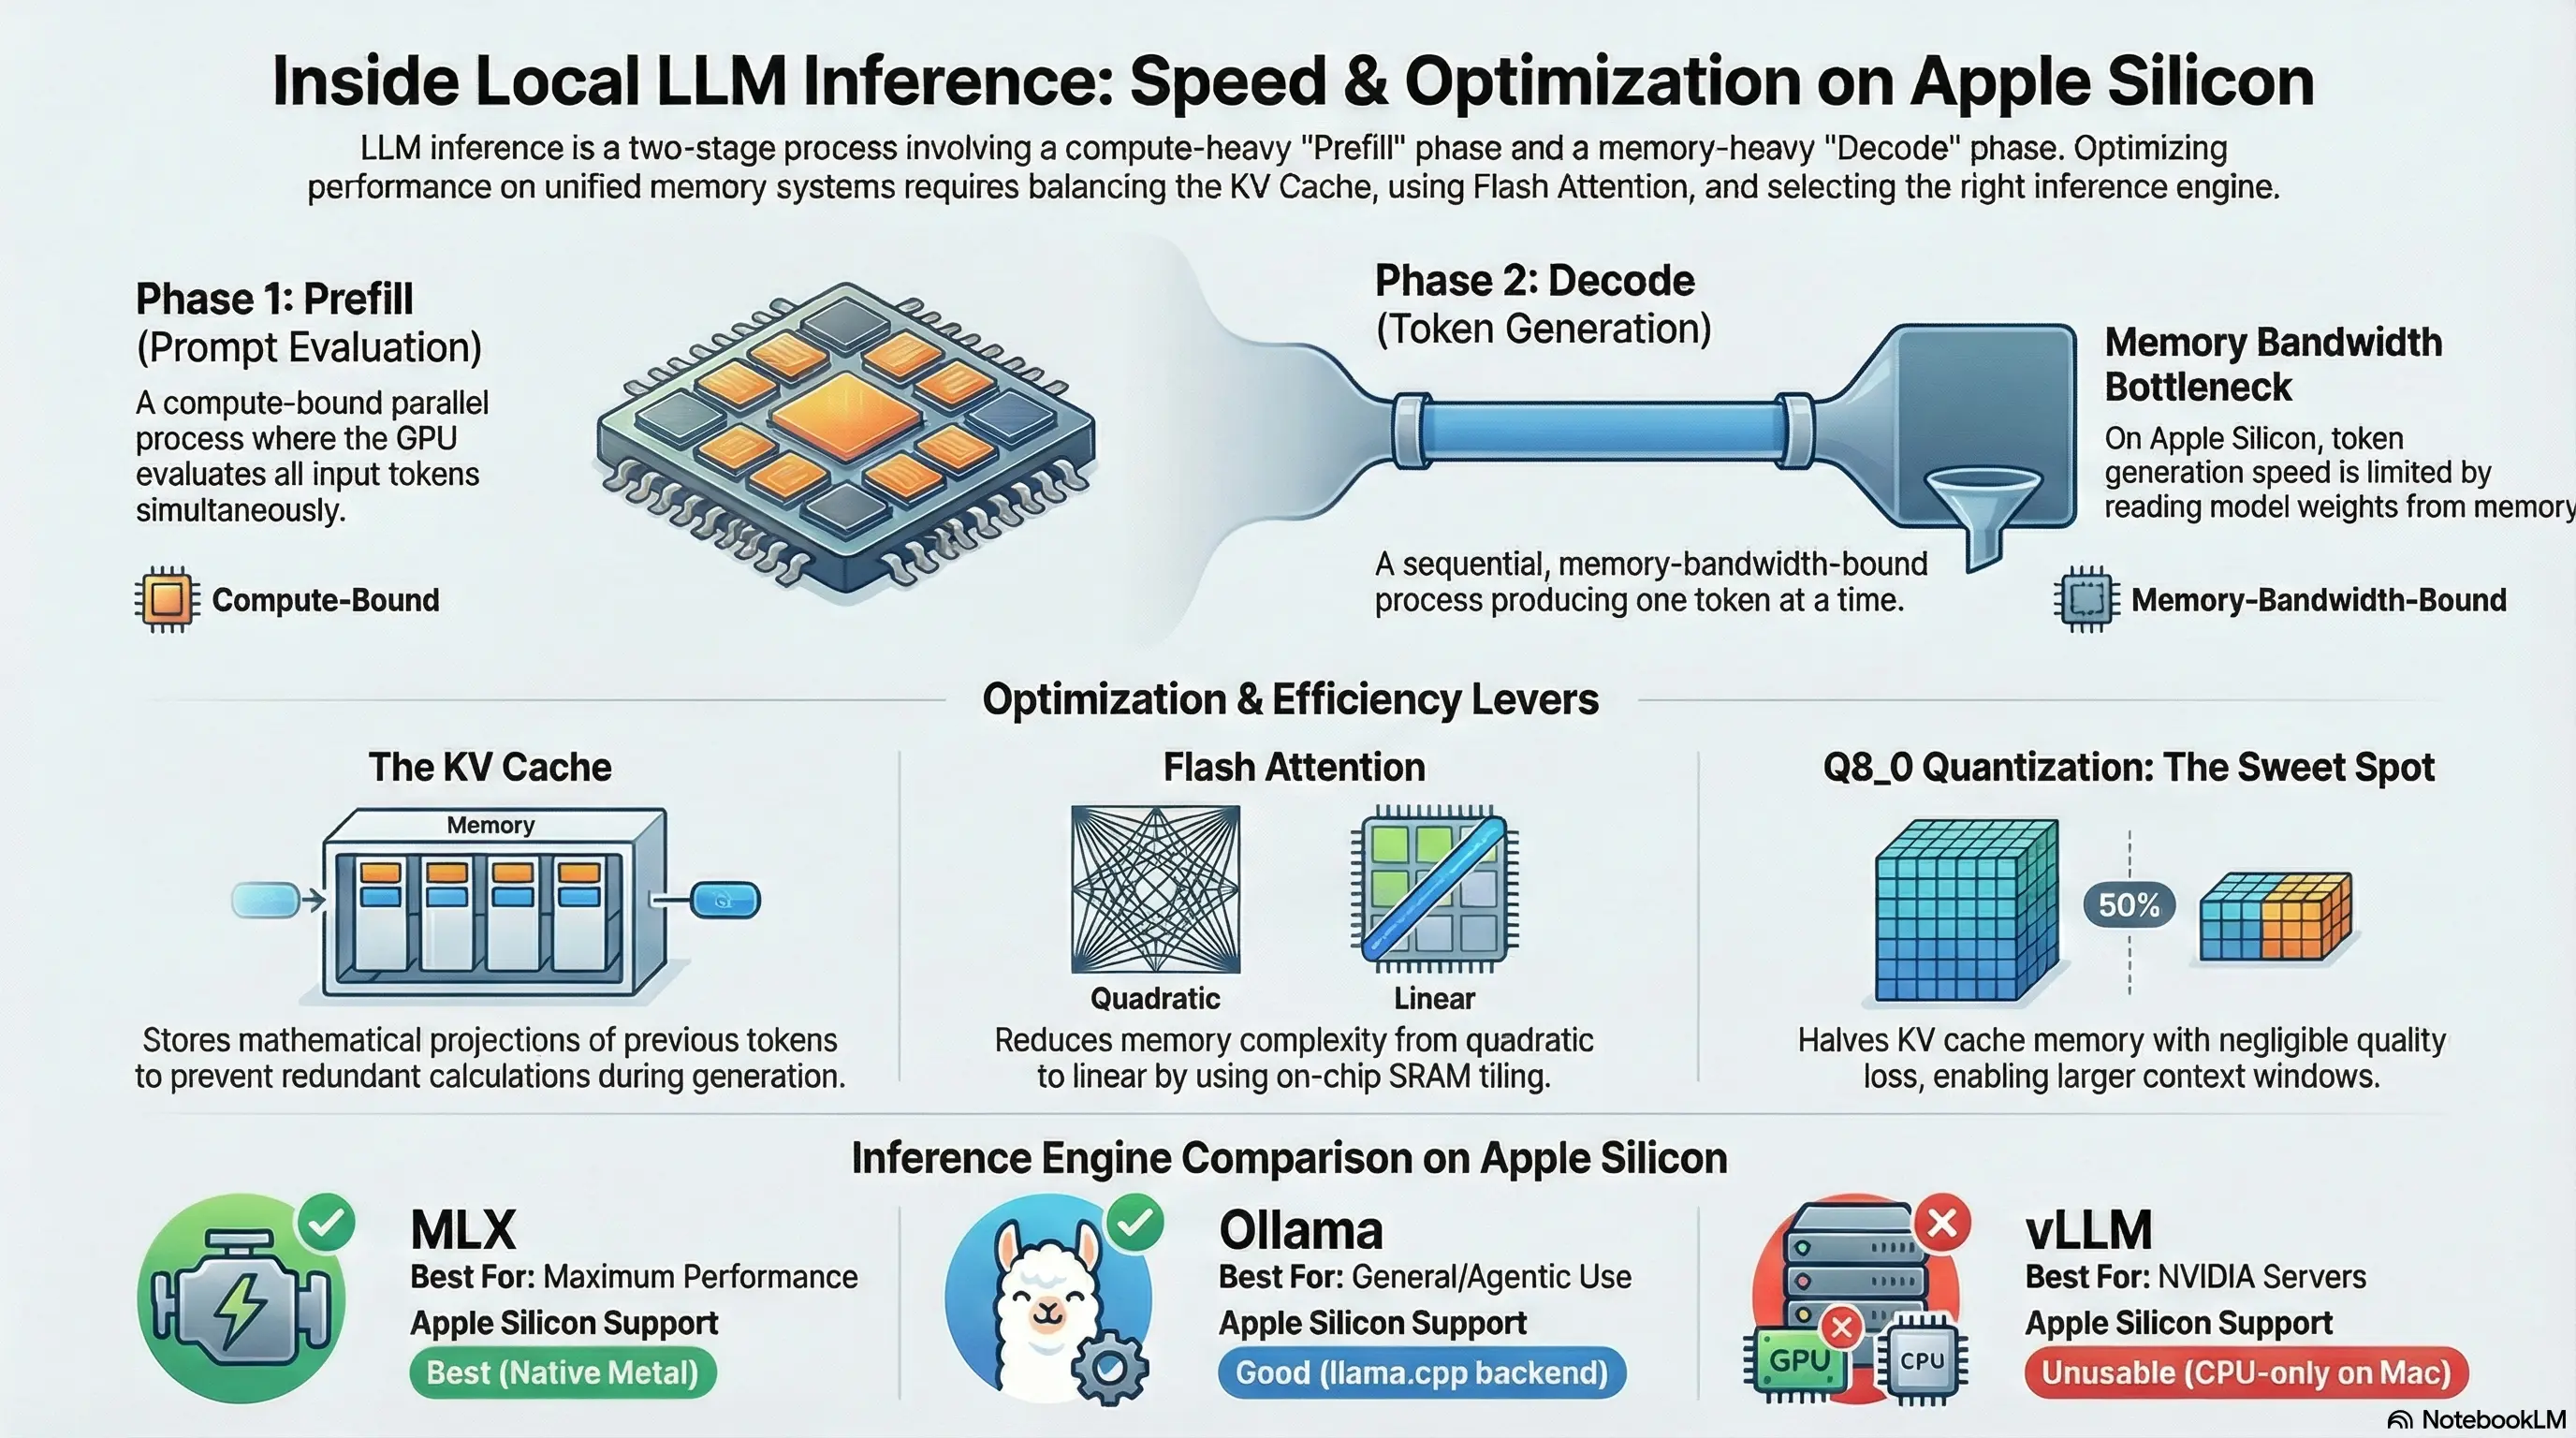
LLM Inference Internals: KV Cache, Flash Attention, and Optimizing for ...

Lessons Learned Scaling LLM Training and Inference with Direct Memory ...

[论文评述] Amplifying Effective CXL Memory Bandwidth for LLM Inference via ...
Advertisement Space (300x250)

Why LLM Inference Gets Fast and Then Runs Out of Memory
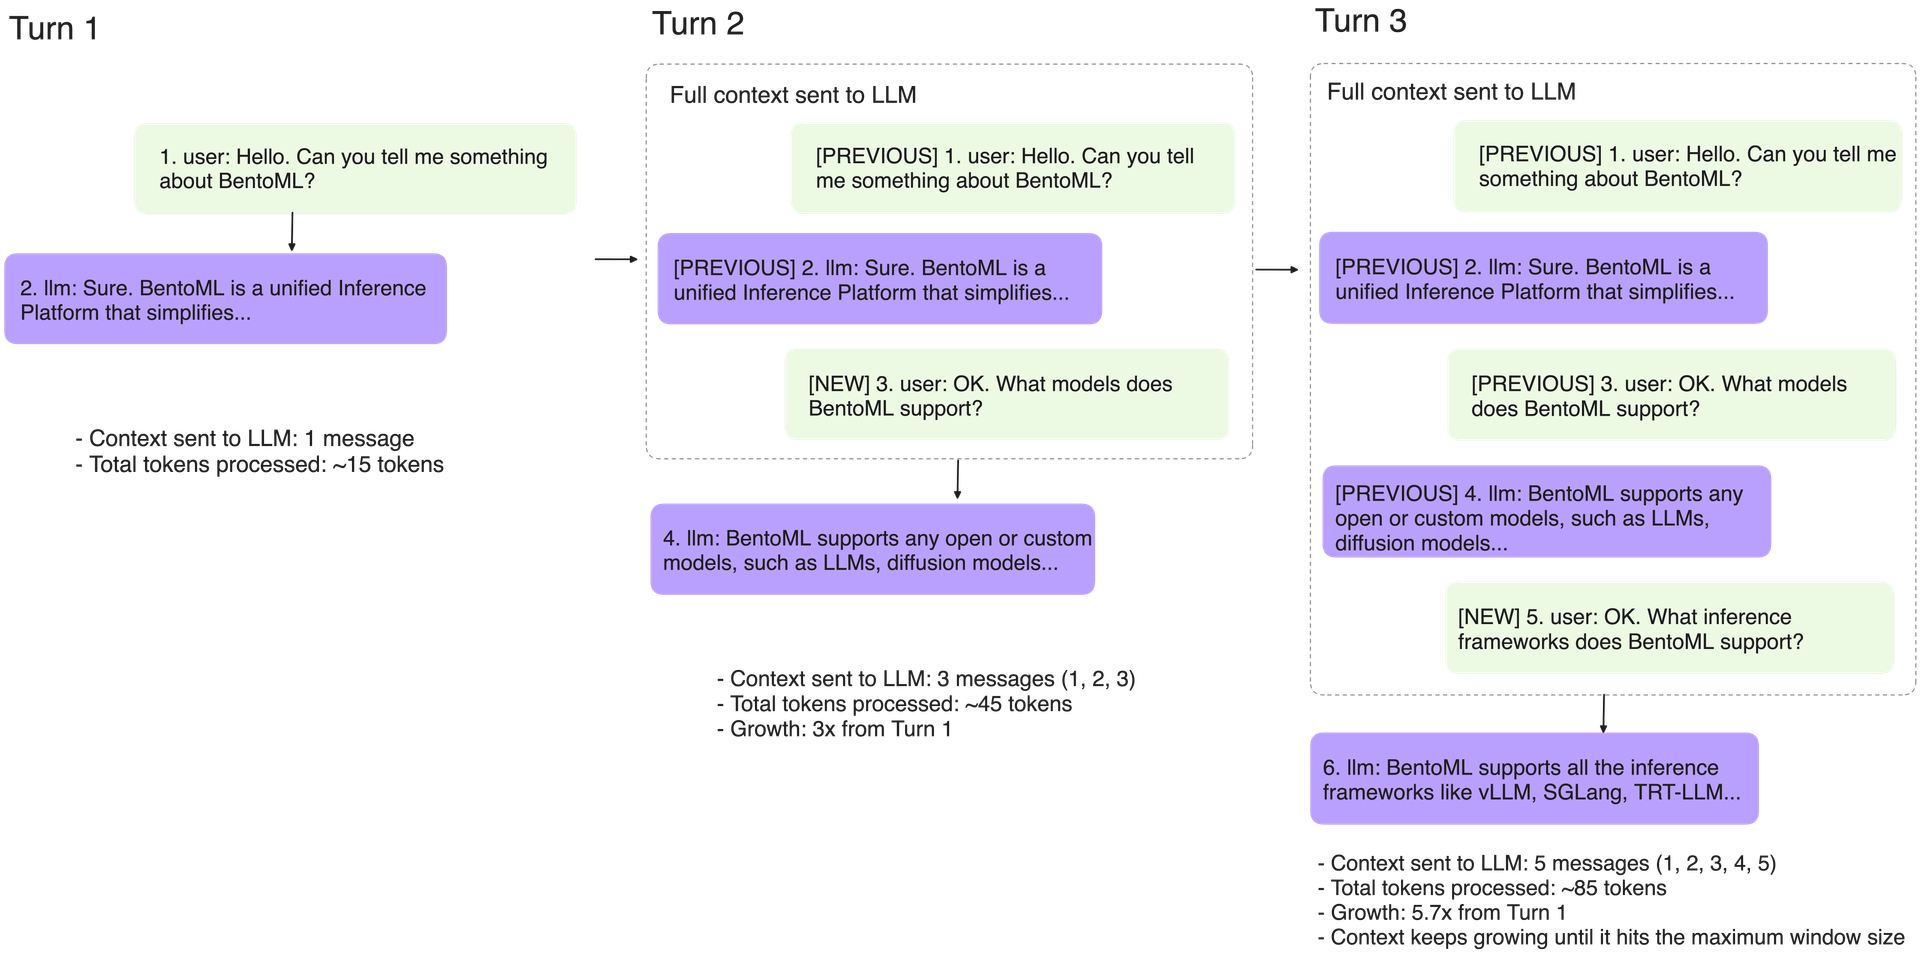
What is GPU Memory and Why it Matters for LLM Inference

[论文评述] Characterizing and Optimizing LLM Inference Workloads on CPU-GPU ...

[论文评述] Accelerating LLM Inference Throughput via Asynchronous KV Cache ...

LLM Inference — Optimizing the KV Cache for High-Throughput, Long ...
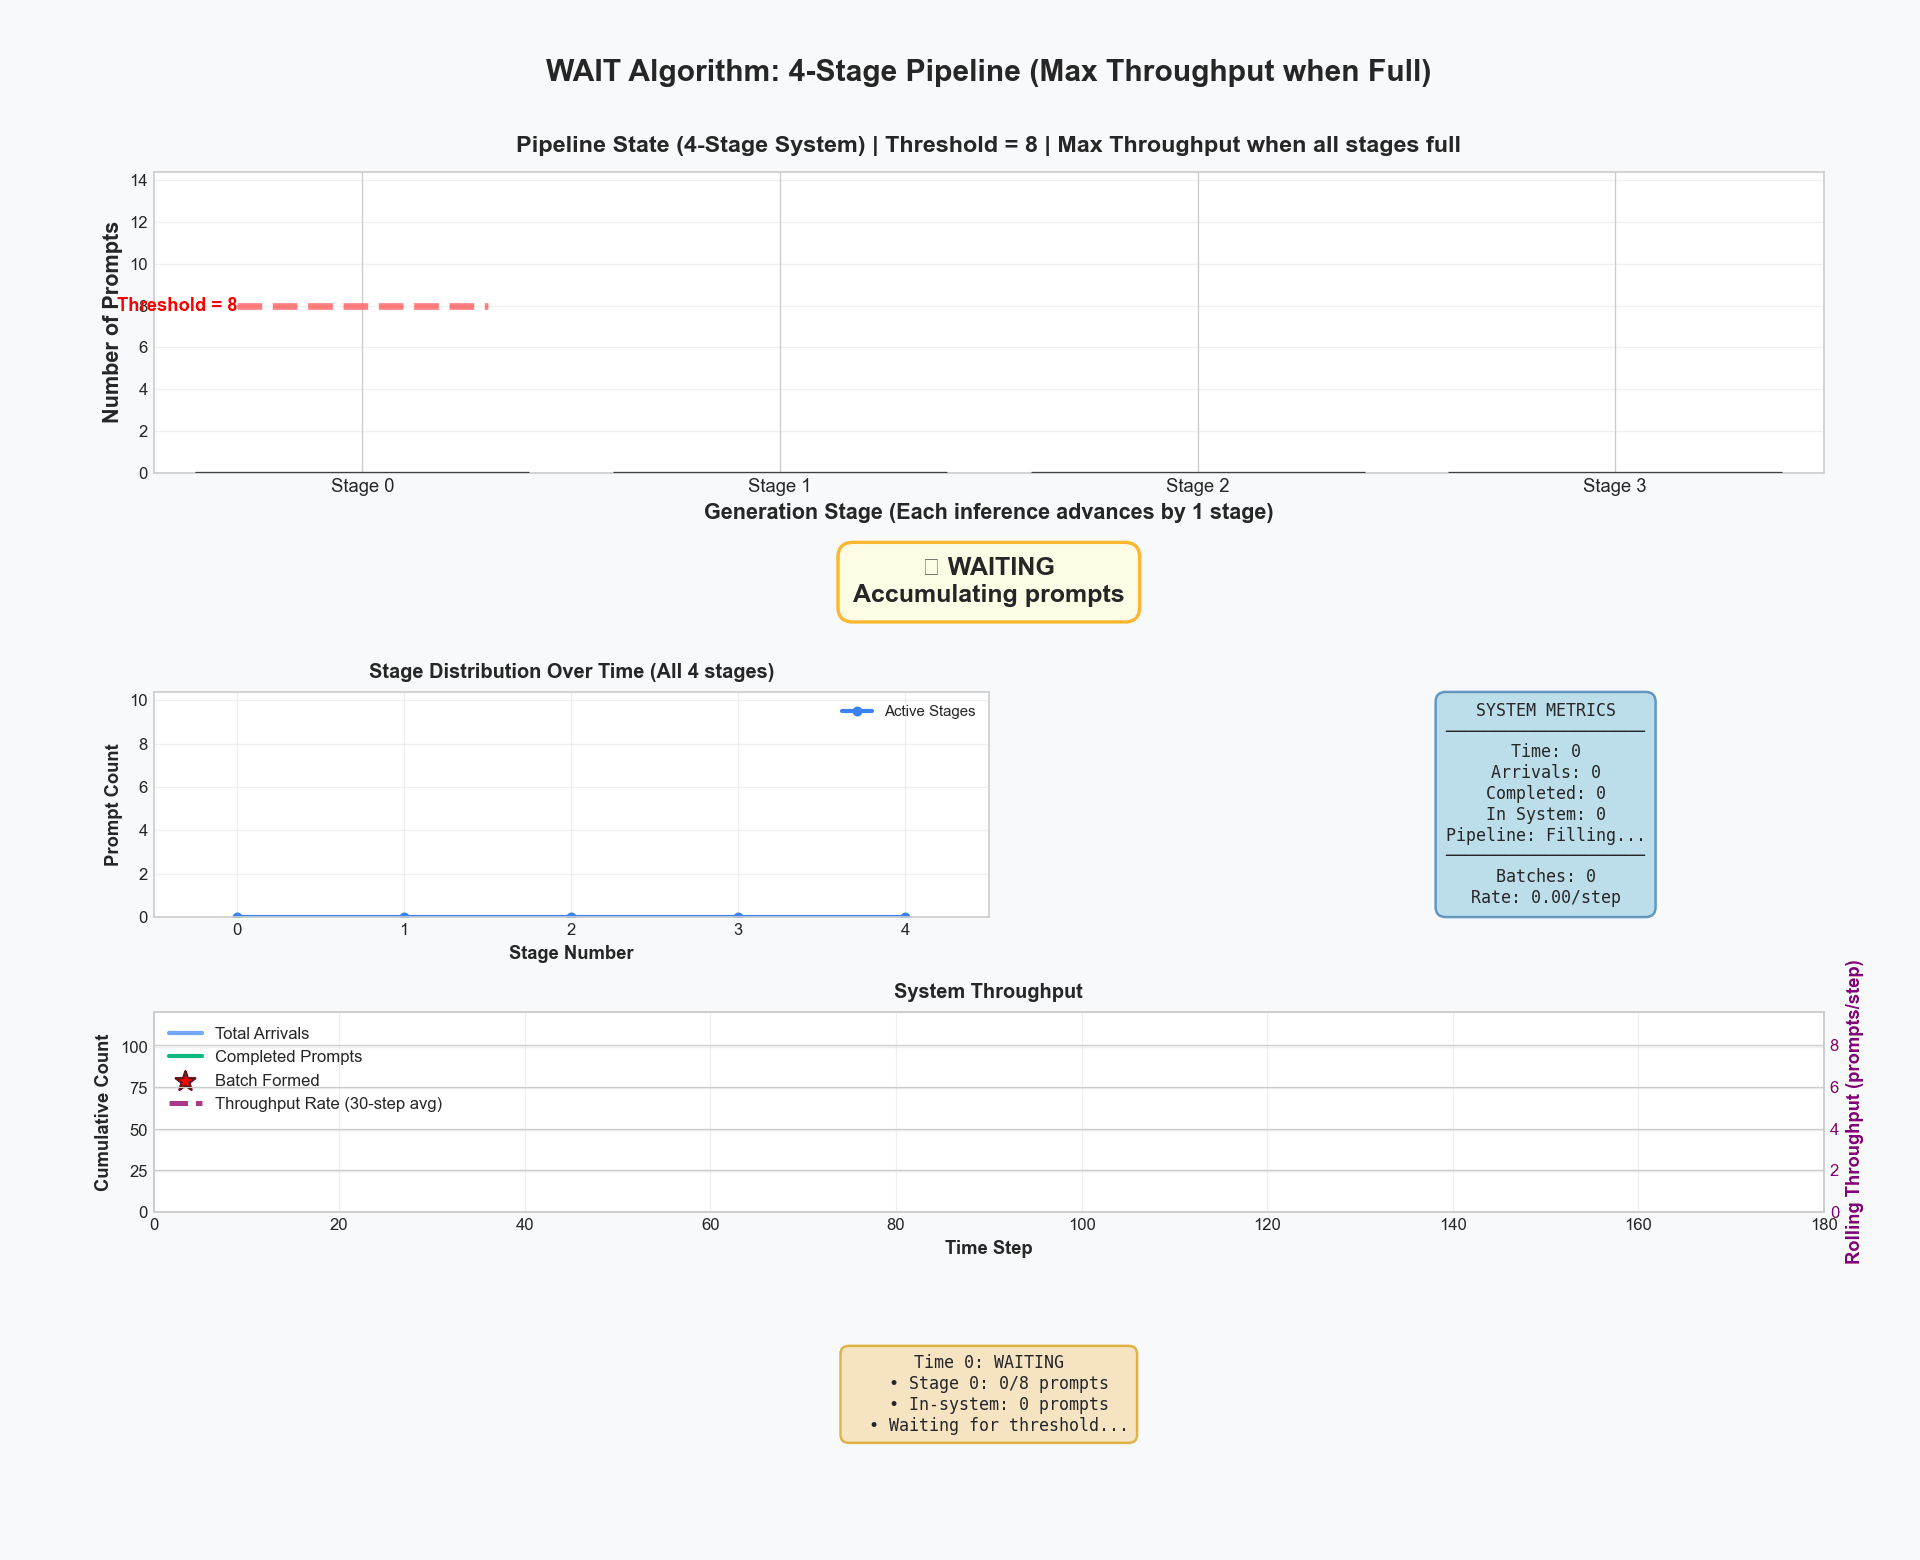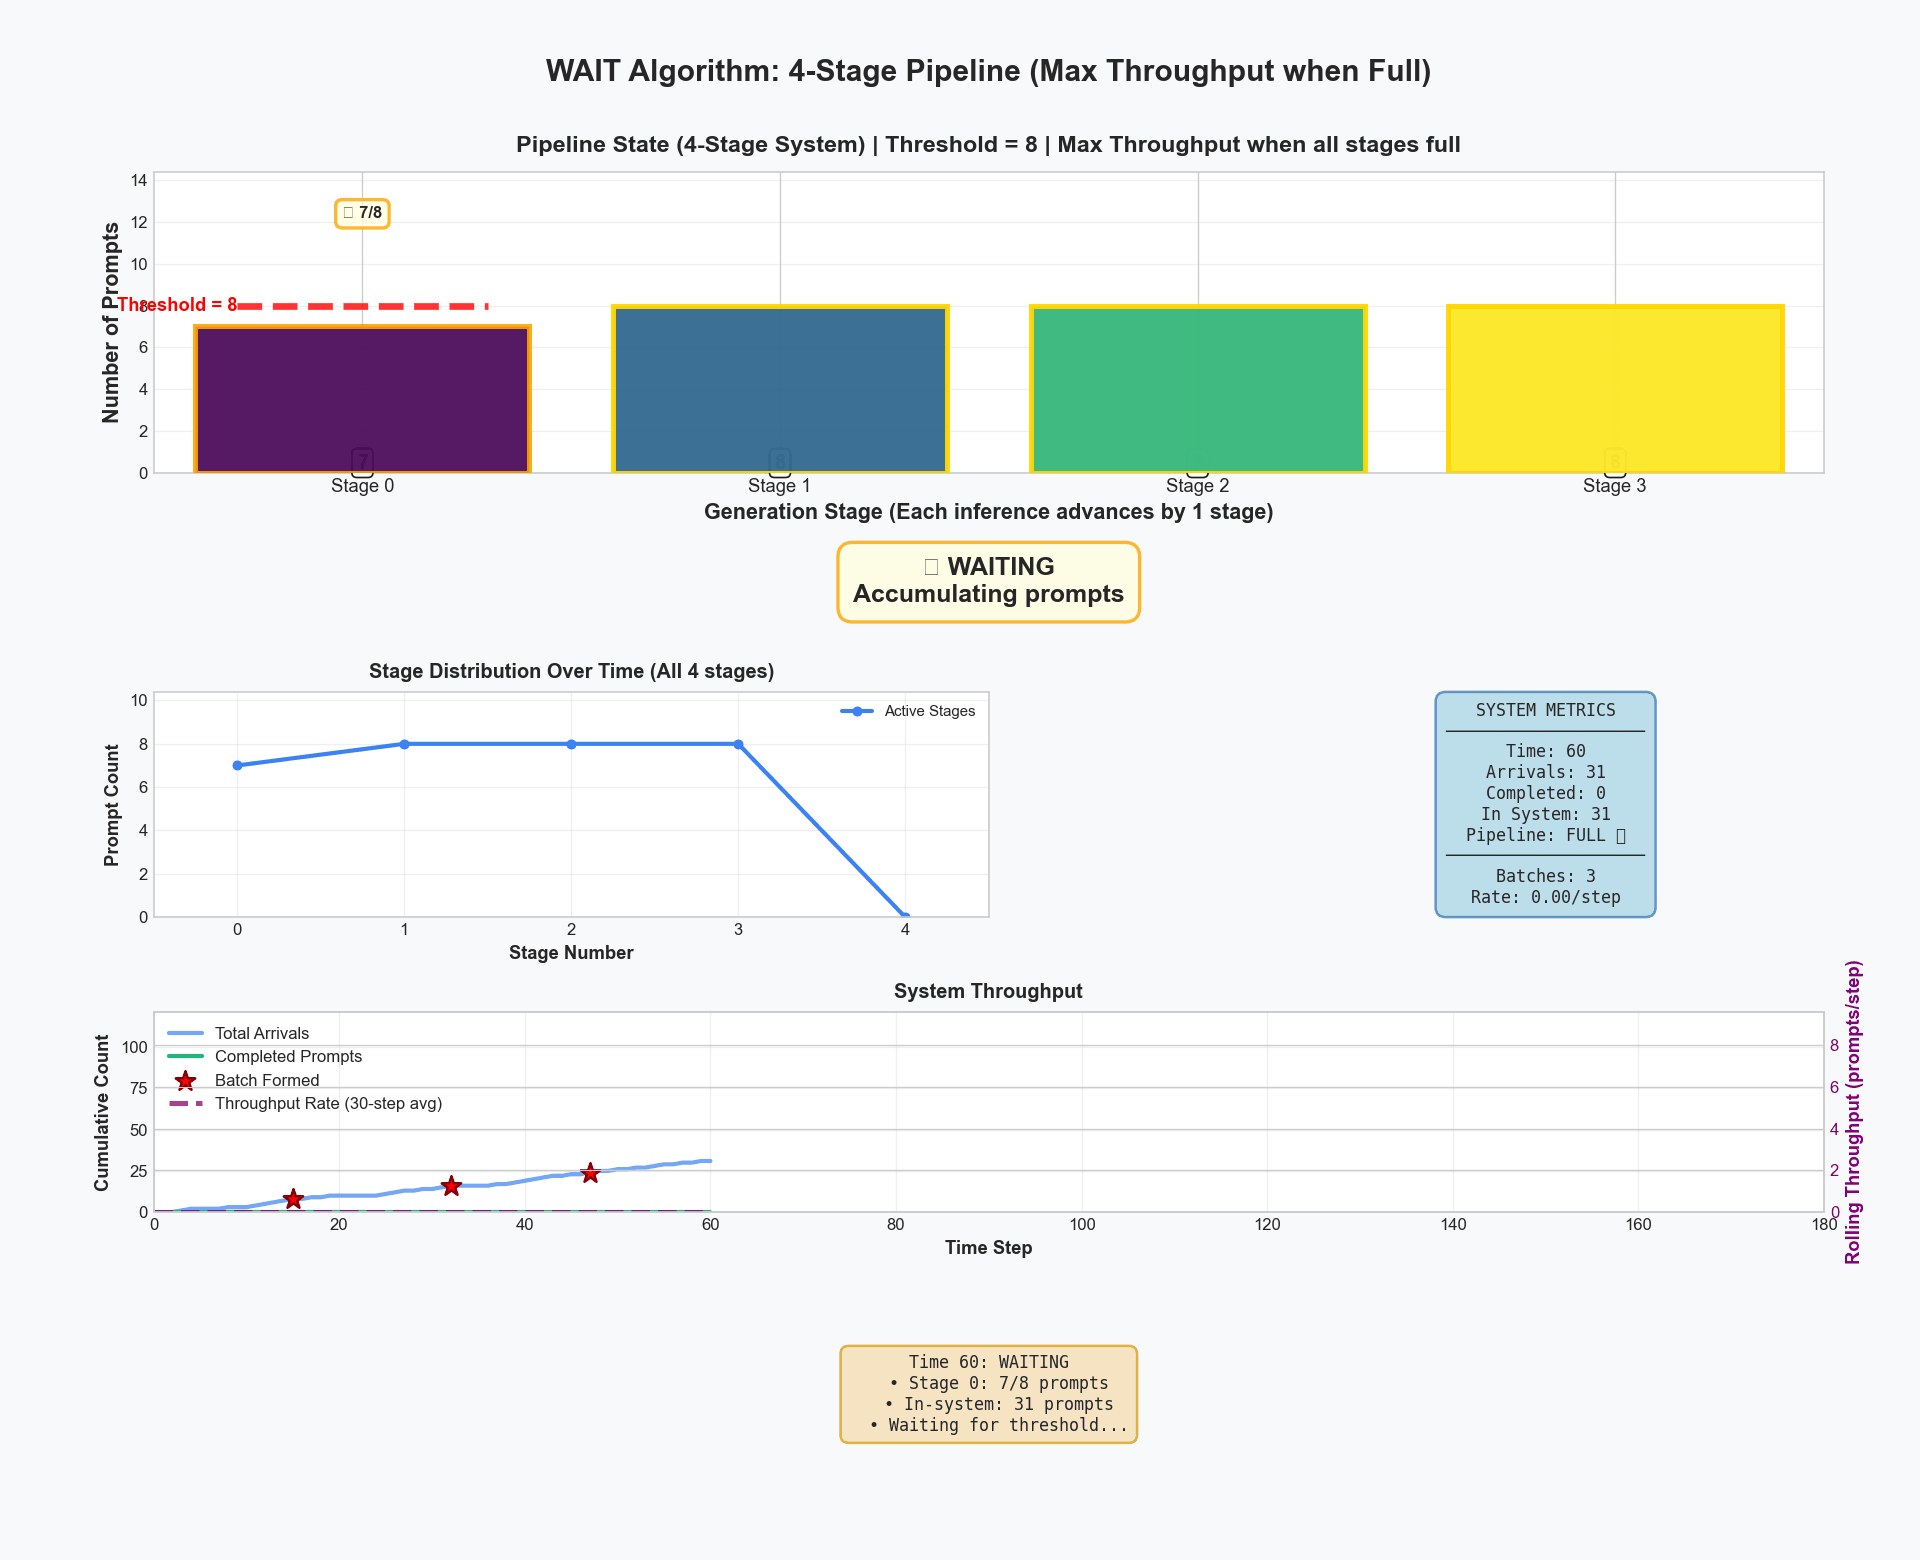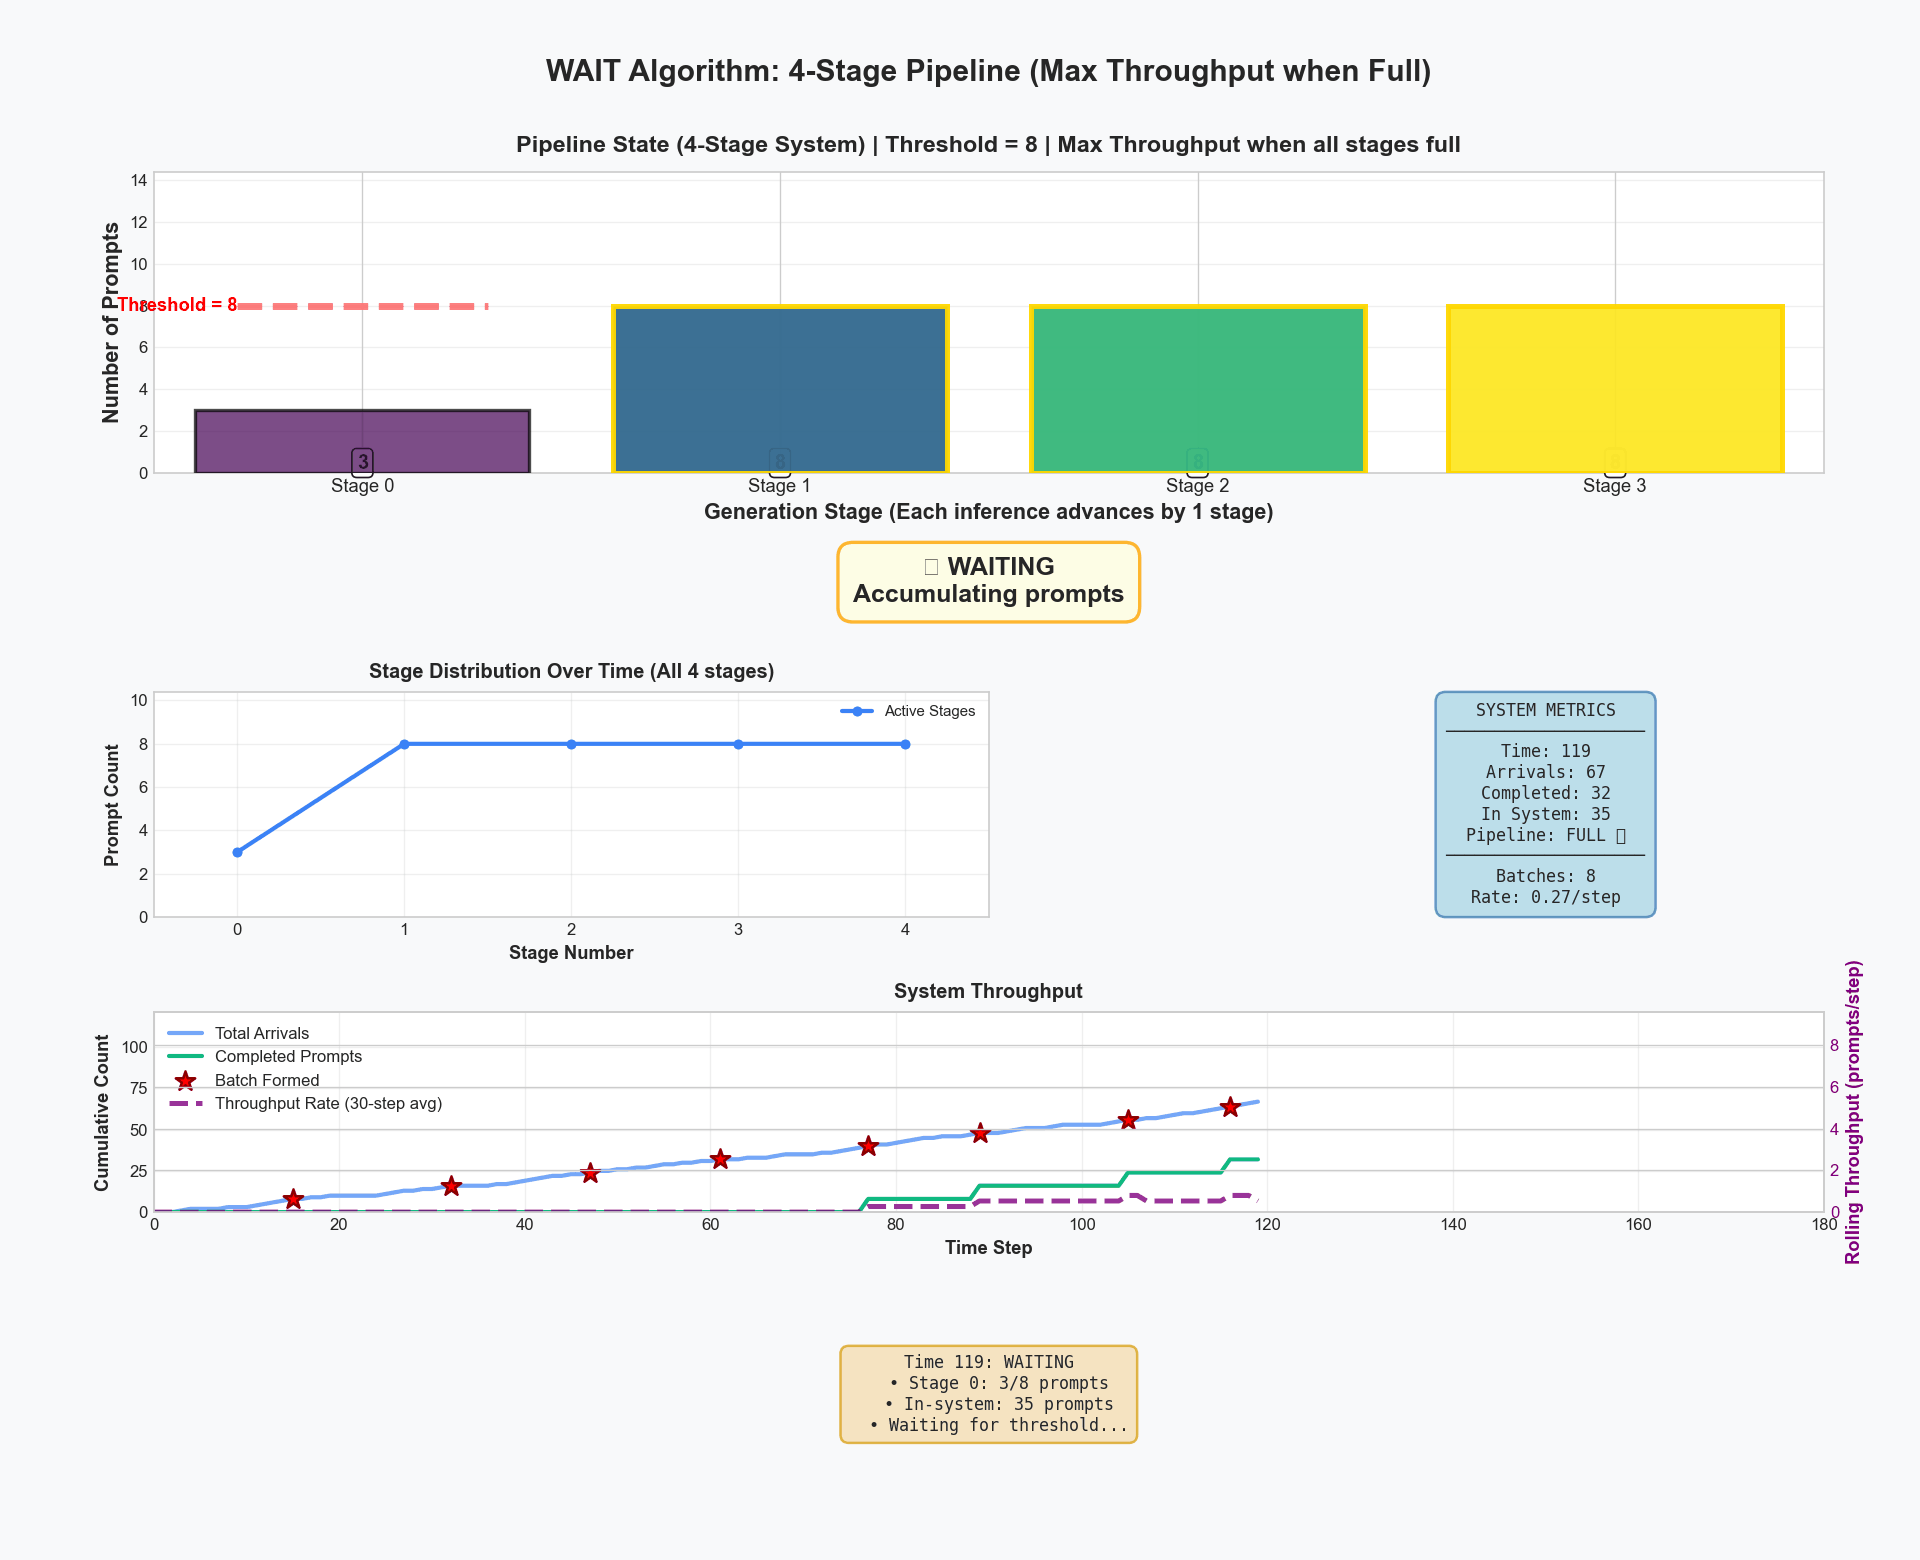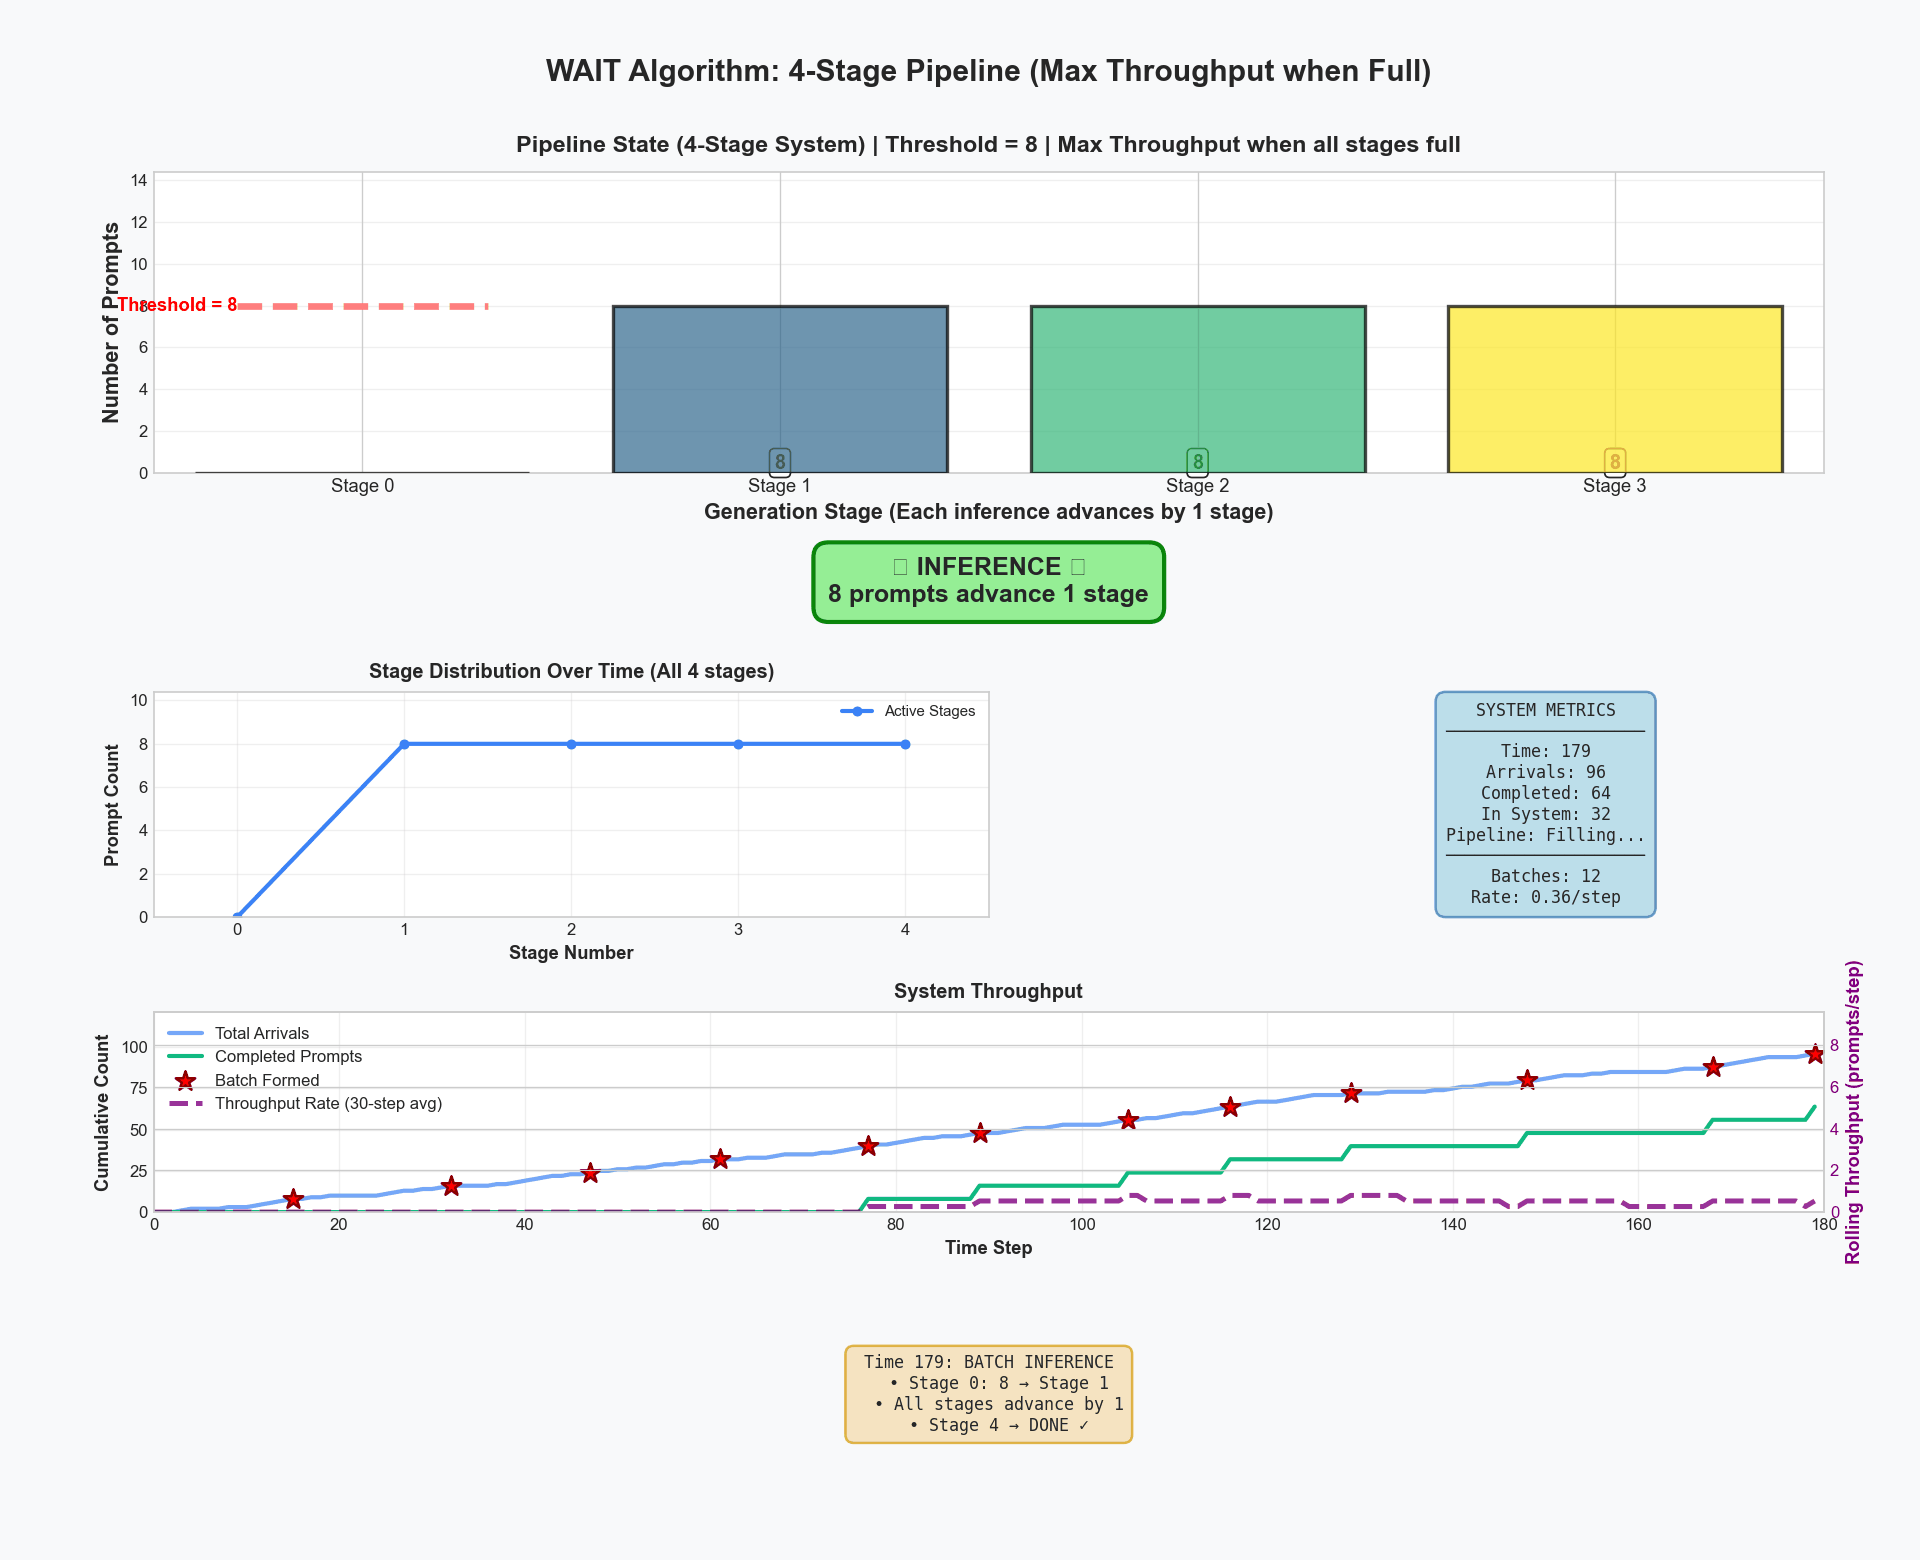
Optimizing LLM Inference: Fluid-Guided Online Scheduling with Memory ...
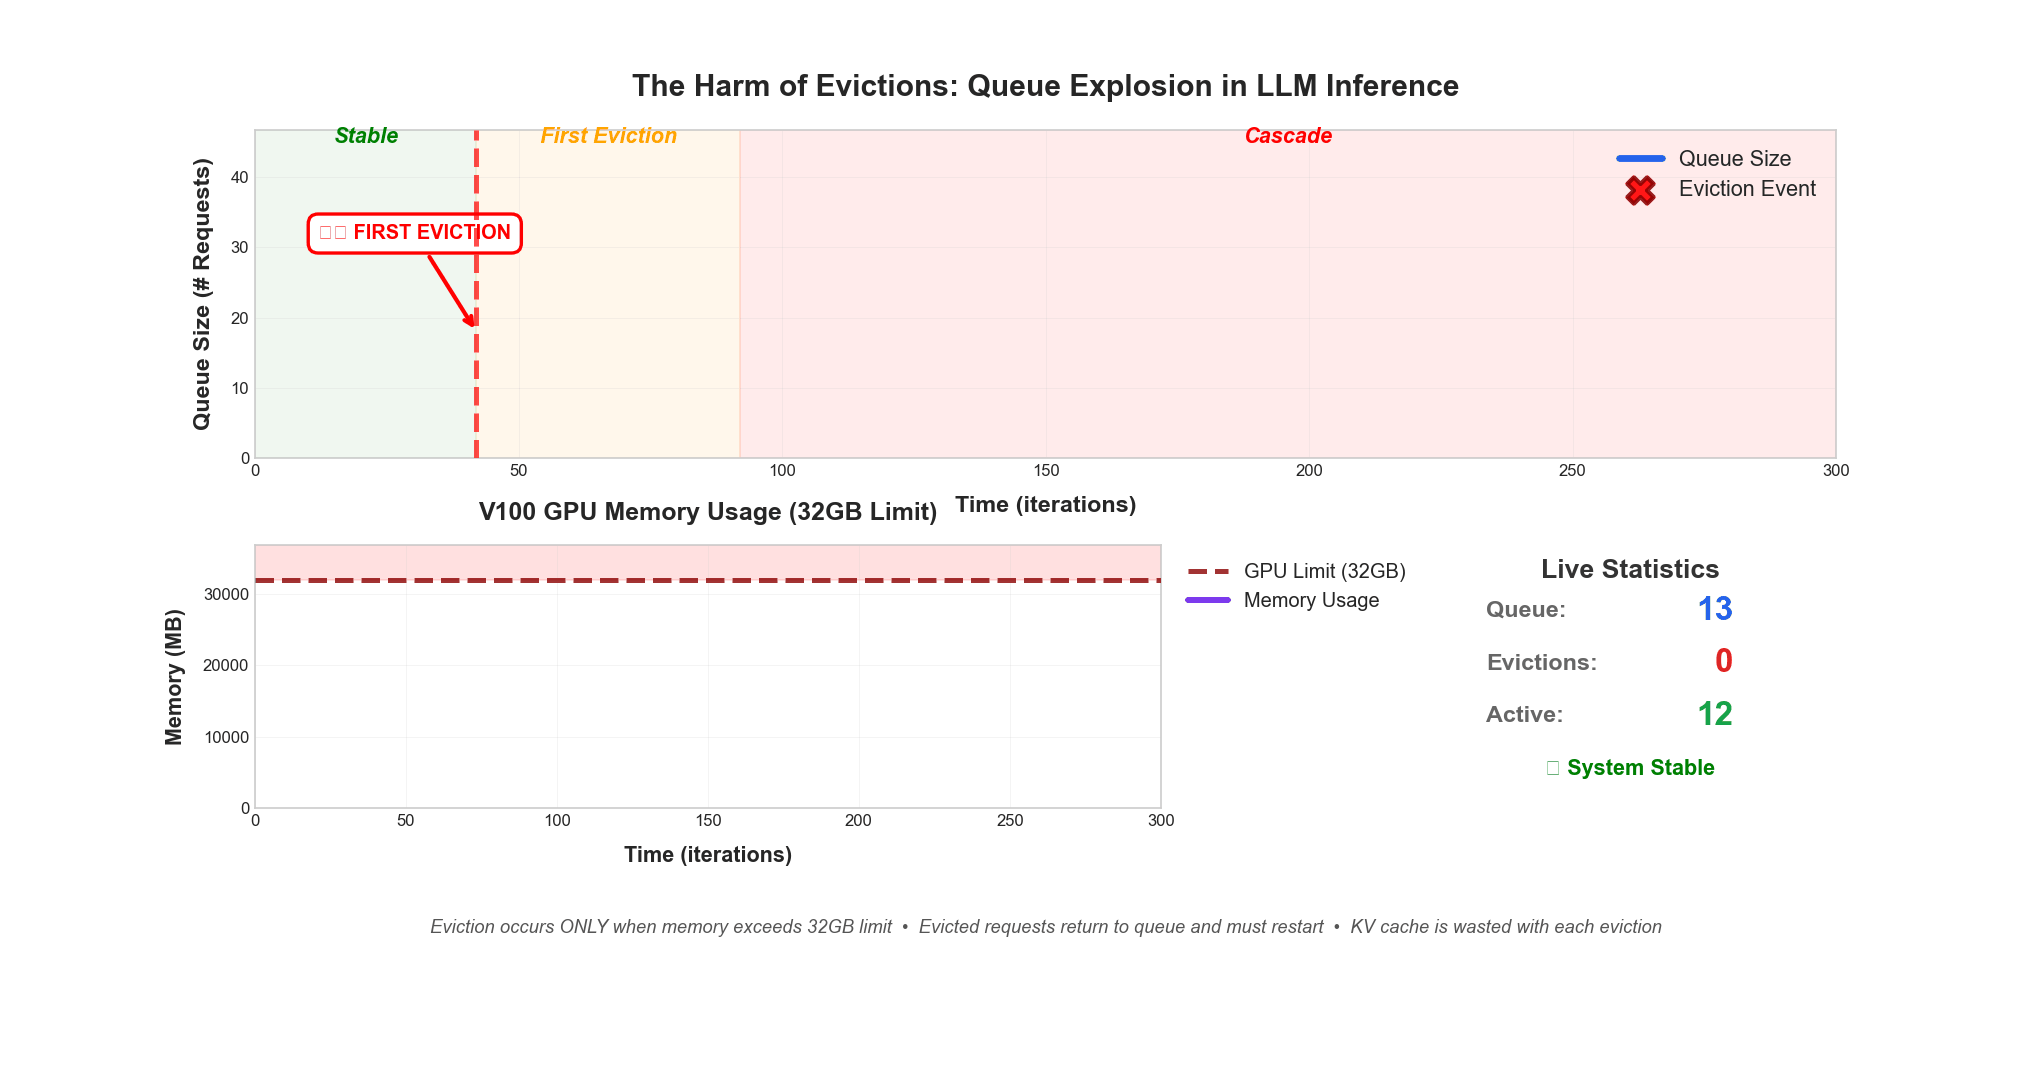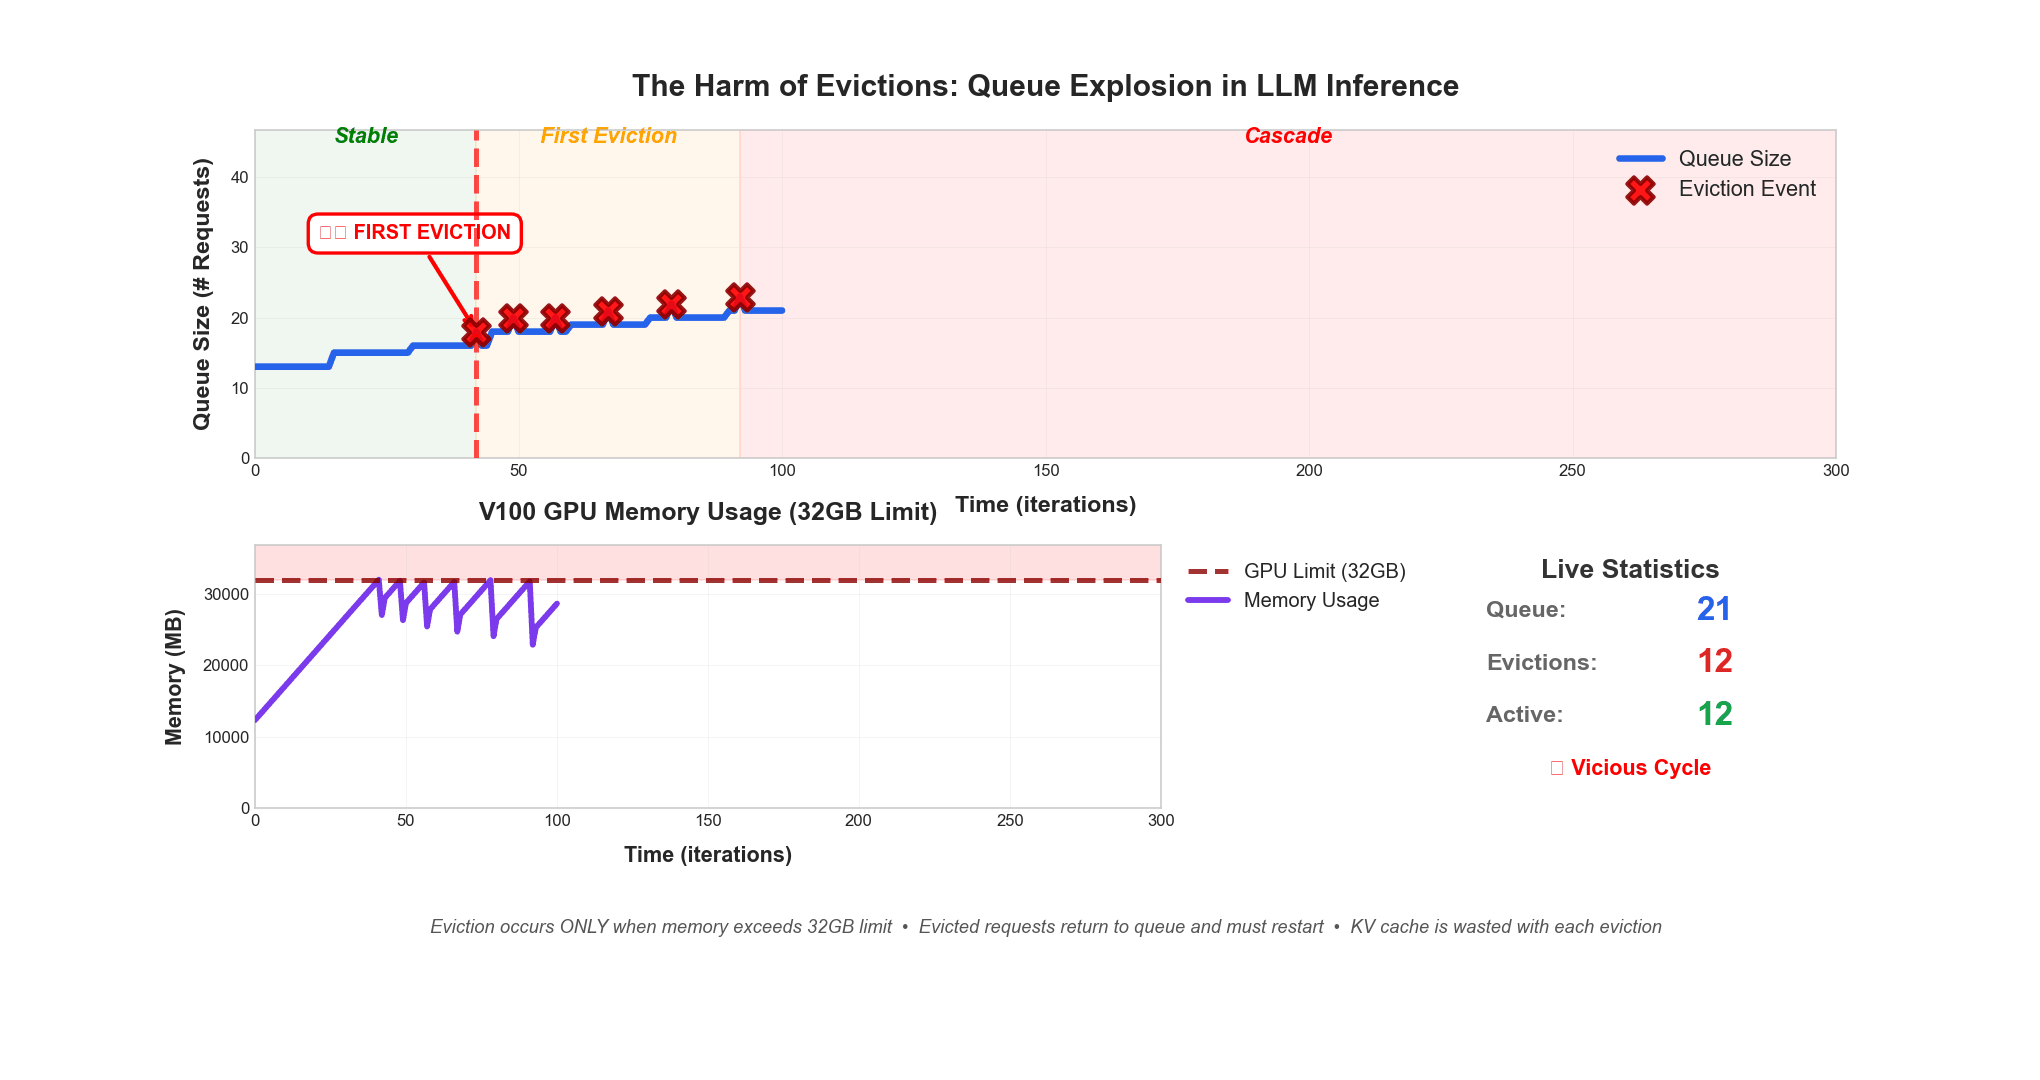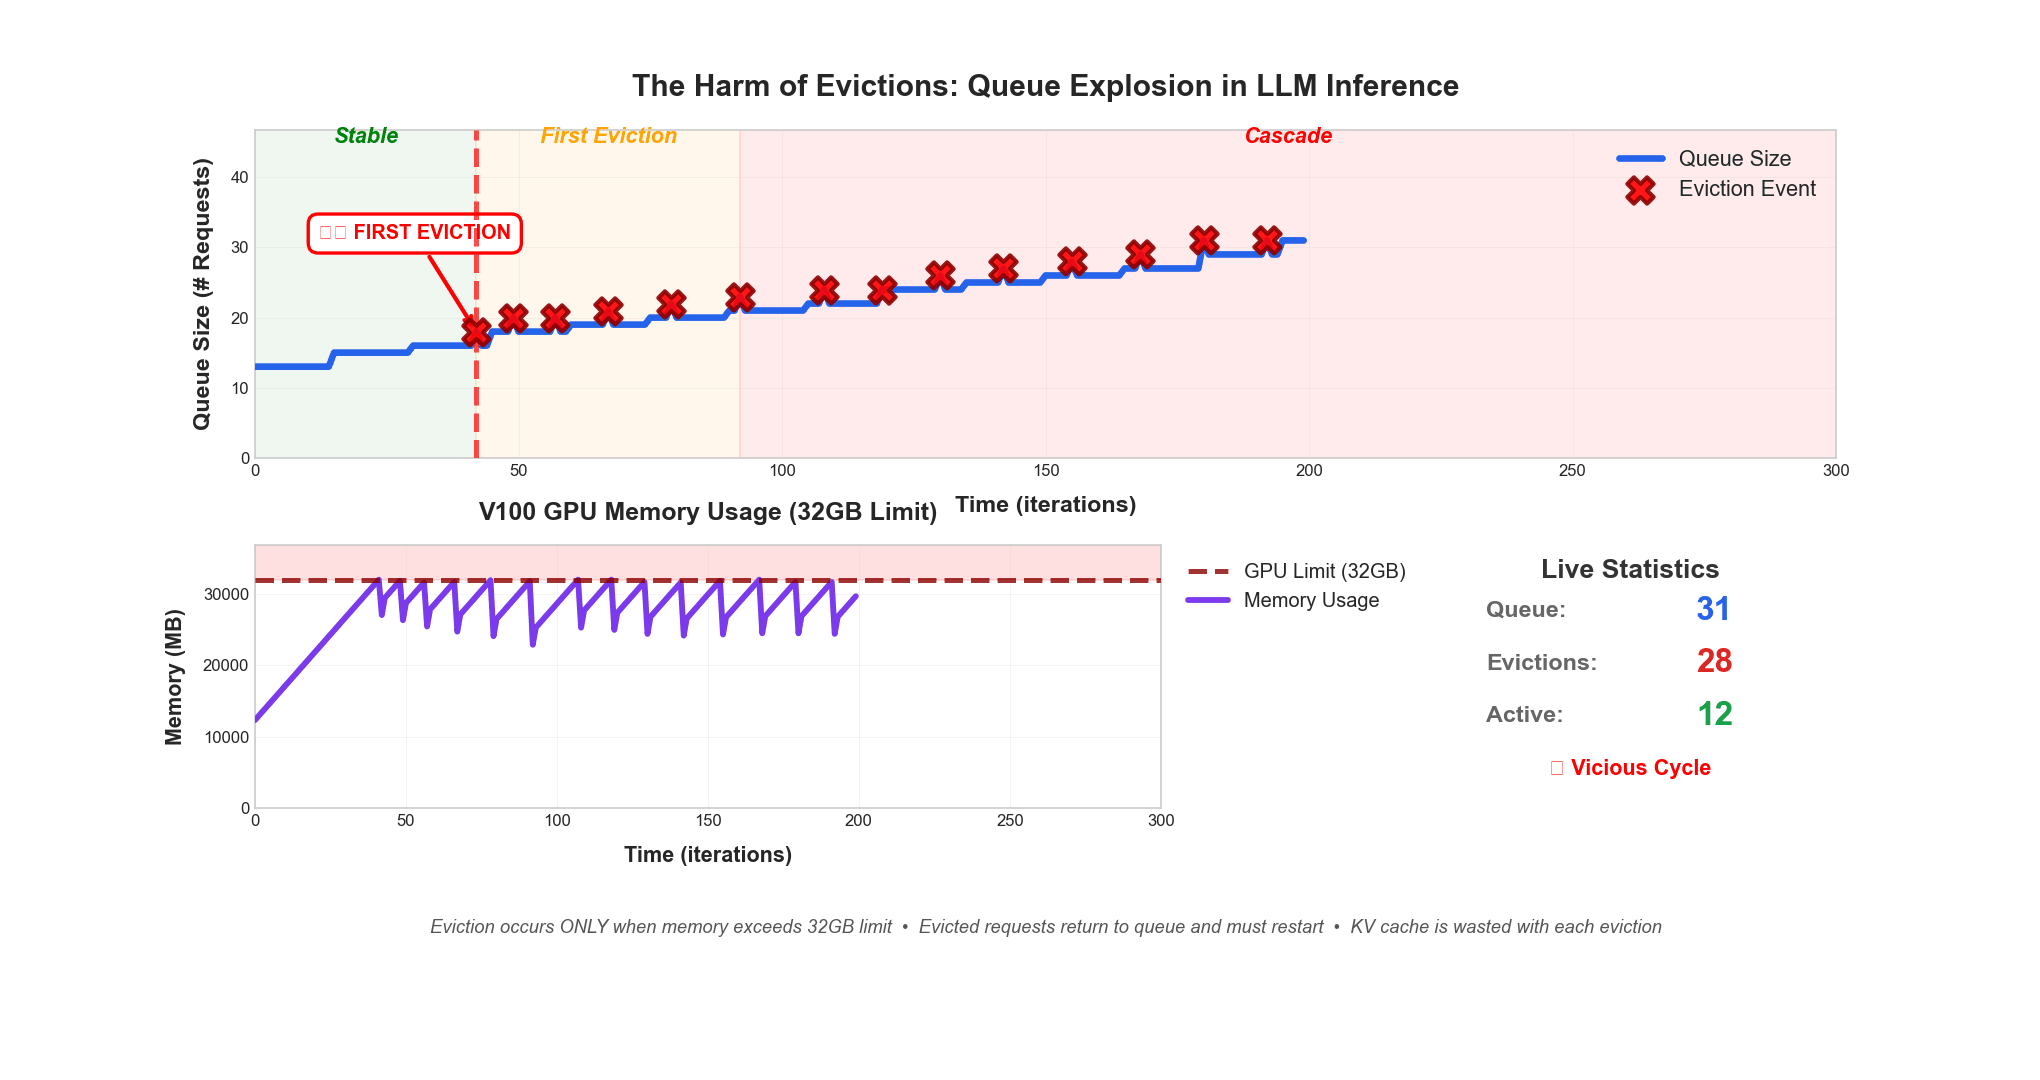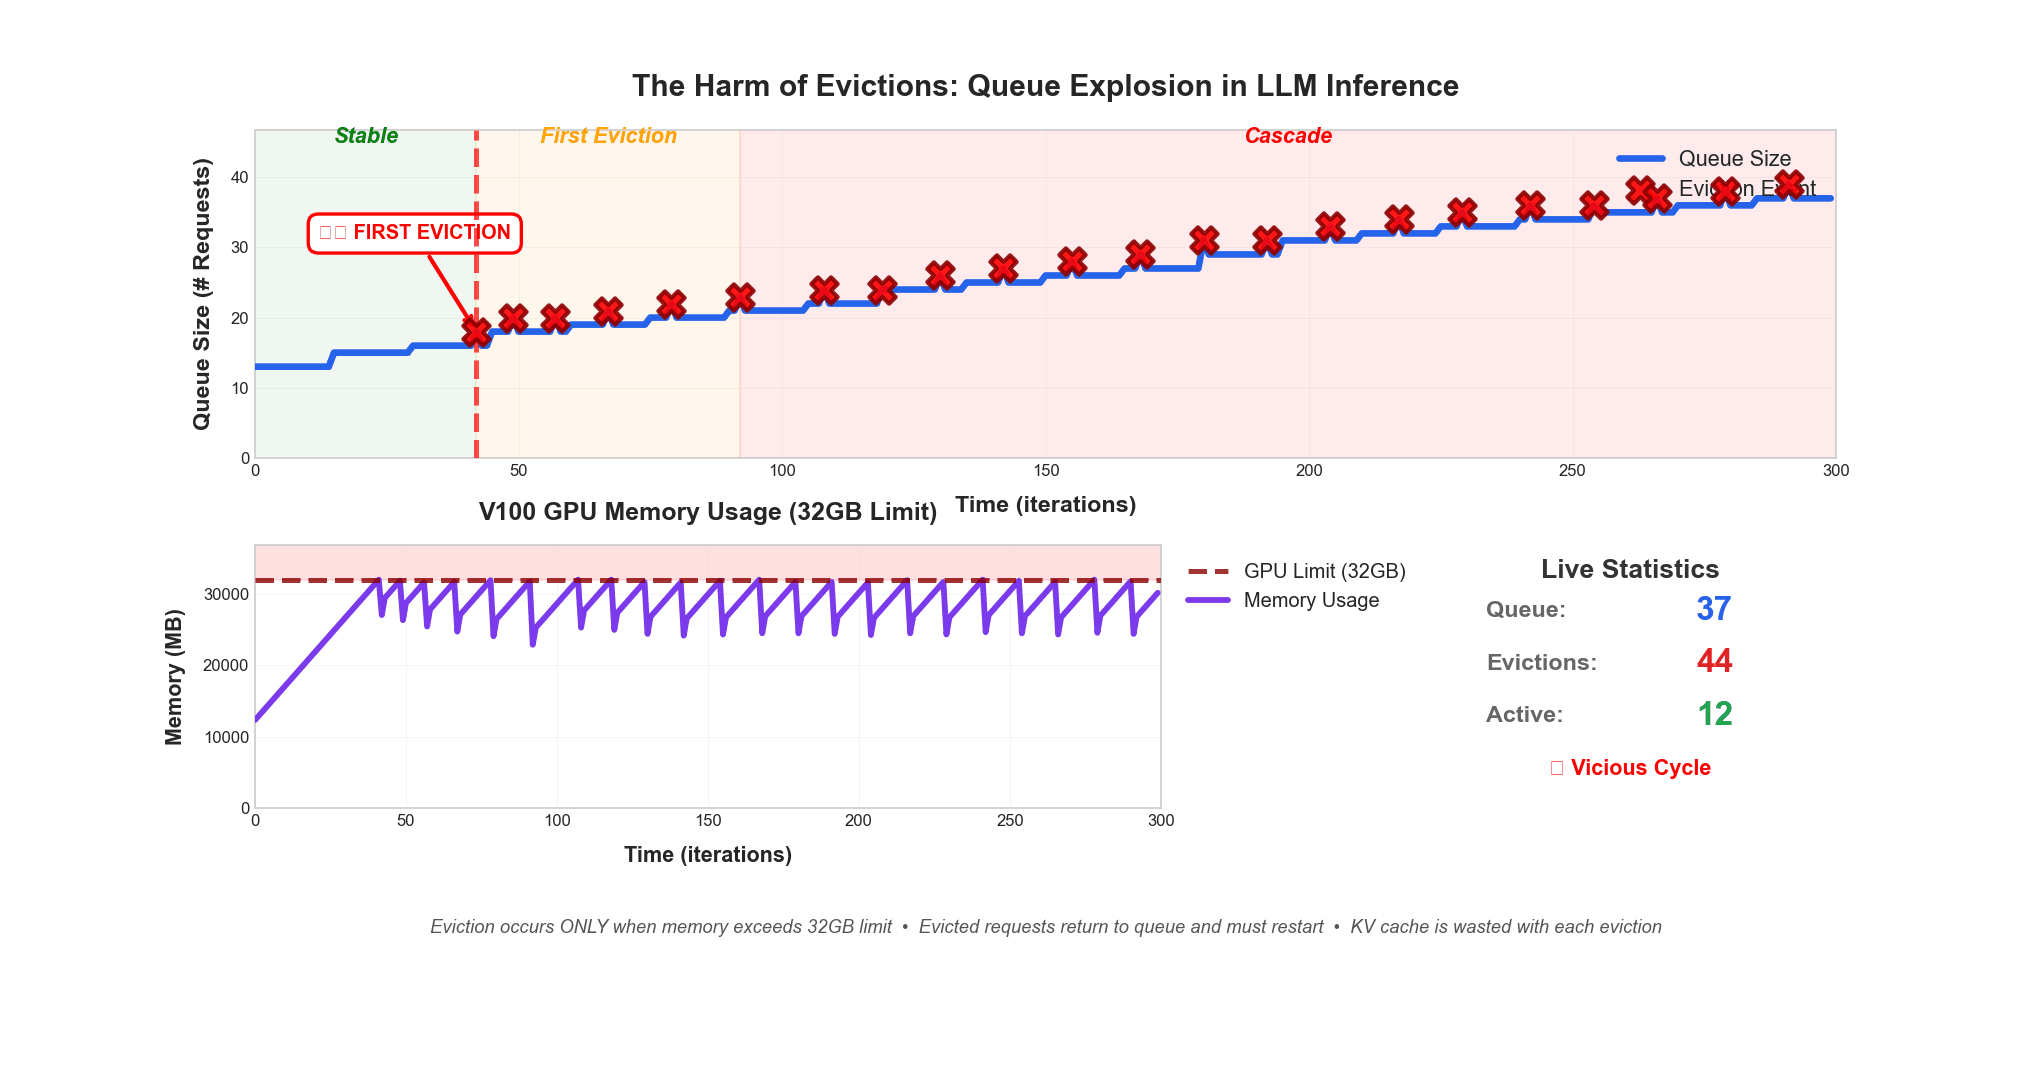
Optimizing LLM Inference: Fluid-Guided Online Scheduling with Memory ...
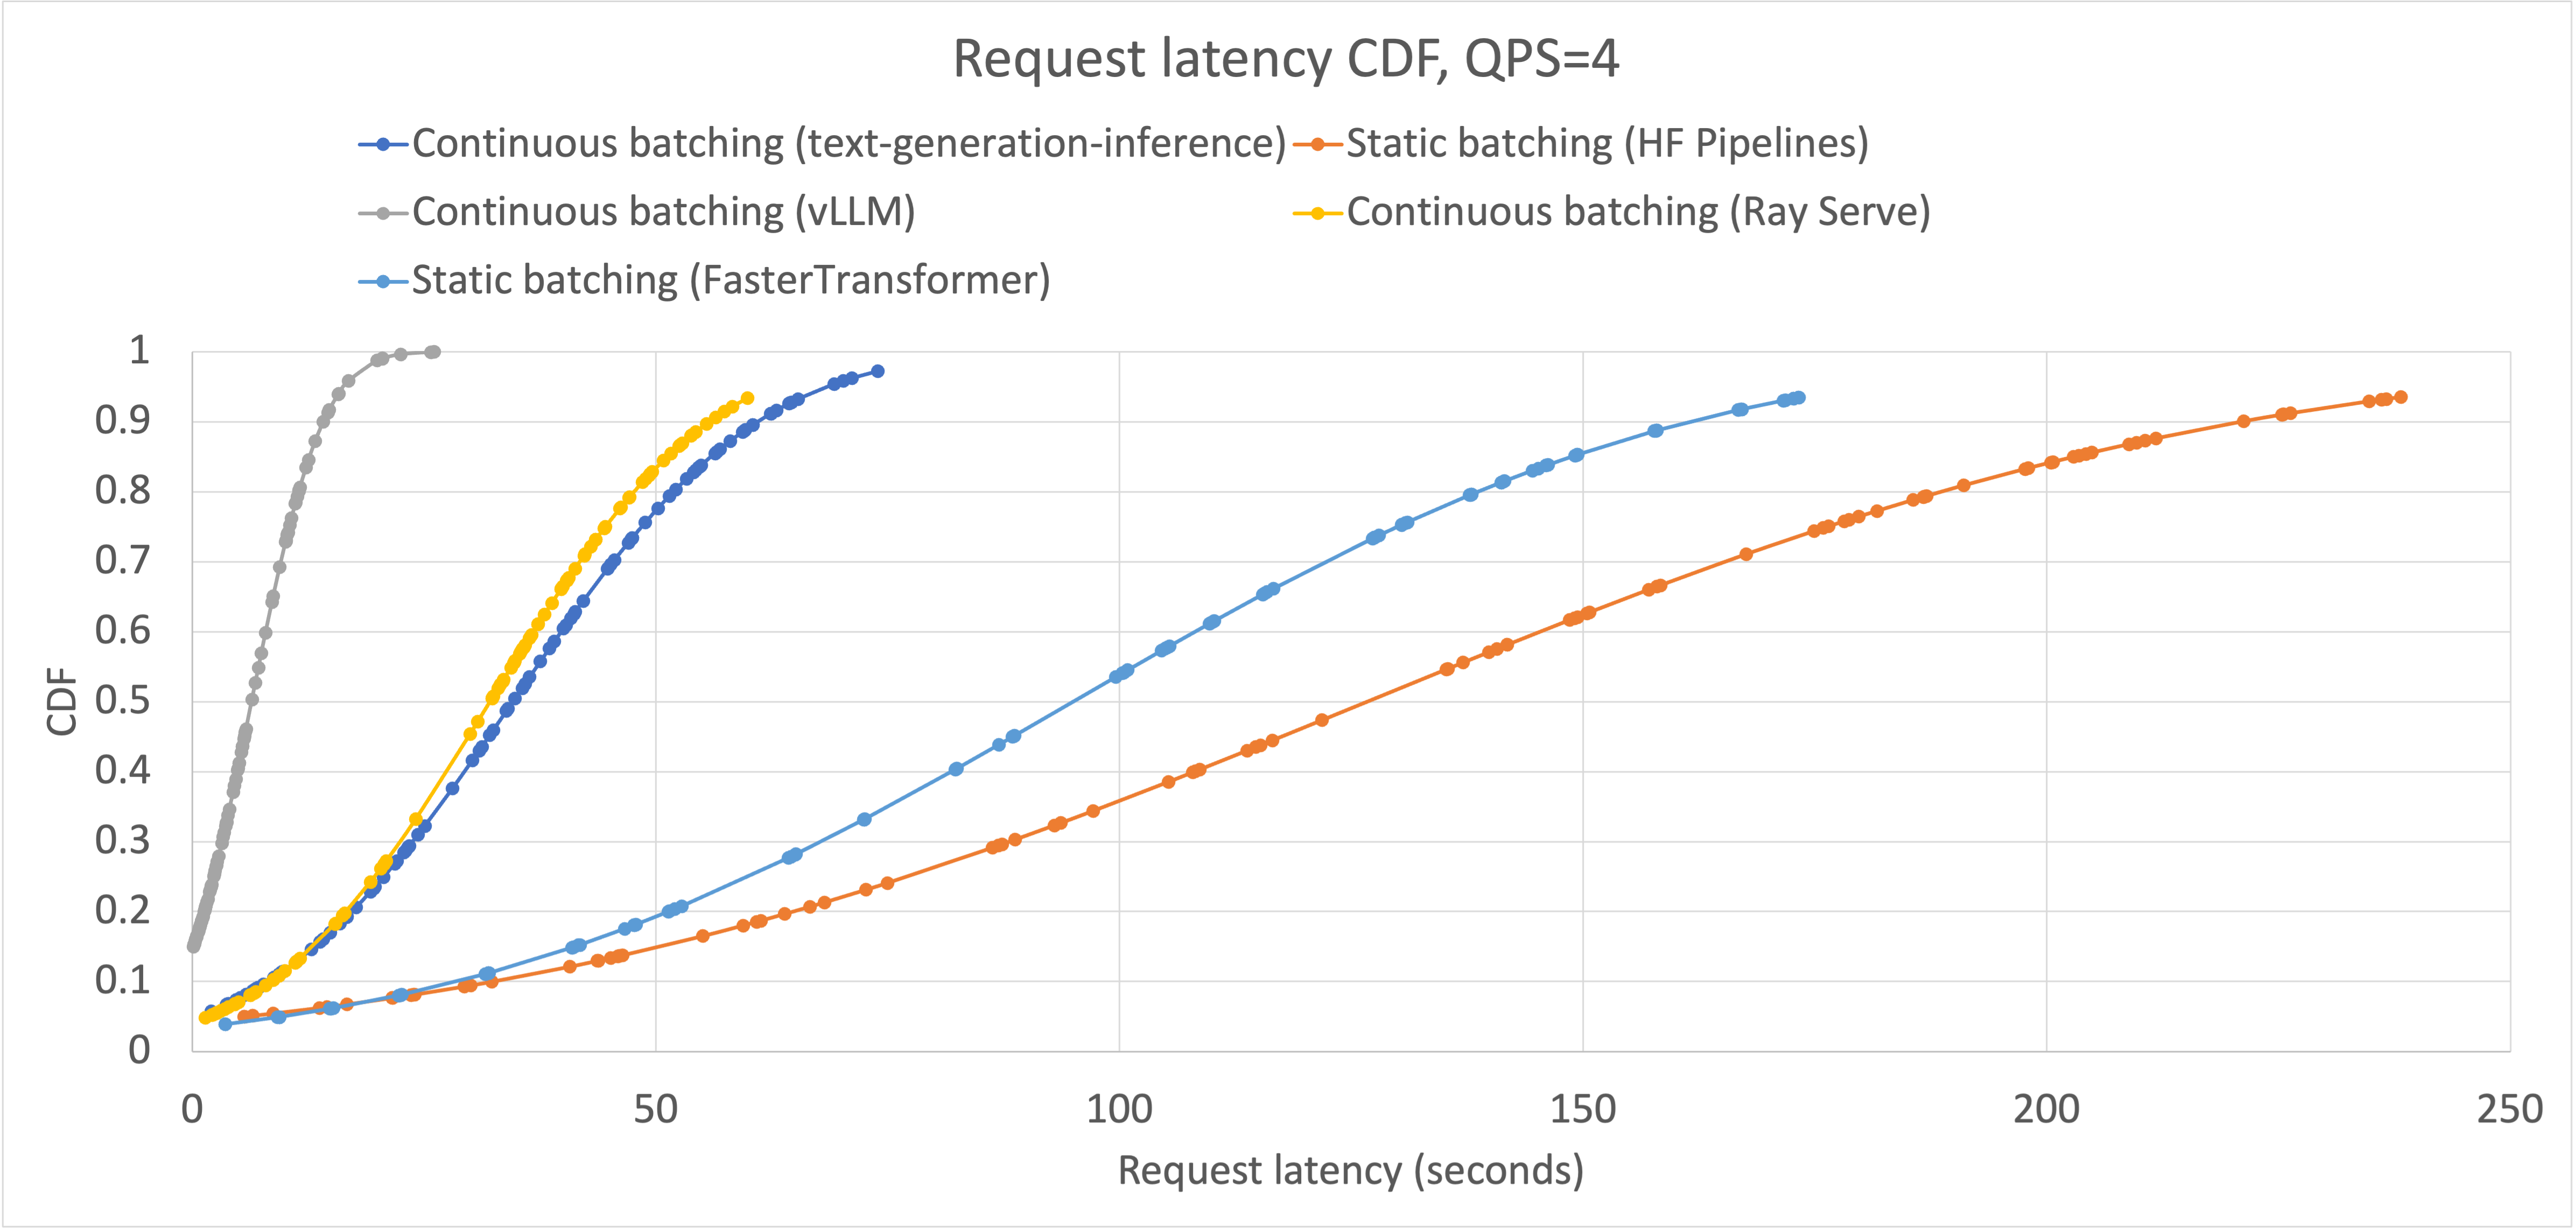
Scaling LLM inference with Ray and vLLM

LLM Inference Optimization: Techniques That Actually Reduce Latency and ...

LLM inference optimization: Model Quantization and Distillation - YouTube
Advertisement Space (336x280)
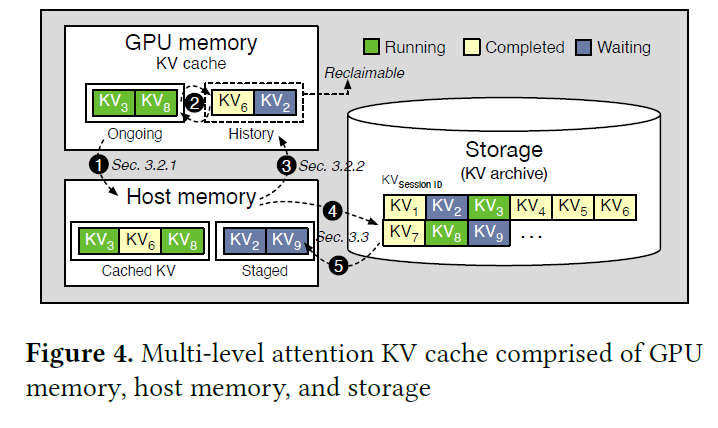
LLM Inference — Optimizing the KV Cache for High-Throughput, Long ...
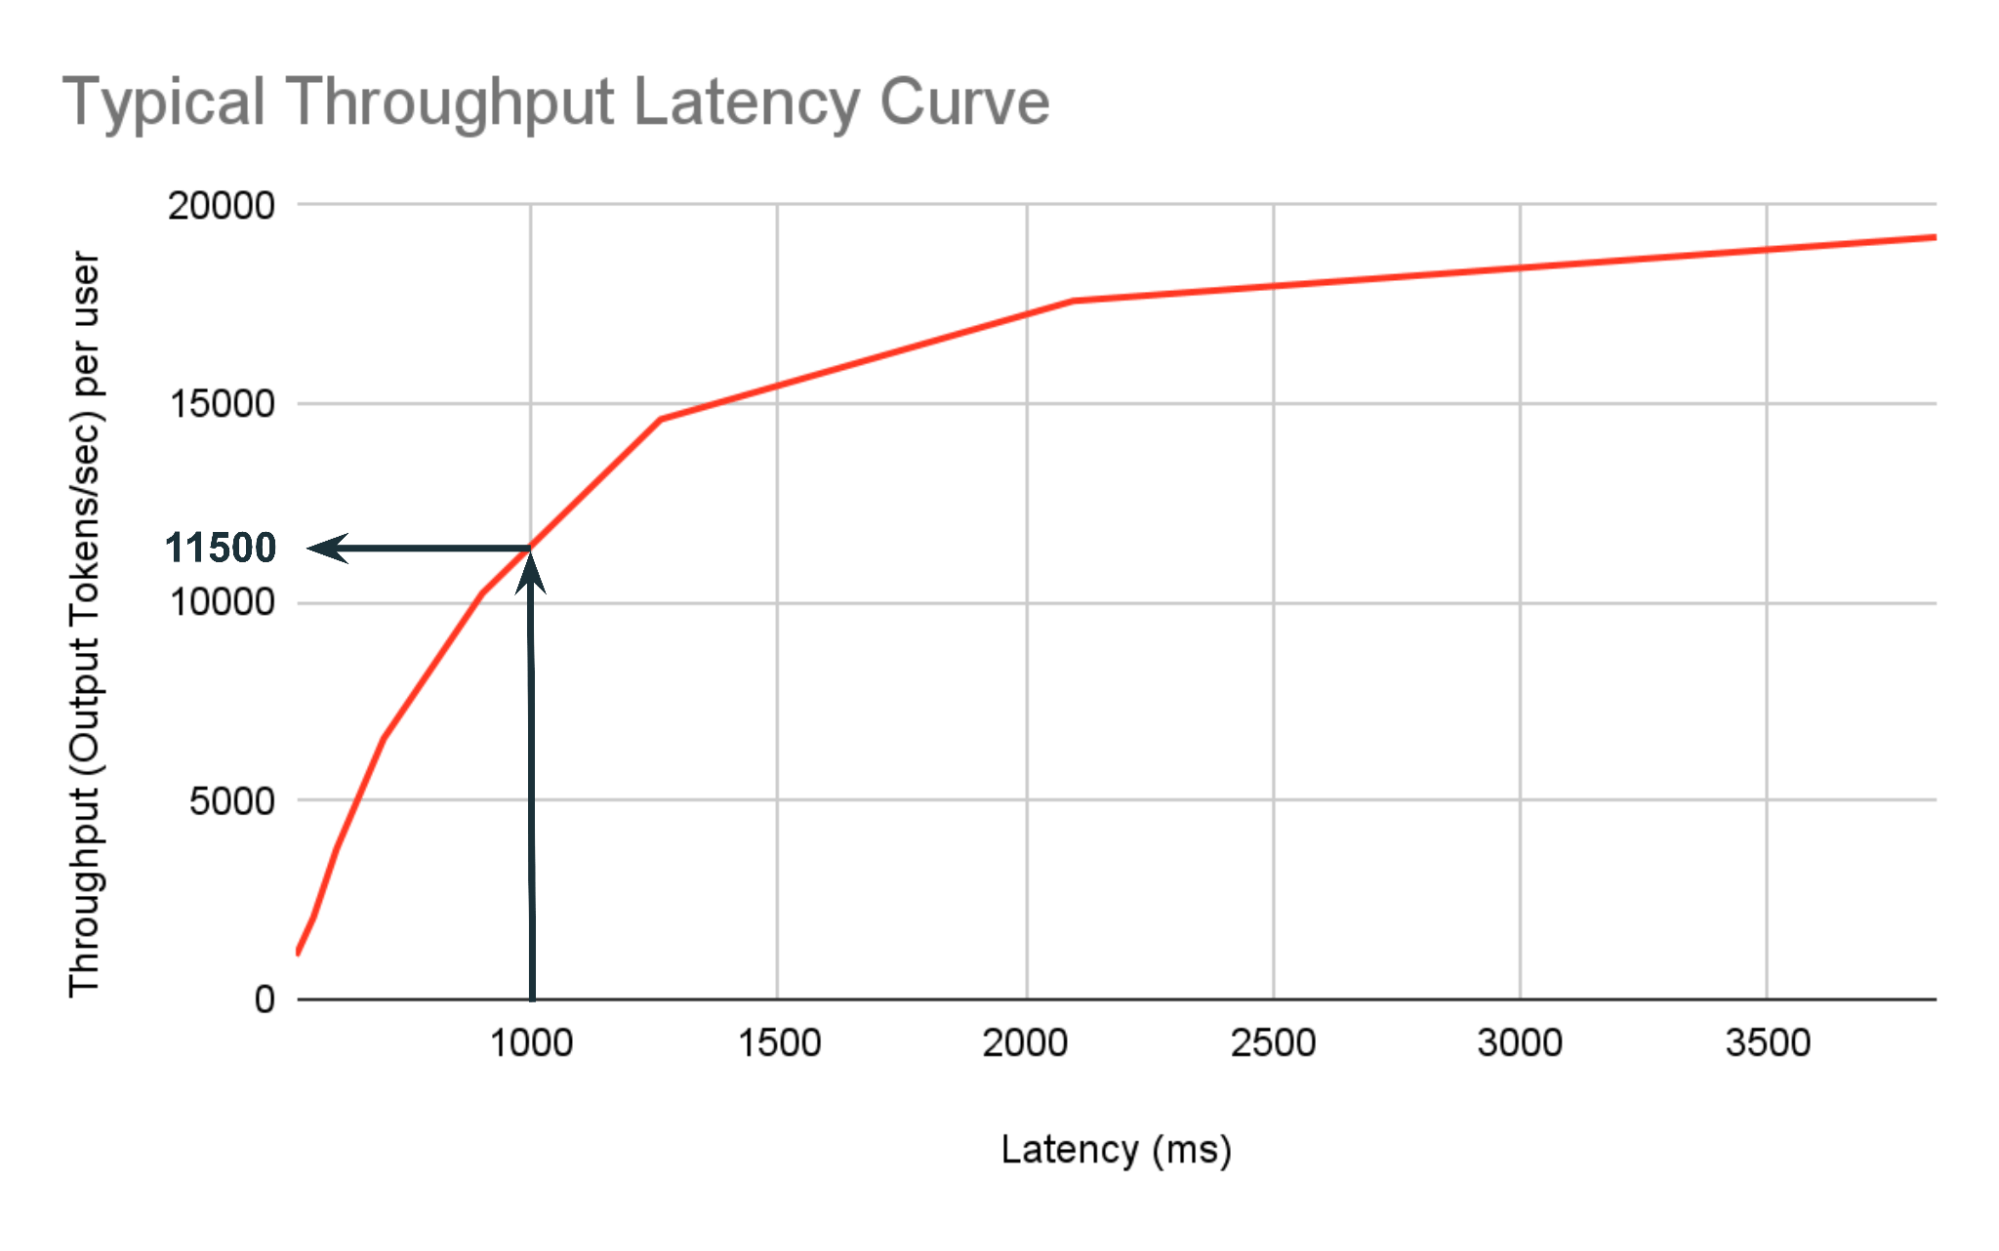
Fast, Secure and Reliable: Enterprise-grade LLM Inference | Databricks
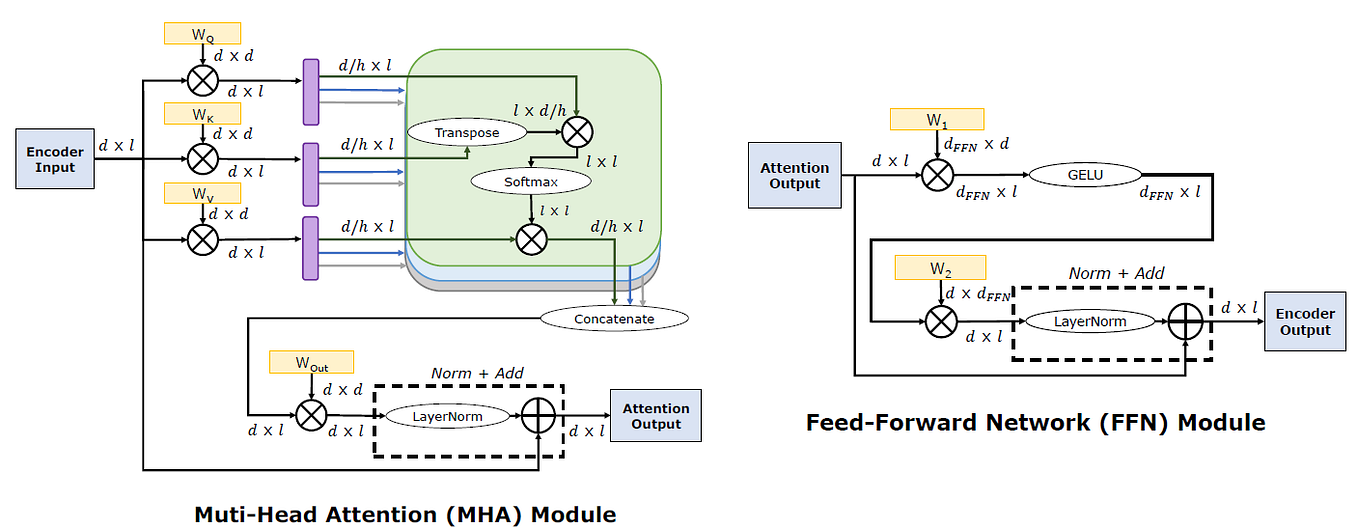
LLM Inference — Optimizing the KV Cache for High-Throughput, Long ...

[논문 리뷰] Seesaw: High-throughput LLM Inference via Model Re-sharding

Paper page - AccLLM: Accelerating Long-Context LLM Inference Via ...

LLM in a flash: Efficient LLM Inference with Limited Memory
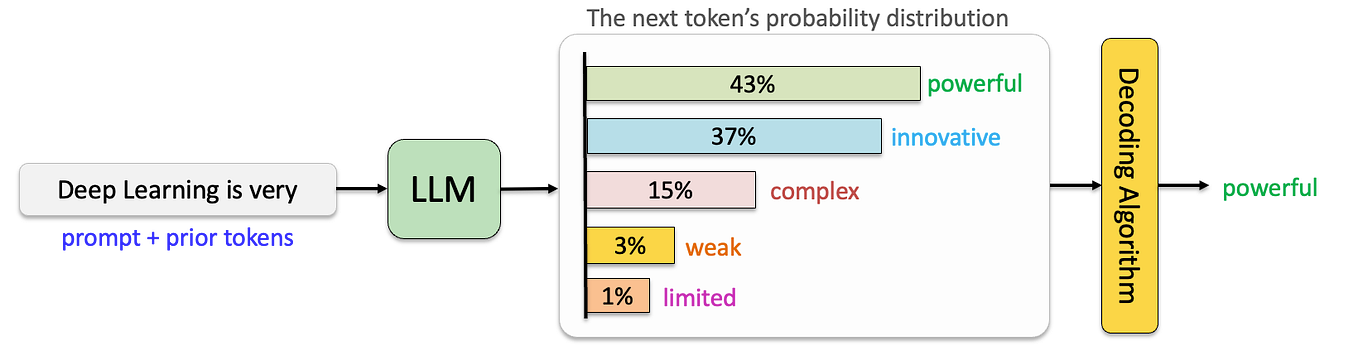
Deep Dive: Estimating Memory Consumption of LLMs for Inference and Fine ...

How continuous batching enables 23x throughput in LLM inference ...

Optimizing LLM Inference: Metrics, Memory, Math, and System | Burak ...

Efficient LLM Inference using Dynamic Input Pruning and Cache-Aware Masking
Advertisement Space (336x280)

CPU-GPU I/O-Aware LLM Inference Reduces Latency in GPUs by Optimizing ...
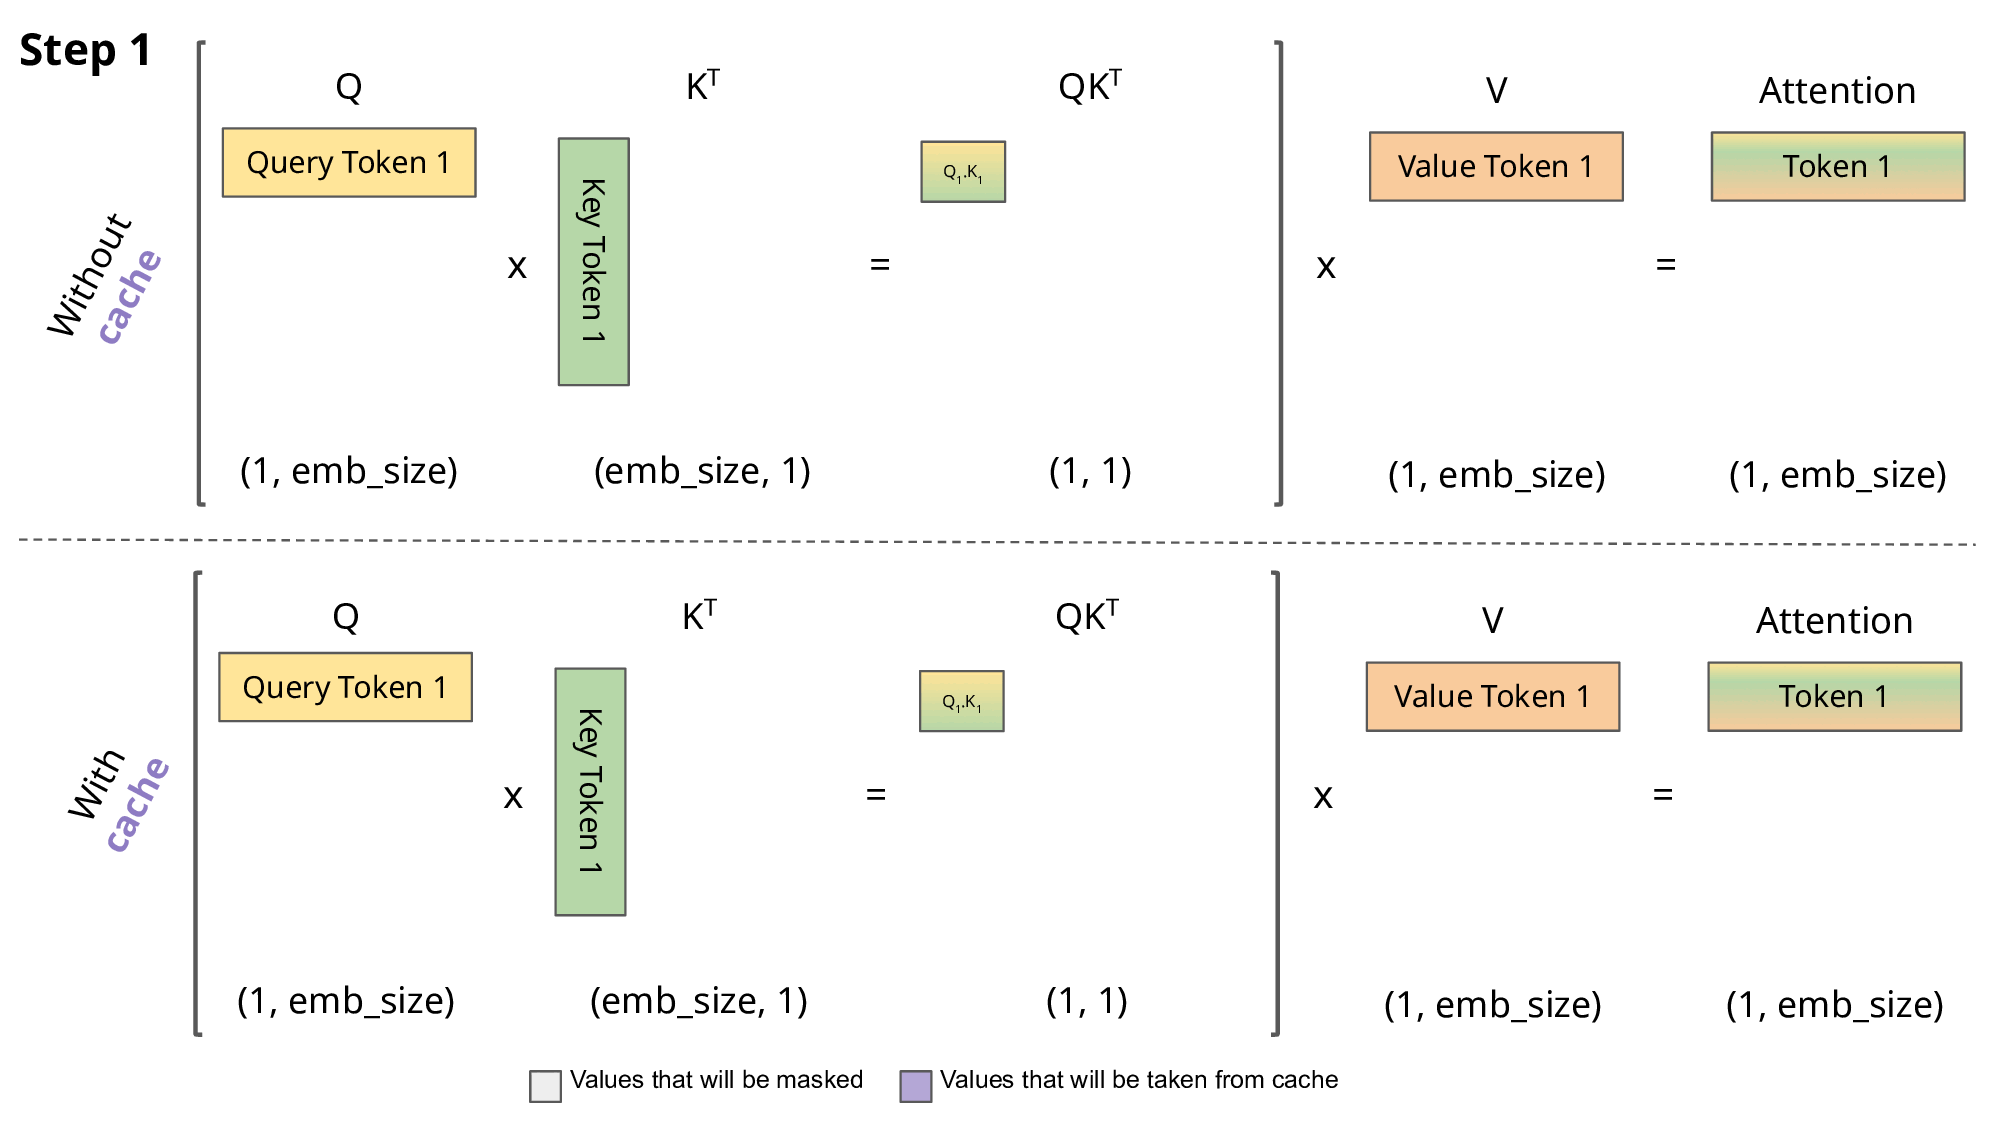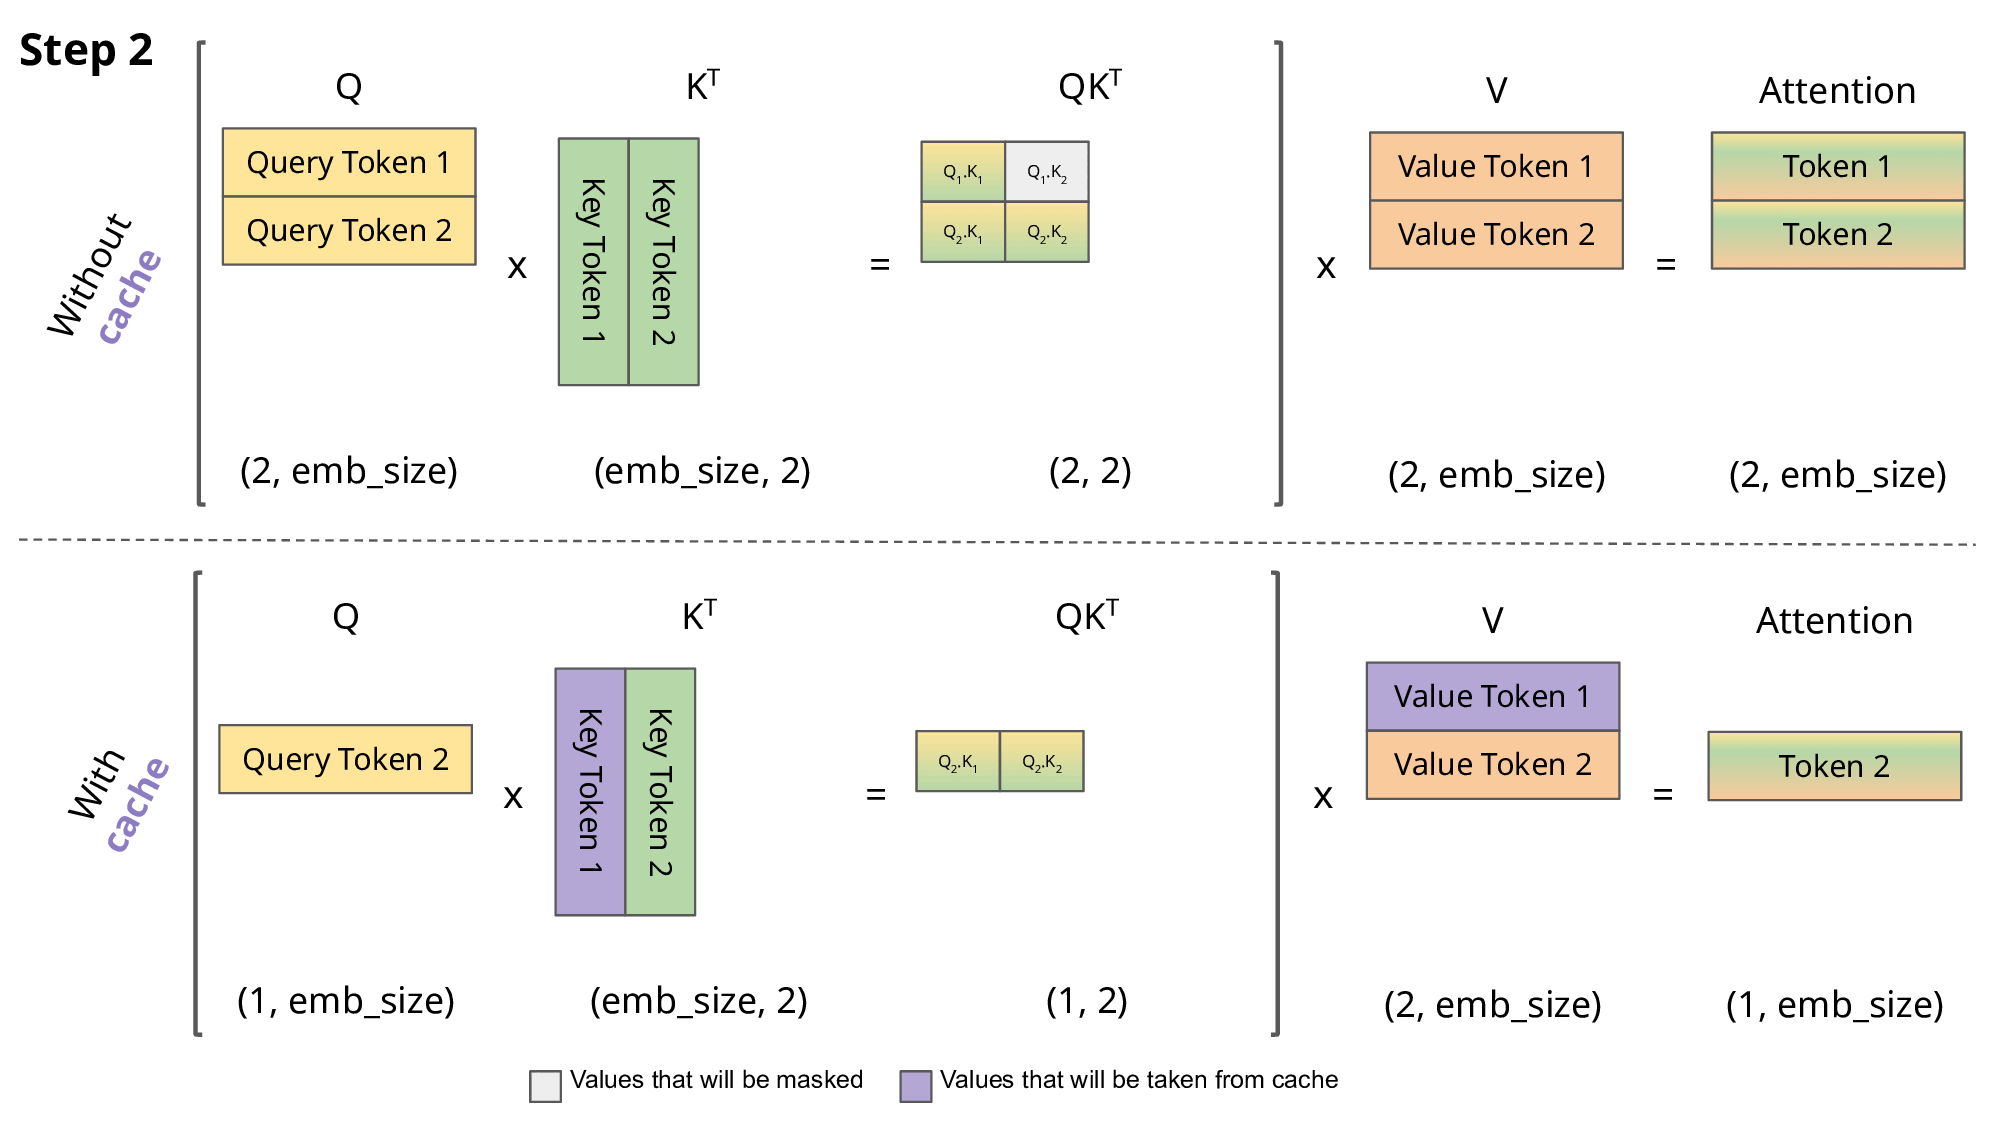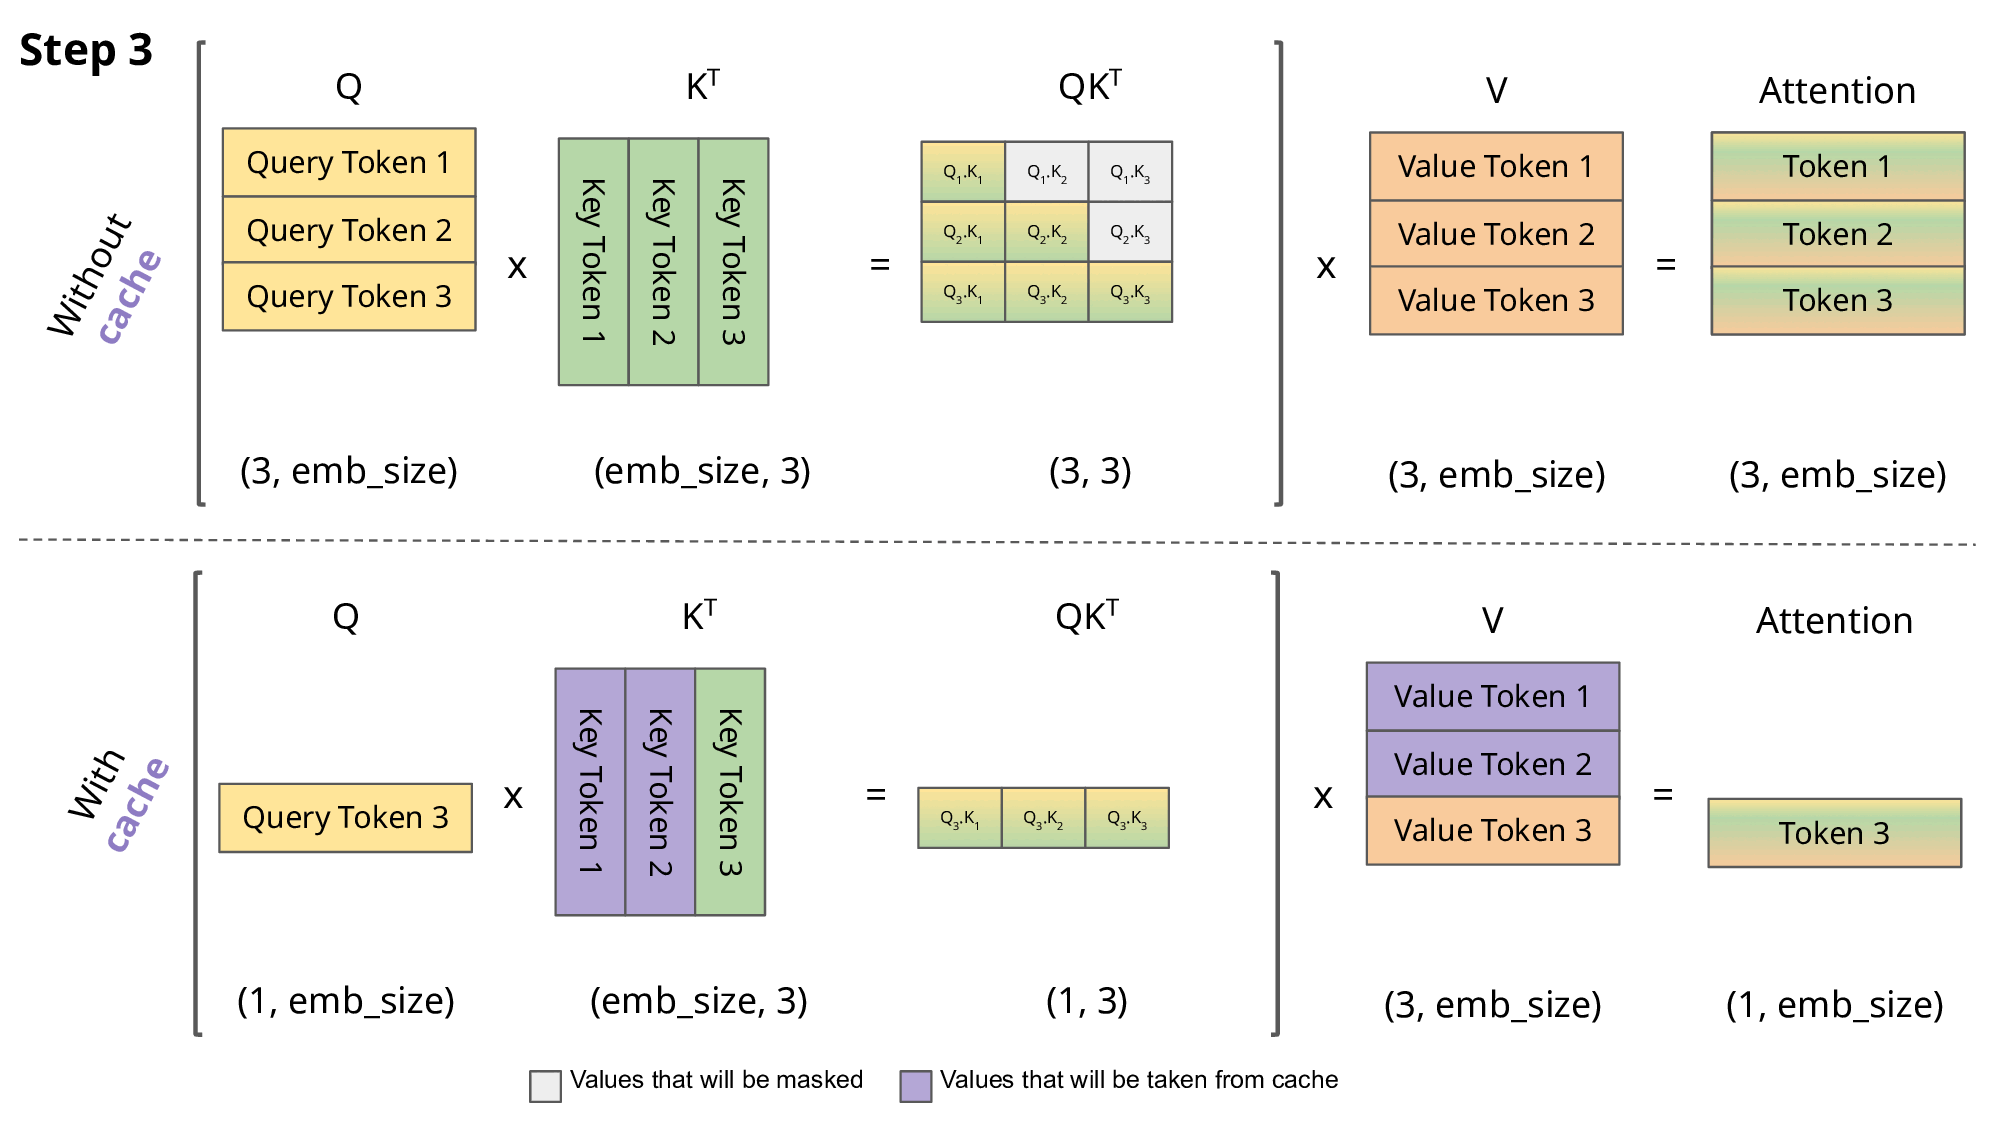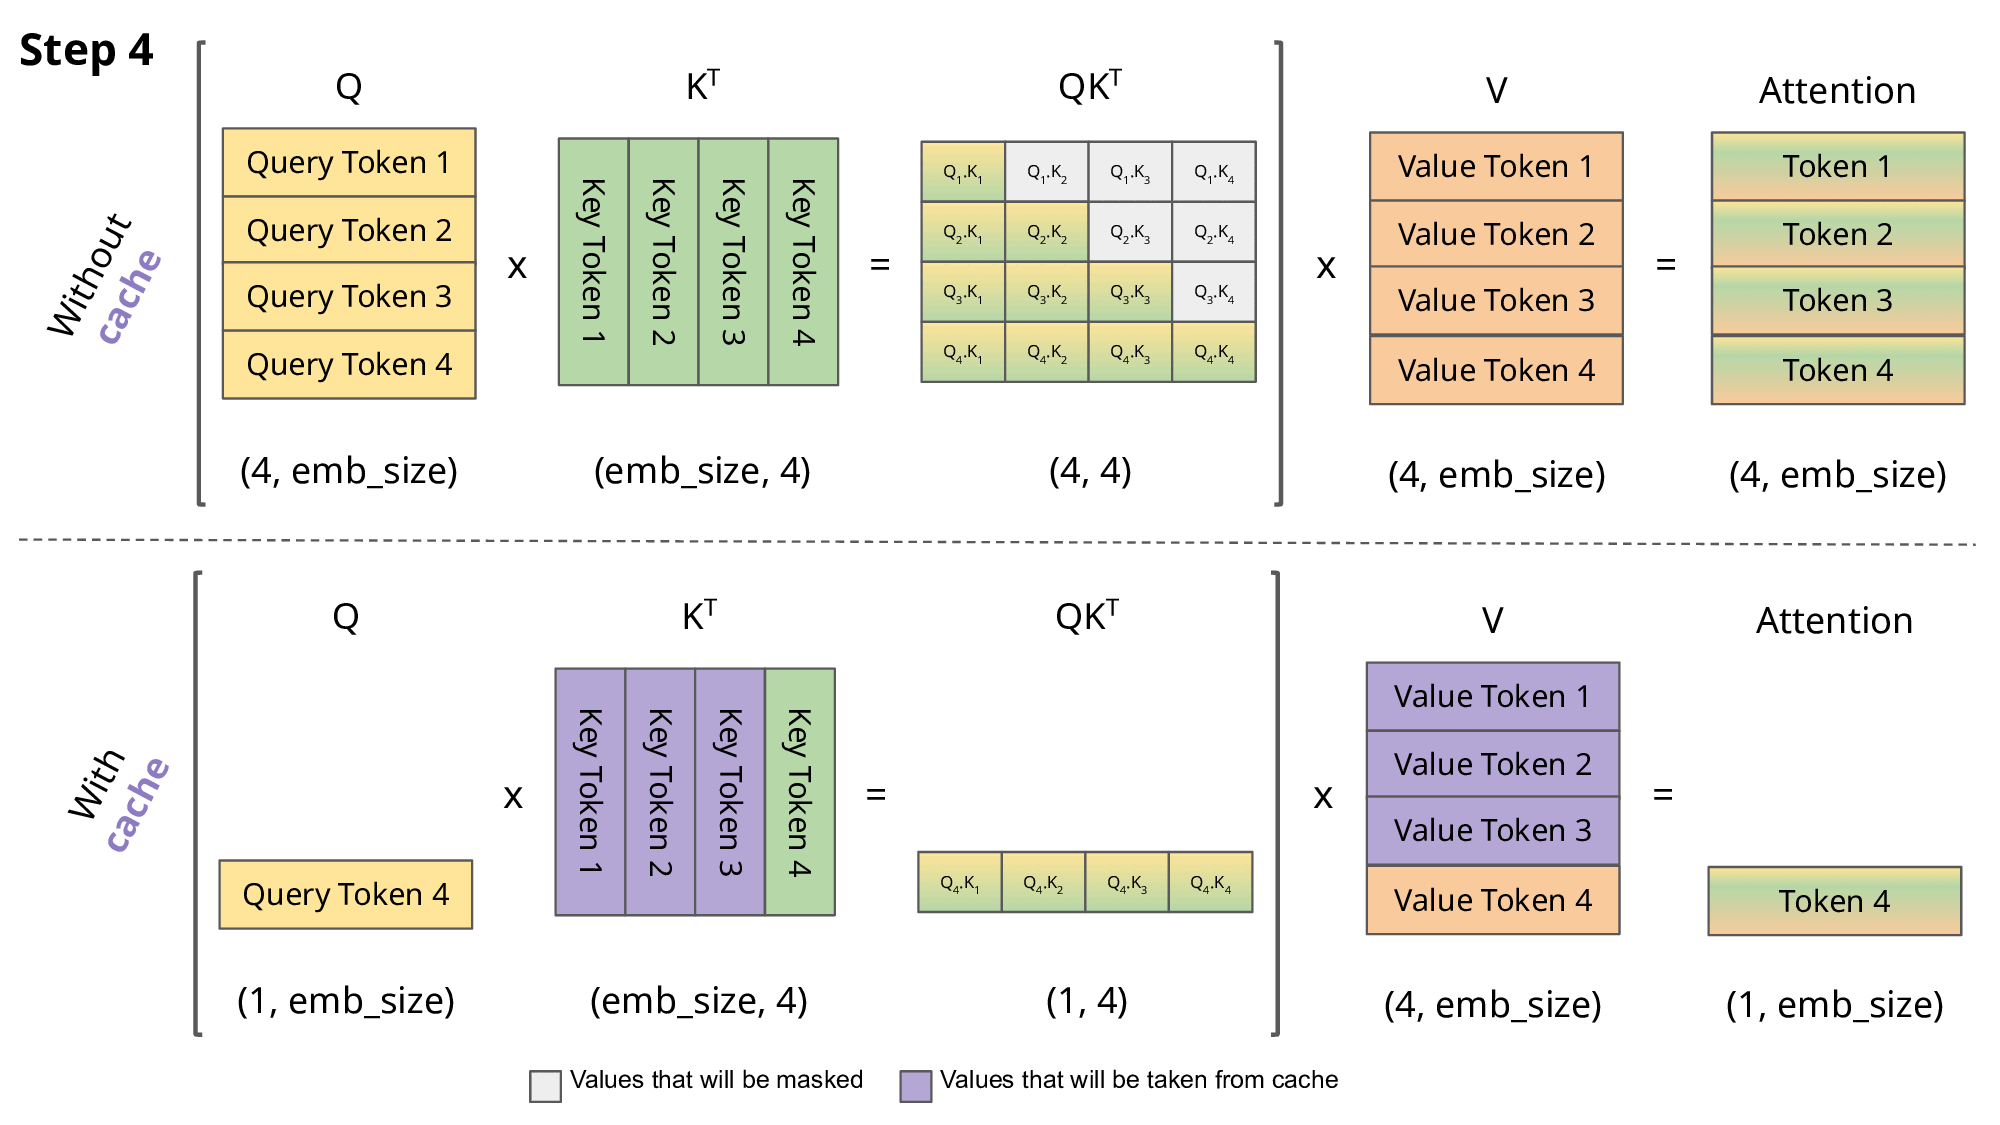
LLM Inference — Optimizing the KV Cache for High-Throughput, Long ...
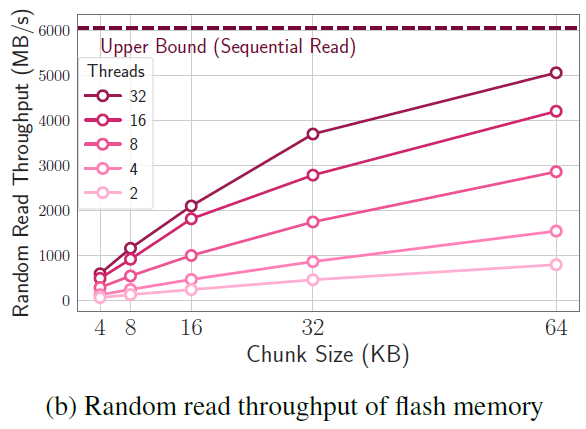
LLM in a flash: Efficient LLM Inference with Limited Memory
Estimating LLM Inference Memory Requirements

How continuous batching enables 23x throughput in LLM inference ...
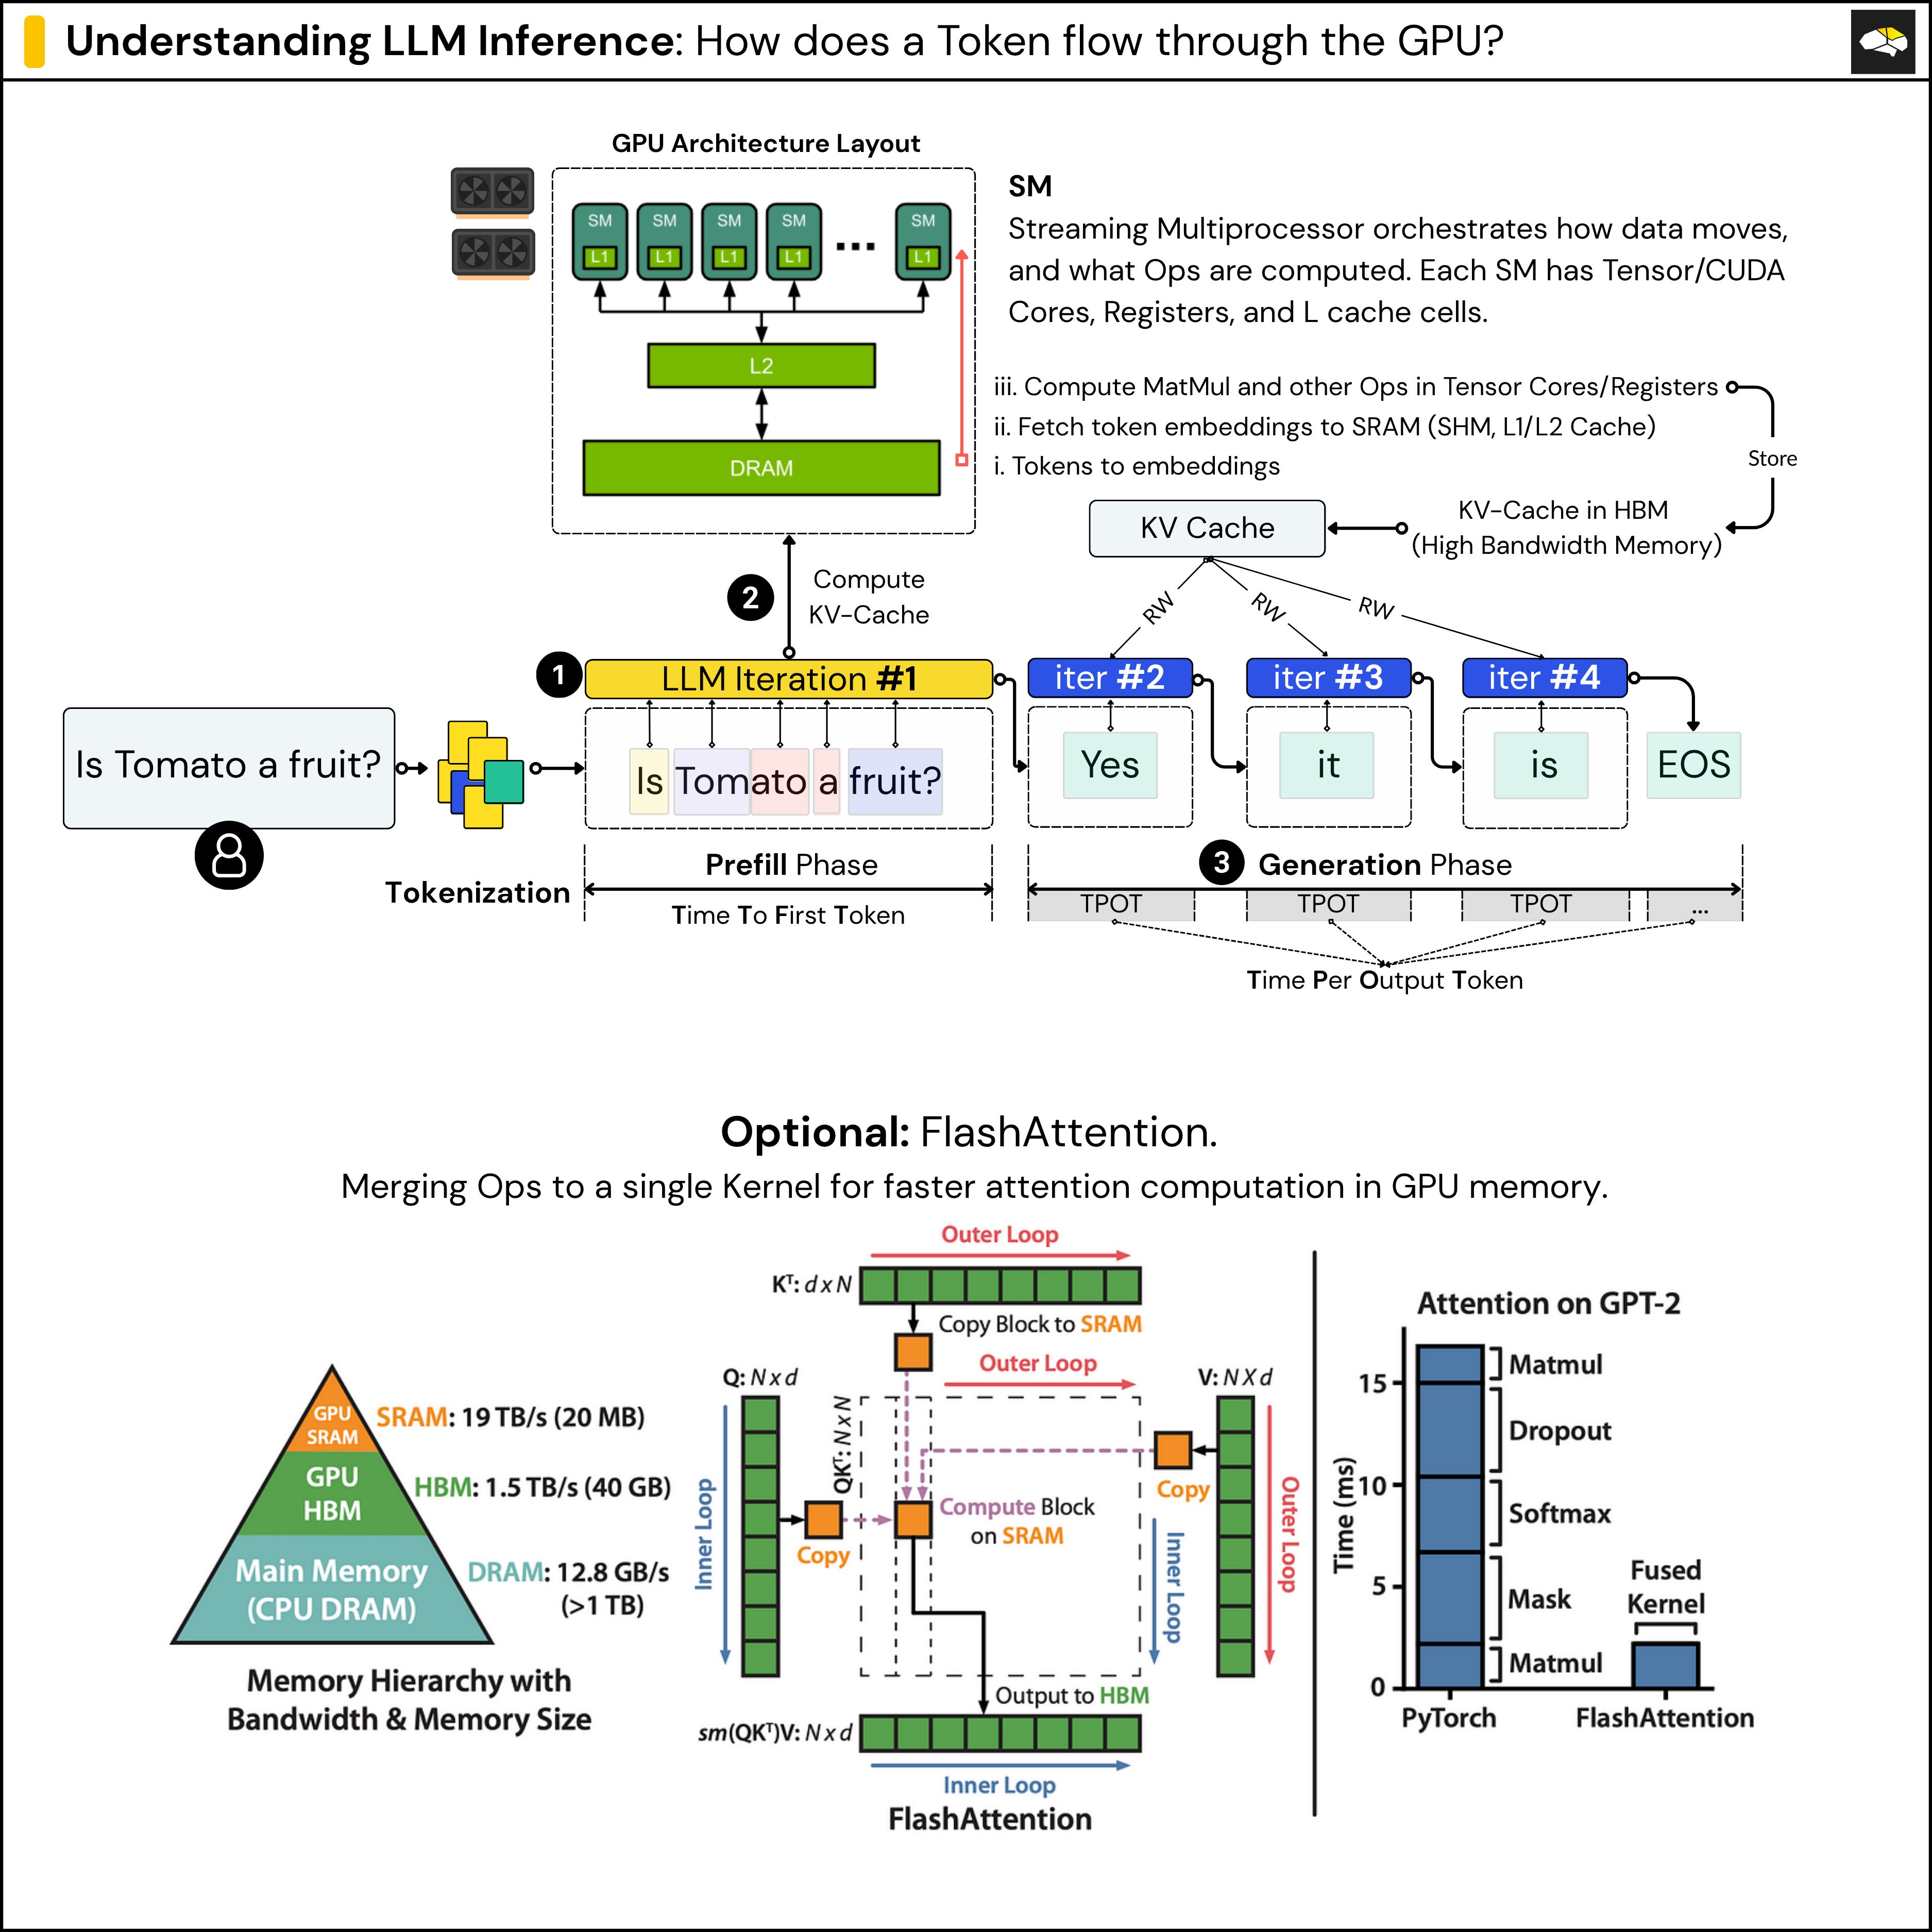
Understanding LLM Inference - by Alex Razvant