
Paper Page Meta Learning For Speeding Up Large Model Inference In

Paper page - Meta-Learning for Speeding Up Large Model Inference in ...

Meta-Learning for Speeding Up Large Model Inference in Decentralized ...

Paper page - OutRank: Speeding up AutoML-based Model Search for Large ...

Paper page - On Speeding Up Language Model Evaluation

Paper page - PRIMA.CPP: Speeding Up 70B-Scale LLM Inference on Low ...

Paper page - QuickSilver -- Speeding up LLM Inference through Dynamic ...

Meta learning for model optimization -- Knowlesys Open Source ...

Meta Reasoning for Large Language Models | AI Research Paper Details
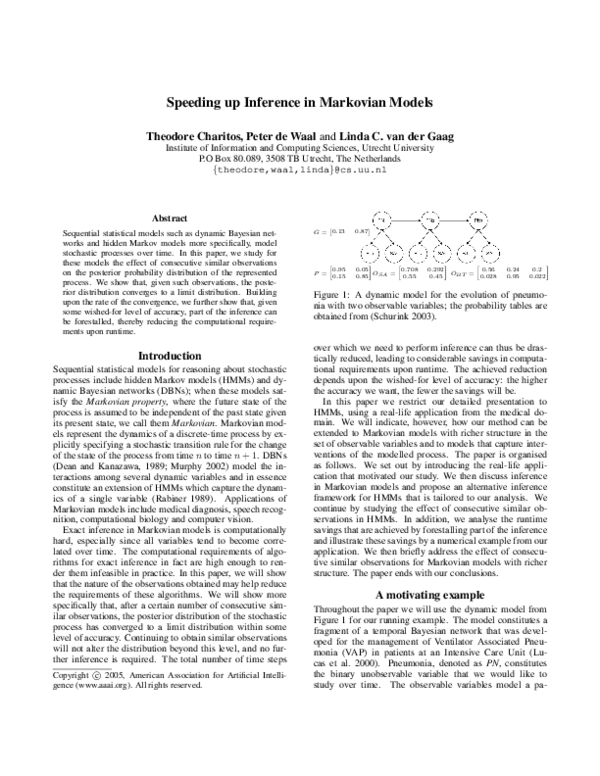
Speeding Up Inference in Markovian Models

Paper page - Scaling Smart: Accelerating Large Language Model Pre ...
Advertisement Space (300x250)

Figure 2 from A Hybrid Training Framework for Speeding up the Inference ...

Paper page - SKIP: Skill-Localized Prompt Tuning for Inference Speed ...

Speeding up transformer training and inference by increasing model size ...

Speeding up Model Loading with fastsafetensors | AI Research Paper Details
Speeding up Deep Learning training and inference | PPTX
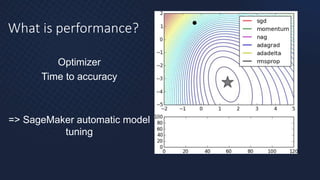
Speeding up Deep Learning training and inference | PPTX

Table 2 Empirical results for speeding up inference from a T5 XXL 11B ...
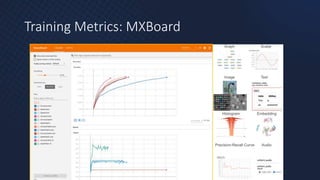
Speeding up Deep Learning training and inference | PPTX

Paper page - KiloNeRF: Speeding up Neural Radiance Fields with ...
Optimum-NVIDIA Library for Speeding Up LLM Inference
Advertisement Space (336x280)
Meta Learning for Model Optimization: A Comprehensive Guide | stAI tuned
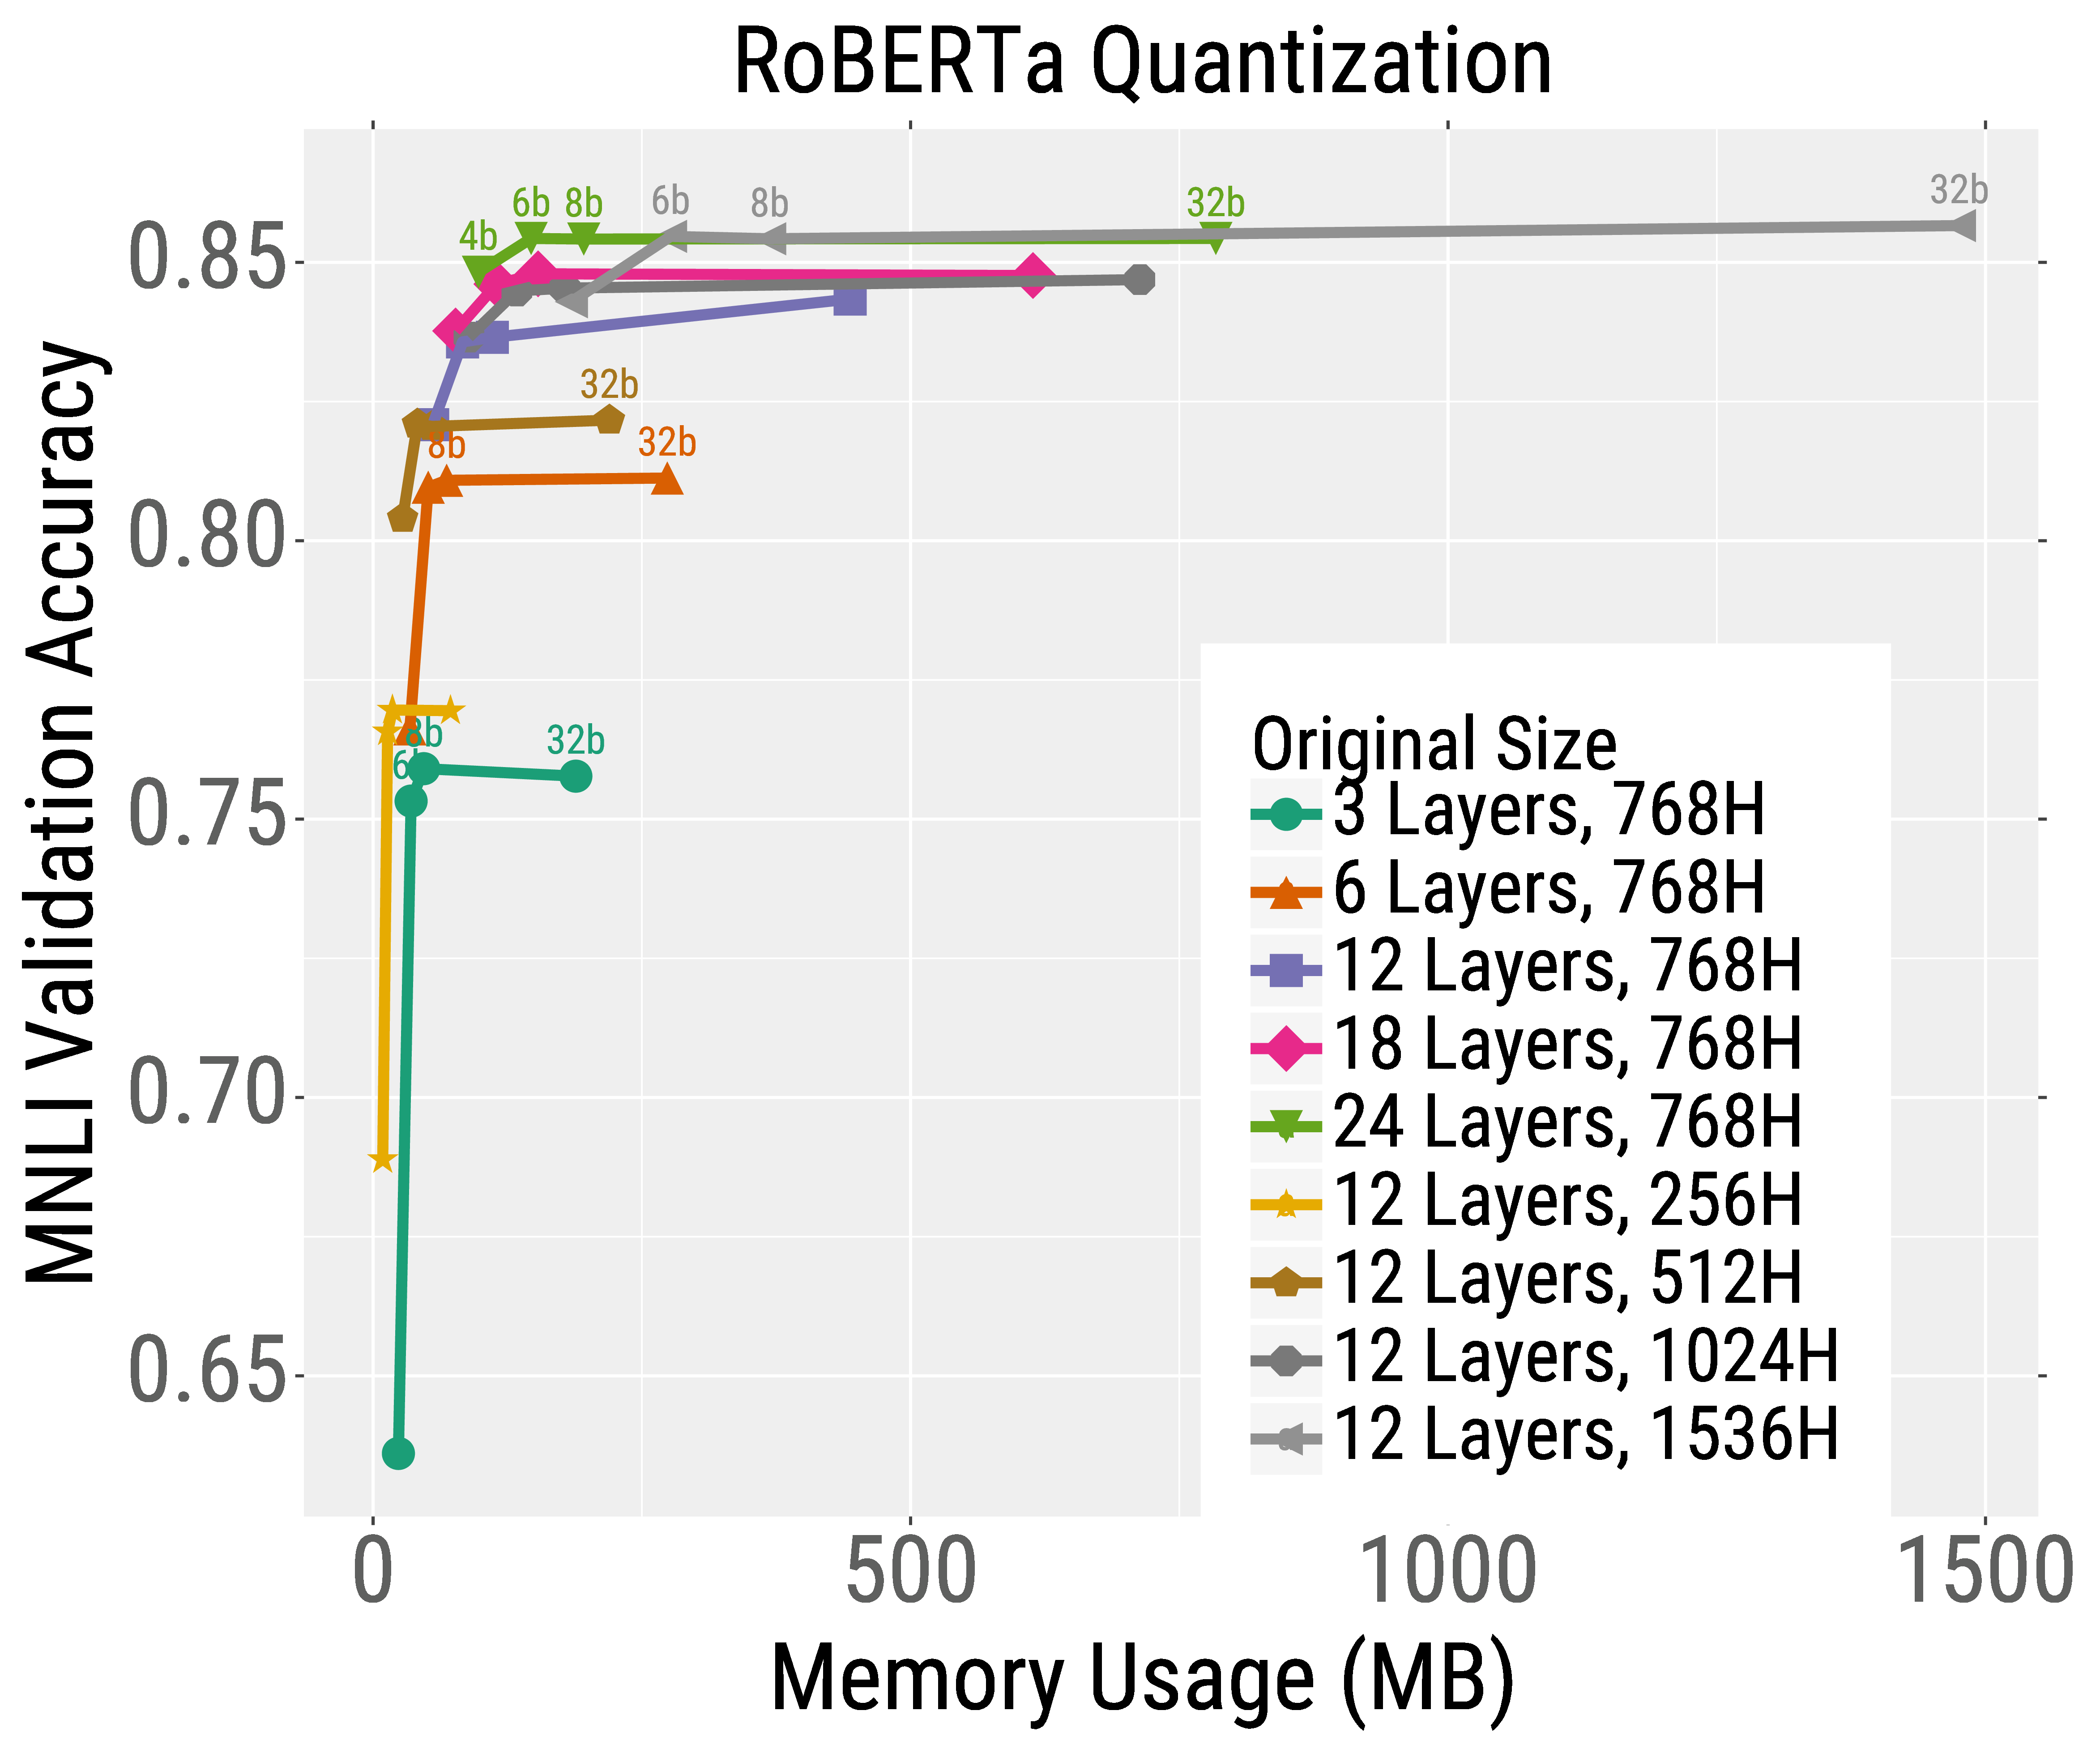
Speeding up transformer training and inference by increasing model size ...

On Speeding Up Language Model Evaluation | AI Research Paper Details

Speeding up Deep Learning training and inference | PPTX

Paper page - LLaDA2.1: Speeding Up Text Diffusion via Token Editing

Paper page - Speeding Up the NSGA-II via Dynamic Population Sizes

Figure 2 from Massive Editing for Large Language Models via Meta ...

SuffixDecoding: A Model-Free Approach to Speeding Up Large Language ...

PRIMA.CPP: Speeding Up 70B-Scale LLM Inference on Low-Resource Everyday ...

(PDF) SuffixDecoding: A Model-Free Approach to Speeding Up Large ...
Advertisement Space (336x280)

Paper page - Internalizing Meta-Experience into Memory for Guided ...
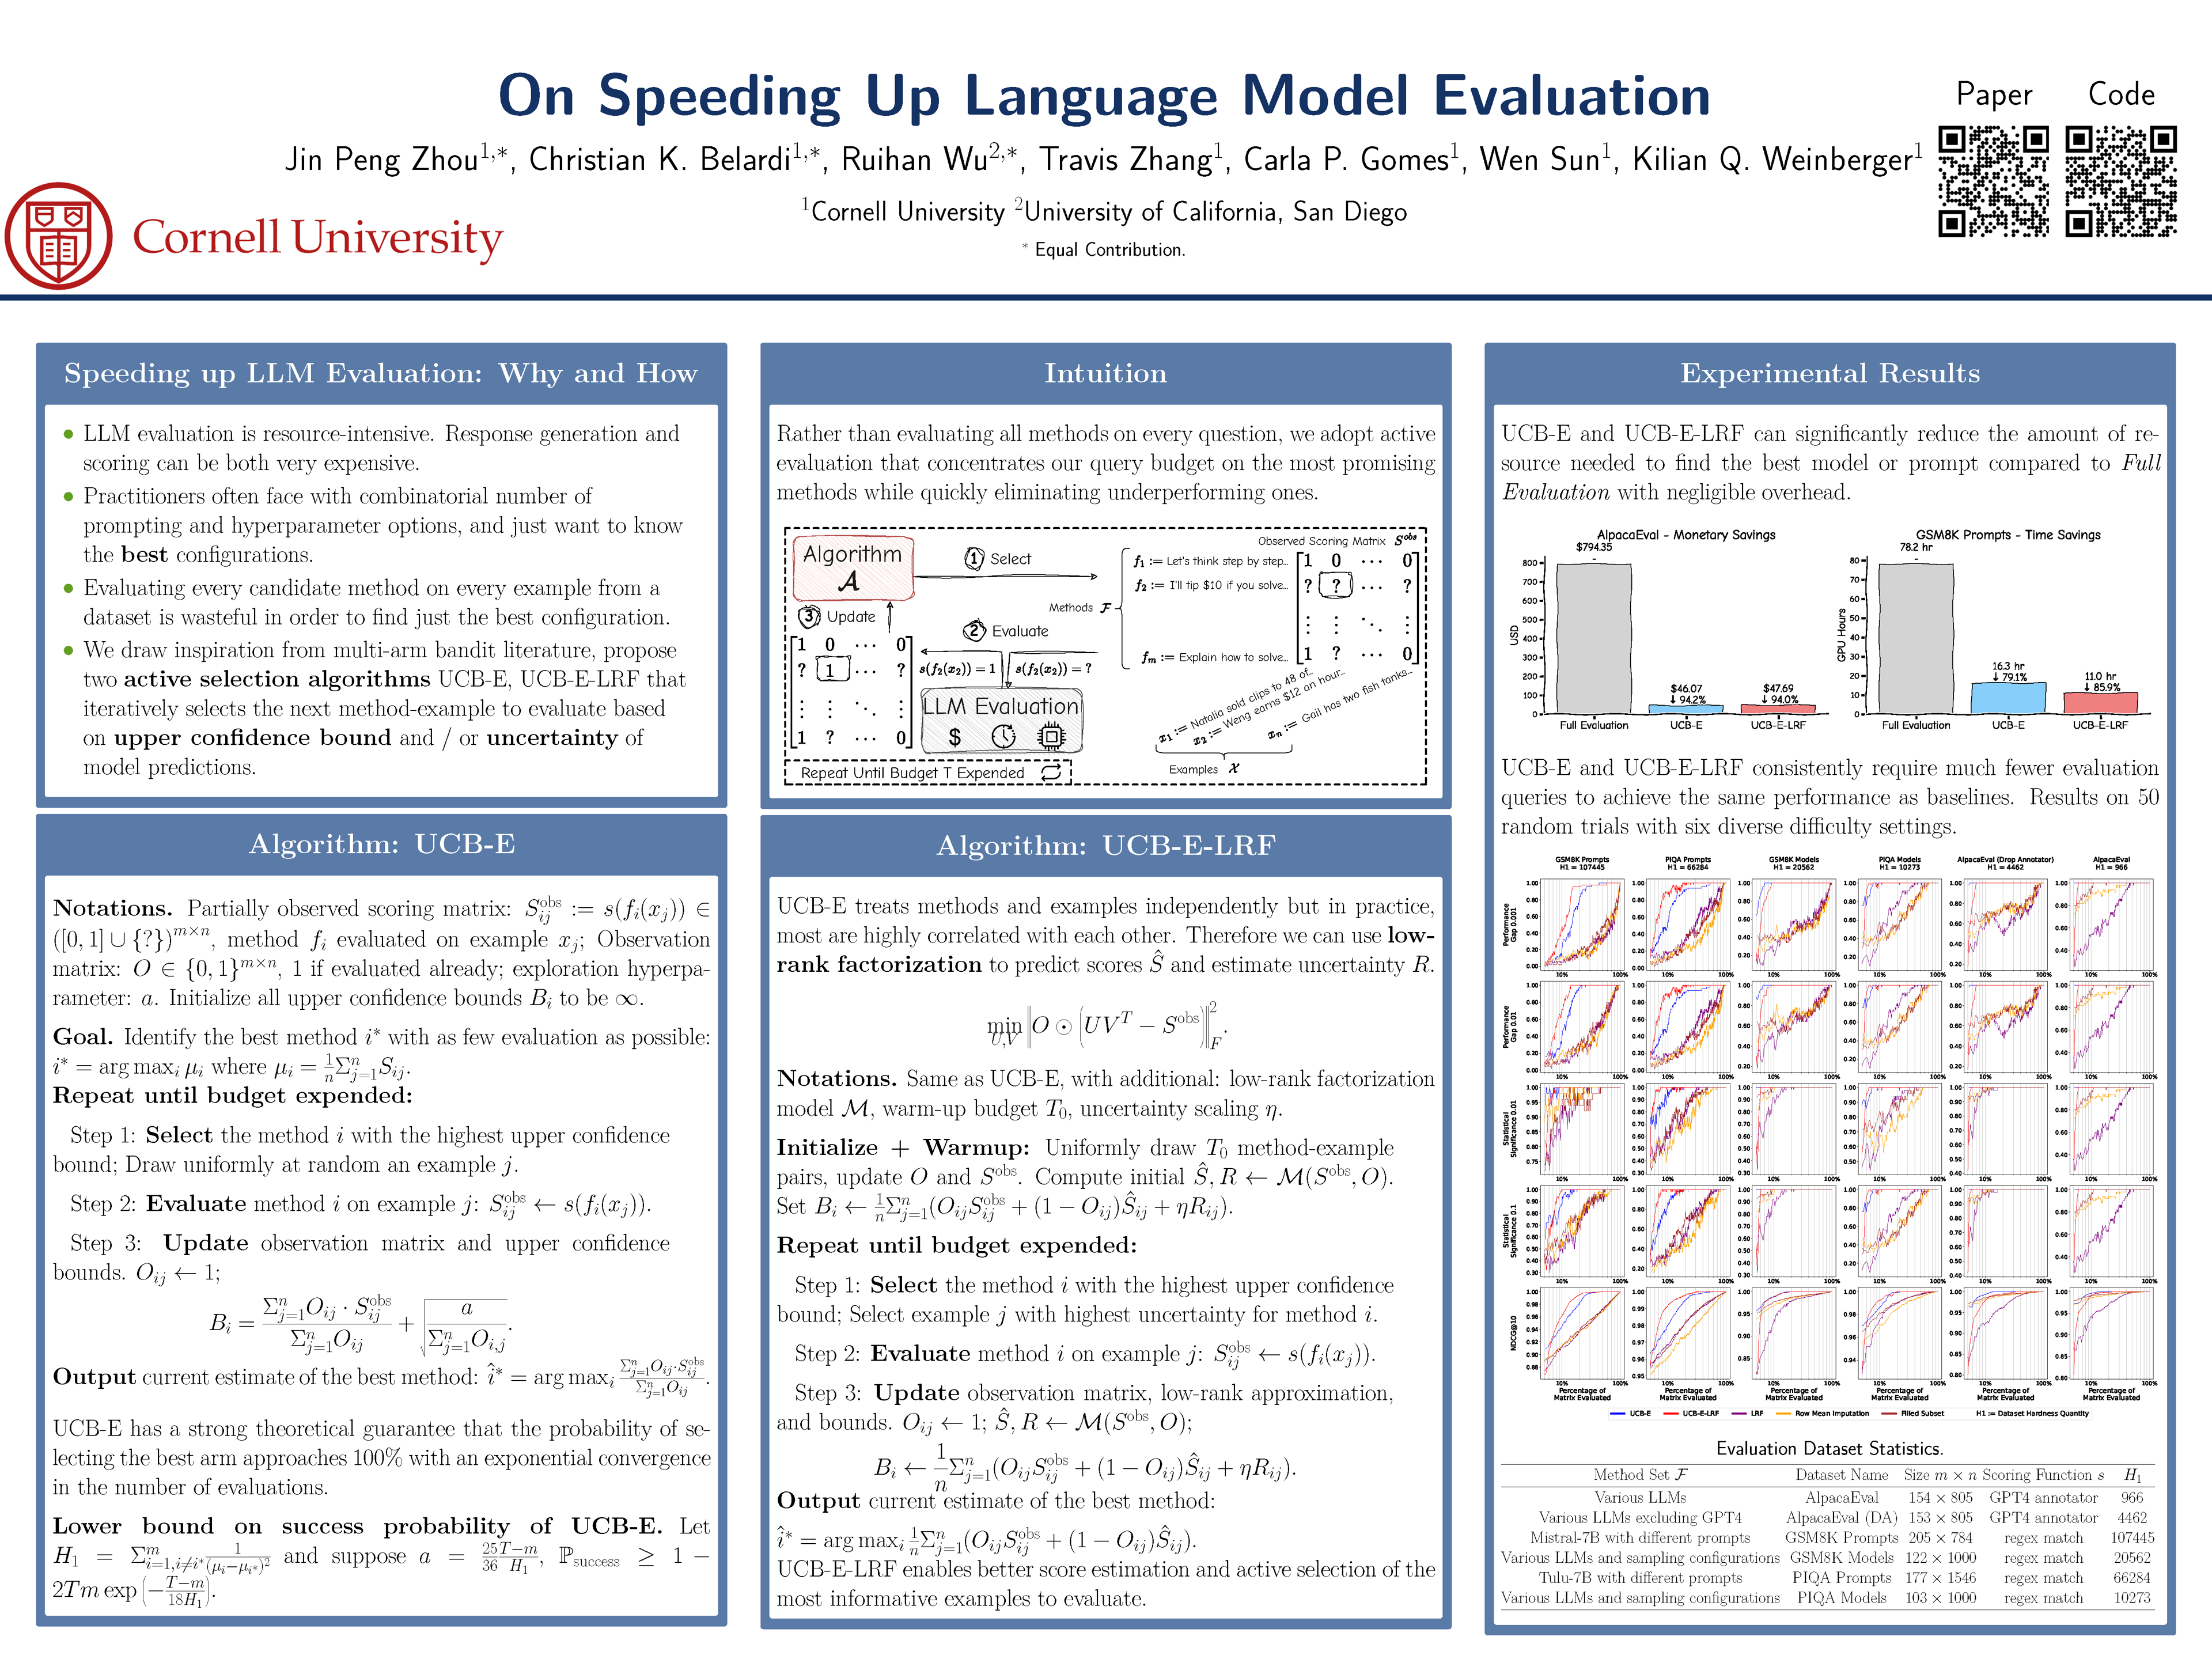
ICLR Poster On Speeding Up Language Model Evaluation

Speeding Up Inference with OpenAI Models: Optimization Techniques
LayerSkip: A Game-Changer for Accelerating Inference in LLMs - Fusion Chat

Learning to Diagnose: Meta-Learning for Efficient Adaptation in Few ...

Inference Performance Optimization for Large Language Models on CPUs ...