
Paper Page Primacpp Speeding Up 70b Scale Llm Inference On Low

Paper page - PRIMA.CPP: Speeding Up 70B-Scale LLM Inference on Low ...
Paper page - PRIMA.CPP: Speeding Up 70B-Scale LLM Inference on Low ...

Paper page - QuickSilver -- Speeding up LLM Inference through Dynamic ...

PRIMA.CPP: Speeding Up 70B-Scale LLM Inference on Low-Resource Everyday ...

Paper page - Meta-Learning for Speeding Up Large Model Inference in ...

PRIMA.CPP: Speeding Up 70B-Scale LLM Inference on Low-Resource Everyday ...
Discussion on "Optimum-NVIDIA Library for Speeding Up LLM Inference ...
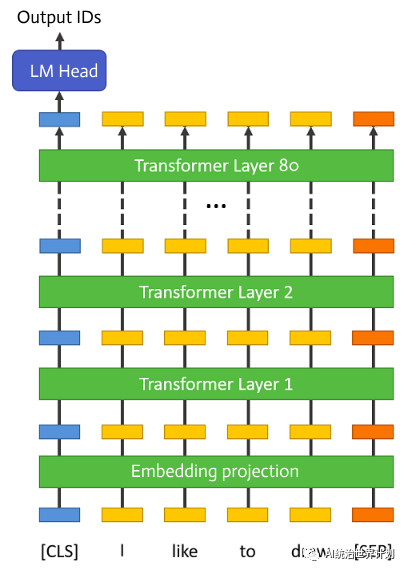
Unbelievable! Run 70B LLM Inference on a Single 4GB GPU with This NEW ...

Paper page - Scalify: scale propagation for efficient low-precision LLM ...

Paper page - TPI-LLM: Serving 70B-scale LLMs Efficiently on Low ...
Advertisement Space (300x250)
Speeding up LLM inference using SparQ Attention & llama.cpp - Graphcore ...

Speeding up LLM inference using SparQ Attention & llama.cpp - Graphcore ...

Paper page - PARD: Accelerating LLM Inference with Low-Cost PARallel ...

Speeding Up LLM Inference Techniques | PDF | Graphics Processing Unit ...

Unbelievable! Run 70B LLM Inference on a Single 4GB GPU with This NEW ...

Paper page - xLSTM 7B: A Recurrent LLM for Fast and Efficient Inference
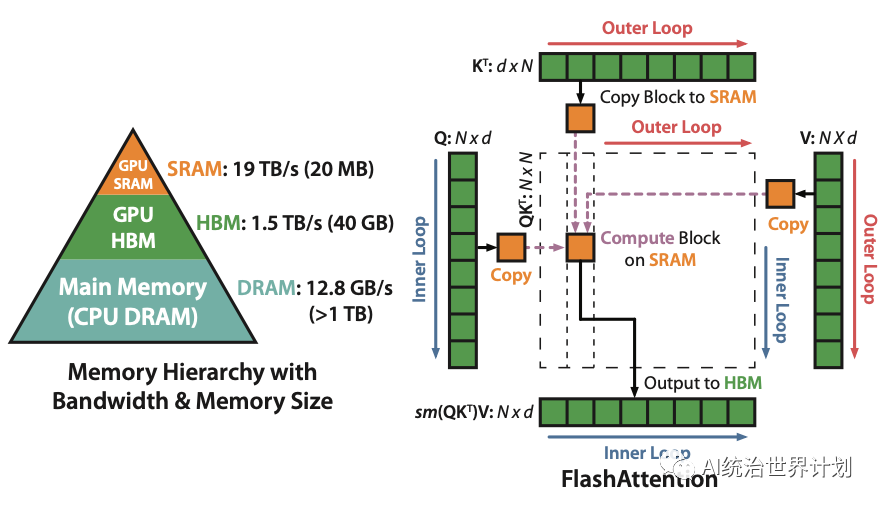
Unbelievable! Run 70B LLM Inference on a Single 4GB GPU with This NEW ...
Optimum-NVIDIA Library for Speeding Up LLM Inference

Paper page - GaLore 2: Large-Scale LLM Pre-Training by Gradient Low ...

Paper page - An Investigation of FP8 Across Accelerators for LLM Inference
Advertisement Space (336x280)

Speeding Up LLM Inference : Speculative Decoding Explained in the ...

Speeding up LLM inference by using model quantizat... - Databricks ...
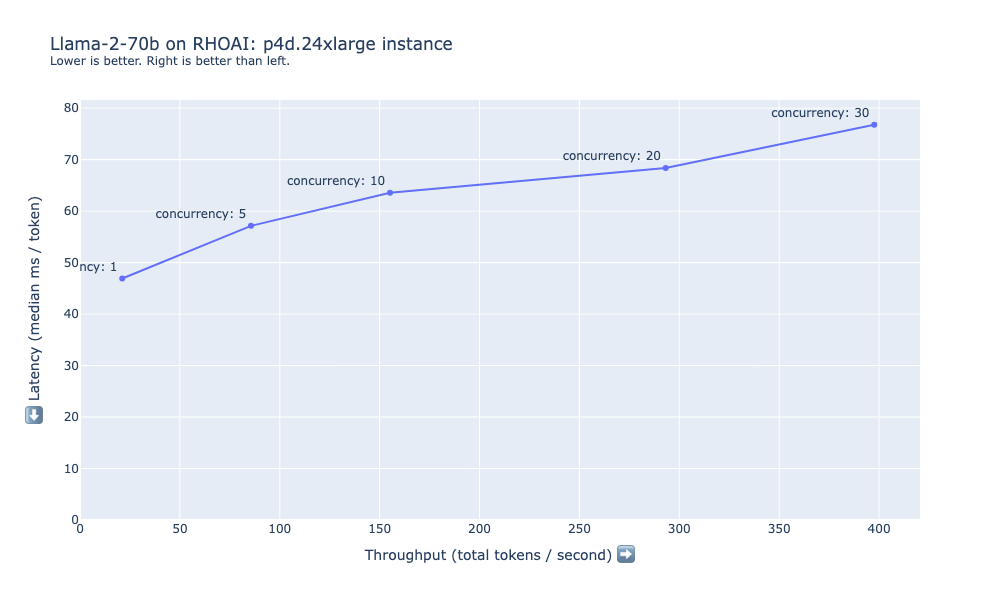
Evaluating LLM inference performance on Red Hat OpenShift AI

Paper page - Scaling LLM Test-Time Compute Optimally can be More ...
Reliable LLM Inference at Scale — Databricks Blog — brickster.ai

Paper page - Scaling up Multi-Turn Off-Policy RL and Multi-Agent Tree ...

Paper page - Low-rank Optimization Trajectories Modeling for LLM RLVR ...

Paper page - 70% Size, 100% Accuracy: Lossless LLM Compression for ...

Paper page - Cambricon-LLM: A Chiplet-Based Hybrid Architecture for On ...
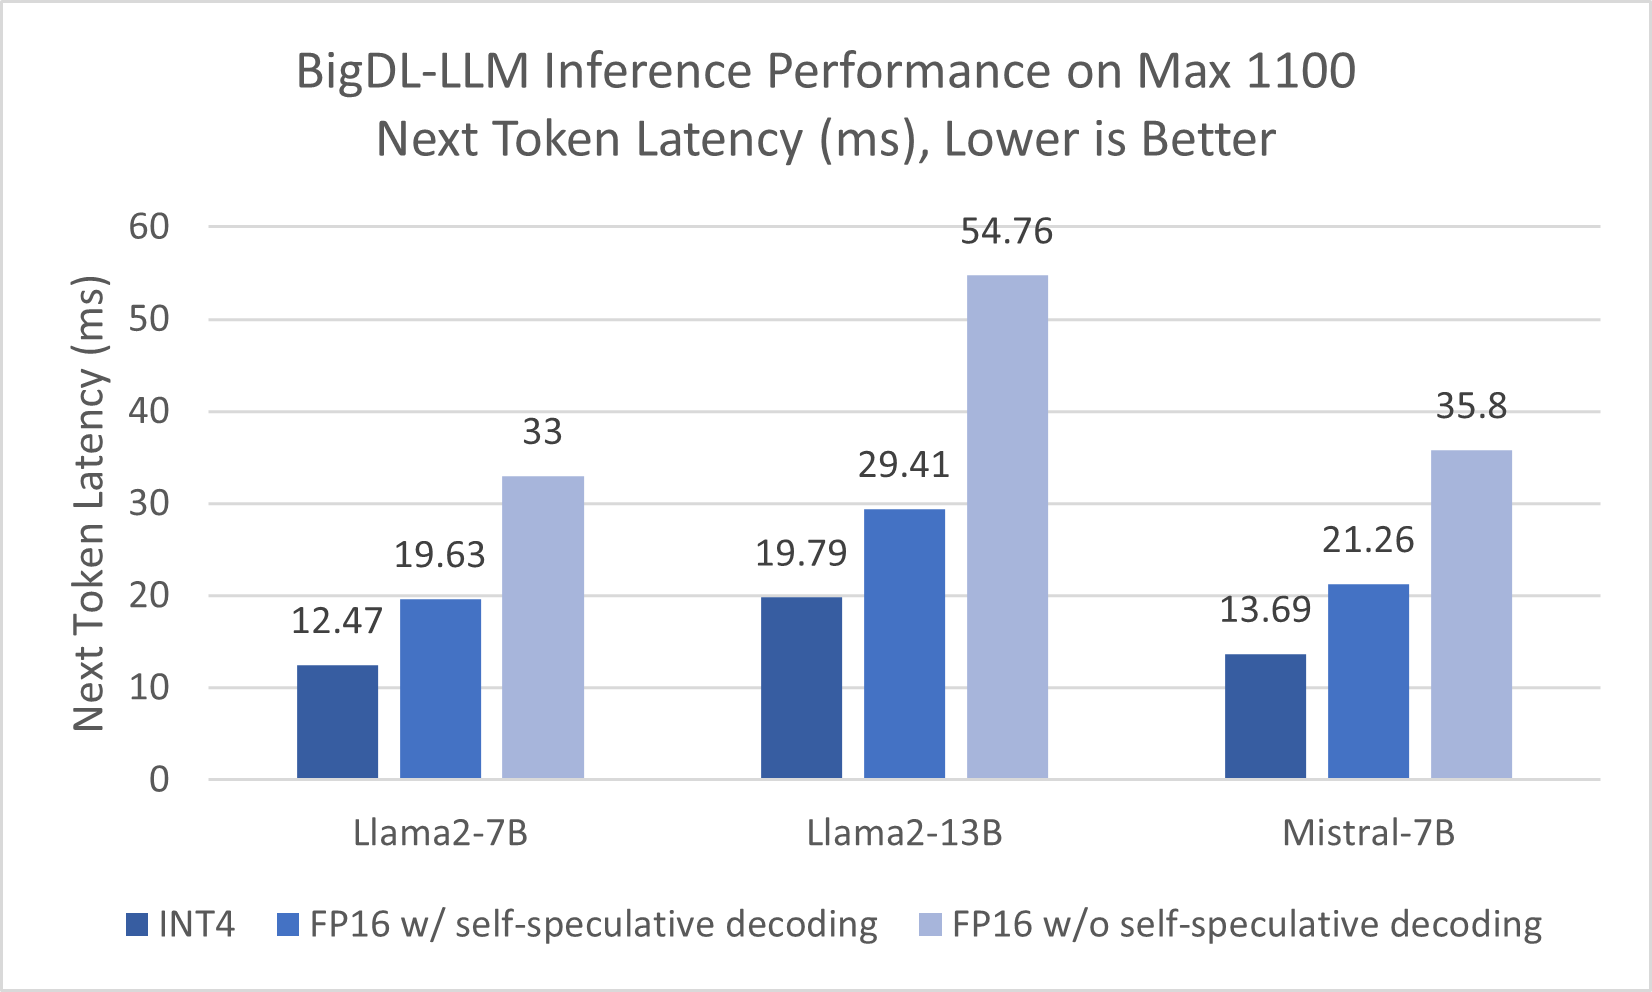
Accelerating LLM Inference on Intel Data Center GPUs using BigDL LLM
Advertisement Space (336x280)

Optimal Singular Damage: Efficient LLM Inference in Low Storage Regimes ...

[논문 리뷰] Optimal Singular Damage: Efficient LLM Inference in Low Storage ...
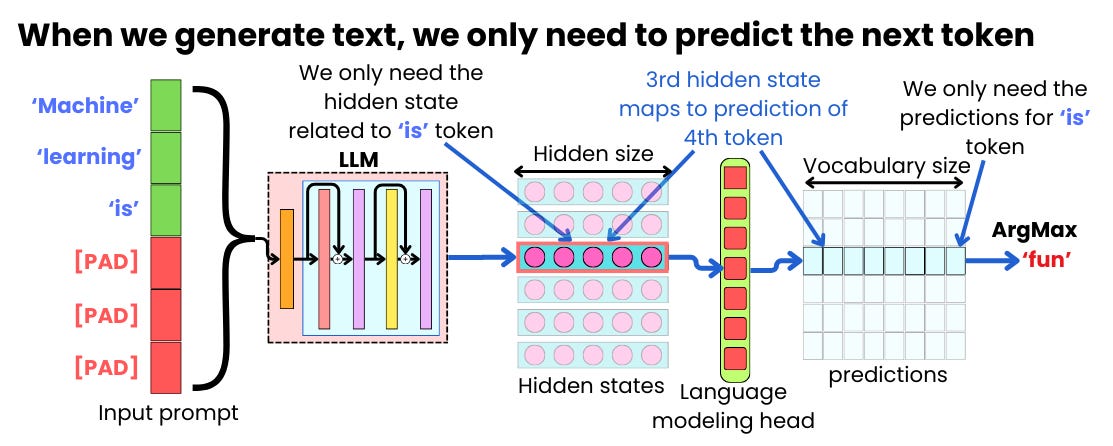
How to Scale LLM Inference - by Damien Benveniste

Paper page - When LLM Meets Time Series: Can LLMs Perform Multi-Step ...

Intel Breakthrough: 1-2 Bit LLM Inference for AI PCs & Edge - Up to 7x ...

Paper page - LUT-LLM: Efficient Large Language Model Inference with ...