
Paper Page Vision Foundation Models As Effective Visual Tokenizers

Paper page - Vision Foundation Models as Effective Visual Tokenizers ...

NeurIPS Poster Vision Foundation Models as Effective Visual Tokenizers ...
Vision Foundation Models as Effective Visual Tokenizers for ...

(PDF) Vision Foundation Models as Effective Visual Tokenizers for ...

Paper page - Vision Foundation Models Can Be Good Tokenizers for Latent ...

Paper page - Do computer vision foundation models learn the low-level ...

Paper page - EffoVPR: Effective Foundation Model Utilization for Visual ...
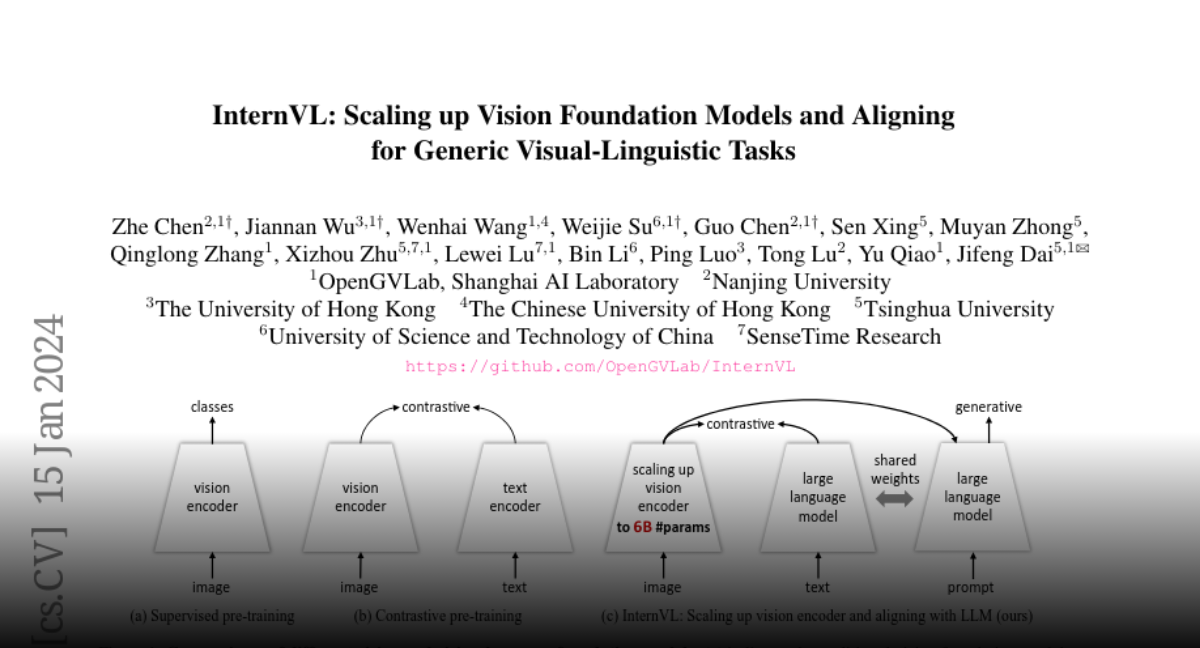
Paper page - InternVL: Scaling up Vision Foundation Models and Aligning ...
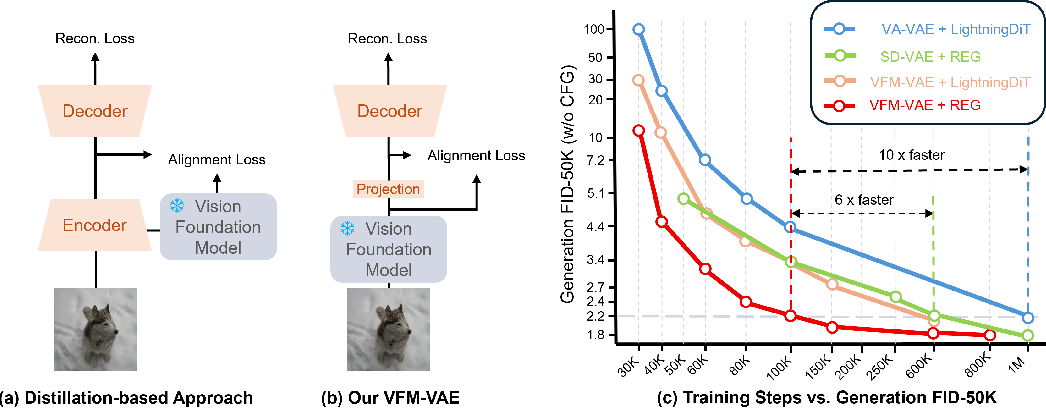
Figure 1 from Vision Foundation Models Can Be Good Tokenizers for ...

Aligning Visual Foundation Encoders to Tokenizers for Diffusion Models ...
Advertisement Space (300x250)

VFM-VAE: Vision Foundation Models Can Be Good Tokenizers for Latent ...

Paper page - What Makes for Good Visual Tokenizers for Large Language ...

Vision Foundation Models Can Be Good Tokenizers for Latent Diffusion ...

Vision Foundation Models Can Be Good Tokenizers for Latent Diffusion ...

VFM-VAE: Vision Foundation Models Can Be Good Tokenizers for Latent ...

Paper page - Latent Denoising Makes Good Visual Tokenizers

VFM-VAE: Vision Foundation Models Can Be Good Tokenizers for Latent ...

Temporal-Guided Visual Foundation Models for Event-Based Vision
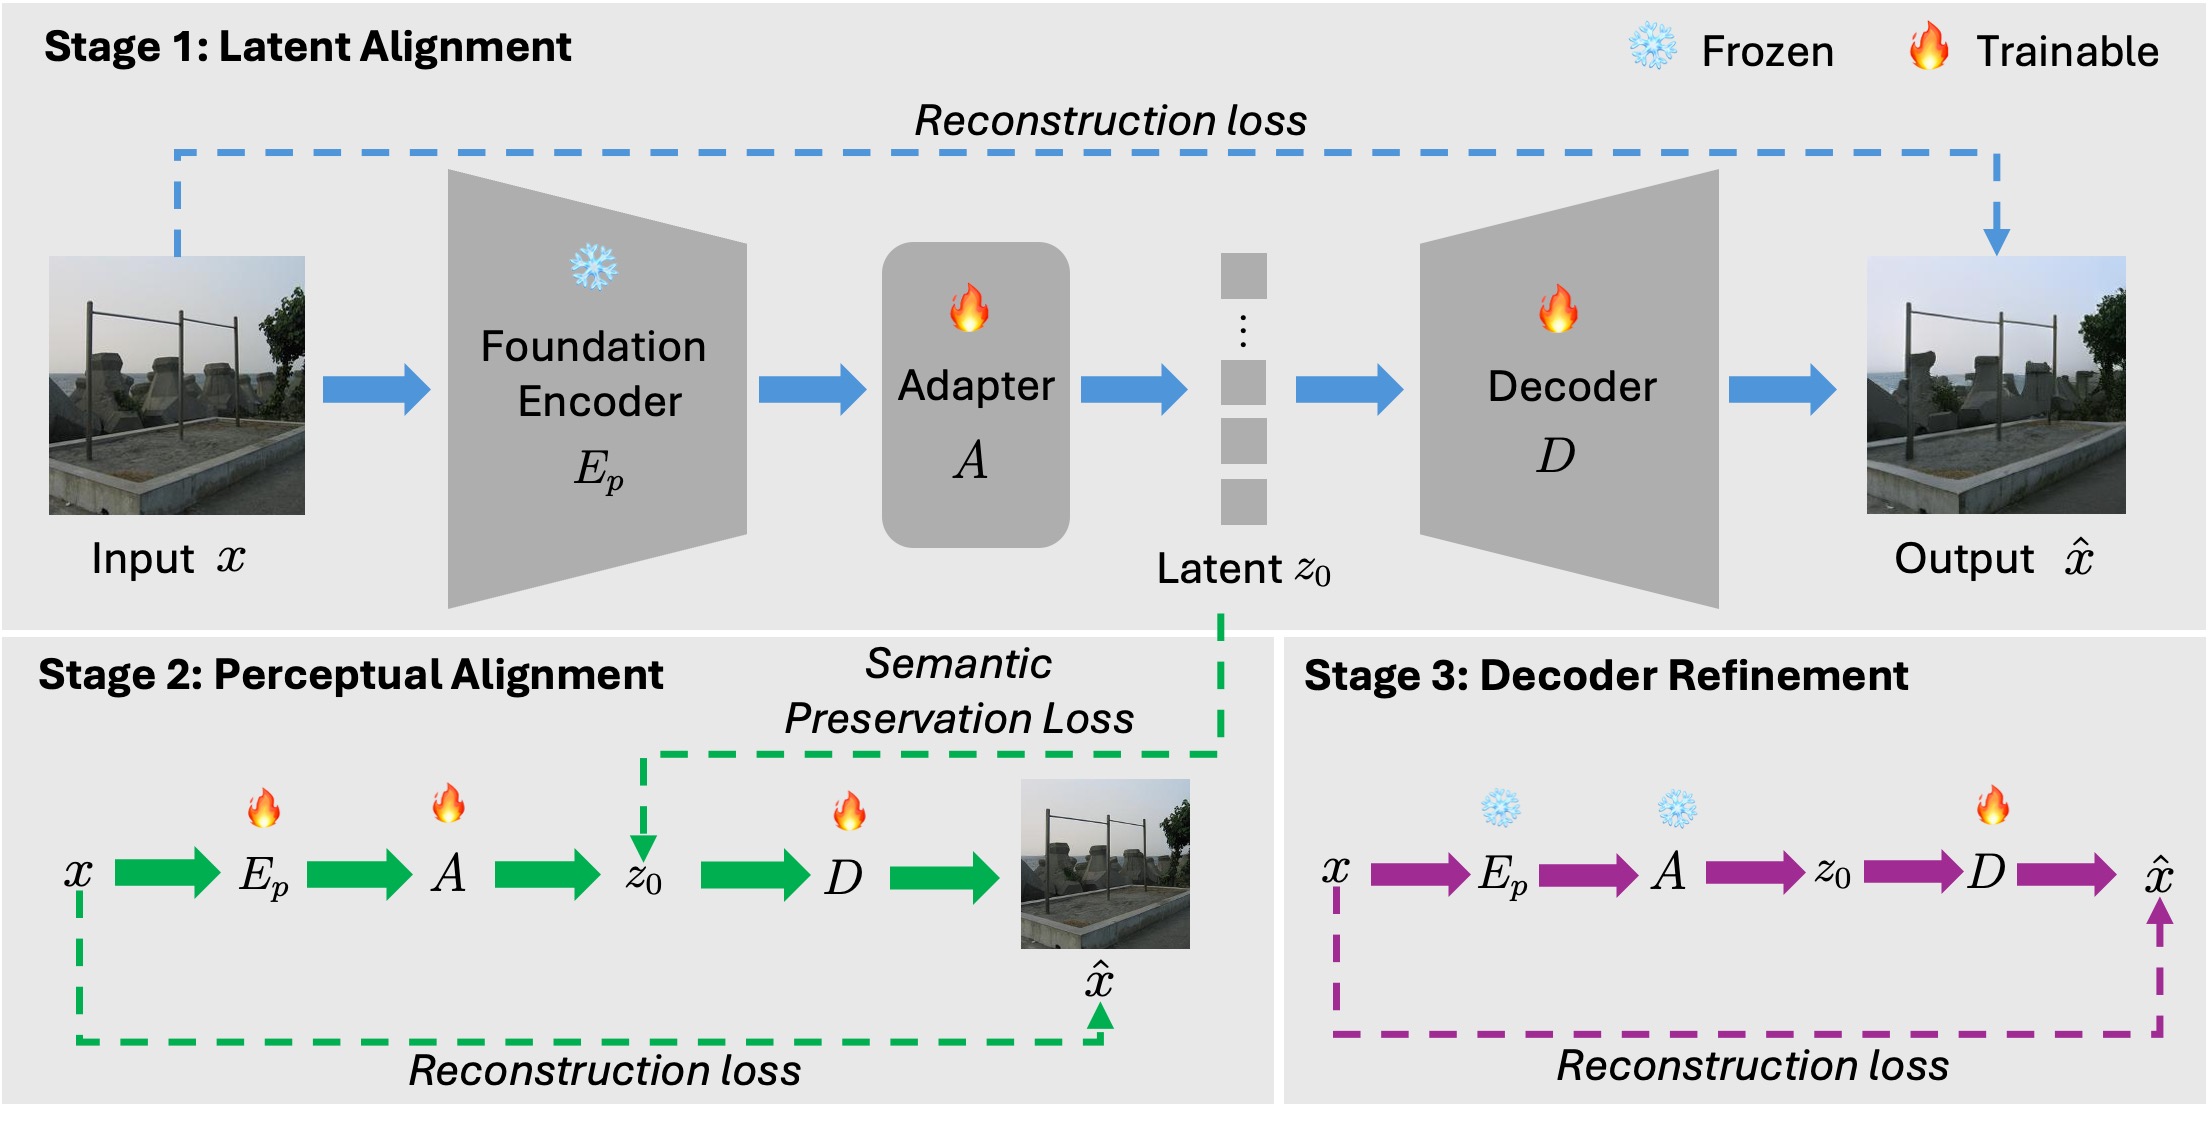
Aligning Visual Foundation Encoders to Tokenizers for Diffusion Models

Paper page - V^2L: Leveraging Vision and Vision-language Models into ...
Advertisement Space (336x280)

Paper page - REAR: Rethinking Visual Autoregressive Models via ...

Paper page - Learnings from Scaling Visual Tokenizers for ...
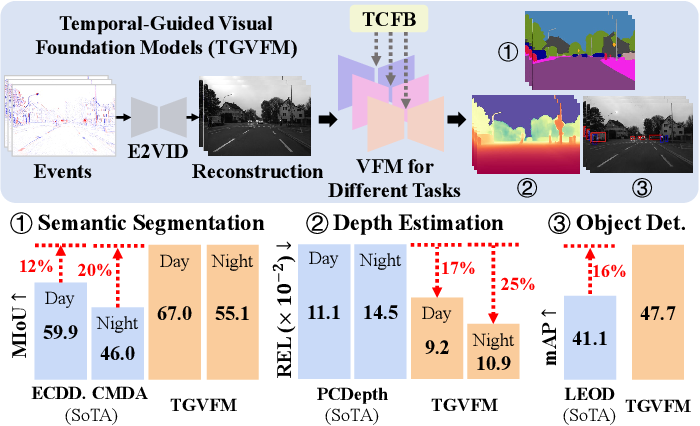
Figure 1 from Temporal-Guided Visual Foundation Models for Event-Based ...

The Foundation Models Reshaping Computer Vision – DevStream

CoMP: Continual Multimodal Pre-training for Vision Foundation Models ...

ICLR Poster Aligning Visual Foundation Encoders to Tokenizers for ...
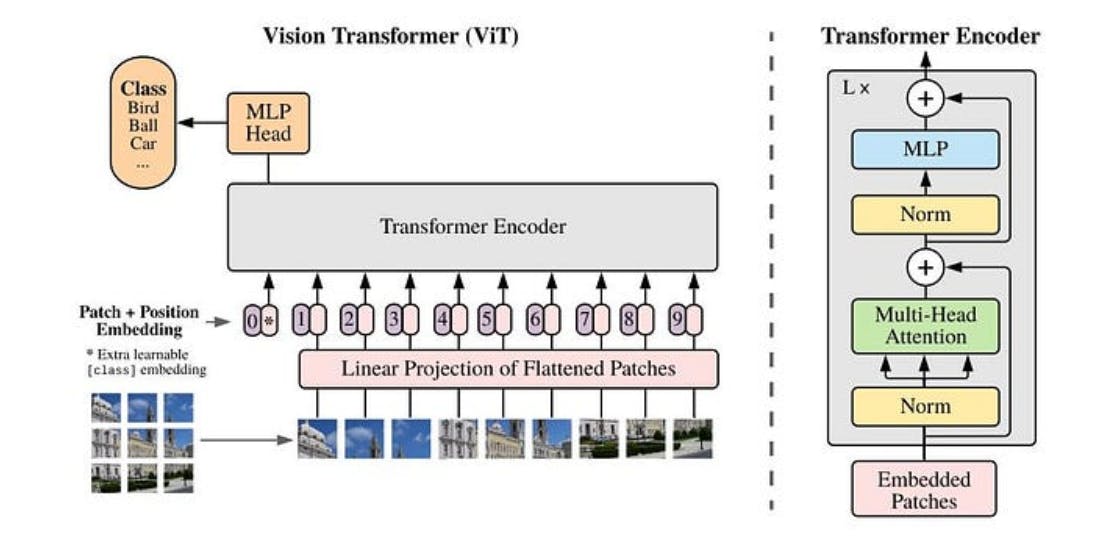
Visual Foundation Models (VFMs) Explained | Encord

Paper page - PVC: Progressive Visual Token Compression for Unified ...

[Literature Review] Aligning Visual Foundation Encoders to Tokenizers ...

Probing the 3D Awareness of Visual Foundation Models - Luigi Freda
Advertisement Space (336x280)
How to Benchmark Vision Foundation Models for Semantic Segmentation ...

Visual Foundation Models (VFMs) Explained | Encord

Foundation Model for Visual Perception | Fundamental Vision Lab

[2312.14238] InternVL: Scaling up Vision Foundation Models and Aligning ...
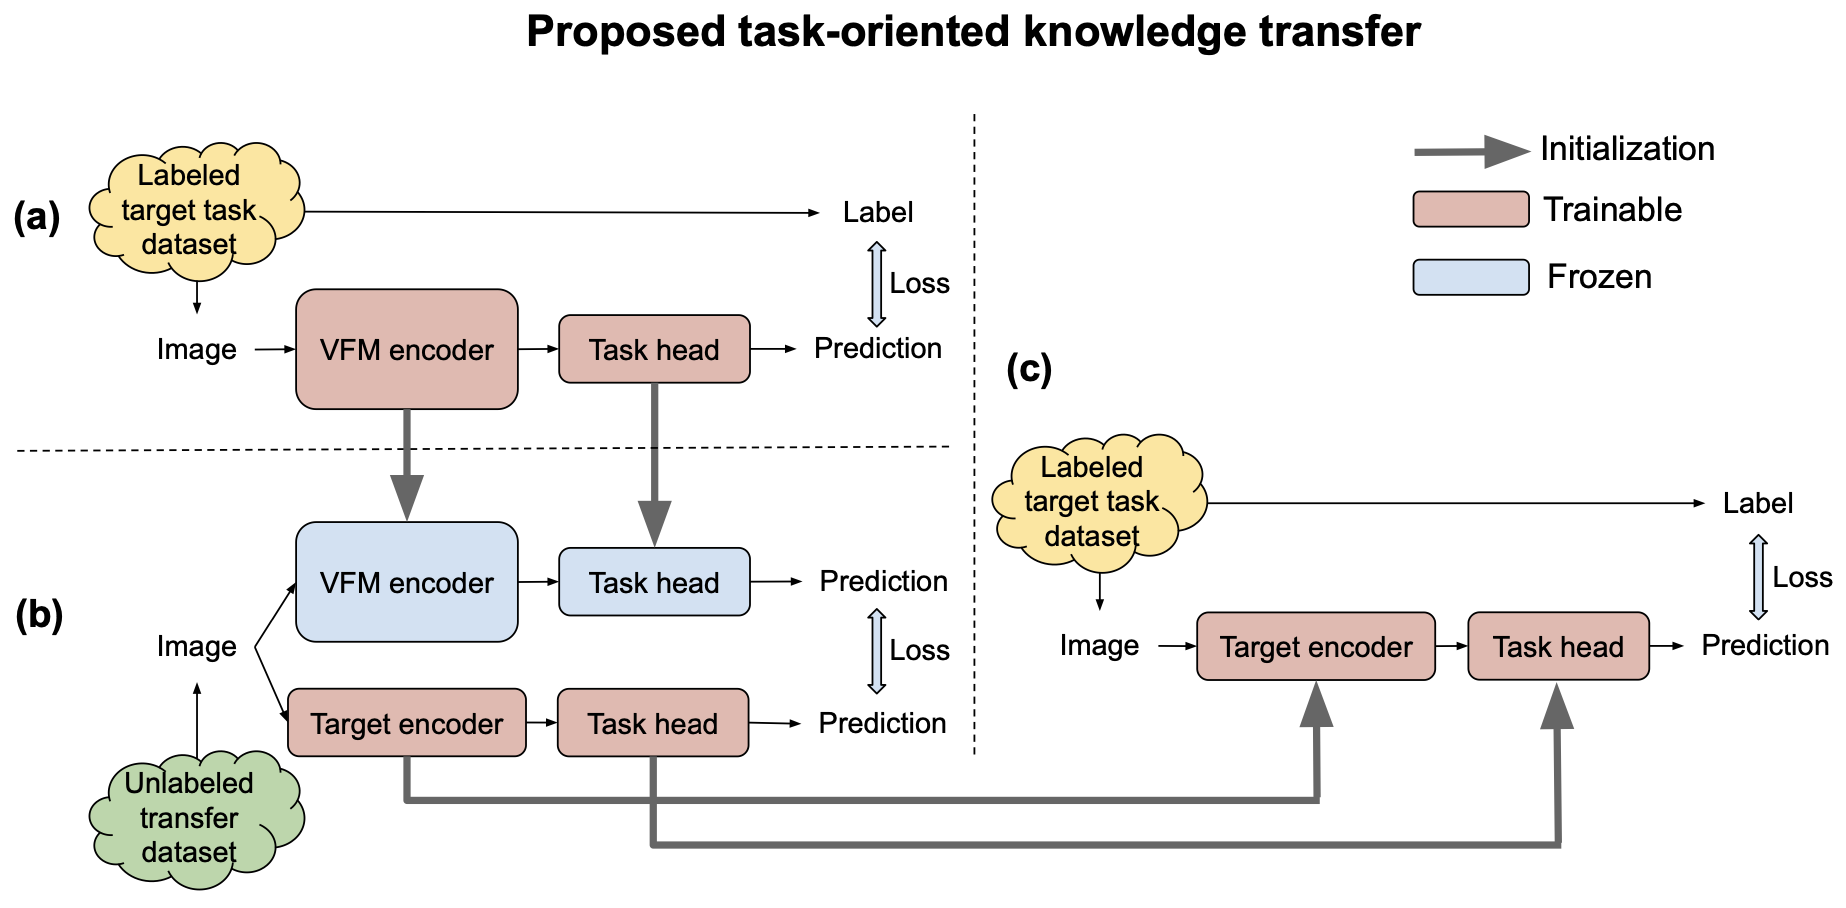
[논문 정리] Knowledge Transfer from Vision Foundation Models for Efficient ...

Vision foundation models | AI Research Papers