
Paper Page Xmodel Vlm A Simple Baseline For Multimodal Vision

Paper page - Xmodel-VLM: A Simple Baseline for Multimodal Vision ...

Xmodel-VLM: A Simple Baseline for Multimodal Vision Language Model | AI ...
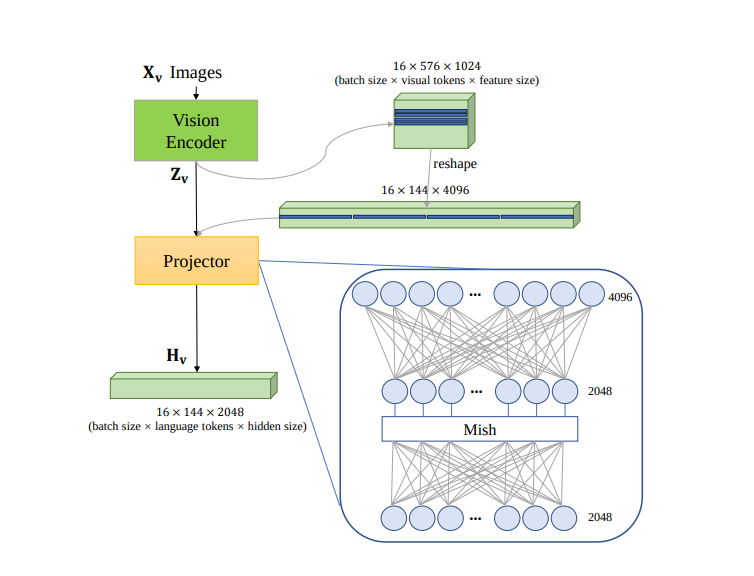
Santosh Sawant - Xmodel-VLM: A Simple Baseline for Multimodal Vision ...
Xmodel-VLM: A Simple Baseline for Multimodal Vision Language Model ...

Xmodel-VLM: A Simple Baseline for Multimodal Vision Language Model ...

Xmodel-VLM: A Simple Baseline for Multimodal Vision Language Model | AI ...

Table 1 from Xmodel-VLM: A Simple Baseline for Multimodal Vision ...

Xmodel-VLM: A Simple Baseline for Multimodal Vision Language Model - 智源社区论文

Paper page - MobileVLM V2: Faster and Stronger Baseline for Vision ...

This AI Paper Introduces VLM-R³: A Multimodal Framework for Region ...
Advertisement Space (300x250)

This AI Paper Introduces VLM-R³: A Multimodal Framework for Region ...

Paper page - Time-VLM: Exploring Multimodal Vision-Language Models for ...

Meet MobileVLM: A Competent Multimodal Vision Language Model (MMVLM ...
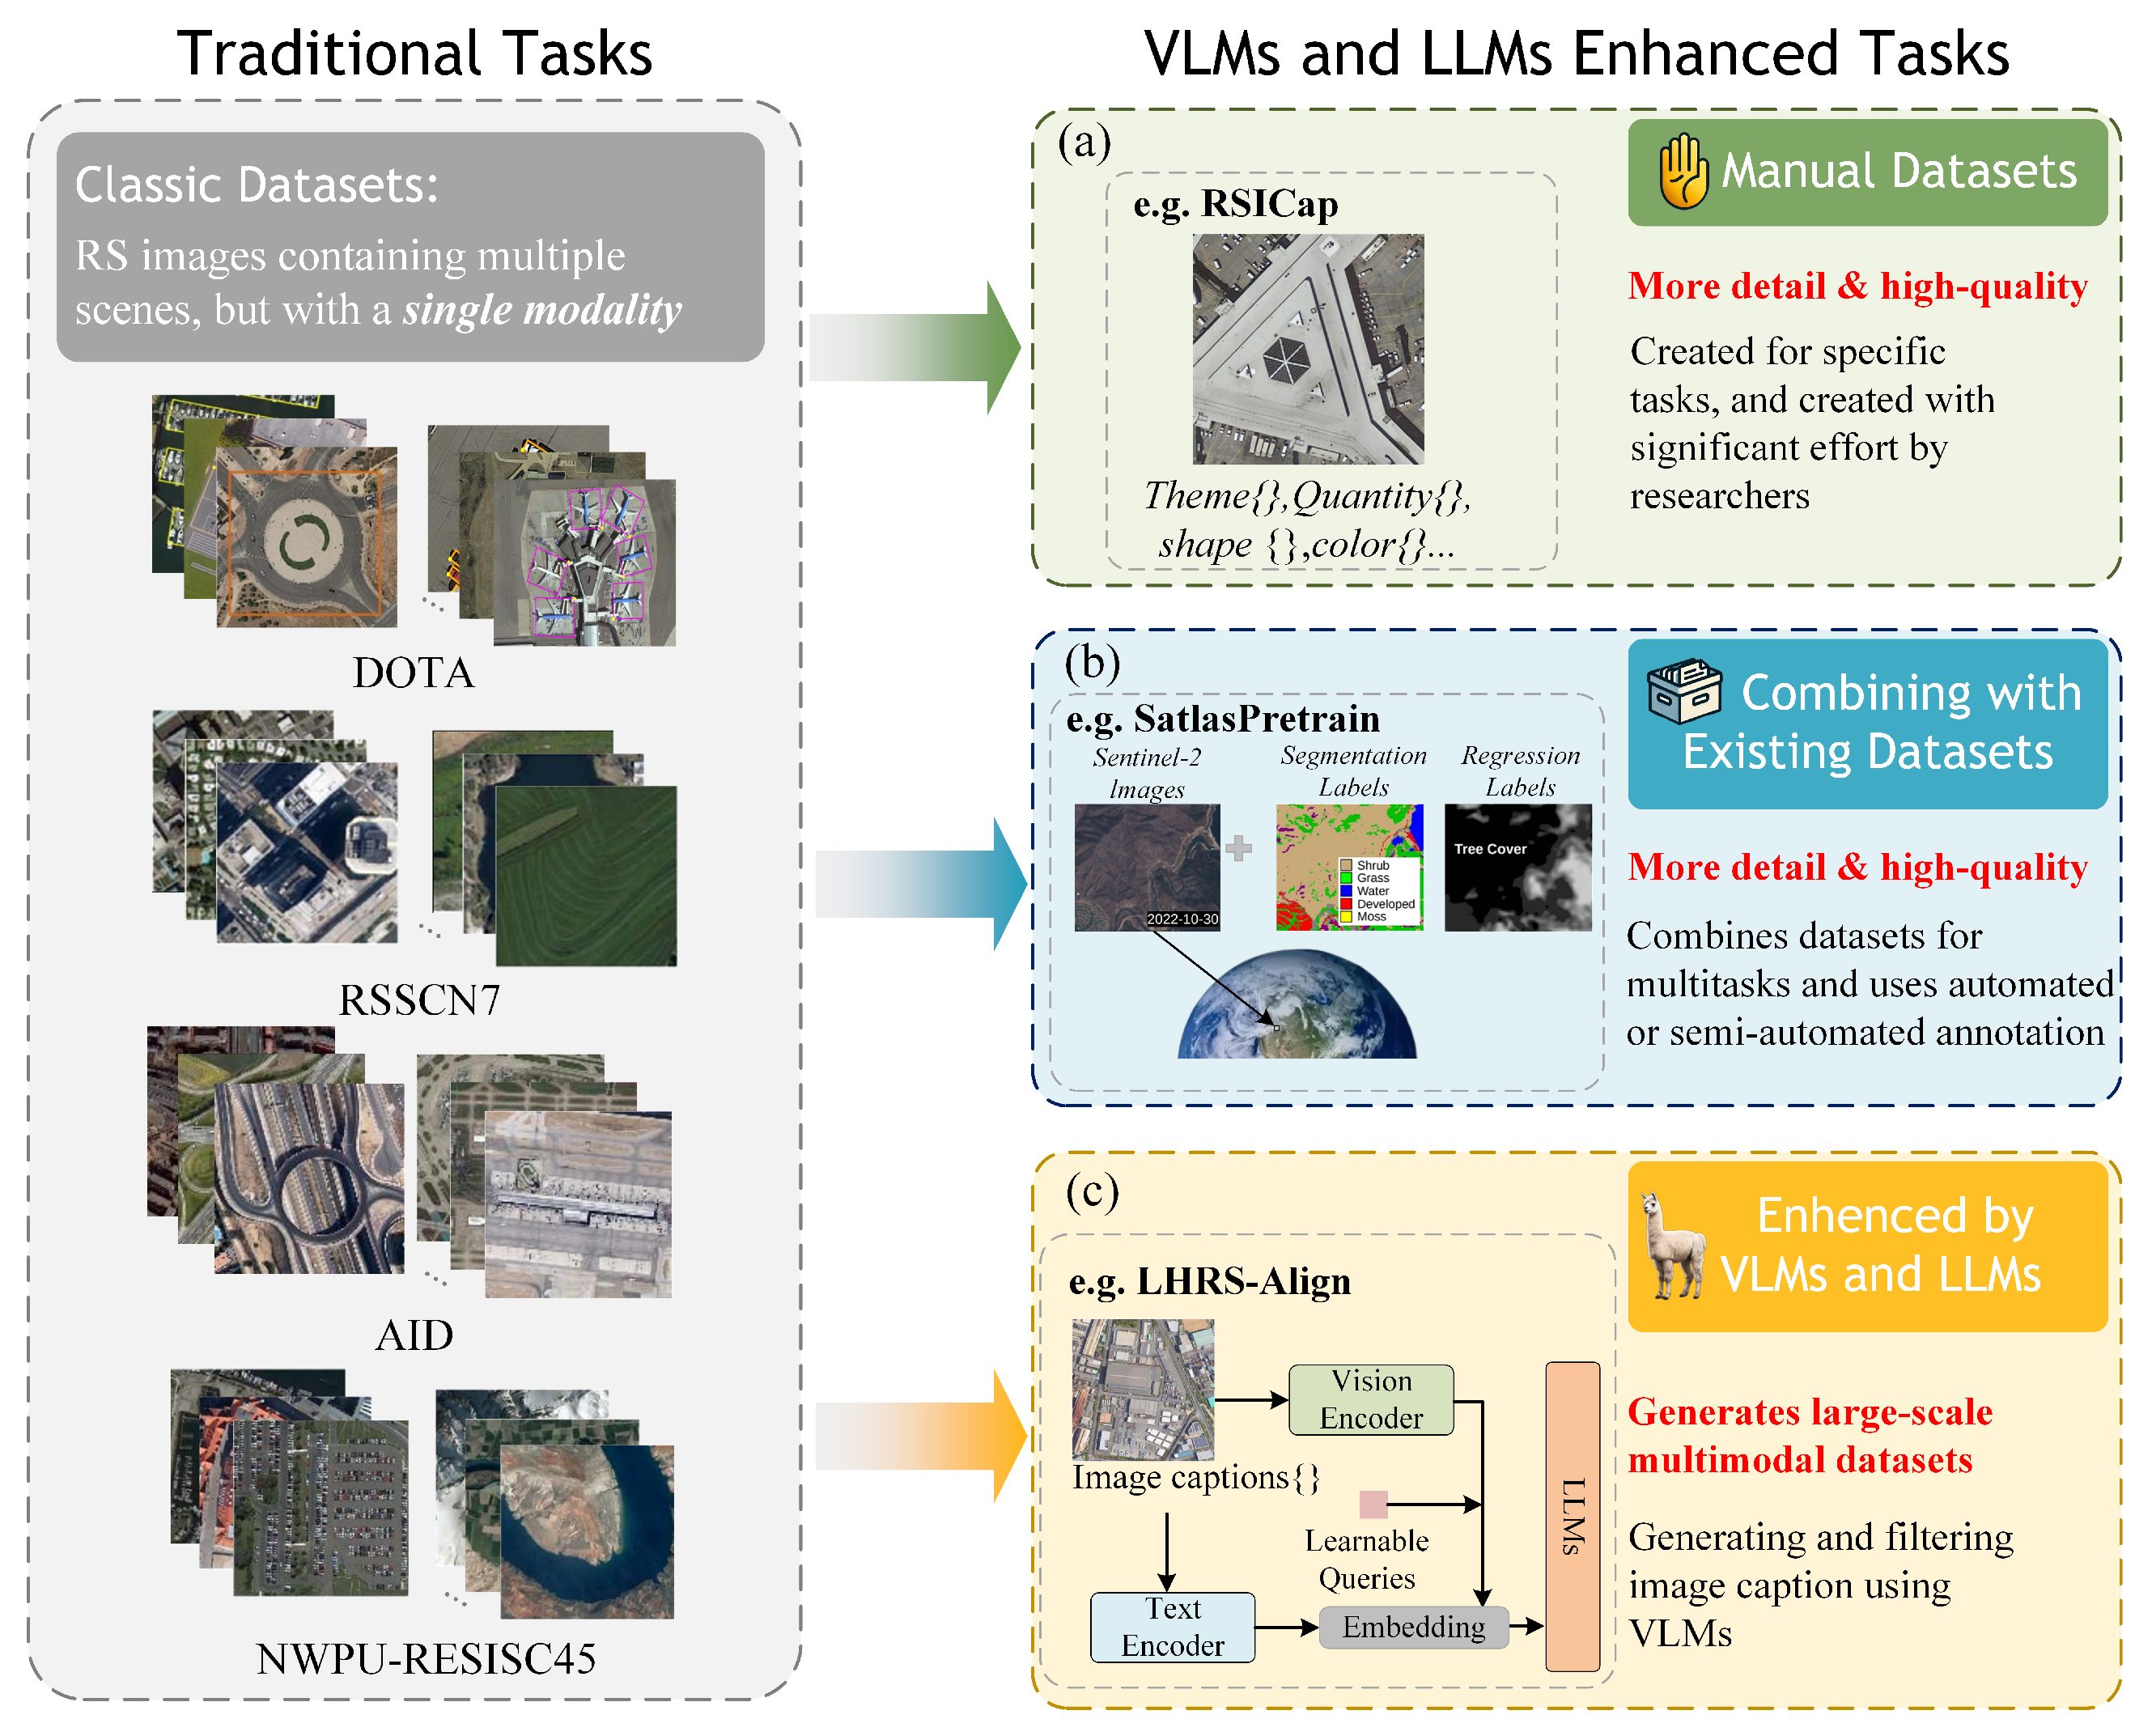
Vision–Language Models for Remote Sensing: A New Era of Multimodal ...

Paper page - OLA-VLM: Elevating Visual Perception in Multimodal LLMs ...

Paper page - Large VLM-based Vision-Language-Action Models for Robotic ...

Paper page - V2PE: Improving Multimodal Long-Context Capability of ...

Paper page - Penguin-VL: Exploring the Efficiency Limits of VLM with ...
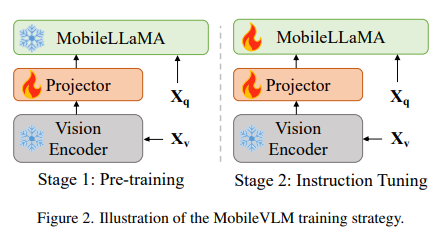
Meet MobileVLM: A Competent Multimodal Vision Language Model (MMVLM ...

Paper page - MUSE-VL: Modeling Unified VLM through Semantic Discrete ...
Advertisement Space (336x280)
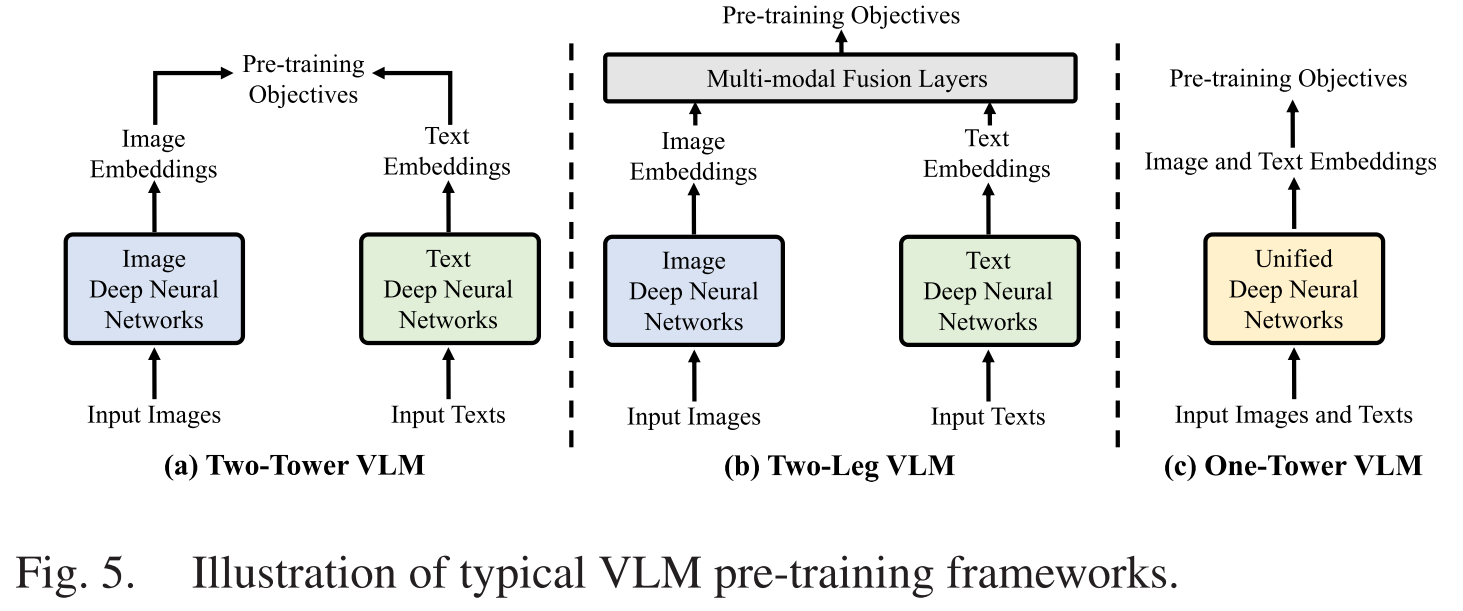
【文献阅读】Vision-Language Models for Vision Tasks: A Survey - 技术栈
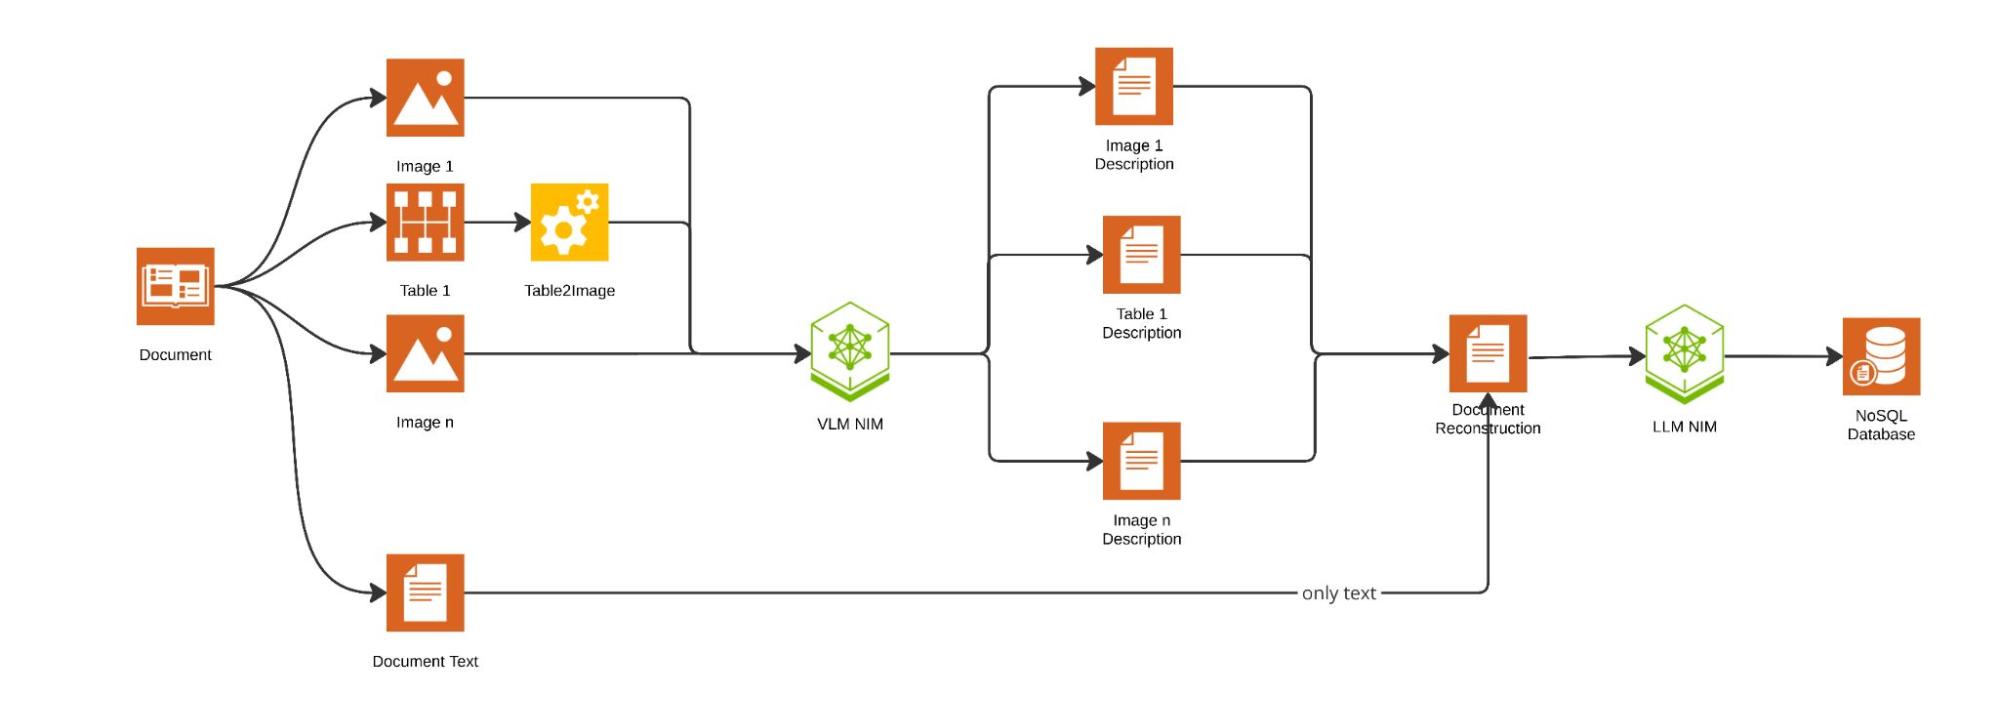
Building a Simple VLM-based Multimodal Information Retrieval System ...
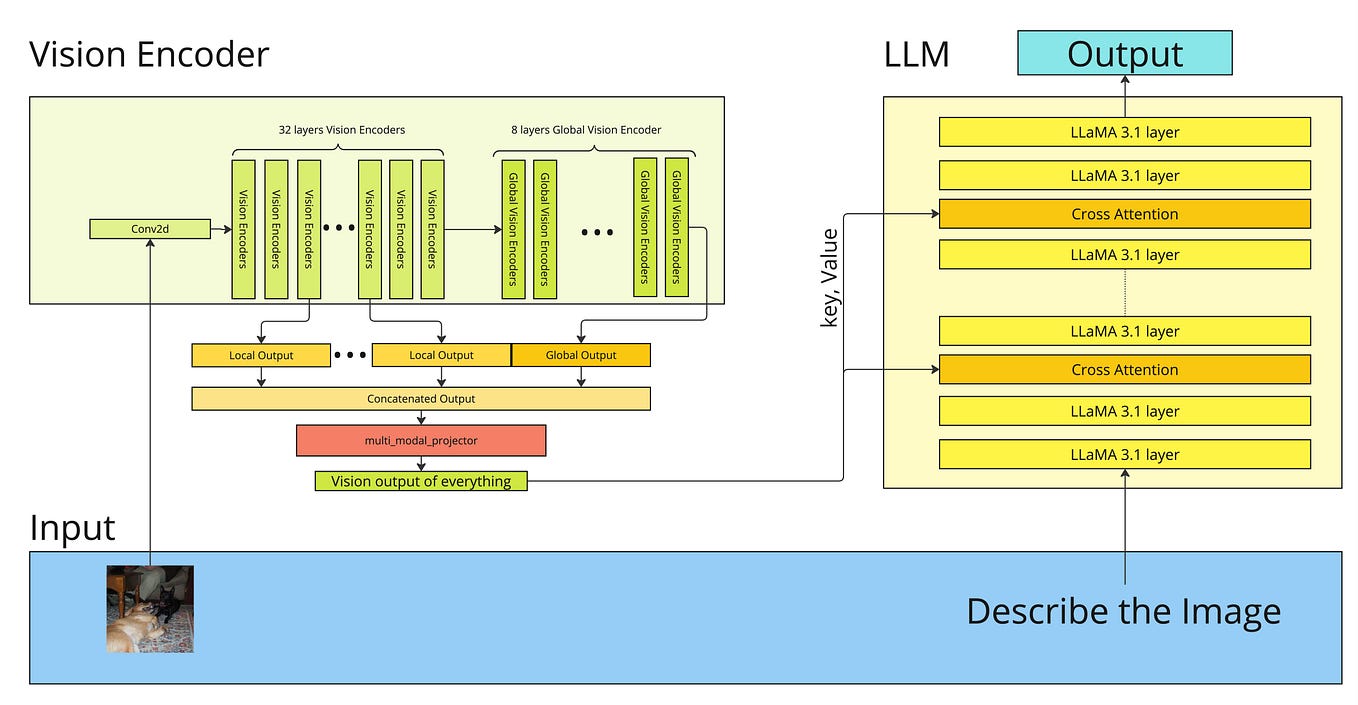
A Guide to Implement the Vision Encoder for LLaVA | Medium

Paper page - DUET-VLM: Dual stage Unified Efficient Token reduction for ...

Training a Vision Language Model from scratch (VLM multi-modal) | by ...
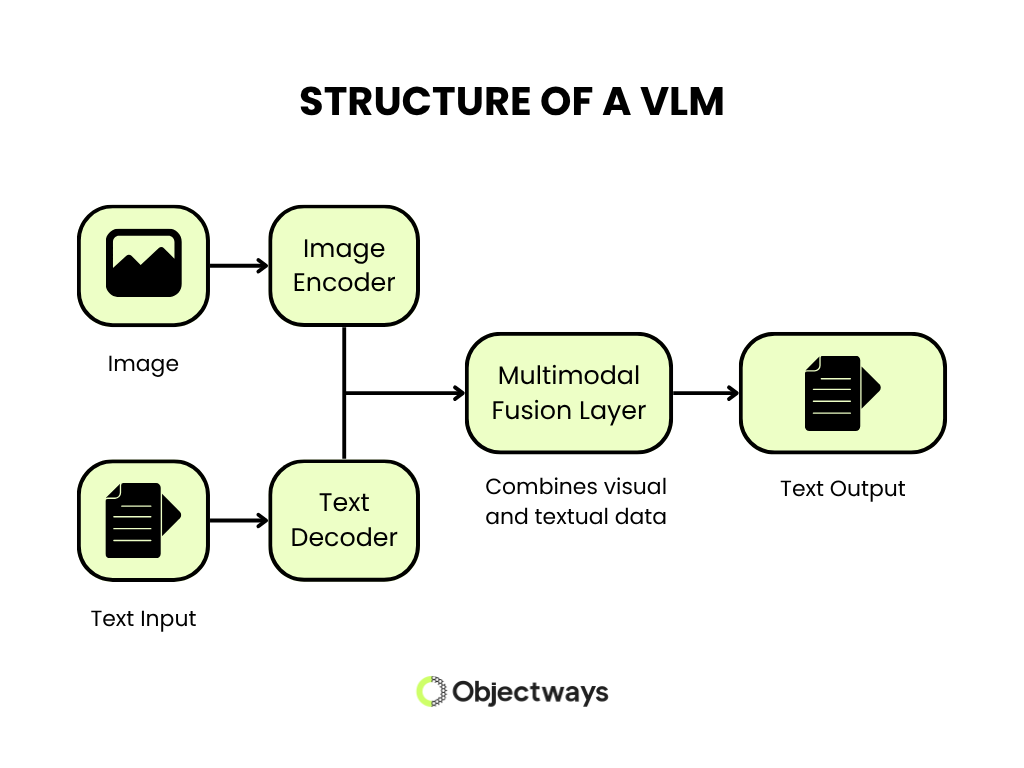
Large Vision Models Take Visual Reasoning a Step Further

Paper page - VLM-3R: Vision-Language Models Augmented with Instruction ...
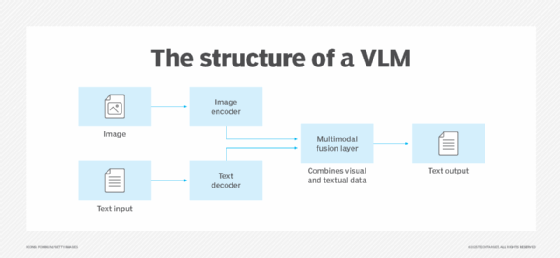
Structured Output in Local Vision Language Models (VLMs): A Step-by ...

[논문 리뷰] Dynamic-VLM: Simple Dynamic Visual Token Compression for VideoLLM

Figure 2 from Time-VLM: Exploring Multimodal Vision-Language Models for ...
Advertisement Space (336x280)
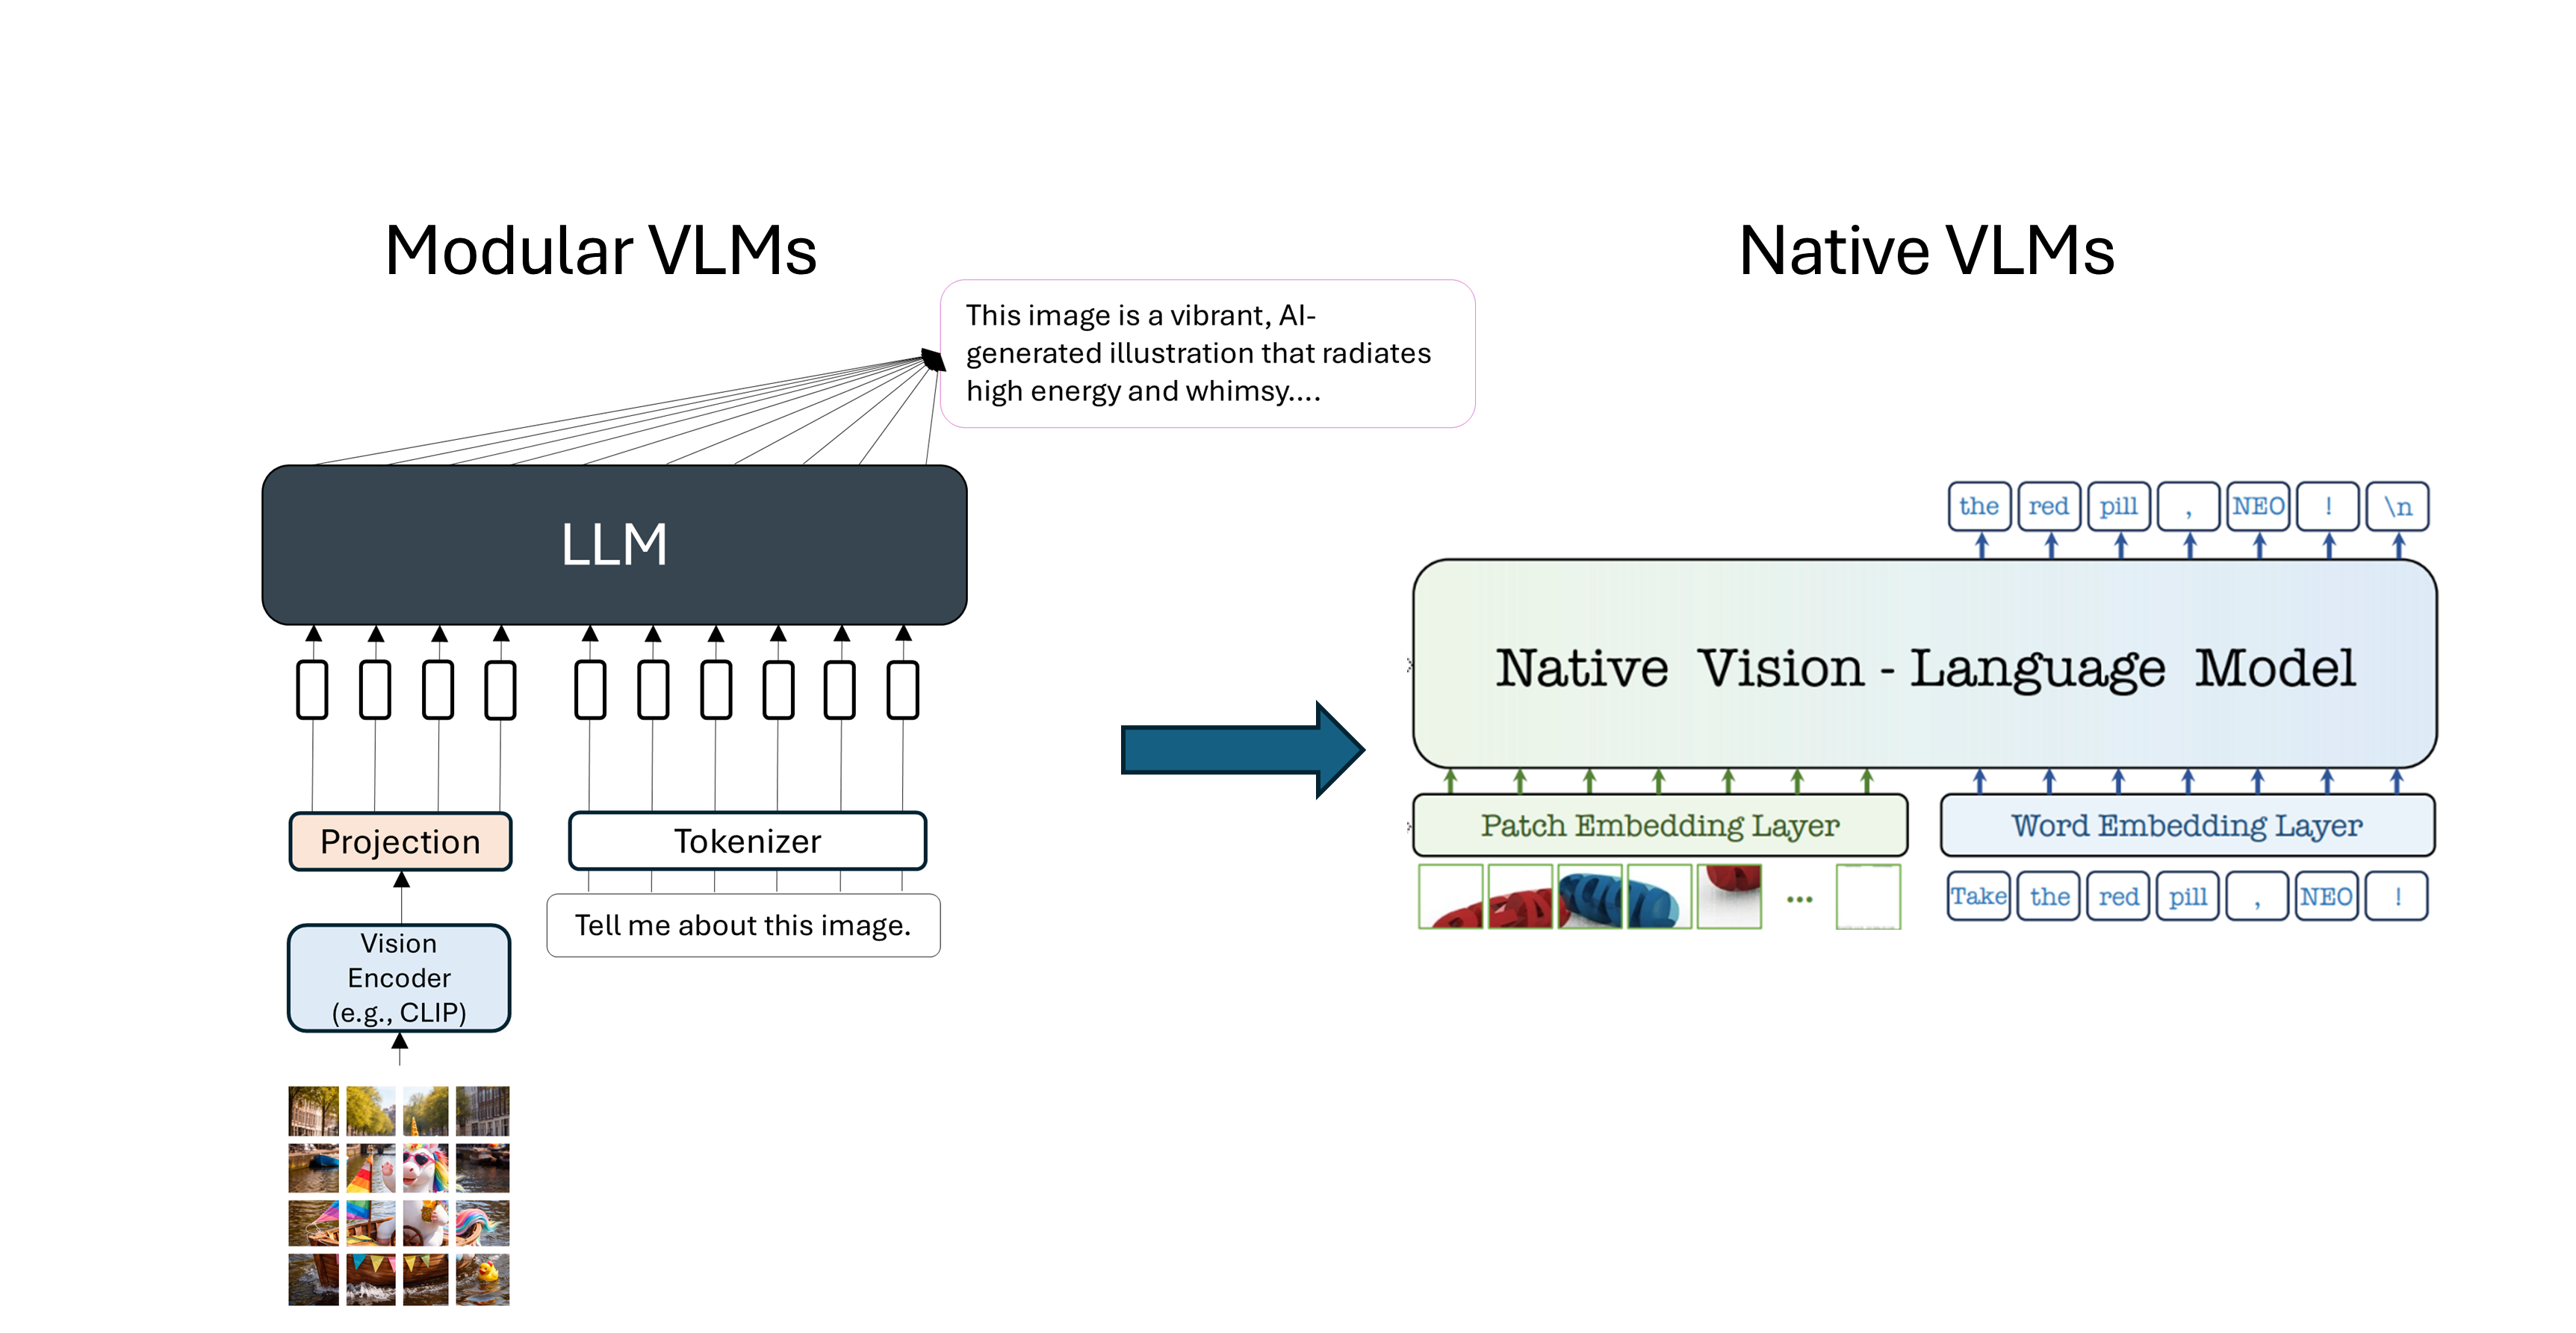
Lecture 8b. Vision Transformers and Multimodal Models - ML Engineering

Paper page - Loc3R-VLM: Language-based Localization and 3D Reasoning ...

Vision Language Model(VLM) in a Nutshell

VLM2Vec: Training Vision-Language Models for Massive Multimodal ...

A Comprehensive Guide to Vision Language Models (VLMs)

VLM-UQBench: A Benchmark for Modality-Specific and Cross-Modality ...