
Pdf Imagetext Matching Model Based On Clip Bimodal Encoding
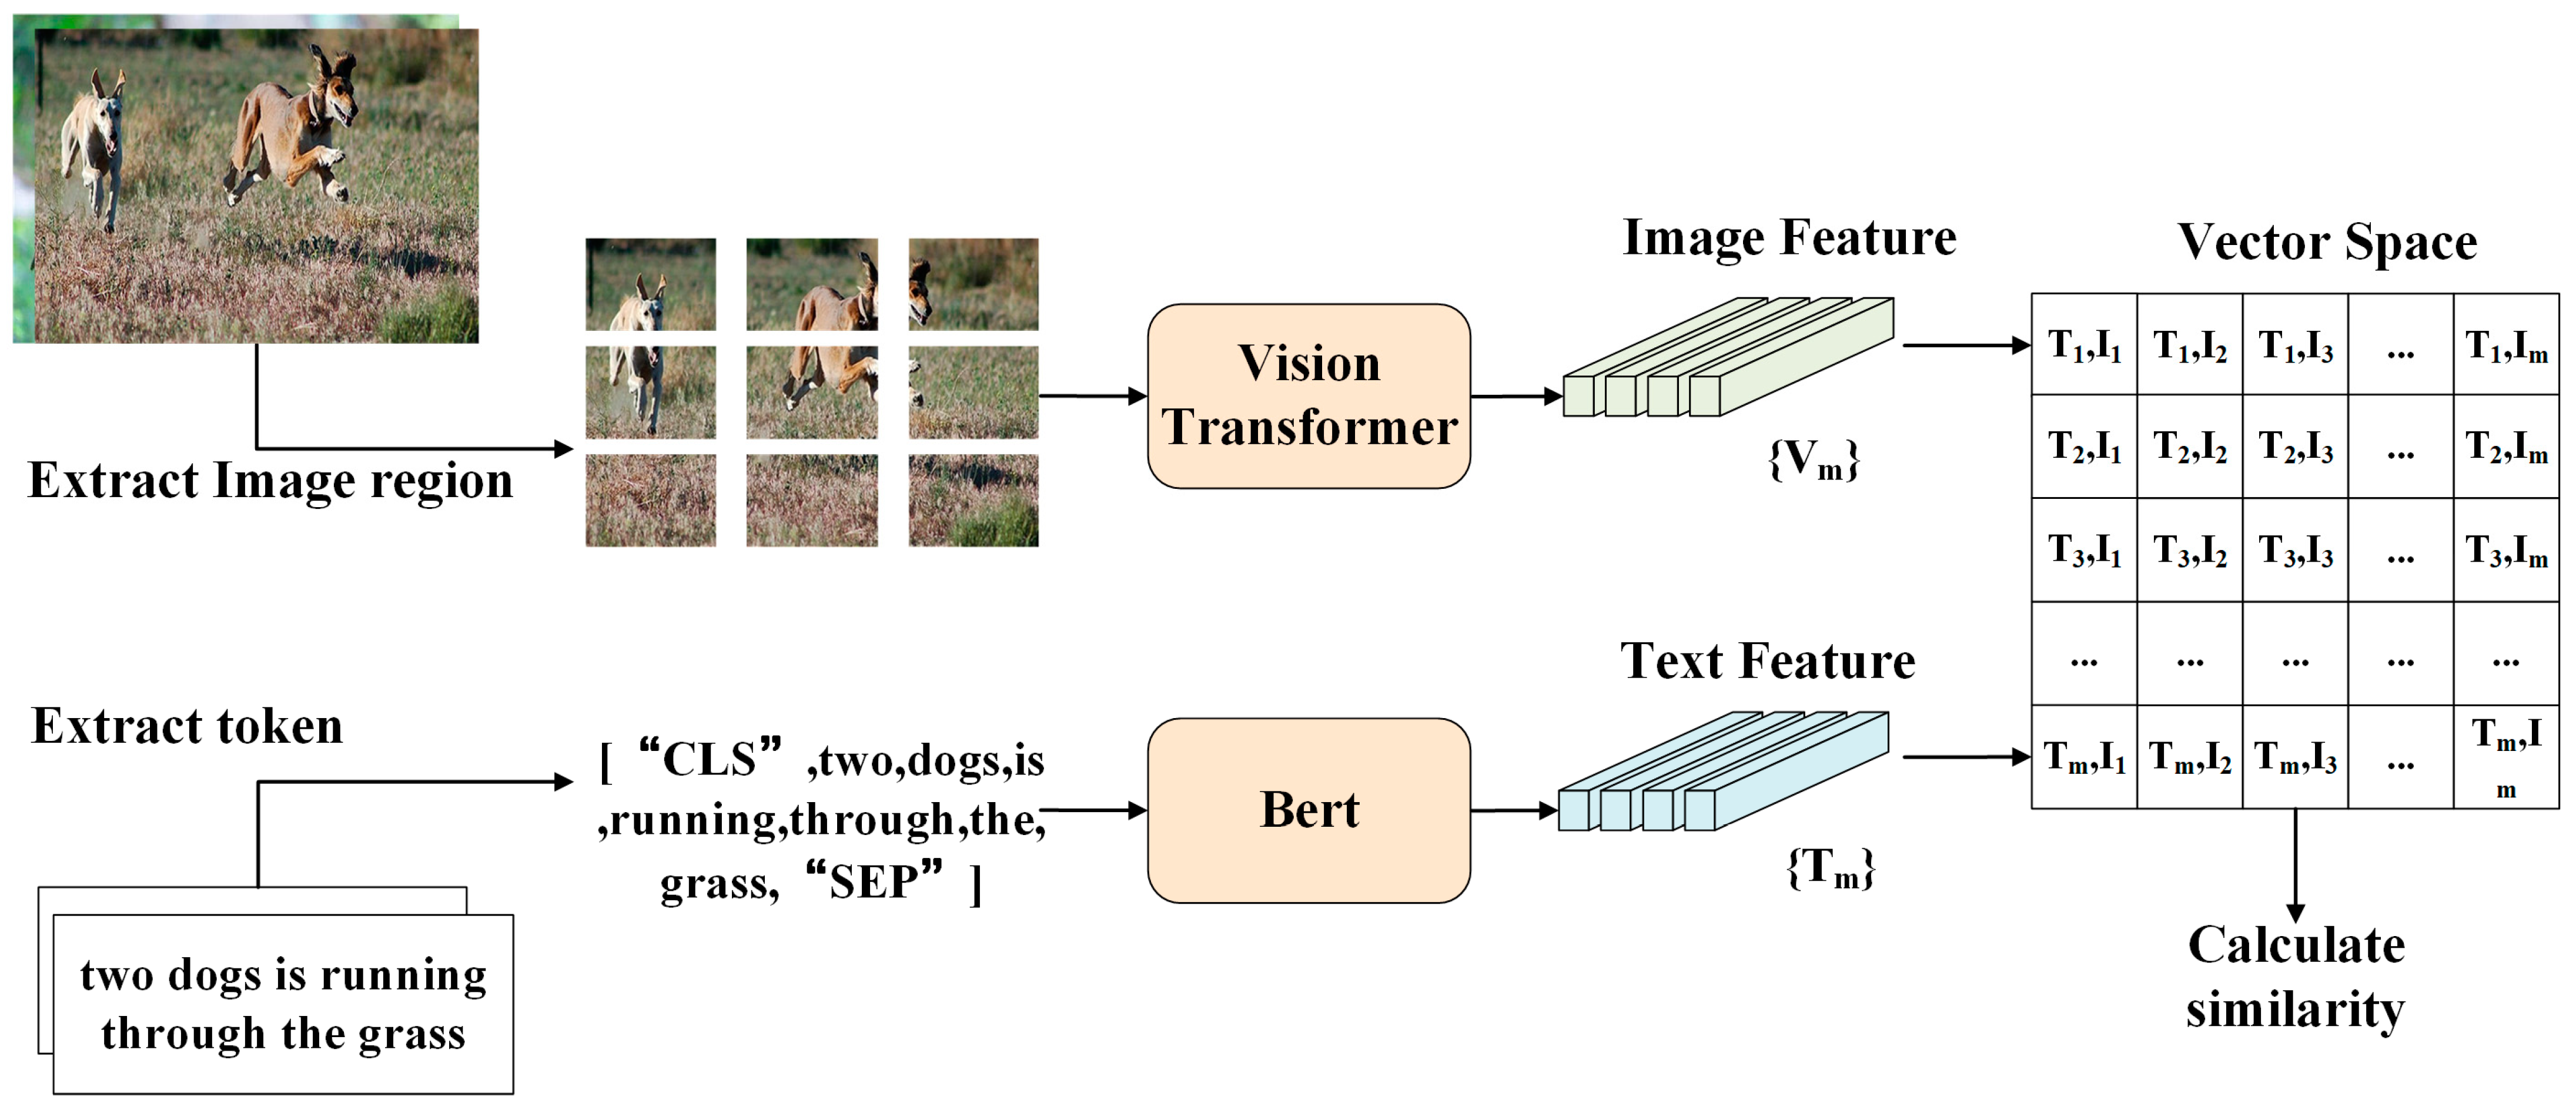
Image–Text Matching Model Based on CLIP Bimodal Encoding | MDPI

(PDF) Image–Text Matching Model Based on CLIP Bimodal Encoding

Image–Text Matching Model Based on CLIP Bimodal Encoding

Image–Text Matching Model Based on CLIP Bimodal Encoding

Image–Text Matching Model Based on CLIP Bimodal Encoding
Image–Text Matching Model Based on CLIP Bimodal Encoding

Figure 1 from A Joint Encoding Model for Image-Text Matching Based on ...

Table 1 from A Joint Encoding Model for Image-Text Matching Based on ...

Figure 2 from A Joint Encoding Model for Image-Text Matching Based on ...
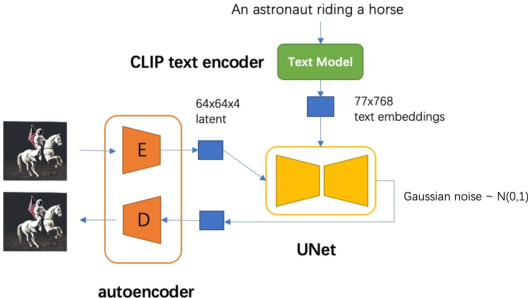
CLIP Model for Images to Textual Prompts Based on Top-k Neighbors
Advertisement Space (300x250)

(PDF) Improved Text Matching Model Based on BERT

Supernode Fusion Model Based on Bimodal Action Recognition

(PDF) A method for image–text matching based on semantic filtering and ...

(PDF) Cross-Modal Sentiment Analysis Based on CLIP Image-Text Attention ...

Figure 3 from A CLIP-Based Cross-Modal Matching Model for Image-Text ...

Multimodal approach: Training procedure of CLIP matching image-text ...

(PDF) Turning a CLIP Model into a Scene Text Spotter

Multimodal approach: Training procedure of CLIP matching image-text ...
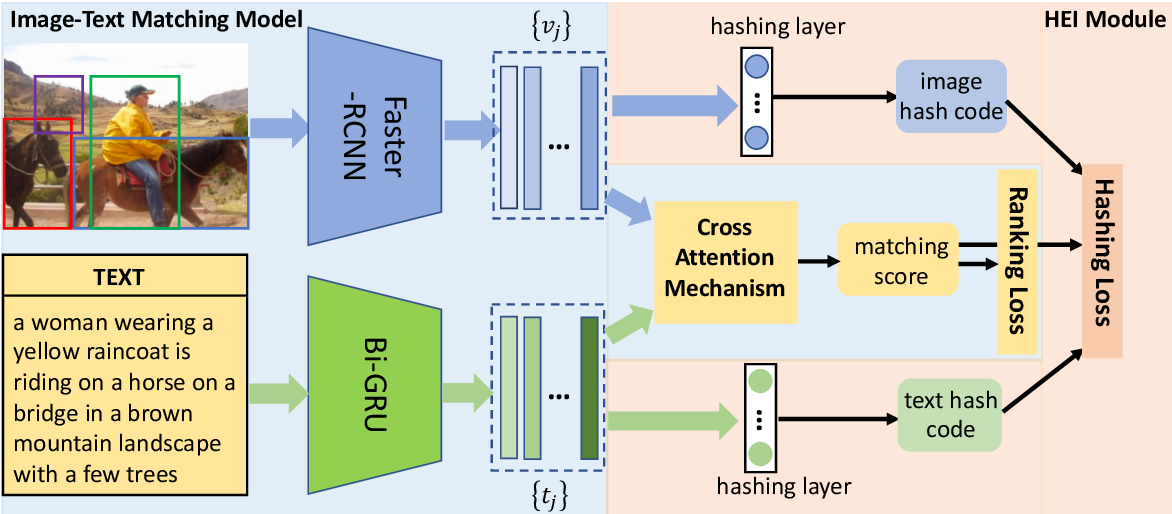
Figure 1 from Hashing based Efficient Inference for Image-Text Matching ...
Training a CLIP Model from Scratch for Text-to-Image Retrieval
Advertisement Space (336x280)
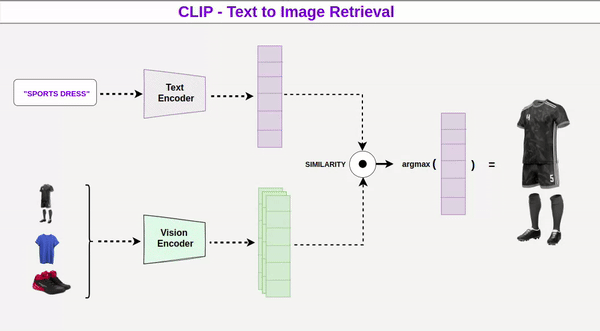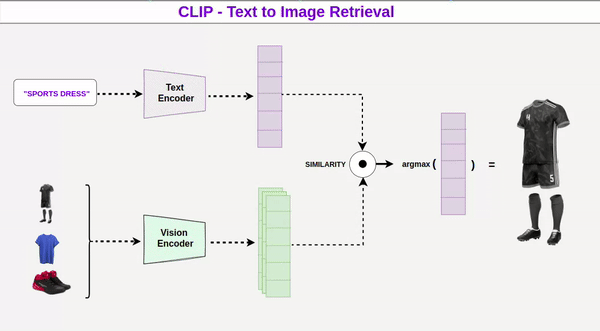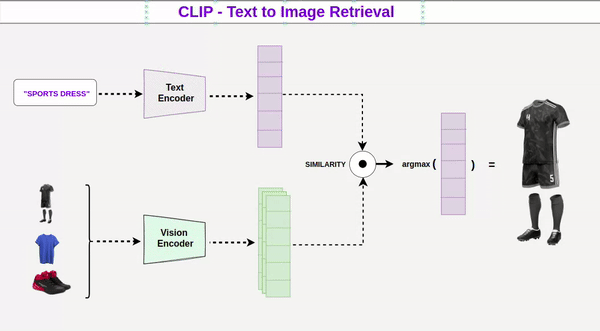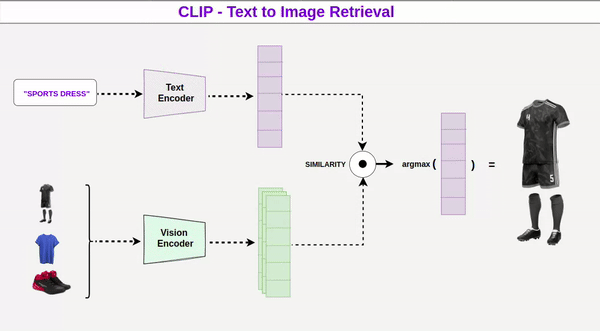
Training a CLIP Model from Scratch for Text-to-Image Retrieval

Figure 1 from A Multimodal Text Matching Model for Obfuscated Language ...

ContextCLIP: Contextual Alignment of Image-Text pairs on CLIP visual ...
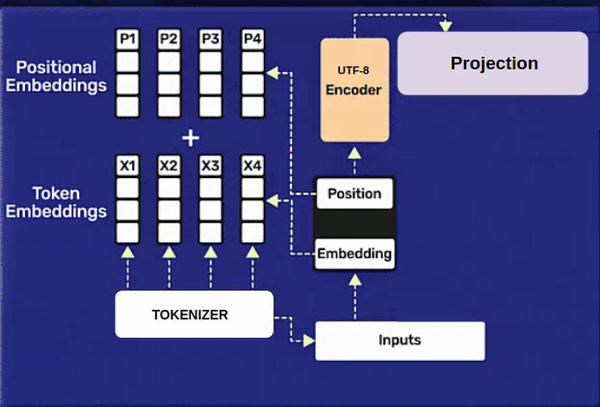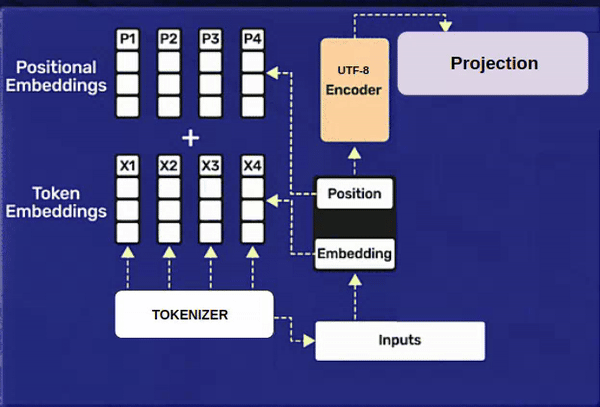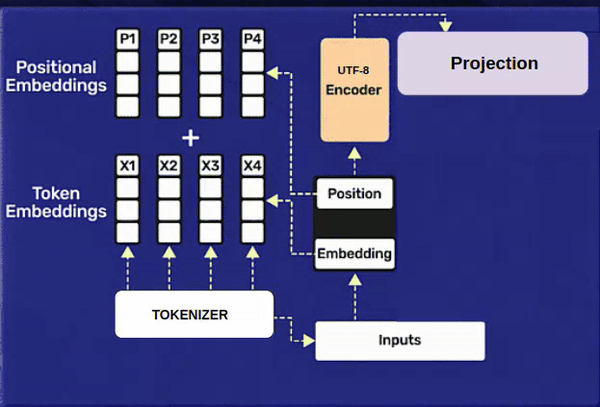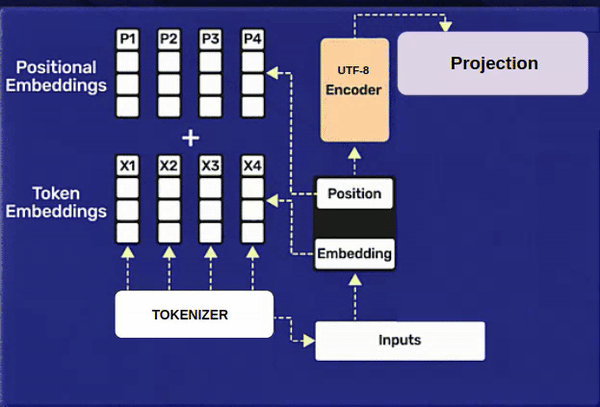
Training a CLIP Model from Scratch for Text-to-Image Retrieval
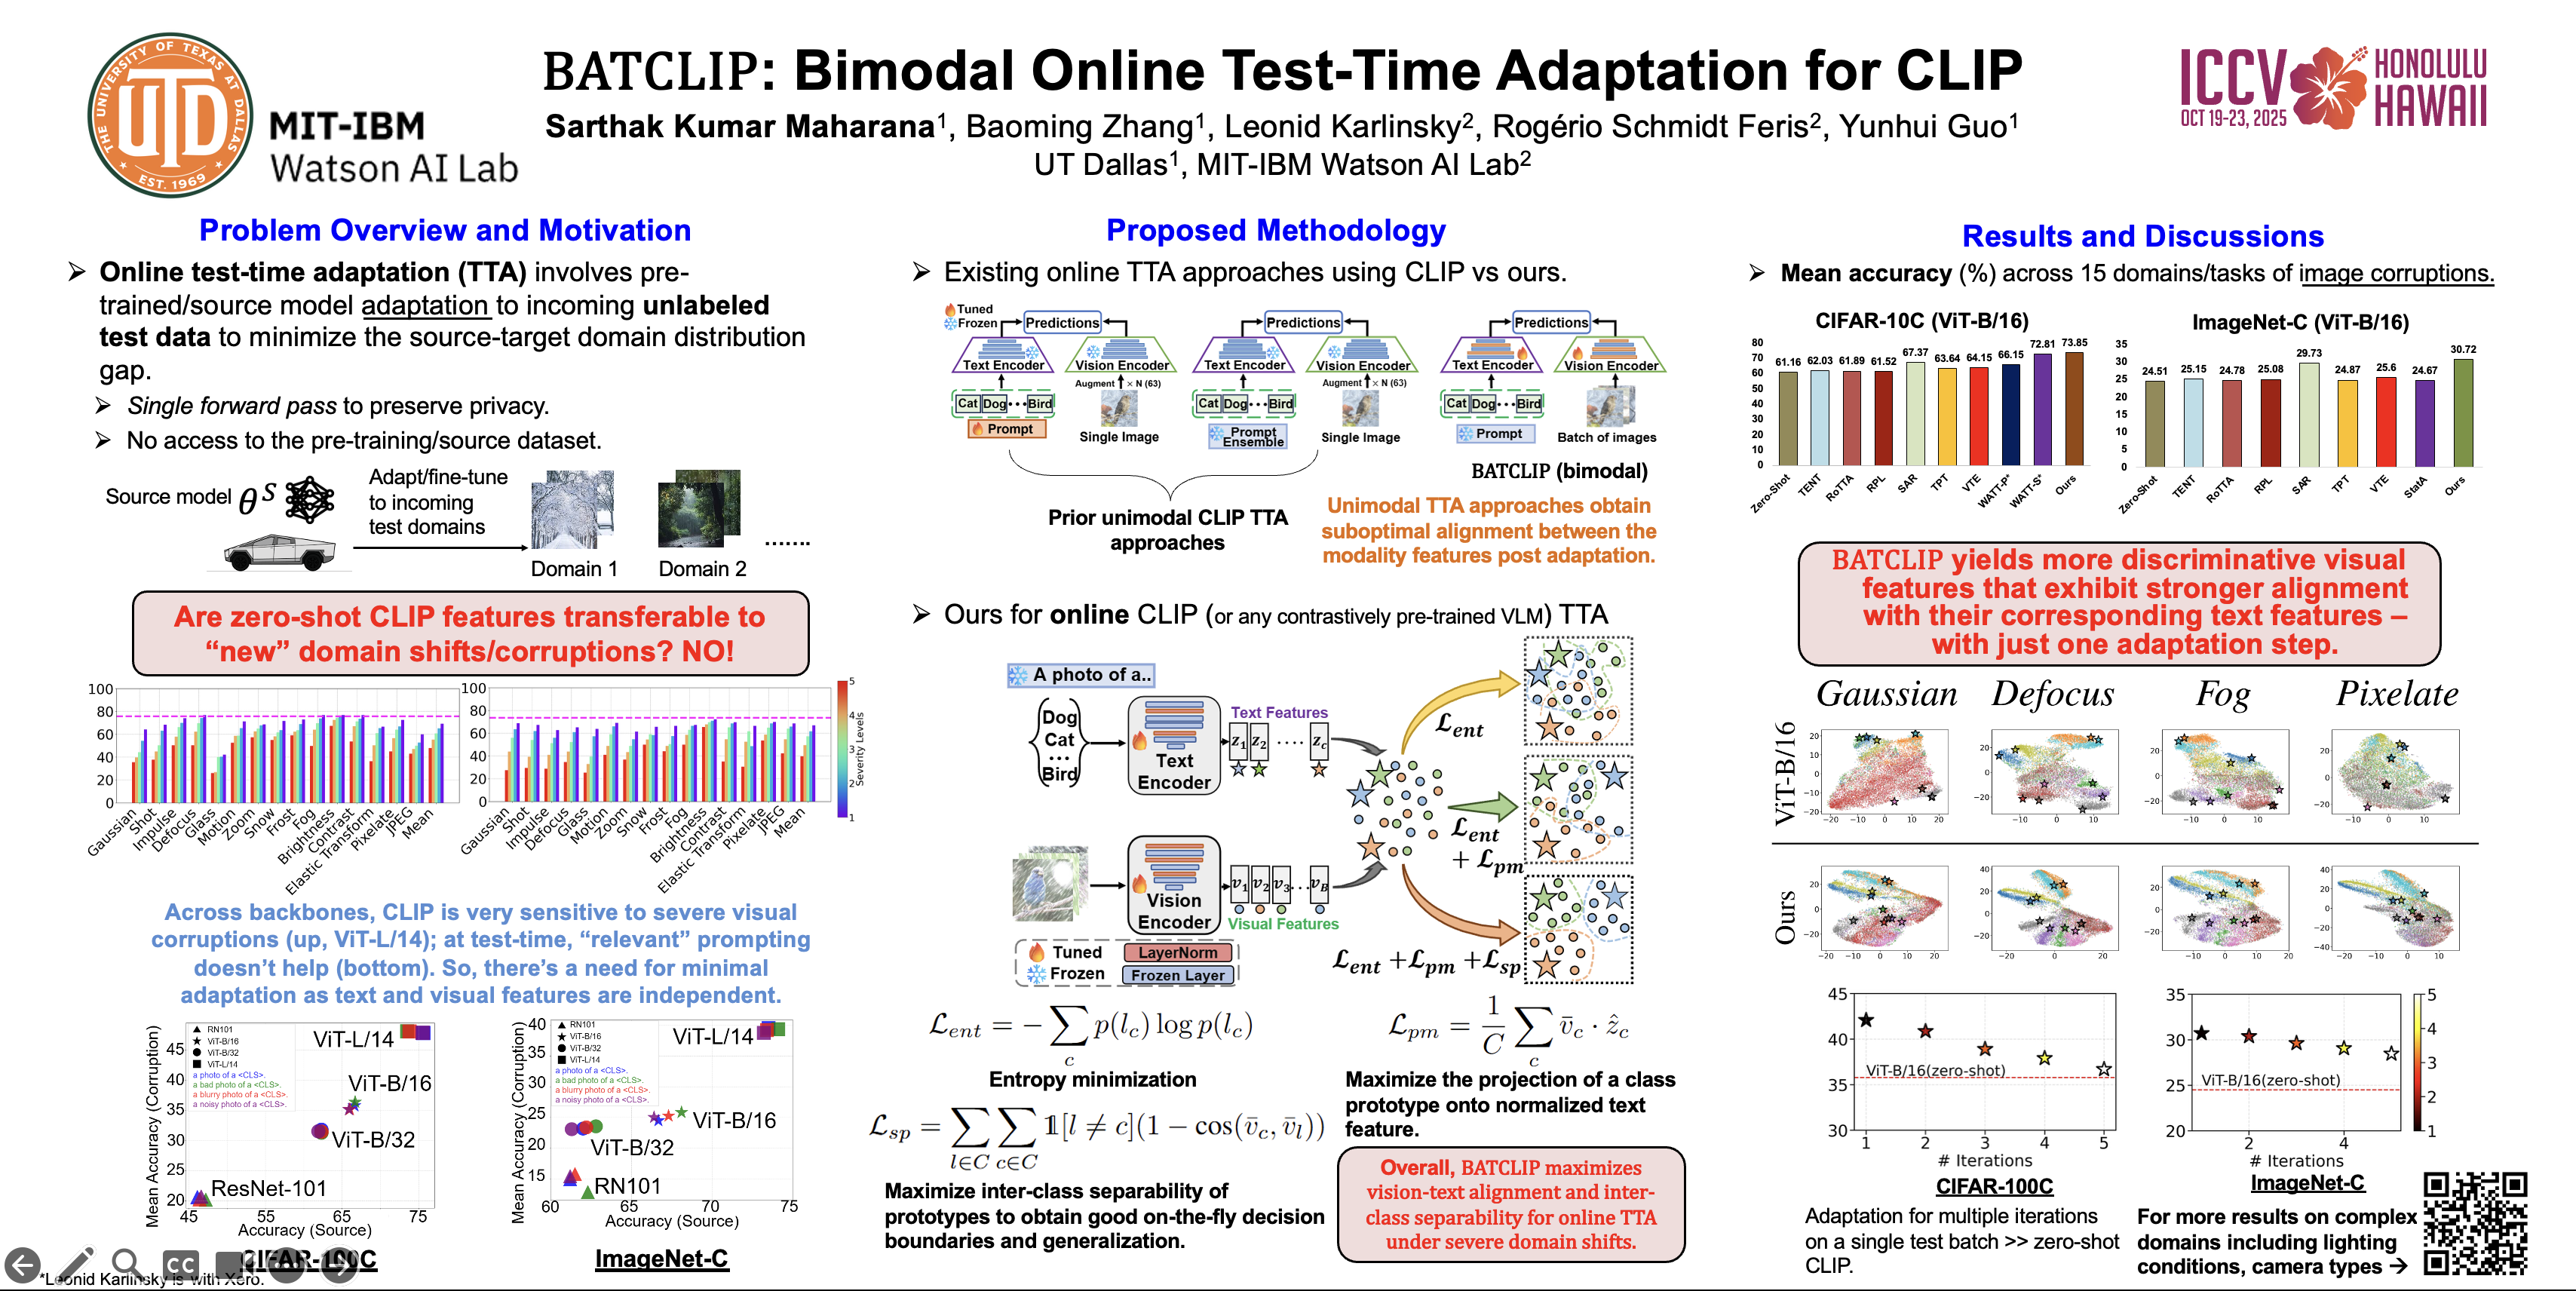
ICCV Poster BATCLIP: Bimodal Online Test-Time Adaptation for CLIP
(PDF) ContextCLIP: Contextual Alignment of Image-Text pairs on CLIP ...

(PDF) Turning a CLIP Model into a Scene Text Detector

Joint3DShapeMatching - a fast approach to 3D model matching using ...

ContextCLIP: Contextual Alignment of Image-Text pairs on CLIP visual ...

Cross-modal Hard Aligning for Image-Text Matching | PDF | Attention ...
Advertisement Space (336x280)

Unlocking the Language of Images: Reflections on CLIP (Contrastive ...

Turning a CLIP Model into a Scene Text Detector - 知乎
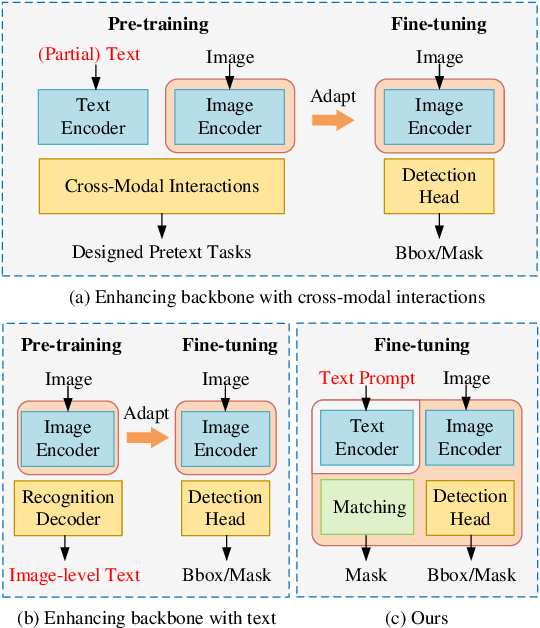
Figure 1 from Turning a CLIP Model into a Scene Text Detector ...

Figure 2 from A Multiview Text Imagination Network Based on Latent ...
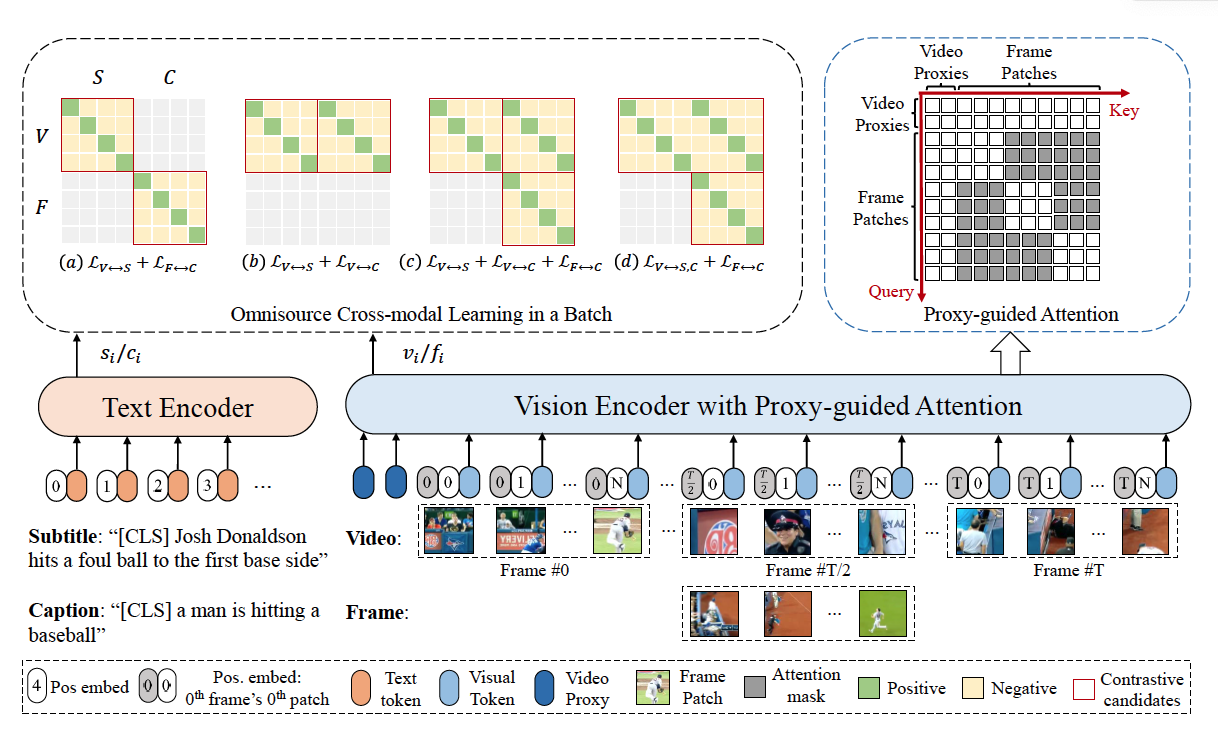
[MultiModal] CLIP-ViP: Adapting Pre-trained Image-Text Model to Video ...
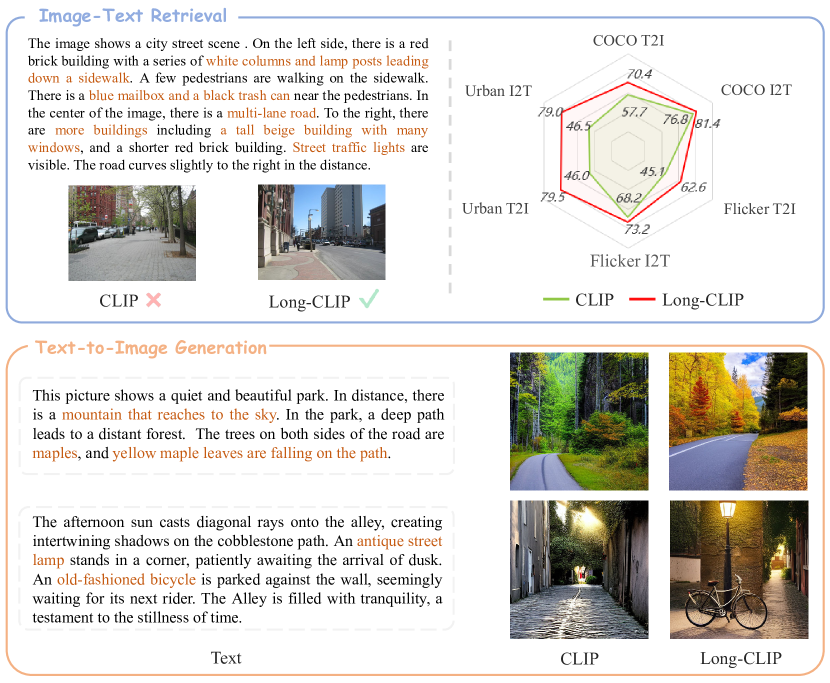
[2403.15378] Long-CLIP: Unlocking the Long-Text Capability of CLIP