
Pdf Self Distilled Vision Transformer For Domain Generalization

(PDF) Self-Distilled Vision Transformer for Domain Generalization

Self-Distilled Vision Transformer for Domain Generalization

(PDF) Prompt Vision Transformer for Domain Generalization

Self-Distilled Vision Transformer for Domain Generalization

Self-Distilled Vision Transformer for Domain Generalization
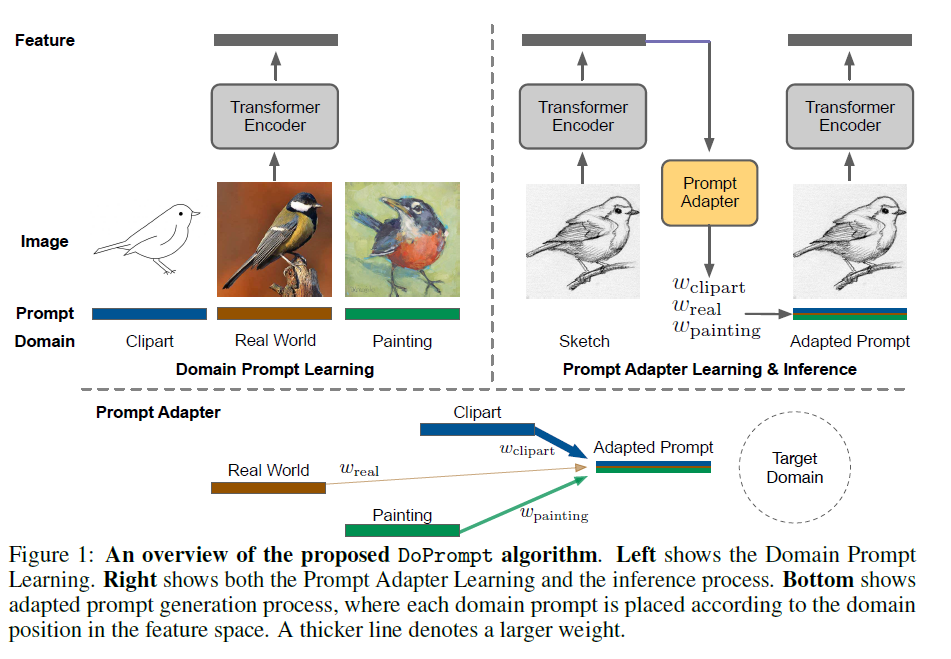
Prompt Vision Transformer for Domain Generalization · Issue #273 · One ...
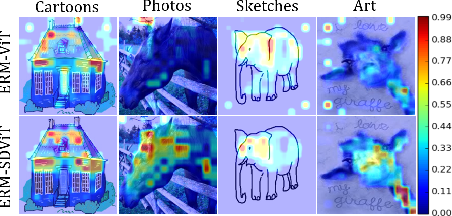
Figure 2 from Self-Distilled Vision Transformer for Domain ...
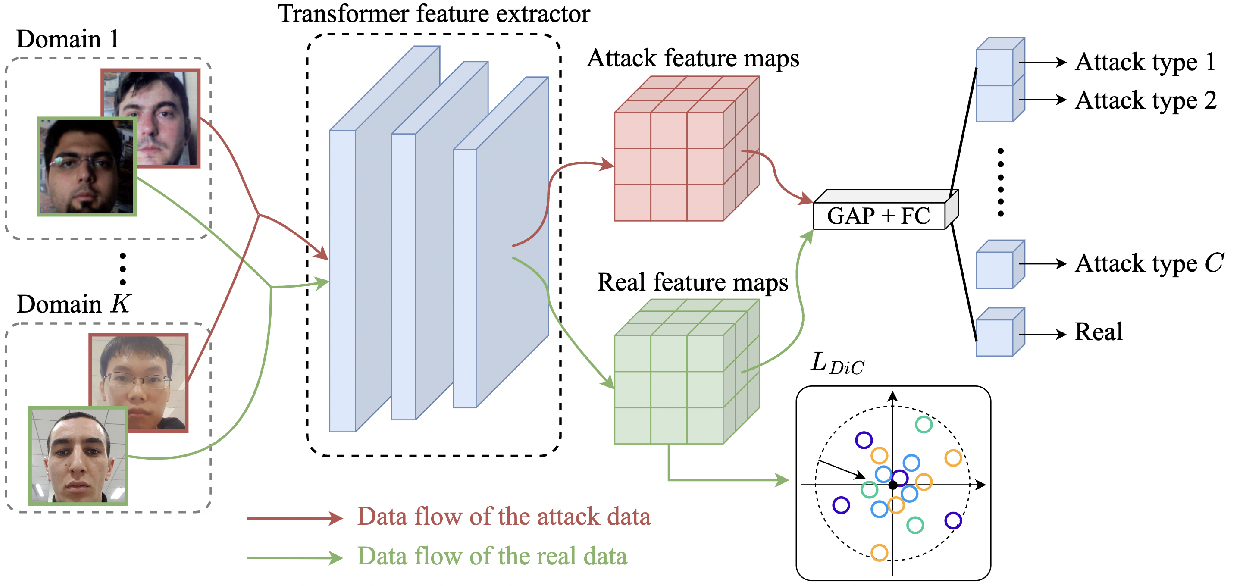
Figure 1 from Domain Invariant Vision Transformer Learning for Face ...

A Simple Single-Scale Vision Transformer For Object Localization | PDF ...

(PDF) EPVT: Environment-aware Prompt Vision Transformer for Domain ...
Advertisement Space (300x250)

(PDF) Domain Adaptation for Efficiently Fine-tuning Vision Transformer ...

Figure 12 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Vision Transformer for Small Datasets | PDF | Computational ...

Self-training transformer for source-free domain adaptation | Request PDF

Figure 1 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Figure 11 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Yang TVT Transferable Vision Transformer For Unsupervised Domain ...

Proposed self-distillation in ViTs for domain generalization ...

Self-supervised Vision Transformer are Scalable Generative Models for ...

(PDF) Vision Transformer based Embeddings Extractor for Unsupervised ...
Advertisement Space (336x280)

(PDF) Vision Transformer Adapters for Generalizable Multitask Learning

Learning cross-domain representations by vision transformer for ...

Vision Transformers For Single Image Dehazing - 1-3 | PDF | Image ...

(PDF) Style-Adaptive Detection Transformer for Single-Source Domain ...

(PDF) SDViT: Stacking of Distilled Vision Transformers for Hand Gesture ...

(PDF) Vision Transformer With Enhanced Self-Attention for Few-Shot Ship ...

Self-Attention Vision Transformer With Transfer Learning For Efficient ...

Vision Transformer Adapters for Generalizable Multitask Learning

Frontiers | Distilled vision transformers with CNN fusion for robust ...

(PDF) A vision transformer architecture for the automated segmentation ...
Advertisement Space (336x280)

Vision Transformer | PDF

(PDF) Self-evolving vision transformer for chest X-ray diagnosis ...

(PDF) A Vision Transformer Architecture for the Automated Segmentation ...

(PDF) TransAdapter: Vision Transformer for Feature-Centric Unsupervised ...

Figure 2 from A Novel Vision Transformer with Residual in Self ...

SDViT: Stacking of Distilled Vision Transformers for Hand Gesture ...