
Self Distilled Vision Transformer For Domain Generalization

(PDF) Self-Distilled Vision Transformer for Domain Generalization
[2207.12392] Self-Distilled Vision Transformer for Domain Generalization

Self-Distilled Vision Transformer for Domain Generalization

Self-Distilled Vision Transformer for Domain Generalization
[2207.12392] Self-Distilled Vision Transformer for Domain Generalization

(PDF) Prompt Vision Transformer for Domain Generalization
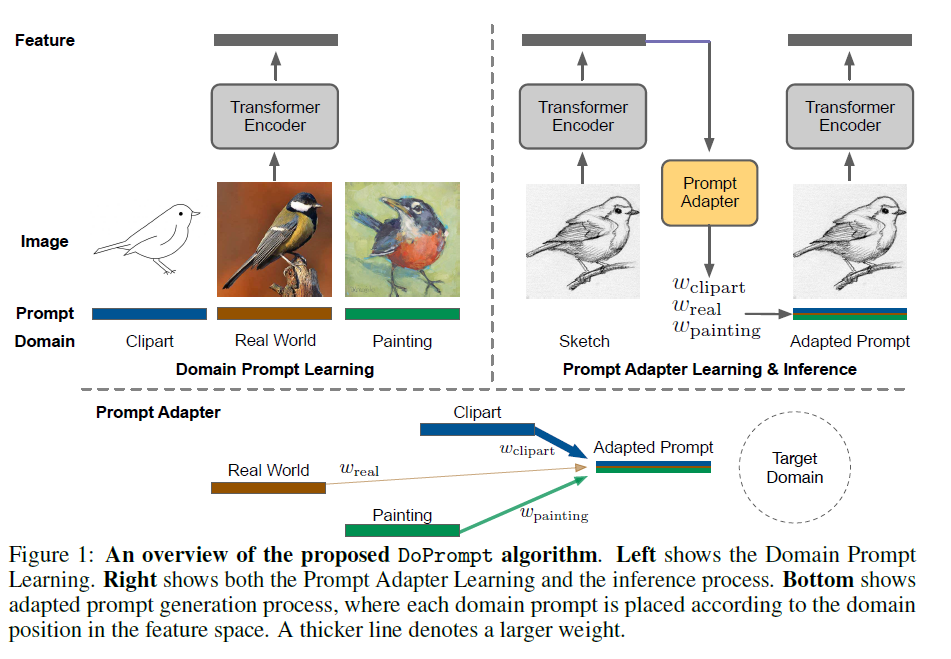
Prompt Vision Transformer for Domain Generalization · Issue #273 · One ...
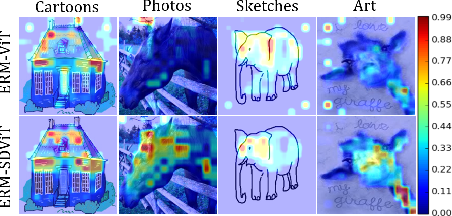
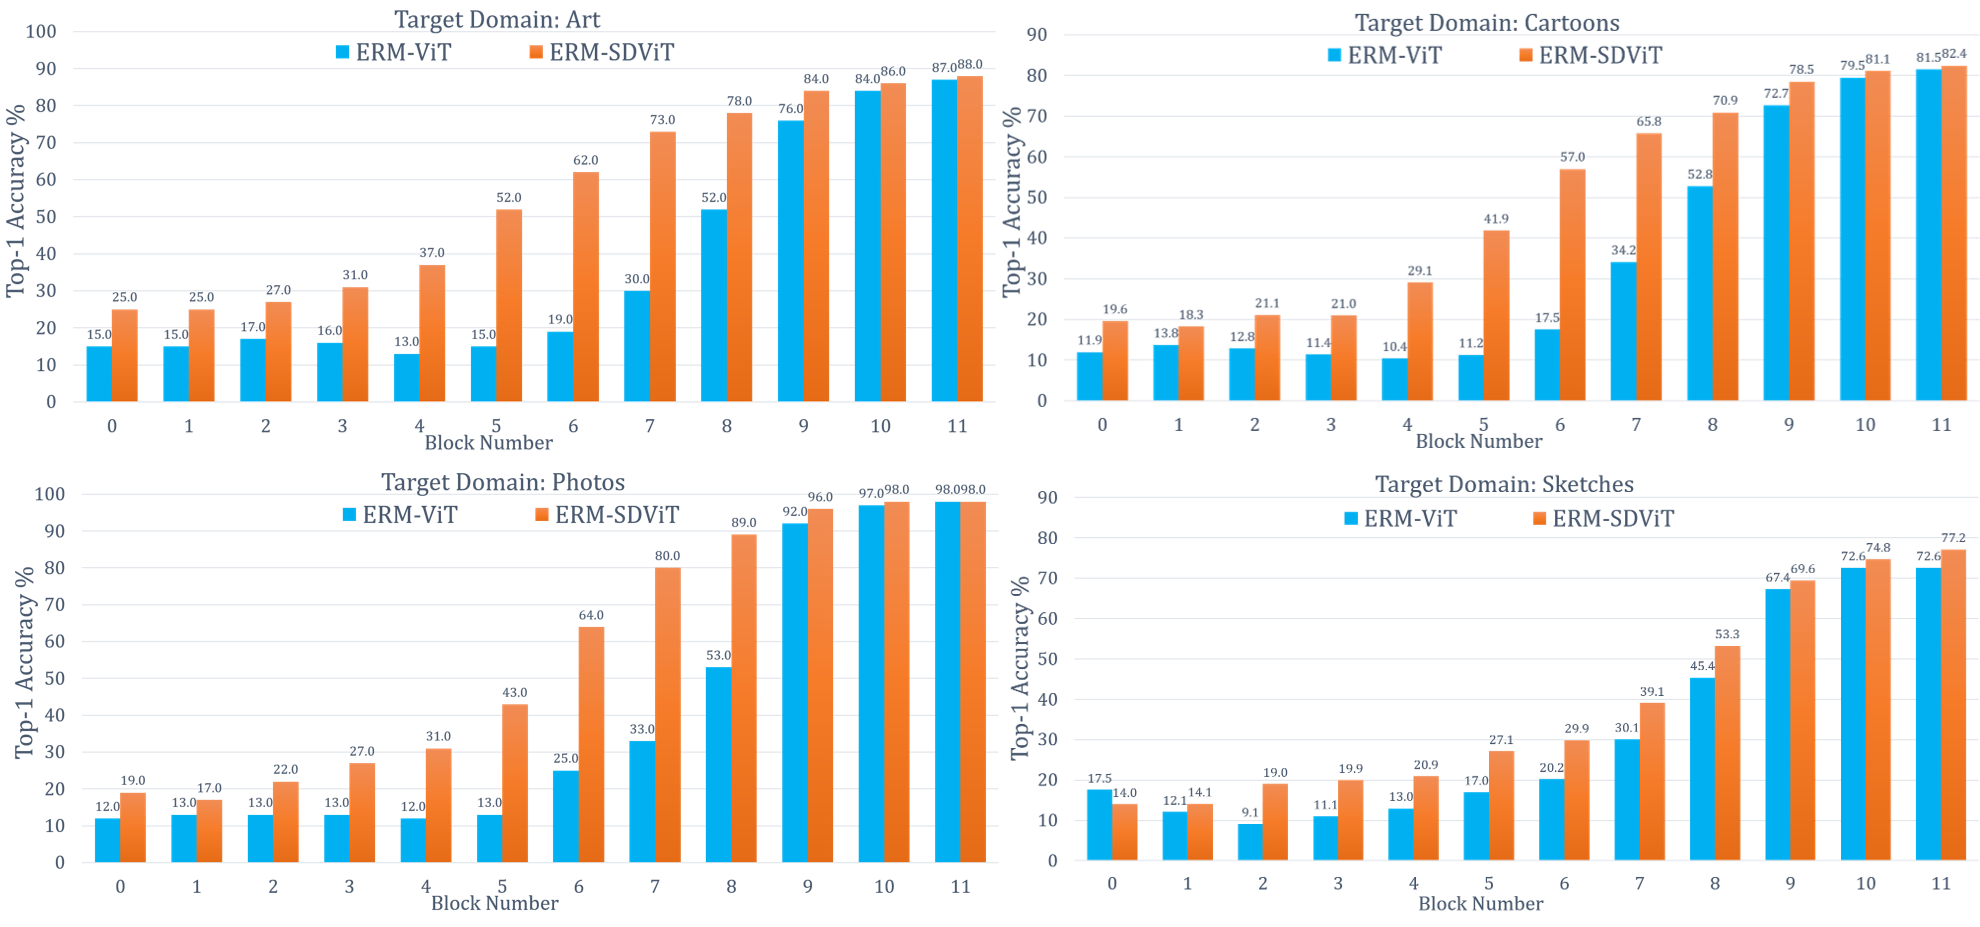
Figure 2 from Self-Distilled Vision Transformer for Domain ...
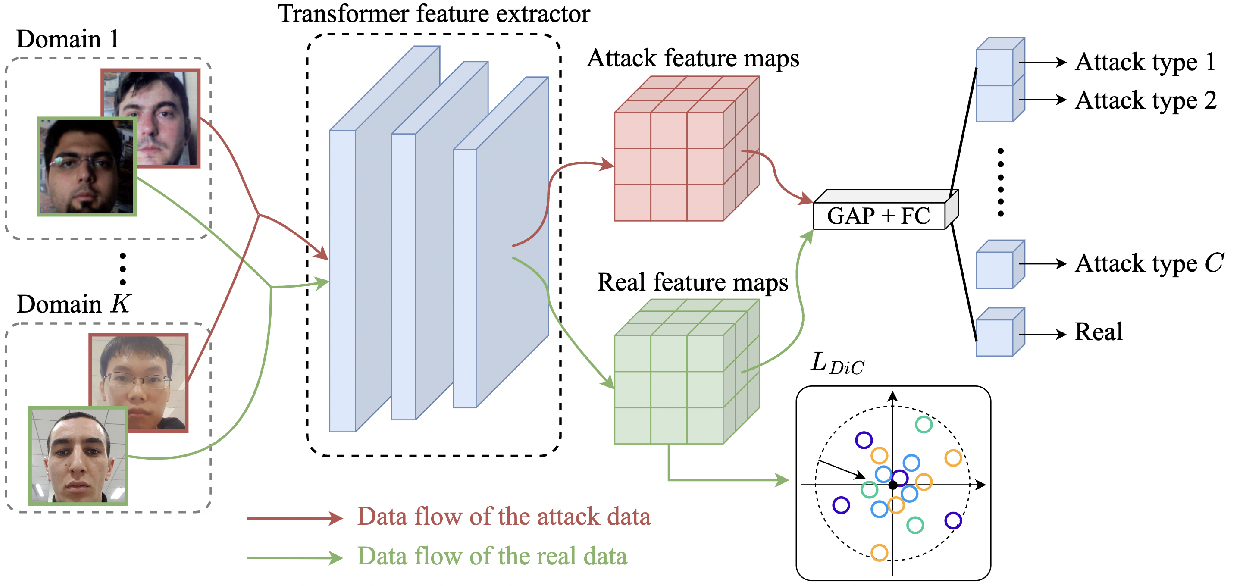
Figure 1 from Domain Invariant Vision Transformer Learning for Face ...

Figure 1 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...
Advertisement Space (300x250)

Proposed self-distillation in ViTs for domain generalization ...

Proposed self-distillation in ViTs for domain generalization ...

Vision Transformer Adapters for Generalizable Multitask Learning

SDViT: Stacking of Distilled Vision Transformers for Hand Gesture ...

SDViT: Stacking of Distilled Vision Transformers for Hand Gesture ...

The architecture of Vision Transformer Model for image classification ...

(PDF) Vision Transformer based Embeddings Extractor for Unsupervised ...
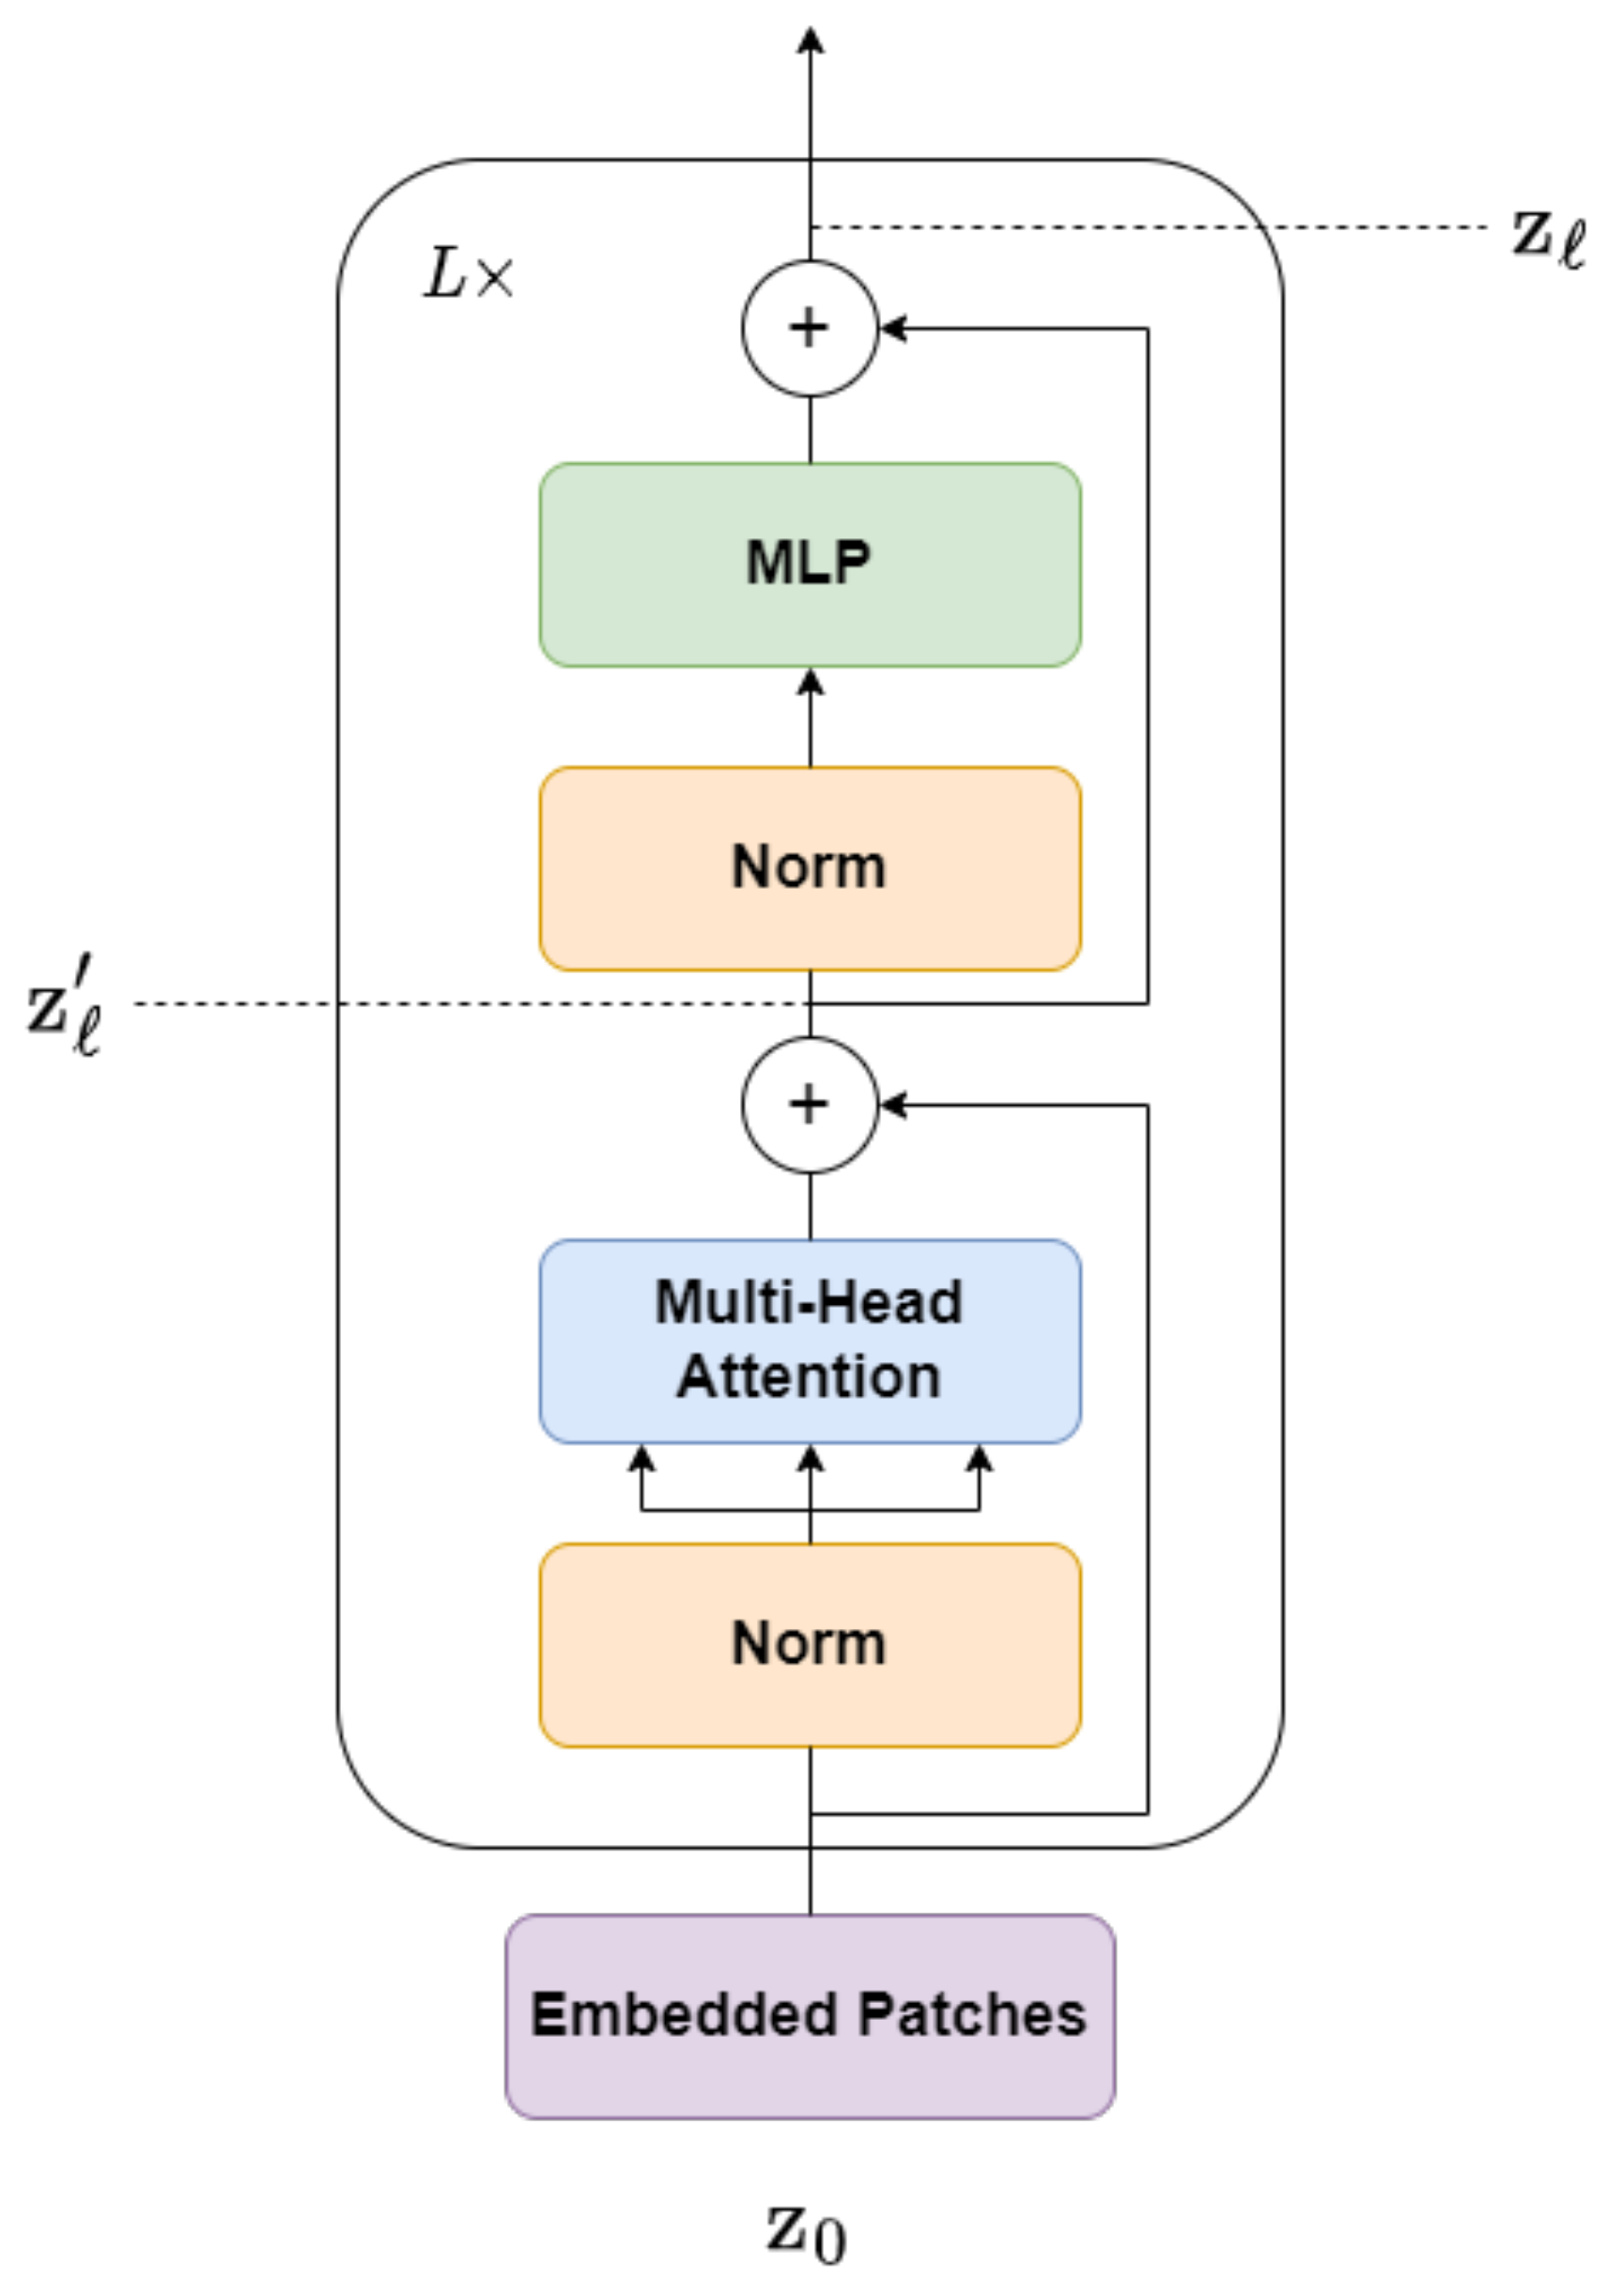
SDViT: Stacking of Distilled Vision Transformers for Hand Gesture ...

Vision Transformer Adapters for Generalizable Multitask Learning | DeepAI

Figure 2 from A Novel Vision Transformer with Residual in Self ...
Advertisement Space (336x280)

SDViT: Stacking of Distilled Vision Transformers for Hand Gesture ...

Self-supervised Vision Transformer are Scalable Generative Models for ...

SDViT: Stacking of Distilled Vision Transformers for Hand Gesture ...

Frontiers | Distilled vision transformers with CNN fusion for robust ...

[논문 리뷰] Style-Adaptive Detection Transformer for Single-Source Domain ...

Intra-task Mutual Attention based Vision Transformer for Few-Shot ...

Vision Transformer Adapters for Generalizable Multitask Learning

Frequency Domain Adaptive Filters in Vision Transformers for Small ...

Figure 2 from Vision Transformers in Domain Adaptation and ...
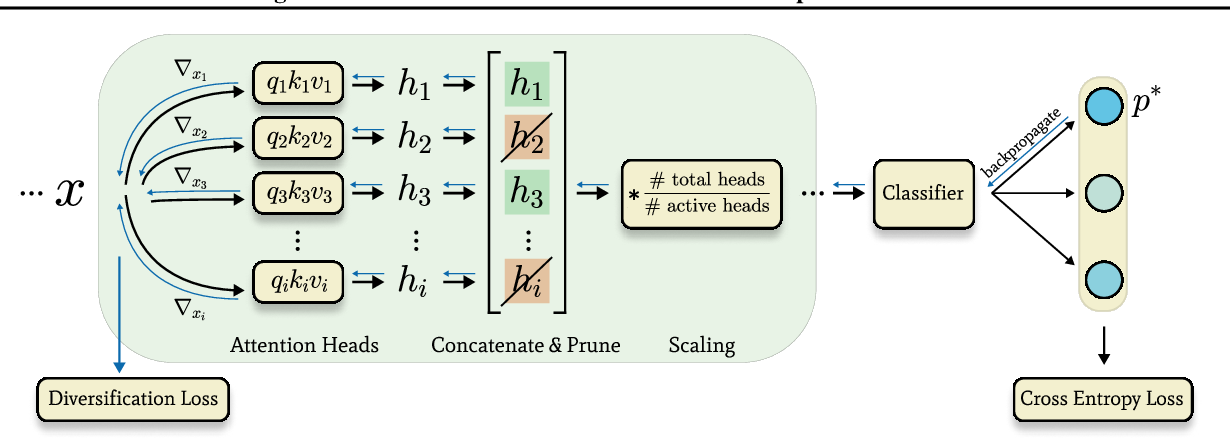
Figure 1 from Learning Diverse Features in Vision Transformers for ...
Advertisement Space (336x280)

Vision transformers in domain adaptation and domain generalization: a ...
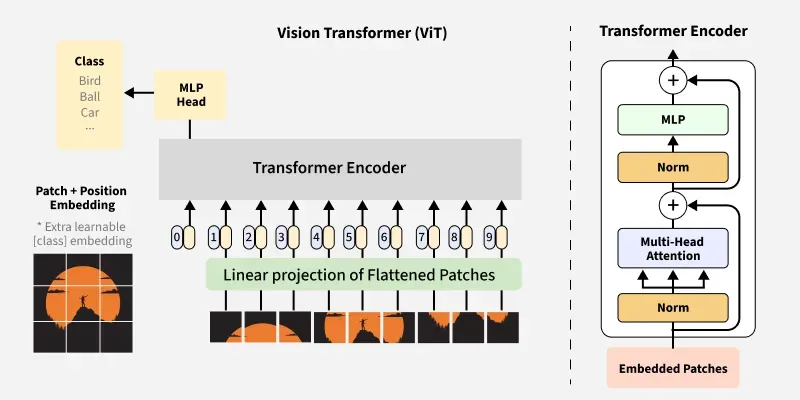
Vision Transformer (ViT) Architecture - GeeksforGeeks

Source-Free Domain Adaptation for RGB-D Semantic Segmentation with ...

Illustration of the vision transformer (ViT) and multi self-attention ...

Figure 2 from A Spatial-Temporal Transformer based on Domain ...

-General architecture of Vision Transformer VIT | Download Scientific ...