
Rethinking Key Value Cache Compression Techniques For Large Language

Rethinking Key-Value Cache Compression Techniques for Large Language ...

Rethinking Key-Value Cache Compression Techniques for Large Language ...

Figure 1 from Rethinking Key-Value Cache Compression Techniques for ...

Figure 10 from Rethinking Key-Value Cache Compression Techniques for ...

Figure 2 from Rethinking Key-Value Cache Compression Techniques for ...
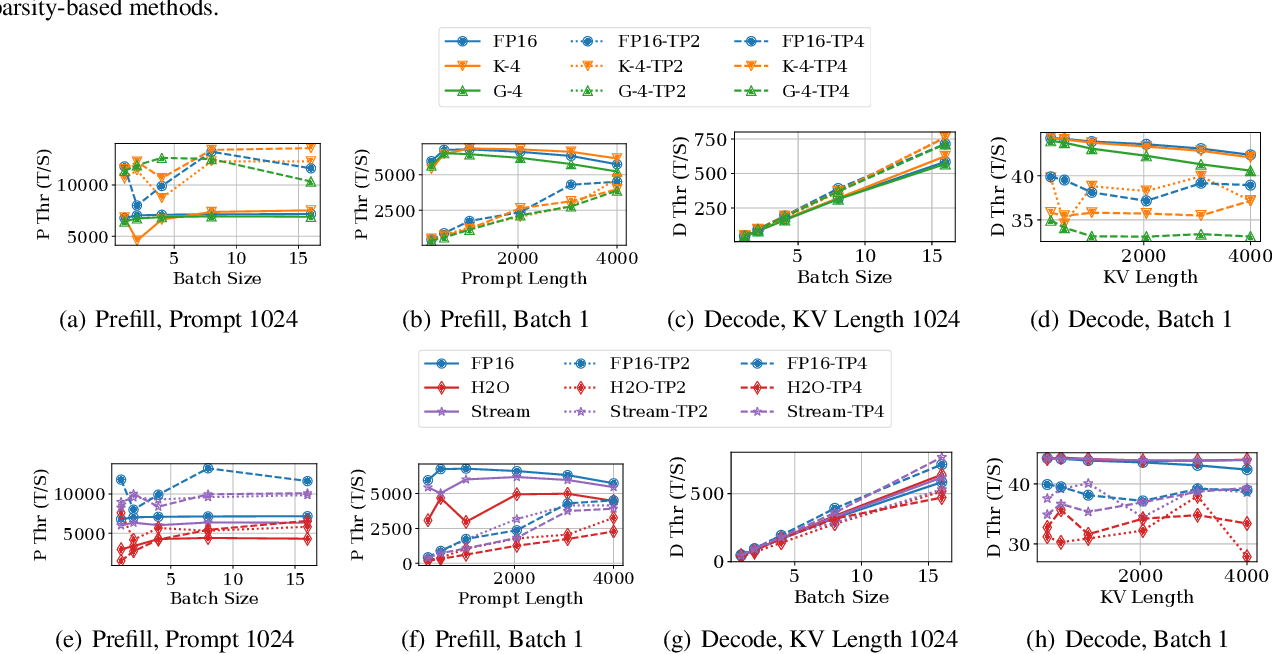
Figure 13 from Rethinking Key-Value Cache Compression Techniques for ...

Figure 14 from Rethinking Key-Value Cache Compression Techniques for ...
Rethinking KV Cache Compression Techniques for LLM Serving (25-mlsys ...
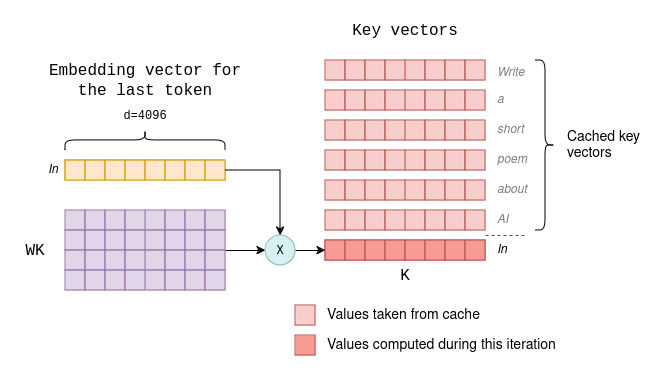
Techniques for KV Cache Optimization in Large Language Models

Table 1 from Rethinking Key-Value Cache Compression Techniques for ...
Advertisement Space (300x250)
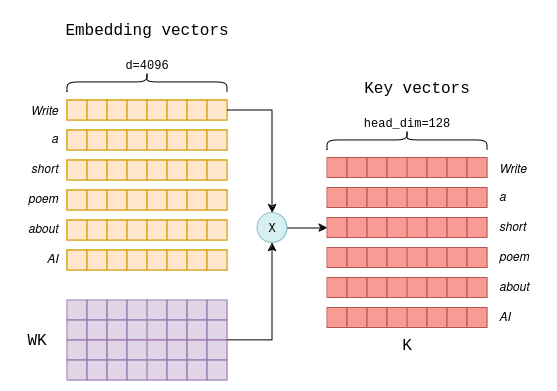
Techniques for KV Cache Optimization in Large Language Models
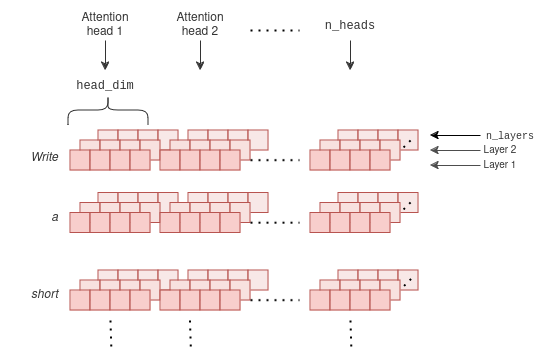
Techniques for KV Cache Optimization in Large Language Models
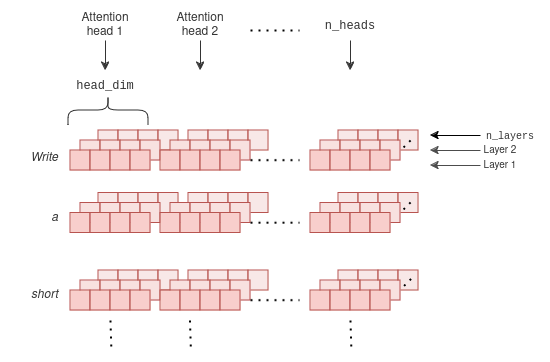
Techniques for KV Cache Optimization in Large Language Models

Table 11 from Rethinking Key-Value Cache Compression Techniques for ...
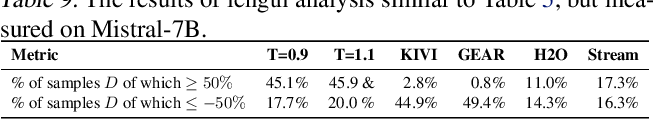
Table 9 from Rethinking Key-Value Cache Compression Techniques for ...

[논문 리뷰] Unifying KV Cache Compression for Large Language Models with LeanKV

Key Value Cache in Large Language Models Explained - YouTube
Top 10 KV Cache Compression Techniques for LLM Inference: Reducing ...

[论文评述] MiniCache: KV Cache Compression in Depth Dimension for Large ...

Key-Value Cache Compression for Long-Context LLMs: A Survey and Key ...
Advertisement Space (336x280)

A Method for Building Large Language Models with Predefined KV Cache ...
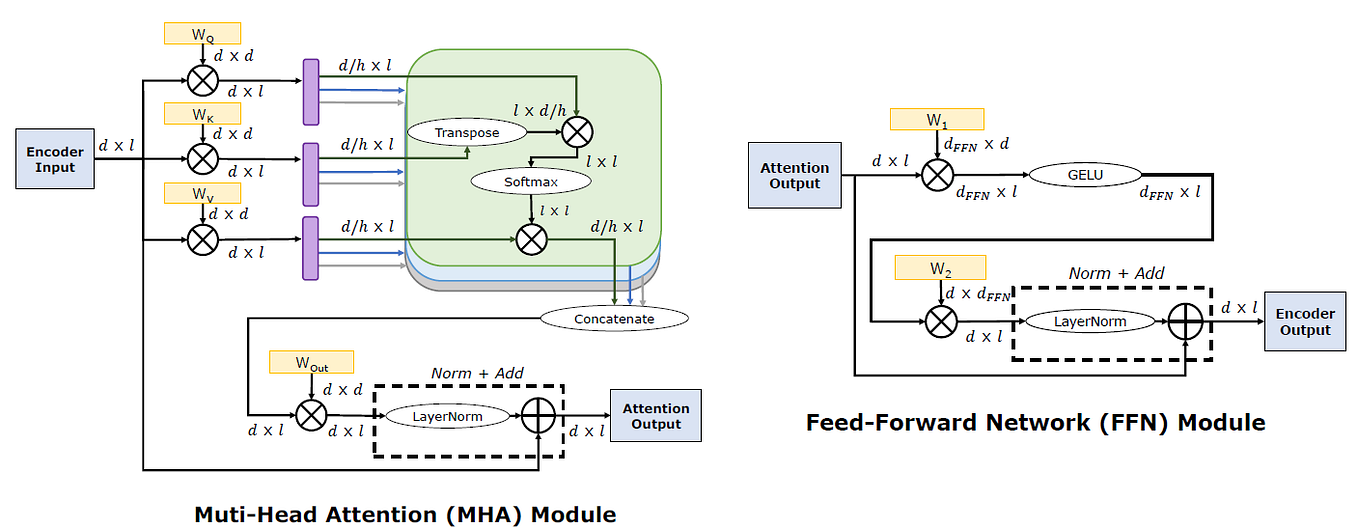
Key-Value Cache Compression for Long-Context LLMs: A Survey and Key ...
Memory Bank Compression for Continual Adaptation of Large Language ...
Top 10 KV Cache Compression Techniques for LLM Inference: Reducing ...
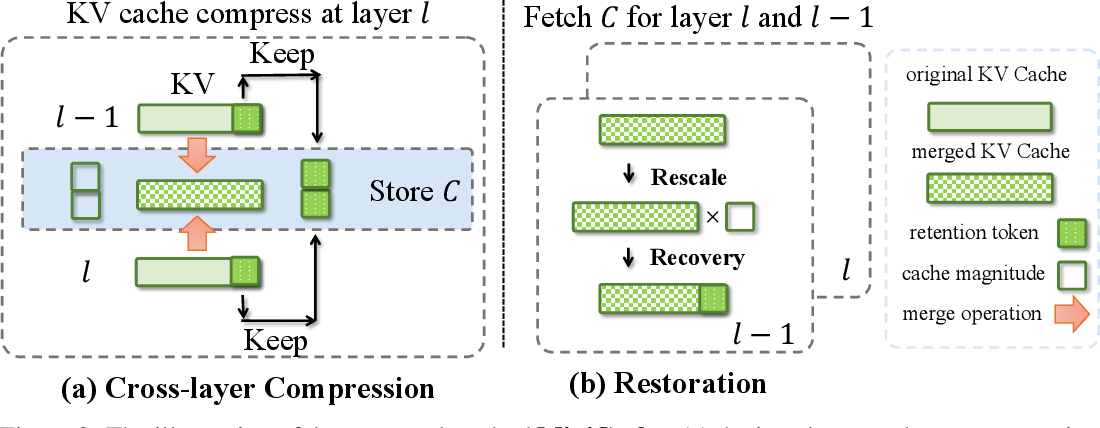
Figure 3 from MiniCache: KV Cache Compression in Depth Dimension for ...

KV Cache Compression for Inference Efficiency in LLMs: A Review | AI ...

Figure 1 from MiniCache: KV Cache Compression in Depth Dimension for ...
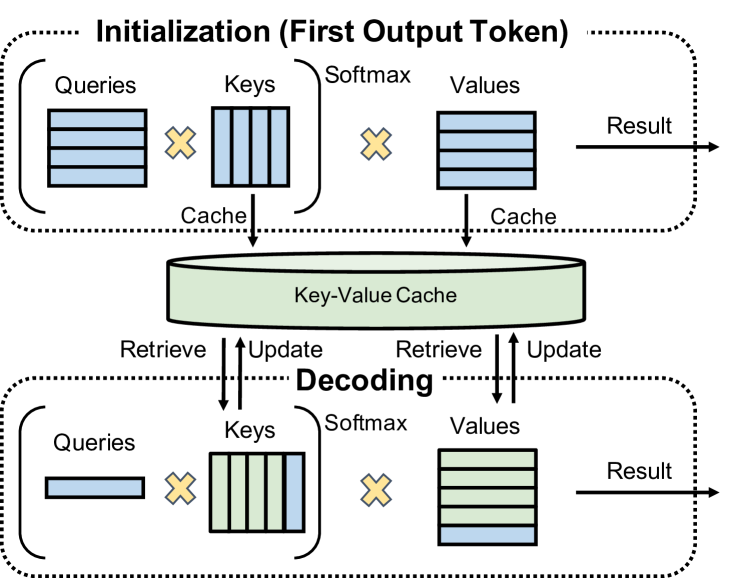
[2305.05920] Fast Distributed Inference Serving for Large Language Models
Unifying KV Cache Compression for LargeLanguage Models with LeanKV——使用 ...

Understanding the Physics of Key-Value Cache Compression for LLMs ...
Advertisement Space (336x280)
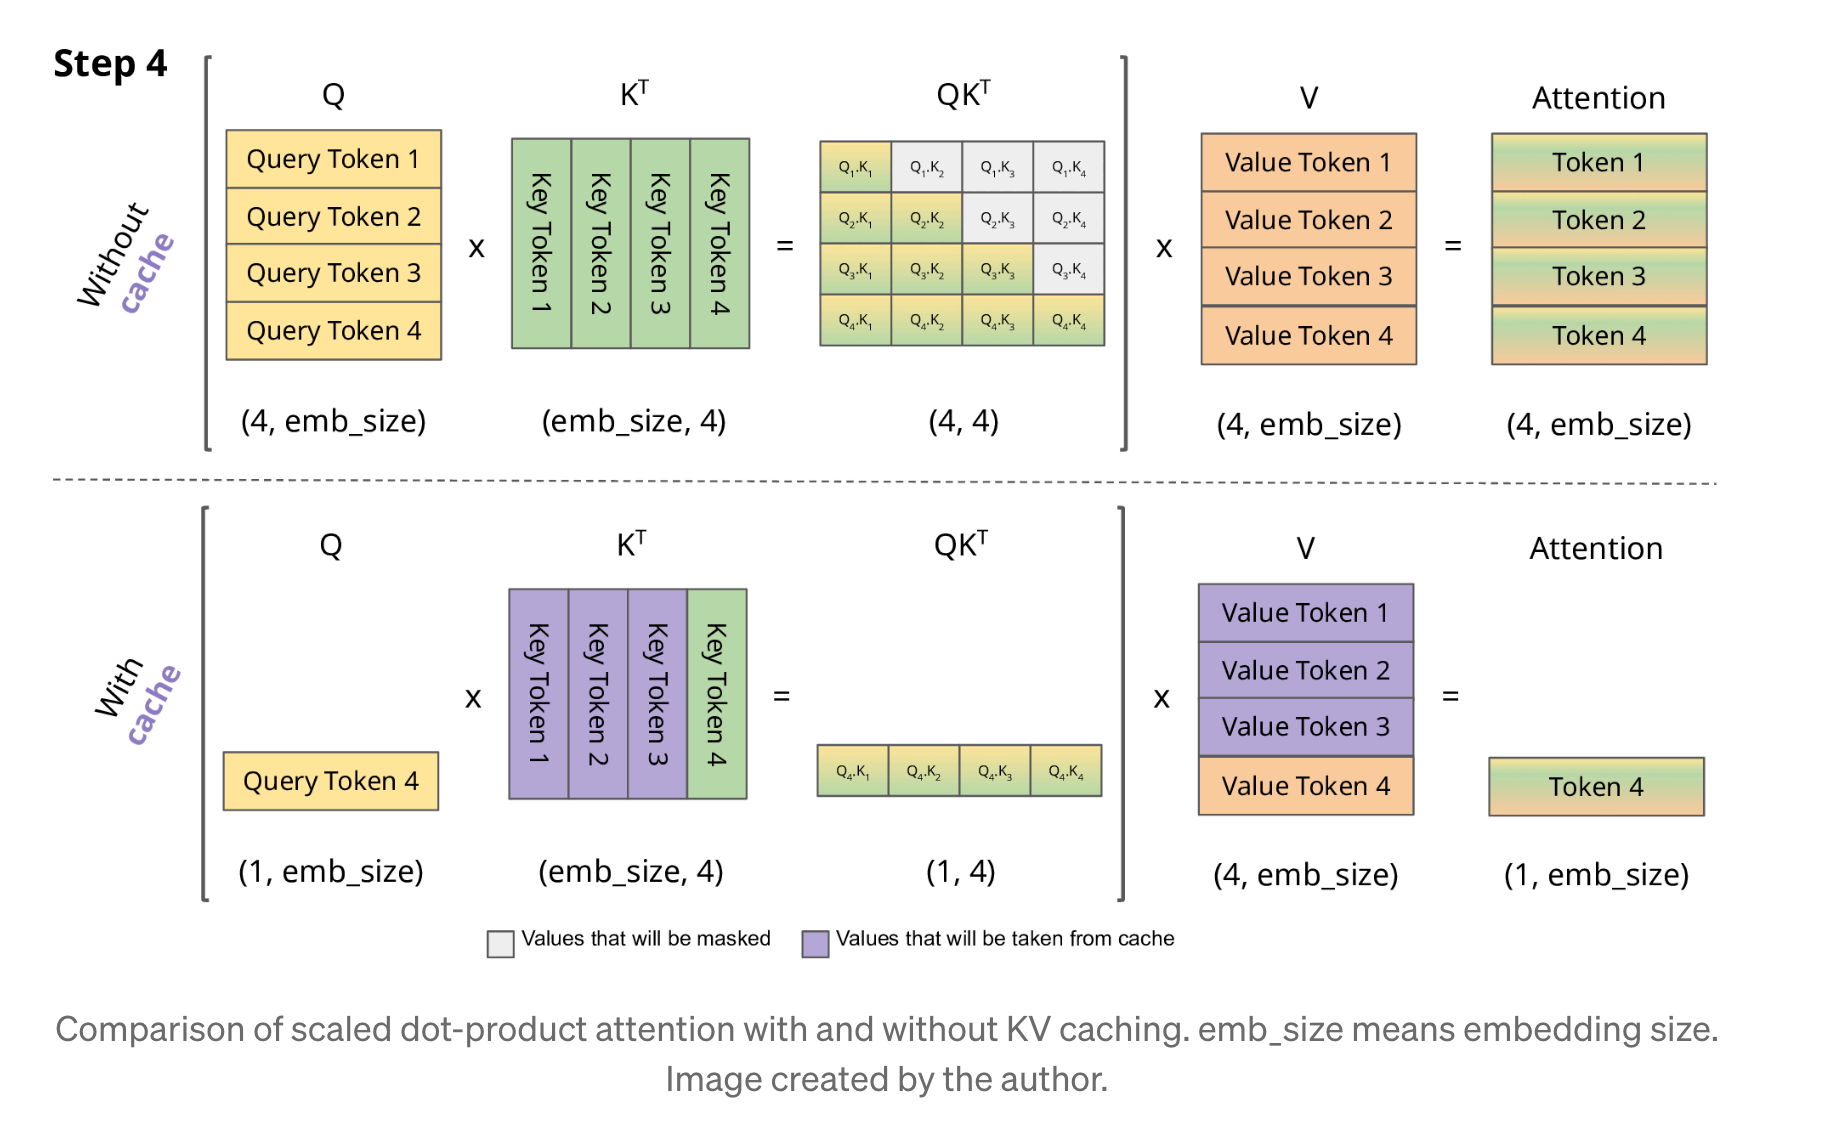
[논문 리뷰] Efficient Memory Management for Large Language Model Serving ...

KV Cache in Large Language Models: Design, Optimization, and Inference ...
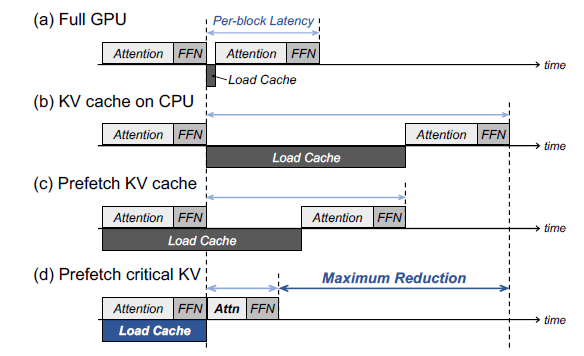
KV Cache compression with Inter-Layer Attention Similarity for ...
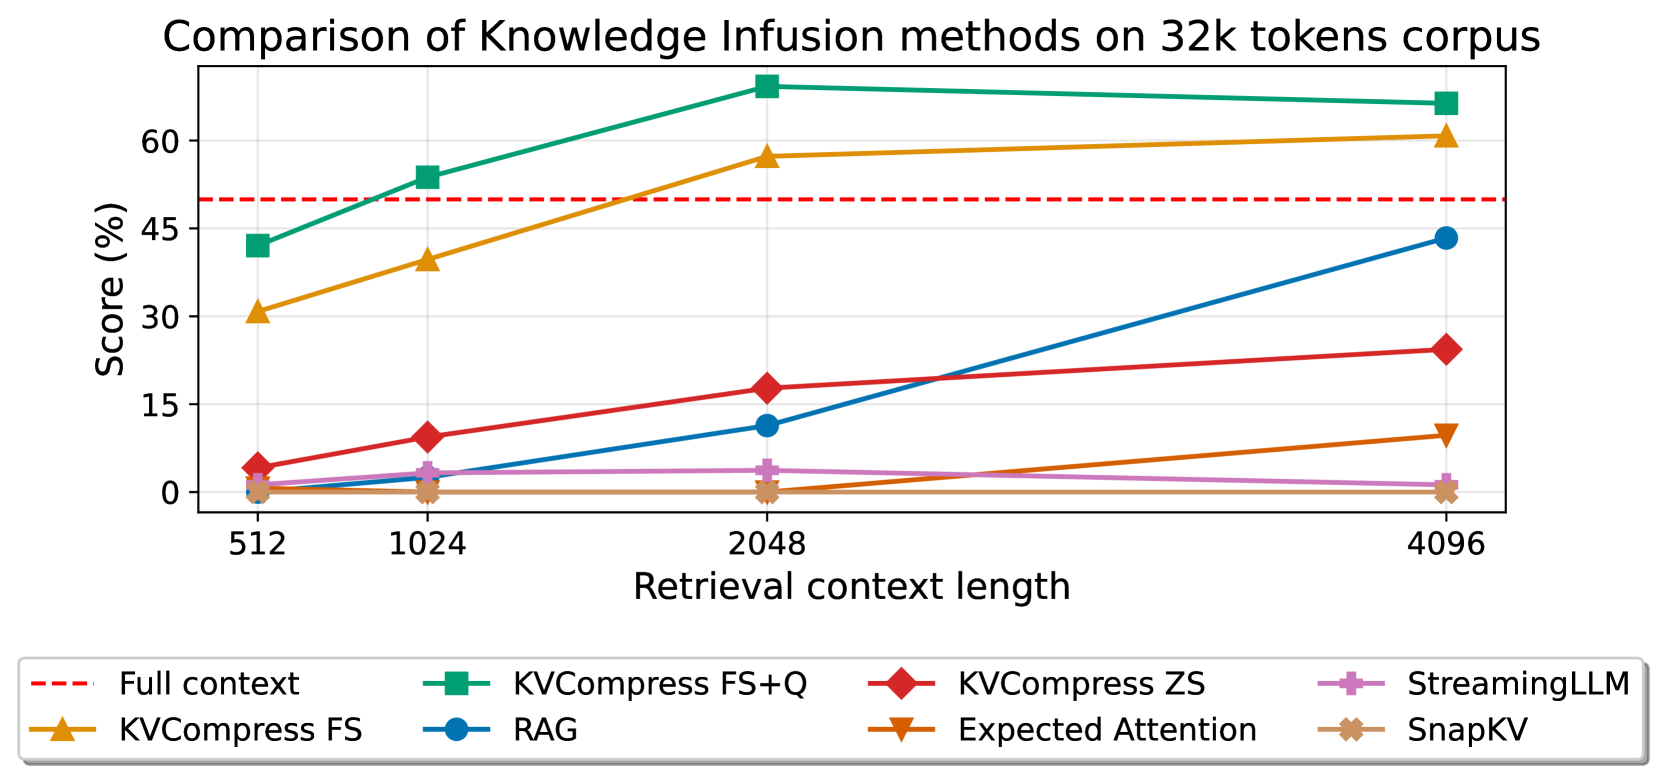
Beyond RAG: Task-Aware KV Cache Compression for Comprehensive Knowledge ...
CacheNotes: Task-Aware Key-Value Cache Compression for Reasoning ...

[논문 리뷰] A Survey on Large Language Model Acceleration based on KV Cache ...