
Table 1 From A Re Parameterized Vision Transformer Revt For Domain

Table 1 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Figure 1 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Table 10 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Table 11 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Table 4 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Table 3 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Table 2 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Table 1 from A Simple Vision Transformer for Weakly Semi-supervised 3D ...

Table 8 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Figure 12 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...
Advertisement Space (300x250)

Figure 11 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Figure 2 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Table 2 from Prompt Vision Transformer for Domain Generalization ...

Figure 5 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Figure 9 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Figure 7 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...
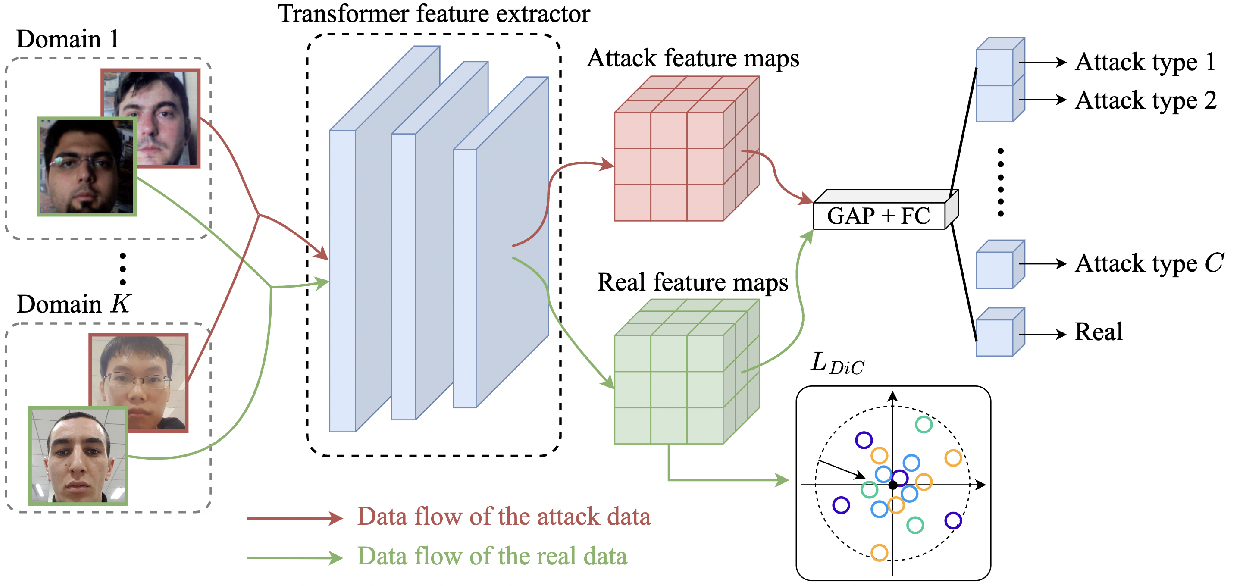
Figure 1 from Domain Invariant Vision Transformer Learning for Face ...
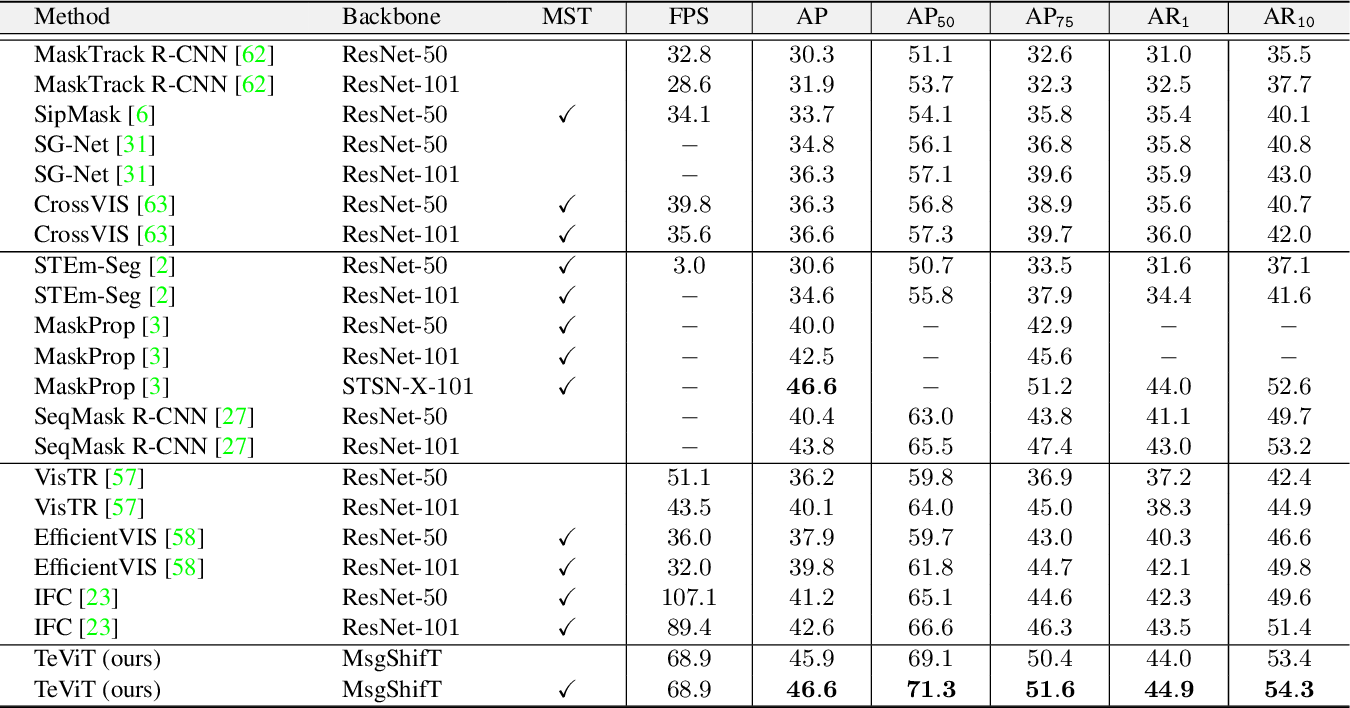
Table 1 from Temporally Efficient Vision Transformer for Video Instance ...

Table 1 from Pretraining the Vision Transformer using self-supervised ...

Table I from Comparison of Transformer Models for Performance on Domain ...
Advertisement Space (336x280)
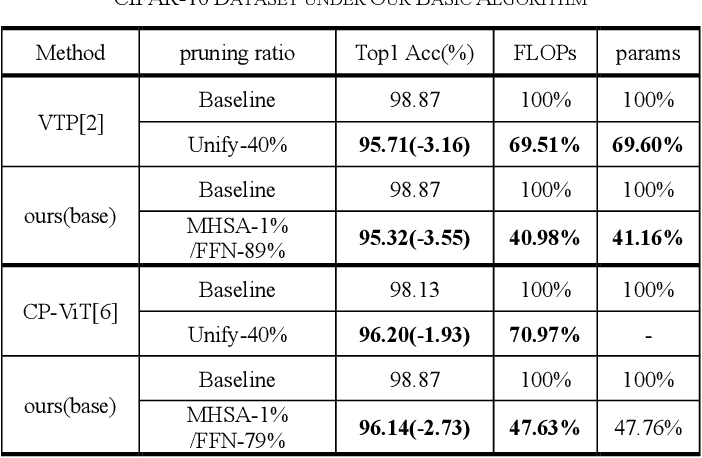
Table I from Automatic Hyper-Parameter Search for Vision Transformer ...
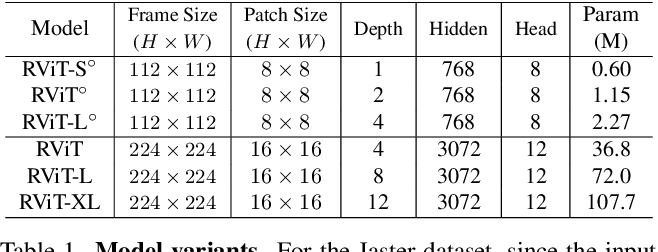
Table 1 from Recurring the Transformer for Video Action Recognition ...
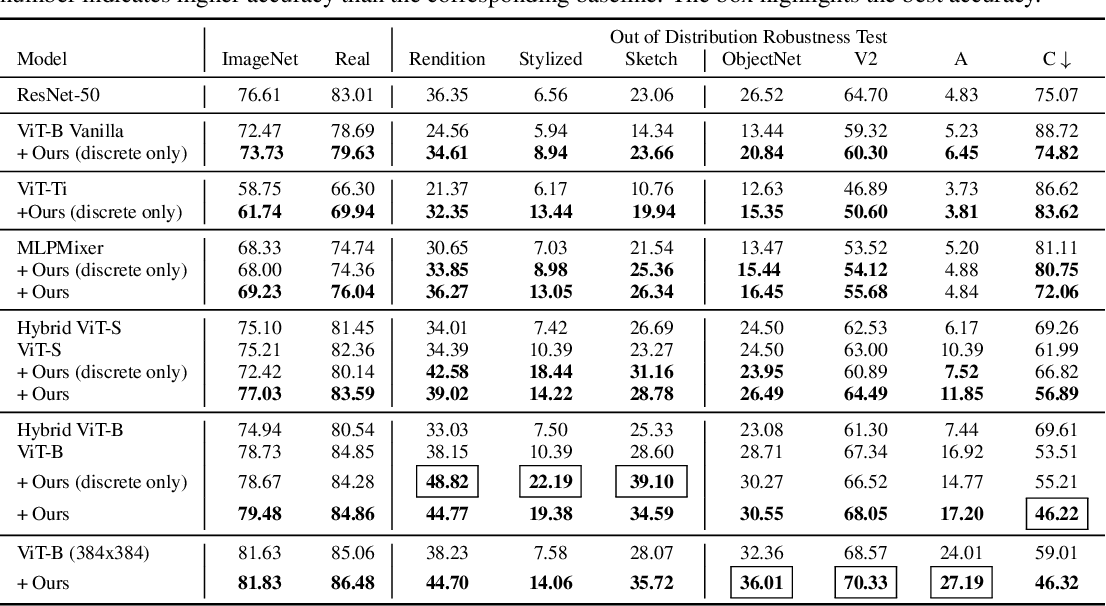
Table 1 from Discrete Representations Strengthen Vision Transformer ...
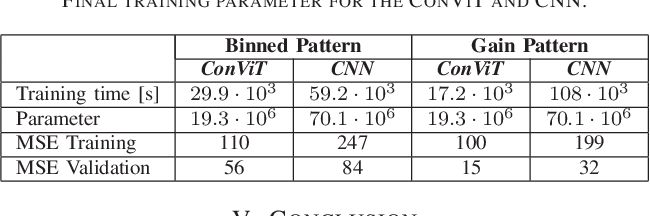
Table I from Vision Transformer for Beamforming on Phased Array ...

Table 1 from Exploring Self-Supervised Vision Transformers for Deepfake ...

Table 1 from Vision Transformers are Parameter-Efficient Audio-Visual ...

Table 1 from Enhancing Parameter-Efficient Fine-Tuning of Vision ...

Table 1 from AUFormer: Vision Transformers are Parameter-Efficient ...
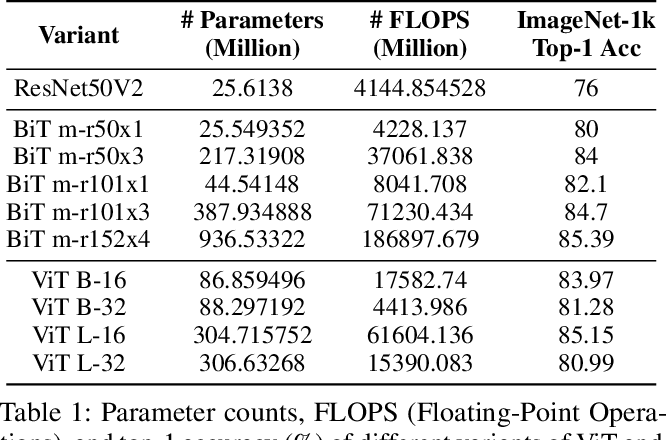
Table 1 from Vision Transformers are Robust Learners | Semantic Scholar
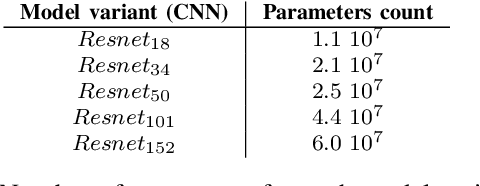
Table I from Combining pre-trained Vision Transformers and CIDER for ...
Advertisement Space (336x280)

Table 1 from Grafting Vision Transformers | Semantic Scholar

Table 1 from Vision Transformers are Parameter-Efficient Audio-Visual ...

Figure 3 from A Lightweight Convolution and Vision Transformer ...
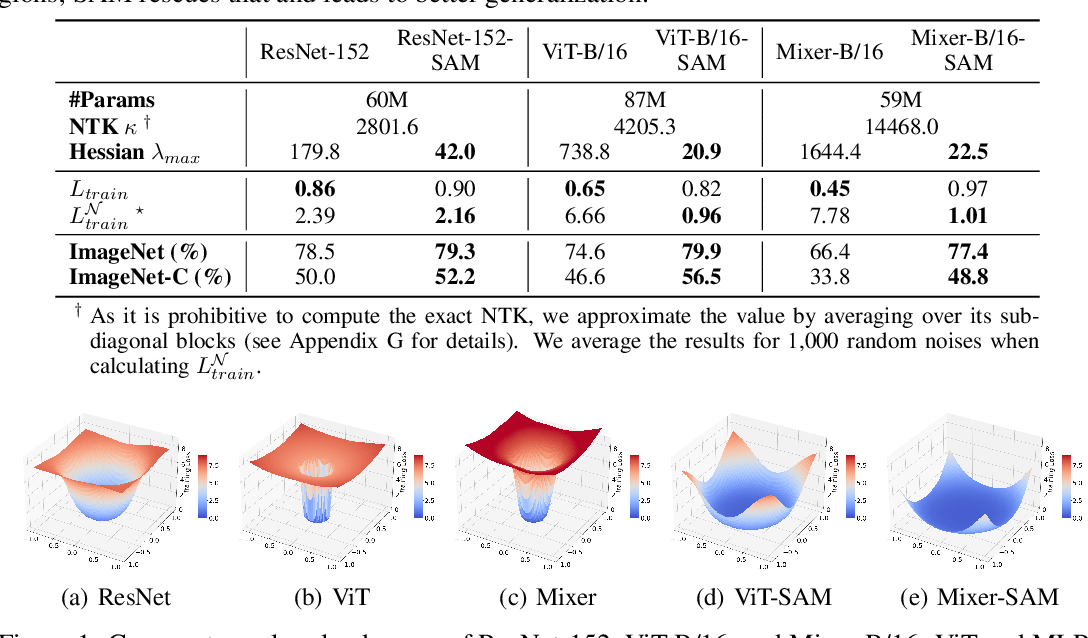
Table 1 from When Vision Transformers Outperform ResNets without ...

Figure 1 from Vision Transformer-based Adversarial Domain Adaptation ...
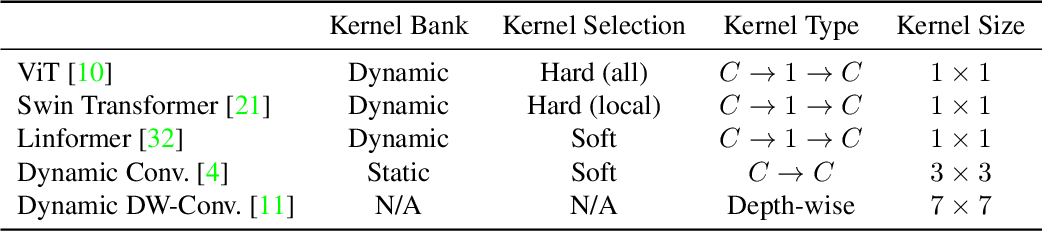
Table 1 from Interpret Vision Transformers as ConvNets with Dynamic ...