
Table 1 From Learning Text Image Joint Embedding For Efficient Cross

Table 1 from Learning Text-image Joint Embedding for Efficient Cross ...
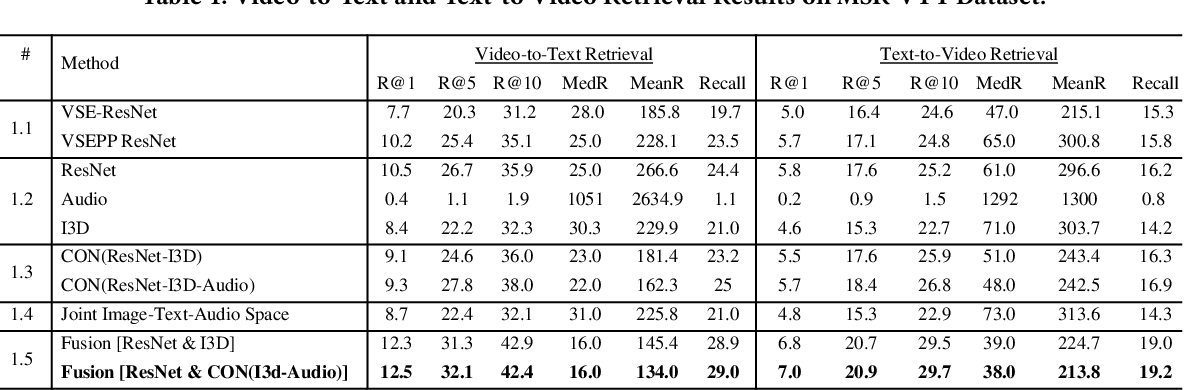
Table 1 from Learning Joint Embedding with Multimodal Cues for Cross ...

Table I from Semantic Embedding Uncertainty Learning for Image and Text ...

Figure 1 from Learning Joint Embedding for Cross-Modal Retrieval ...

Figure 1 from JECL: Joint Embedding and Cluster Learning for Image-Text ...

Figure 1 from Joint Input-Label Embedding for Neural Text ...

Figure 1 from A Multi-View Joint Learning Framework for Embedding ...

Learning Text-Image Joint Embedding for Efficient Cross-Modal Retrieval ...
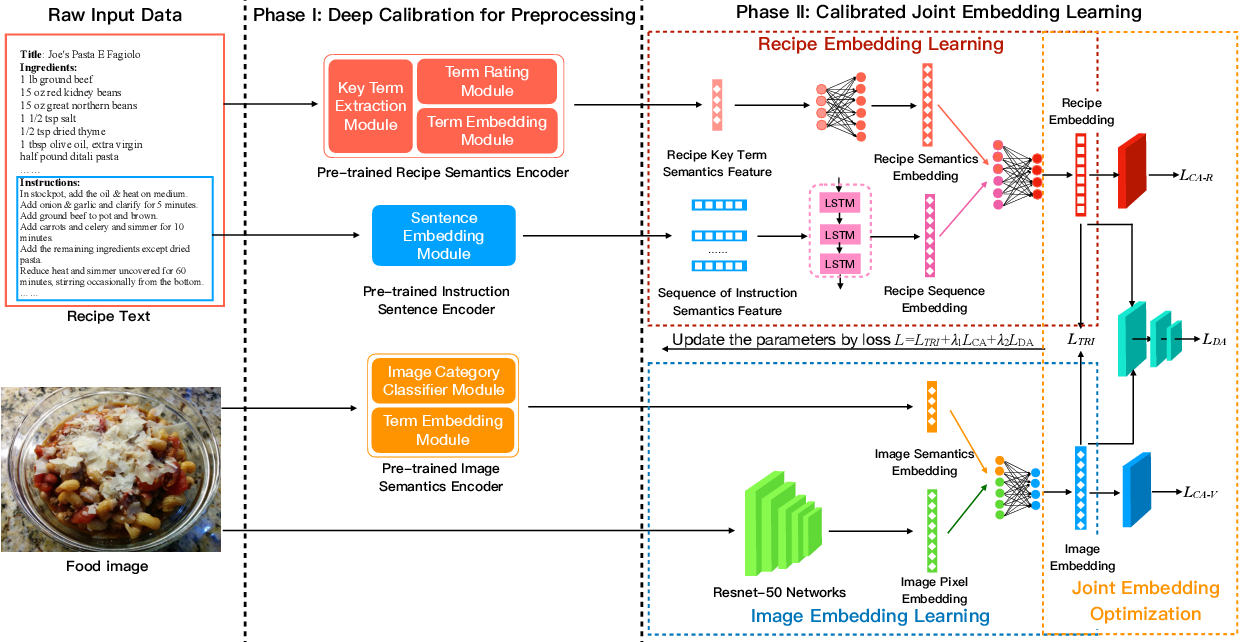
Figure 1 from Efficient Deep Feature Calibration for Cross-Modal Joint ...

Learning Text-Image Joint Embedding for Efficient Cross-Modal Retrieval ...
Advertisement Space (300x250)

Learning Text-Image Joint Embedding for Efficient Cross-Modal Retrieval ...

Figure 1 from Part2Word: Learning Joint Embedding of Point Clouds and ...
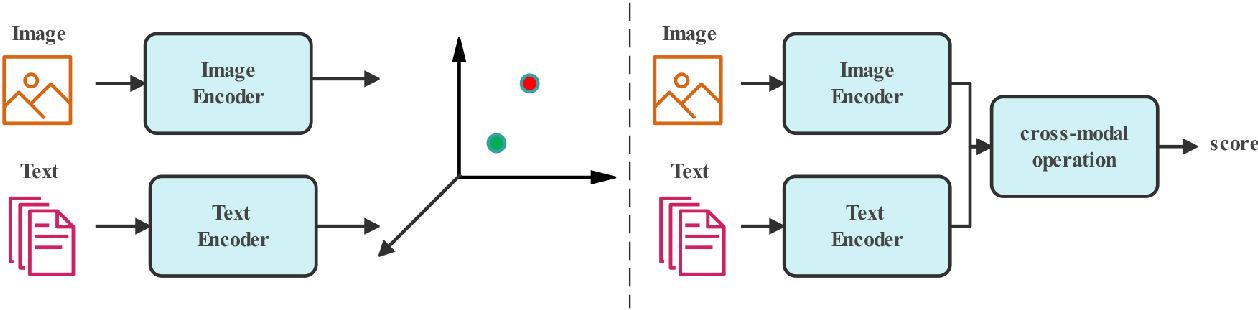
Figure 1 from Learning hierarchical embedding space for image-text ...

Table 1 from Exploring Joint Embedding Architectures and Data ...

Figure 1 from Appearance Codes using Joint Embedding Learning of ...
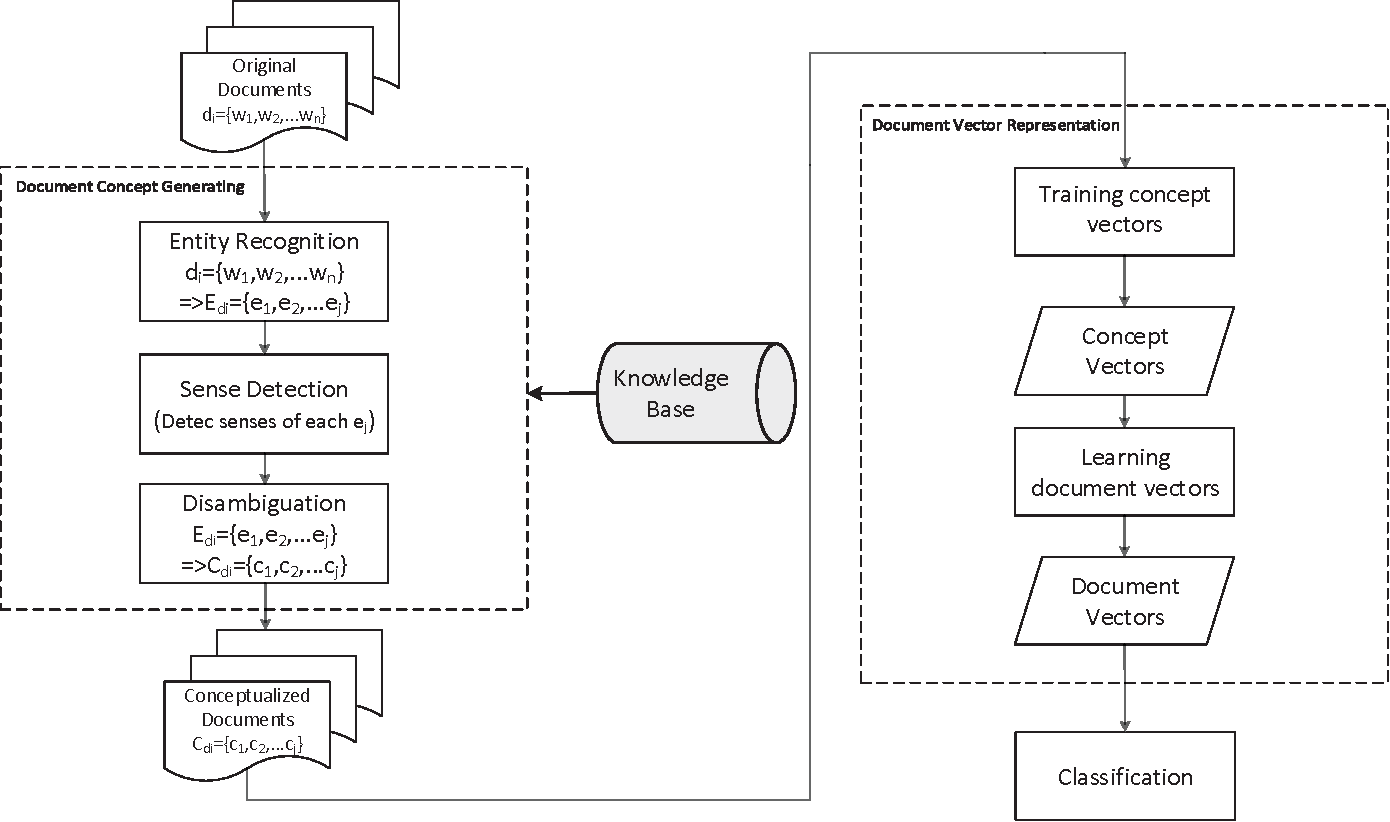
Figure 1 from Knowledge-based document embedding for cross-domain text ...

Figure 1 from Joint Language Semantic and Structure Embedding for ...

Deep Structured Joint Embedding for Image Text Matching - YouTube

(PDF) Learning Joint Embedding for Cross-Modal Retrieval
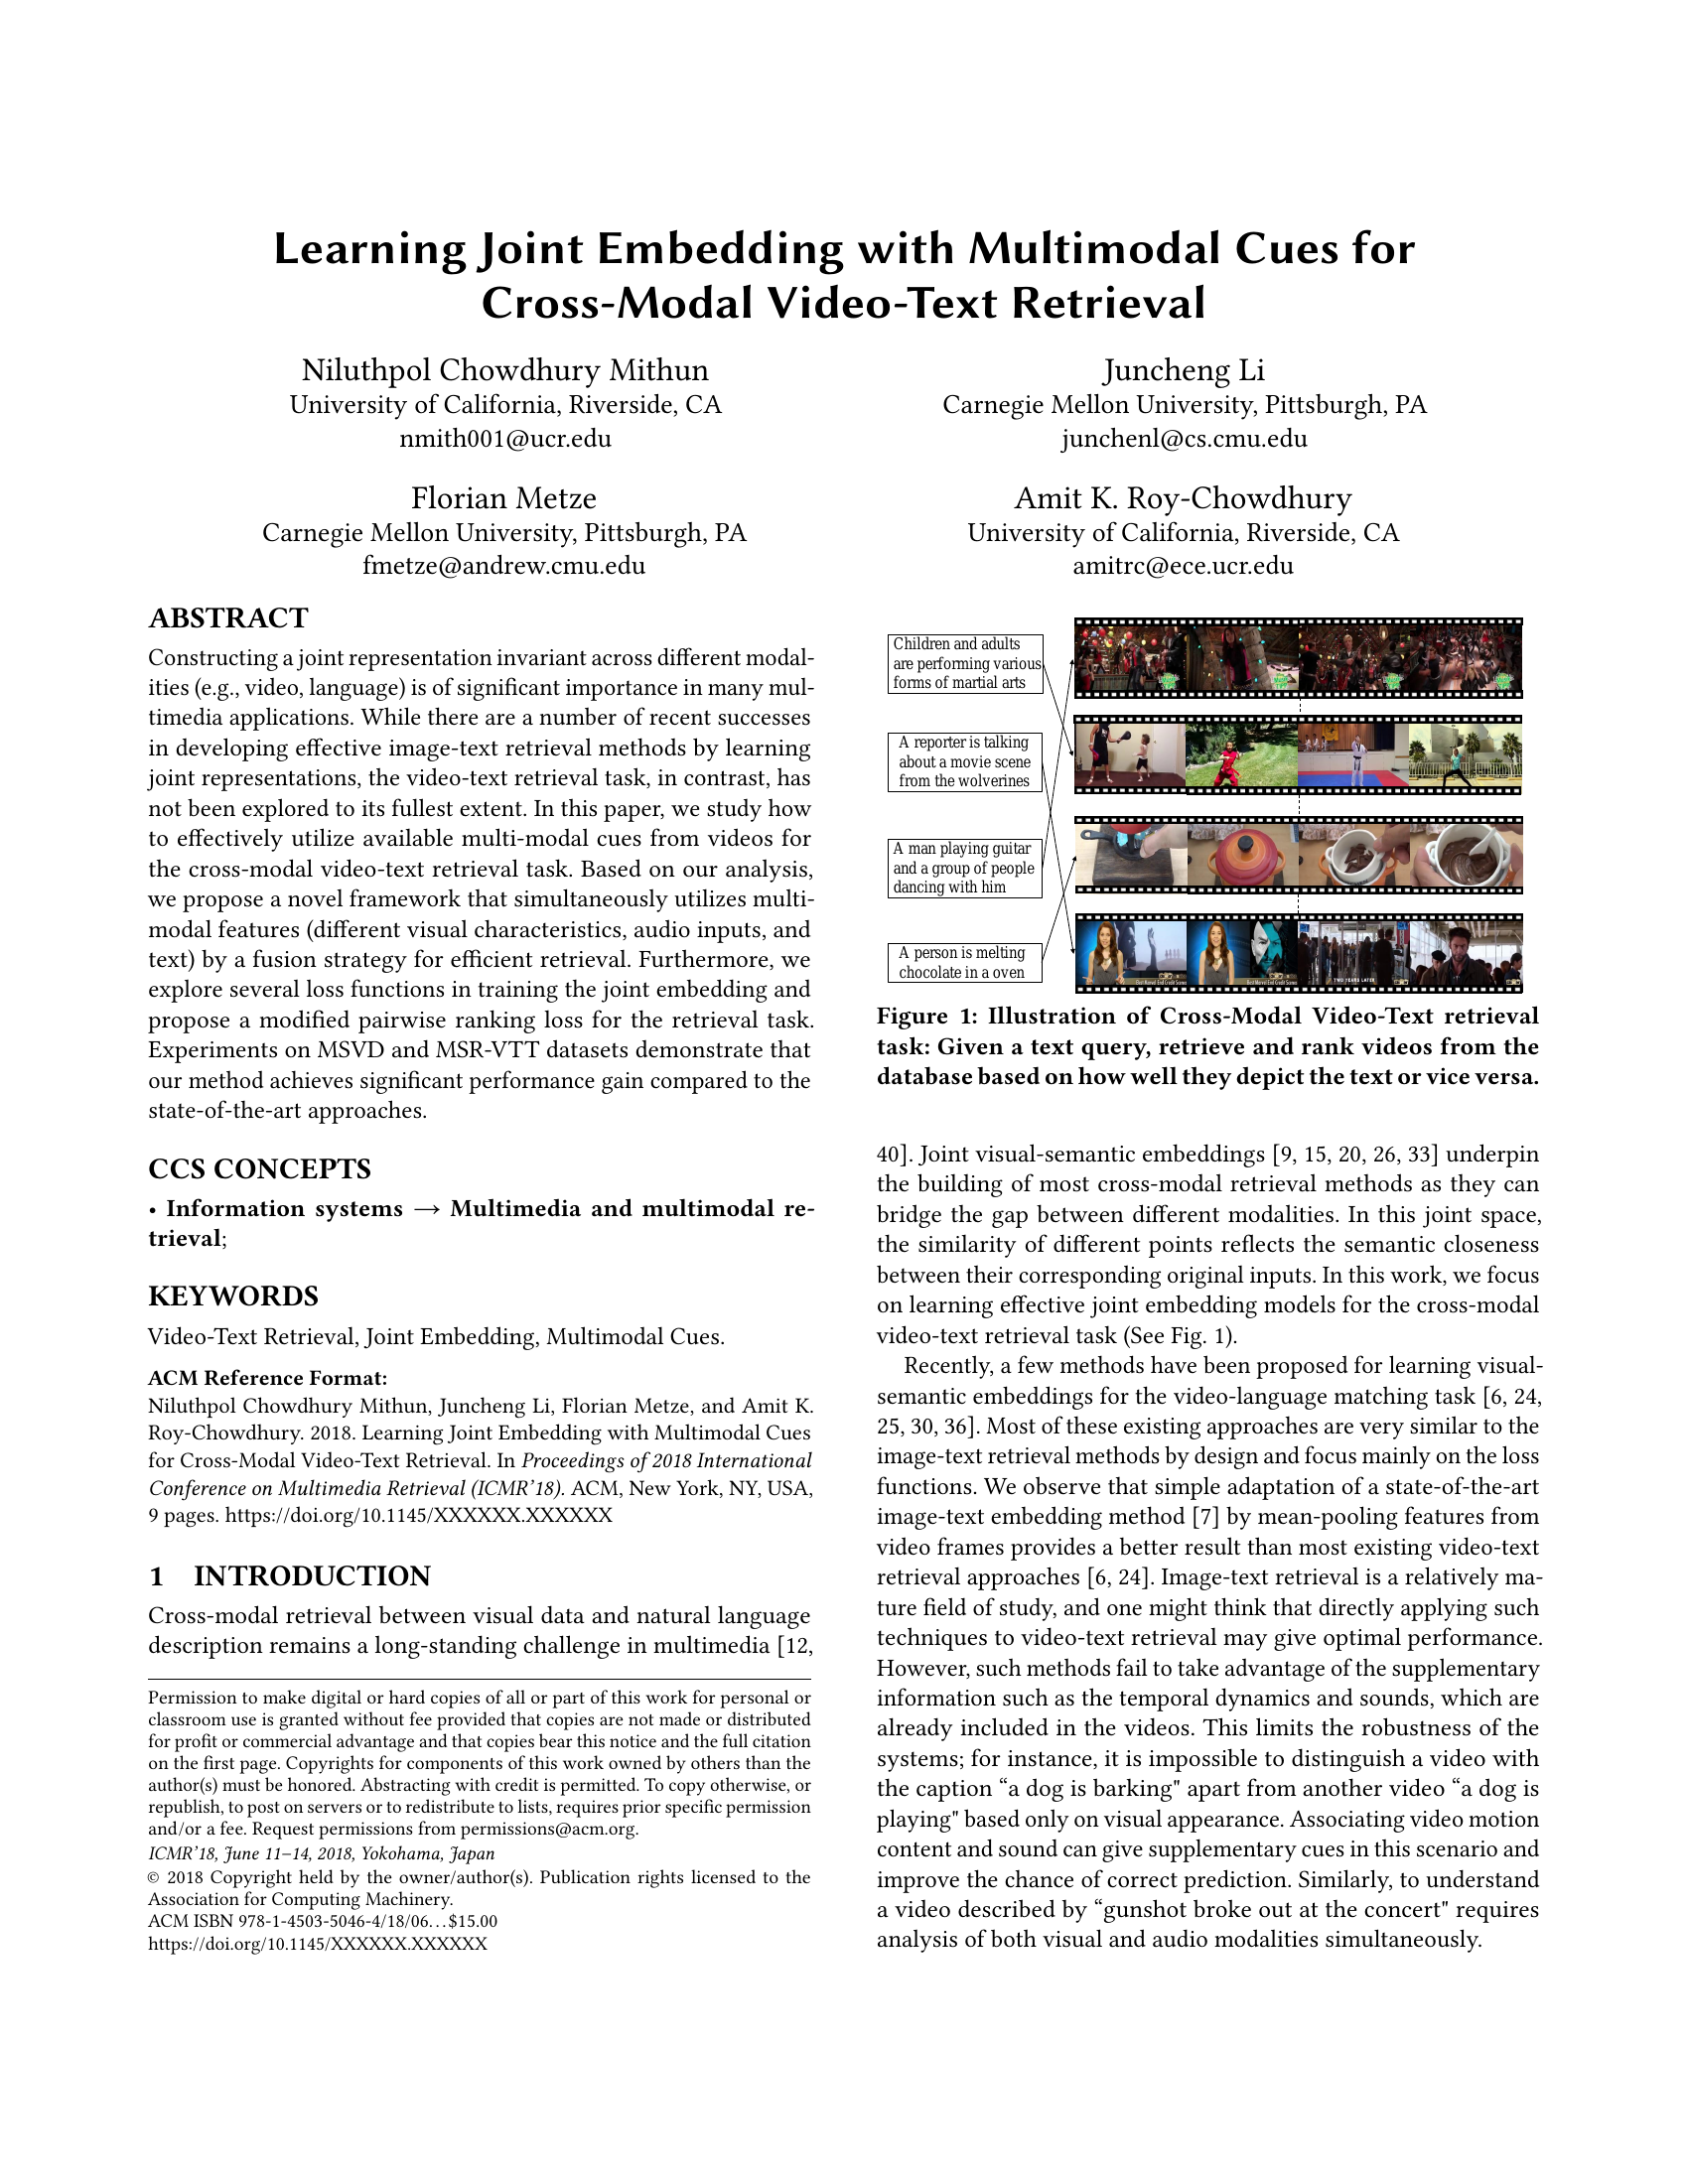
Learning Joint Embedding with Multimodal Cues for Cross-Modal Video ...
Advertisement Space (336x280)

Learning TFIDF Enhanced Joint Embedding for Recipe-Image Cross-Modal ...

Figure 1 from A neural architecture to learn image-text joint embedding ...

Figure 2 from Adversarial Multi-Grained Embedding Network for Cross ...
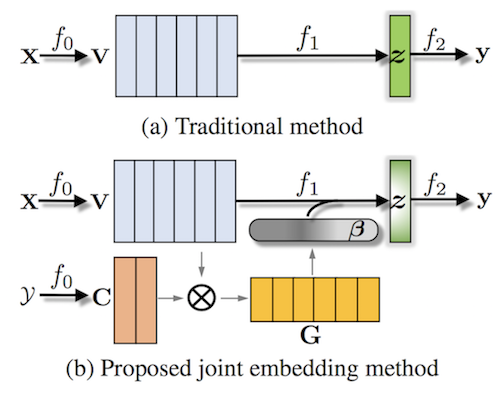
Joint Embedding of Words and Labels for Text Classification - Paper Survey

TI-JEPA: An Innovative Energy-based Joint Embedding Strategy for Text ...

Learning Joint Embedding with Multimodal Cues for Cross-Modal Video ...

Figure 1 from Higher-order Cross-structural Embedding Model for Time ...

Cross-modal Contrastive Learning for Generalizable and Efficient Image ...

Table 1 from Joint Access Point Selection and Local Discriminant ...

[논문 리뷰] How to Make Cross Encoder a Good Teacher for Efficient Image ...
Advertisement Space (336x280)
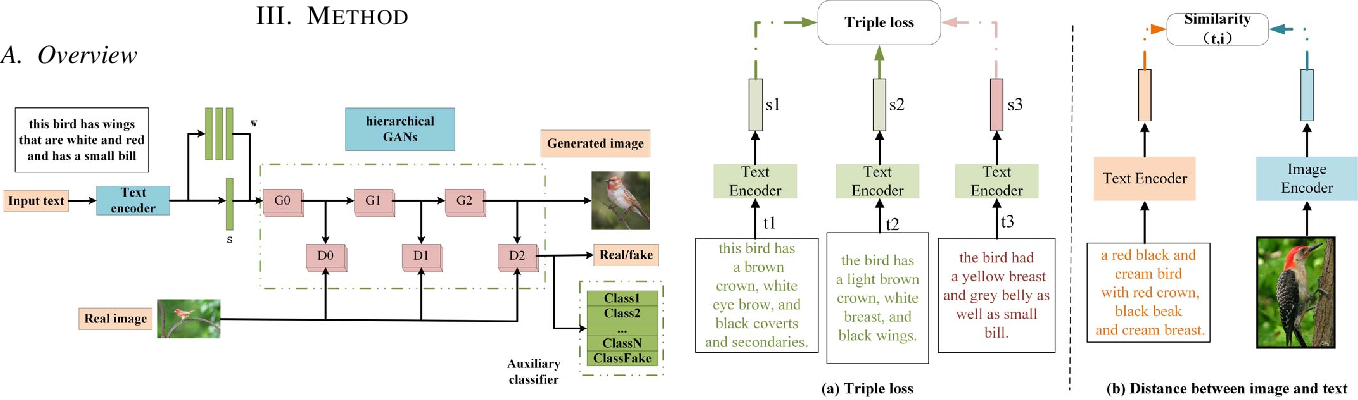
Figure 1 from Joint Embedding based Text-to-Image Synthesis | Semantic ...
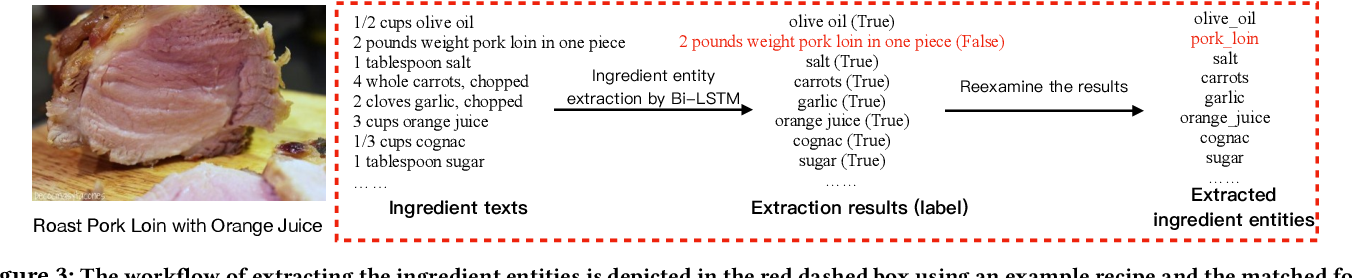
Learning Joint Embedding with Modality Alignments for Cross-Modal ...

Figure 2 from Parts2Words: Learning Joint Embedding of Point Clouds and ...

Figure 1 from Joint Pre-Encoding Representation and Structure Embedding ...

Joint Embedding of 2D and 3D Networks for Medical Image Anomaly ...

SML: a new Semantic Embedding Alignment Transformer for efficient cross ...