
Table 1 From Text Image Transformer With Cross Attention For Visual
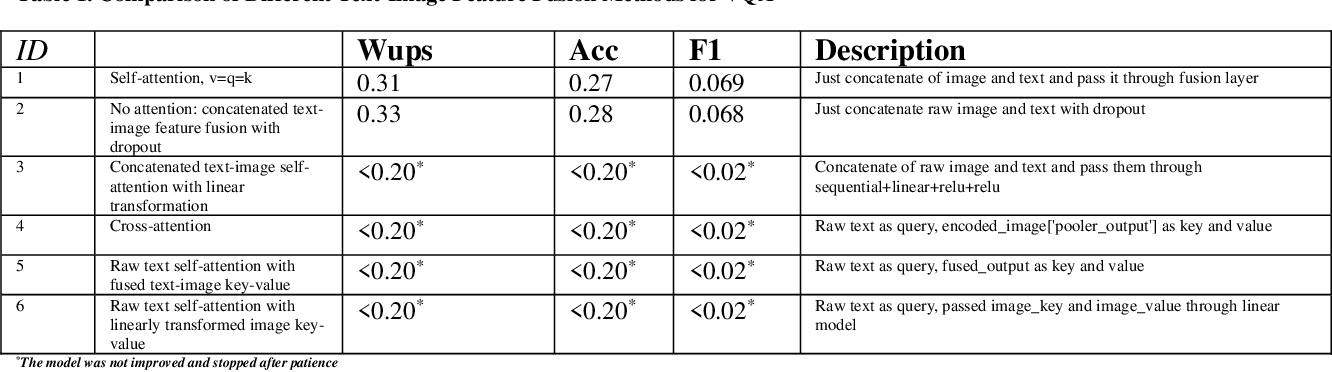
Table 1 from Text-Image Transformer with Cross-Attention for Visual ...

Figure 1 from Text-Image Transformer with Cross-Attention for Visual ...

Figure 1 from Cross Attention with Monotonic Alignment for Speech ...
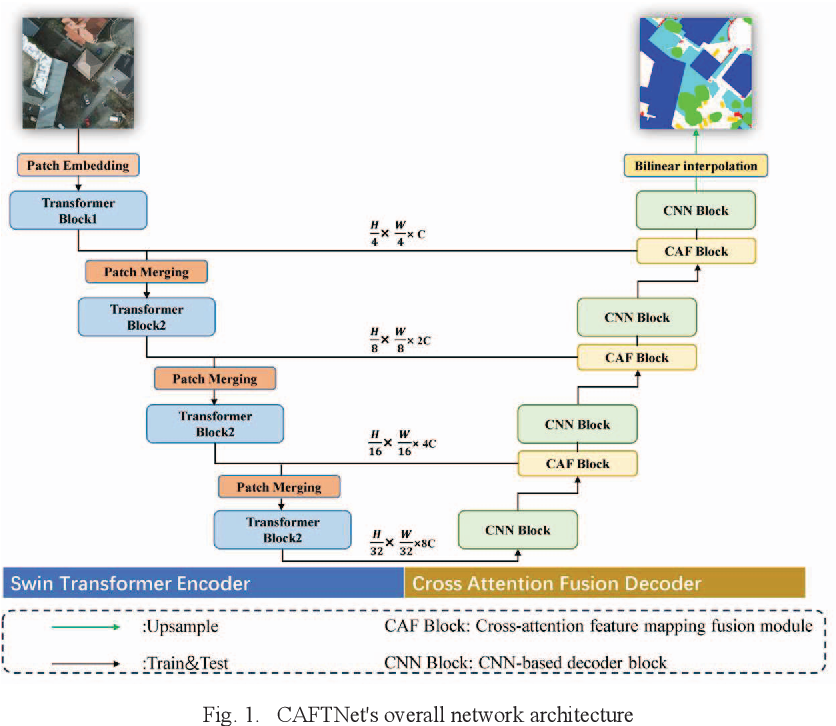
Figure 1 from Cross Attention Fusion Transformer Network for Urban ...

Figure 1 from Vision And Text Transformer For Predicting Answerability ...

Figure 3 from Cross on Cross Attention: Deep Fusion Transformer for ...

Criss-Cross Attention Enhanced Transformer for Image Captioning ...

(PDF) C2I-CAT: Class-to-Image Cross Attention Transformer for Out-of ...

Figure 1 from Spatial Cross-Attention for Transformer-Based Image ...

Figure 1 from Word2Pix: Word to Pixel Cross-Attention Transformer in ...
Advertisement Space (300x250)

Proposed Local Global Cross Attention Transformer (LG-CAT). Input ...

Crossvit: Cross-Attention Multi-Scale Vision Transformer For Image ...

Cross-Attention in Transformer Architecture Can Merge Images with Text ...
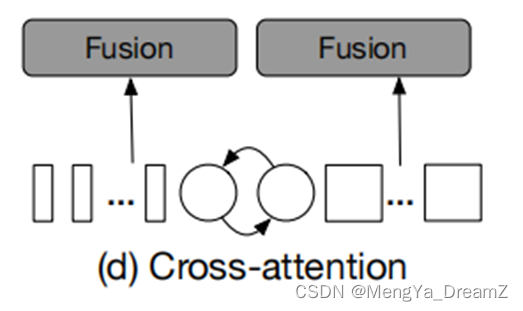
CrossViT: Cross-Attention Multi-Scale Vision Transformer for Image ...
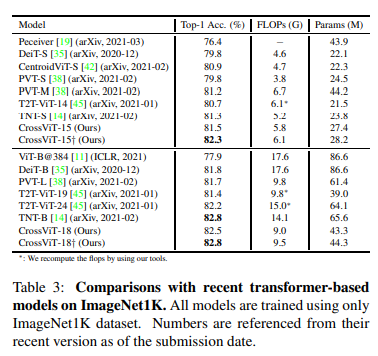
CrossViT: Cross-Attention Multi-Scale Vision Transformer for Image ...

Neural machine translation with attention | Text | TensorFlow

Figure 2 from Spatial Cross-Attention for Transformer-Based Image ...
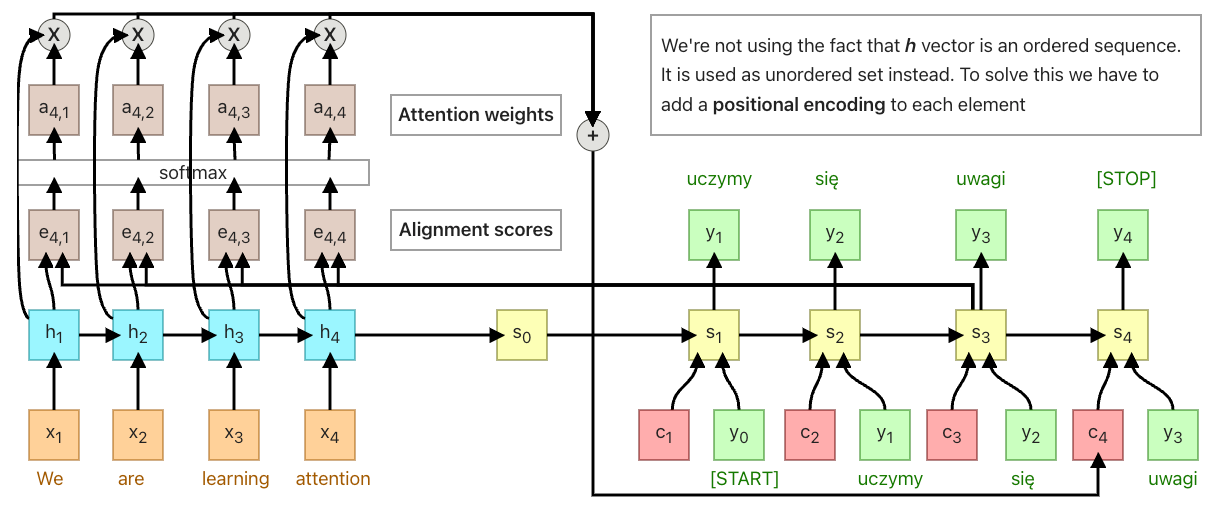
Deep Learning Series 21: Understanding Cross Attention in Transformer ...

CrossViT: Cross-Attention Multi-Scale Vision Transformer for Image ...

CrossViT: Cross-Attention Multi-Scale Vision Transformer for Image ...
Advertisement Space (336x280)
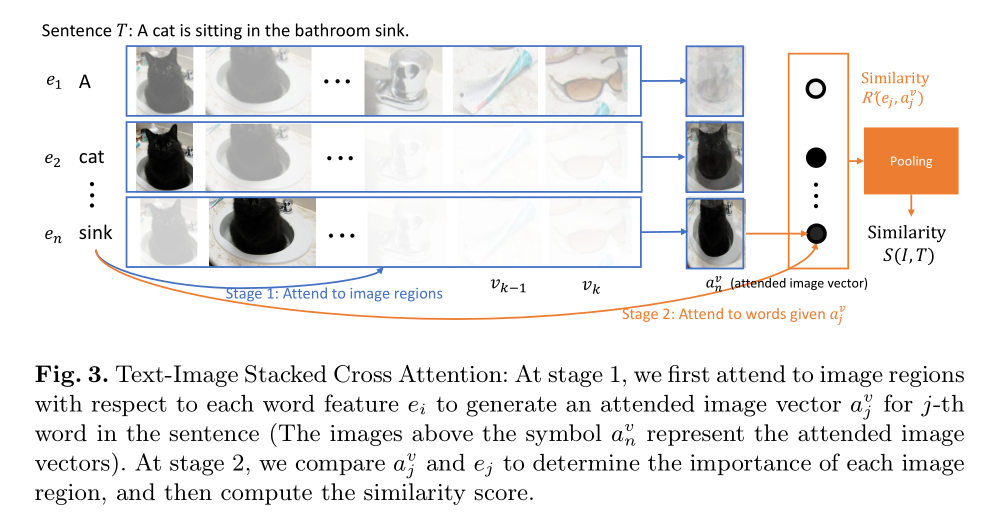
Stacked Cross Attention for Image-Text Matching - AHU-WangXiao - 博客园

A basic transformer model for sign to text translation, showing the ...

Vision Transformer with Cross-attention by Temporal Shift for Efficient ...

Deep Learning Series 21: Understanding Cross Attention in Transformer ...
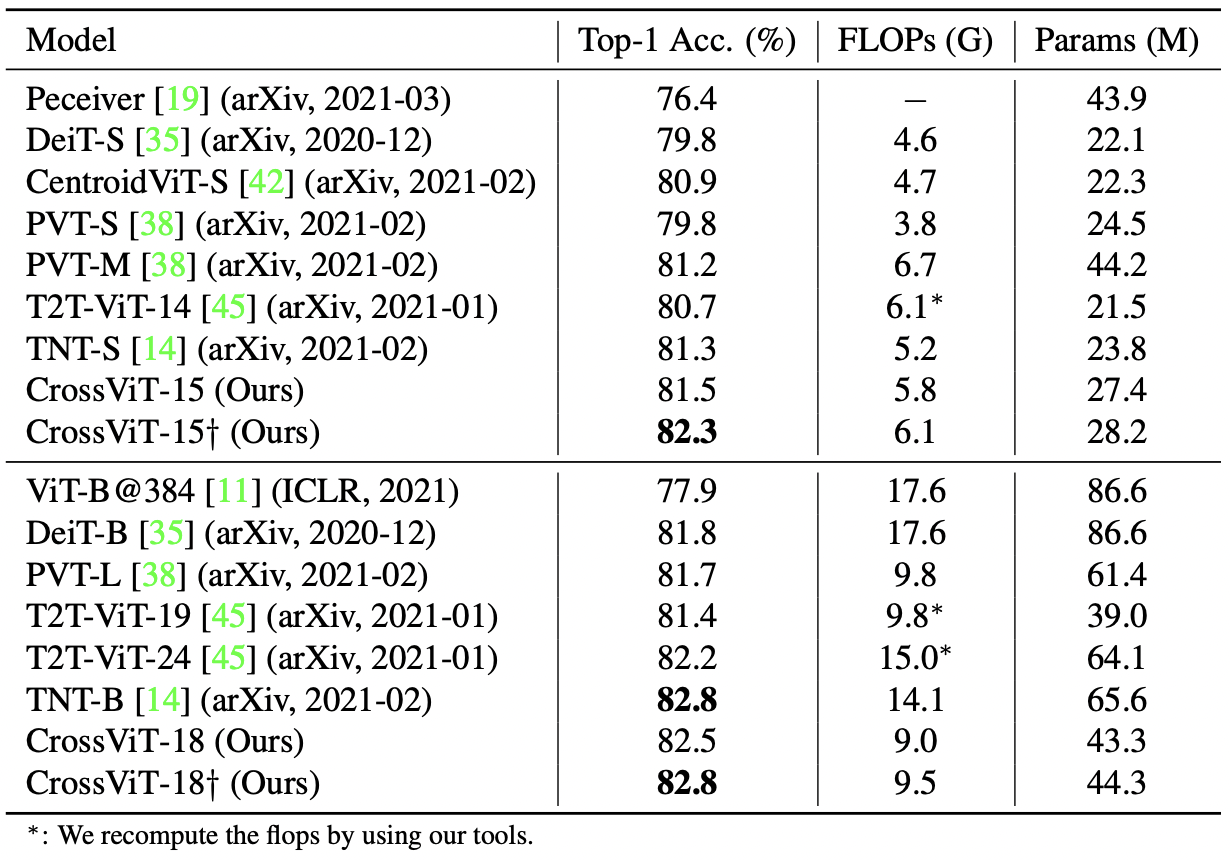
CrossViT: Cross-Attention Multi-Scale Vision Transformer for Image
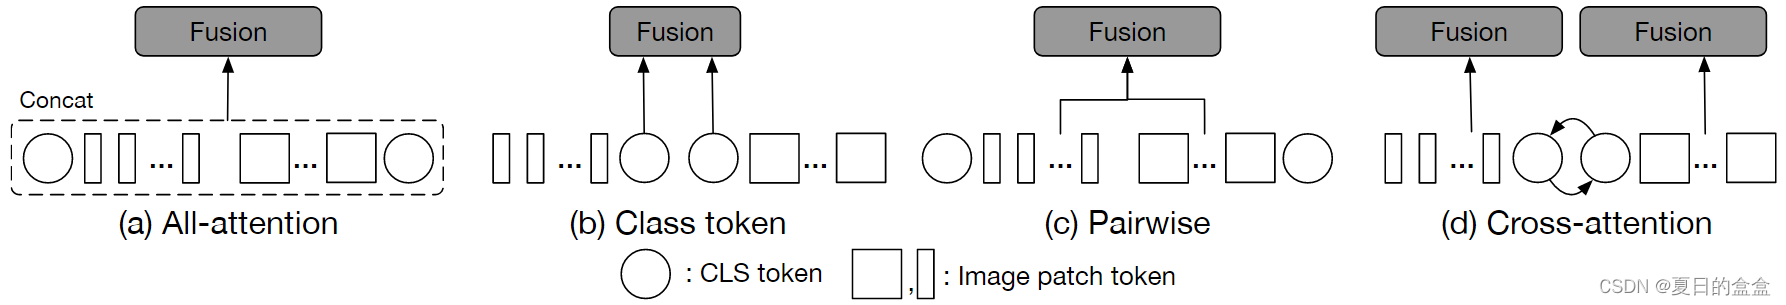
《CrossViT: Cross-Attention Multi-Scale Vision Transformer for Image ...
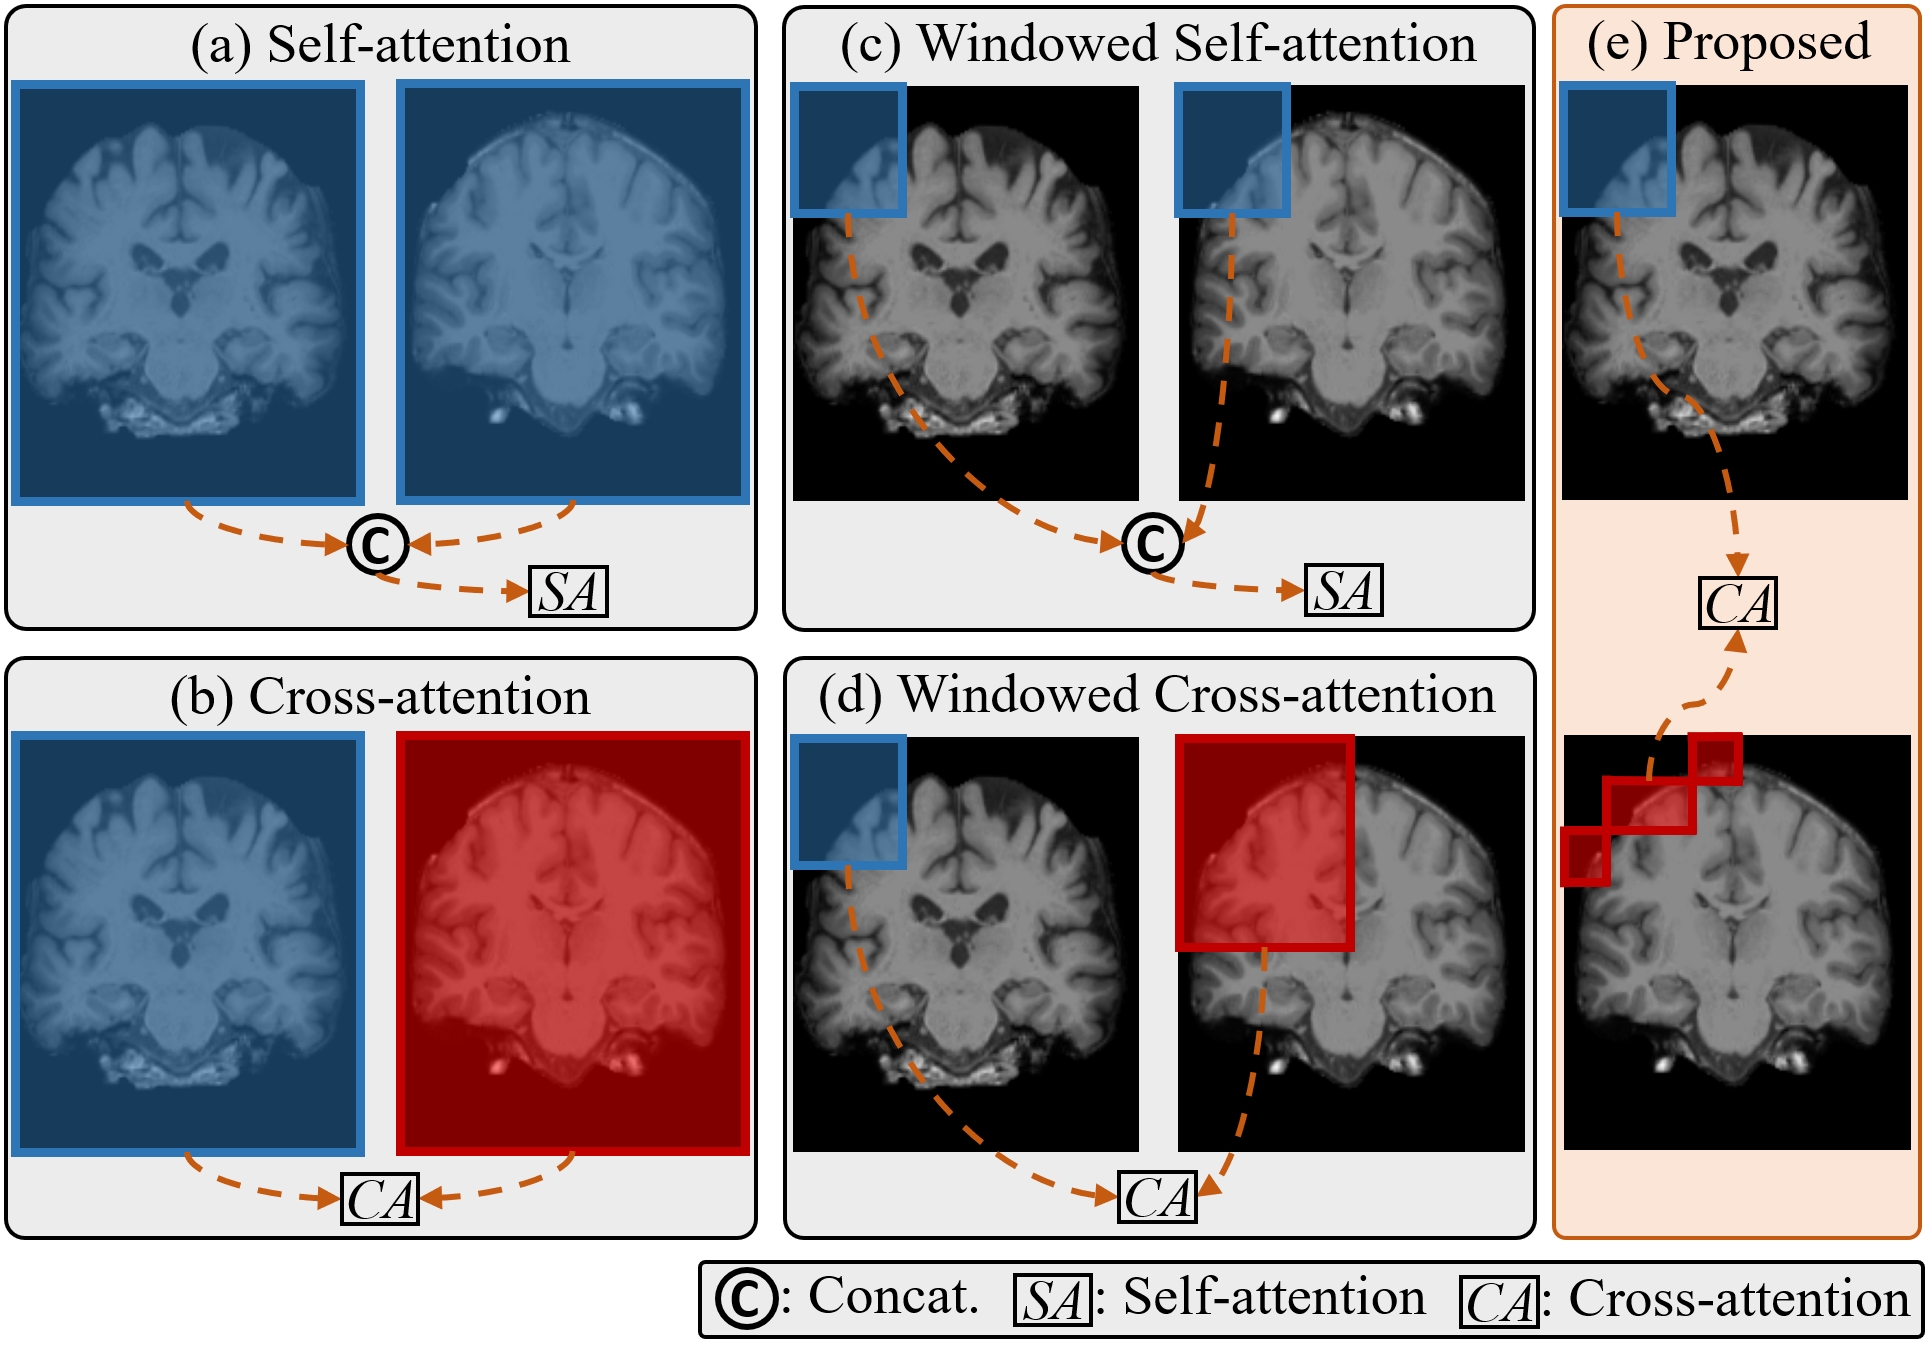
[2303.06179] Deformable Cross-Attention Transformer for Medical Image ...

CrossViT: Cross-Attention Multi-Scale Vision Transformer for Image ...

CrossViT: Cross-Attention Multi-Scale Vision Transformer for Image ...

Figure 3 from Cascade Transformer for Hierarchical Semantic Reasoning ...
Advertisement Space (336x280)
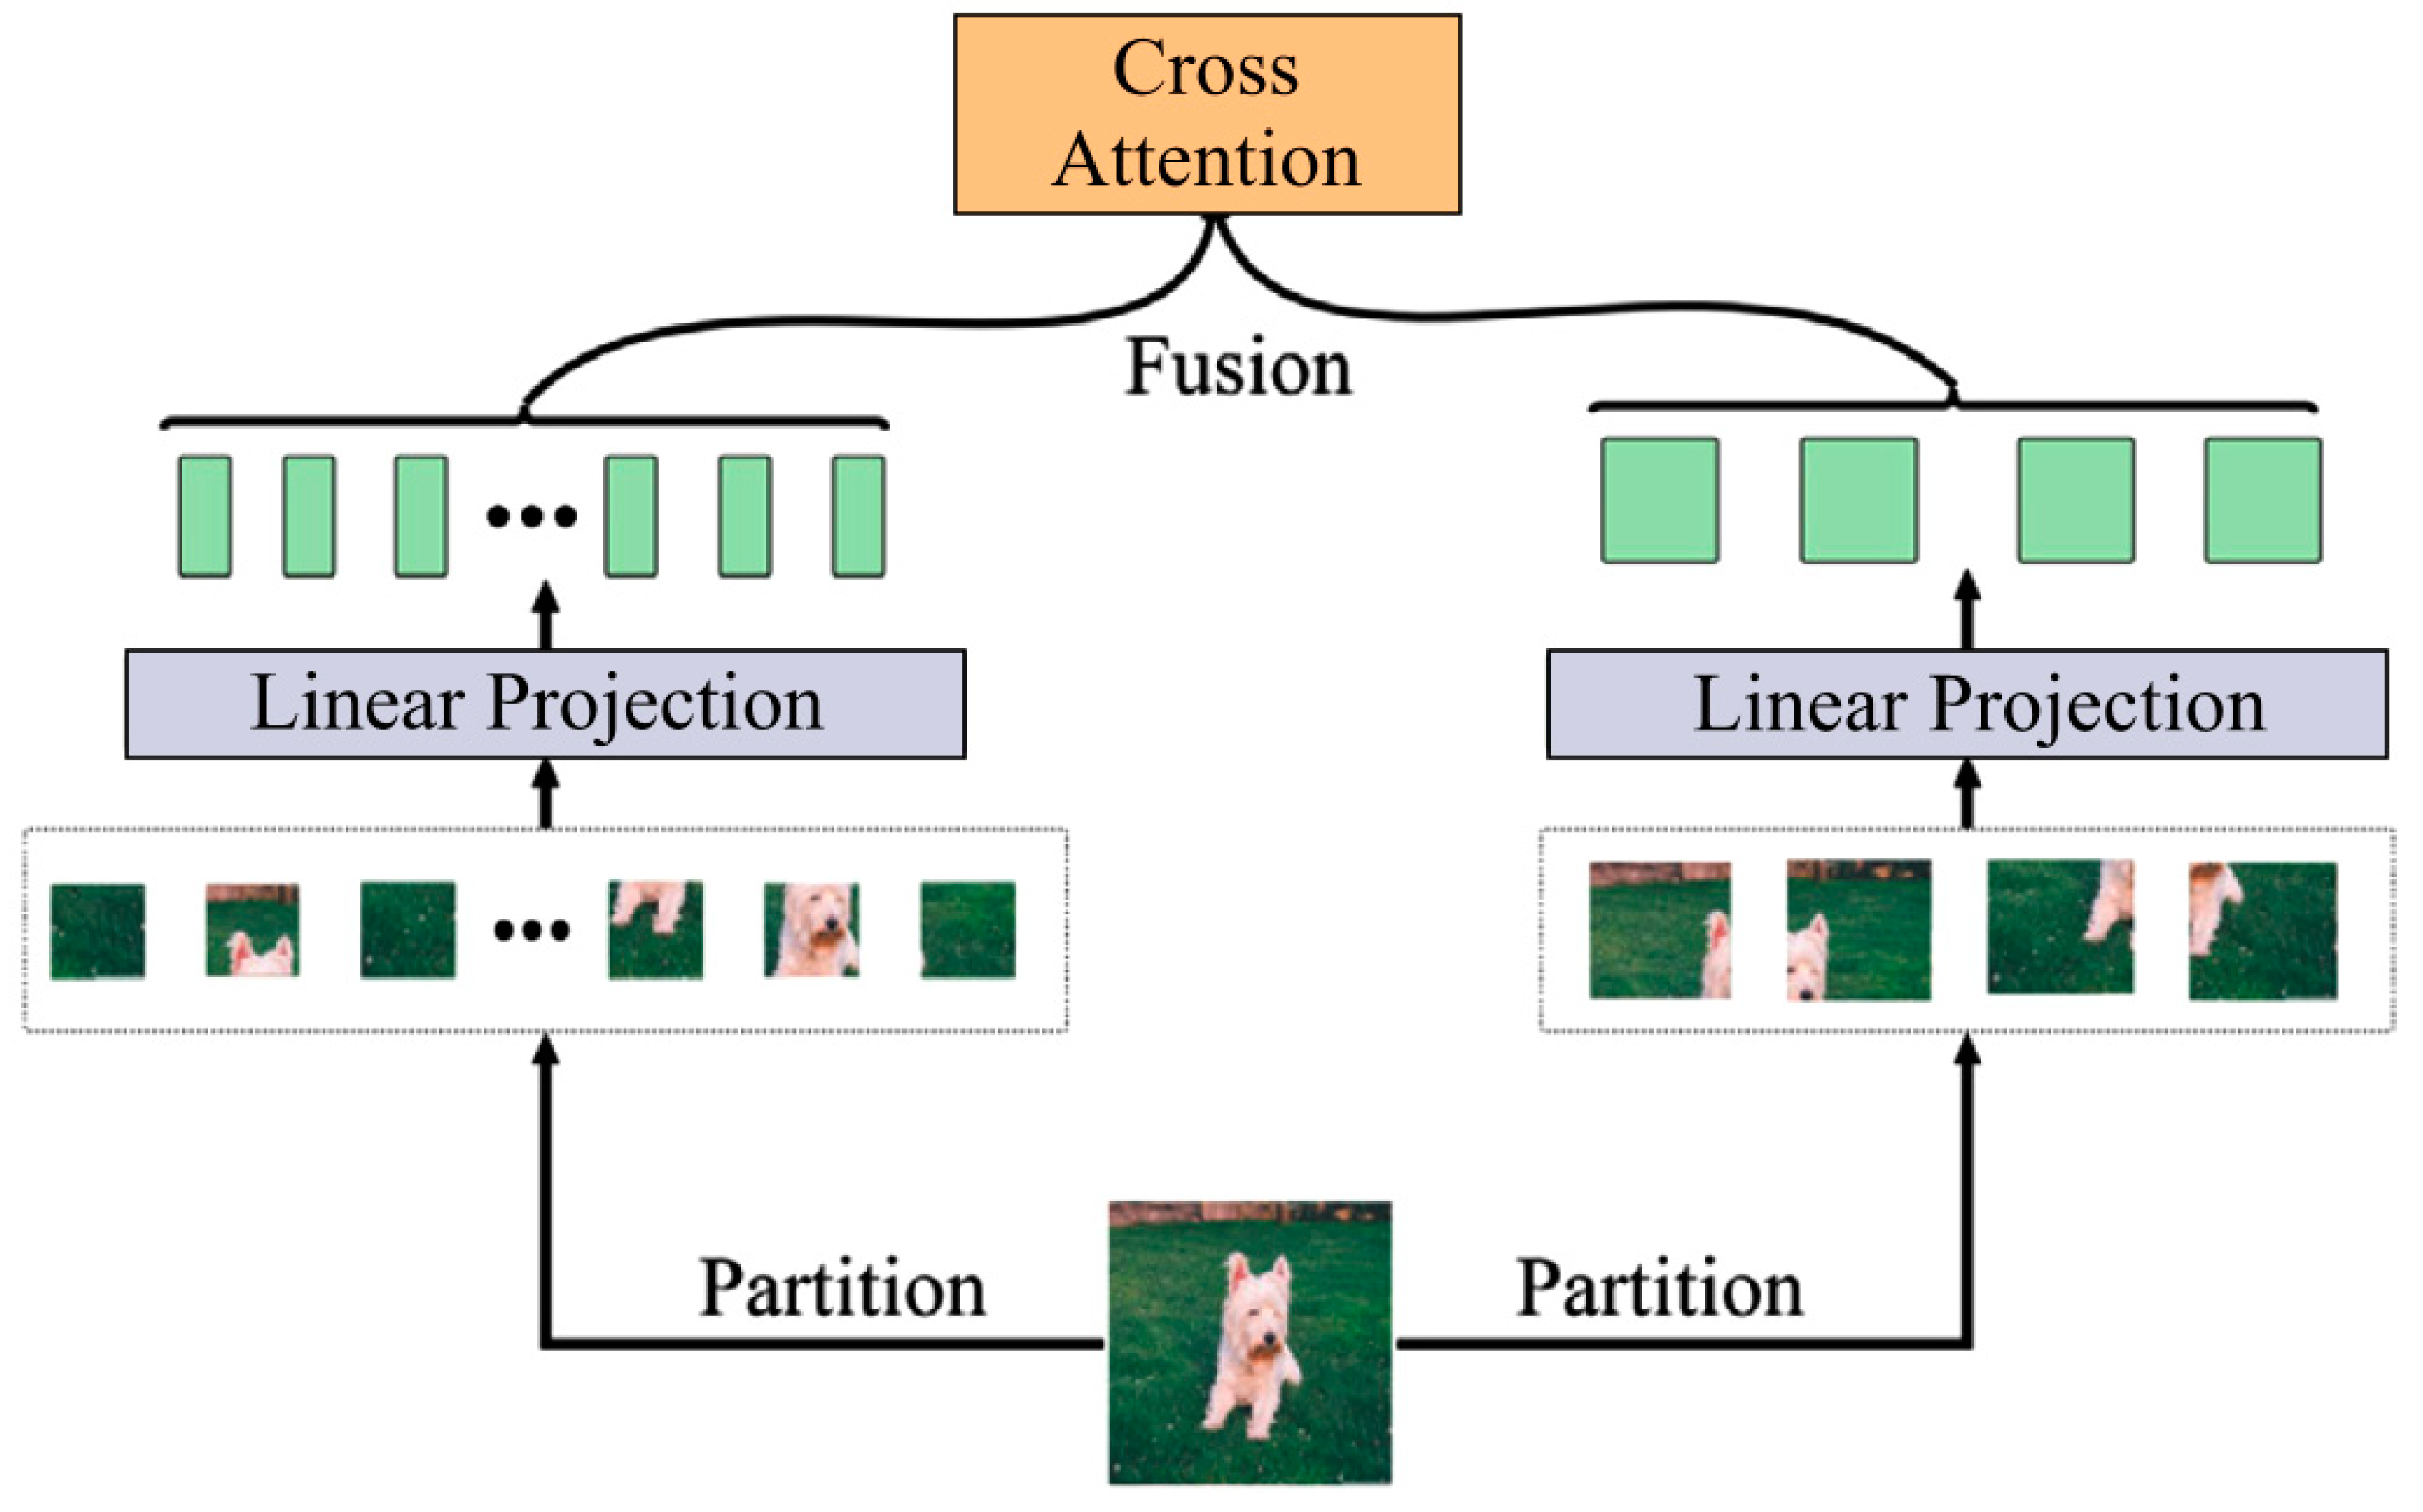
Comparative Analysis of Vision Transformer Models for Facial Emotion ...

Figure 1 from Cross-Attention Transformer-Based Visual-Language Fusion ...

Aligning Text with Images Using Transformers | AI Tutorial | Next ...

Aligning Text with Images Using Transformers | AI Tutorial | Next ...

Decoding CrossViT: Cross-Attention Multi-Scale Vision Transformer for ...
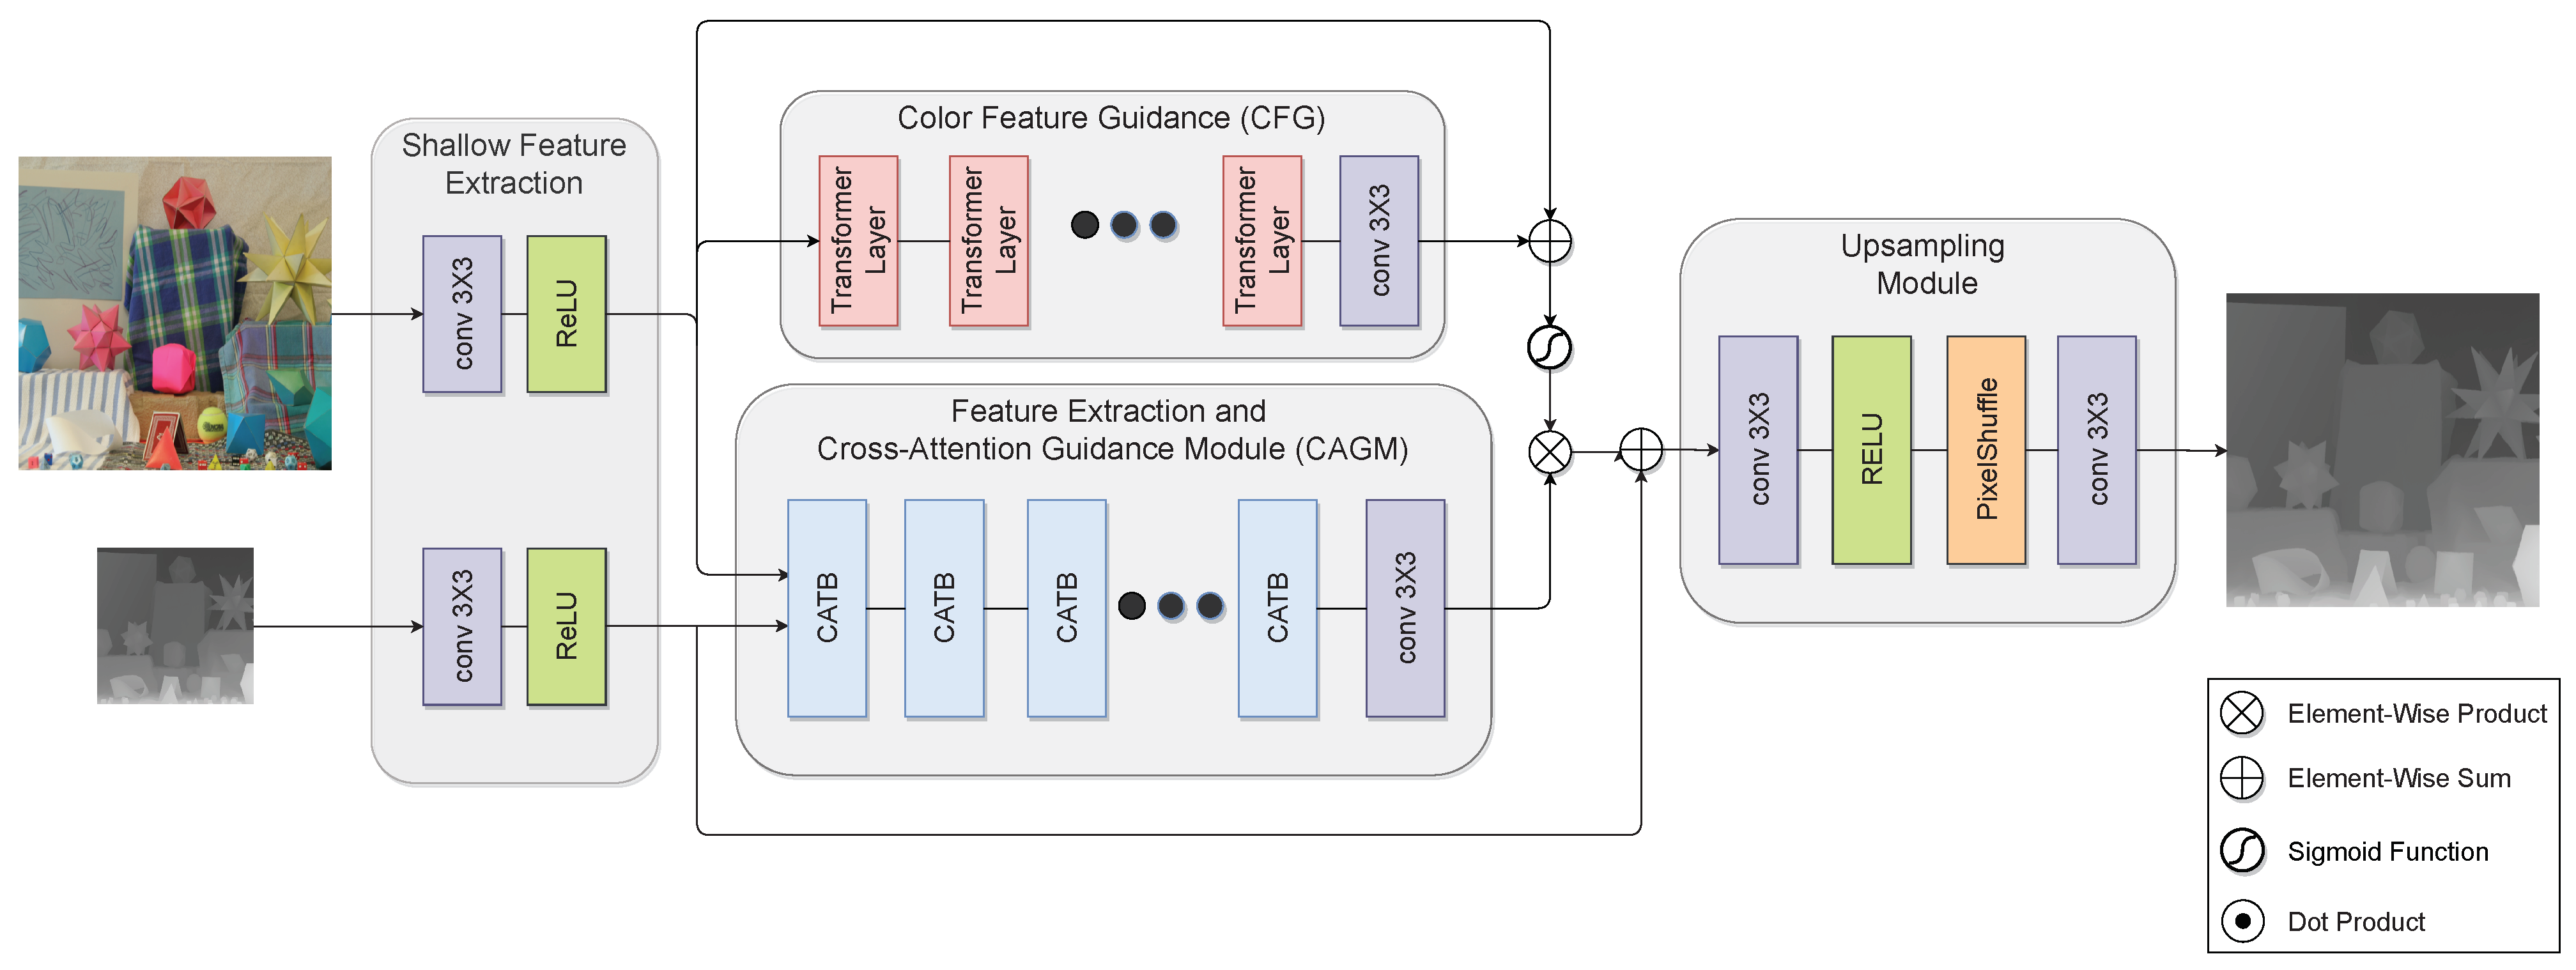
Fully Cross-Attention Transformer for Guided Depth Super-Resolution