
Table 2 From Benchmarking Large Language Models For Molecule Prediction
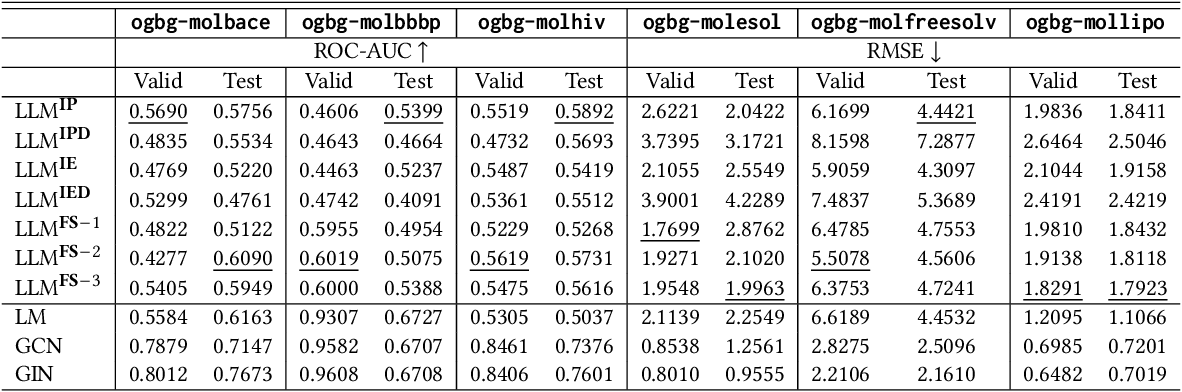
Table 2 from Benchmarking Large Language Models for Molecule Prediction ...
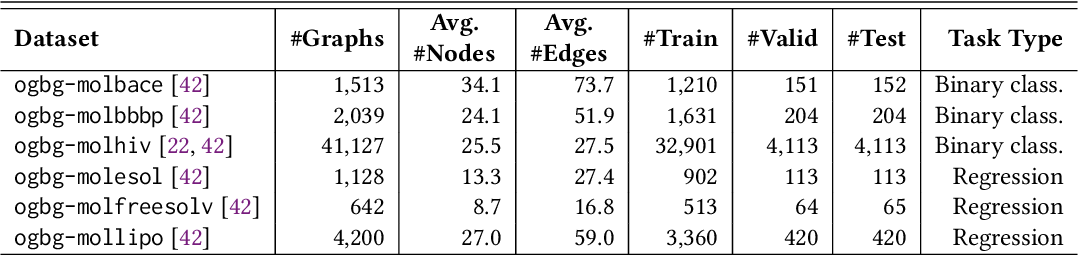
Table 1 from Benchmarking Large Language Models for Molecule Prediction ...
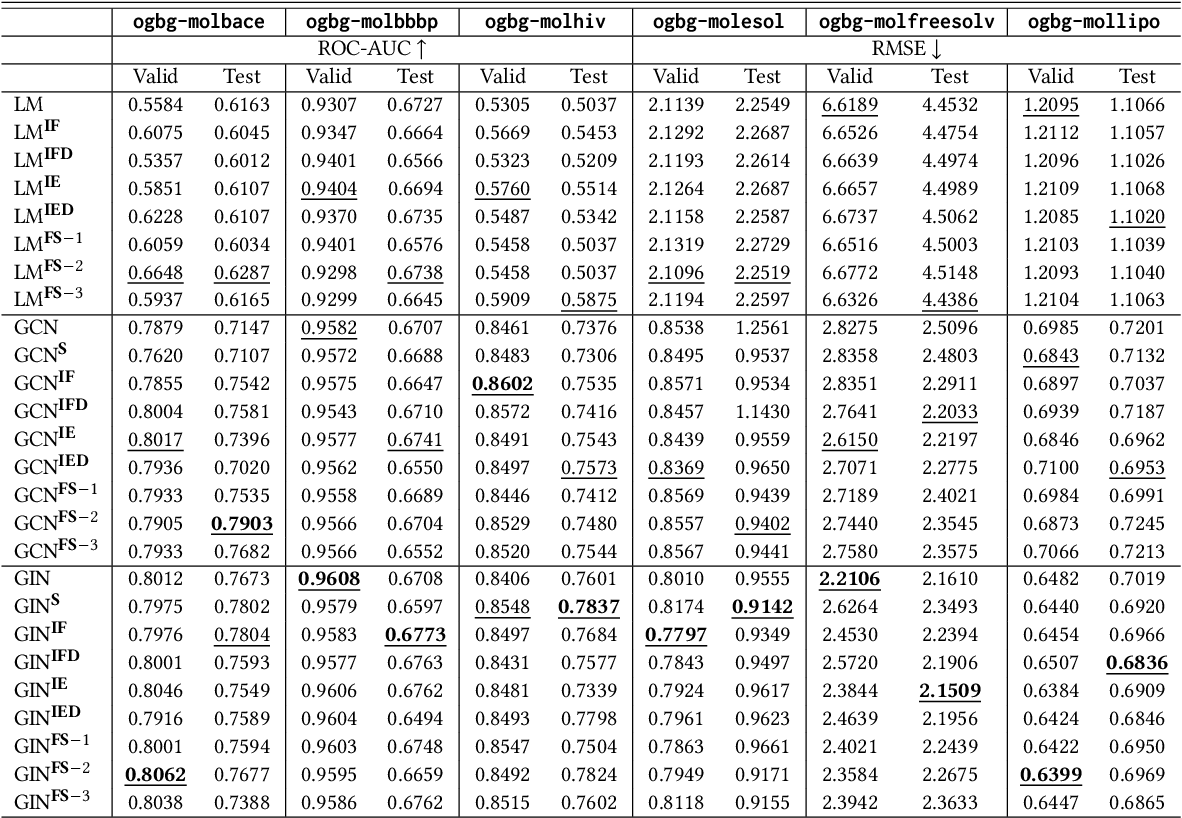
Table 3 from Benchmarking Large Language Models for Molecule Prediction ...

Table 2 from Beyond Single Bugs: Benchmarking Large Language Models for ...
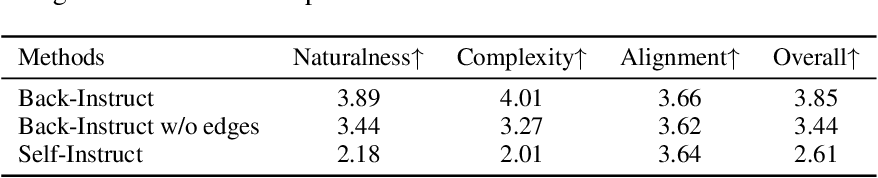
Table 2 from TaskBench: Benchmarking Large Language Models for Task ...

Table 1 from BUFFET: Benchmarking Large Language Models for Few-shot ...

Table 2 from Benchmarking Large Language Model Capabilities for ...
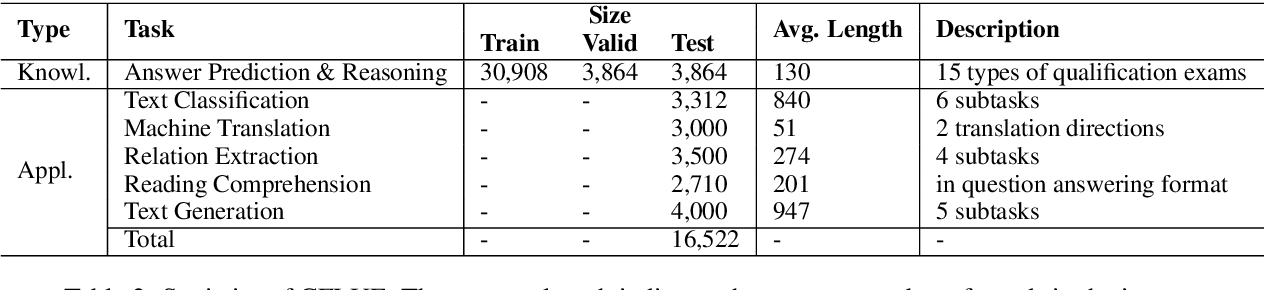
Table 2 from Benchmarking Large Language Models on CFLUE - A Chinese ...

Table 2 from Benchmarking Large Language Models in Retrieval-Augmented ...

Figure 1 from Benchmarking Large Language Models for Molecule ...
Advertisement Space (300x250)
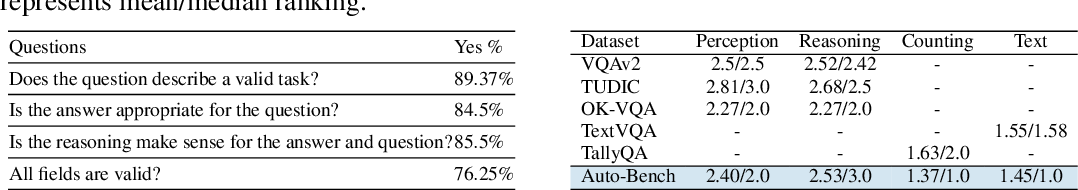
Table 2 from Large Language Models as Automated Aligners for ...

Table 1 from BUFFET: Benchmarking Large Language Models for Few-shot ...
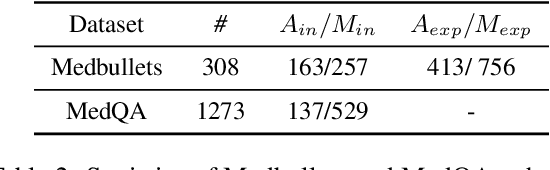
Table 2 from Benchmarking Large Language Models on Answering and ...

Table 1 from BUFFET: Benchmarking Large Language Models for Few-shot ...

Table 2 from SEED-Bench-2: Benchmarking Multimodal Large Language ...

Table 2 from Large Language Model for Multi-Domain Translation ...
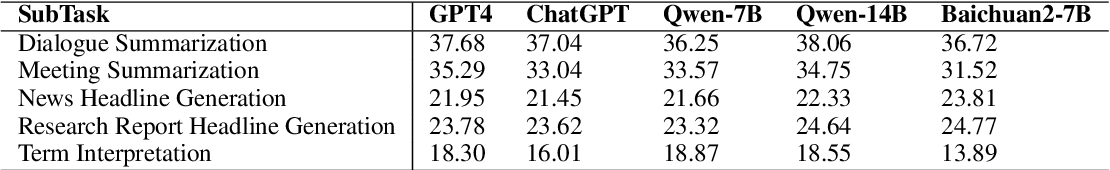
Table 13 from Benchmarking Large Language Models on CFLUE - A Chinese ...
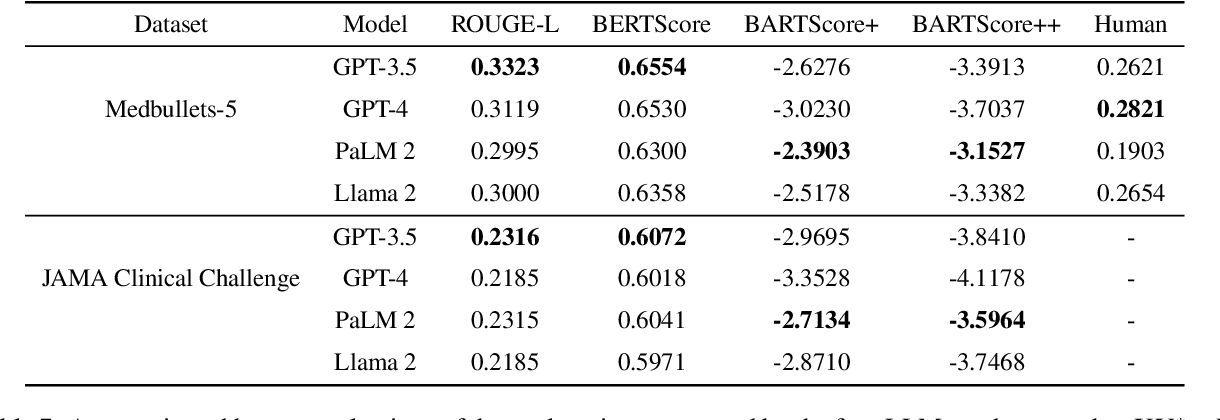
Table 7 from Benchmarking Large Language Models on Answering and ...

Table 3 from Large Language Models as Automated Aligners for ...
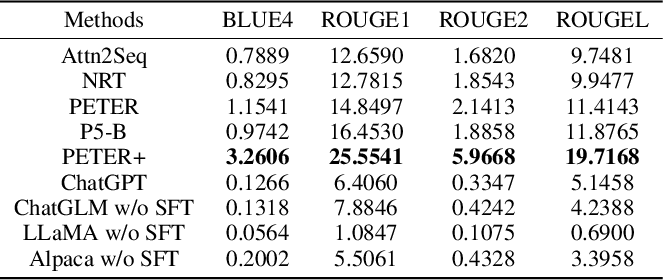
Table 1 from LLMRec: Benchmarking Large Language Models on ...
Advertisement Space (336x280)

Table 1 from Benchmarking Large Language Model Capabilities for ...

Table 1 from Benchmarking Knowledge Boundary for Large Language Model ...

Table 18 from Benchmarking Benchmark Leakage in Large Language Models ...

Table 1 from MEGAVERSE: Benchmarking Large Language Models Across ...
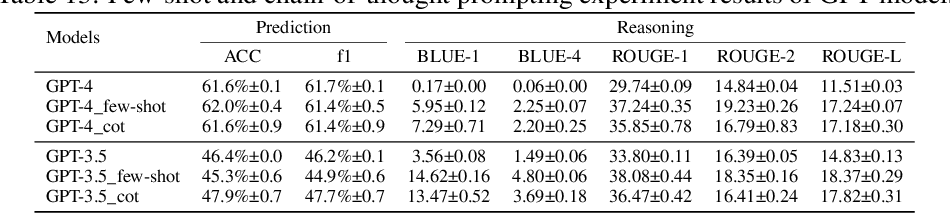
Table 13 from Benchmarking Large Language Models on CMExam - A ...

Figure 1 from Benchmarking Large Language Models for Personalized ...
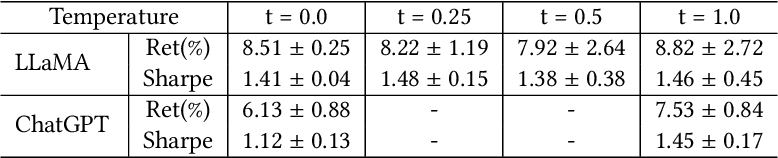
Table 2 from Benchmarking Large Language Model Volatility | Semantic ...

Table 14 from Benchmarking Benchmark Leakage in Large Language Models ...

Benchmarking Large Language Models for News Summarization

(PDF) LLM4Mat-bench: benchmarking large language models for materials ...
Advertisement Space (336x280)

Benchmarking Large Language Models for Math Reasoning Tasks | AI ...
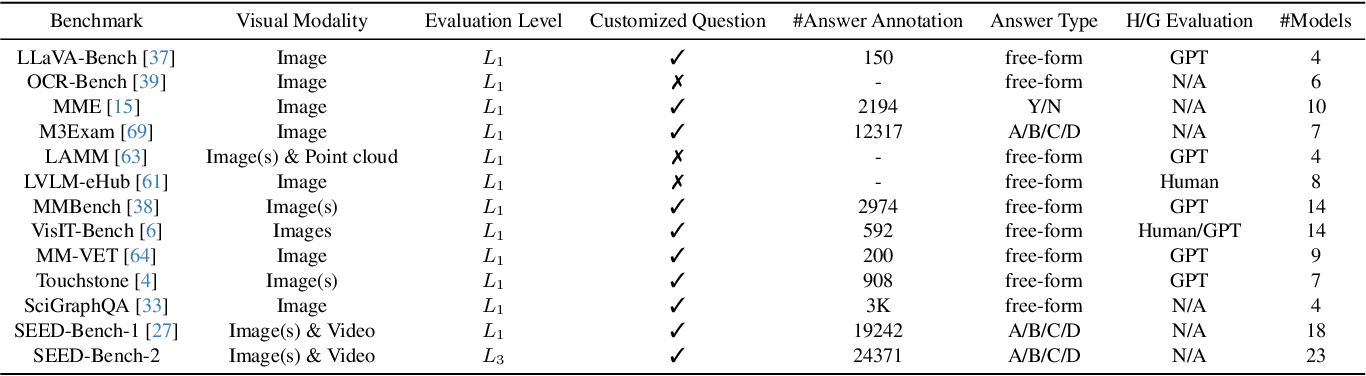
Table 1 from SEED-Bench-2: Benchmarking Multimodal Large Language ...

AD-LLM: Benchmarking Large Language Models for Anomaly Detection
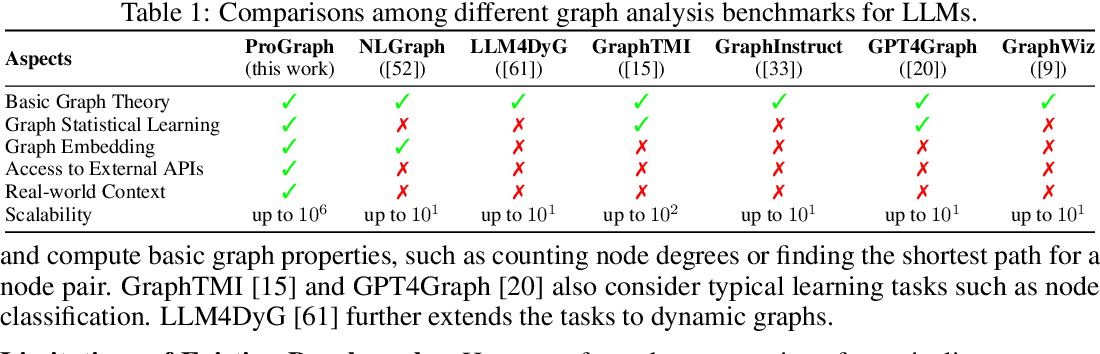
Table 1 from Can Large Language Models Analyze Graphs like ...

(PDF) Benchmarking Large Language Models for Replication of Guideline ...

Benchmarking Large Language Models for Side-by-Side Evaluation of ...