
Tensorrt Llm Vs Triton Inference Server Optimizing Large Language

TensorRT LLM vs. Triton Inference Server: Optimizing Large Language ...

TensorRT LLM vs. Triton Inference Server: Optimizing Large Language ...

TensorRT LLM vs. Triton Inference Server: Optimizing Large Language ...

Optimizing Large CV models using TensorRT and Triton Inference Server ...

Optimizing Large CV models using TensorRT and Triton Inference Server ...

LLM Deployment: A Guide to NVIDIA Triton Inference Server and TensorRT ...
LLM Deployment: A Guide to NVIDIA Triton Inference Server and TensorRT ...
LLM Deployment: A Guide to NVIDIA Triton Inference Server and TensorRT ...
LLM Deployment: A Guide to NVIDIA Triton Inference Server and TensorRT ...

🤖 LLM Inferencing with TensorRT-LLM + Triton Inference Server | by ...
Advertisement Space (300x250)

Optimizing Inference on Large Language Models with NVIDIA TensorRT-LLM ...

TensorRT vs vLLM: The Complete Guide to LLM Inference Engines

Optimizing Inference on Large Language Models with NVIDIA TensorRT-LLM ...

GPU Memory Required for Large Language Model Inference with TensorRT ...
Transforming LLM Serving: NVIDIA Triton Inference Server Meets vLLM ...
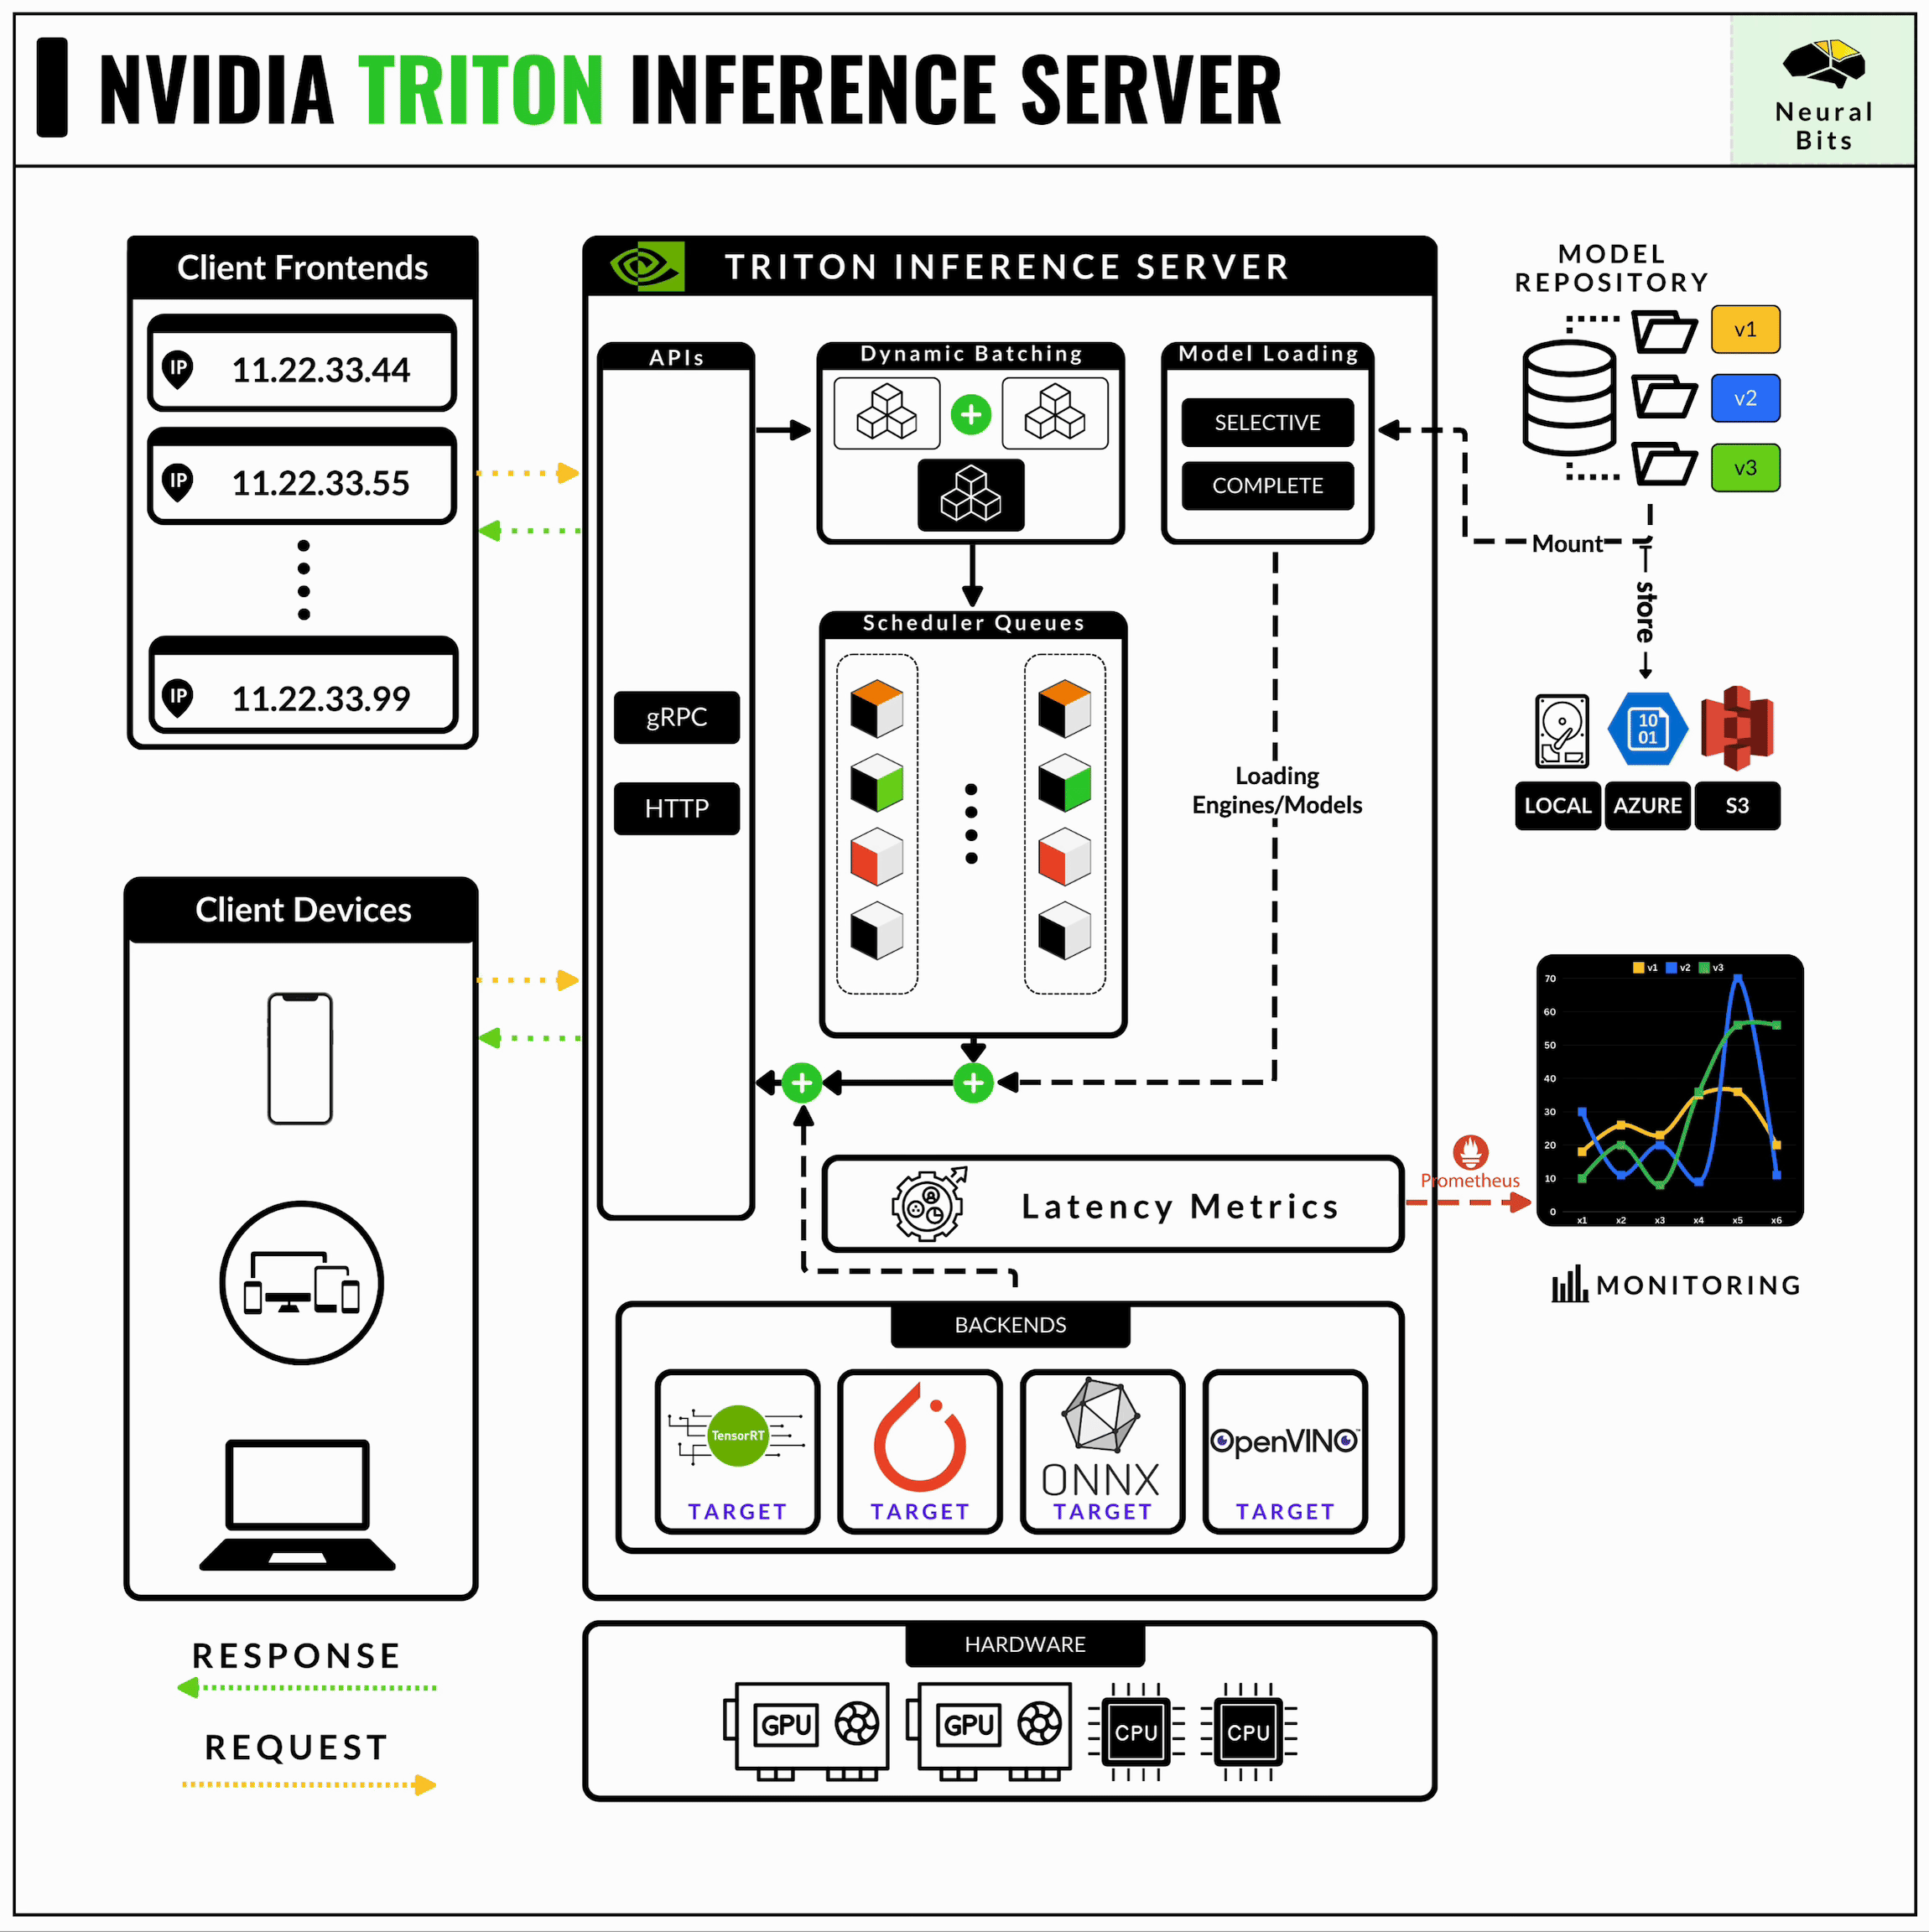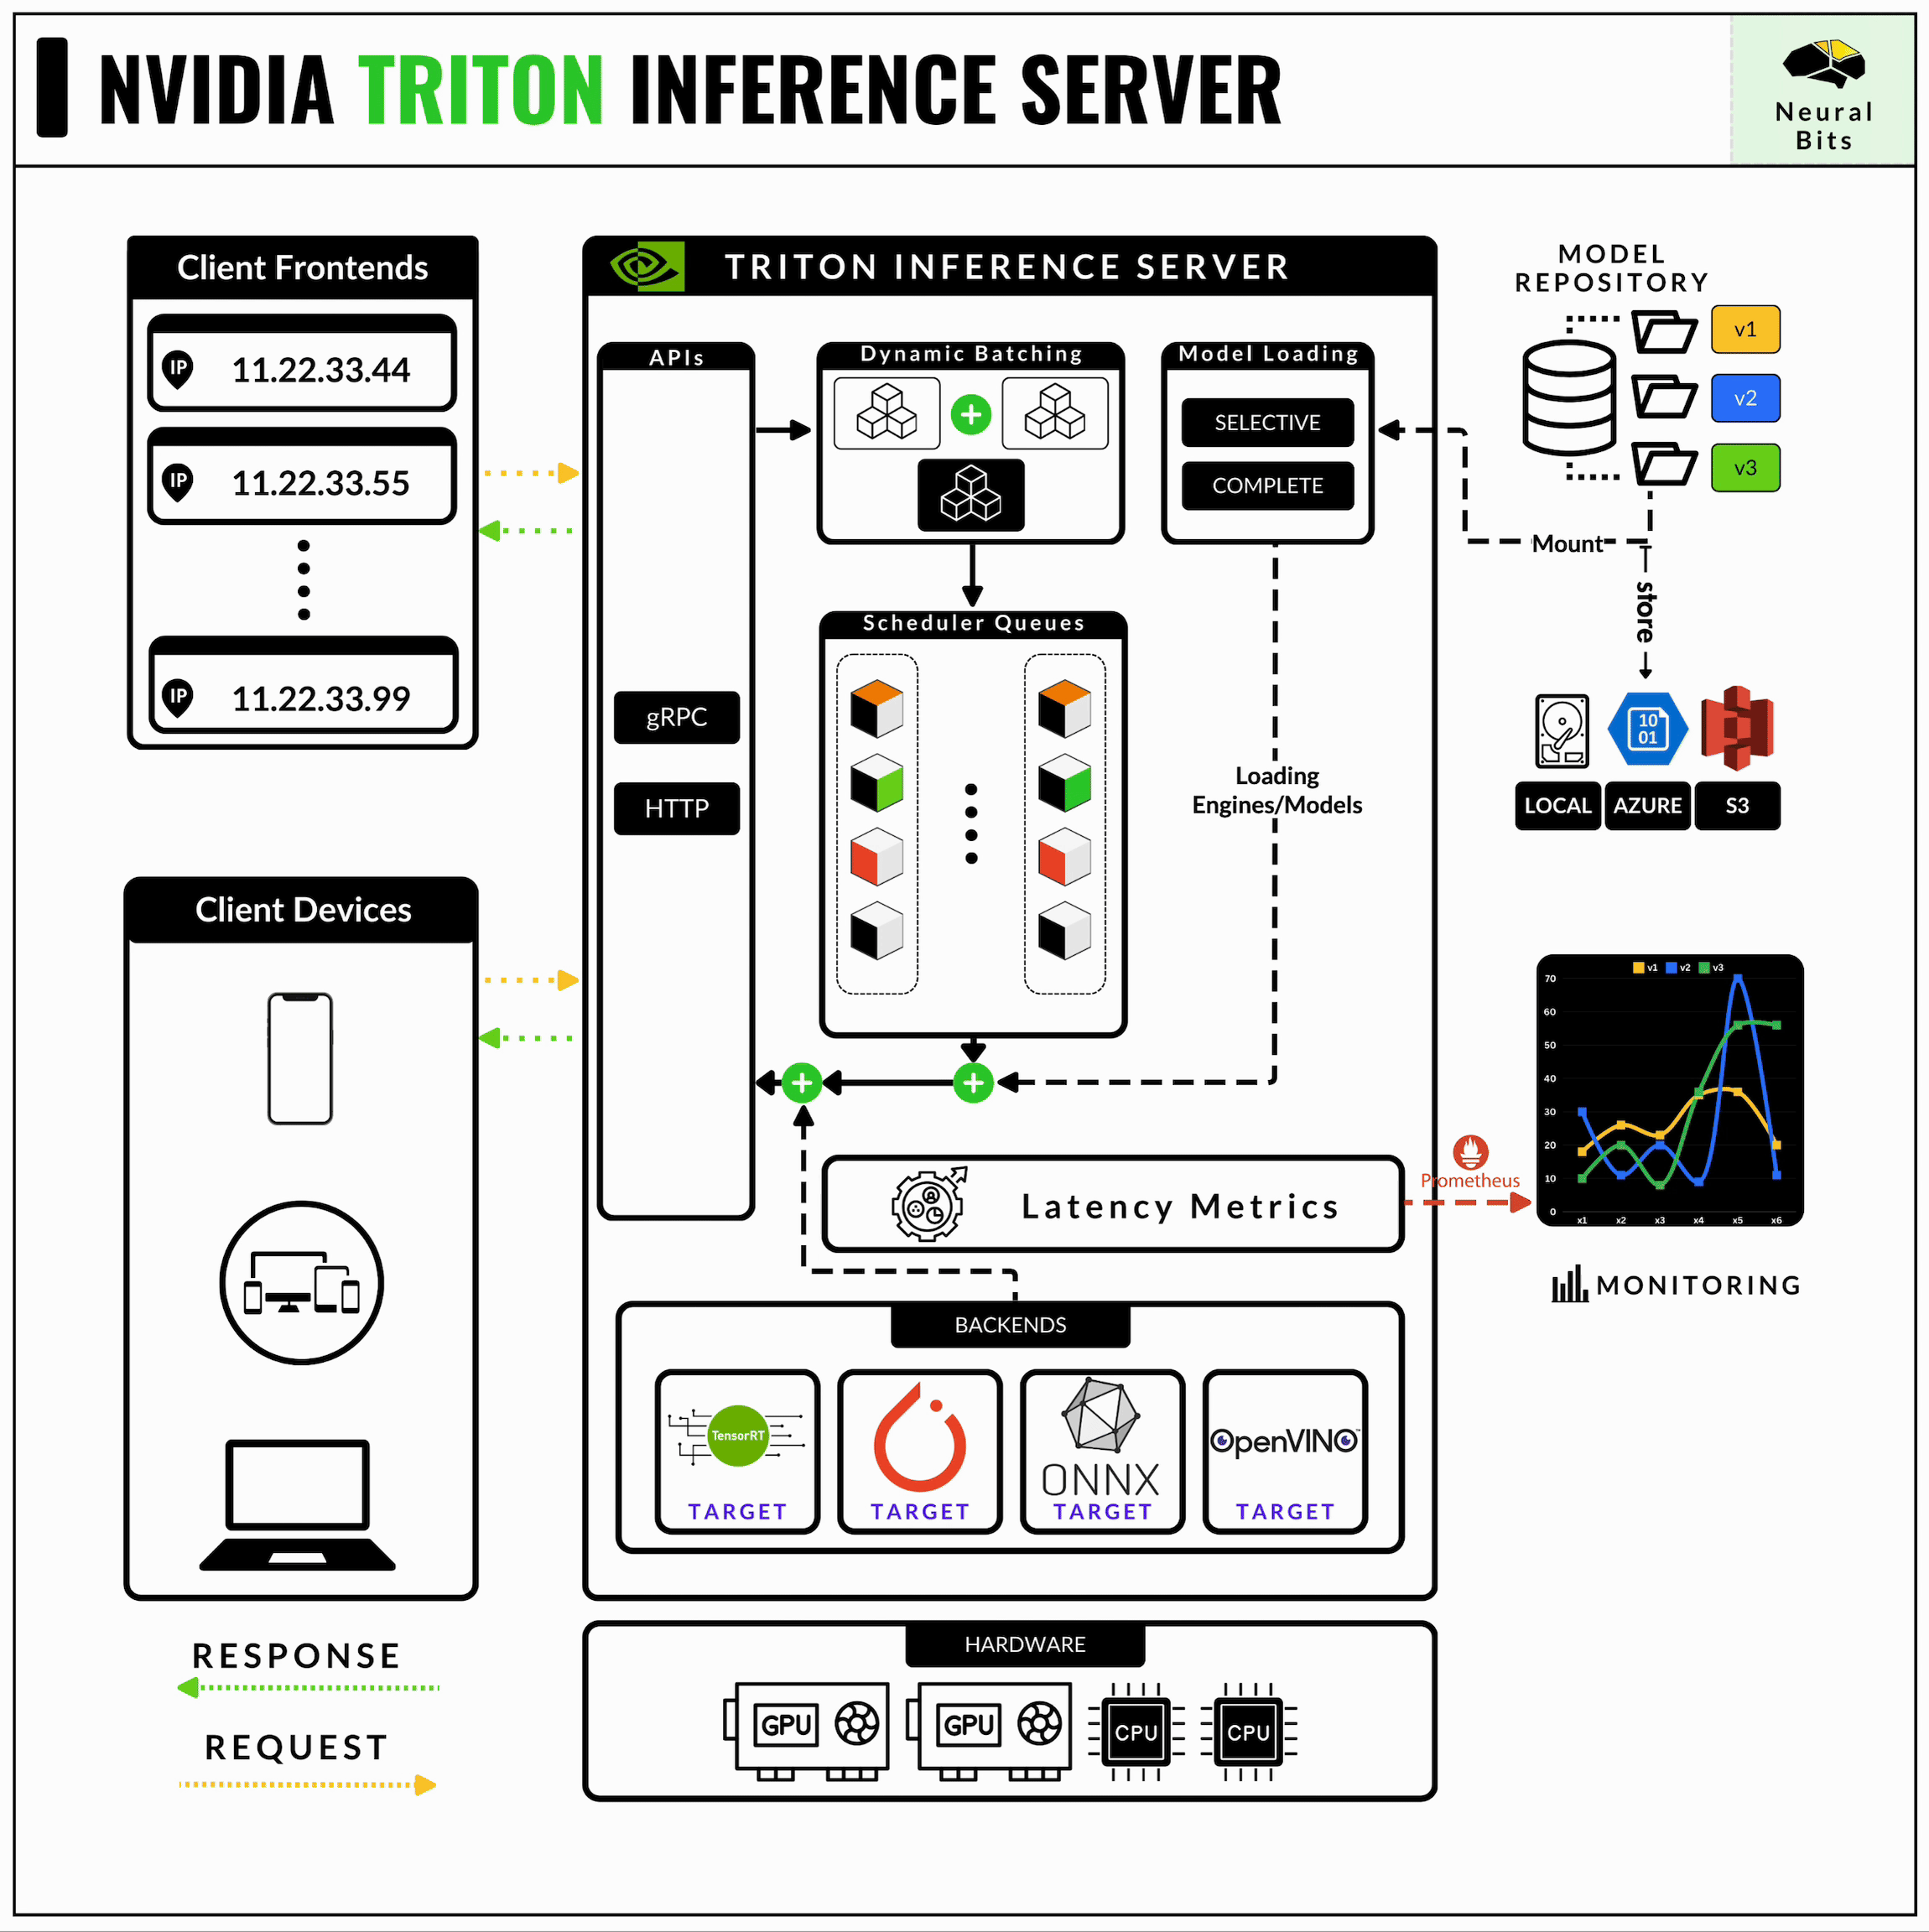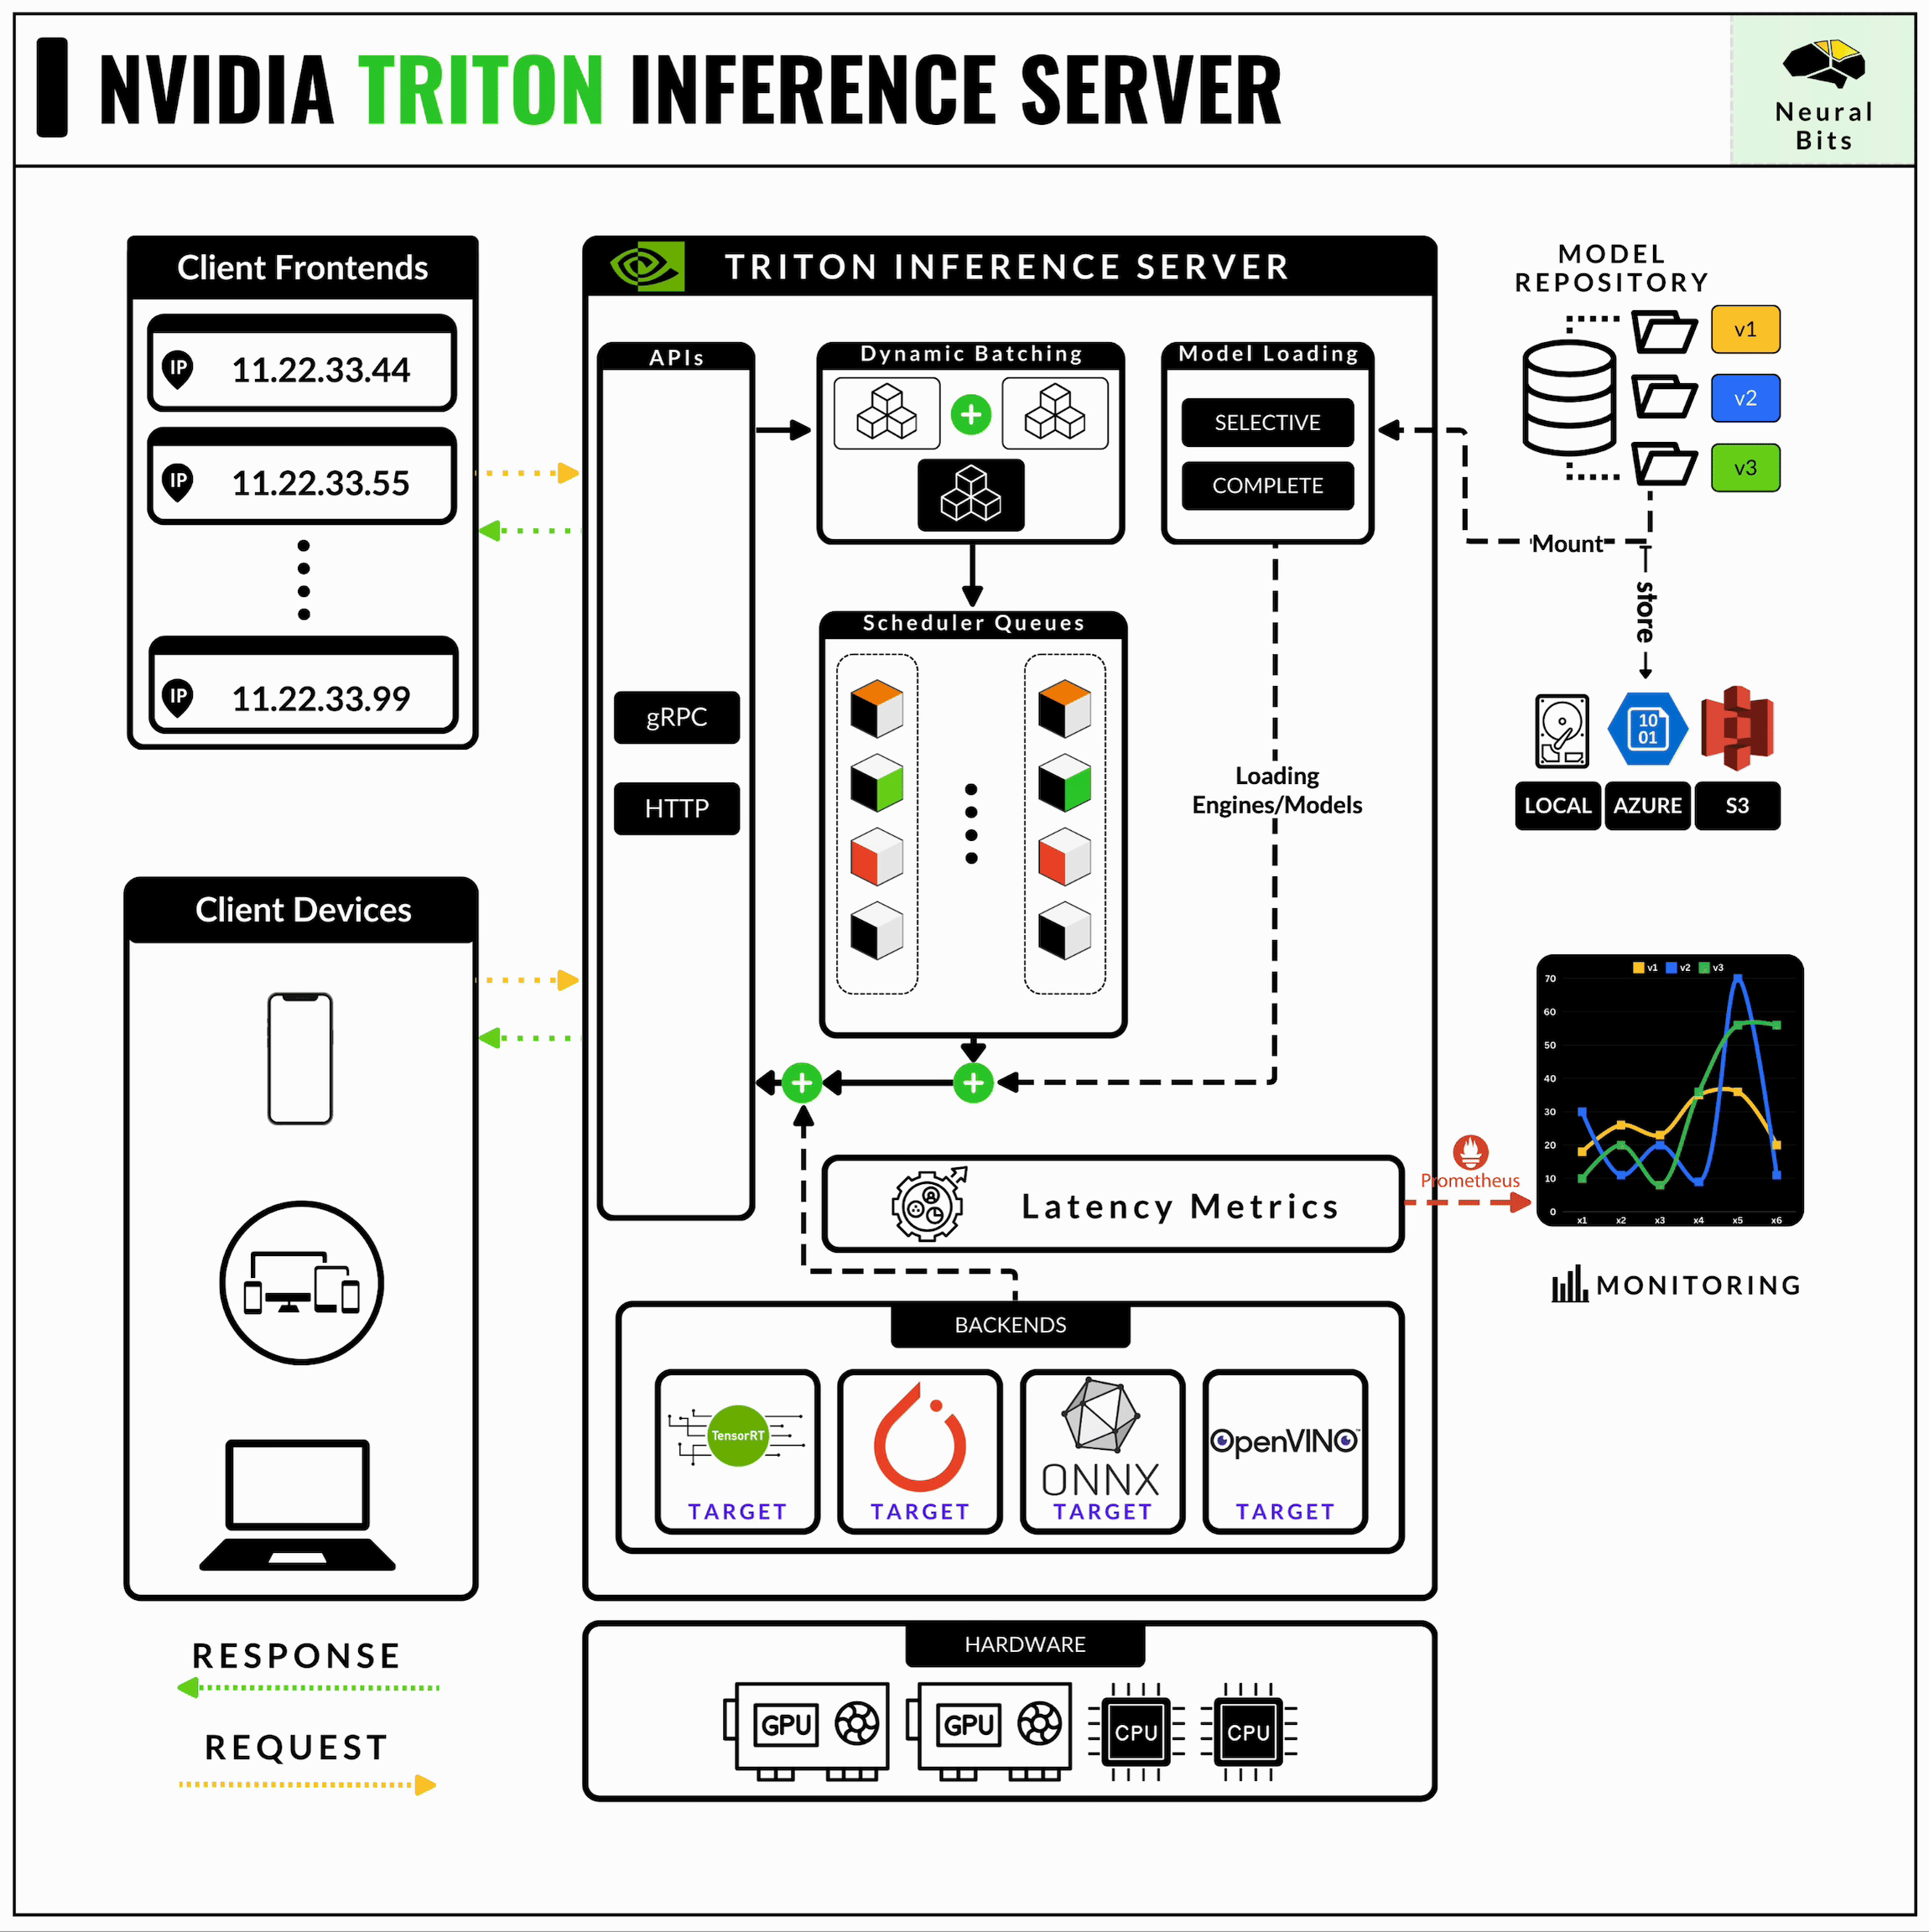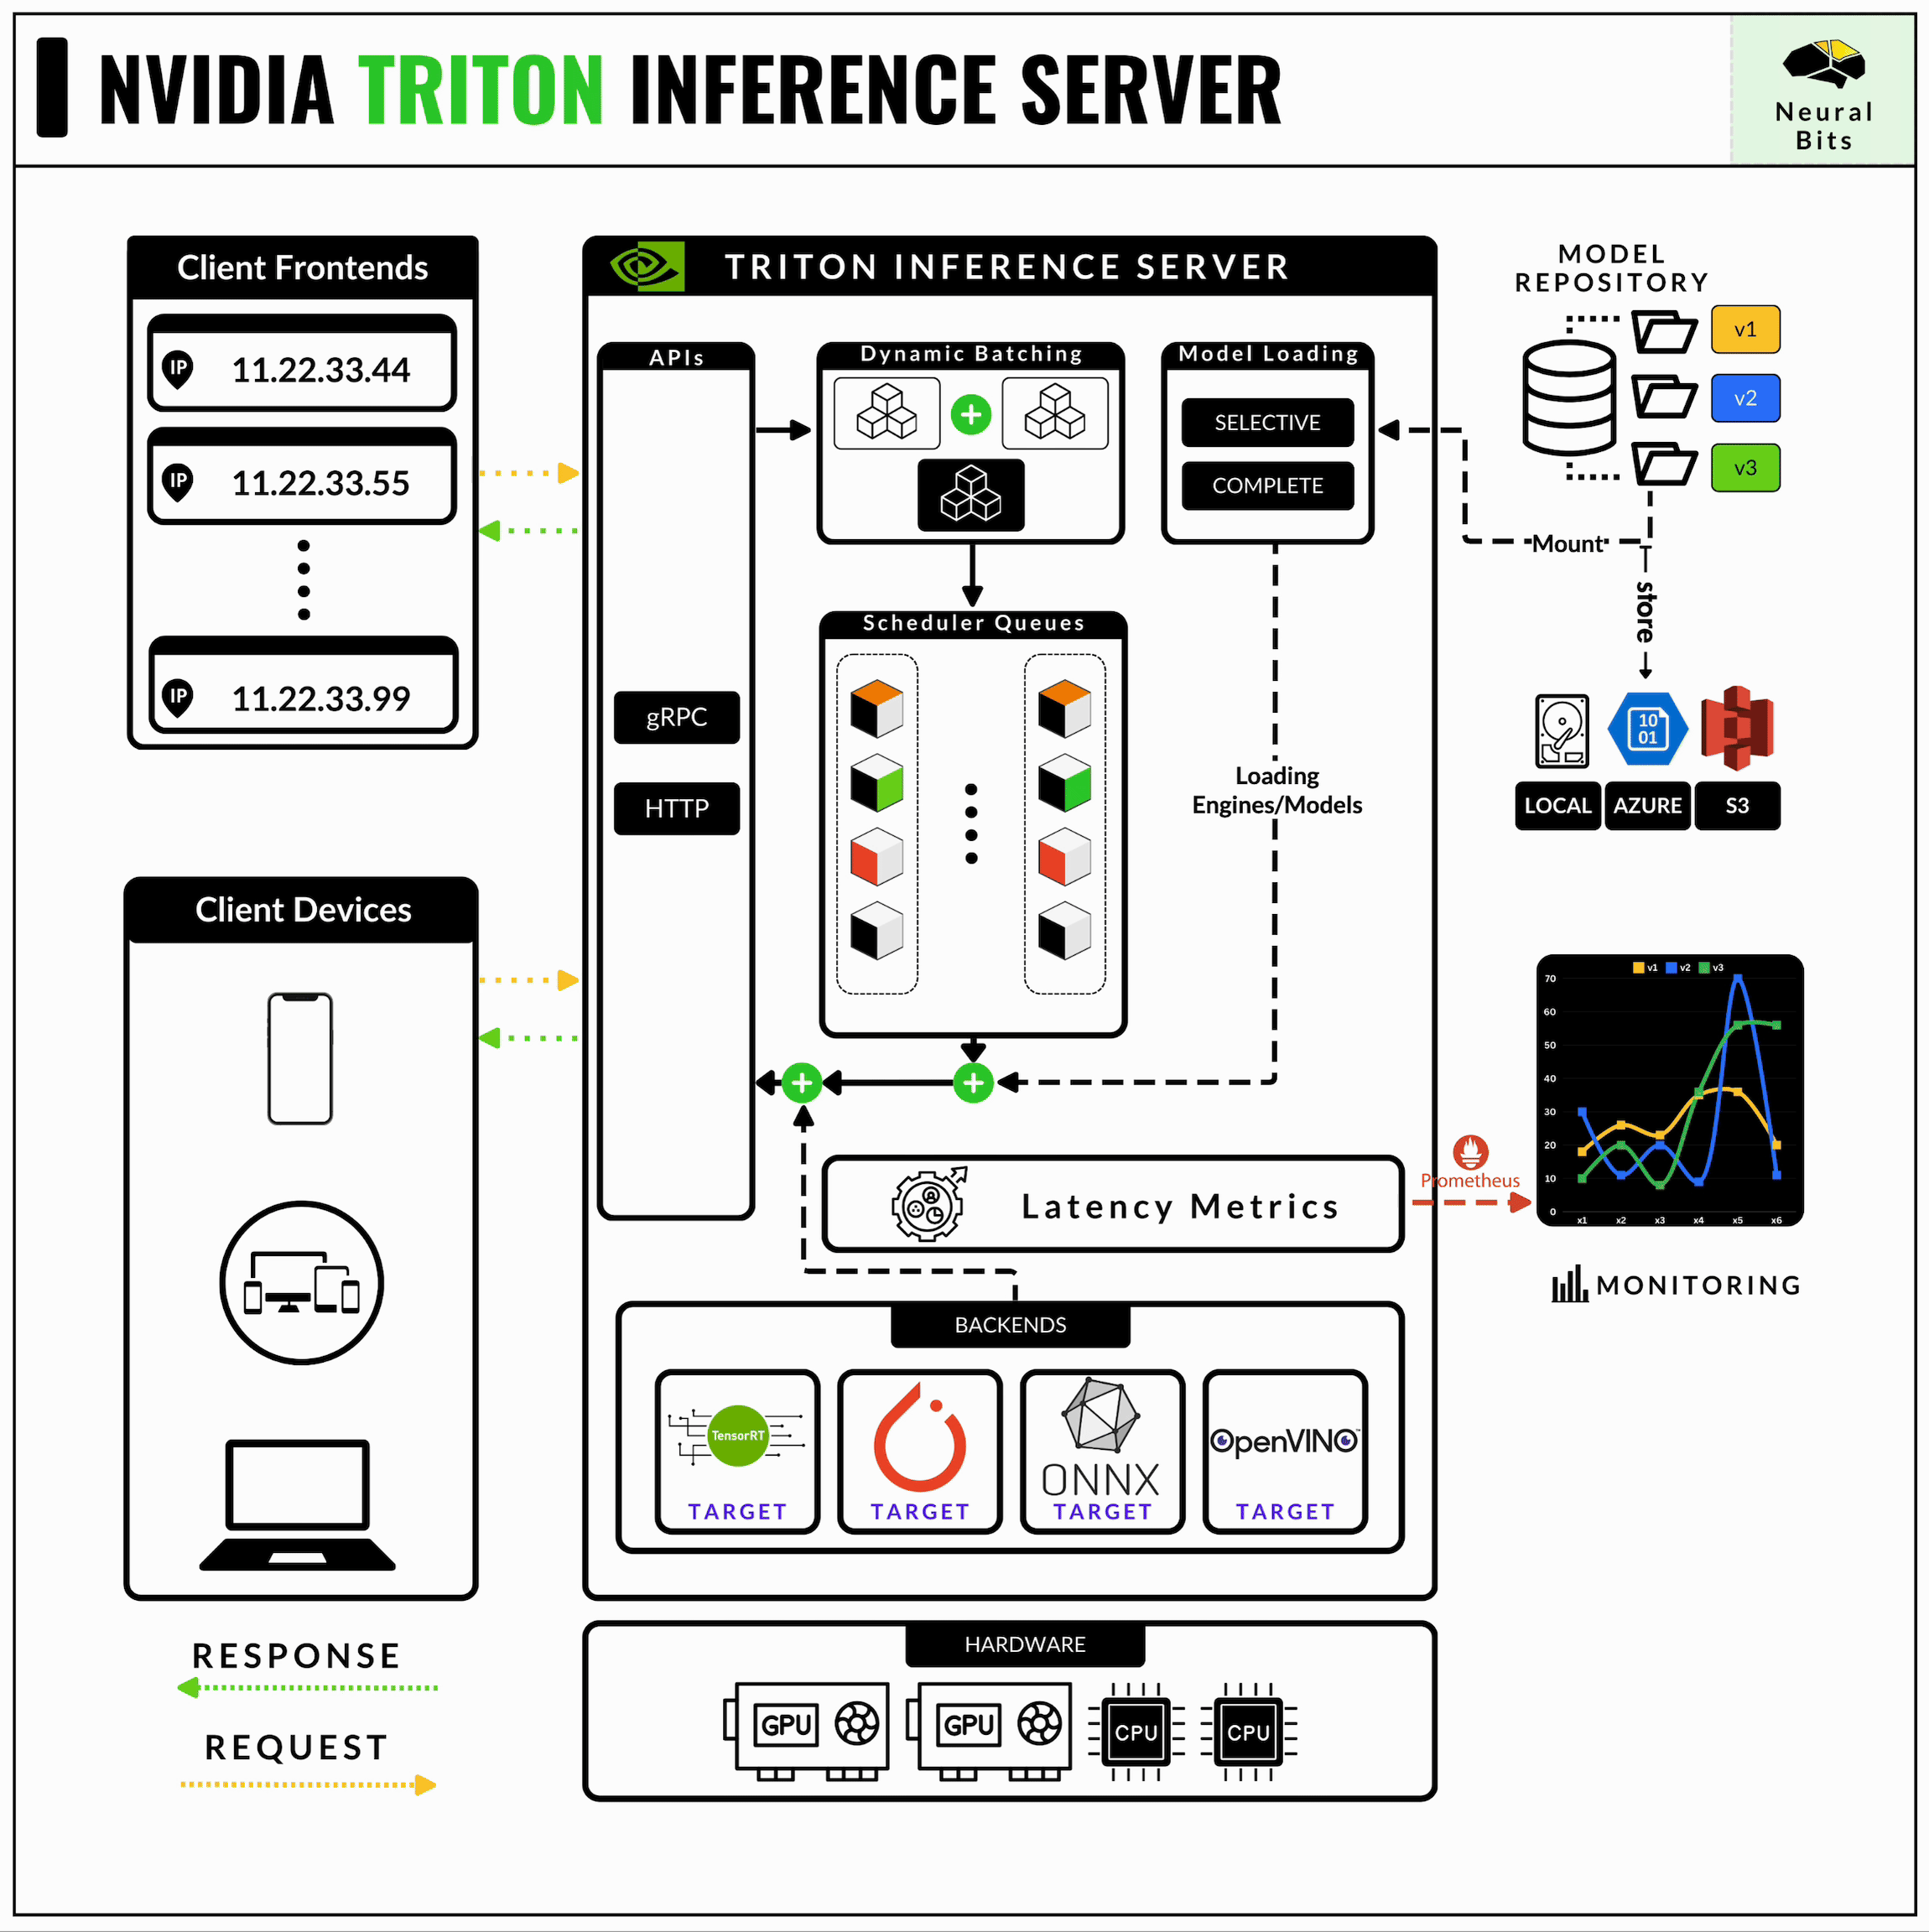
Deploy Triton Inference server and TensorRT-LLM - Cerebrium
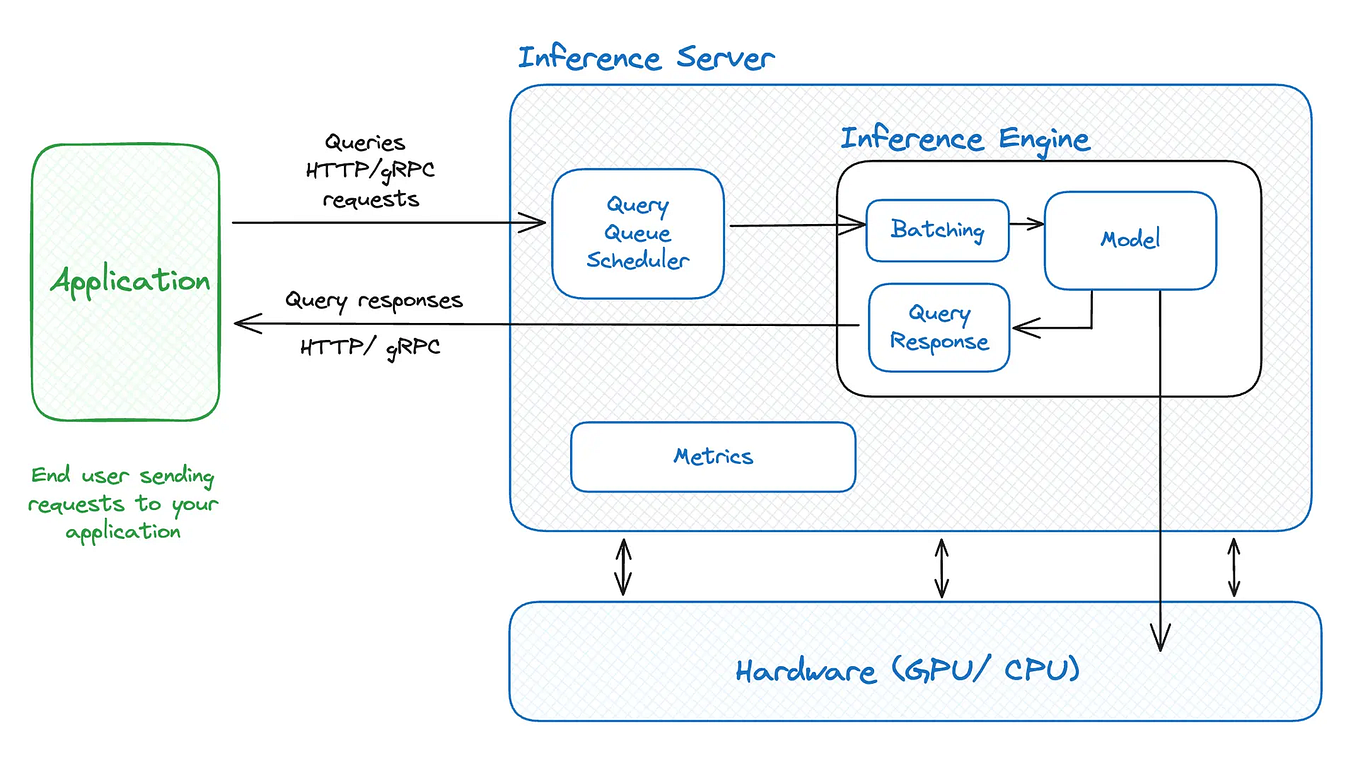
Deploying a Large Language Model (LLM) with TensorRT-LLM on Triton ...

Deploying a Large Language Model (LLM) with TensorRT-LLM on Triton ...

vLLM vs. Triton Inference Server: In-Depth Comparison for Optimized LLM ...
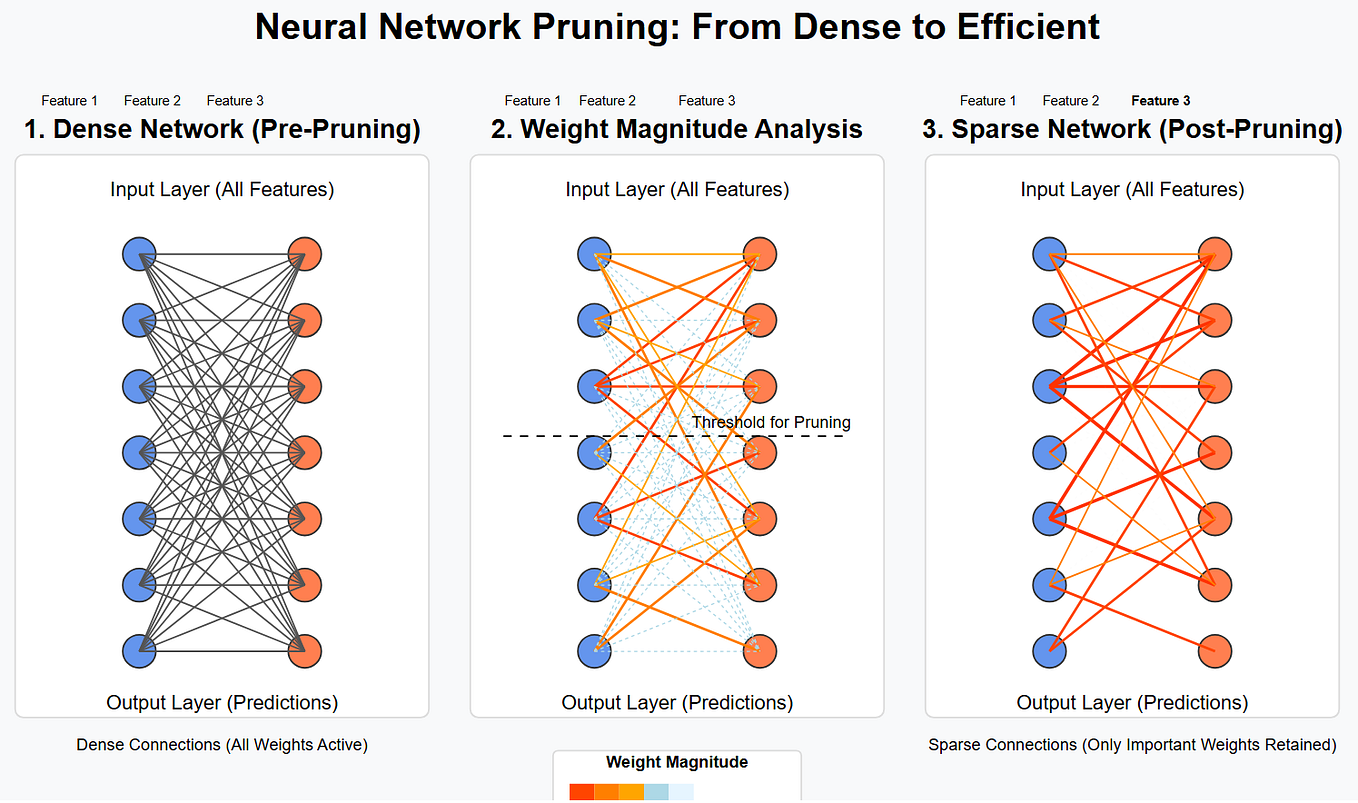
Deploying a Large Language Model (LLM) with TensorRT-LLM on Triton ...
Advertisement Space (336x280)

TensorRT-LLM Backend — NVIDIA Triton Inference Server

vLLM vs. Triton Inference Server: In-Depth Comparison for Optimized LLM ...
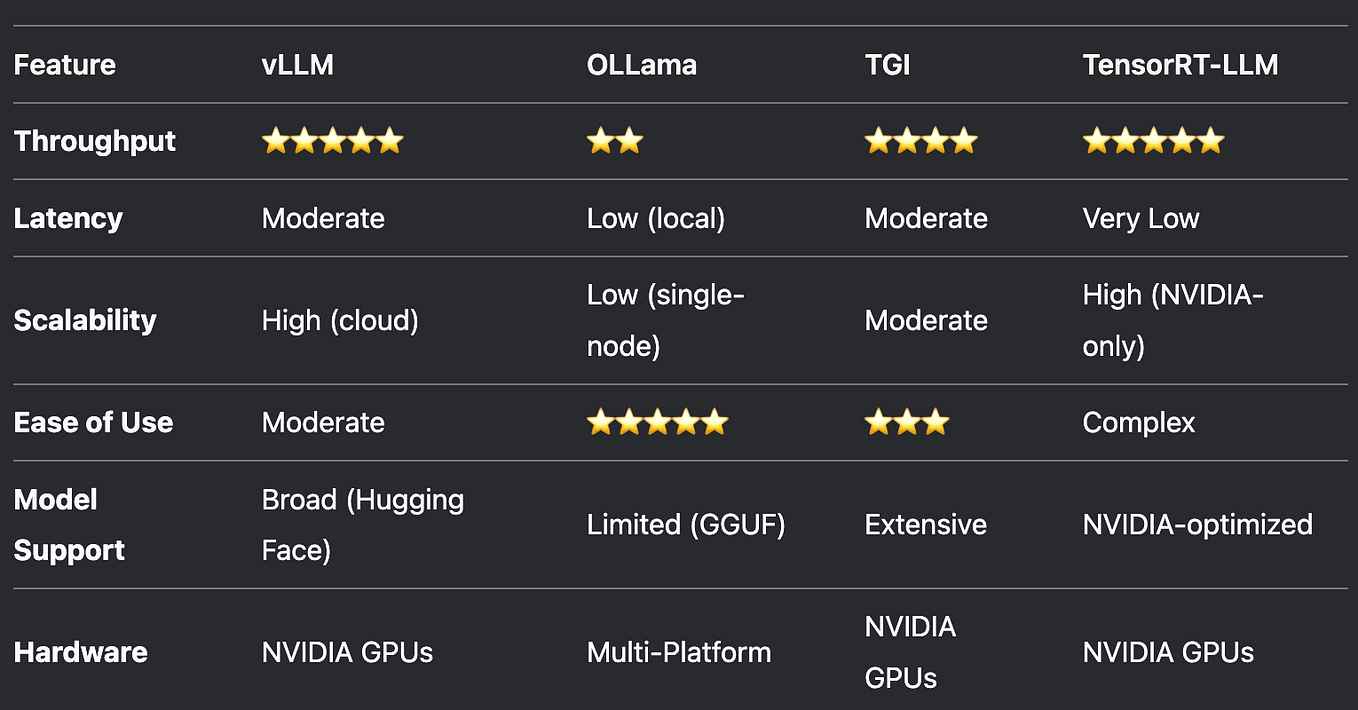
Deploying a Large Language Model (LLM) with TensorRT-LLM on Triton ...

The Great LLM Inference Showdown: TensorRT-LLM vs vLLM Technical Comparison
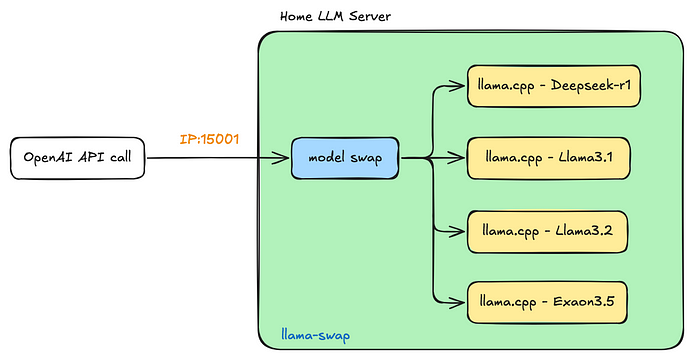
Deploying a Large Language Model (LLM) with TensorRT-LLM on Triton ...
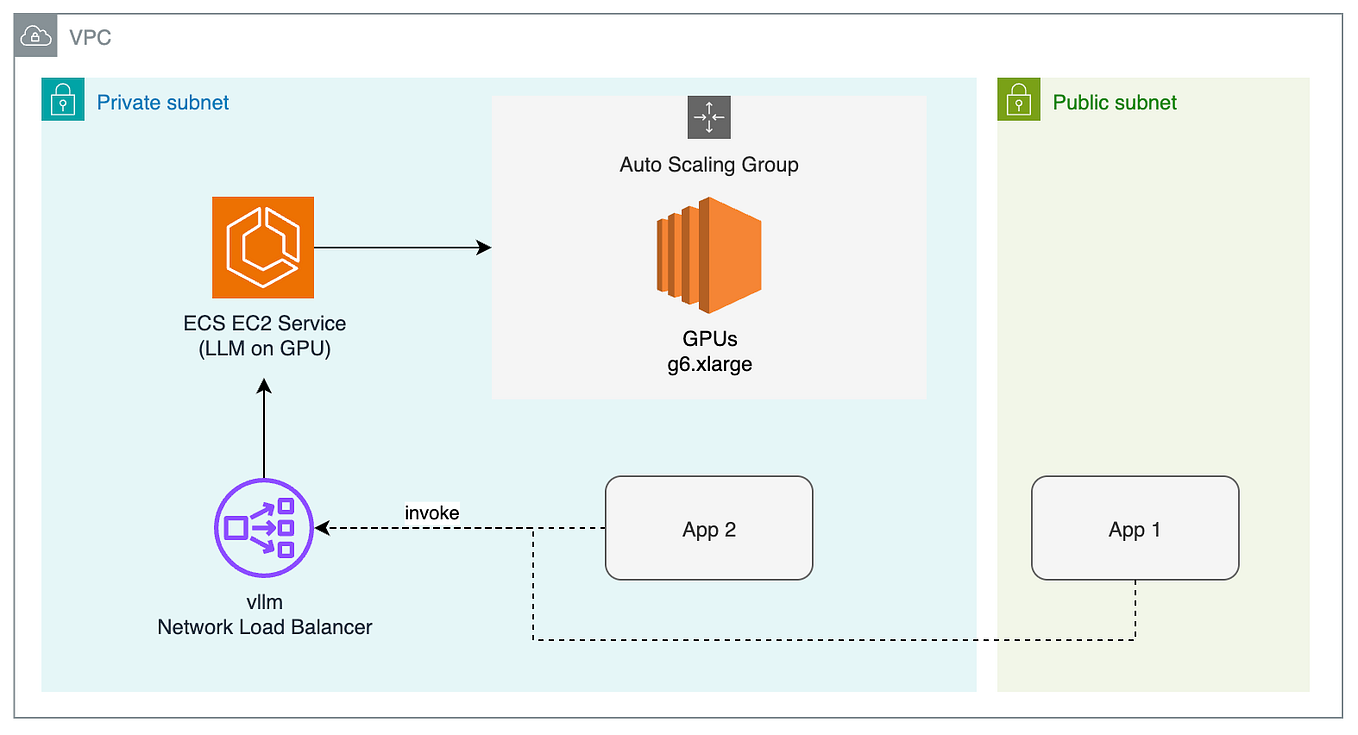
Deploying a Large Language Model (LLM) with TensorRT-LLM on Triton ...
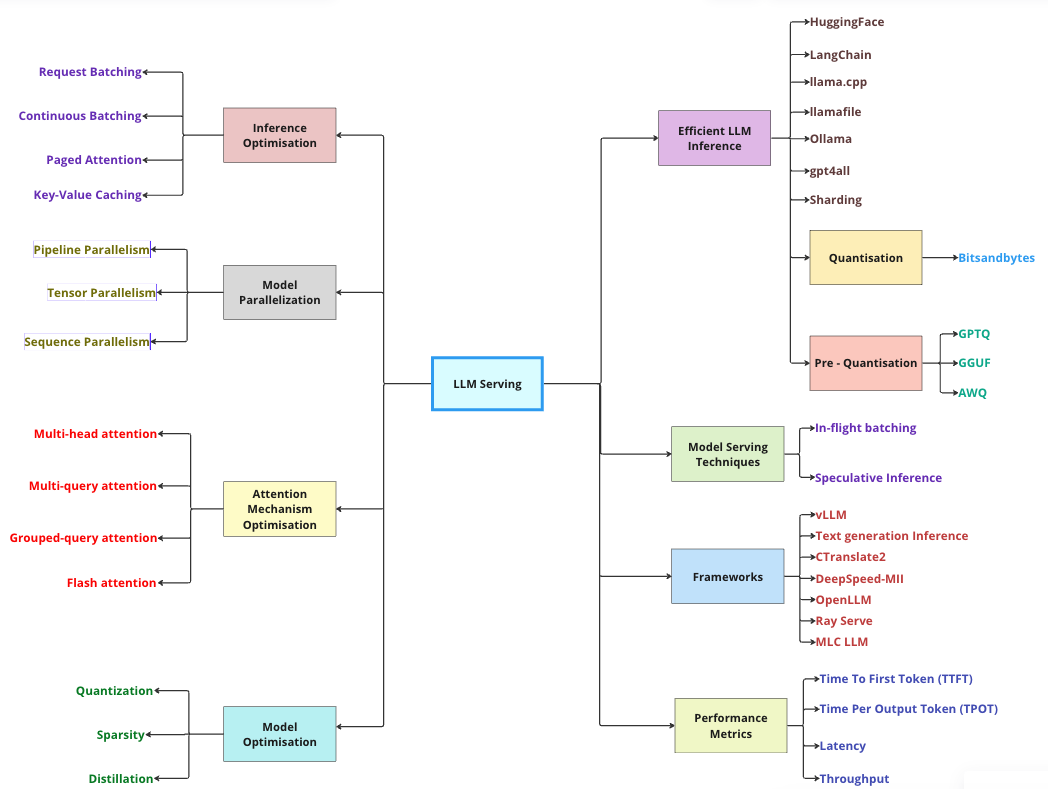
Deploying a Large Language Model (LLM) with TensorRT-LLM on Triton ...

Accelerated Inference for Large Transformer Models Using NVIDIA Triton ...
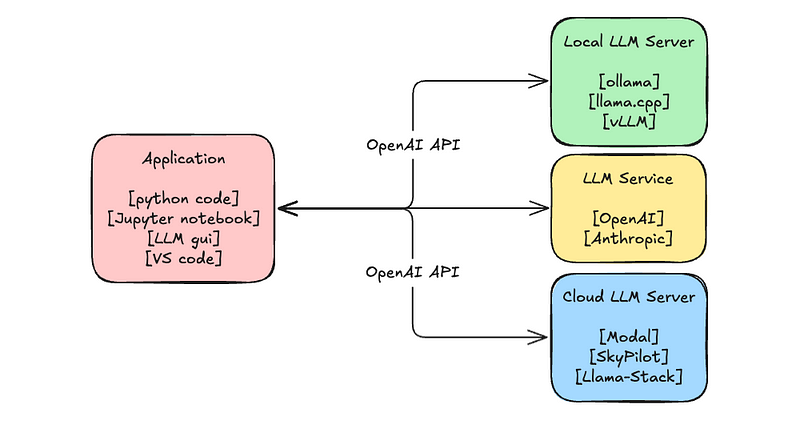
Deploying a Large Language Model (LLM) with TensorRT-LLM on Triton ...
Deploying a Large Language Model (LLM) with TensorRT-LLM on Triton ...
Advertisement Space (336x280)
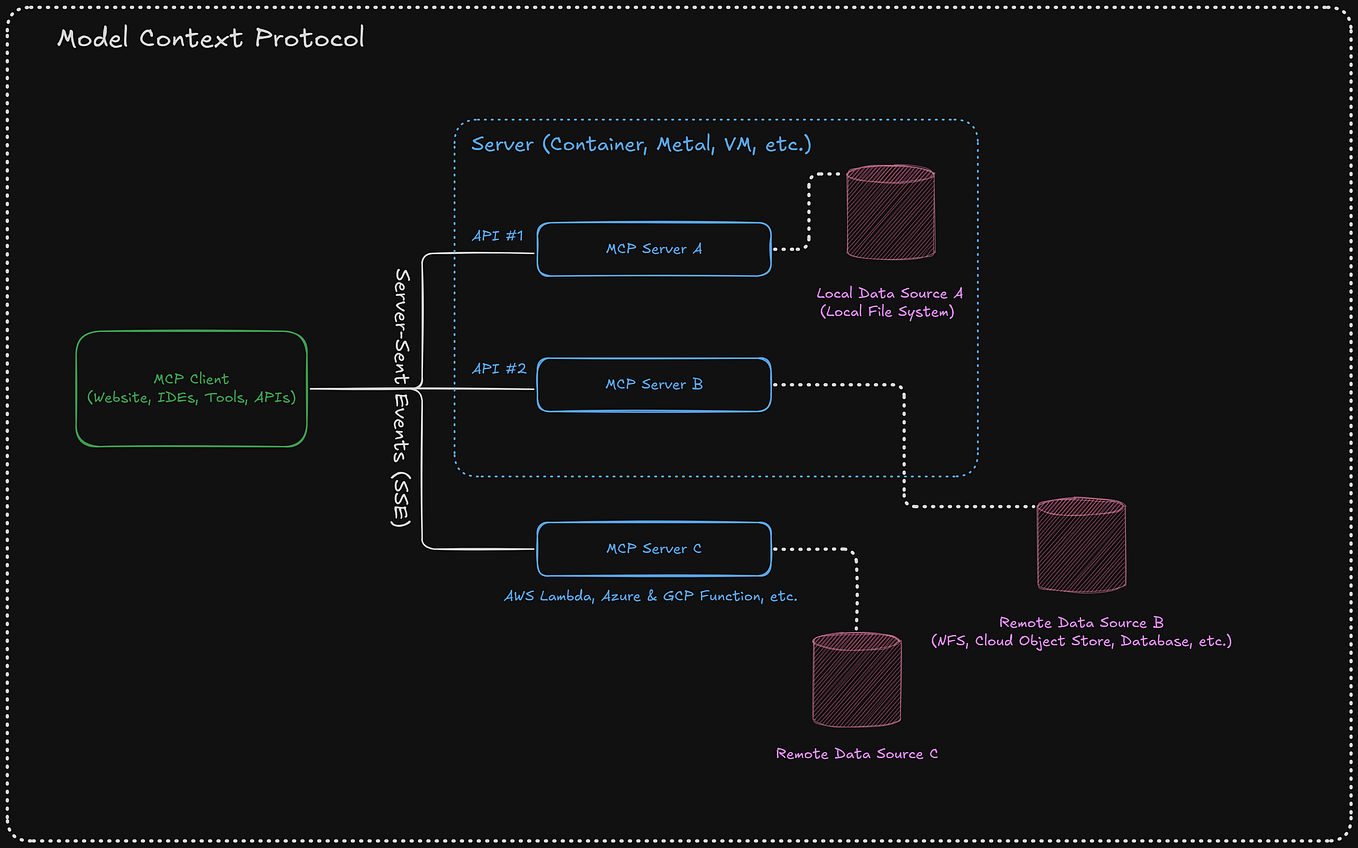
Deploying a Large Language Model (LLM) with TensorRT-LLM on Triton ...

LLM 推理:Nvidia TensorRT-LLM 与 Triton Inference Server_tensorrt llm ...
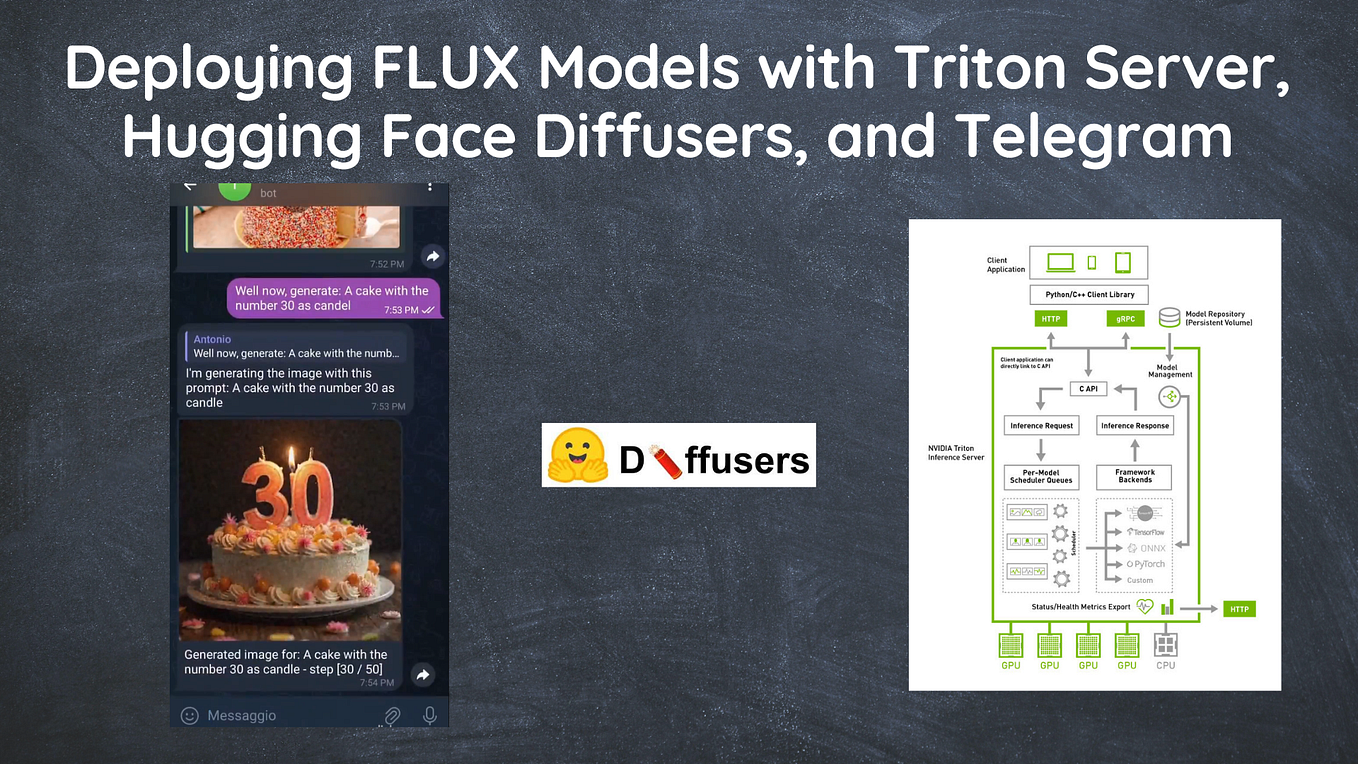
Deploying a Large Language Model (LLM) with TensorRT-LLM on Triton ...

Deploying a Large Language Model (LLM) with TensorRT-LLM on Triton ...
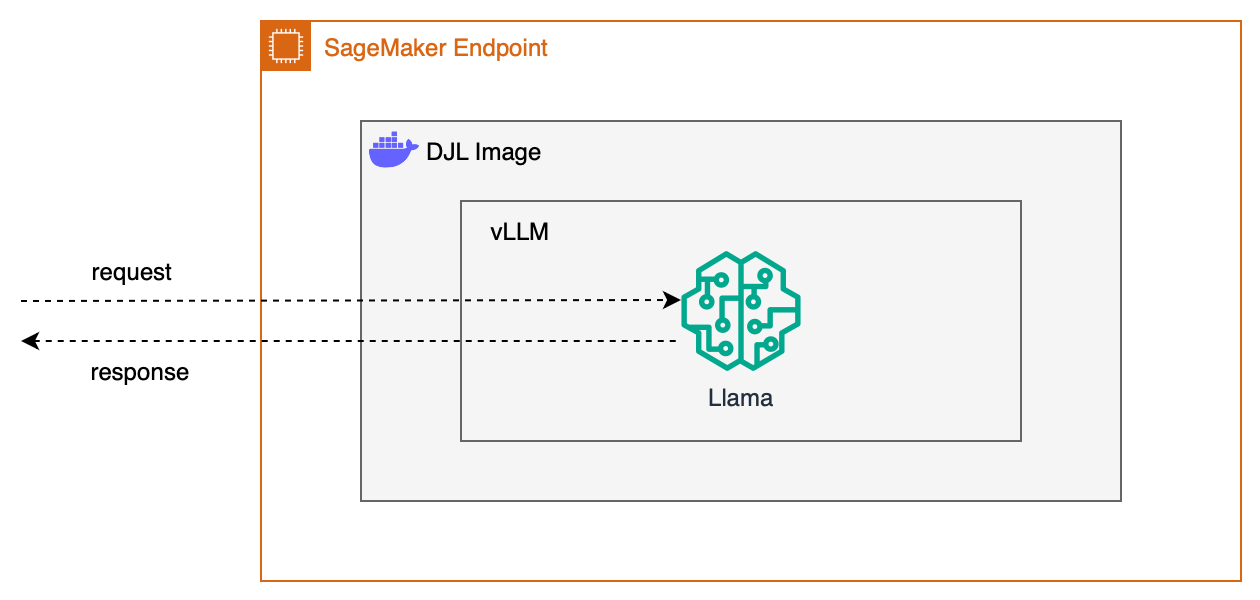
Deploying a Large Language Model (LLM) with TensorRT-LLM on Triton ...
Deploying a Large Language Model (LLM) with TensorRT-LLM on Triton ...