
Trainable Log Linear Sparse Attention For Efficient Diffusion
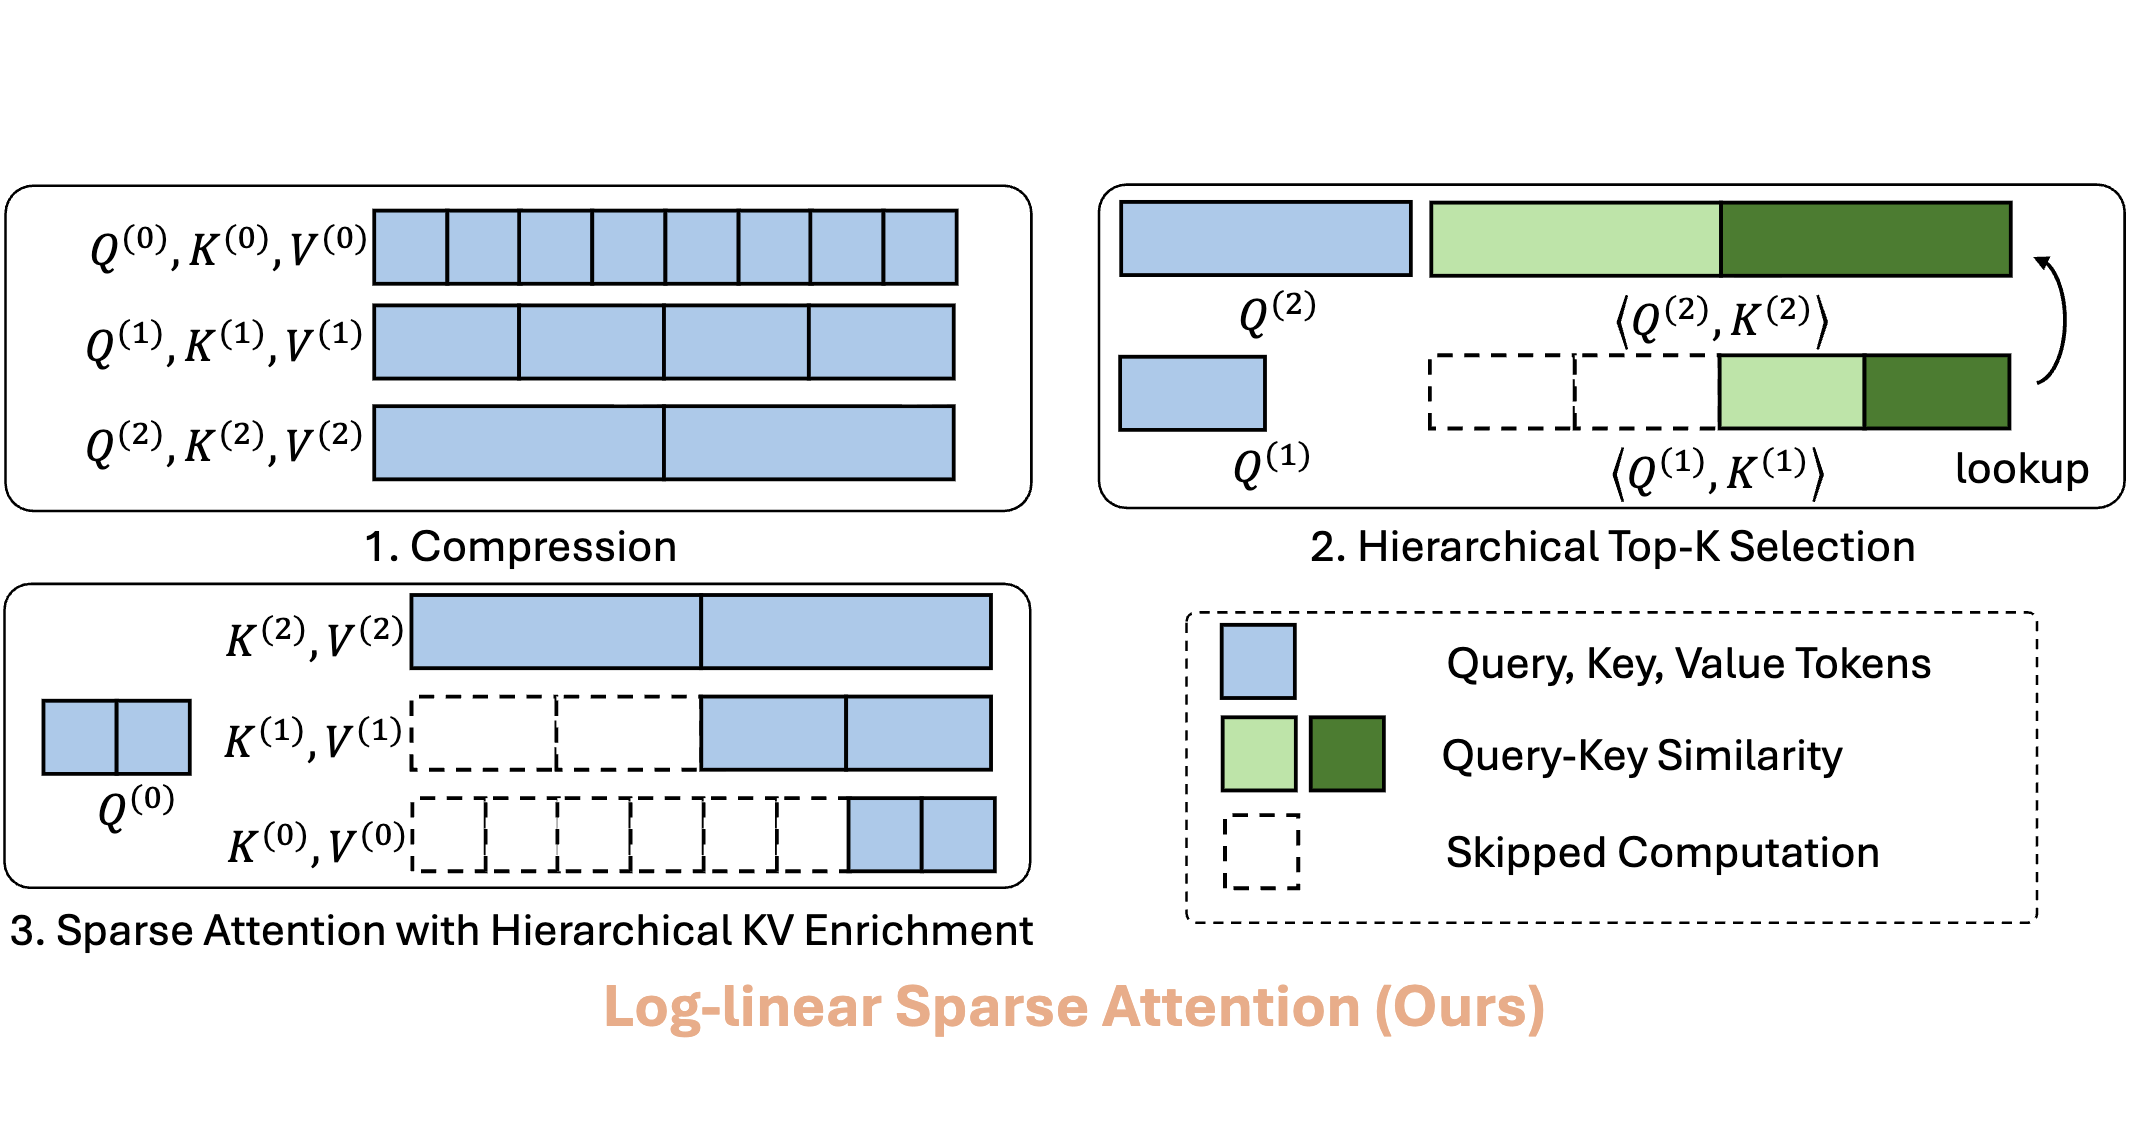
Trainable Log-linear Sparse Attention for Efficient Diffusion Transformers

Trainable Log-linear Sparse Attention for Efficient Diffusion Transformers
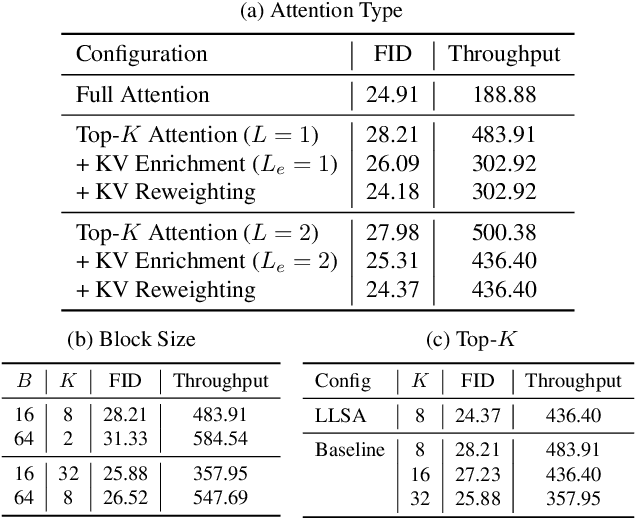
Trainable Log-linear Sparse Attention for Efficient Diffusion Transformers
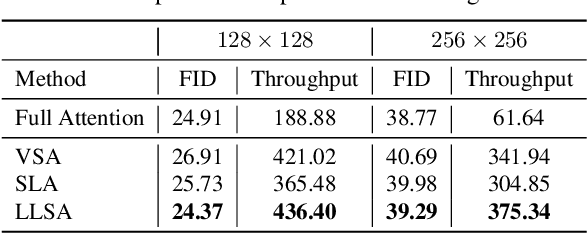
Trainable Log-linear Sparse Attention for Efficient Diffusion Transformers

Trainable Log-linear Sparse Attention for Efficient Diffusion Transformers
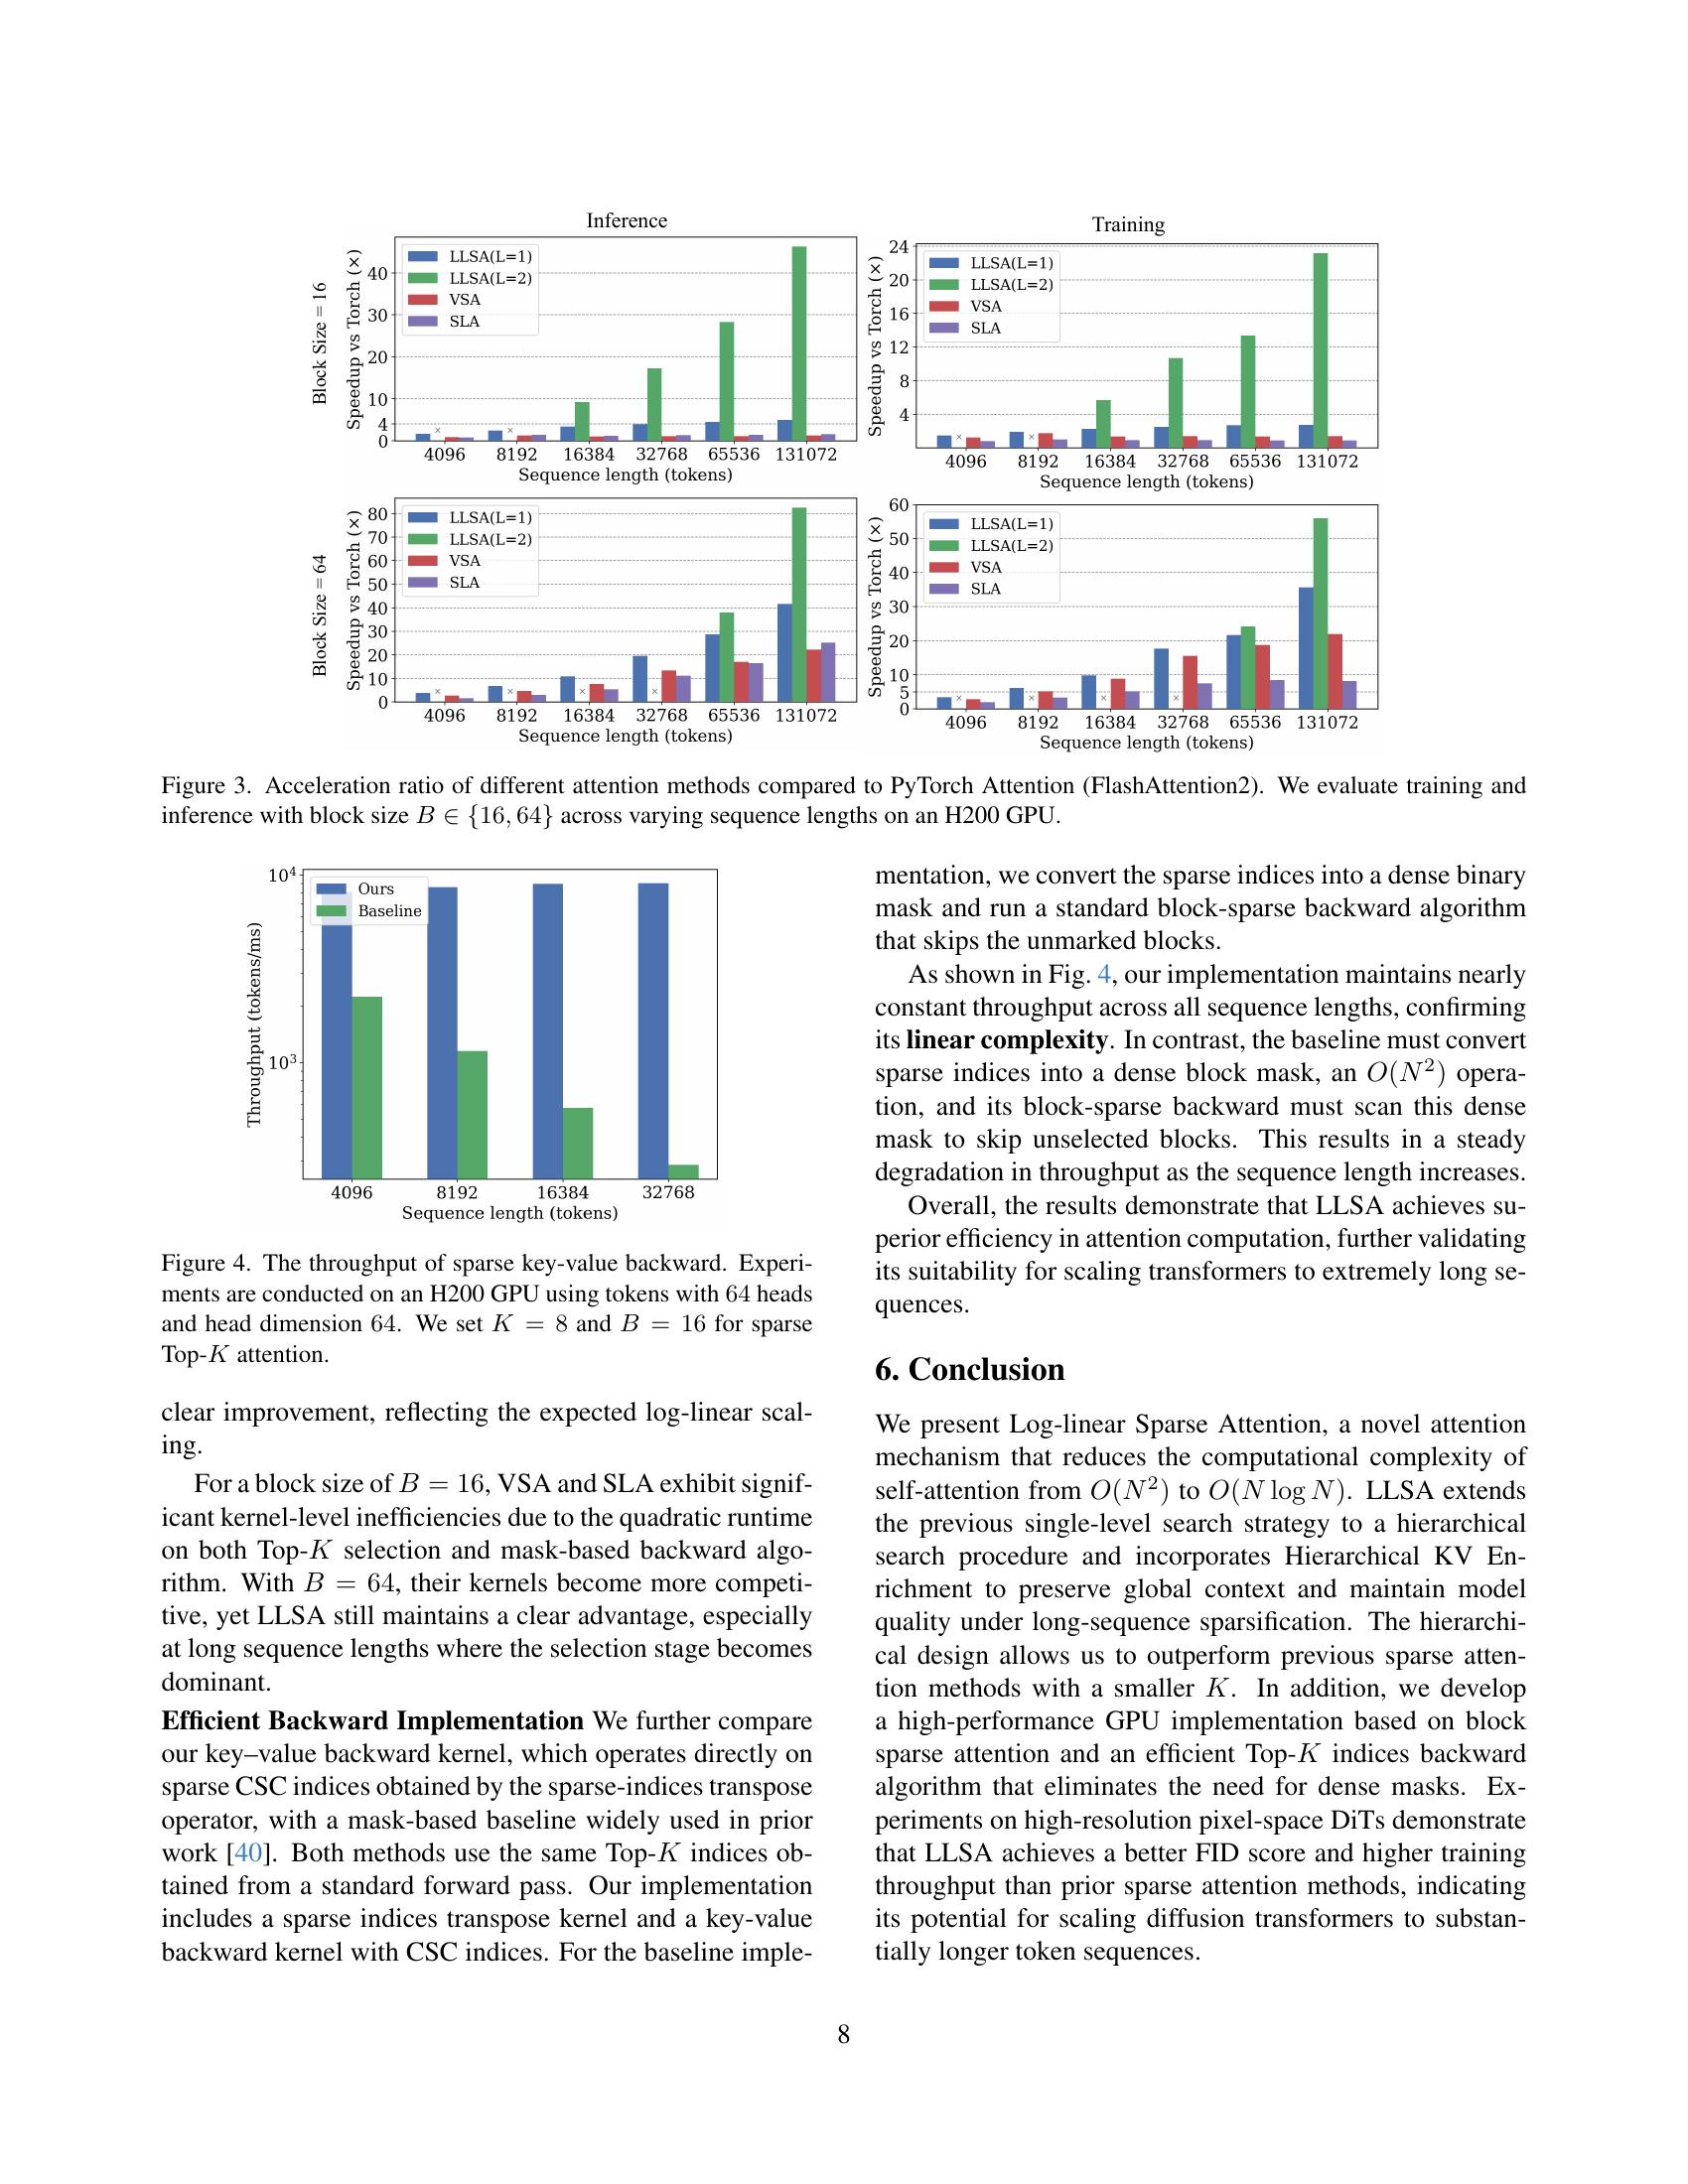
Trainable Log-linear Sparse Attention for Efficient Diffusion ...
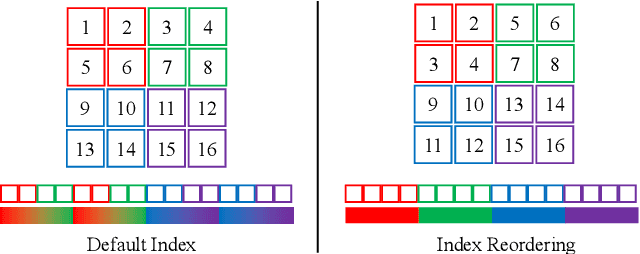
Trainable Log-linear Sparse Attention for Efficient Diffusion Transformers

SparseD: Sparse Attention for Diffusion Language Models | AI Research ...

LVSA: Training-Free Sparse Attention for Long Video Diffusion
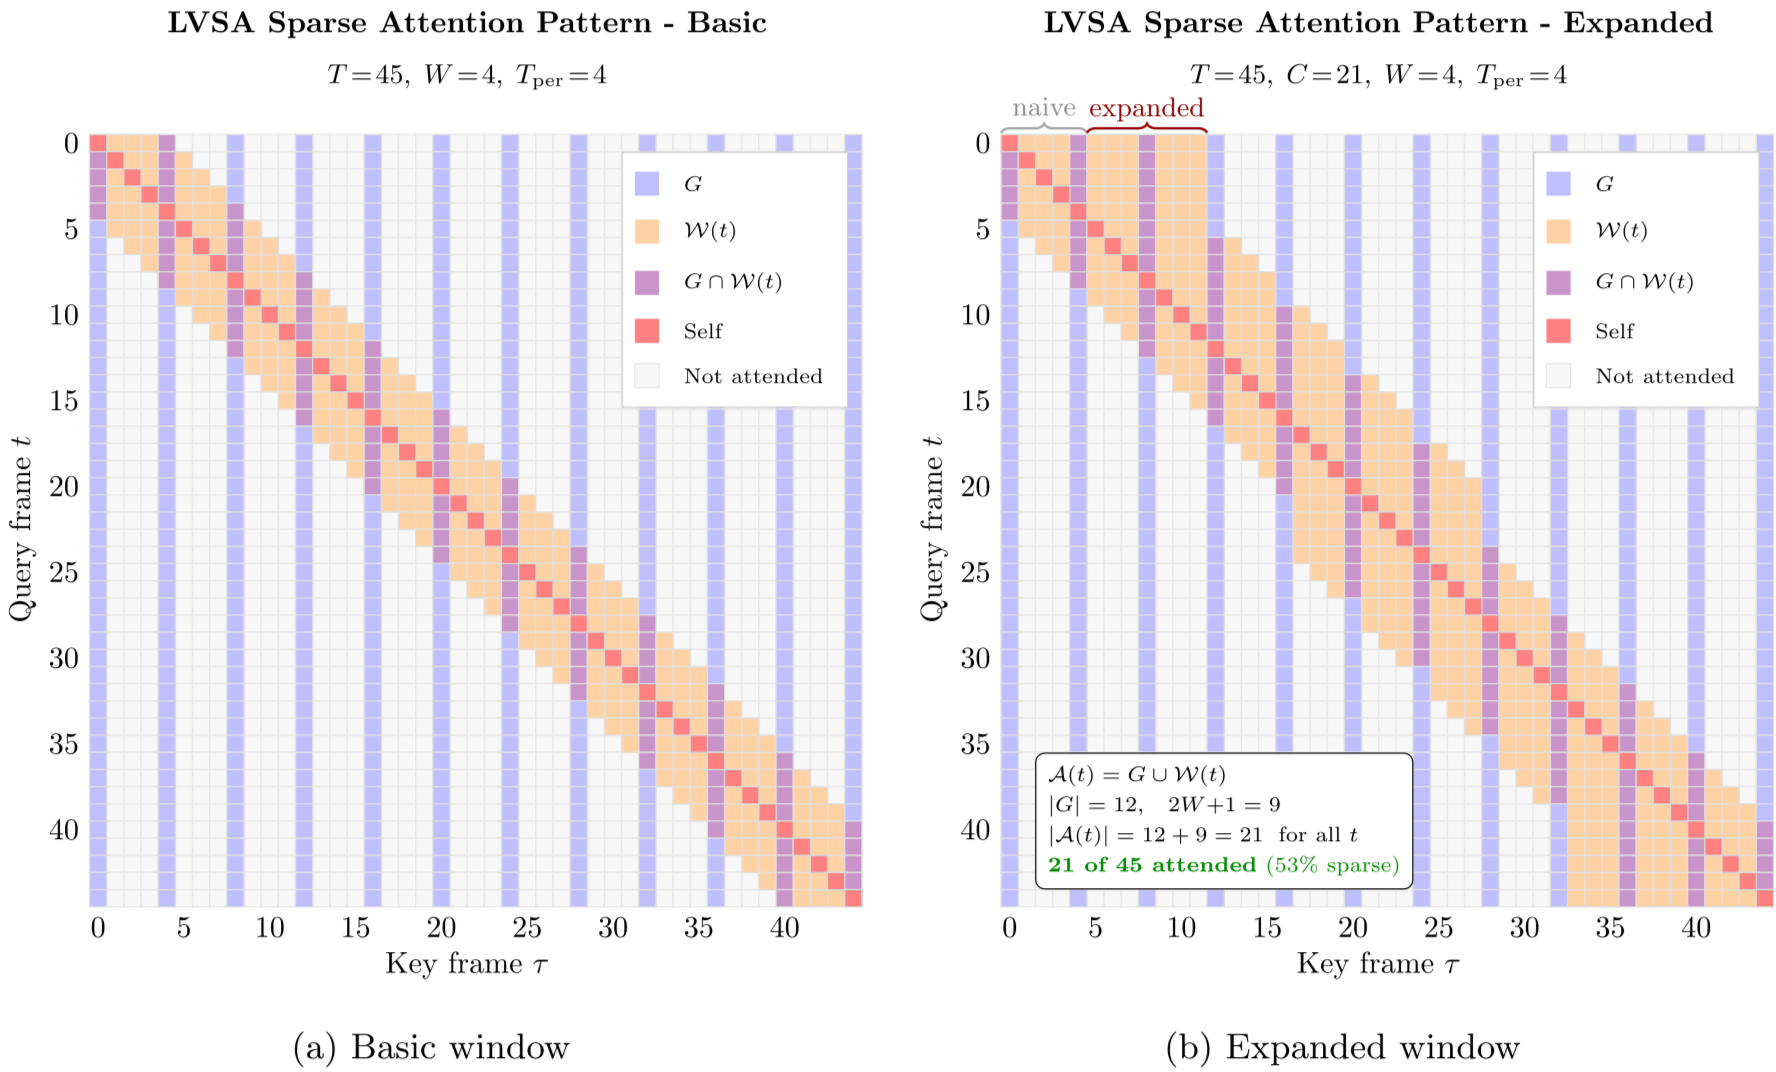
[논문 리뷰] LVSA: Training-Free Sparse Attention for Long Video Diffusion
Advertisement Space (300x250)

(PDF) SparseD: Sparse Attention for Diffusion Language Models

Paper page - Faster Video Diffusion with Trainable Sparse Attention
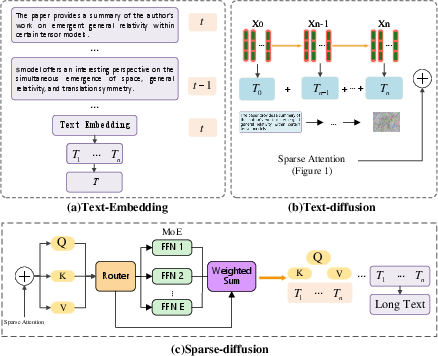
SA-DiffuSeq: Sparse Attention & Diffusion for Long Text

[论文评述] Faster Video Diffusion with Trainable Sparse Attention
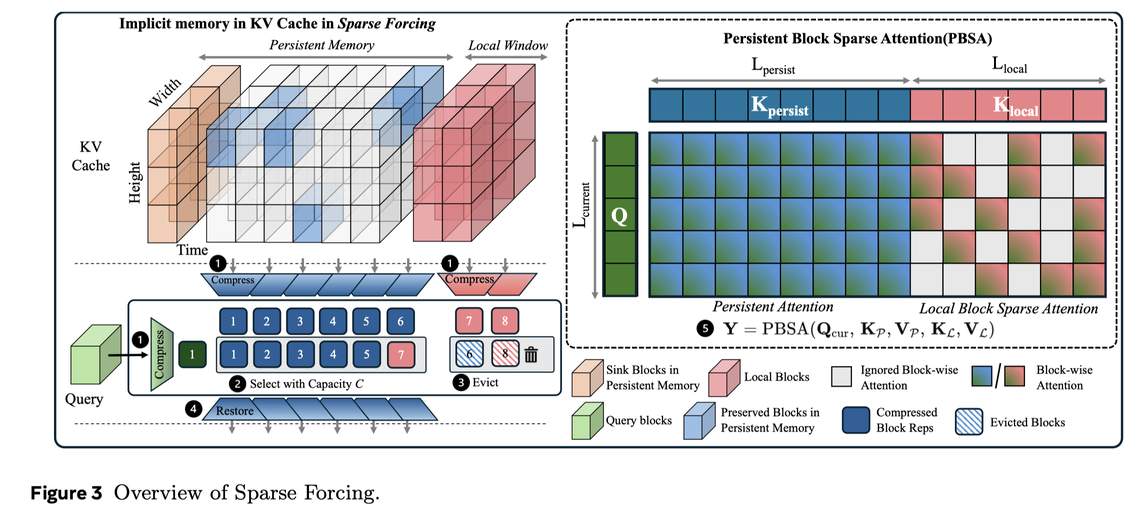
Sparse Forcing: Native Trainable Sparse Attention for Real-time ...

Paper page - MiniCPM-SALA: Hybridizing Sparse and Linear Attention for ...

DFSAttn: Dynamic Fine-grained Sparse Attention for Efficient Video ...

SparseD: Sparse Attention for Diffusion Language Models | AI Research ...
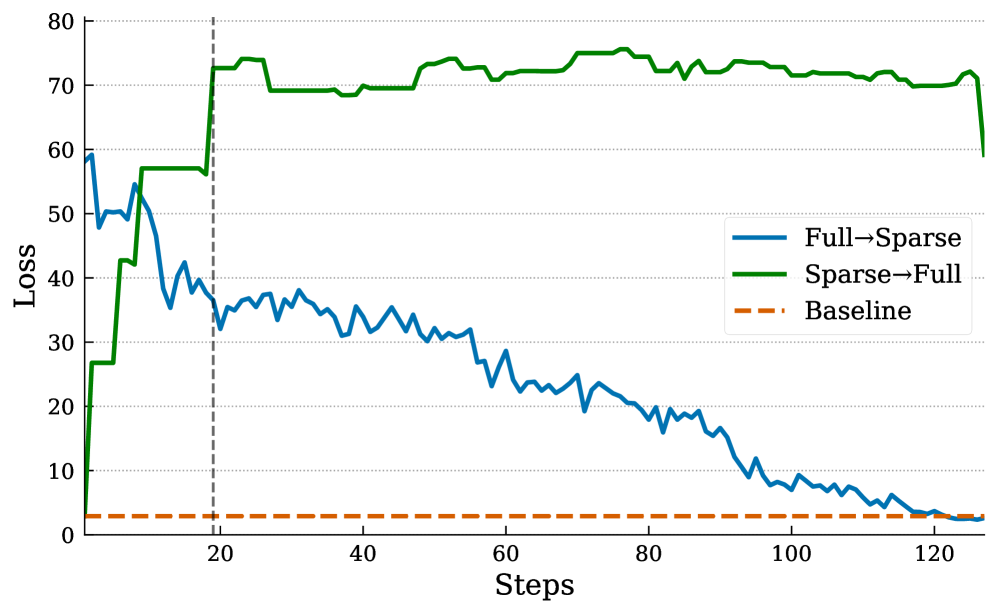
SparseD: Sparse Attention for Diffusion Language Models | AI Research ...
VSA: Faster Video Diffusion with Trainable Sparse Attention | alphaXiv
Advertisement Space (336x280)
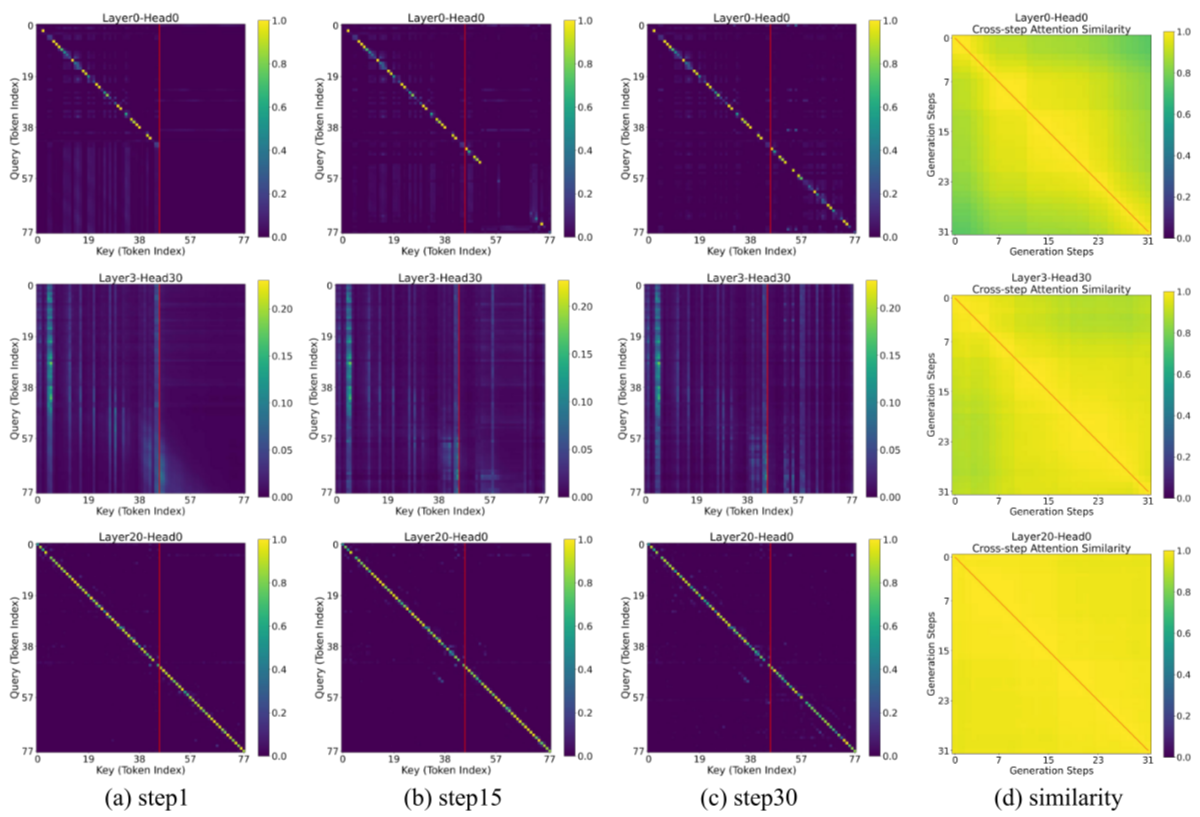
[논문 리뷰] SparseD: Sparse Attention for Diffusion Language Models
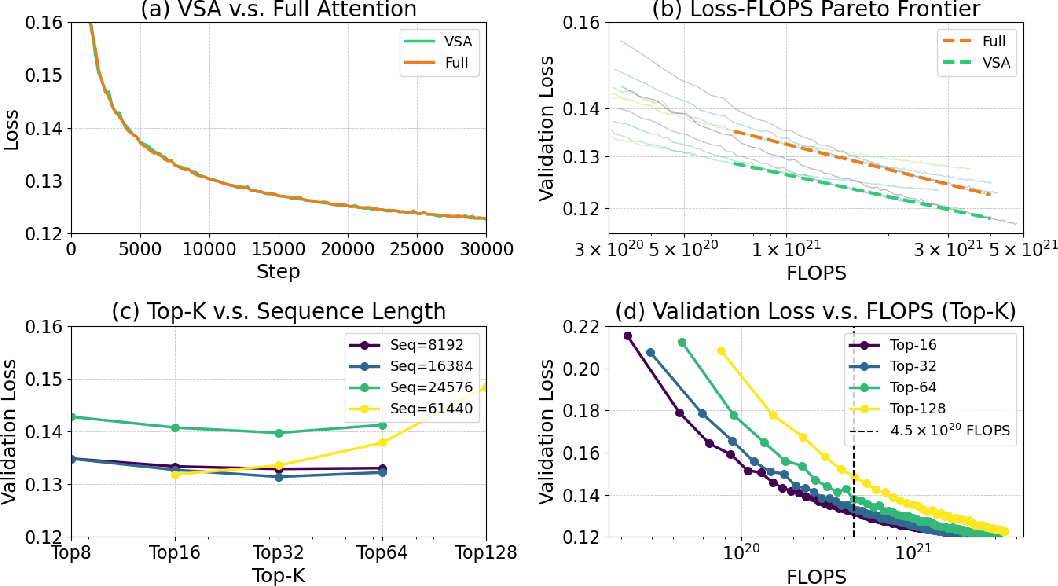
Figure 2 from VSA: Faster Video Diffusion with Trainable Sparse ...

SALAD: Achieve High-Sparsity Attention via Efficient Linear Attention ...

SALAD: Achieve High-Sparsity Attention via Efficient Linear Attention ...

SALAD: Achieve High-Sparsity Attention via Efficient Linear Attention ...

SALAD: Achieve High-Sparsity Attention via Efficient Linear Attention ...

SALAD: Achieve High-Sparsity Attention via Efficient Linear Attention ...

SALAD: Achieve High-Sparsity Attention via Efficient Linear Attention ...

SALAD: Achieve High-Sparsity Attention via Efficient Linear Attention ...

DiG: Scalable and Efficient Diffusion Models with Gated Linear ...
Advertisement Space (336x280)
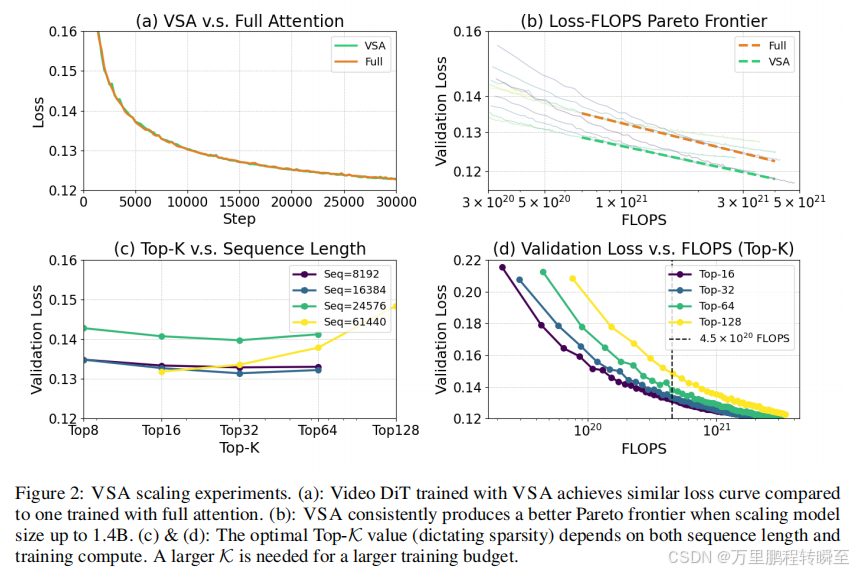
论文翻译:VSA | Faster Video Diffusion with Trainable Sparse Attention-CSDN博客
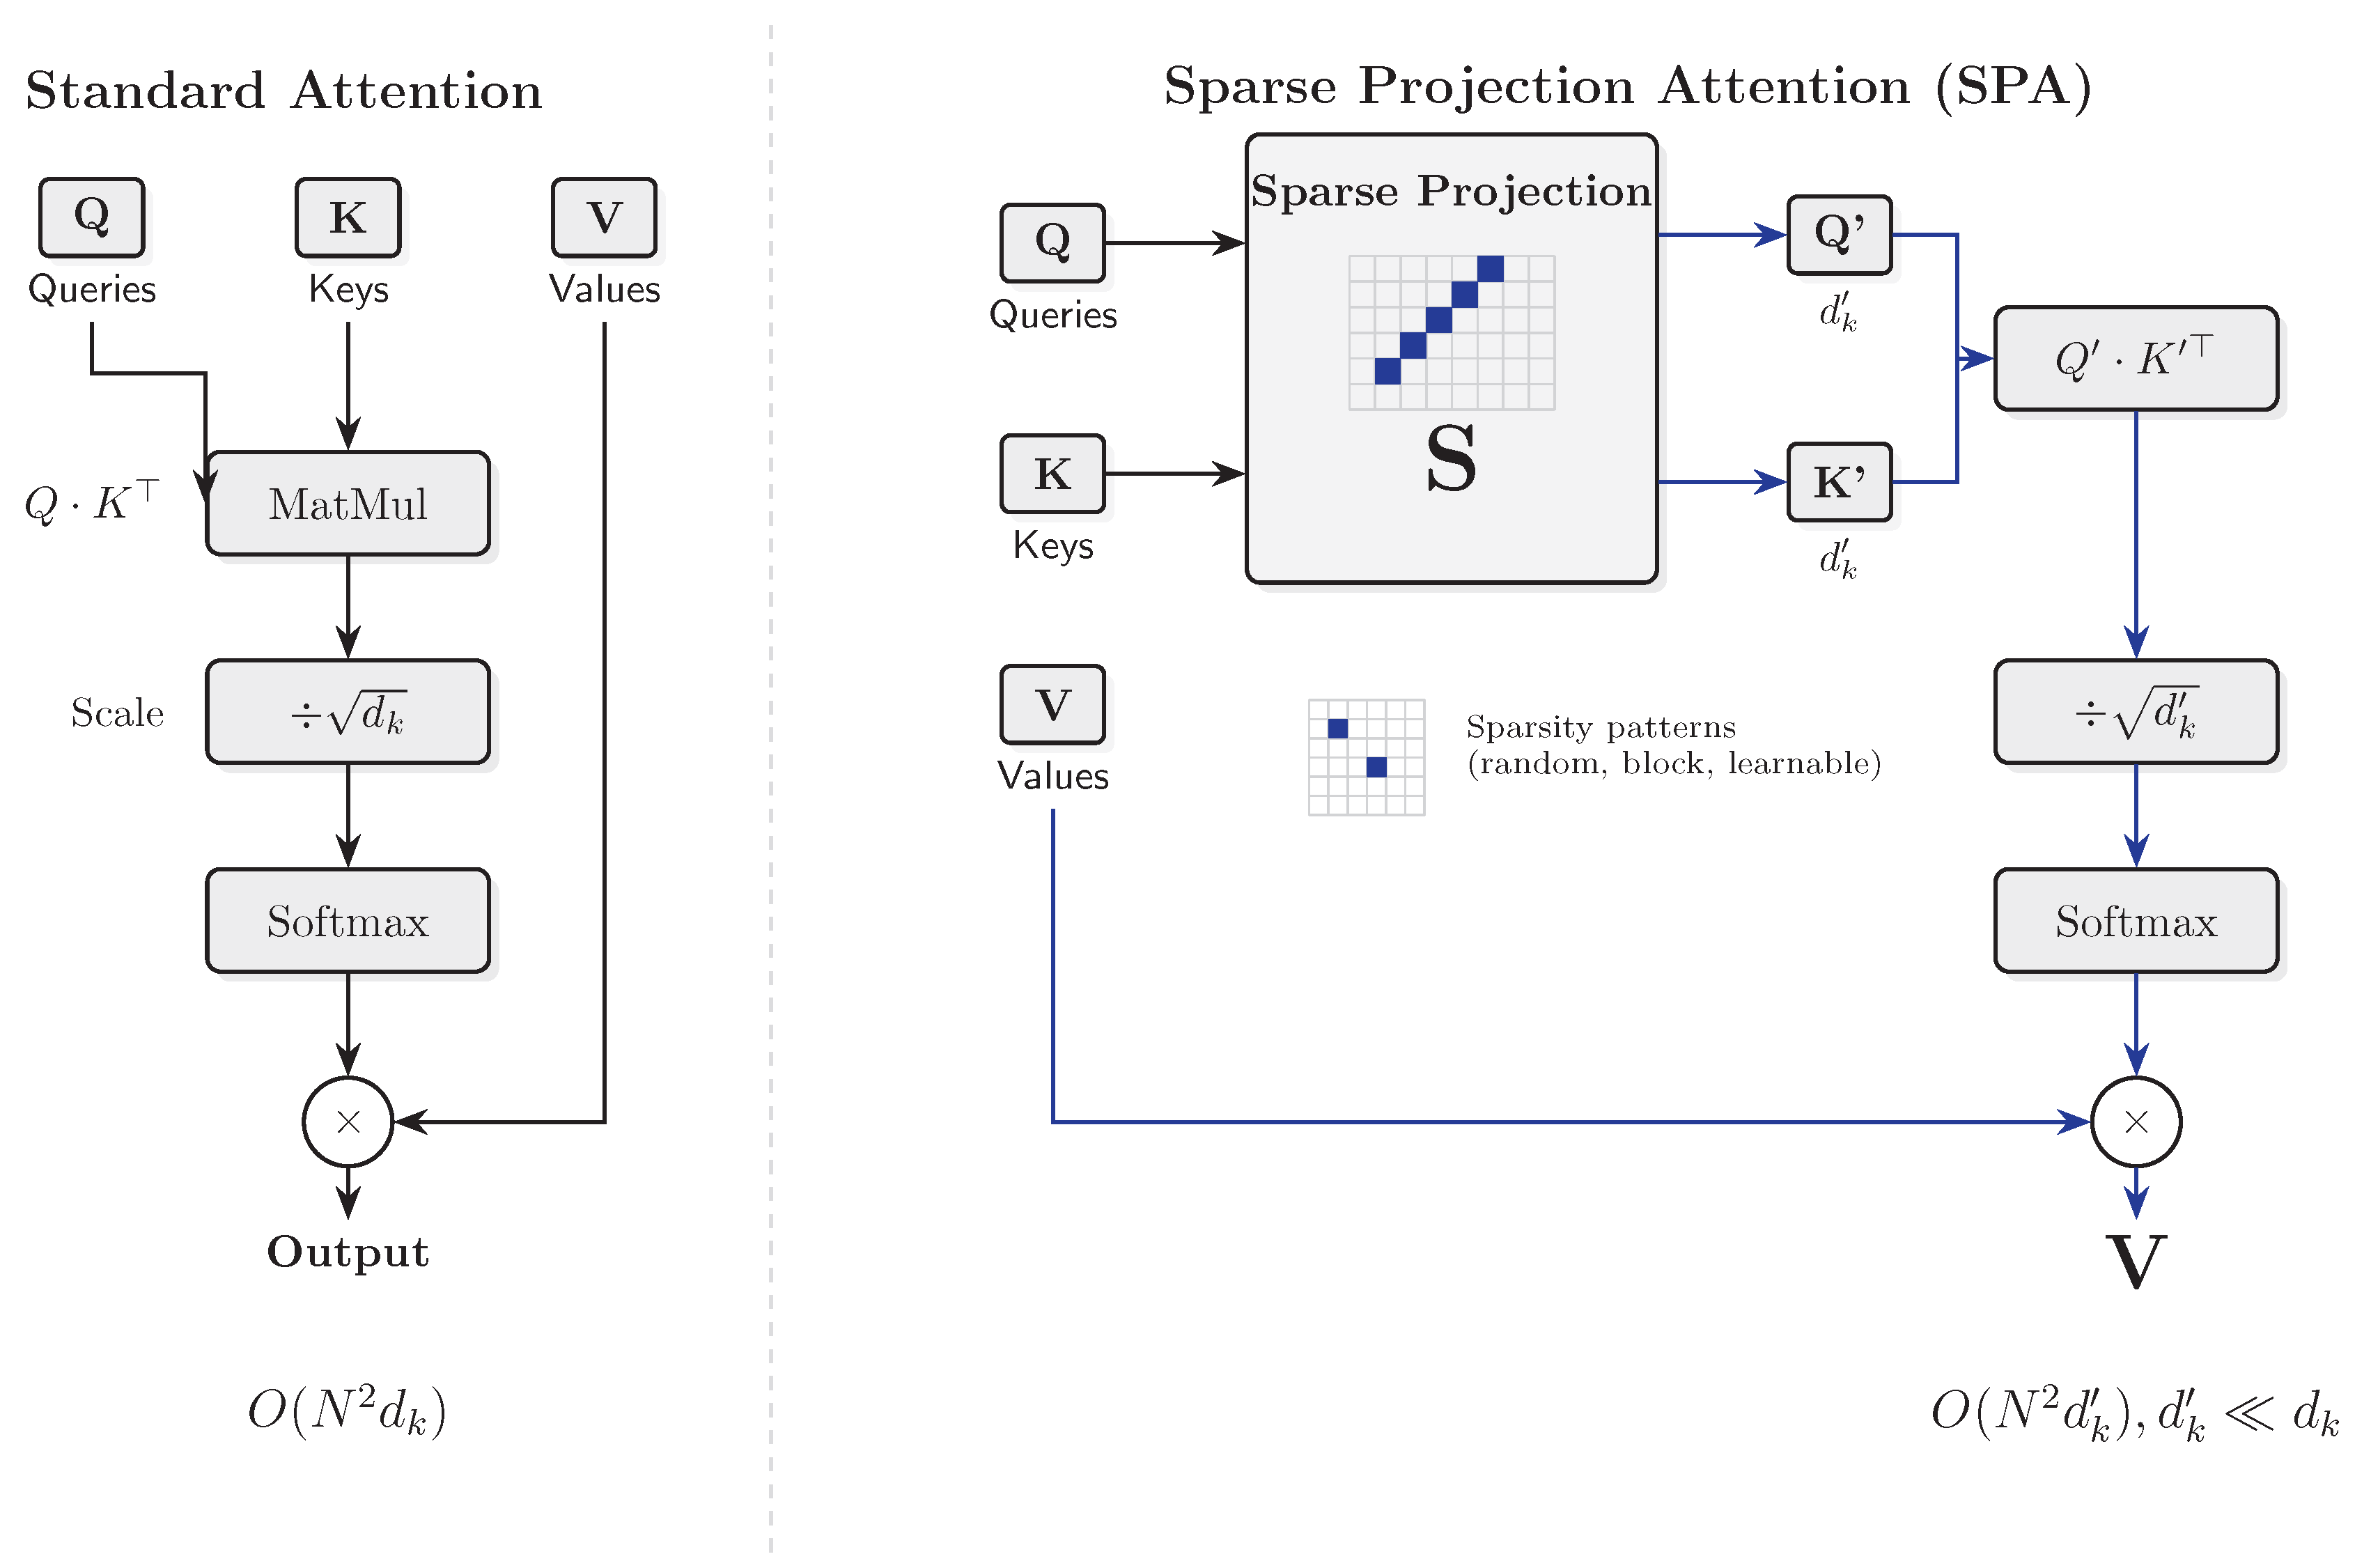
Sparse Projection Attention: A Computationally Efficient Framework for ...

SALAD: Achieve High-Sparsity Attention via Efficient Linear Attention ...

Paper page - SpargeAttention2: Trainable Sparse Attention via Hybrid ...

SALAD: Achieve High-Sparsity Attention via Efficient Linear Attention ...
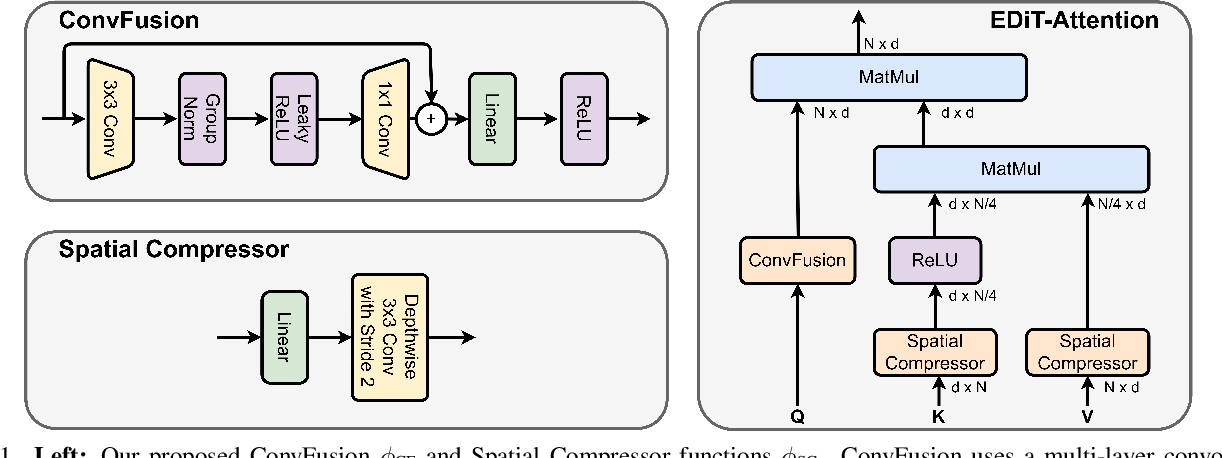
Figure 1 from Edit: Efficient Diffusion Transformers with Linear ...