
230311126 Robustifying Token Attention For Vision Transformers

Figure 2 from Robustifying Token Attention for Vision Transformers ...
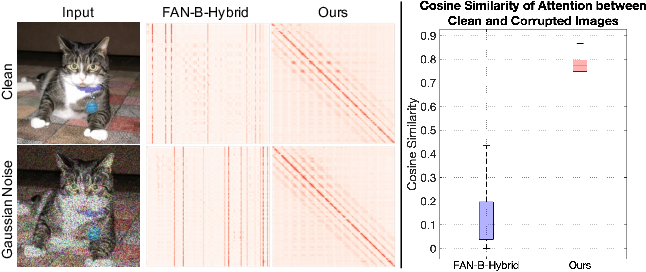
Figure 1 from Robustifying Token Attention for Vision Transformers ...

Robustifying Token Attention for Vision Transformers - YouTube

[2303.11126] Robustifying Token Attention for Vision Transformers

[2303.11126] Robustifying Token Attention for Vision Transformers

【ICCV2023】Robustifying Token Attention for Vision Transformers-CSDN博客

【ICCV2023】Robustifying Token Attention for Vision Transformers-CSDN博客

【ICCV2023】Robustifying Token Attention for Vision Transformers-CSDN博客

【ICCV2023】Robustifying Token Attention for Vision Transformers-CSDN博客

【ICCV2023】Robustifying Token Attention for Vision Transformers-CSDN博客
Advertisement Space (300x250)

最近的vision transformer阅读_multimodal token fusion for vision transformers ...

【ICCV2023】Robustifying Token Attention for Vision Transformers-CSDN博客

Token Pooling in Vision Transformers for Image Classification - YouTube

【ICCV2023】Robustifying Token Attention for Vision Transformers-CSDN博客

Learning Correlation Structures for Vision Transformers | AI Research ...

CVPR2023 Making Vision Transformers Efficient from A Token ...
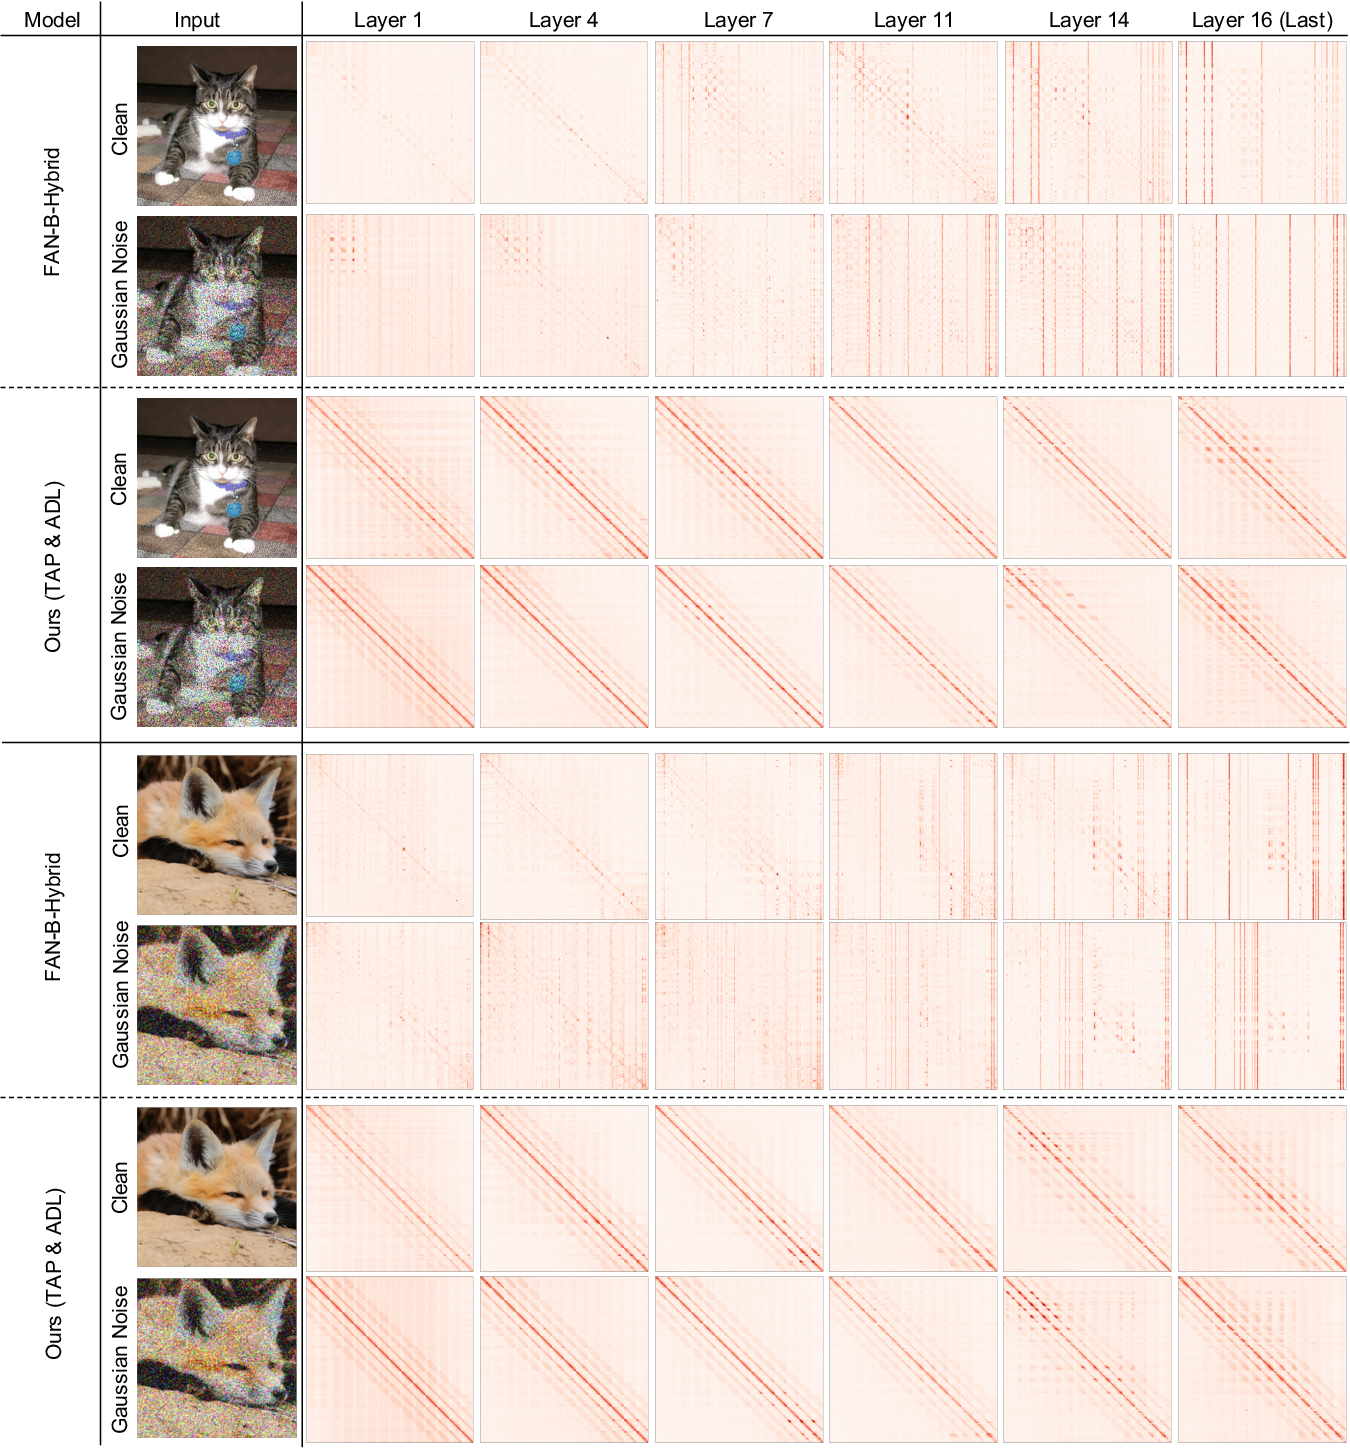
Figure I from Supplementary Materials for “Robustifying Token Attention ...
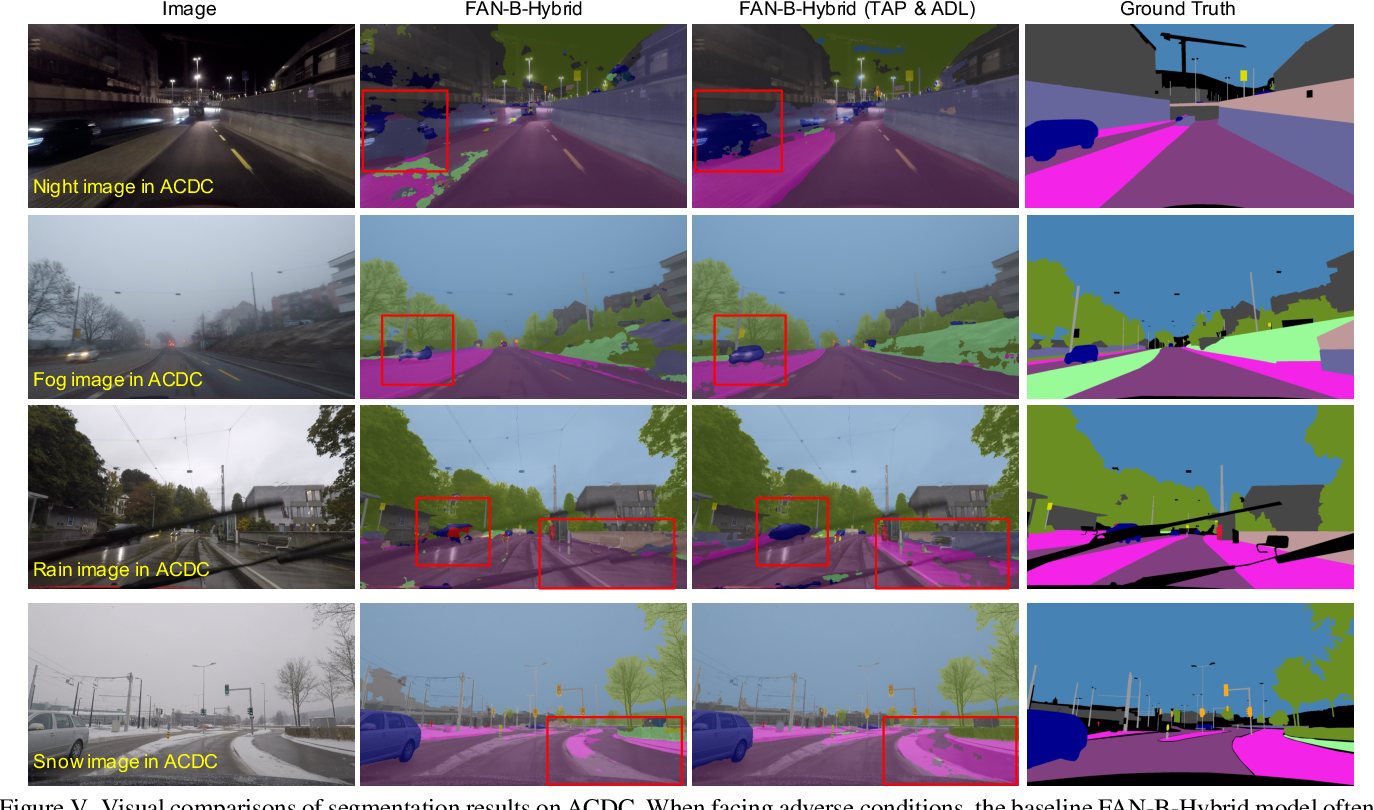
Figure V from Supplementary Materials for “Robustifying Token Attention ...

Efficient Token Compression for Vision Transformer with Spatial ...

Transferable Adversarial Attacks on Vision Transformers with Token ...
Advertisement Space (336x280)

(PDF) Context-Aware Token Selection and Packing for Enhanced Vision ...

Frequency-Aware Token Reduction for Efficient Vision Transformer | AI ...
DynamicViT: Efficient Vision Transformers with Dynamic Token Sparsification
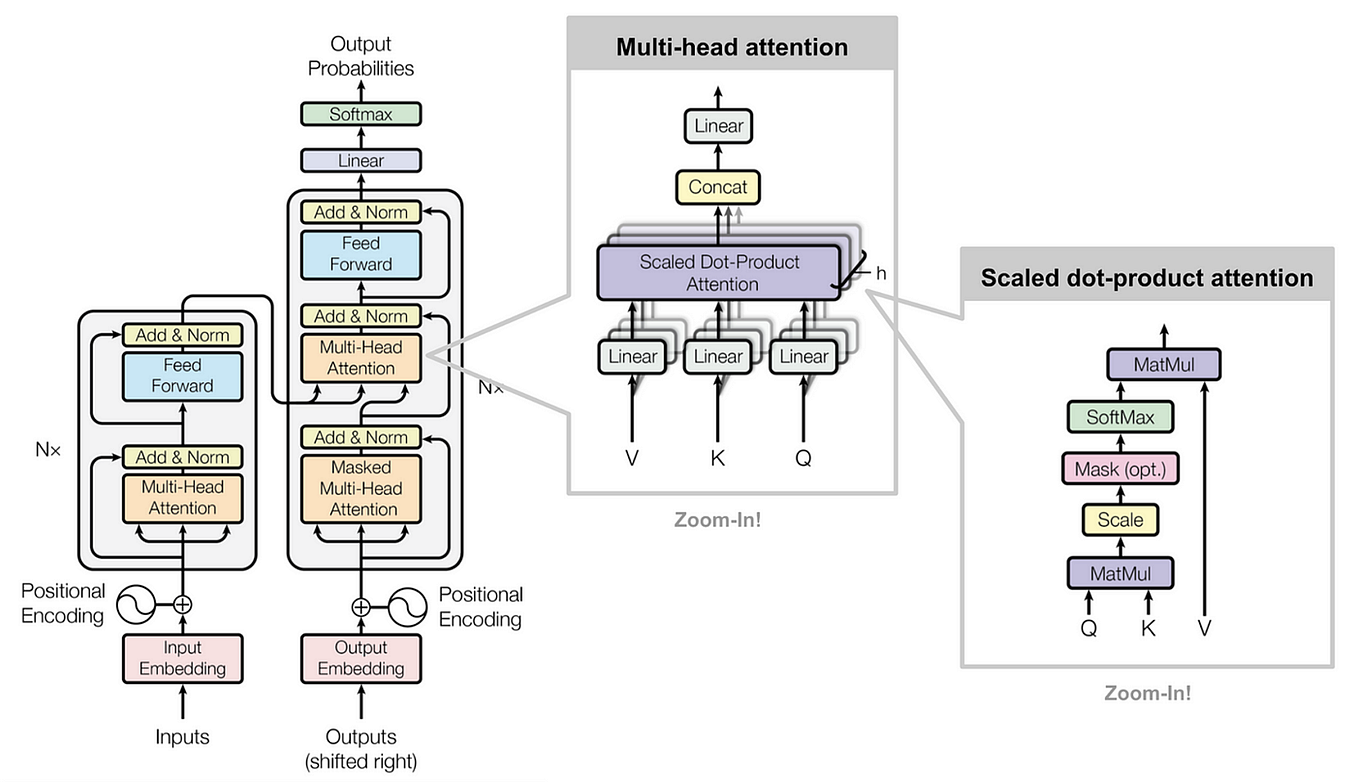
ViT: Vision Transformer. Transformers for image recognition at… | by ...

Table I from Supplementary Materials for “Robustifying Token Attention ...

(PDF) Vision Transformers with Hierarchical Attention
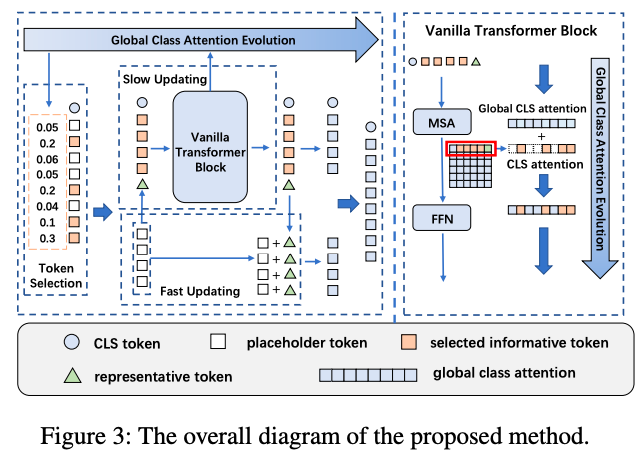
CVPR2023 Making Vision Transformers Efficient from A Token ...
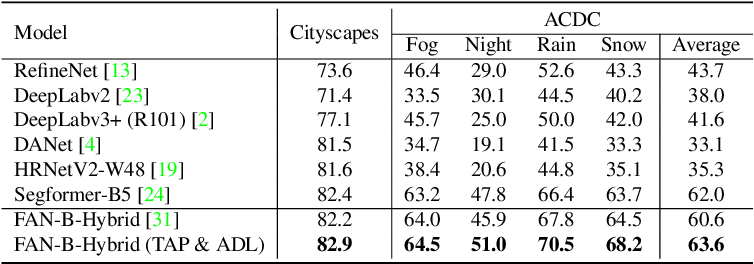
Table V from Supplementary Materials for “Robustifying Token Attention ...

[论文评述] Efficient Token Compression for Vision Transformer with Spatial ...
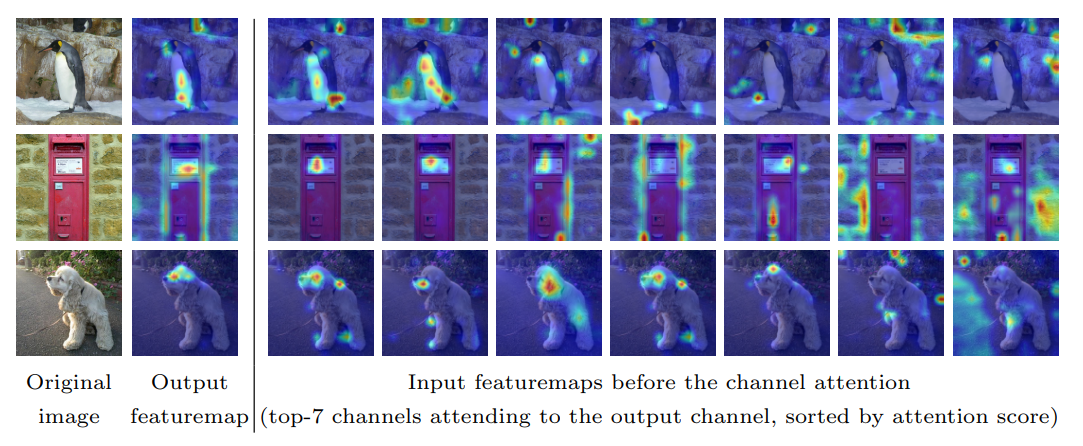
DaViT: Dual Attention Vision Transformers - 知乎
Advertisement Space (336x280)
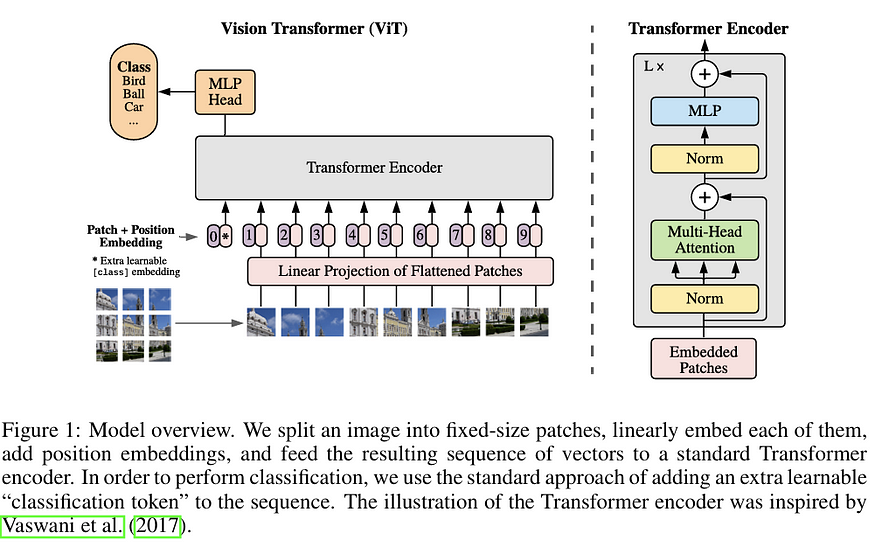
Understanding The Attention Mechanism in Transformers with Code | by ...

Speed-up of Vision Transformer Models by Attention-aware Token ...
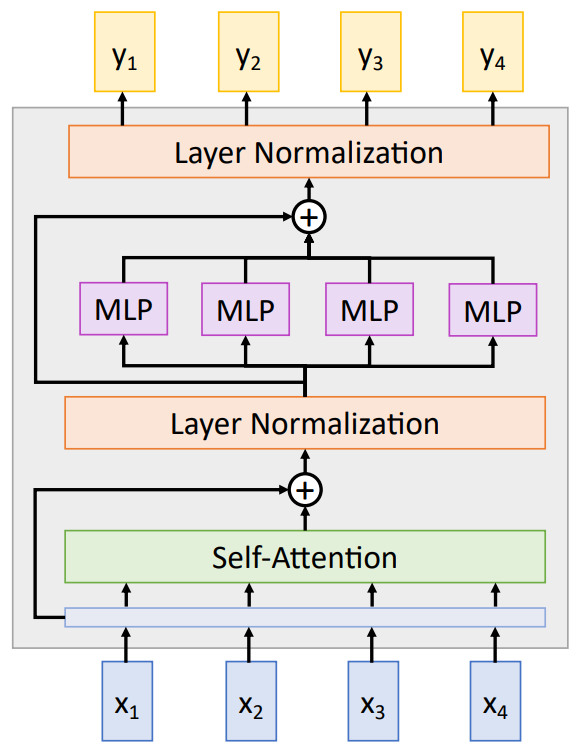
Attention & Transformers | Vision-Array

【解析】Token to Token Vision Transformer-CSDN博客

[论文评述] SPOT: Sparsification with Attention Dynamics via Token Relevance ...

How To Compute The Token Consumption Of Vision Transformers? » ML Digest