
Figure 1 From Robustifying Token Attention For Vision Transformers
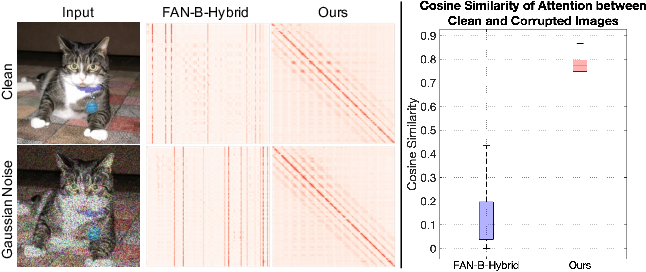
Figure 1 from Robustifying Token Attention for Vision Transformers ...

Figure 2 from Robustifying Token Attention for Vision Transformers ...
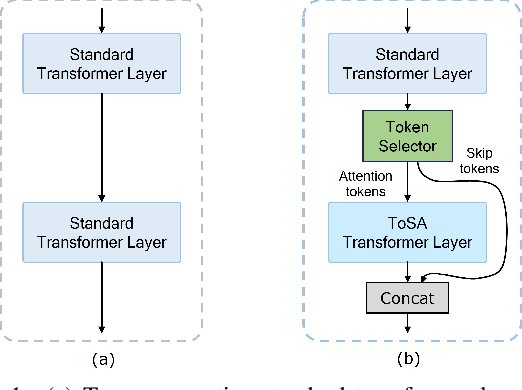
Figure 1 from ToSA: Token Selective Attention for Efficient Vision ...

Figure 1 from Token Pooling in Vision Transformers for Image ...
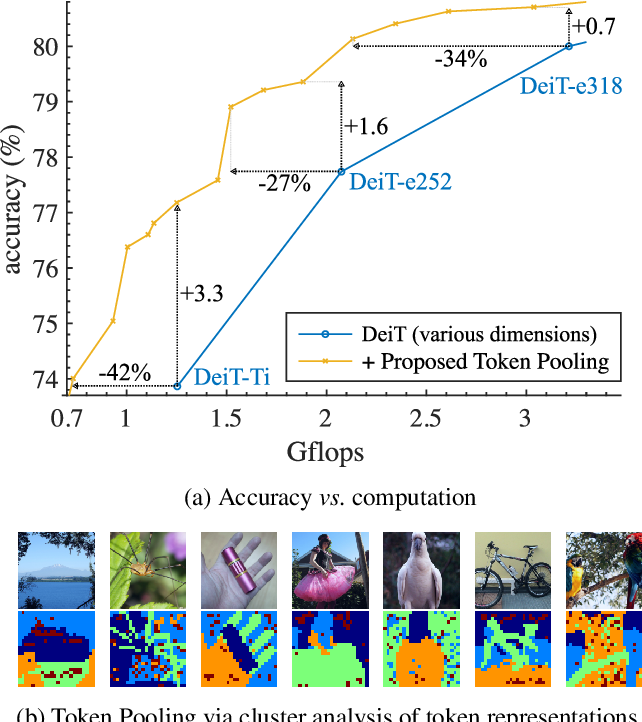
Figure 1 from Token Pooling in Vision Transformers for Image ...

Figure 1 from Token-Label Alignment for Vision Transformers | Semantic ...
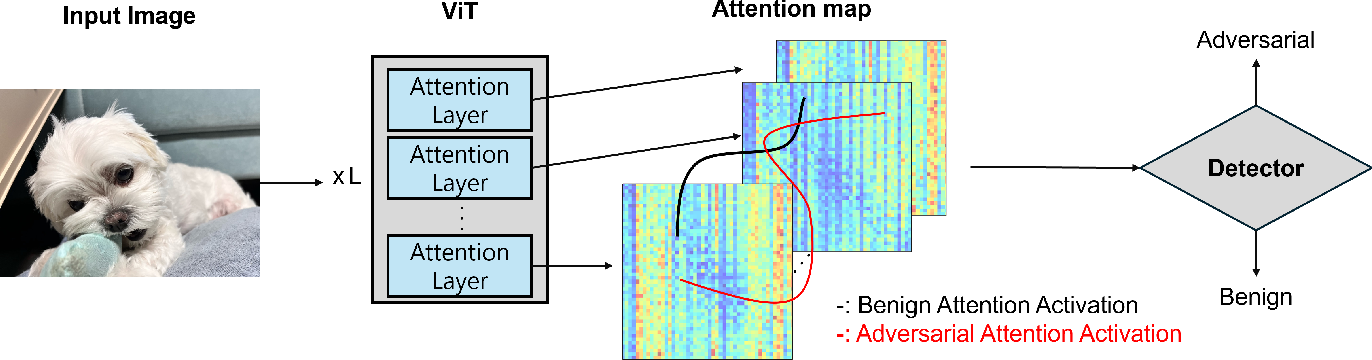
Figure 1 from Adversarial Image Detection for Vision Transformers via ...

[2303.11126] Robustifying Token Attention for Vision Transformers

[2303.11126] Robustifying Token Attention for Vision Transformers

Figure 1 from PPT: Token Pruning and Pooling for Efficient Vision ...
Advertisement Space (300x250)

Robustifying Token Attention for Vision Transformers - YouTube

Figure 1 from Token Pooling in Vision Transformers | Semantic Scholar

Figure 1 from DiT: Efficient Vision Transformers with Dynamic Token ...
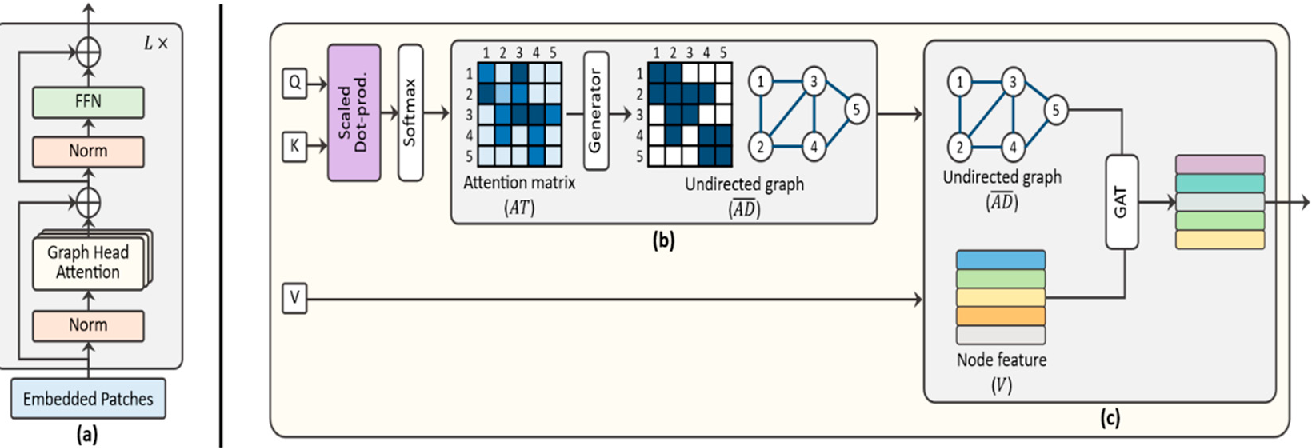
Figure 1 from Rethinking Attention Mechanisms in Vision Transformers ...
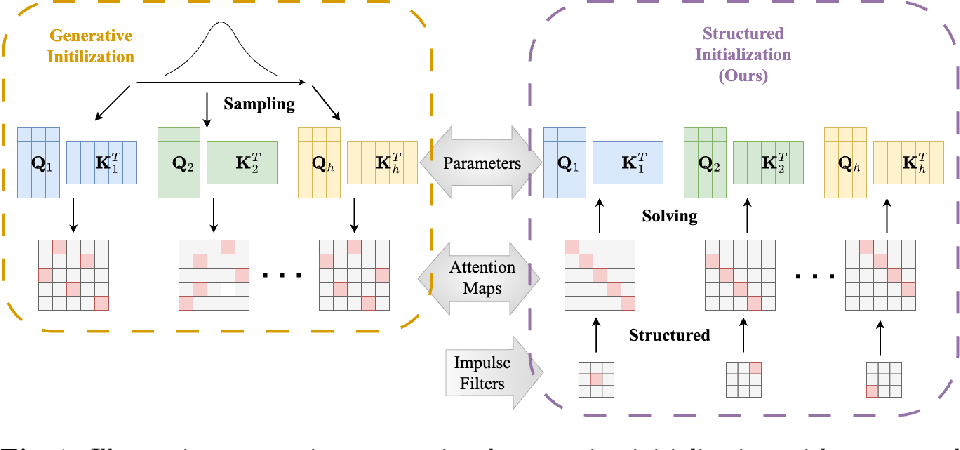
Figure 1 from Structured Initialization for Attention in Vision ...
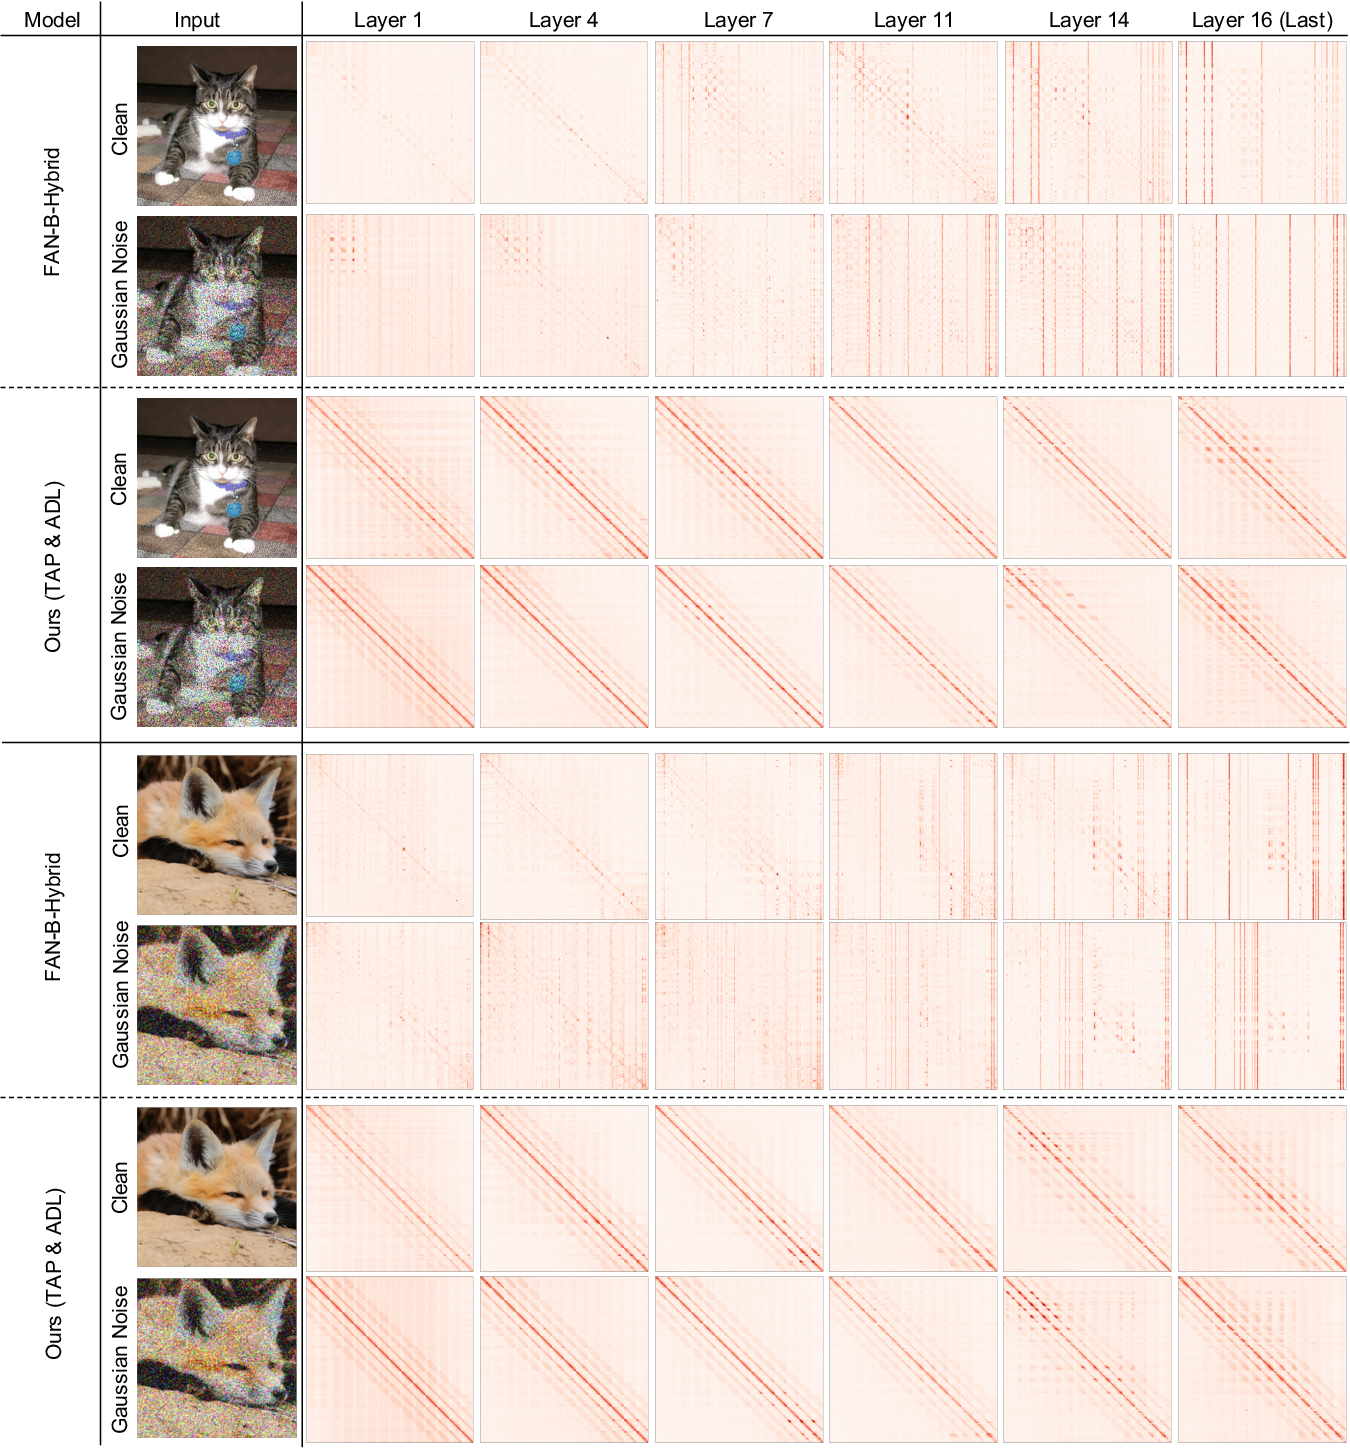
Figure I from Supplementary Materials for “Robustifying Token Attention ...

Figure 1 from Token Adaptive Vision Transformer with Efficient ...
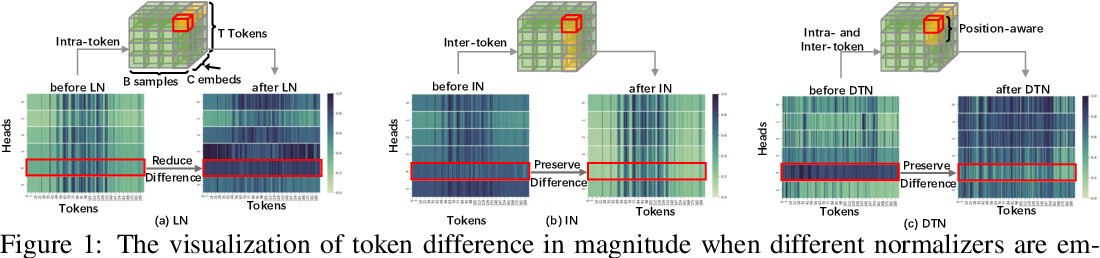
Figure 1 from Dynamic Token Normalization Improves Vision Transformer ...
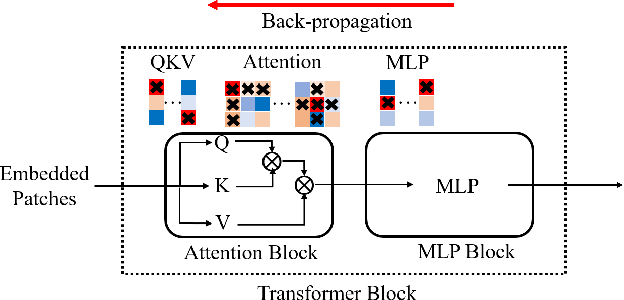
Figure 1 from Transferable Adversarial Attacks on Vision Transformers ...

Figure 1 from Content-aware Token Sharing for Efficient Semantic ...
Advertisement Space (336x280)
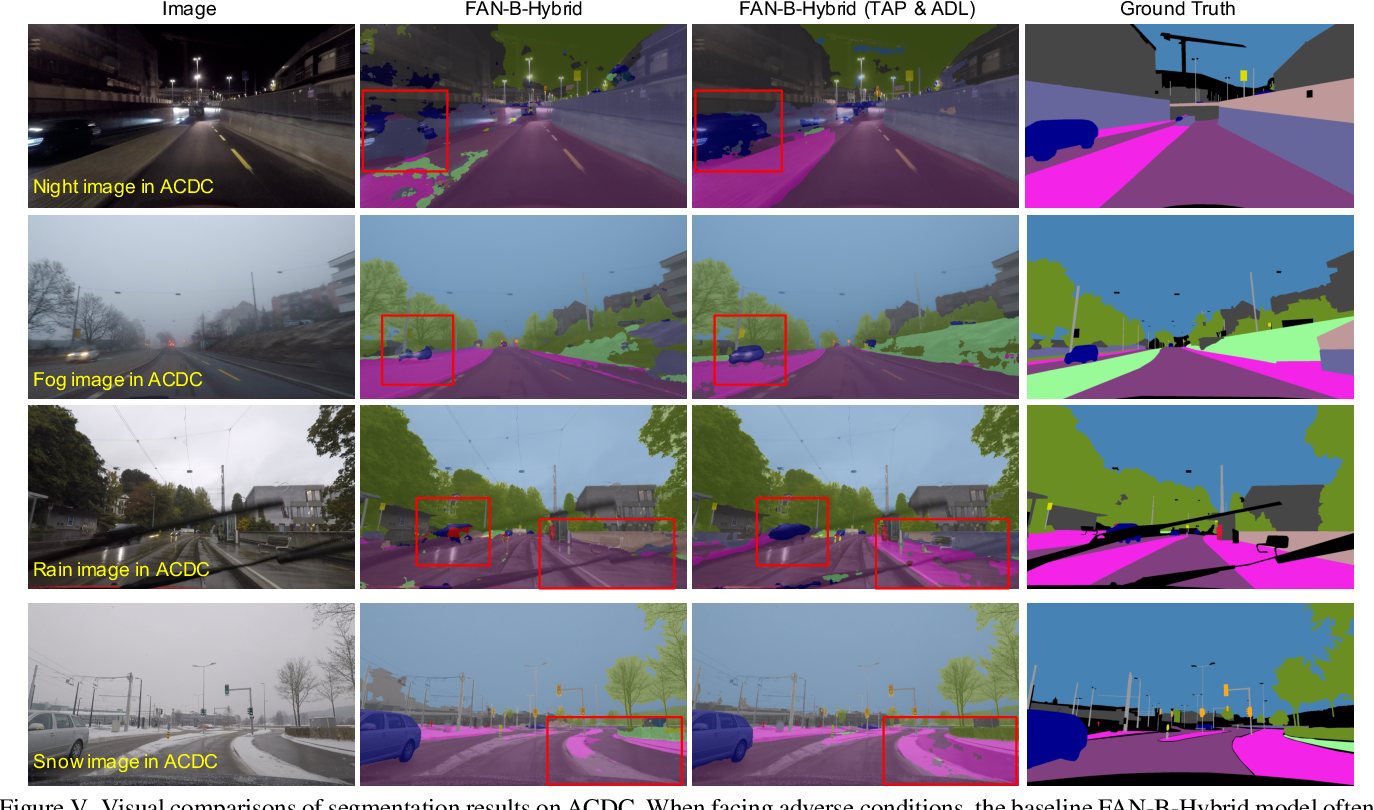
Figure V from Supplementary Materials for “Robustifying Token Attention ...

Figure 1 from Multi-Criteria Token Fusion with One-Step-Ahead Attention ...

Figure 1 from How Does Attention Work in Vision Transformers? A Visual ...

Figure 1 from Hybrid Attention Vision Transformer-based Deep Learning ...

Figure 1 from Learning to Mask and Permute Visual Tokens for Vision ...
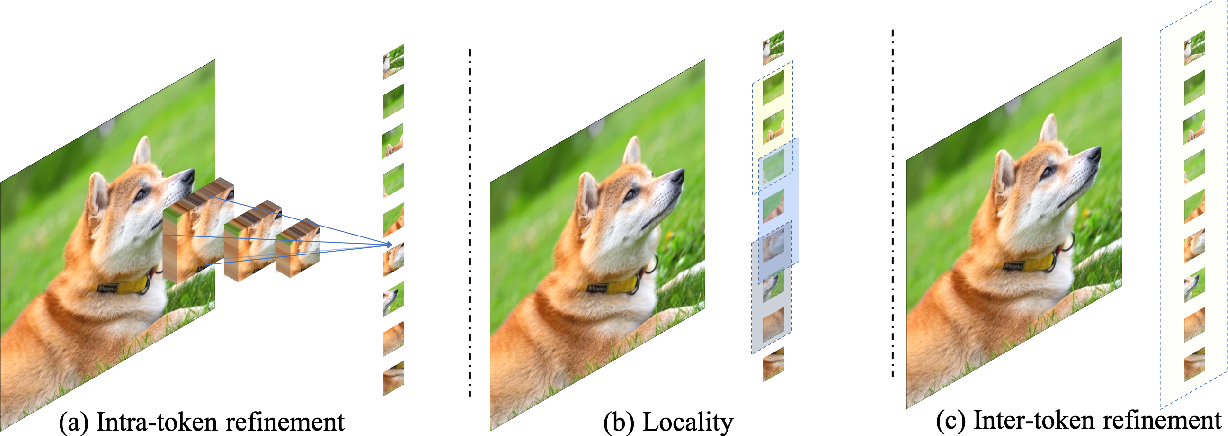
Figure 1 from What Makes for Good Tokenizers in Vision Transformer ...

Figure 1 from S-Adapter: Generalizing Vision Transformer for Face Anti ...
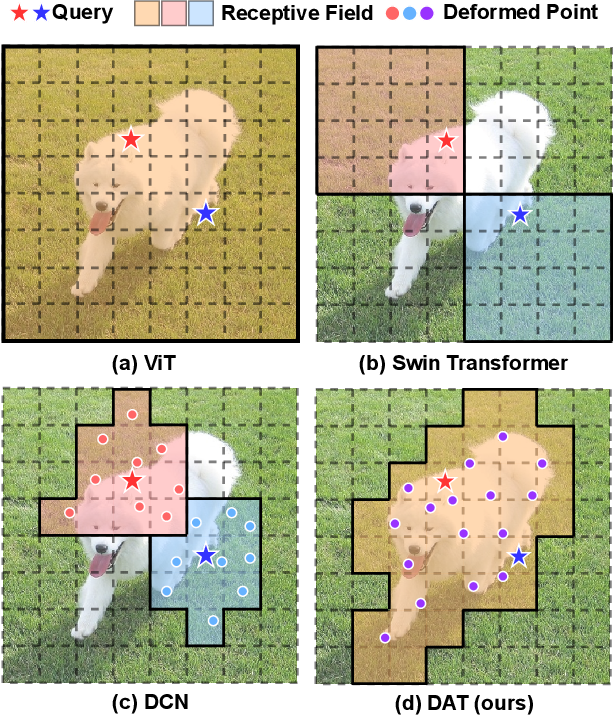
Figure 1 from Vision Transformer with Deformable Attention | Semantic ...

Figure 1 from ParFormer: Vision Transformer Baseline with Parallel ...
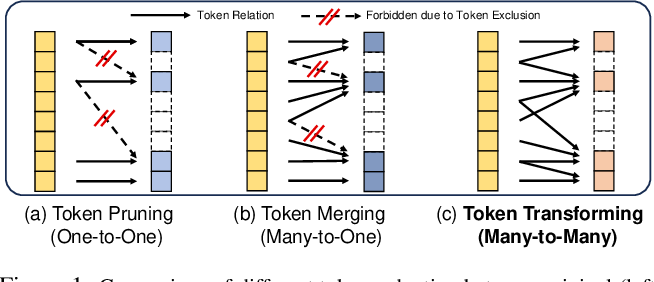
Figure 1 from Token Transforming: A Unified and Training-Free Token ...
Advertisement Space (336x280)

[PDF] Multimodal Token Fusion for Vision Transformers | Semantic Scholar

Figure 1 from Token Transformation Matters: Towards Faithful Post-Hoc ...

【ICCV2023】Robustifying Token Attention for Vision Transformers-CSDN博客

CVPR2023 Making Vision Transformers Efficient from A Token ...

[논문 리뷰] TinyDrop: Tiny Model Guided Token Dropping for Vision Transformers

【ICCV2023】Robustifying Token Attention for Vision Transformers-CSDN博客