
251007081 Accelerating Diffusion Llm Inference Via Local Determinism

Accelerating Diffusion LLM Inference via Local Determinism Propagation ...

Accelerating Diffusion LLM Inference via Local Determinism Propagation ...

Accelerating Diffusion LLM Inference via Local Determinism Propagation ...

Accelerating Diffusion LLM Inference via Local Determinism Propagation ...

[Literature Review] Accelerating Diffusion LLM Inference via Local ...

Focus-dLLM: Accelerating Long-Context Diffusion LLM Inference via ...

RetrievalAttention: Accelerating Long-Context LLM Inference via Vector ...

RetrievalAttention: Accelerating Long-Context LLM Inference via Vector ...
Accelerating LLM Inference via Dynamic KV Cache Placement in ...

Paper page - AccLLM: Accelerating Long-Context LLM Inference Via ...
Advertisement Space (300x250)

(PDF) RetrievalAttention: Accelerating Long-Context LLM Inference via ...
Accelerating Diffusion Sampling via Exploiting Local Transition ...

AccLLM: Accelerating Long-Context LLM Inference Via Algorithm-Hardware ...

Paper page - AdaBlock-dLLM: Semantic-Aware Diffusion LLM Inference via ...

Paper page - Accelerating Diffusion Language Model Inference via ...

Paper page - SlimInfer: Accelerating Long-Context LLM Inference via ...

Paper page - SenCache: Accelerating Diffusion Model Inference via ...
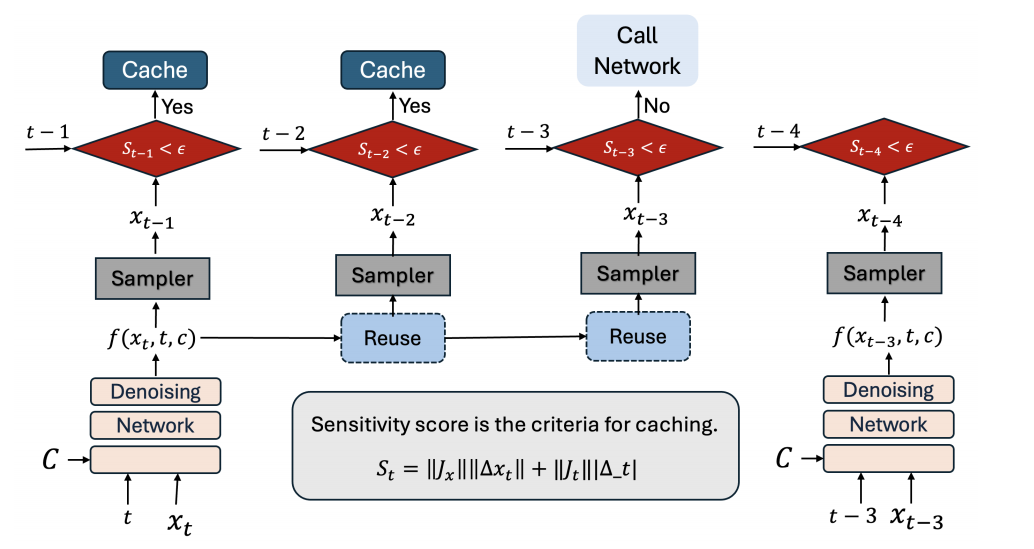
论文阅读:SenCache: Accelerating Diffusion Model Inference via Sensitivity ...
SenCache: Accelerating Diffusion Model Inference via Sensitivity-Aware ...
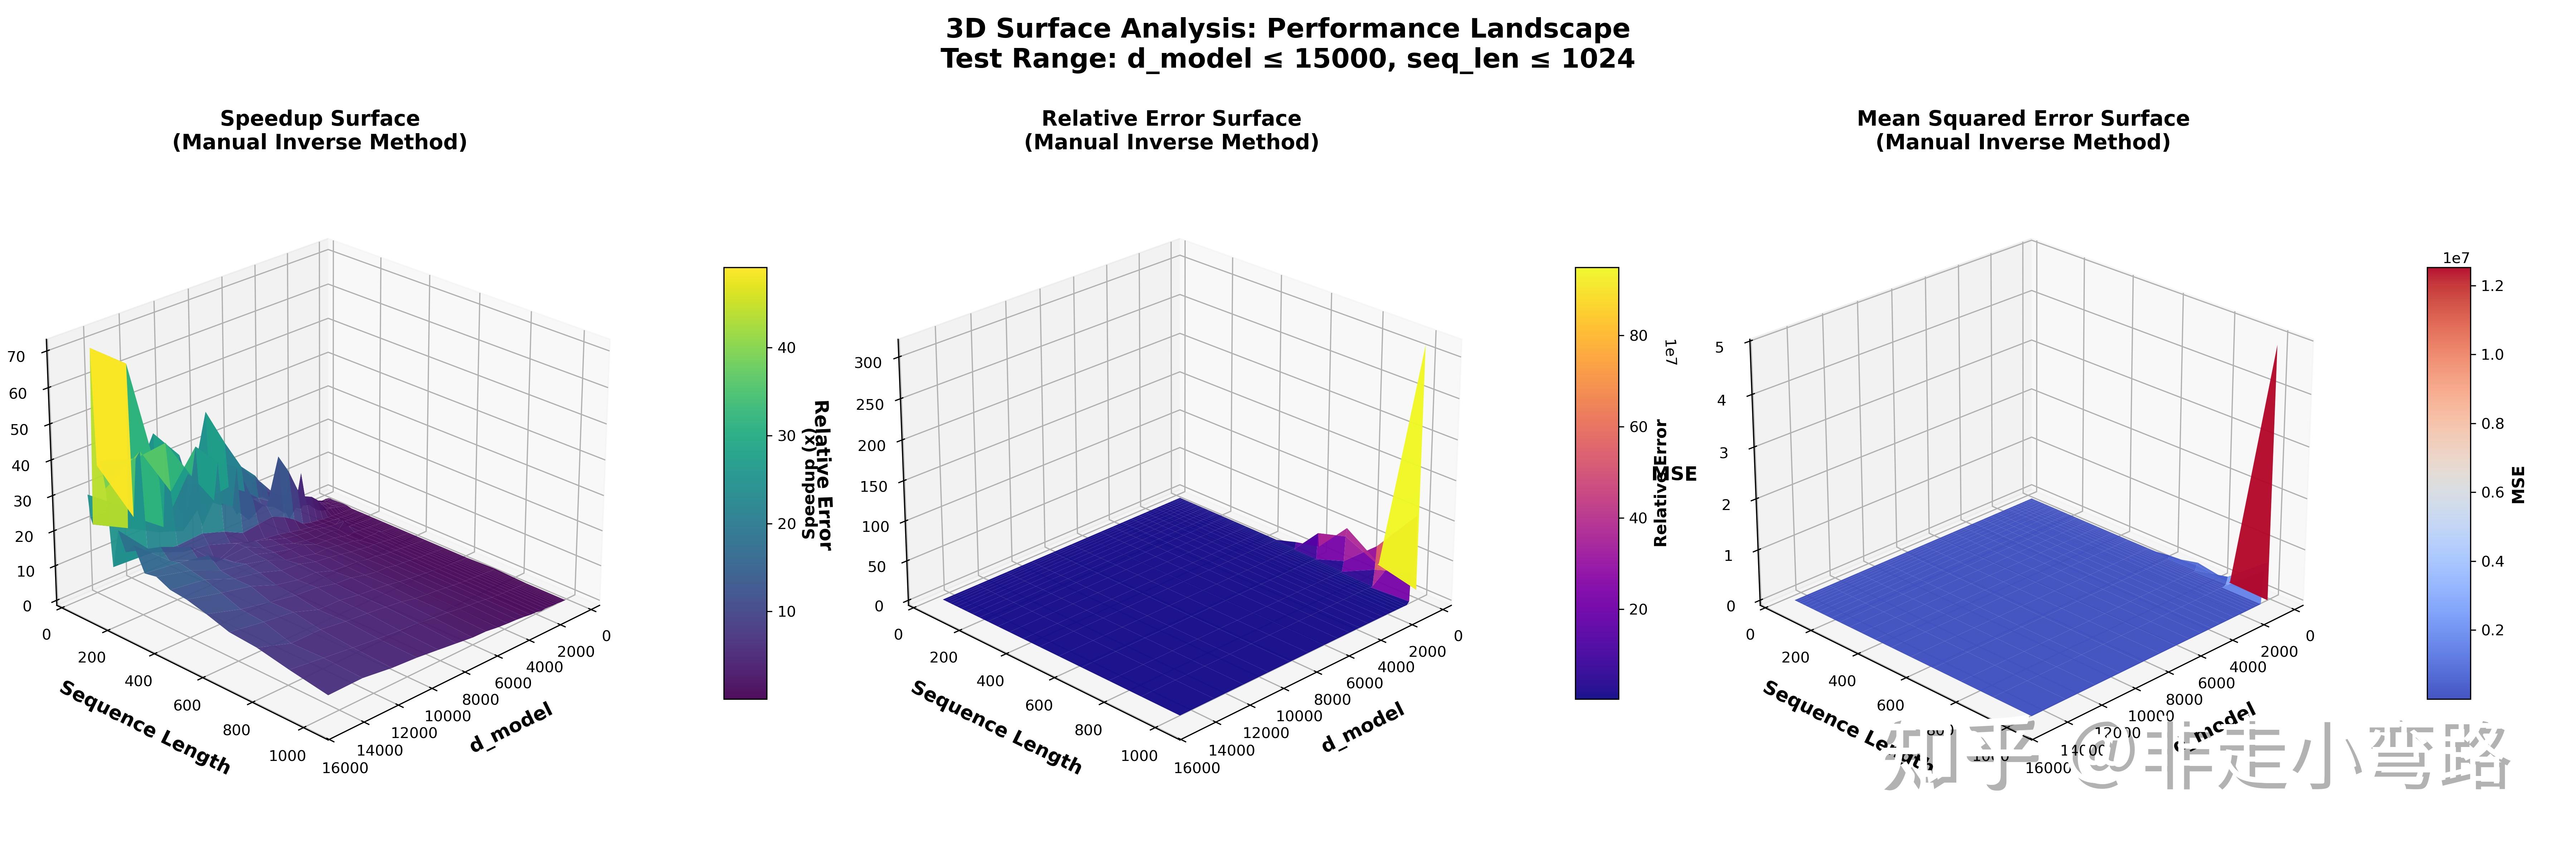
Accelerating next token inference in diffusion LLM on CPU - 知乎
Advertisement Space (336x280)
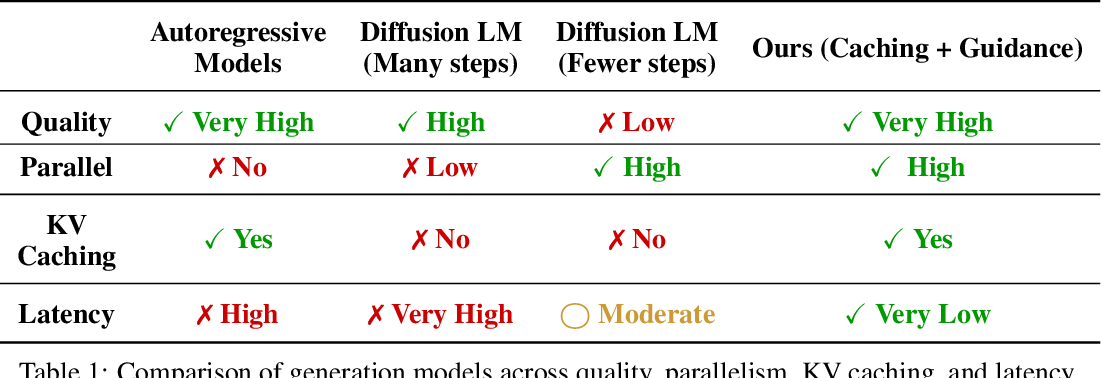
Table 1 from Accelerating Diffusion Language Model Inference via ...

Paper page - DASH-KV: Accelerating Long-Context LLM Inference via ...

[论文评述] DASH-KV: Accelerating Long-Context LLM Inference via Asymmetric ...

LycheeDecode: Accelerating Long-Context LLM Inference via Hybrid-Head ...

AcceLLM: Accelerating LLM Inference using Redundancy for Load Balancing ...

Spiffy: Multiplying Diffusion LLM Acceleration via Lossless Speculative ...

(PDF) Accelerating Diffusion LLMs via Adaptive Parallel Decoding

Accelerating LLM Inference - Tradeoffs, Design, and New Ideas

Paper page - Focus-dLLM: Accelerating Long-Context Diffusion LLM ...

Paper page - Accelerating Diffusion LLMs via Adaptive Parallel Decoding
Advertisement Space (336x280)

Diffusion LLMs Can Do Faster-Than-AR Inference via Discrete Diffusion ...

LLM Inference Acceleration via Efficient Operation Fusion

Paper page - Accelerating LLM Inference with Staged Speculative Decoding

[Literature Review] Focus-dLLM: Accelerating Long-Context Diffusion LLM ...

(PDF) LLM-42: Enabling Determinism in LLM Inference with Verified ...
Accelerating LLM Inference with Prompt Caching for Open‑Source Models ...