
Focus Dllm Accelerating Long Context Diffusion Llm Inference Via

Focus-dLLM: Accelerating Long-Context Diffusion LLM Inference via ...

Accelerating Diffusion LLM Inference via Local Determinism Propagation ...

Squeezed Attention: Accelerating Long Context Length LLM Inference ...

[논문 리뷰] Accelerating Diffusion LLM Inference via Local Determinism ...

Focus-dLLM: Accelerating Long-Context Diffusion LLM Inference via ...

RetrievalAttention: Accelerating Long-Context LLM Inference via Vector ...

FlashDLM: Accelerating Diffusion Language Model Inference via Efficient ...
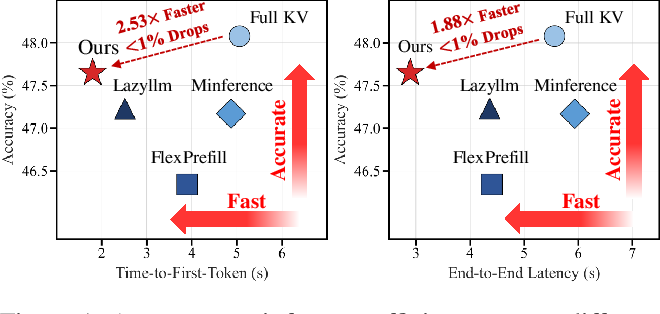
Figure 1 from SlimInfer: Accelerating Long-Context LLM Inference via ...

Paper page - SlimInfer: Accelerating Long-Context LLM Inference via ...

Paper page - AccLLM: Accelerating Long-Context LLM Inference Via ...
Advertisement Space (300x250)

Accelerating Long-Context LLM Inference via Vector Retrieval ...

RetrievalAttention: Accelerating Long-Context LLM Inference via Vector ...

AccLLM: Accelerating Long-Context LLM Inference Via Algorithm-Hardware ...
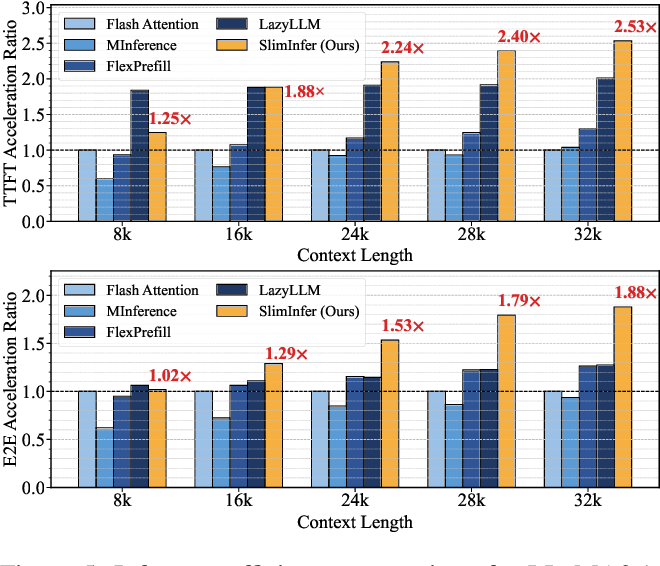
Figure 5 from SlimInfer: Accelerating Long-Context LLM Inference via ...

Paper page - Squeezed Attention: Accelerating Long Context Length LLM ...

RetrievalAttention: Accelerating Long-Context LLM Inference via Vector ...

(PDF) RetrievalAttention: Accelerating Long-Context LLM Inference via ...

LycheeDecode: Accelerating Long-Context LLM Inference via Hybrid-Head ...

[论文评述] DASH-KV: Accelerating Long-Context LLM Inference via Asymmetric ...
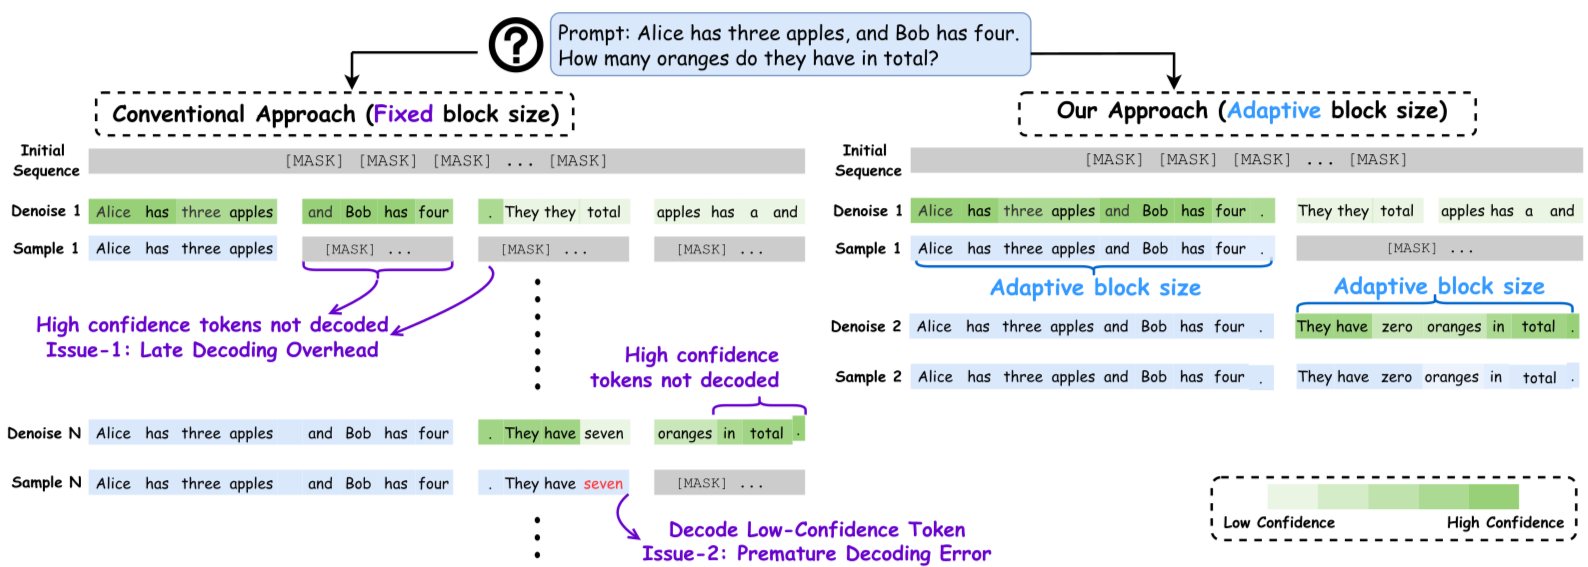
[논문 리뷰] AdaBlock-dLLM: Semantic-Aware Diffusion LLM Inference via ...
Advertisement Space (336x280)

(PDF) RocketKV: Accelerating Long-Context LLM Inference via Two-Stage ...

Paper page - AdaBlock-dLLM: Semantic-Aware Diffusion LLM Inference via ...

Paper page - DASH-KV: Accelerating Long-Context LLM Inference via ...
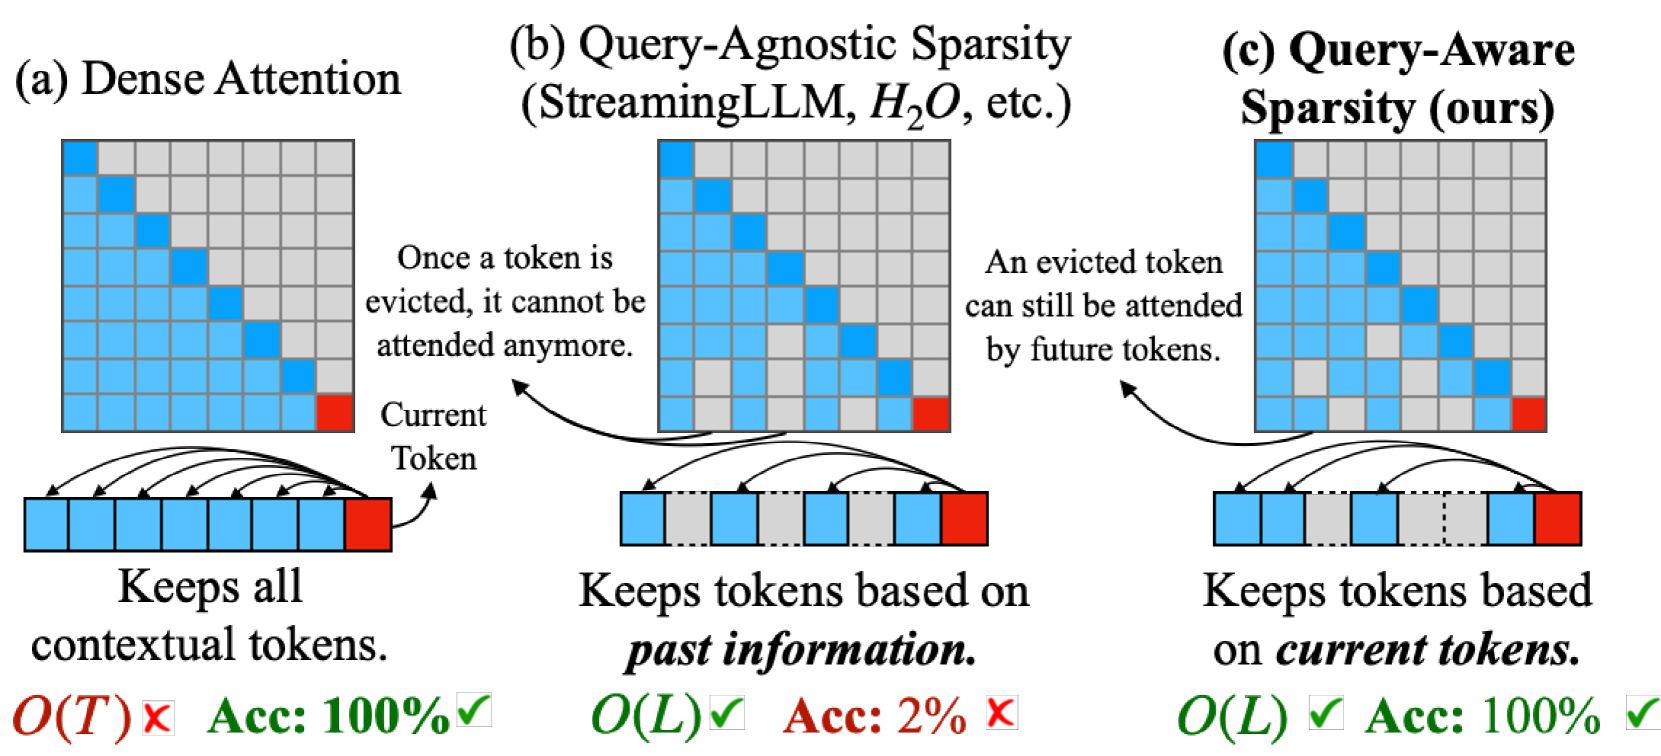
Near-Lossless Acceleration of Long Context LLM Inference with Adaptive ...
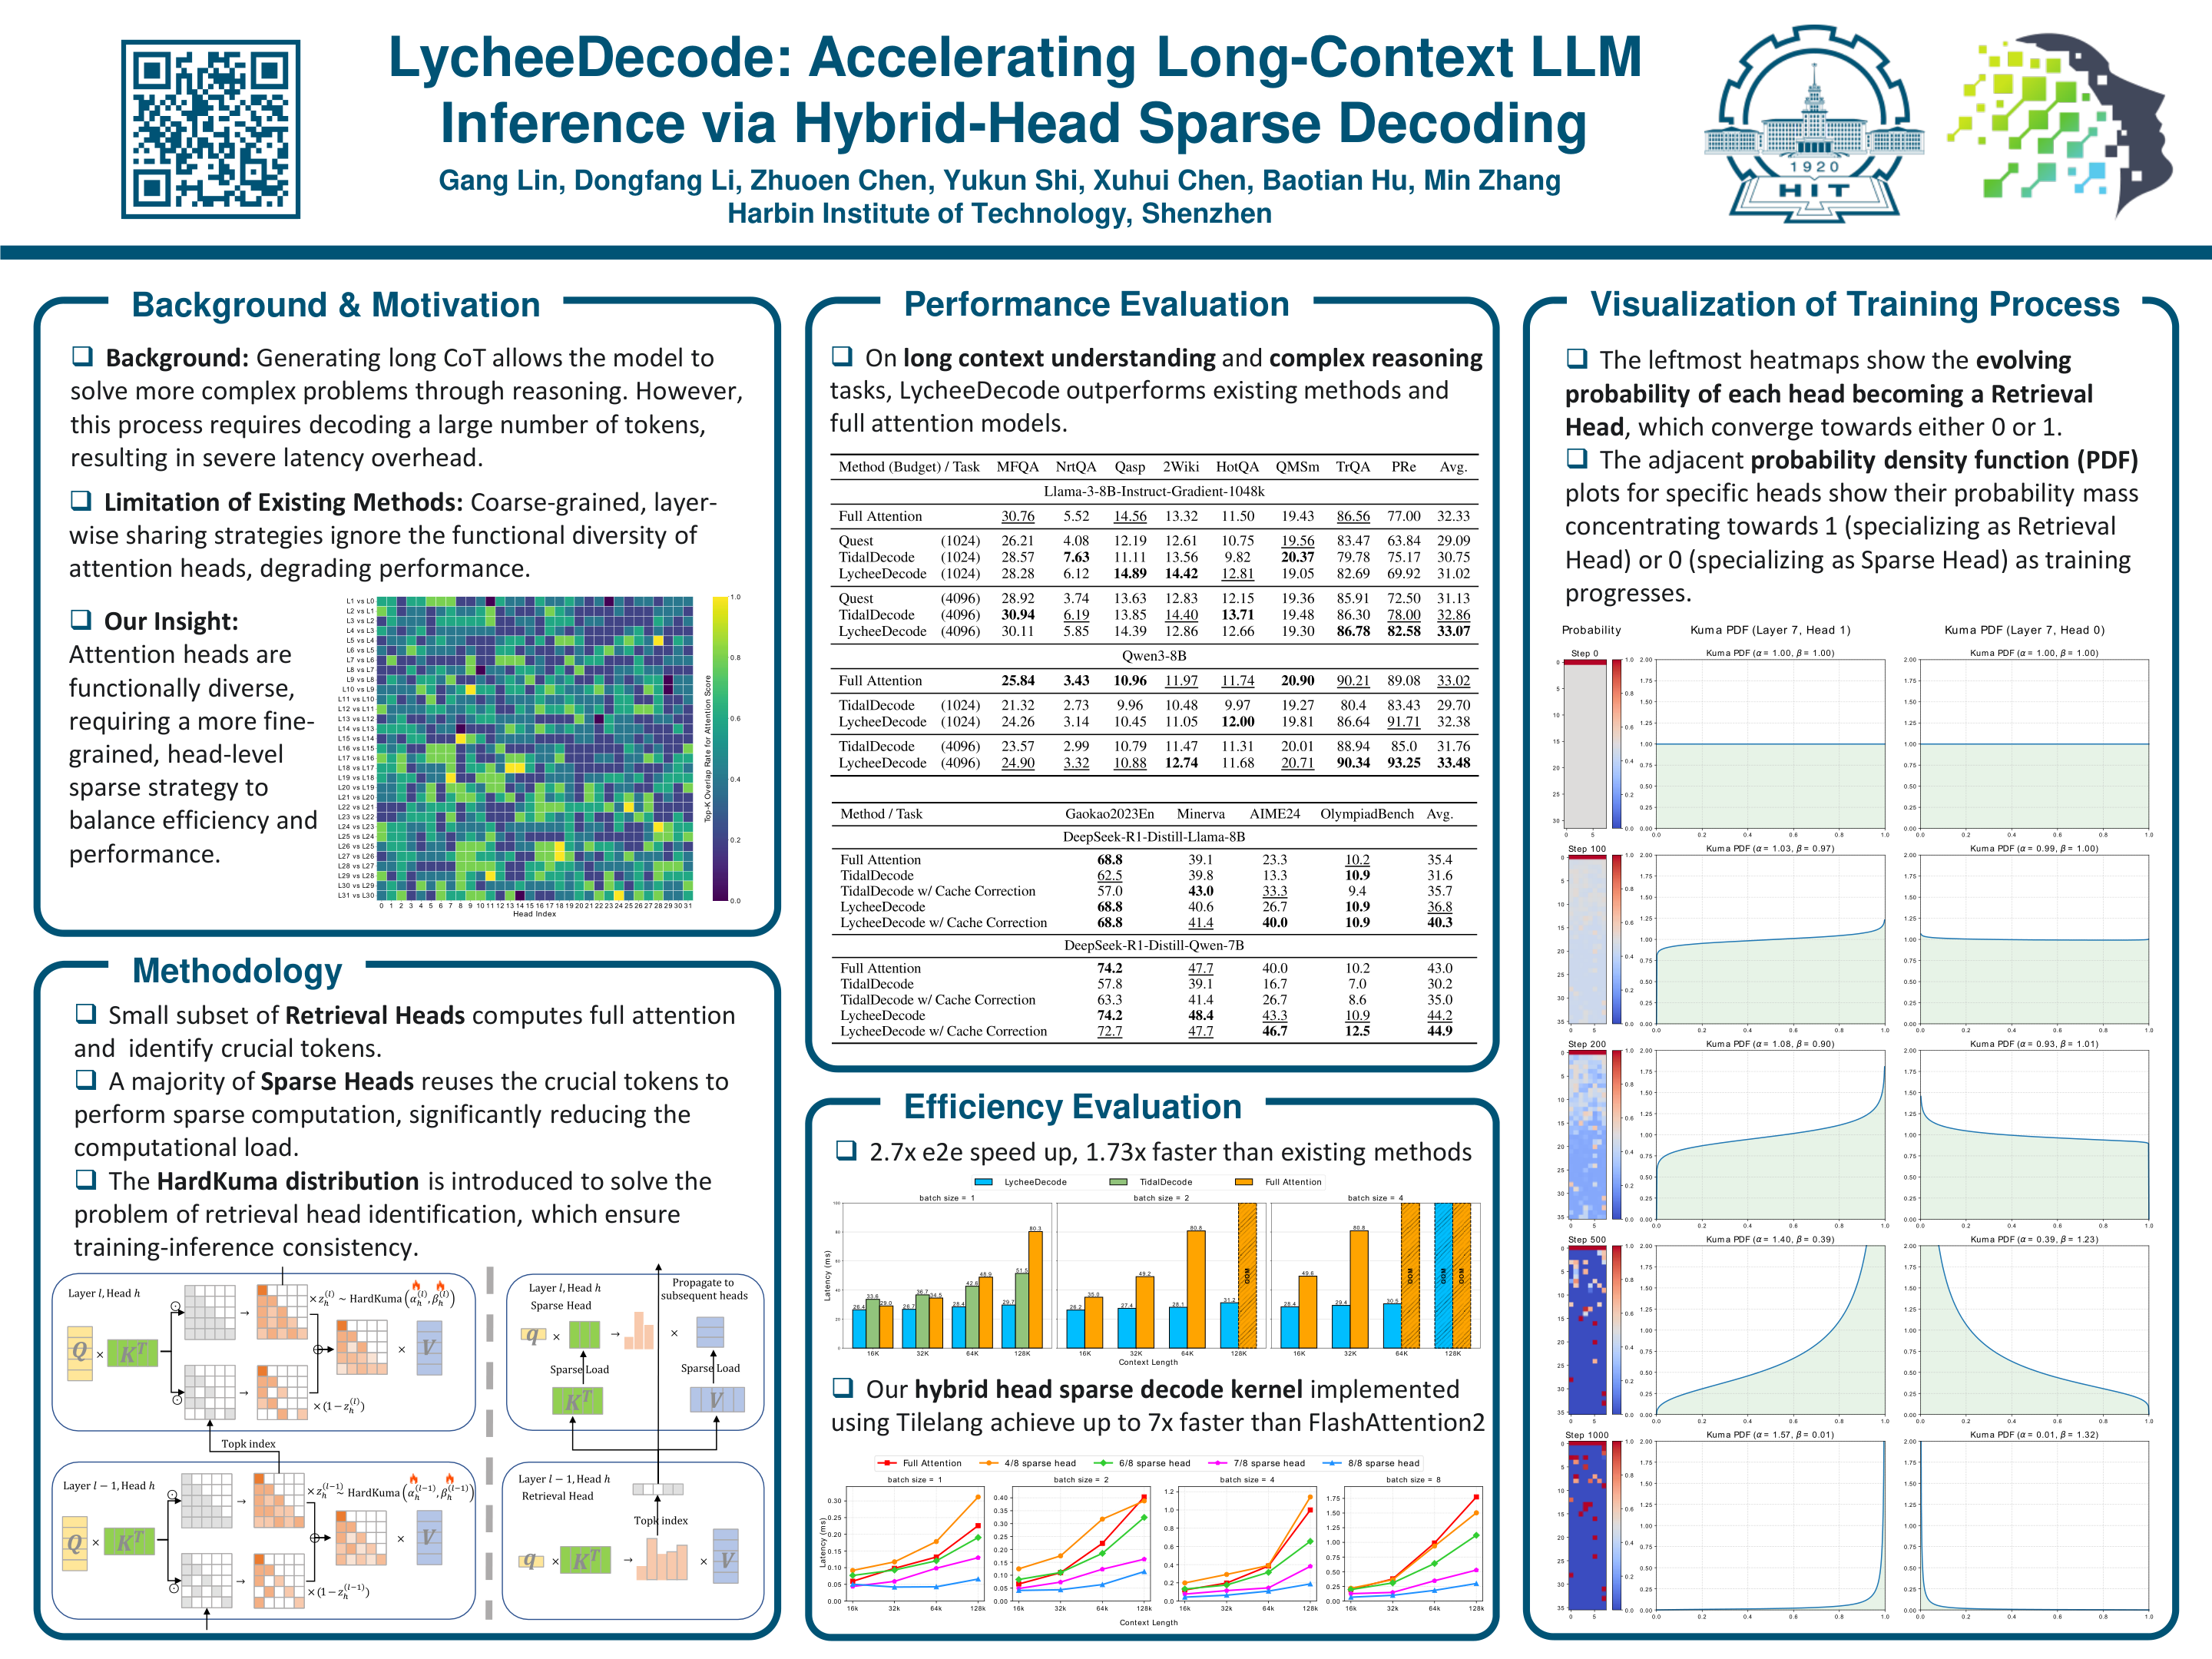
ICLR Poster LycheeDecode: Accelerating Long-Context LLM Inference via ...

LycheeDecode: Accelerating Long-Context LLM Inference via Hybrid-Head ...

LLM Inference: Accelerating Long Context Generation with KV Cache ...

Paper page - LycheeDecode: Accelerating Long-Context LLM Inference via ...
LazyLLM: Dynamic Token Pruning for Efficient Long Context LLM Inference ...

MILLION: Mastering Long-Context LLM Inference Via Outlier-Immunized KV ...
Advertisement Space (336x280)

Paper page - Focus-dLLM: Accelerating Long-Context Diffusion LLM ...

[Literature Review] Focus-dLLM: Accelerating Long-Context Diffusion LLM ...

Paper page - Streaming-dLLM: Accelerating Diffusion LLMs via Suffix ...

(PDF) Efficient Long-Context LLM Inference via KV Cache Clustering

[논문 리뷰] $R^2$-dLLM: Accelerating Diffusion Large Language Models via ...

Pushing the Limits of LLM Inference via 2-Bit Layer-Discriminative KV ...