
Literature Review Accelerating Diffusion Llm Inference Via Local

[Literature Review] Accelerating Diffusion LLM Inference via Local ...

Accelerating Diffusion LLM Inference via Local Determinism Propagation ...

Accelerating Diffusion LLM Inference via Local Determinism Propagation ...

Accelerating Diffusion LLM Inference via Local Determinism Propagation ...

Accelerating Diffusion LLM Inference via Local Determinism Propagation ...

Focus-dLLM: Accelerating Long-Context Diffusion LLM Inference via ...

RetrievalAttention: Accelerating Long-Context LLM Inference via Vector ...

[Literature Review] HAMburger: Accelerating LLM Inference via Token ...

Paper page - SlimInfer: Accelerating Long-Context LLM Inference via ...

[논문 리뷰] RetrievalAttention: Accelerating Long-Context LLM Inference via ...
Advertisement Space (300x250)
Accelerating LLM Inference via Dynamic KV Cache Placement in ...

[Literature Review] Accelerating Diffusion Language Model Inference via ...
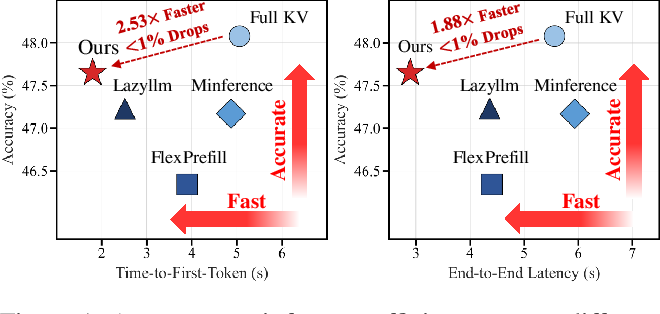
Figure 1 from SlimInfer: Accelerating Long-Context LLM Inference via ...

(PDF) RocketKV: Accelerating Long-Context LLM Inference via Two-Stage ...
Accelerating Diffusion Sampling via Exploiting Local Transition ...

RetrievalAttention: Accelerating Long-Context LLM Inference via Vector ...

(PDF) RetrievalAttention: Accelerating Long-Context LLM Inference via ...

Paper page - LycheeDecode: Accelerating Long-Context LLM Inference via ...
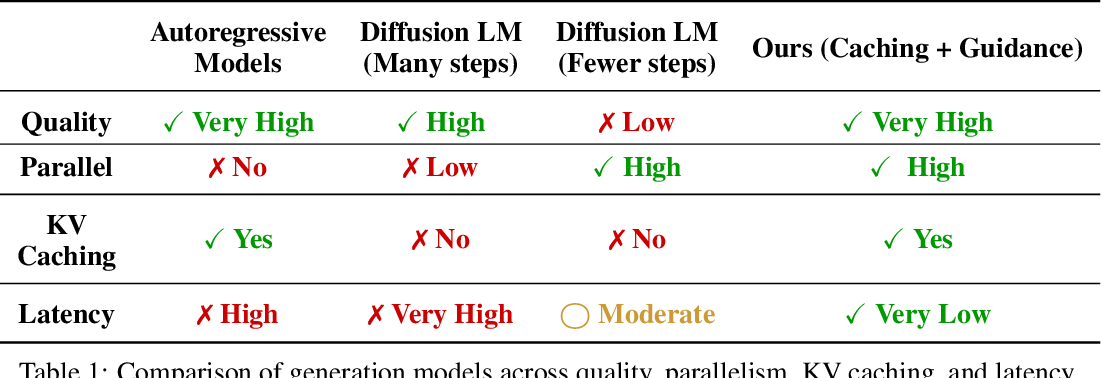
Table 1 from Accelerating Diffusion Language Model Inference via ...
SenCache: Accelerating Diffusion Model Inference via Sensitivity-Aware ...
Advertisement Space (336x280)
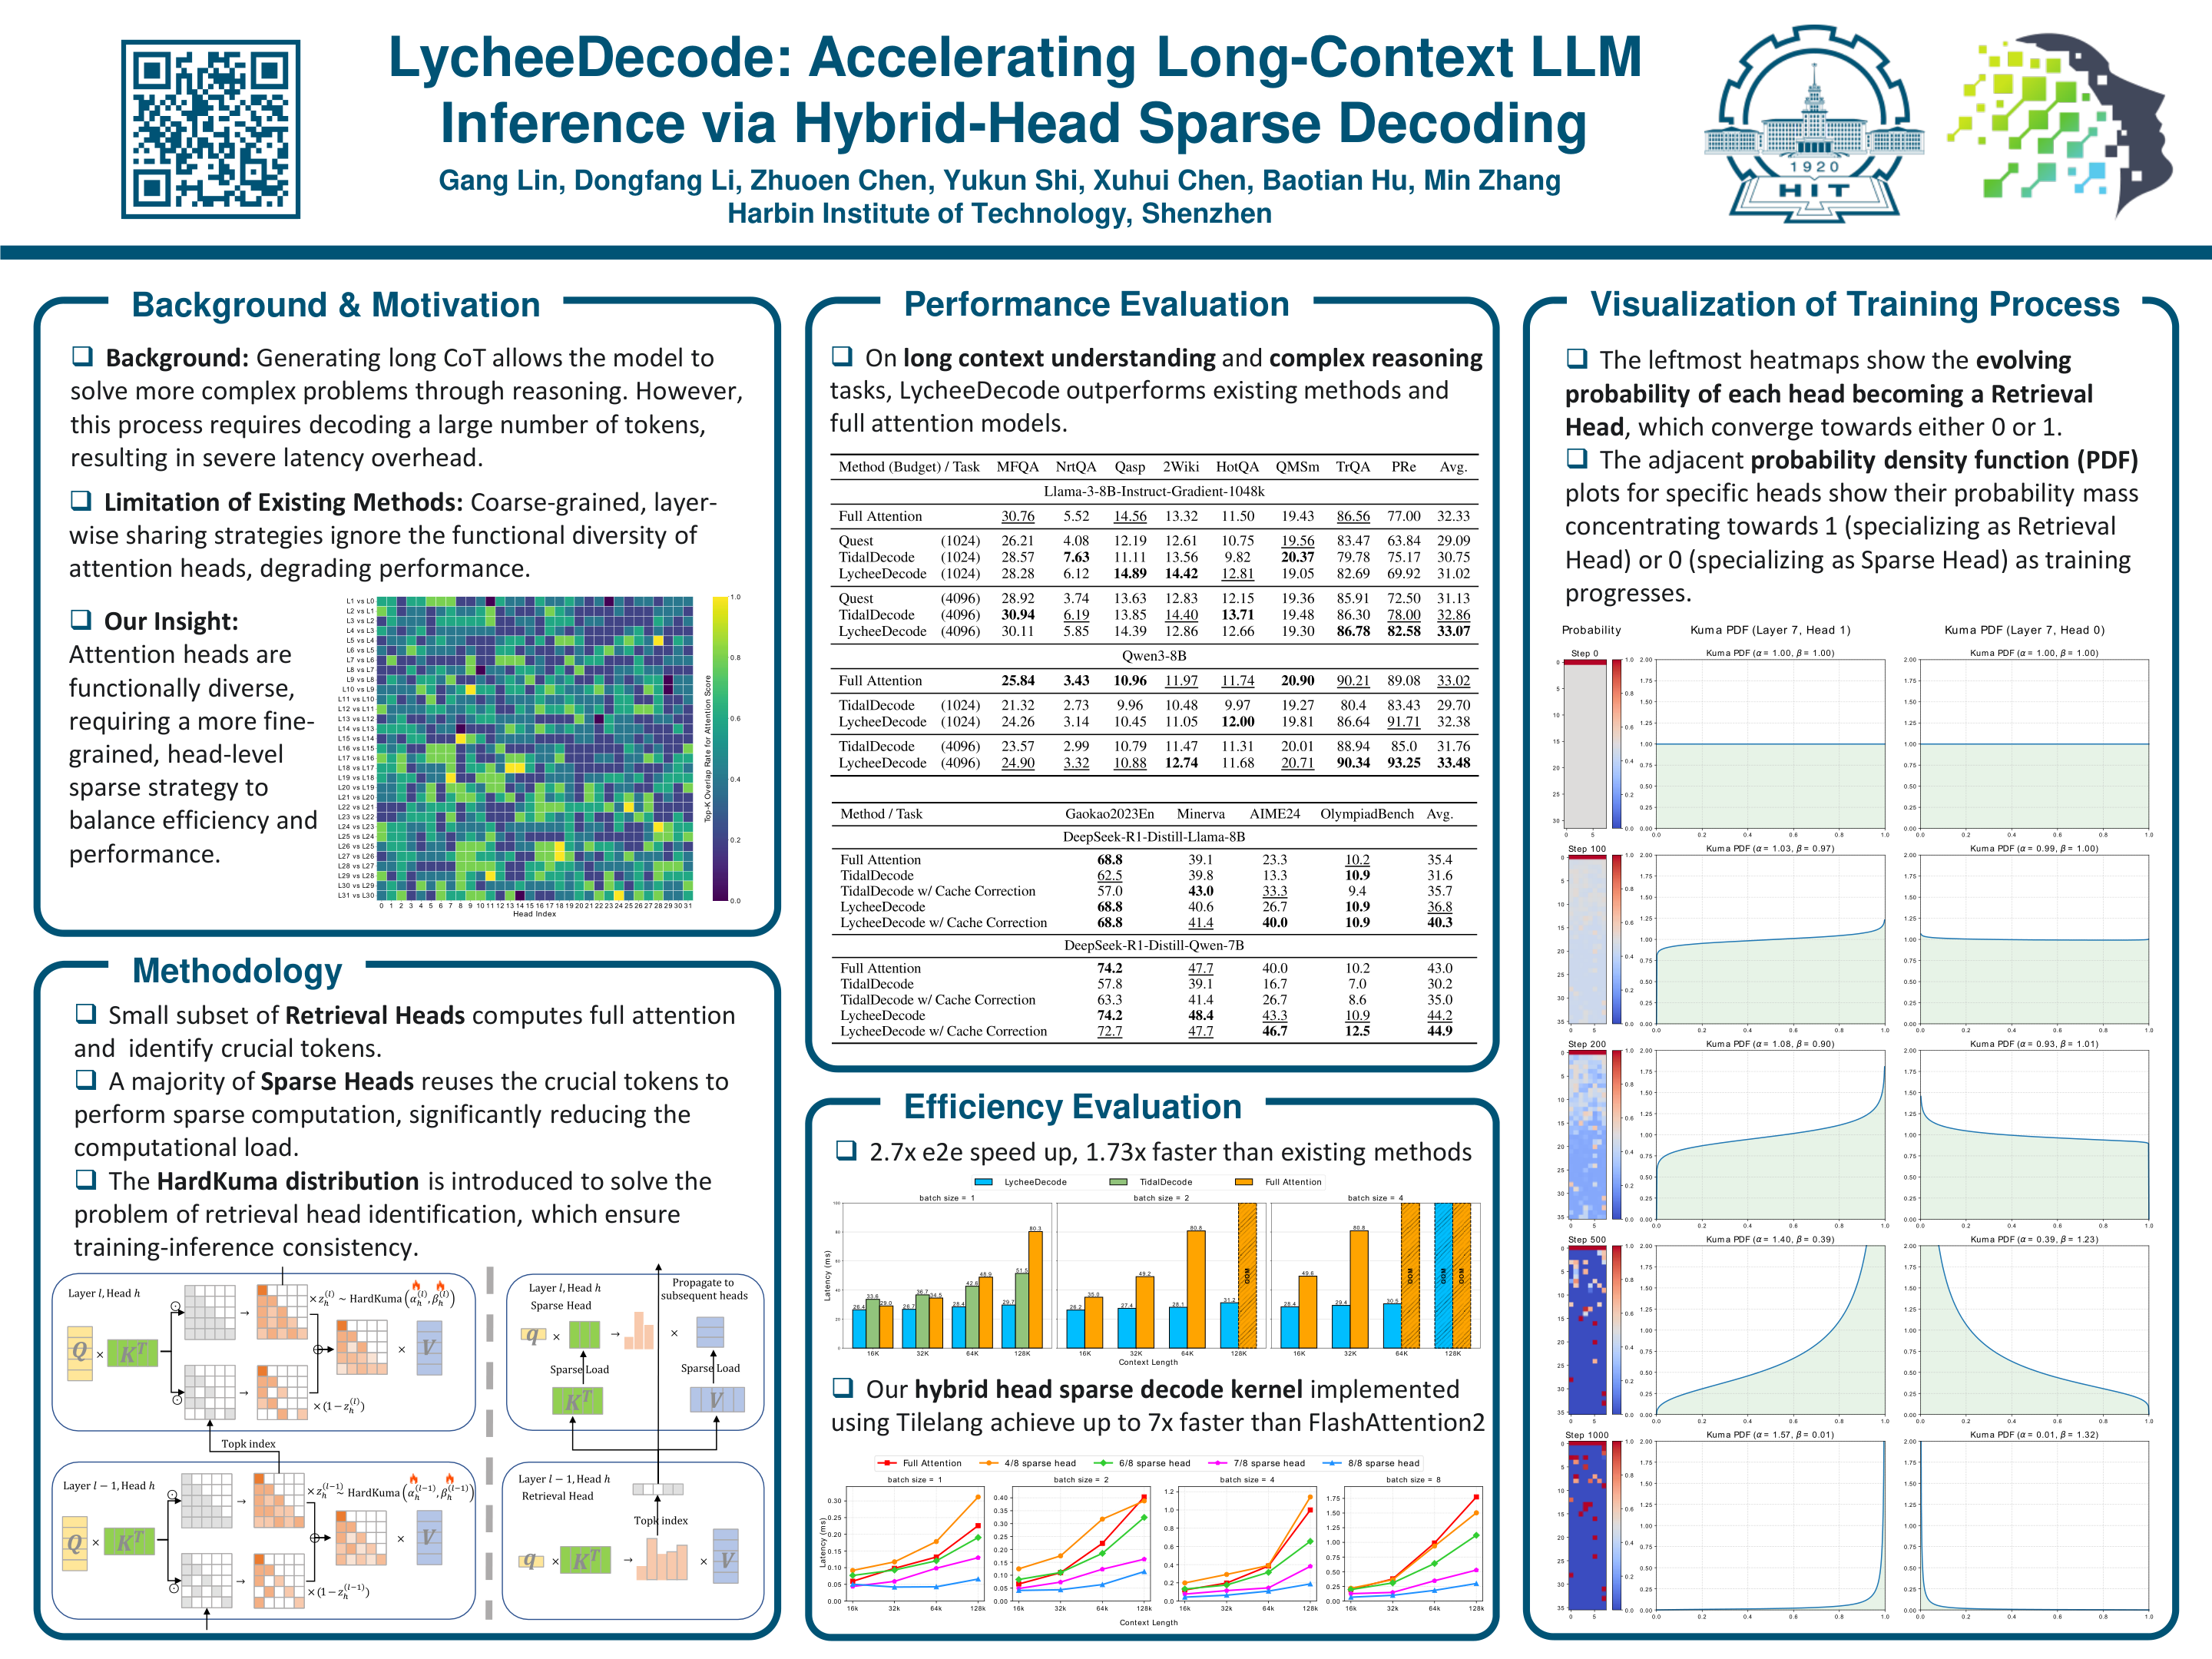
ICLR Poster LycheeDecode: Accelerating Long-Context LLM Inference via ...
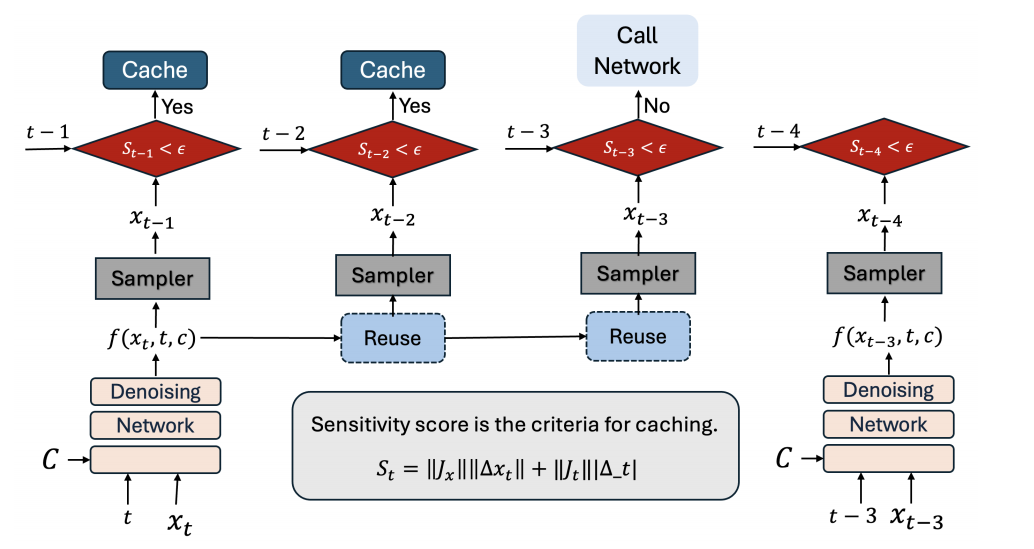
论文阅读:SenCache: Accelerating Diffusion Model Inference via Sensitivity ...
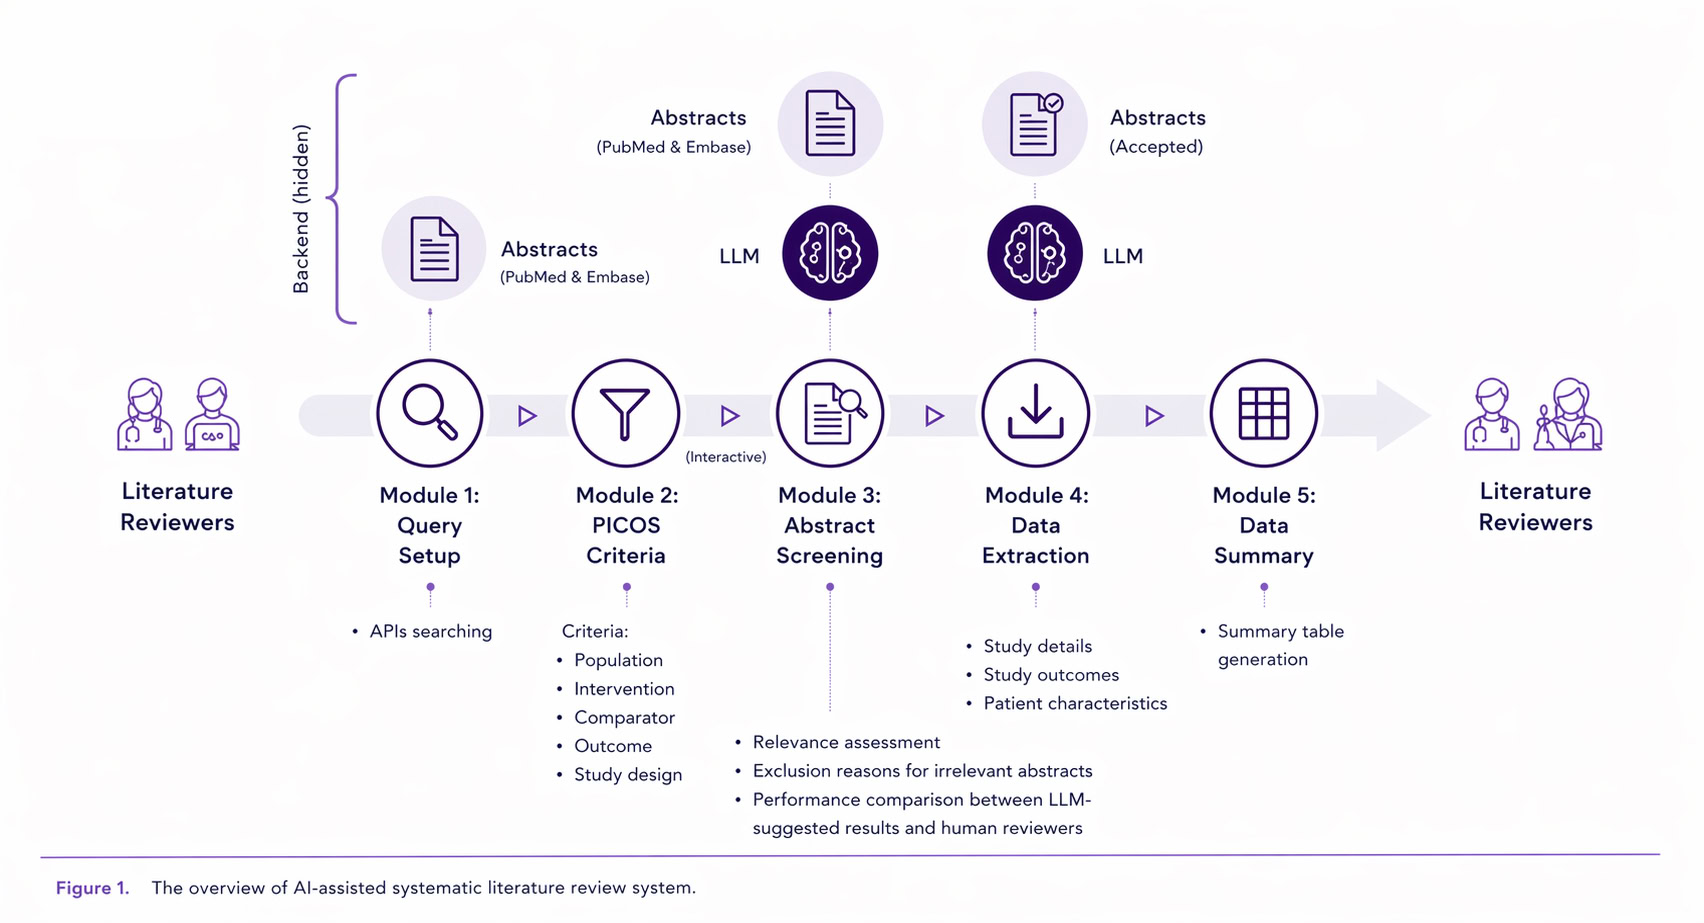
Case study: Accelerating literature review with AI-assisted precision

[Literature Review] VocalNet-MDM: Accelerating Streaming Speech LLM via ...

[Literature Review] PipeInfer: Accelerating LLM Inference using ...

[Literature Review] Focus-dLLM: Accelerating Long-Context Diffusion LLM ...

Paper page - Accelerating LLM Inference with Staged Speculative Decoding

Paper page - Focus-dLLM: Accelerating Long-Context Diffusion LLM ...

[Literature Review] SDSAT: Accelerating LLM Inference through ...

(PDF) Accelerating LLM Inference with Staged Speculative Decoding
Advertisement Space (336x280)

(PDF) Accelerating LLM Inference with Lossless Speculative Decoding ...

Paper page - Recursive Speculative Decoding: Accelerating LLM Inference ...

AcceLLM: Accelerating LLM Inference using Redundancy for Load Balancing ...

(PDF) Accelerating Diffusion LLMs via Adaptive Parallel Decoding

[論文レビュー] Accelerating Unbiased LLM Evaluation via Synthetic Feedback

[Literature Review] SpecFed: Accelerating Federated LLM Inference with ...