
Accelerating Diffusion Llm Inference Via Local Determinism Propagation

Accelerating Diffusion LLM Inference via Local Determinism Propagation ...

Accelerating Diffusion LLM Inference via Local Determinism Propagation ...

Accelerating Diffusion LLM Inference via Local Determinism Propagation ...

[2510.07081] Accelerating Diffusion LLM Inference via Local Determinism ...

[Literature Review] Accelerating Diffusion LLM Inference via Local ...

Focus-dLLM: Accelerating Long-Context Diffusion LLM Inference via ...

Paper page - AccLLM: Accelerating Long-Context LLM Inference Via ...

RetrievalAttention: Accelerating Long-Context LLM Inference via Vector ...
Accelerating Diffusion Sampling via Exploiting Local Transition ...
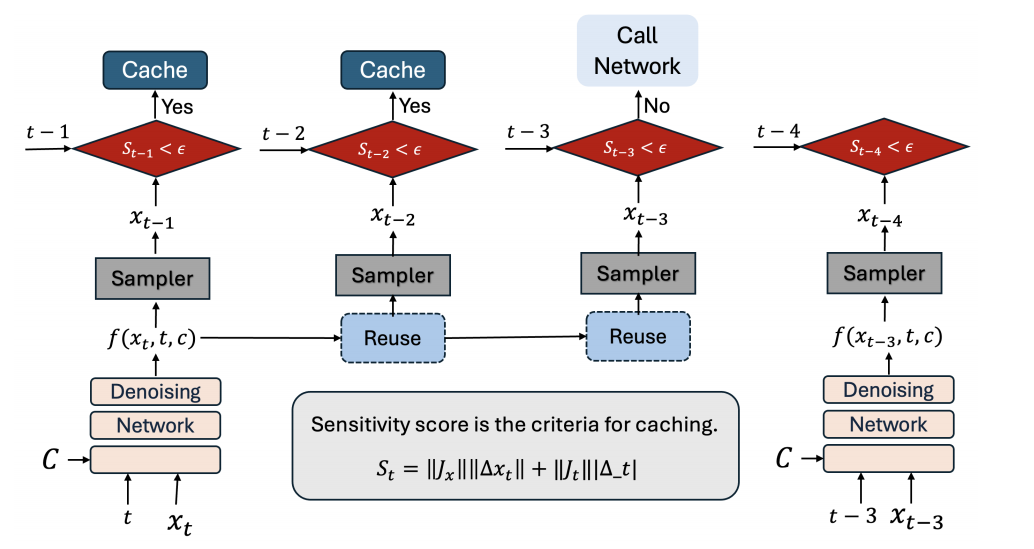
论文阅读:SenCache: Accelerating Diffusion Model Inference via Sensitivity ...
Advertisement Space (300x250)

RetrievalAttention: Accelerating Long-Context LLM Inference via Vector ...
Accelerating LLM Inference via Dynamic KV Cache Placement in ...
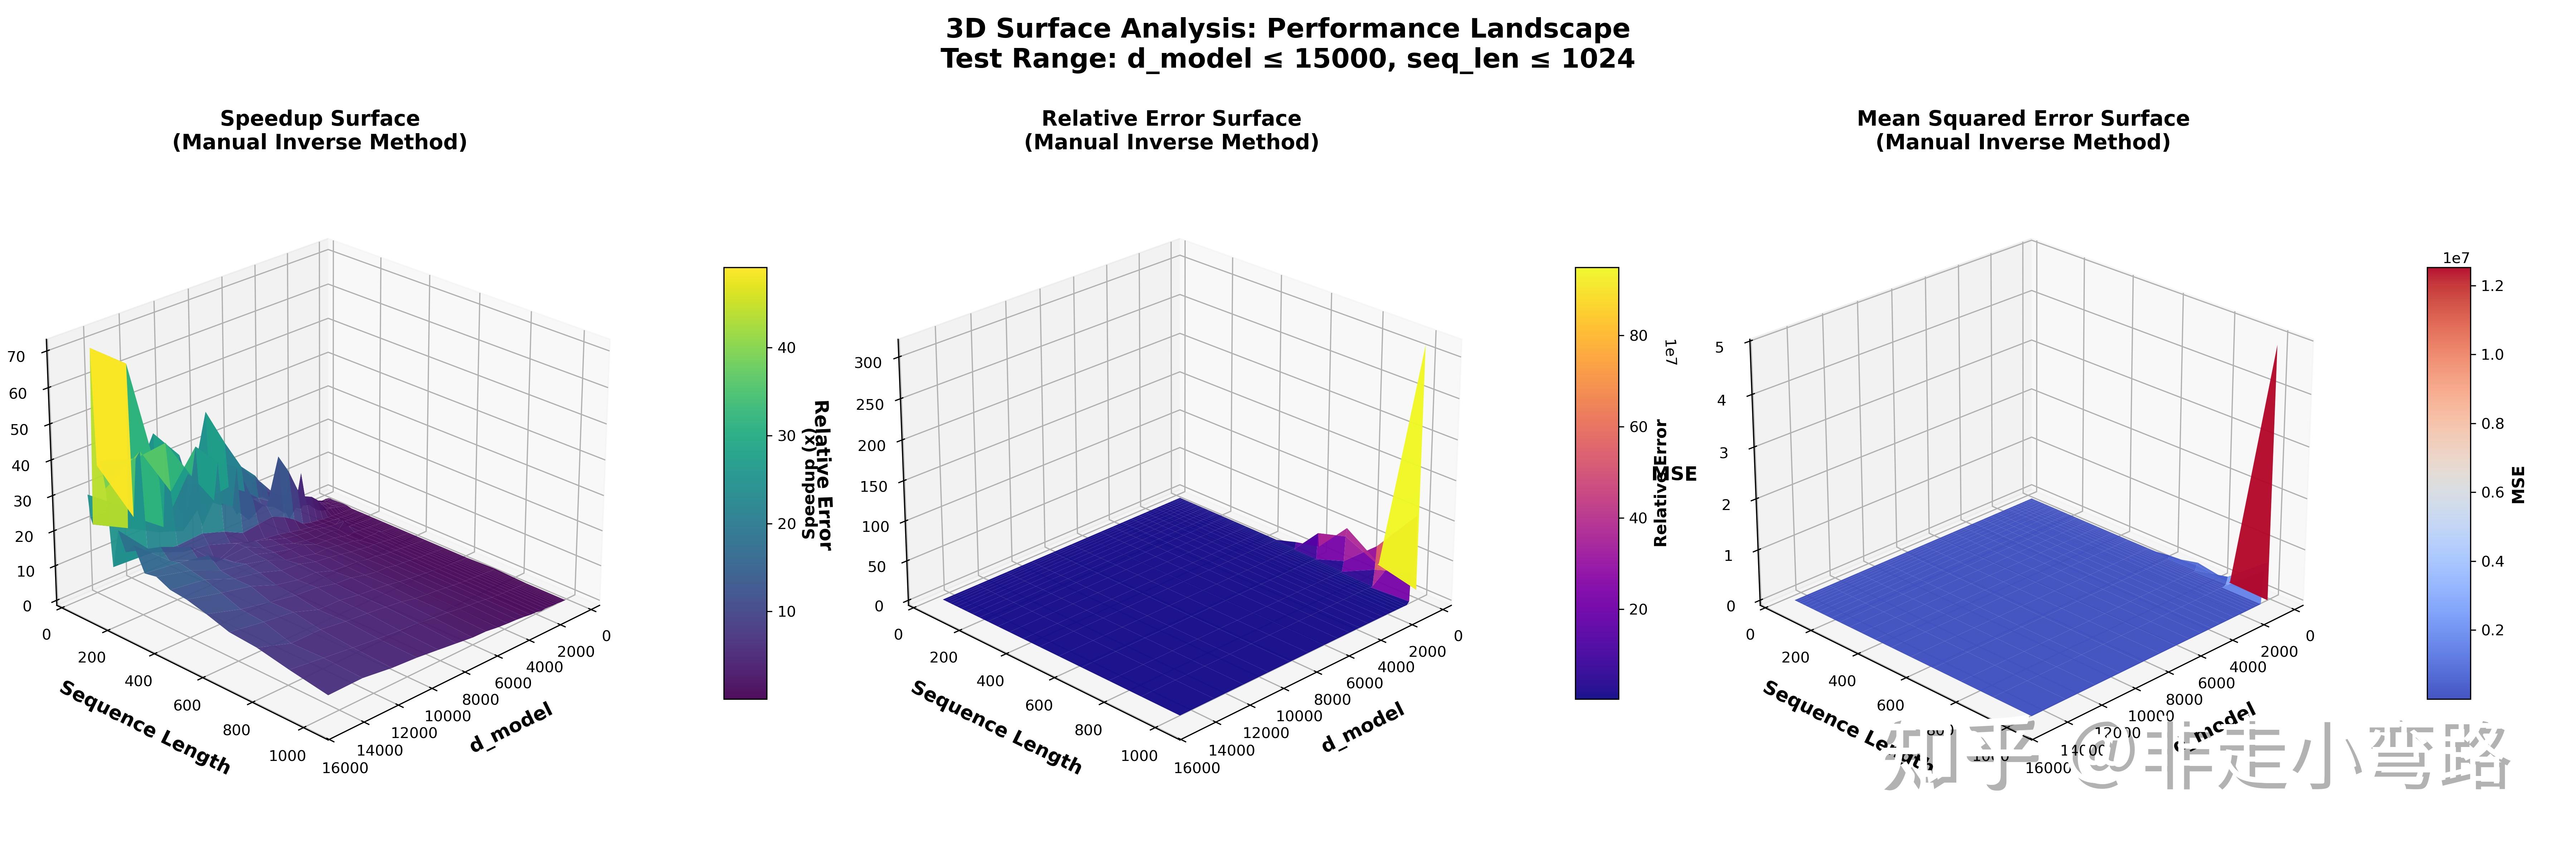
Accelerating next token inference in diffusion LLM on CPU - 知乎

(PDF) RetrievalAttention: Accelerating Long-Context LLM Inference via ...

AccLLM: Accelerating Long-Context LLM Inference Via Algorithm-Hardware ...

Paper page - Accelerating Diffusion Language Model Inference via ...

[Literature Review] Accelerating Diffusion Language Model Inference via ...

Paper page - SenCache: Accelerating Diffusion Model Inference via ...

[论文评述] Accelerating LLM Inference Throughput via Asynchronous KV Cache ...

Spiffy: Multiplying Diffusion LLM Acceleration via Lossless Speculative ...
Advertisement Space (336x280)

No Cache Left Idle: Accelerating diffusion model via Extreme-slimming ...

Accelerating Inference in Molecular Diffusion Models with Latent ...

Accelerating Inference in Molecular Diffusion Models with Latent ...
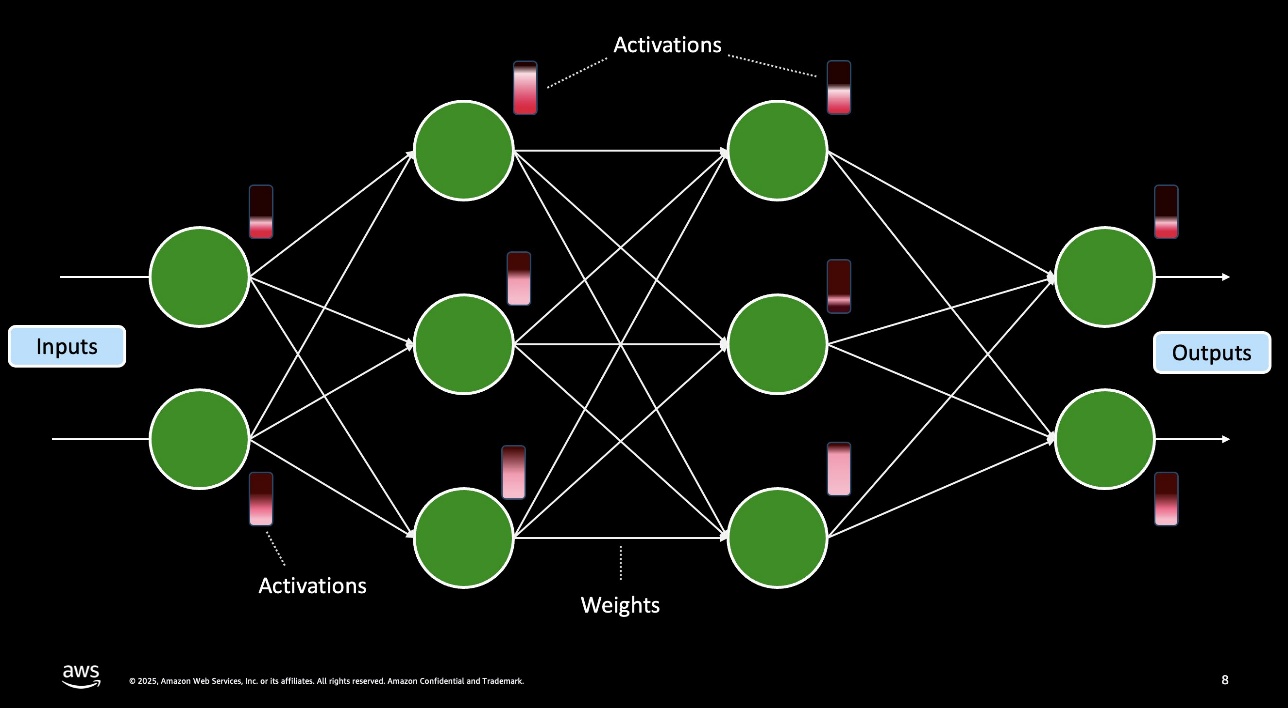
Accelerating LLM Inference on Amazon SageMaker Using AWQ and GPTQ ...

Accelerating Diffusion Transformer via Gradient-Optimized Cache | AI ...

[论文评述] PLD+: Accelerating LLM inference by leveraging Language Model ...

[Literature Review] Focus-dLLM: Accelerating Long-Context Diffusion LLM ...

Paper page - Focus-dLLM: Accelerating Long-Context Diffusion LLM ...

Paper page - Accelerating LLM Inference with Staged Speculative Decoding

[論文レビュー] Accelerating Diffusion Transformer via Error-Optimized Cache
Advertisement Space (336x280)

[论文评述] Spiffy: Multiplying Diffusion LLM Acceleration via Lossless ...

(PDF) Accelerating LLM Inference with Lossless Speculative Decoding ...

Accelerating Inference in Molecular Diffusion Models with Latent ...

Accelerating Diffusion Models with Parallel Sampling: Inference at Sub ...

Accelerating LLM Inference - Tradeoffs, Design, and New Ideas

(PDF) Accelerating LLM Inference with Staged Speculative Decoding