
Accelerating Generative Llms Inference With Parallel Draft Models Pard
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)
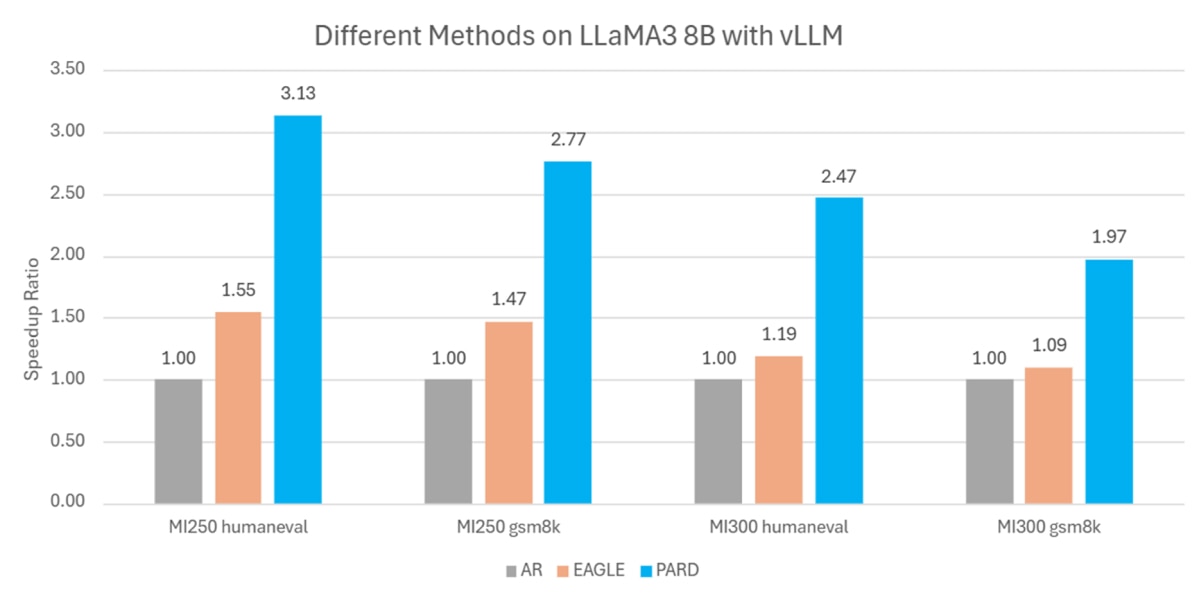
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)
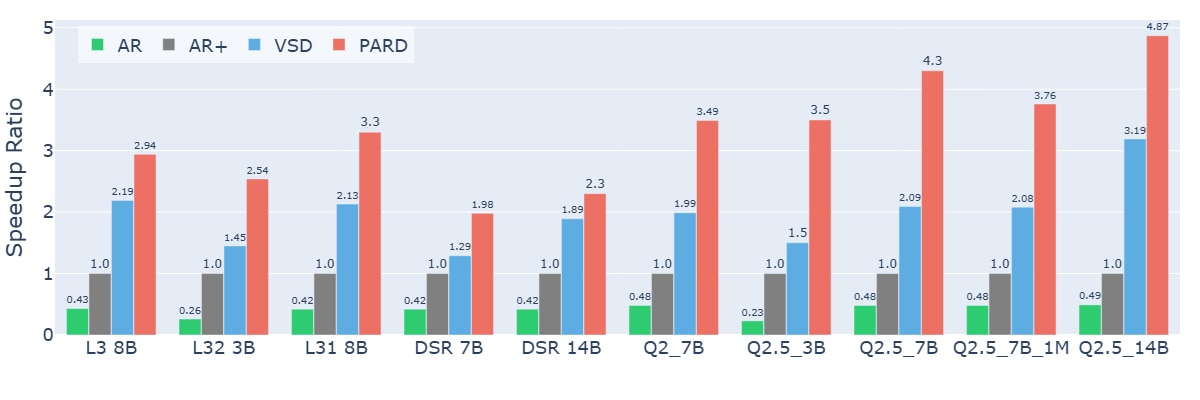
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)
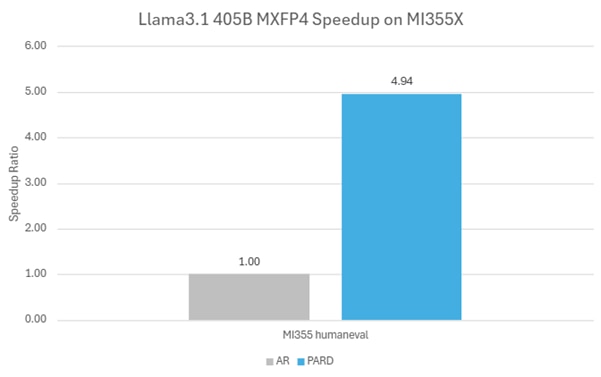
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)

PARD: Accelerating LLM Inference with Low-Cost PARallel Draft Model ...

PARD: Accelerating LLM Inference with Low-Cost PARallel Draft Model ...
Advertisement Space (300x250)

PARD: Accelerating LLM Inference with Low-Cost PARallel Draft Model ...

PARD: Accelerating LLM Inference with Low-Cost PARallel Draft Model ...

PARD: Accelerating LLM Inference with Low-Cost PARallel Draft Model ...
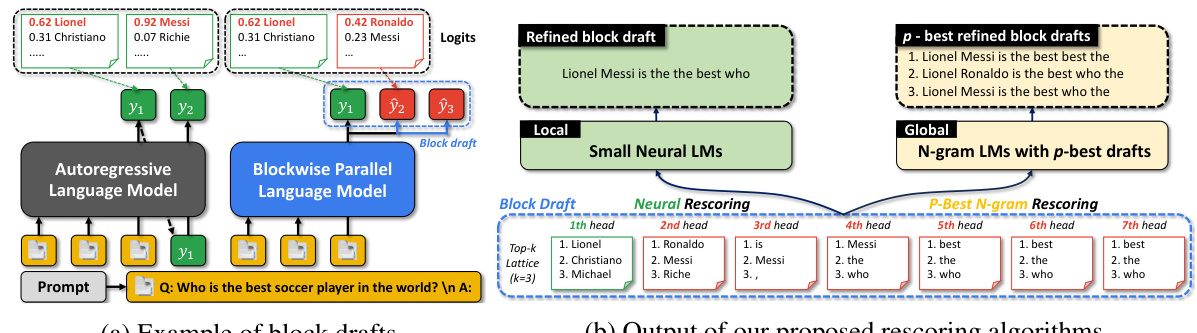
Accelerating Blockwise Parallel Language Models with Draft Refinement ...
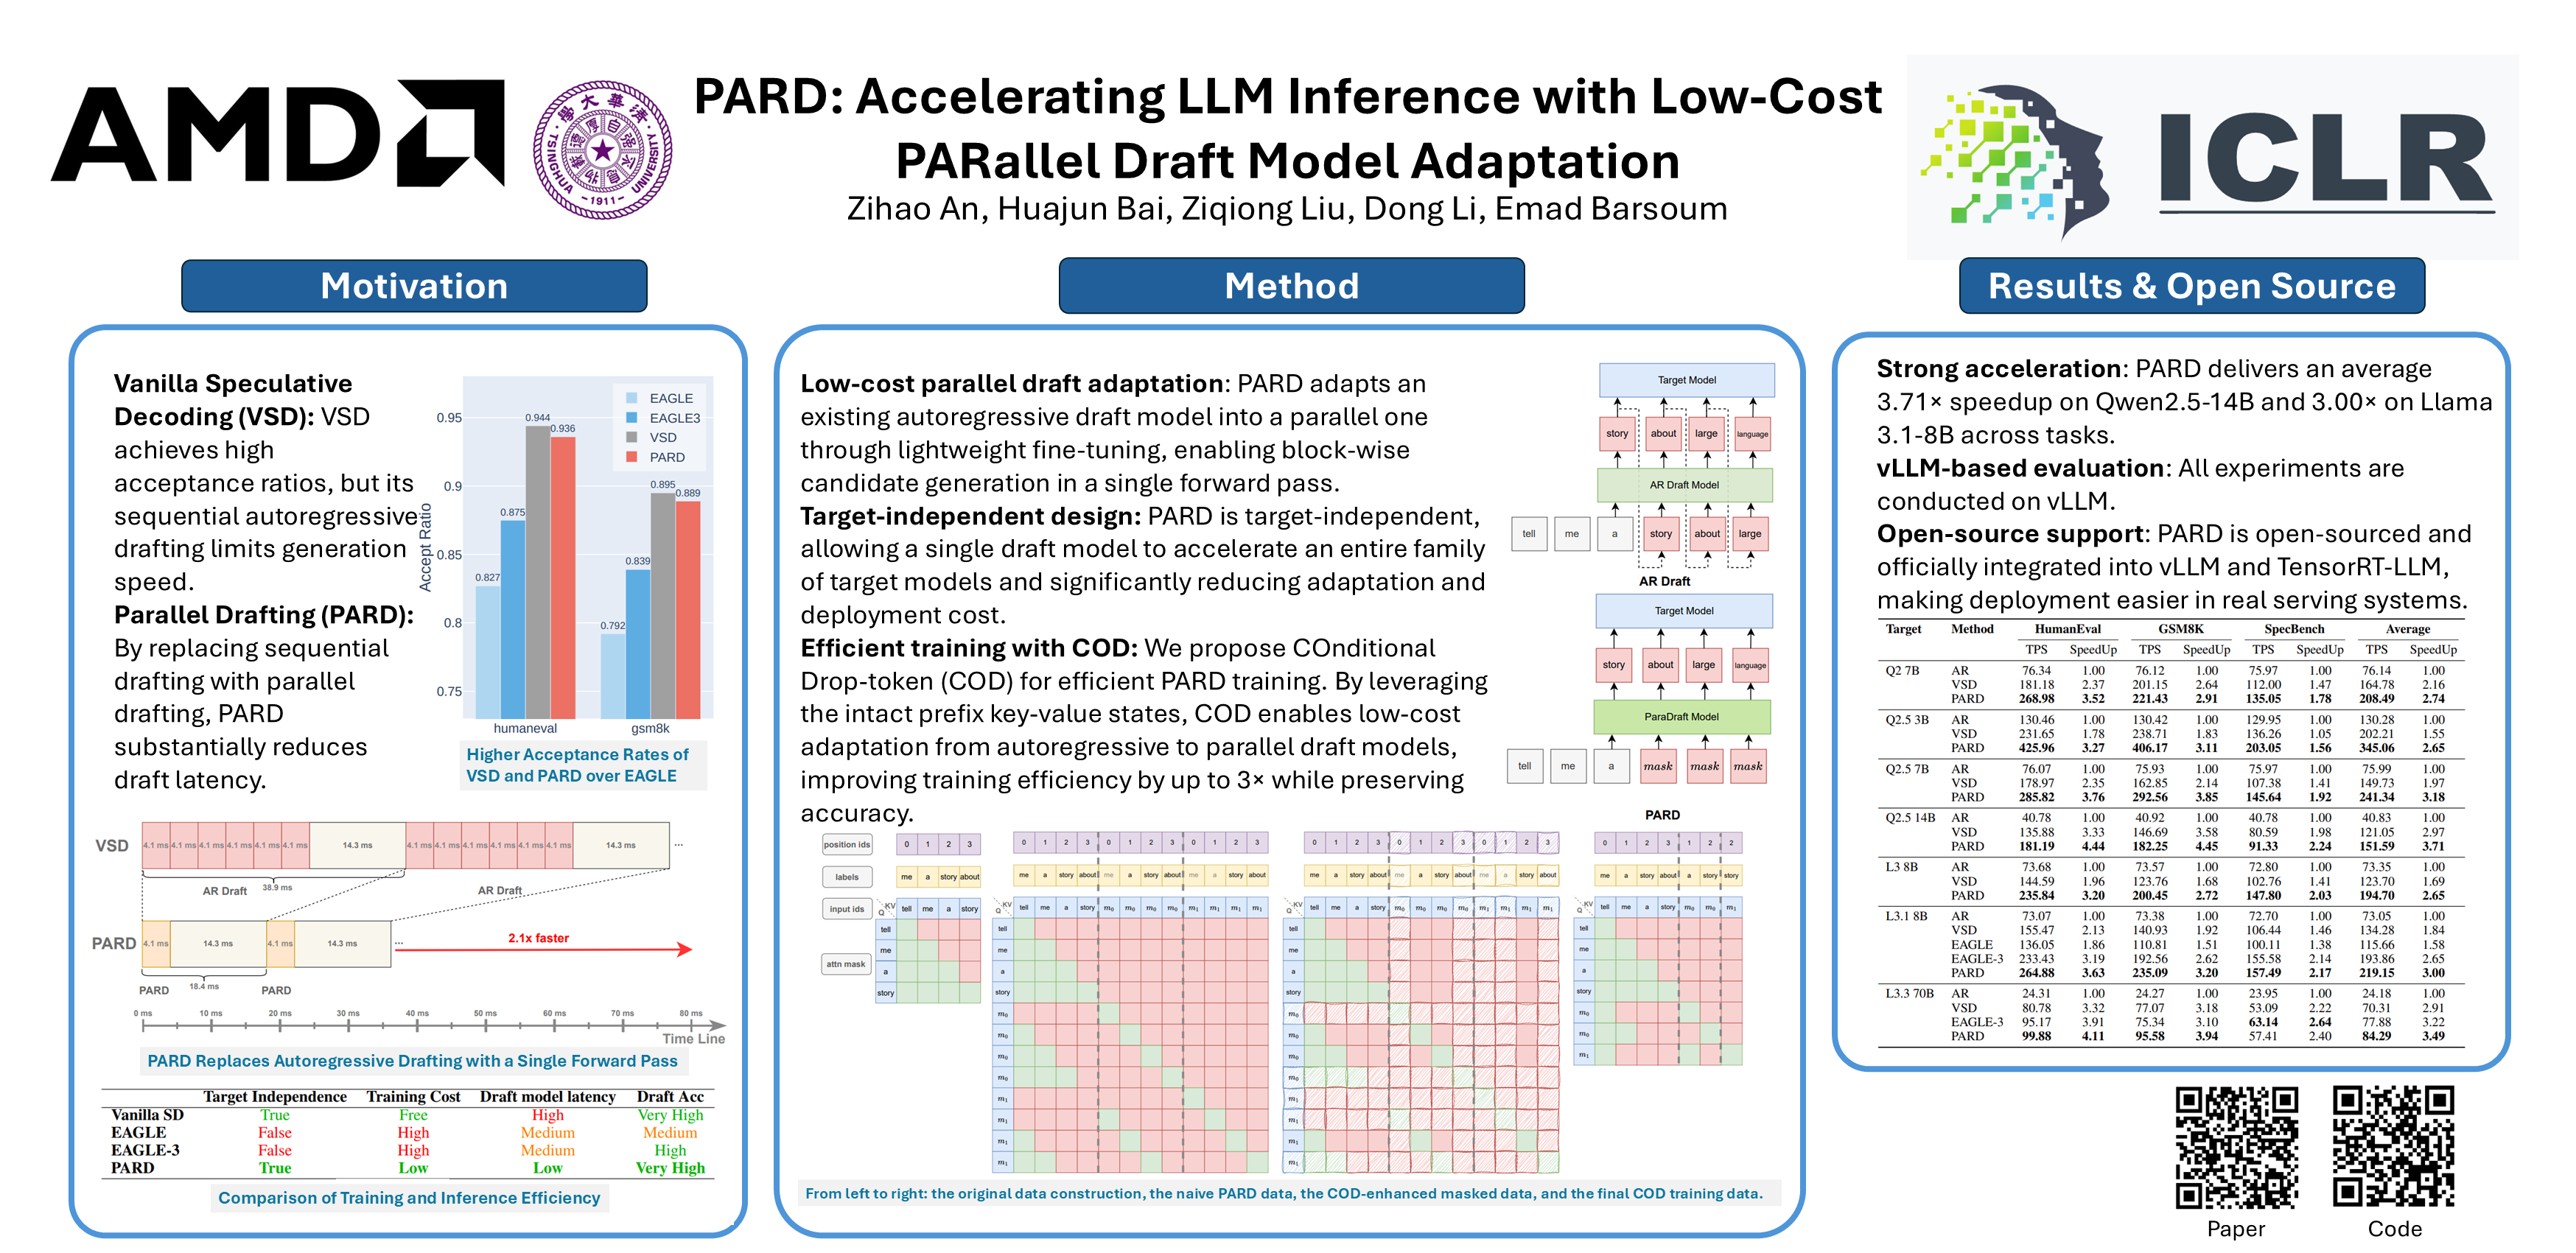
ICLR Poster PARD: Accelerating LLM Inference with Low‑Cost PARallel ...

Paper page - PARD: Accelerating LLM Inference with Low-Cost PARallel ...
GitHub - AMD-AGI/PARD: PARD: Accelerating LLM Inference with Low-Cost ...
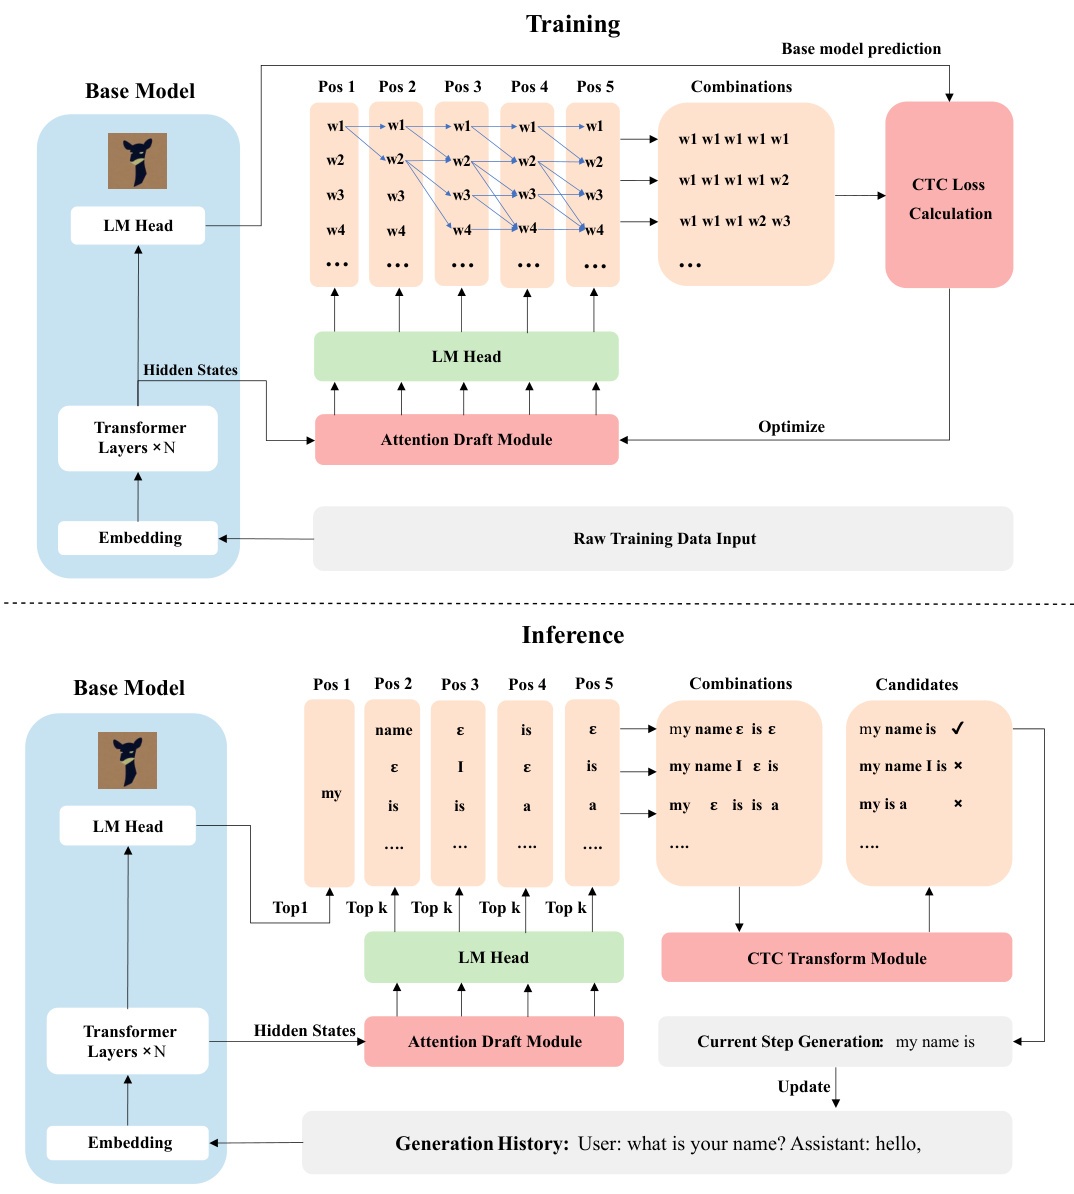
Speculative Decoding with CTC-based Draft Model for LLM Inference ...

[논문 리뷰] Falcon: Faster and Parallel Inference of Large Language Models ...
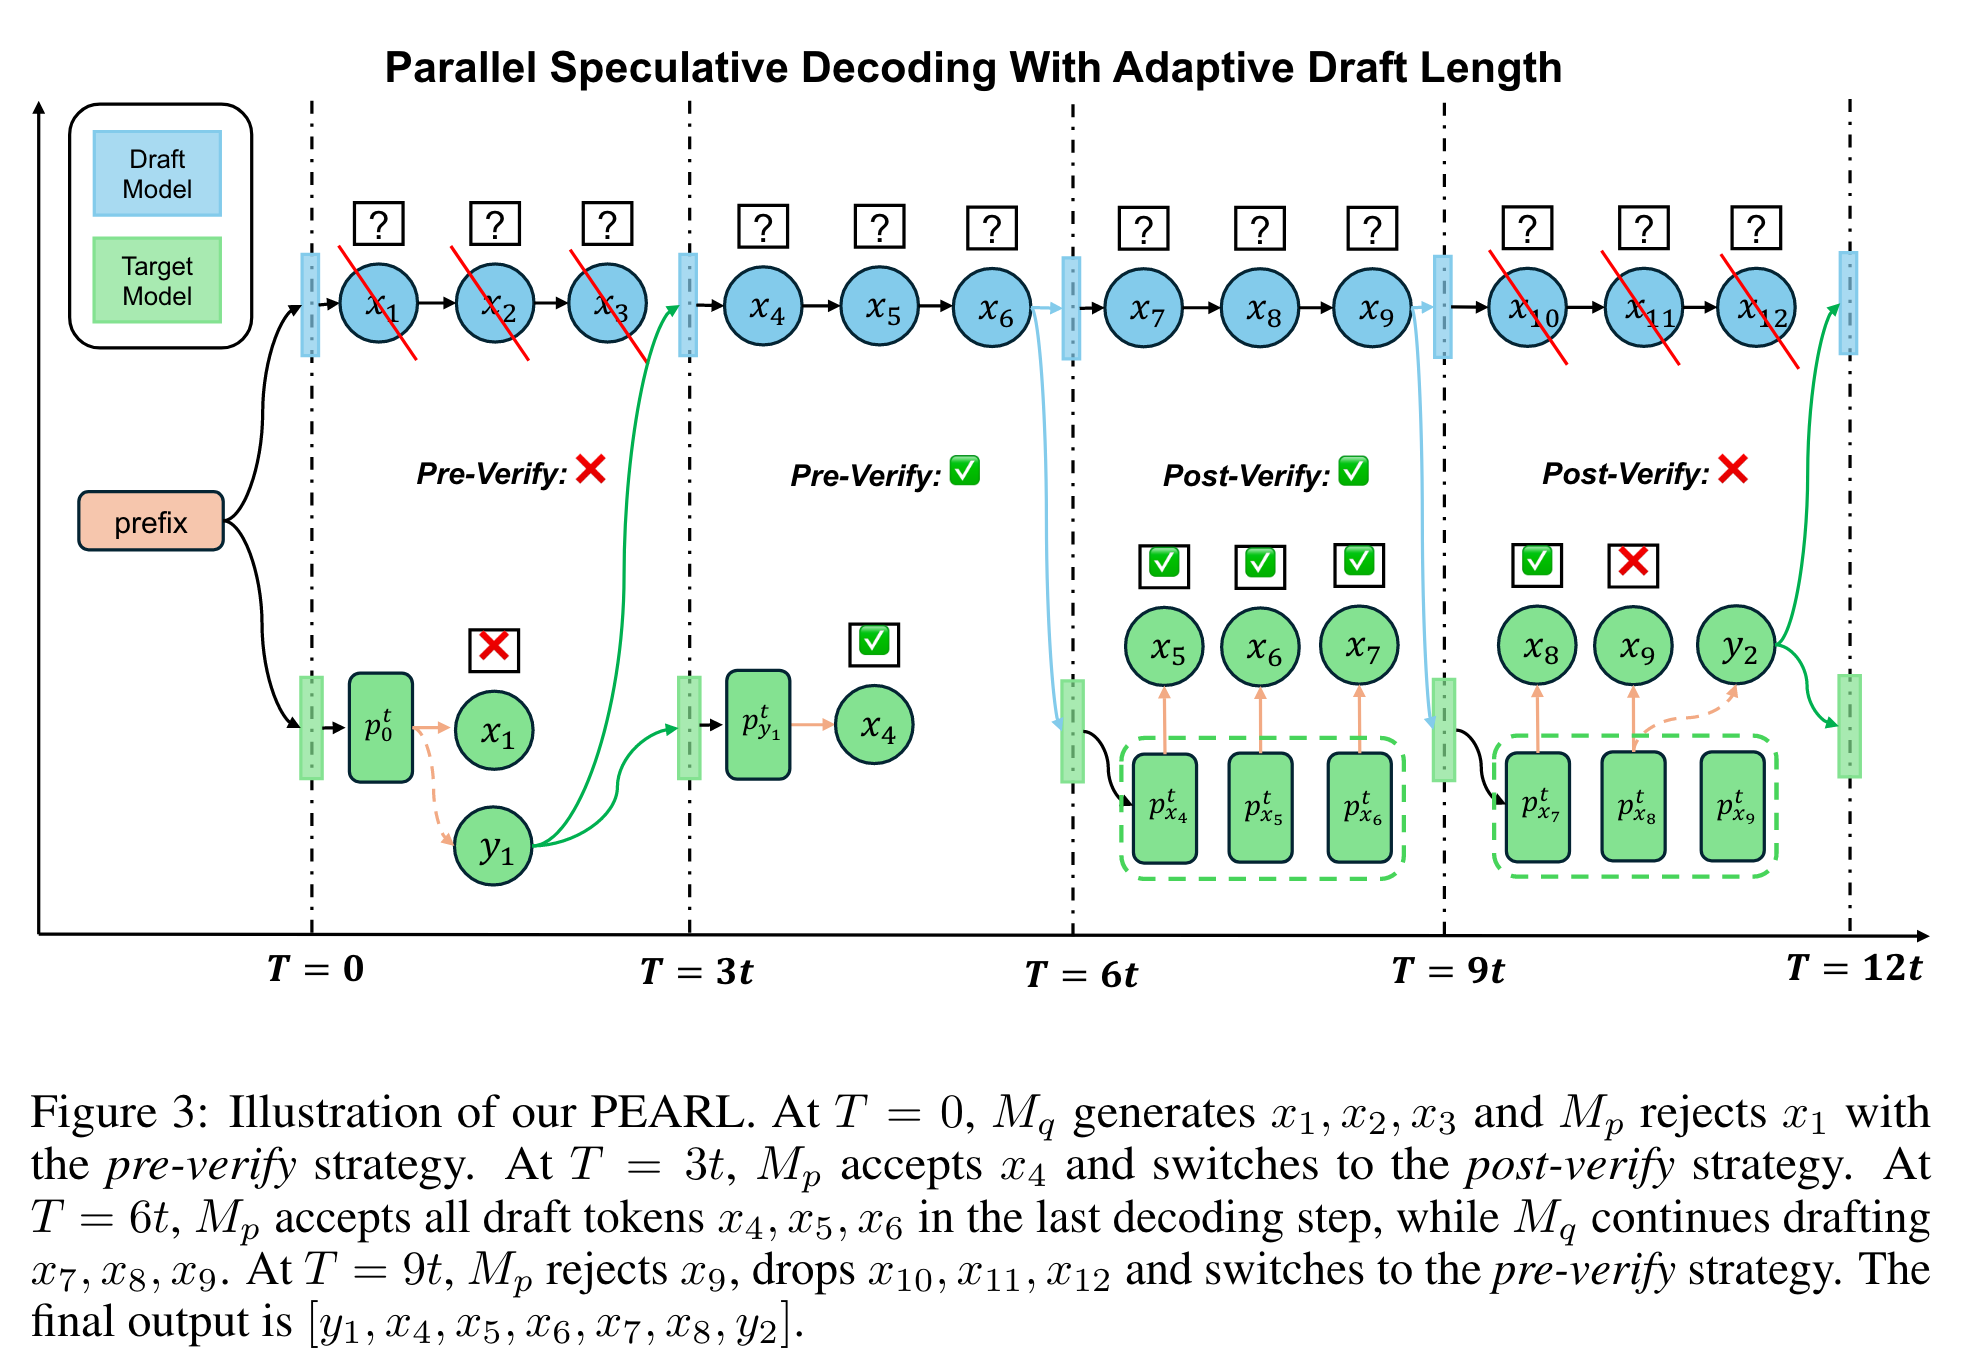
PEARL: Parallel Speculative Decoding with Adaptive Draft Length - 知乎
Advertisement Space (336x280)

SpecInfer: Accelerating Generative LLM Serving with Speculative ...

Parallel Speculative Decoding with Adaptive Draft Length

SpecInfer: Accelerating Generative LLM Serving with Speculative ...

Falcon: Faster and Parallel Inference of Large Language Models through ...
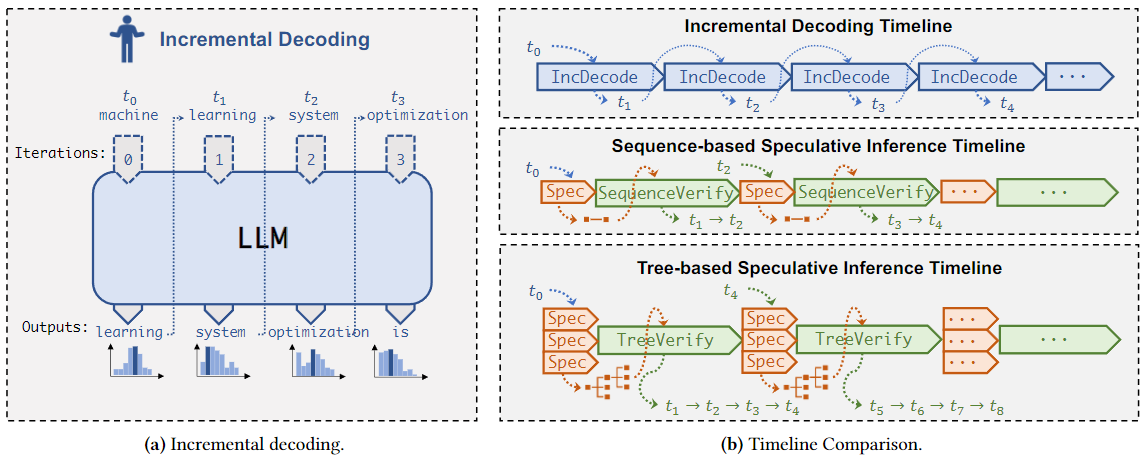
SpecInfer: Accelerating Generative LLM Serving with Tree-based ...
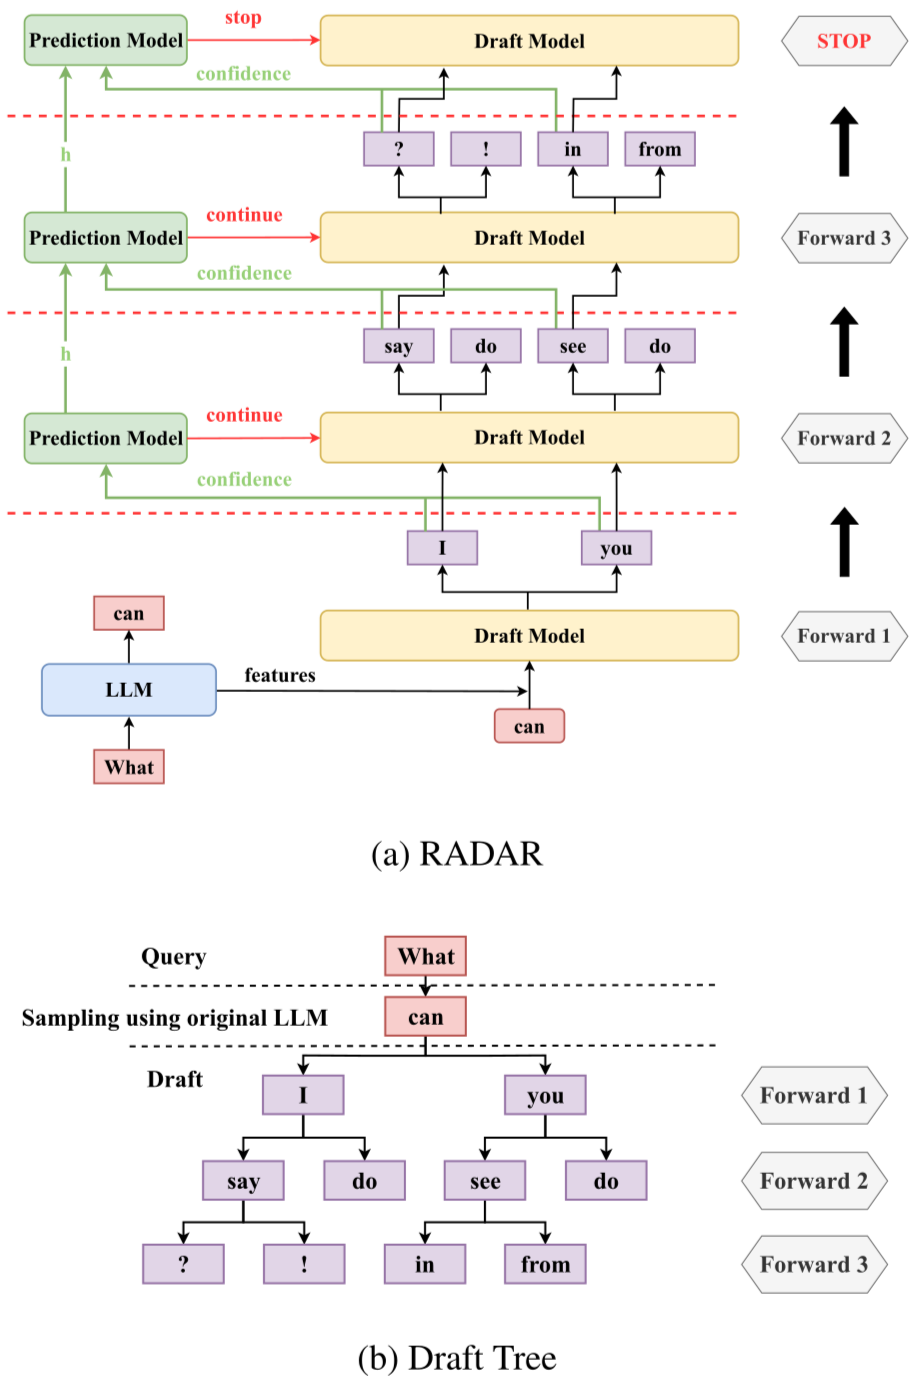
[논문 리뷰] RADAR: Accelerating Large Language Model Inference With RL ...

Paper page - SpecInfer: Accelerating Generative LLM Serving with ...
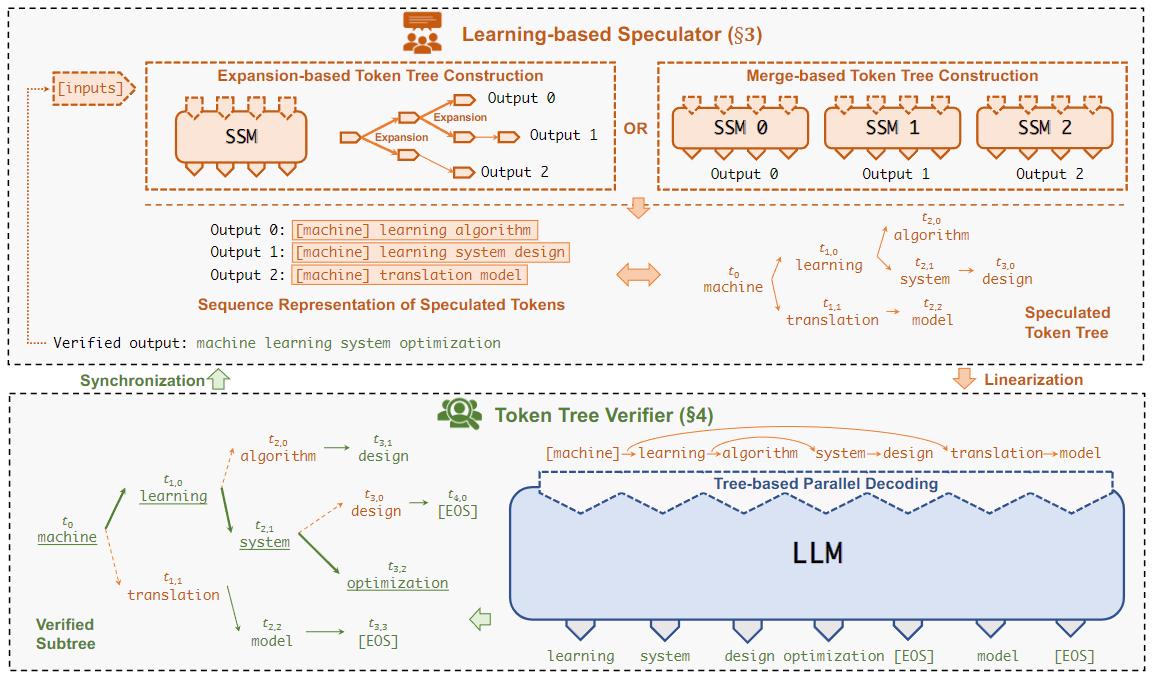
SpecInfer: Accelerating Generative LLM Serving with Tree-based ...

(PDF) SpecInfer: Accelerating Generative LLM Serving with Speculative ...

transforming LLMs into parallel decoders boosts inference speed by up ...
Advertisement Space (336x280)
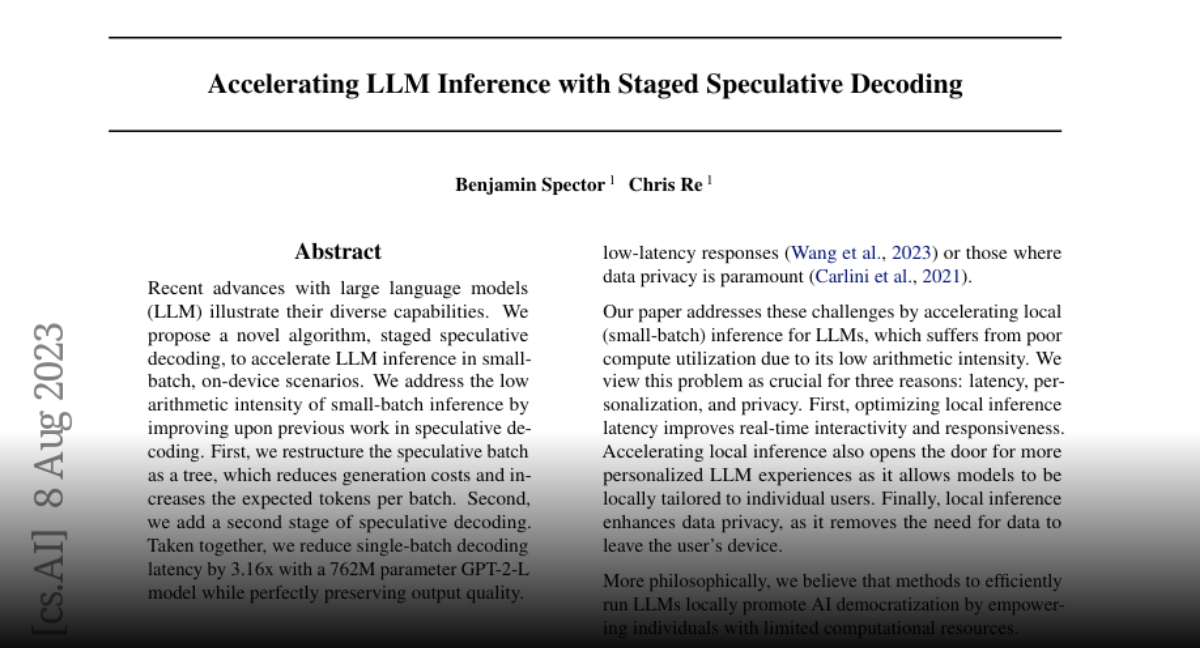
Paper page - Accelerating LLM Inference with Staged Speculative Decoding
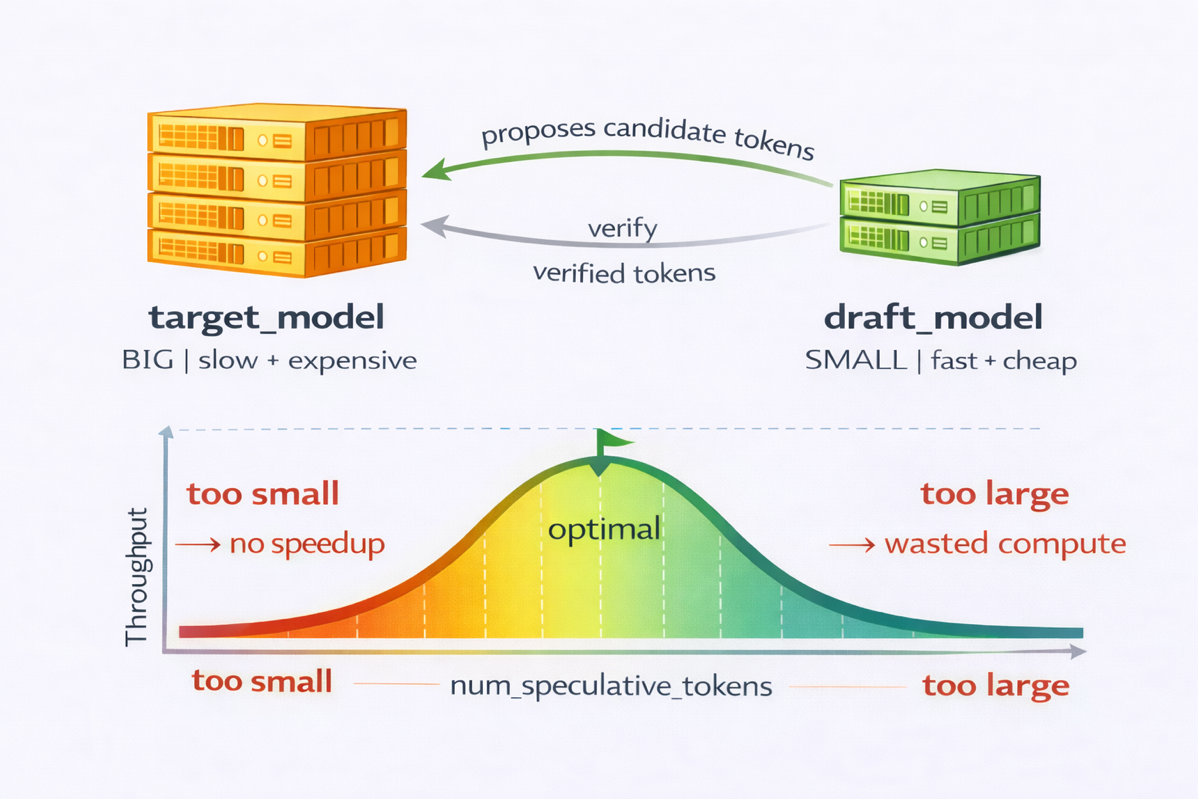
Accelerating decode-heavy LLM inference with speculative decoding on ...
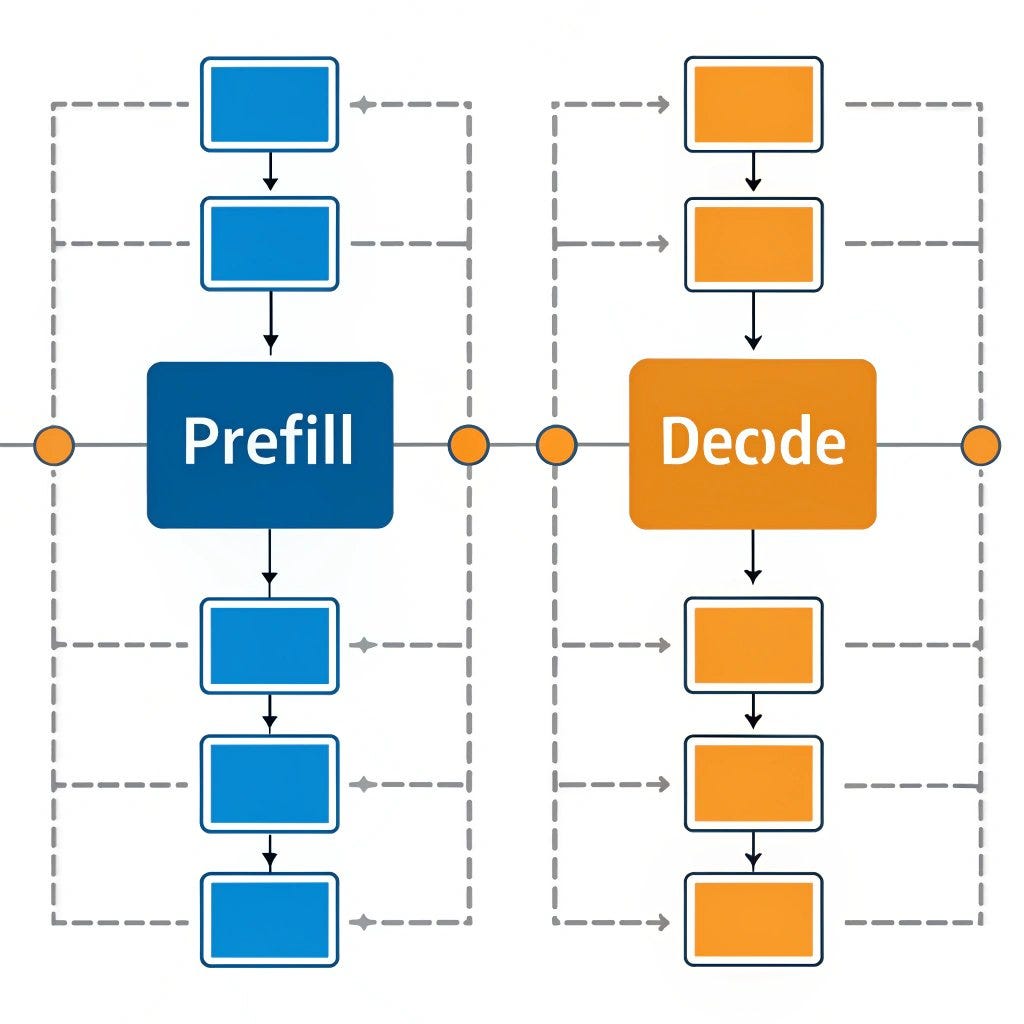
Accelerating Language Models with Multi-Token Prediction | by Himank ...
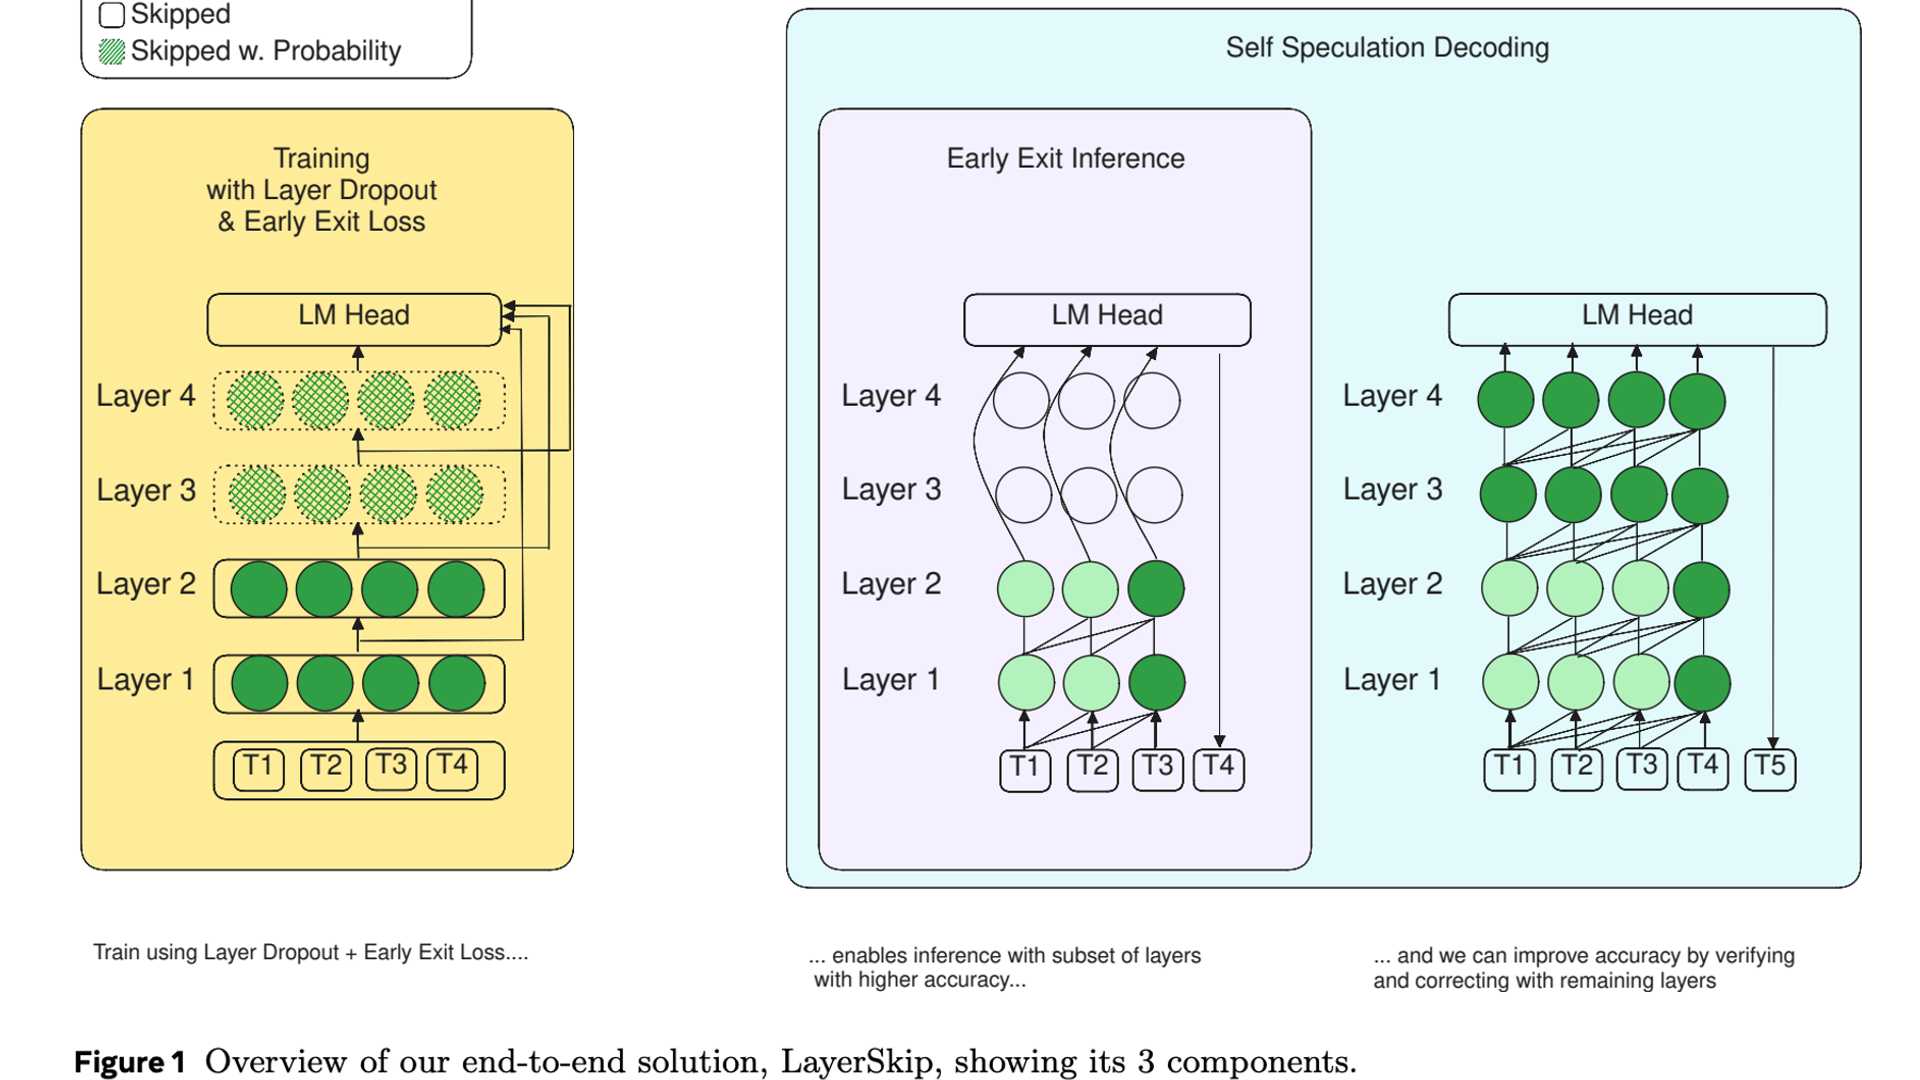
LayerSkip: A Game-Changer for Accelerating Inference in LLMs - Fusion Chat
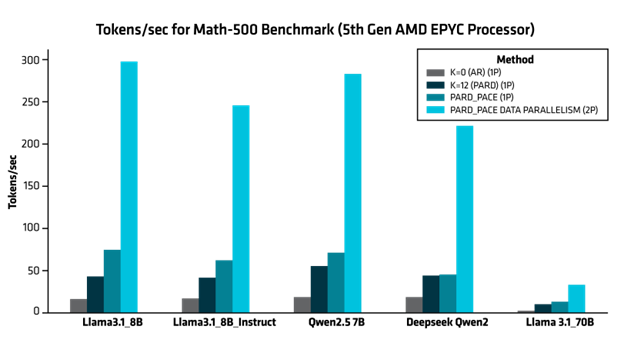
Speculative LLM Inference on the 5th Gen AMD EPYC Processors with PARD ...
P-EAGLE: Faster LLM inference with Parallel Speculative Decoding in ...