
Efficient Attention Sharing Information Distillation Transformer For
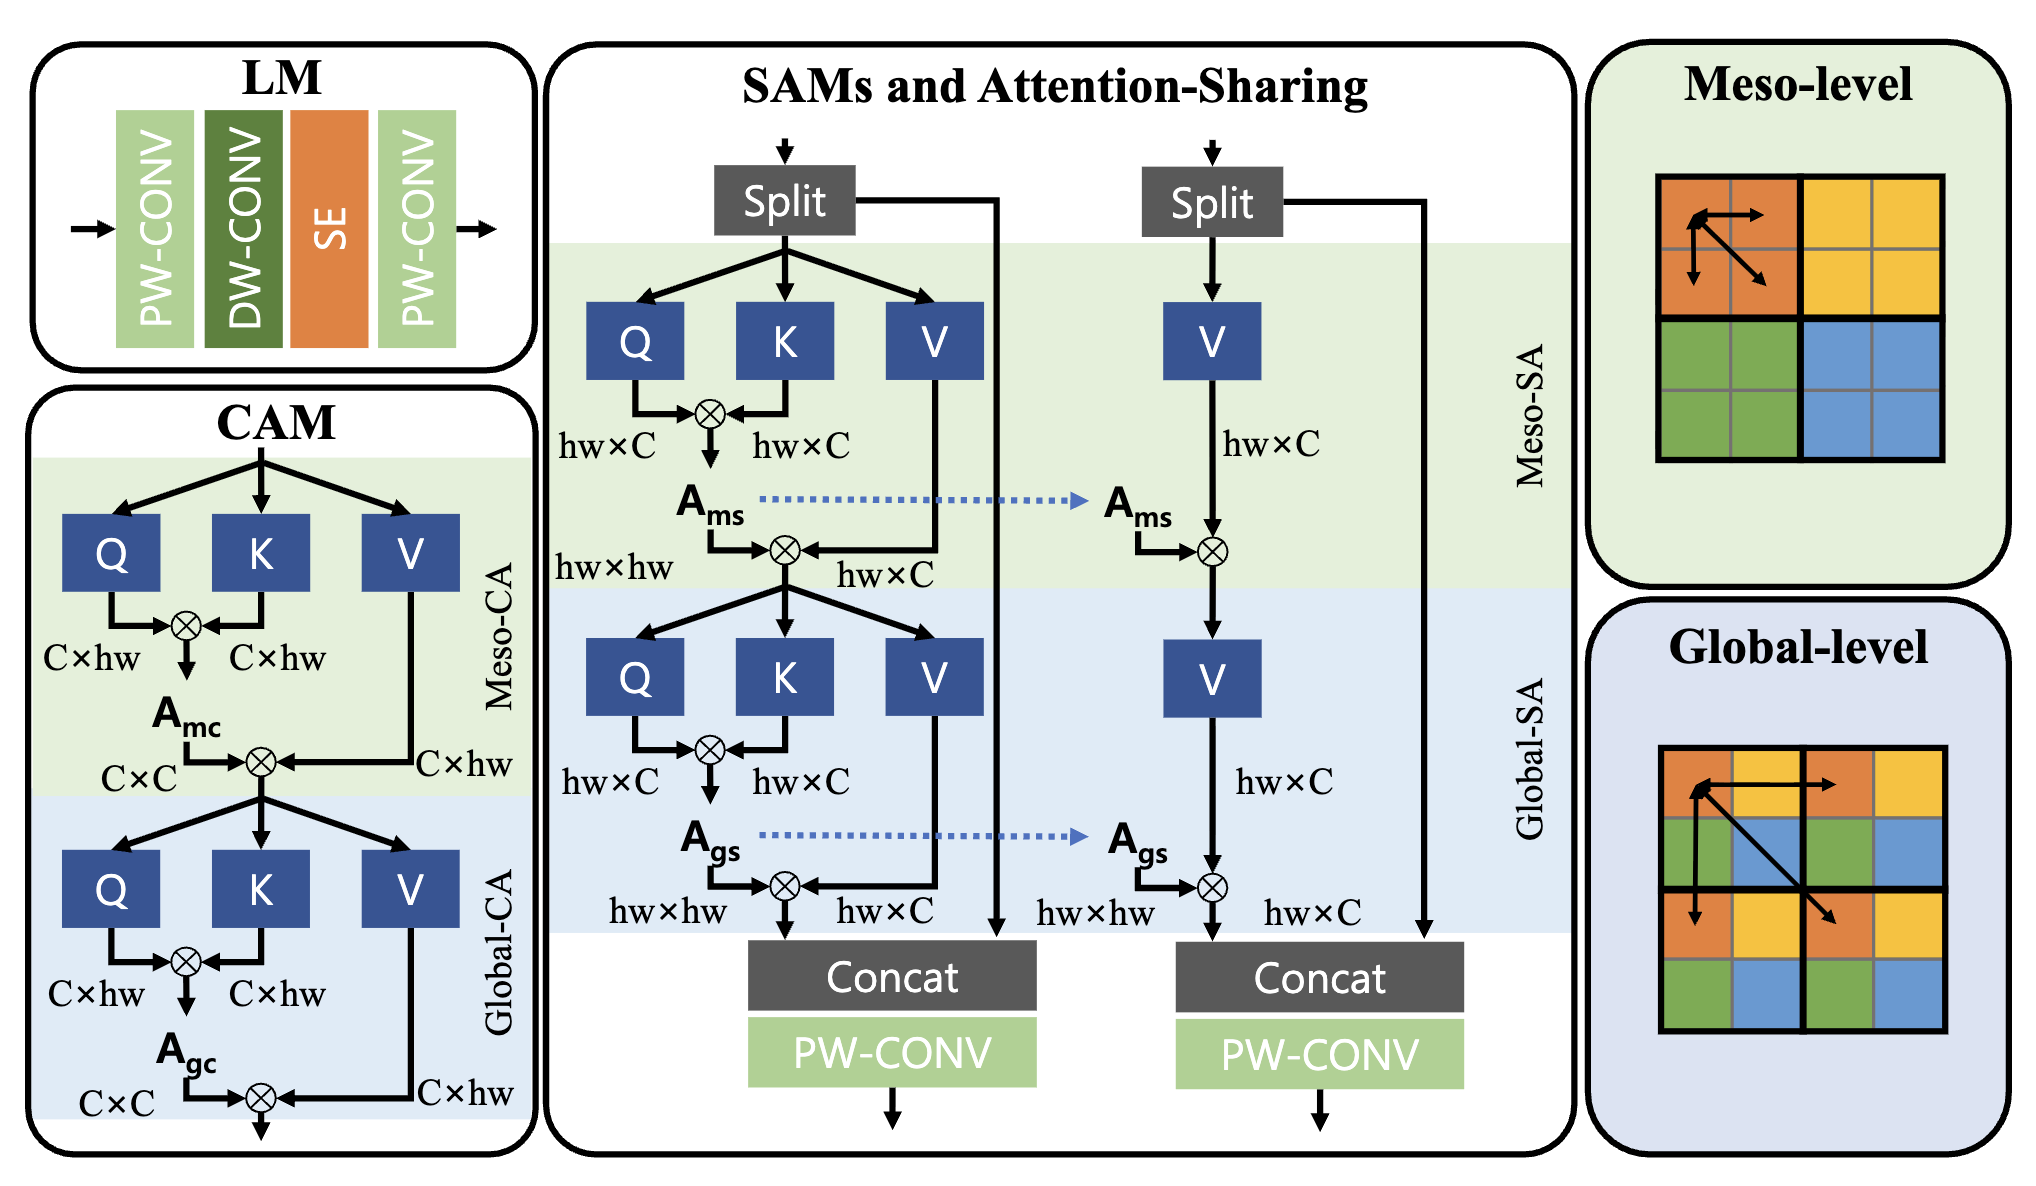
Efficient Attention-Sharing Information Distillation Transformer for ...
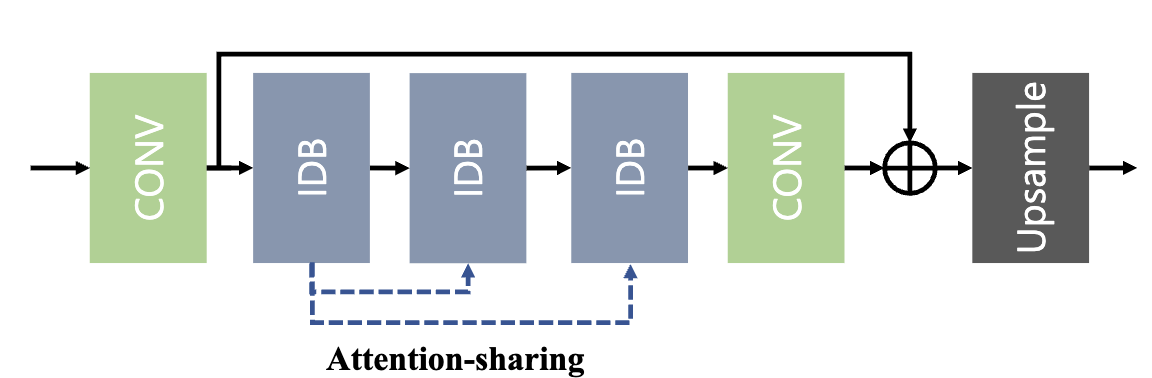
Efficient Attention-Sharing Information Distillation Transformer for ...
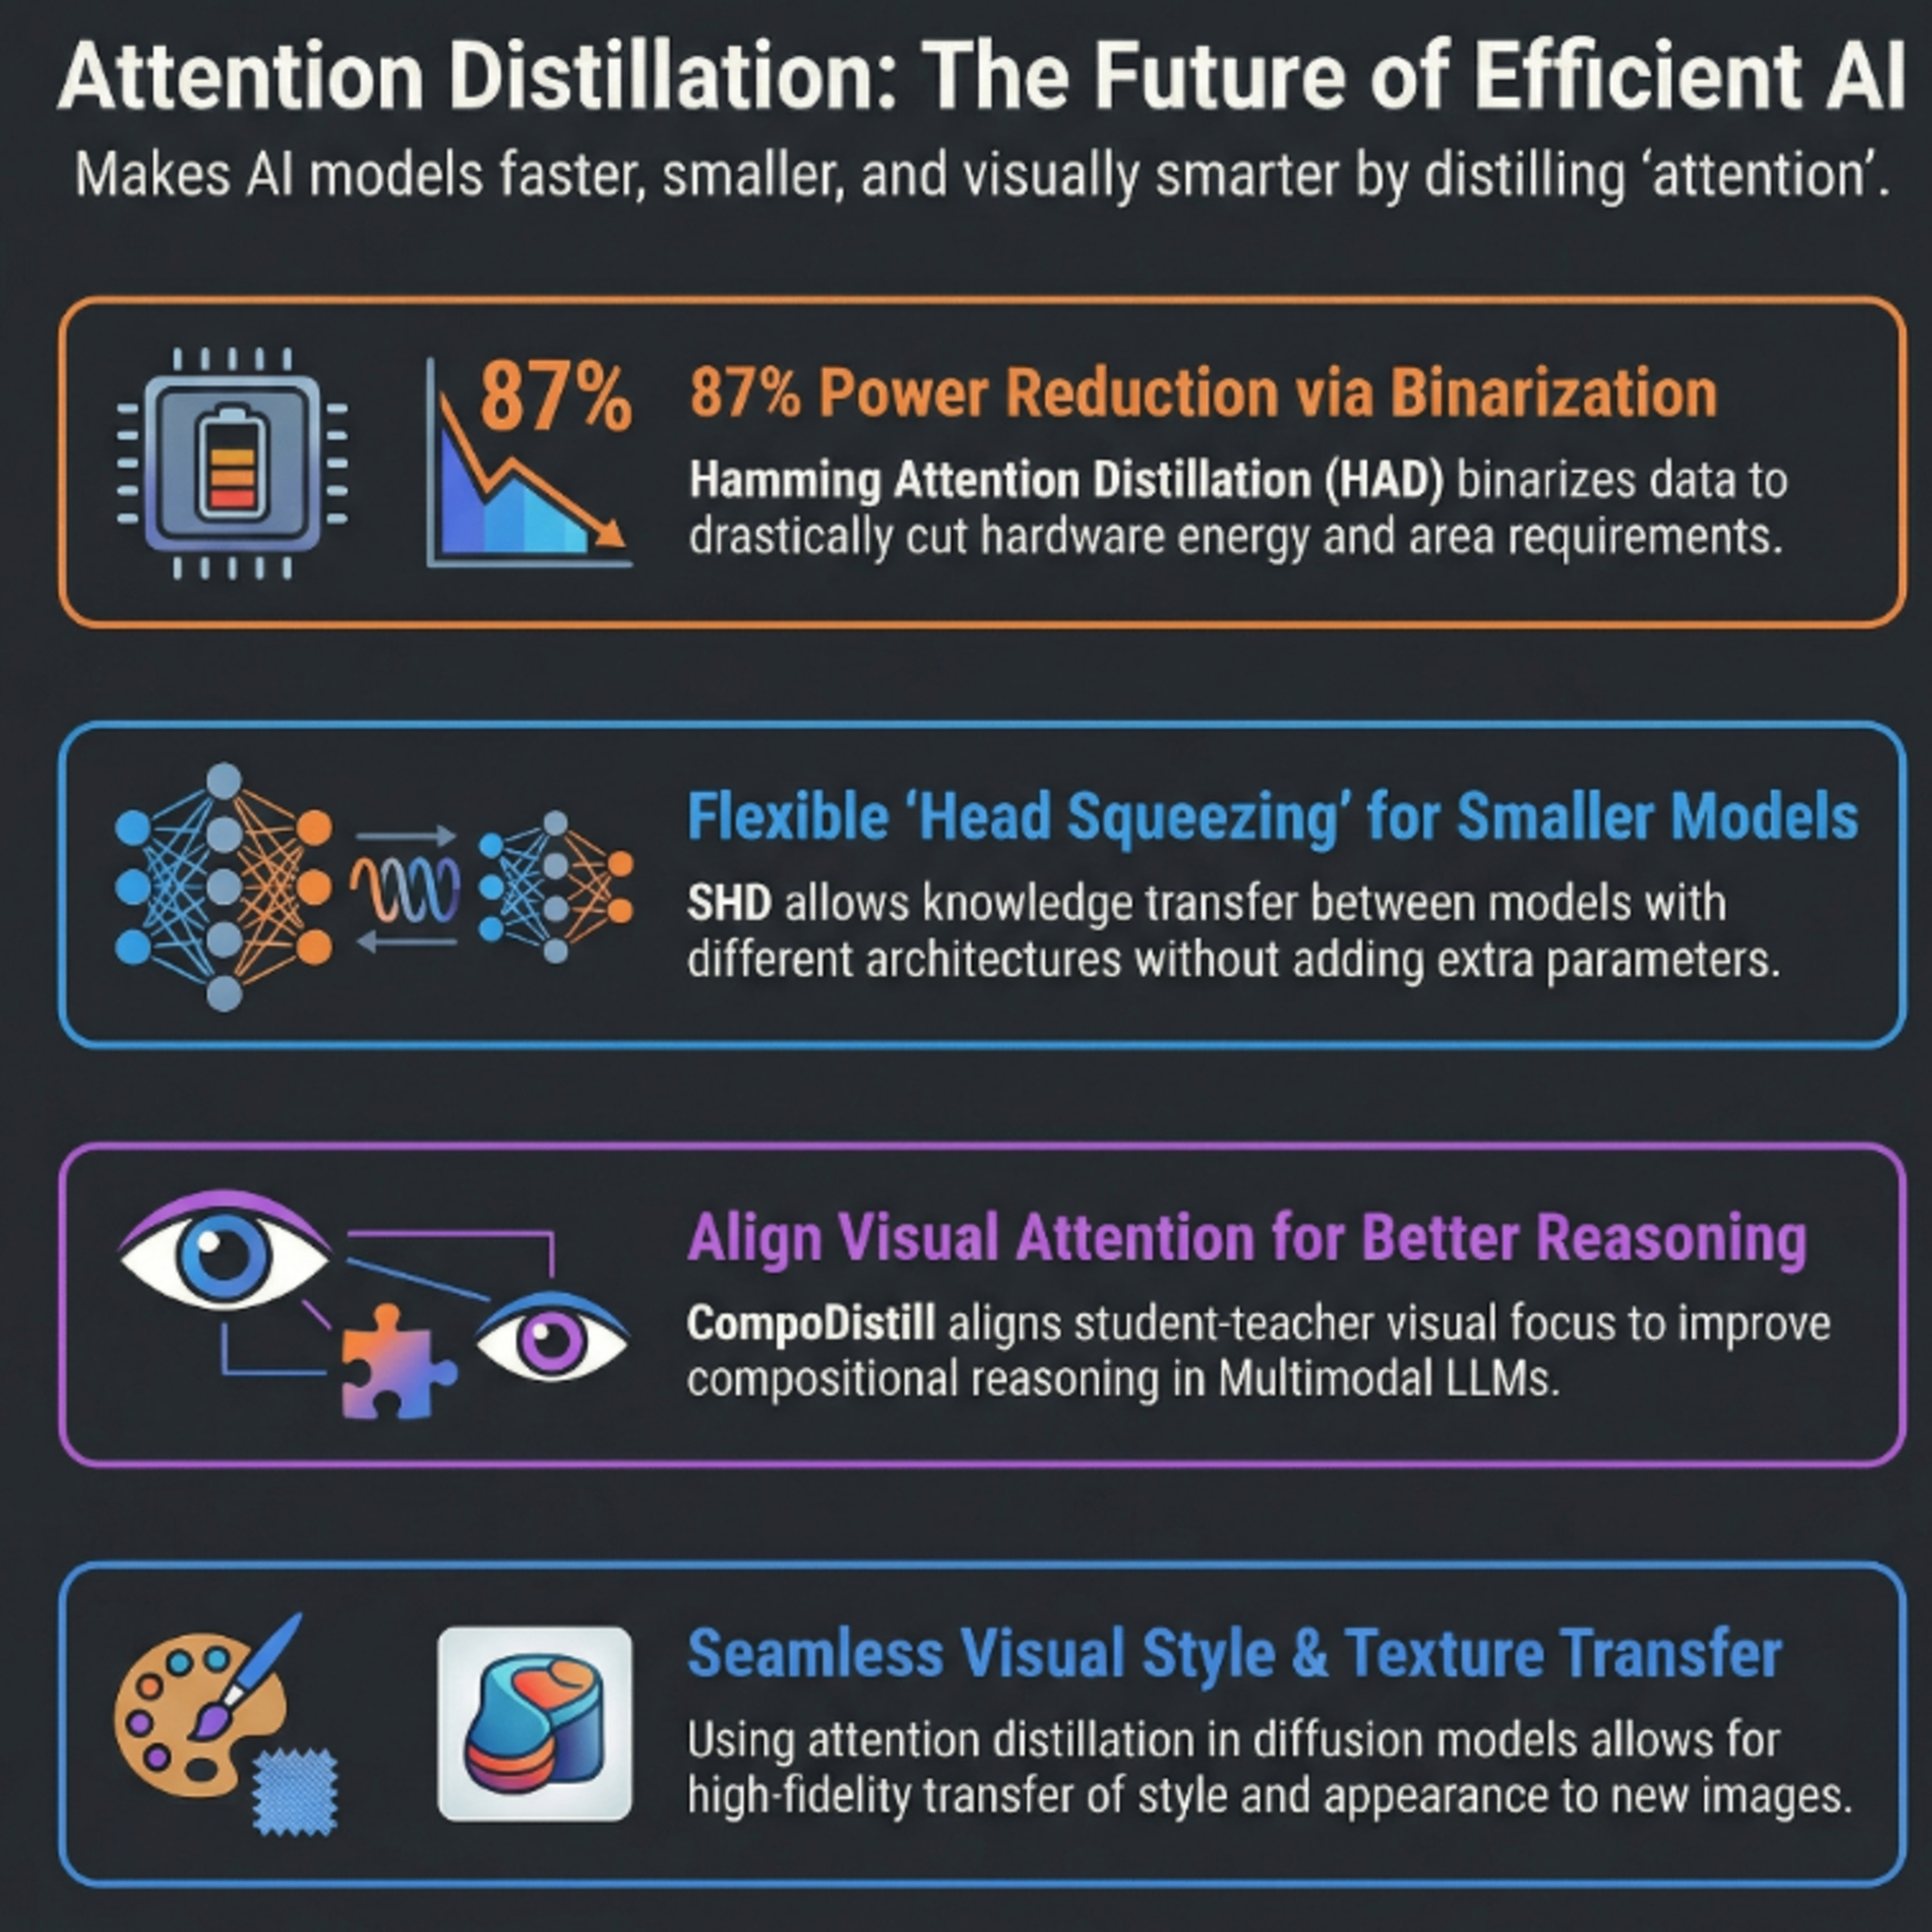
Advances in Attention Distillation for Efficient Transformer Models ...
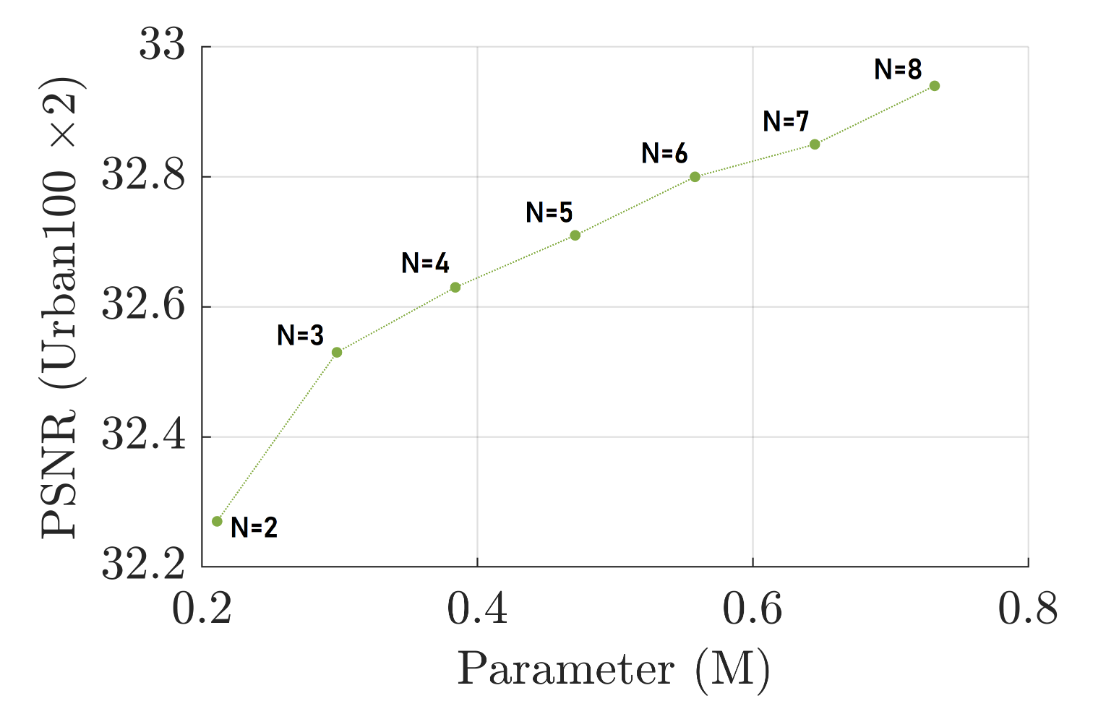
Efficient Attention-Sharing Information Distillation Transformer for ...
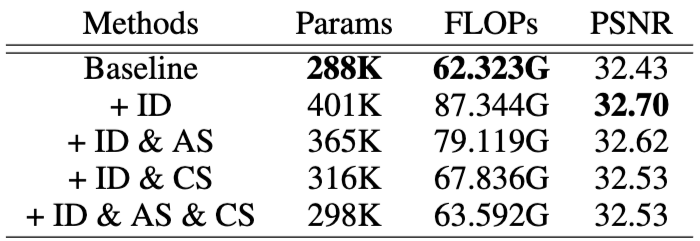
Efficient Attention-Sharing Information Distillation Transformer for ...
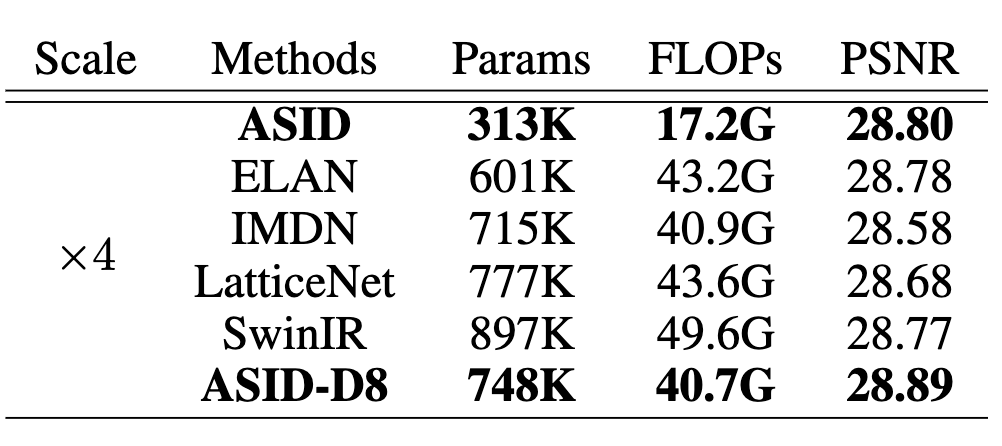
Efficient Attention-Sharing Information Distillation Transformer for ...
How to Implement Attention Distillation for Transformer Models ...

Attention Network with Information Distillation for Super-Resolution
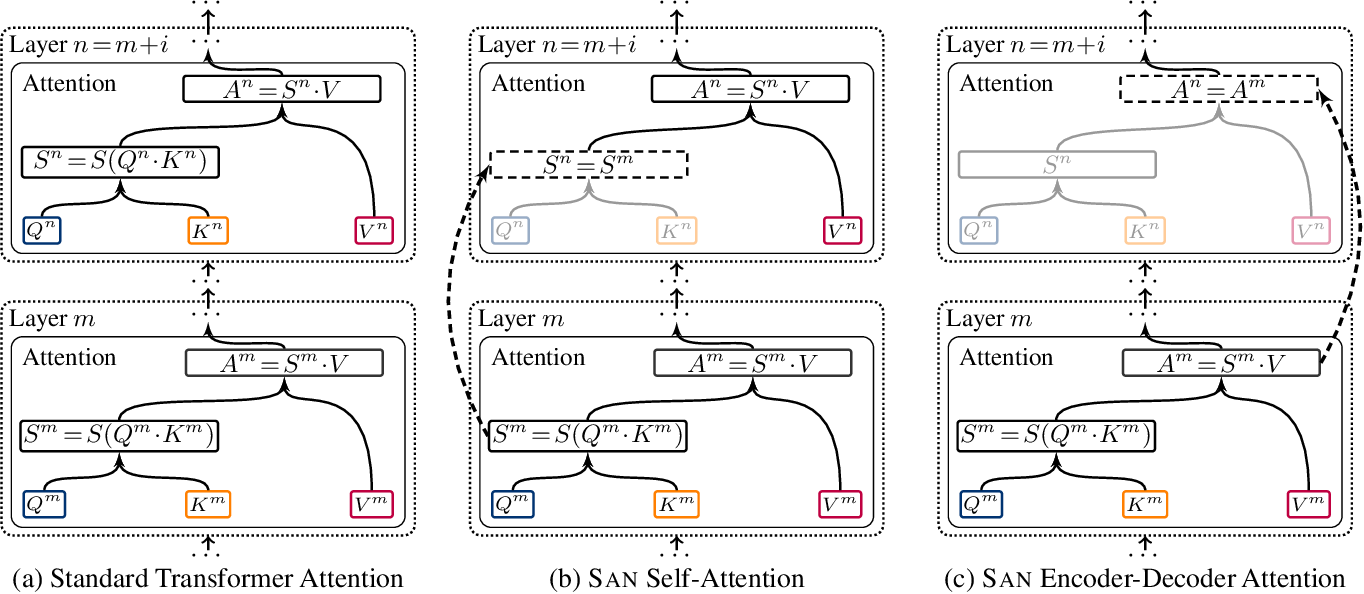
Figure 3 from Sharing Attention Weights for Fast Transformer | Semantic ...

[2501.15774] Efficient Attention-Sharing Information Distillation ...
Advertisement Space (300x250)

[논문 리뷰] Efficient Attention-Sharing Information Distillation ...

[2501.15774] Efficient Attention-Sharing Information Distillation ...

Attention Transfer: A Novel Machine Learning Approach for Efficient ...

Loop and distillation: Attention weights fusion transformer for fine ...

Figure 1 from Abstracting Local Transformer Attention for Enhancing ...

Loop and distillation: Attention weights fusion transformer for fine ...

Knowledge Distillation for Efficient Transformer-Based Reinforcement ...
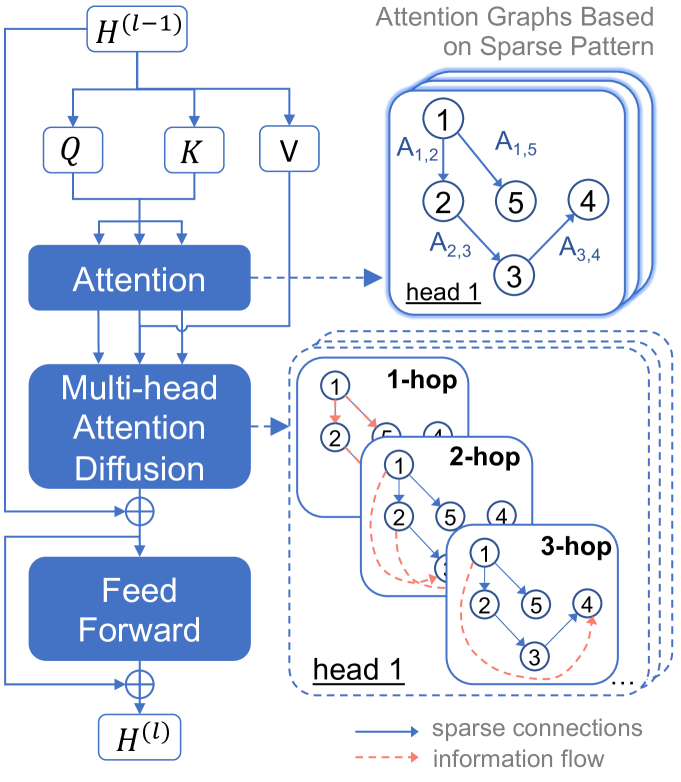
[2210.11794] Diffuser: Efficient Transformers with Multi-hop Attention ...
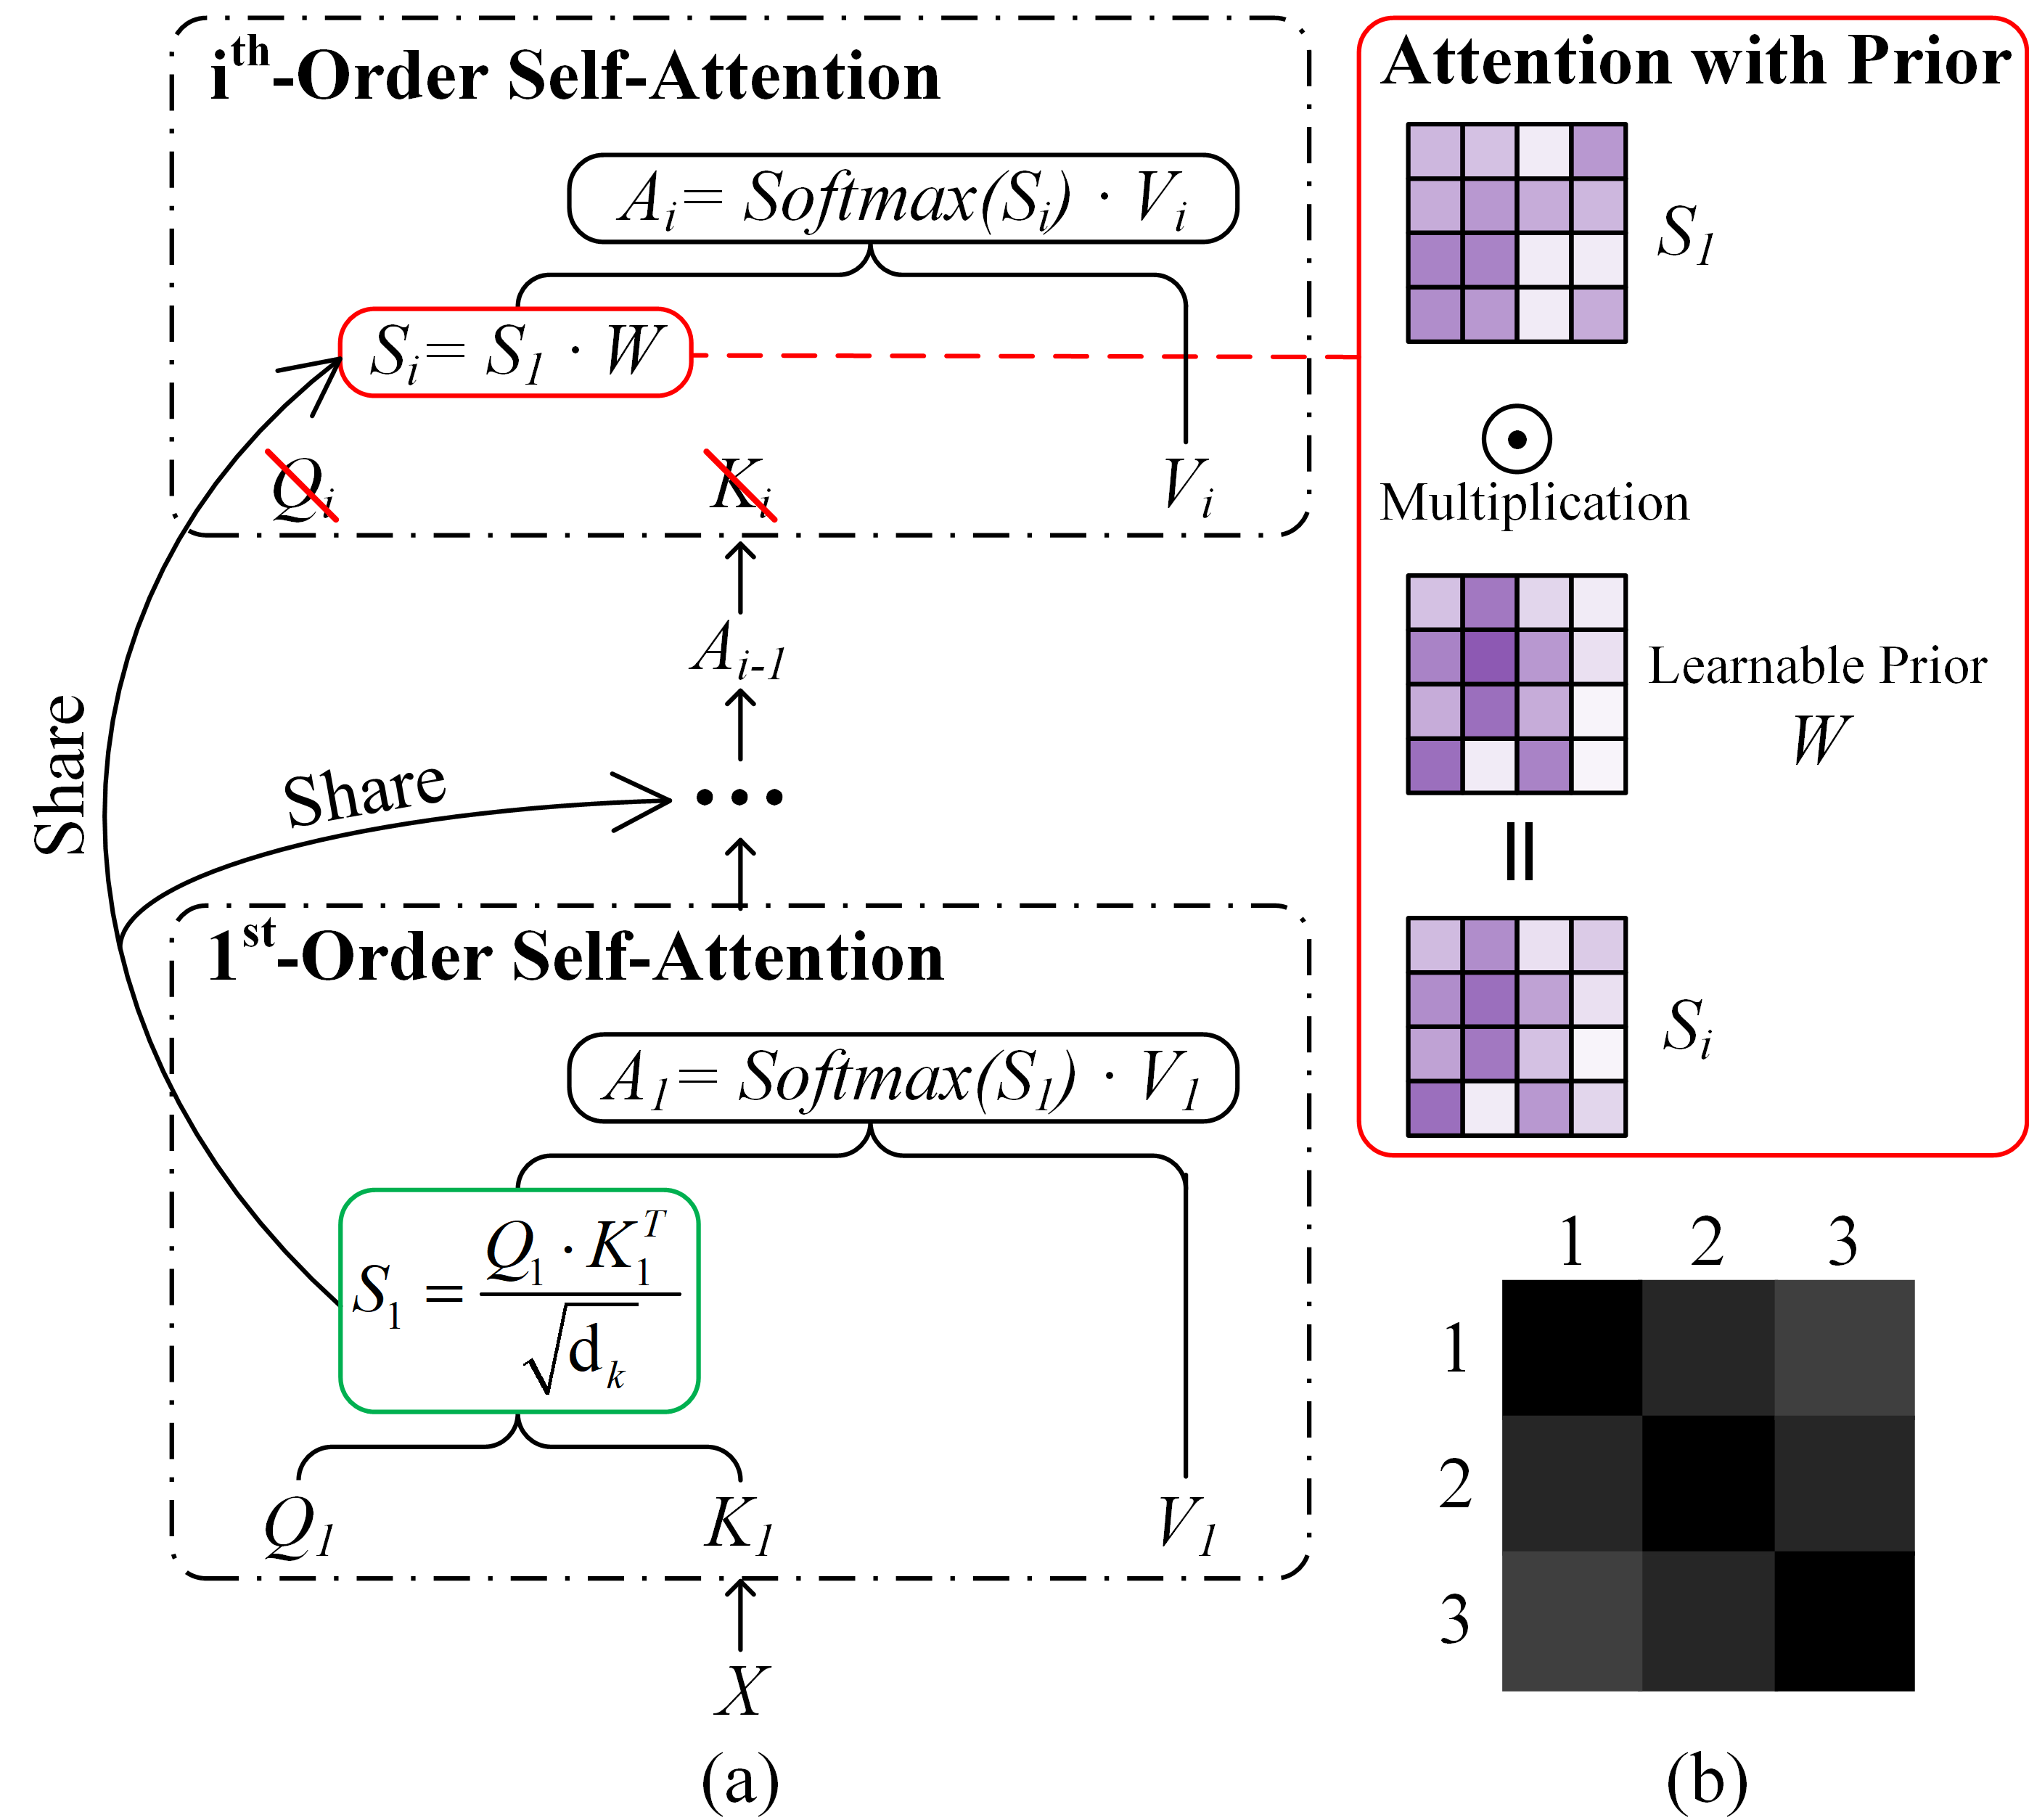
[2109.11159] OH-Former: Omni-Relational High-Order Transformer for ...
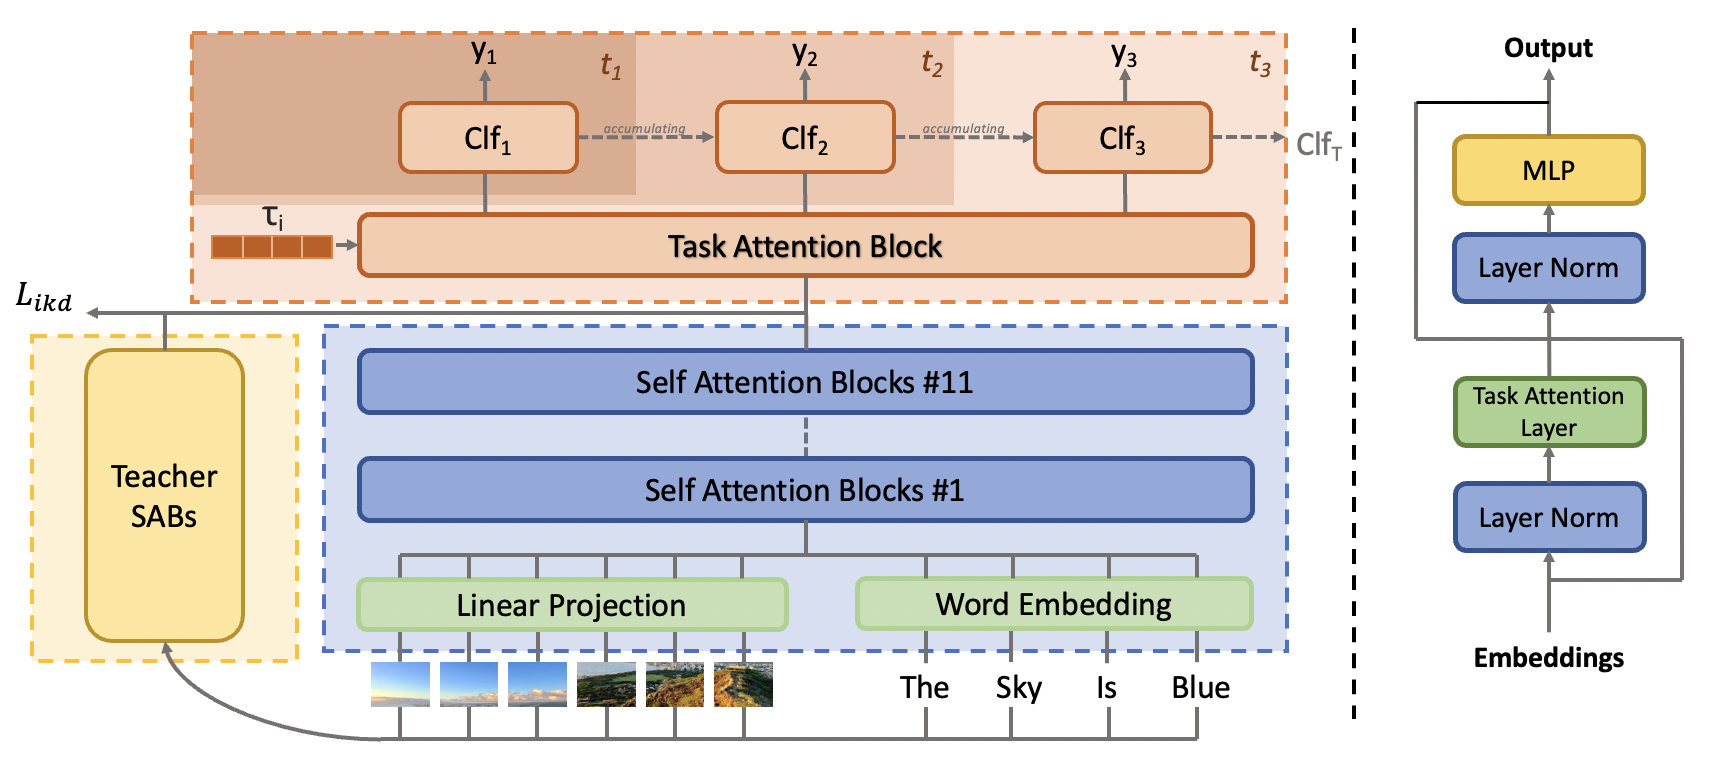
[2303.14423] Task-Attentive Transformer Architecture for Continual ...
Advertisement Space (336x280)
Learning Efficient Linear Graph Transformer via Graph-attention ...

Transformer Model Fig. 2: Attention mechanism (a) shows complete ...

Patterns and Messages: A New Framing of Transformer Attention · Chris ...
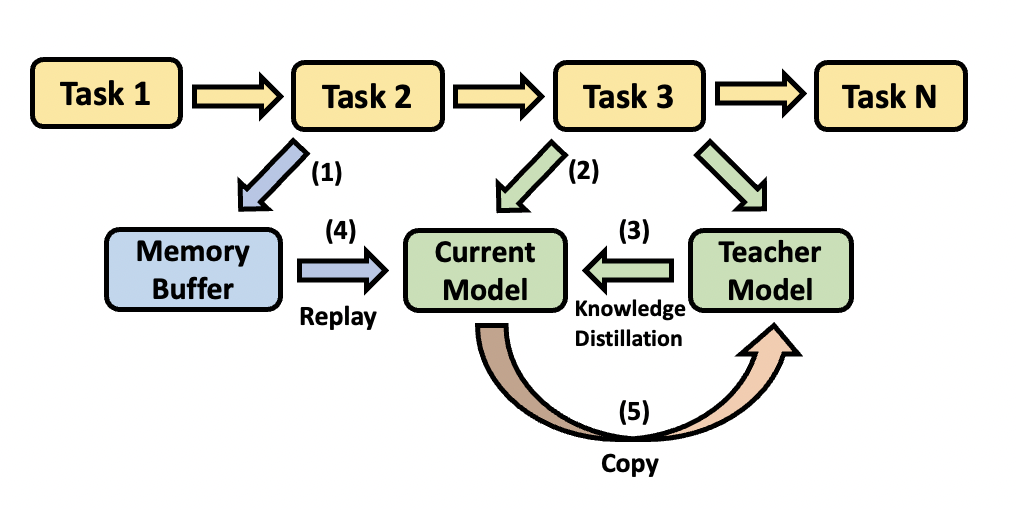
[2303.14423] Task-Attentive Transformer Architecture for Continual ...
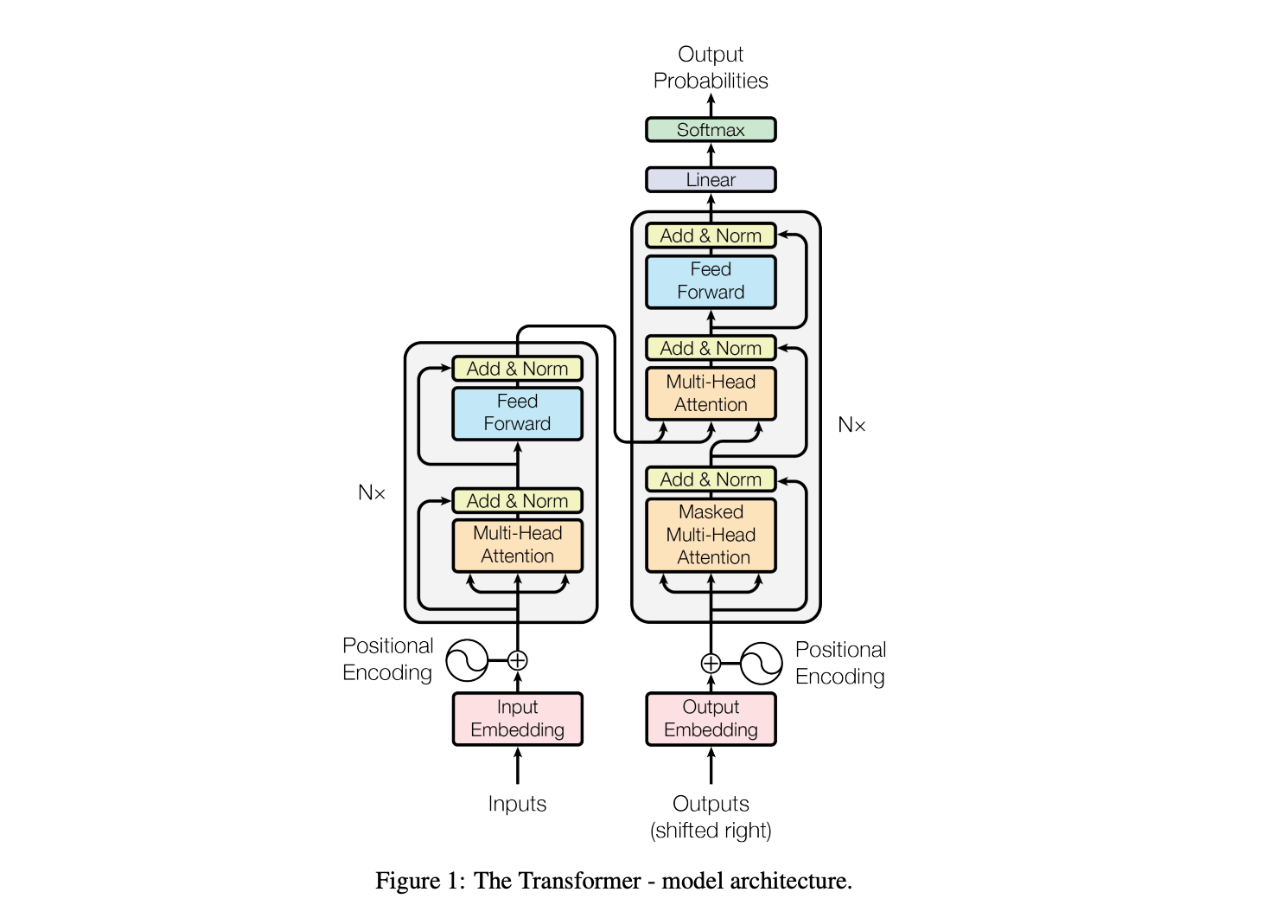
[basic] Attention and Transformer
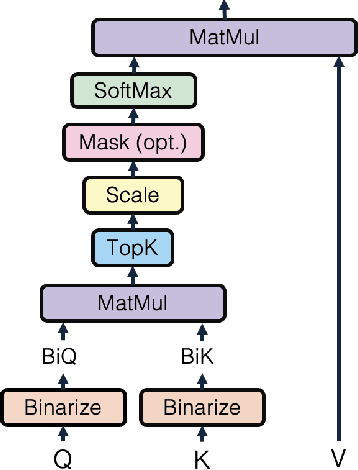
Hamming Attention Distillation: Binarizing Keys and Queries for ...

Hierarchical Multi-Attention Transfer for Knowledge Distillation | ACM ...
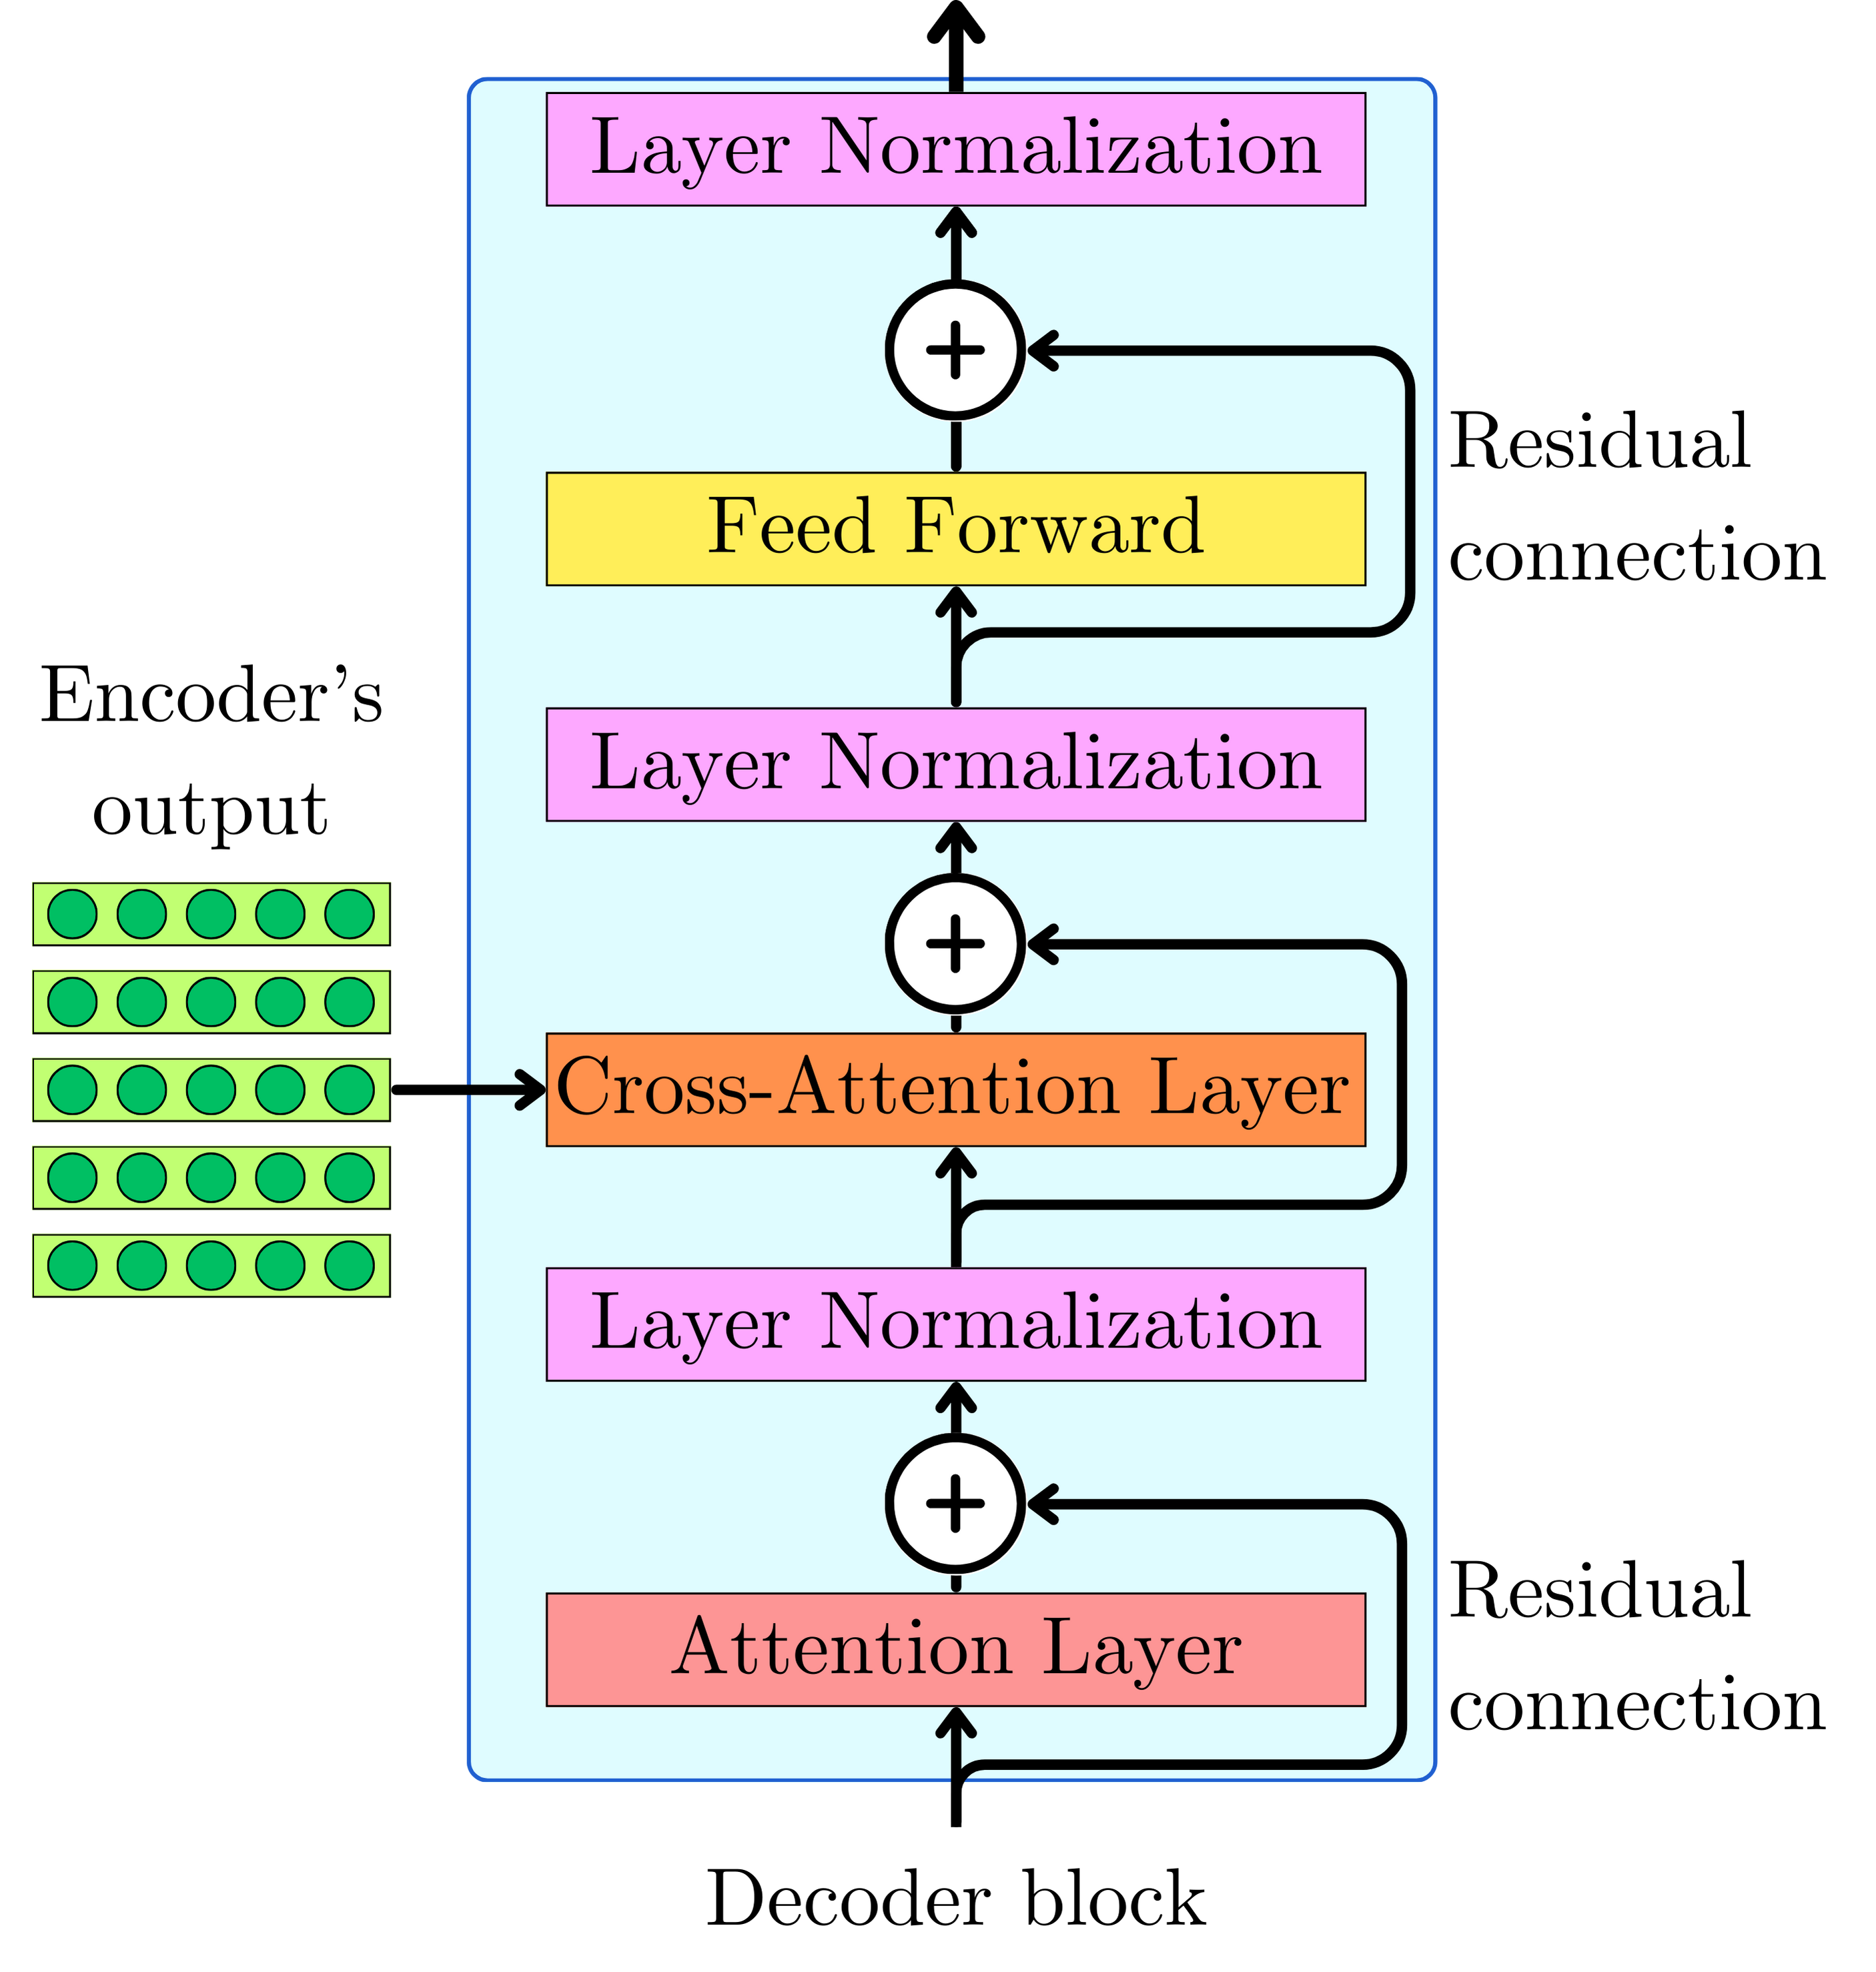
Attention Is All You Need: The Original Transformer Architecture

Attention is all you need - Transformer

【蜻蜓点论文】Training data efficient image transformers & distillation ...
Advertisement Space (336x280)
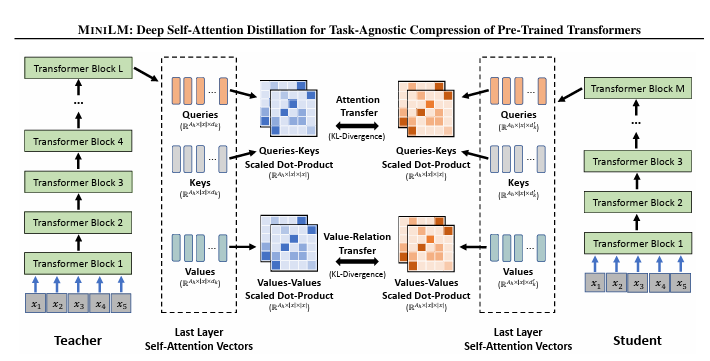
[논문리뷰] Deep Self-Attention Distillation for Task-Agnostic Compression ...
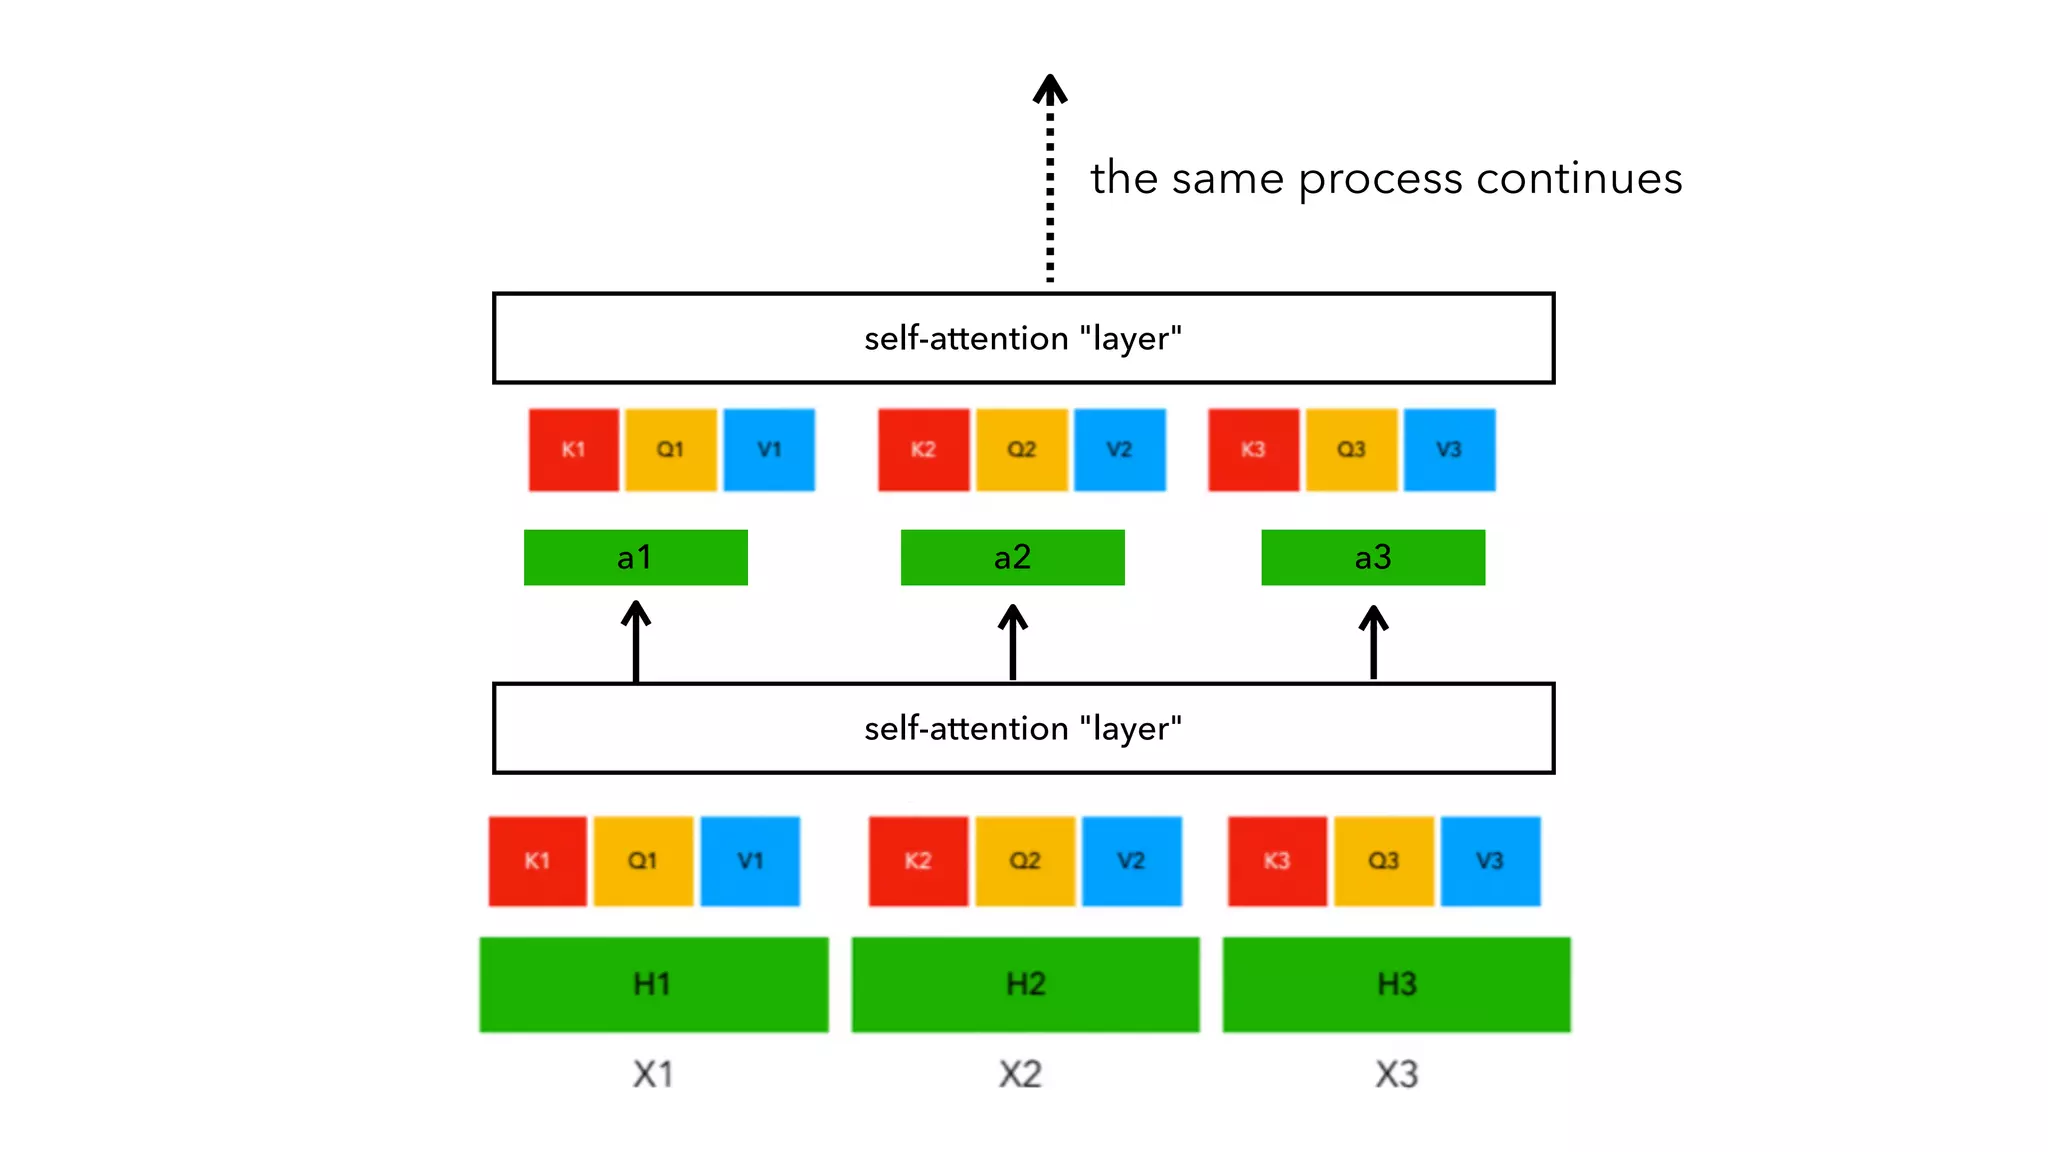
A Multiscale Visualization of Attention in the Transformer Model | PPT
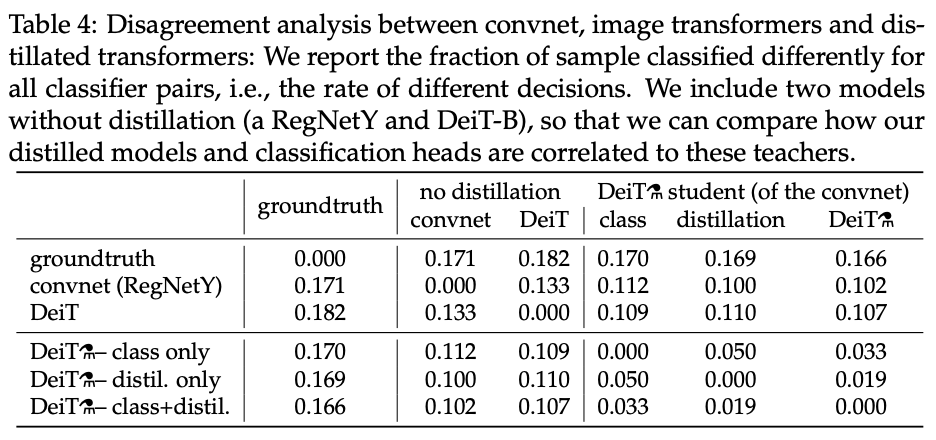
Training data-efficient image transformers & distillation through attention

Hierarchical and Step-Layer-Wise Tuning of Attention Specialty for ...

Figure 1 from From Multimodal to Unimodal Attention in Transformers ...
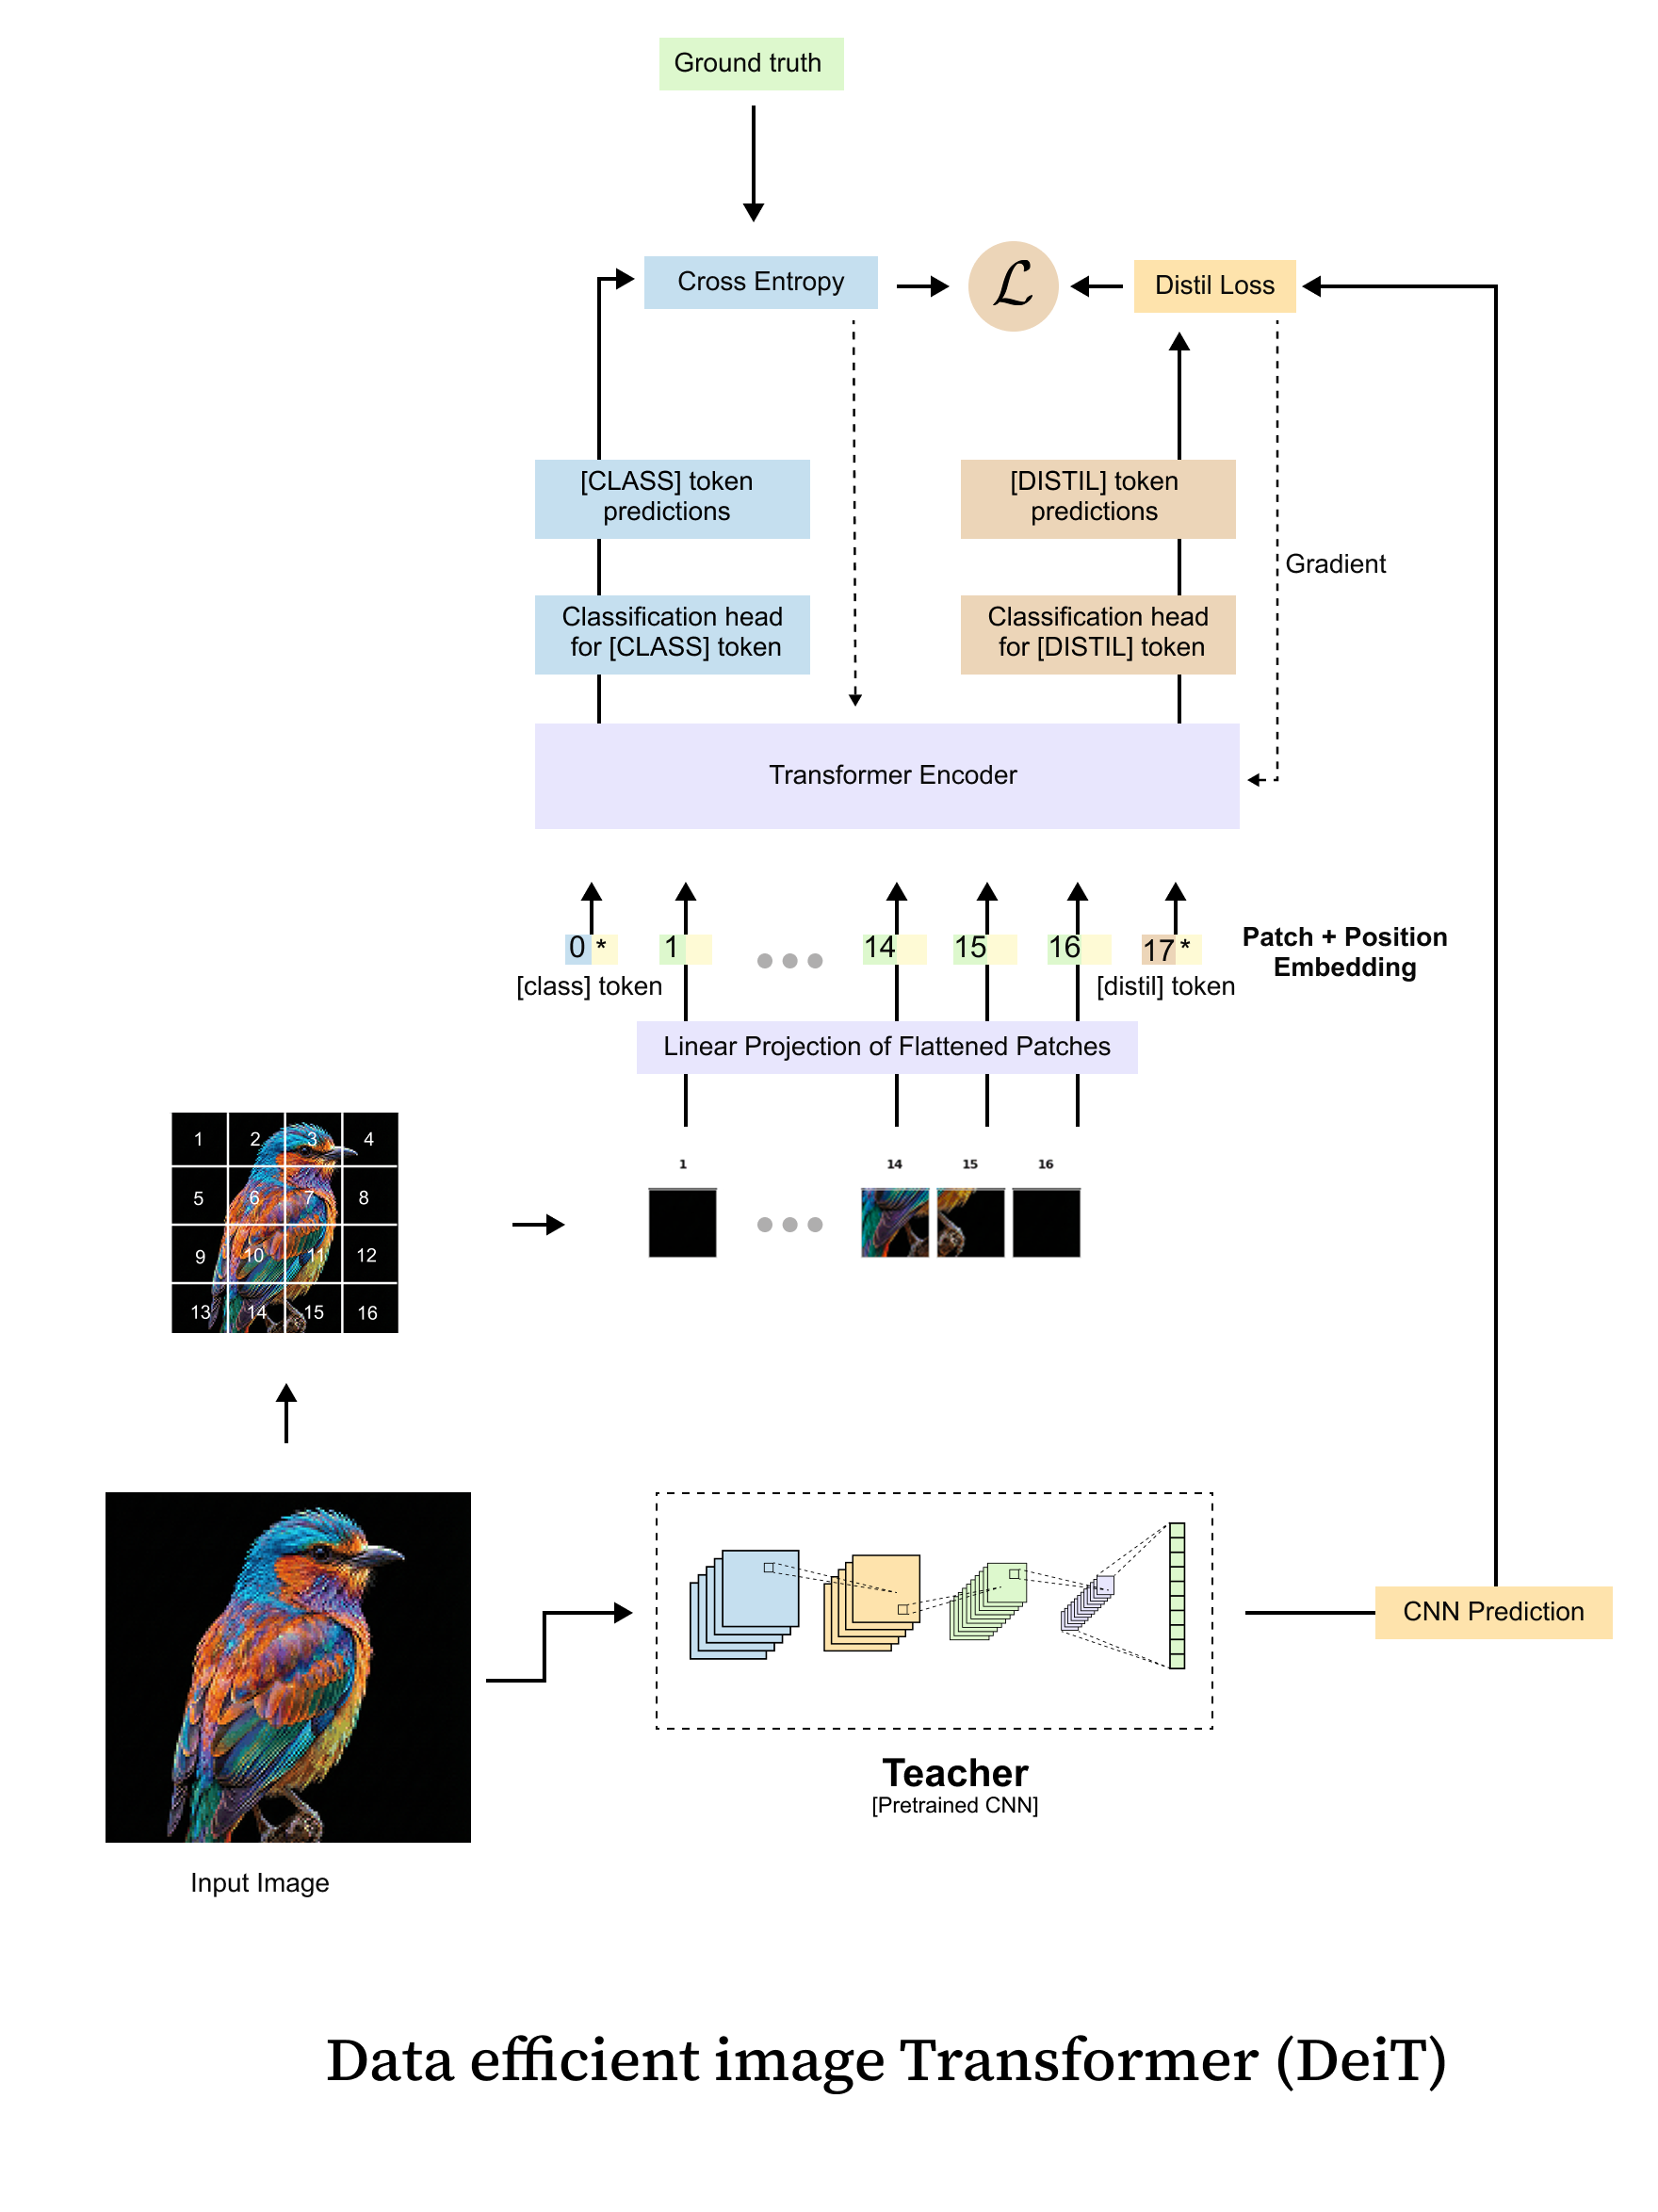
Knowledge Distillation & Data-Efficient Image Transformers