
Figure 1 From Arkvale Efficient Generative Llm Inference With
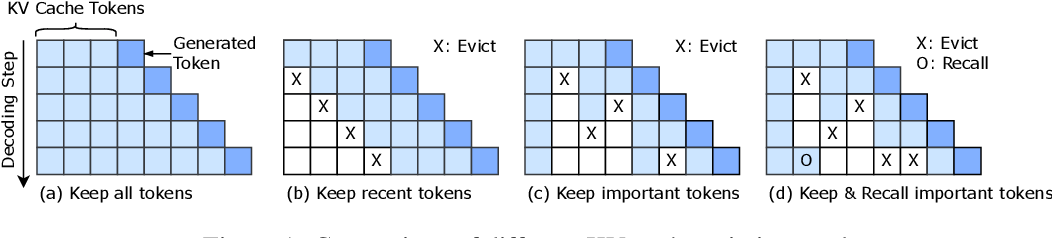
Figure 1 from ArkVale: Efficient Generative LLM Inference with ...
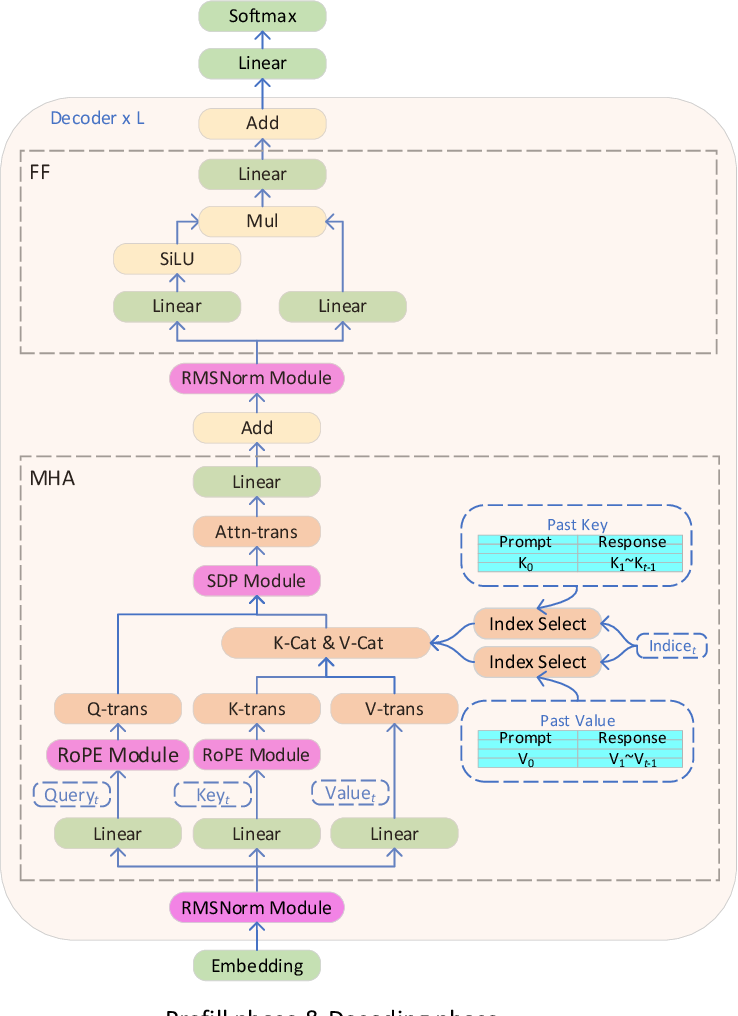
Figure 1 from Efficient LLM inference solution on Intel GPU | Semantic ...
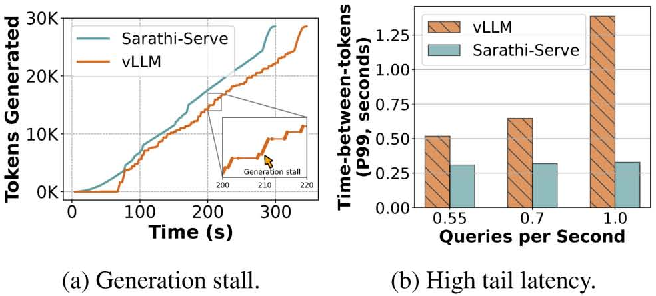
Figure 1 from Efficient LLM Inference via Chunked Prefills | Semantic ...

NeurIPS Poster ArkVale: Efficient Generative LLM Inference with ...

AsyncTLS: Efficient Generative LLM Inference with Asynchronous Two ...

ArkVale: Efficient Generative LLM Inference with Recallable Key-Value ...
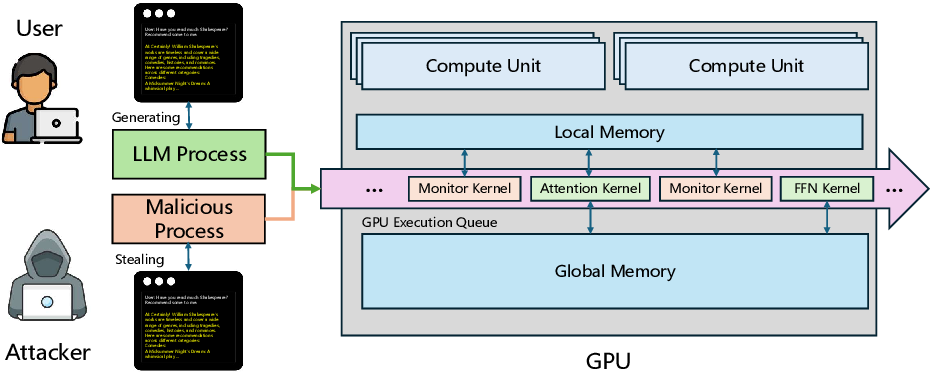
Figure 1 from A First Look At Efficient And Secure On-Device LLM ...

Figure 3 from Efficient LLM inference solution on Intel GPU | Semantic ...

AsyncTLS: Efficient Generative LLM Inference with Asynchronous Two ...

Figure 1 from Efficient Inference for Large Language Model-based ...
Advertisement Space (300x250)
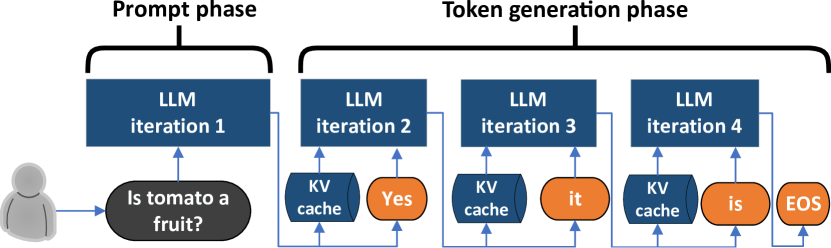
[2311.18677] Splitwise: Efficient Generative LLM Inference Using Phase ...
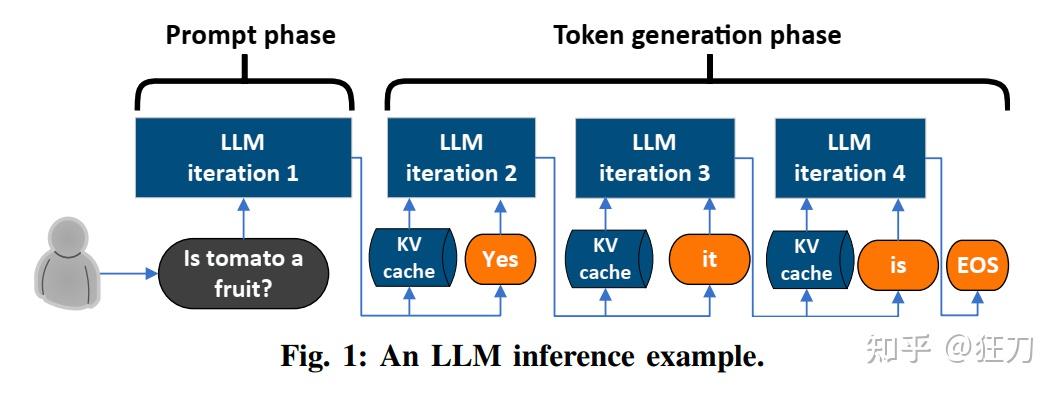
Splitwise: Efficient Generative LLM Inference Using Phase Splitting - 知乎

[PDF] Splitwise: Efficient Generative LLM Inference Using Phase ...
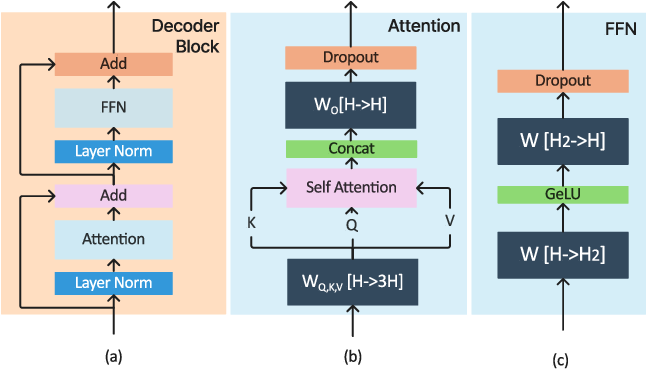
SARATHI: Efficient LLM Inference by Piggybacking Decodes with Chunked ...
Splitwise: Efficient Generative LLM Inference Using Phase Splitting

[PDF] Splitwise: Efficient Generative LLM Inference Using Phase ...
GitHub - pku-liang/ArkVale: ArkVale: Efficient Generative LLM Inference ...

InfiniGen: Efficient Generative Inference of Large Language Models with ...

Paper page - Splitwise: Efficient generative LLM inference using phase ...
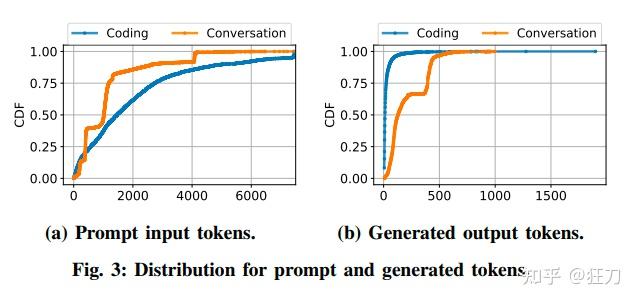
Splitwise: Efficient Generative LLM Inference Using Phase Splitting - 知乎
Advertisement Space (336x280)

Splitwise: Efficient Generative LLM Inference Using Phase Splitting - 知乎

Splitwise: Efficient Generative LLM Inference Using Phase Splitting - 知乎

Splitwise: Efficient Generative LLM Inference Using Phase Splitting - 知乎

[논문 리뷰] Efficient LLM Inference with Activation Checkpointing and ...

Splitwise: Efficient generative LLM inference using phase splitting ...
Efficient LLM Inference and Serving with vLLM

Splitwise: Efficient Generative LLM Inference Using Phase Splitting - 知乎

Splitwise: Efficient Generative LLM Inference Using Phase Splitting - 知乎

Paper page - Efficient LLM Inference with Kcache

[2503.10325] Collaborative Speculative Inference for Efficient LLM ...
Advertisement Space (336x280)

Figure 1 from Flash-LLM: Enabling Low-Cost and Highly-Efficient Large ...

Star Attention: Efficient LLM Inference over Long Sequences | AI ...

[论文评述] EARN: Efficient Inference Acceleration for LLM-based Generative ...

Collaborative Speculative Inference for Efficient LLM Inference Serving ...

LLM Inference Acceleration via Efficient Operation Fusion

(PDF) eFedLLM: Efficient LLM Inference Based on Federated Learning