
Figure 1 From Bio Inspired Modality Fusion For Active Speaker Detection
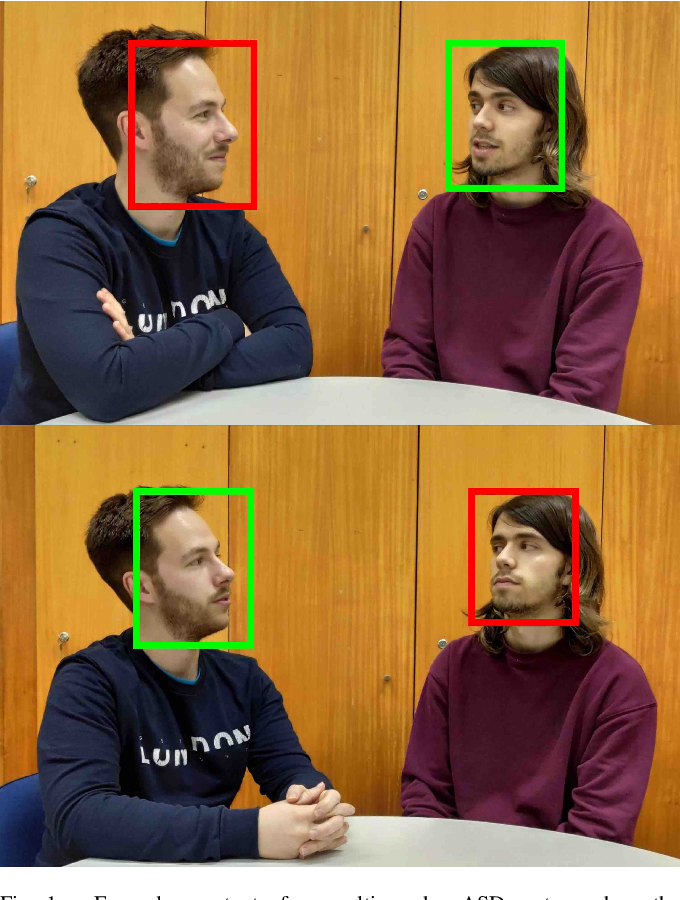
Figure 1 from Bio-Inspired Modality Fusion for Active Speaker Detection ...

Bio-Inspired Modality Fusion for Active Speaker Detection
Bio-Inspired Modality Fusion for Active Speaker Detection | DeepAI

Bio-Inspired Modality Fusion for Active Speaker Detection
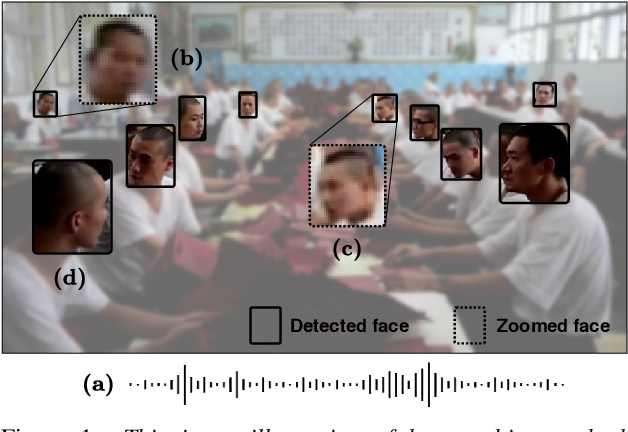
Figure 1 from Active Speaker Detection as a Multi-Objective ...
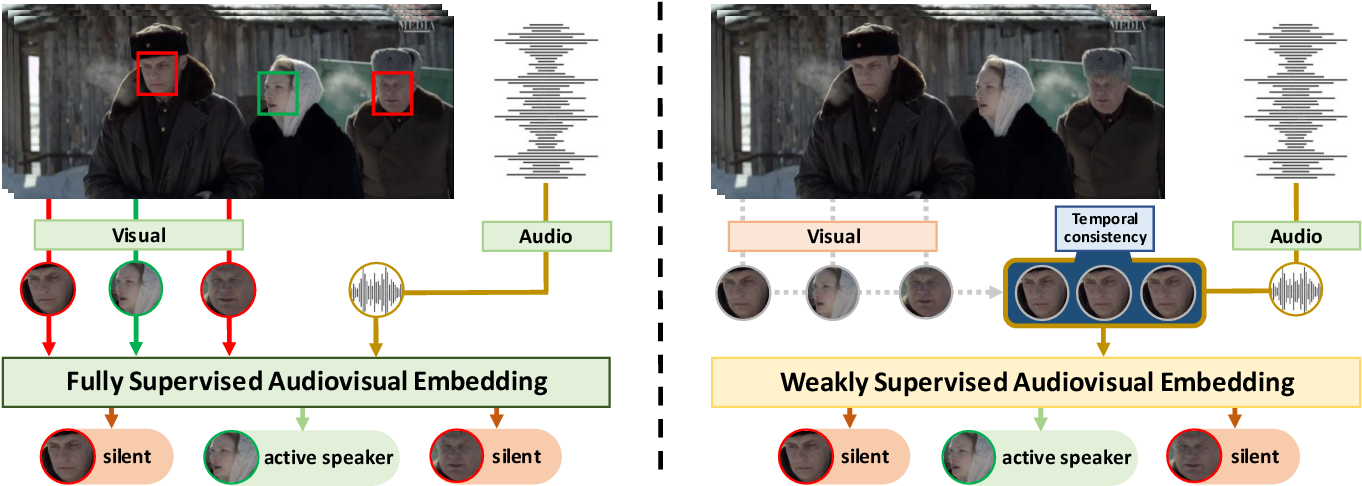
Figure 1 from End-to-End Active Speaker Detection | Semantic Scholar
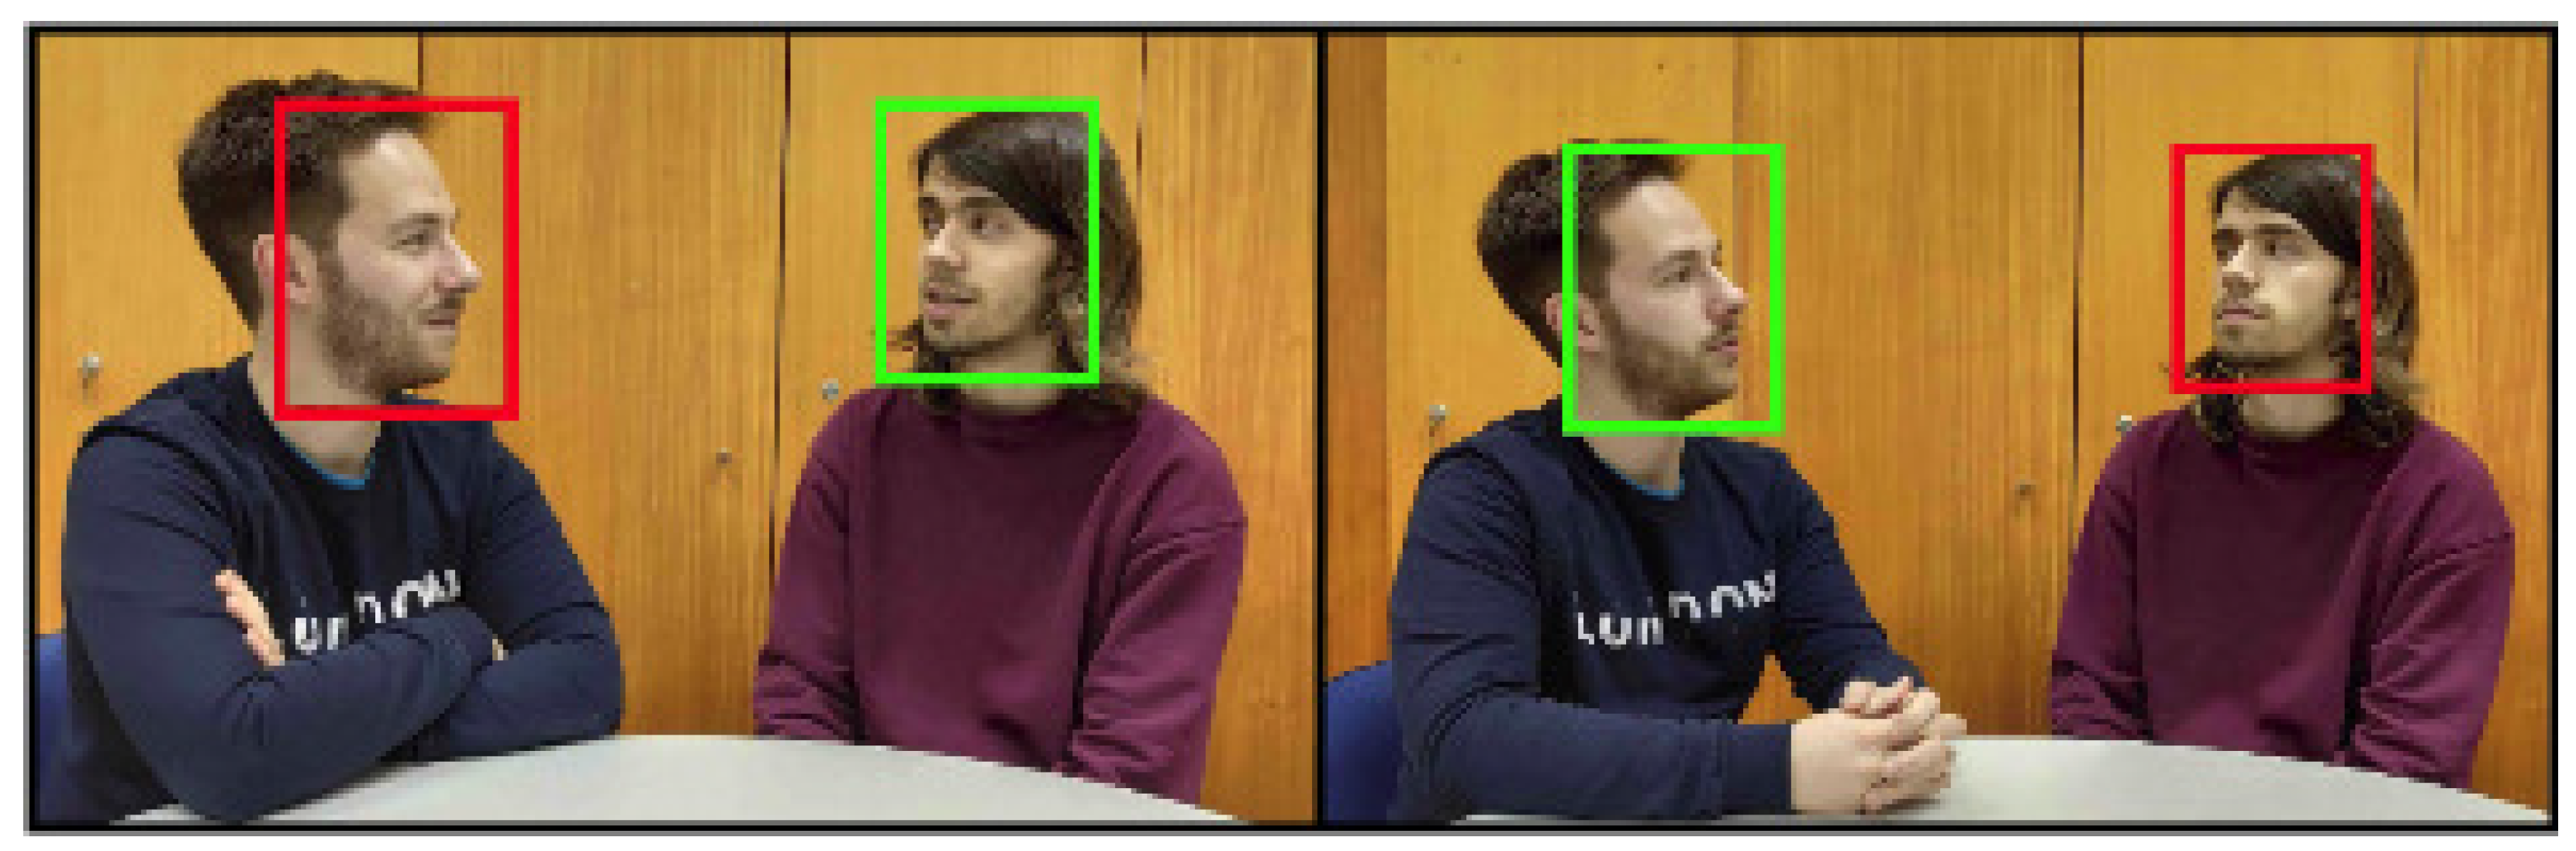
Bio-Inspired Modality Fusion for Active Speaker Detection

Figure 1 from Target Active Speaker Detection with Audio-visual Cues ...

Figure 1 from Multimodal active speaker detection using cross-attention ...

Figure 1 from Multimodal Attention Fusion for Target Speaker Extraction ...
Advertisement Space (300x250)
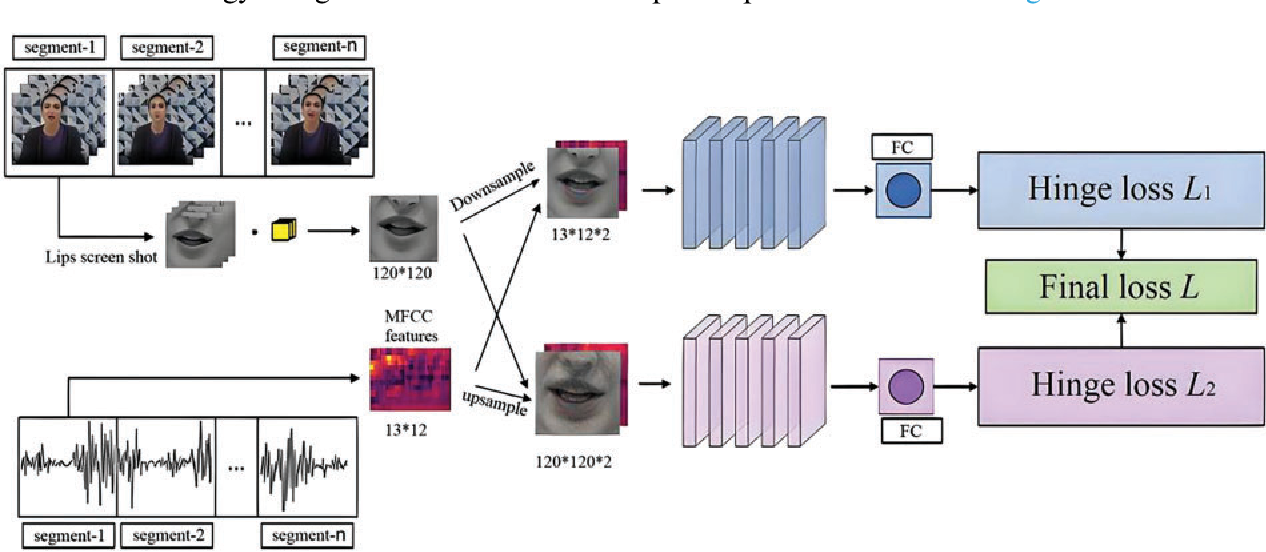
Figure 1 from Lip-Audio Modality Fusion for Deep Forgery Video ...
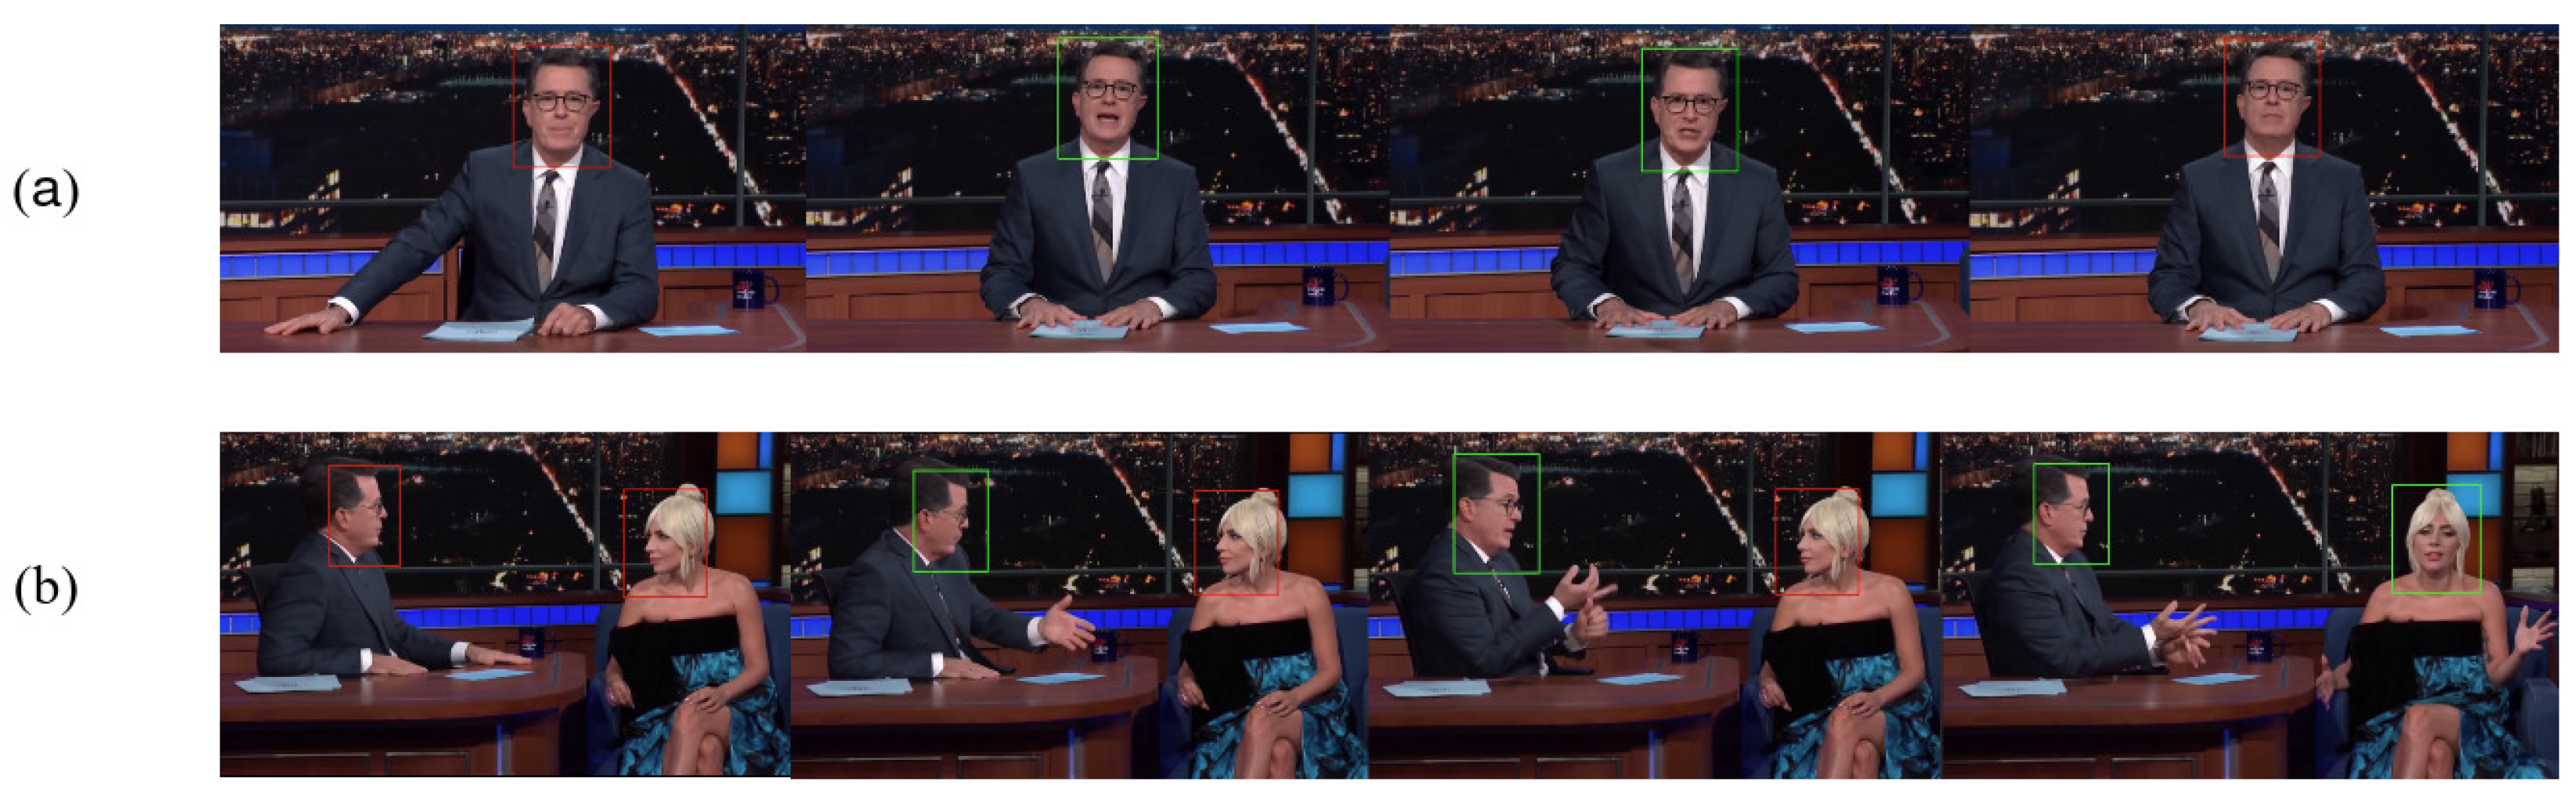
Bio-Inspired Modality Fusion for Active Speaker Detection
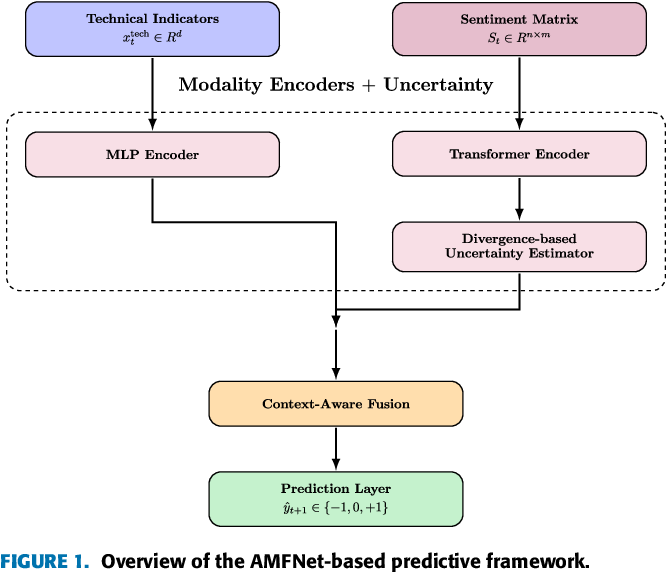
Figure 1 from An Adaptive Modality Fusion Network for Stock Trend ...
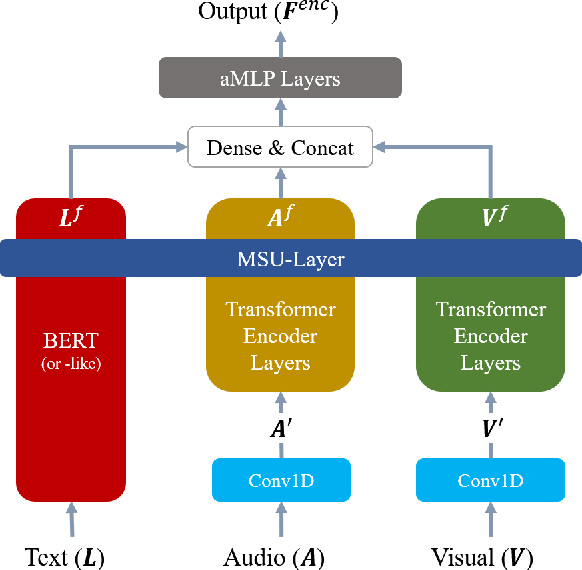
Figure 1 from Word-Aware Modality Stimulation for Multimodal Fusion ...
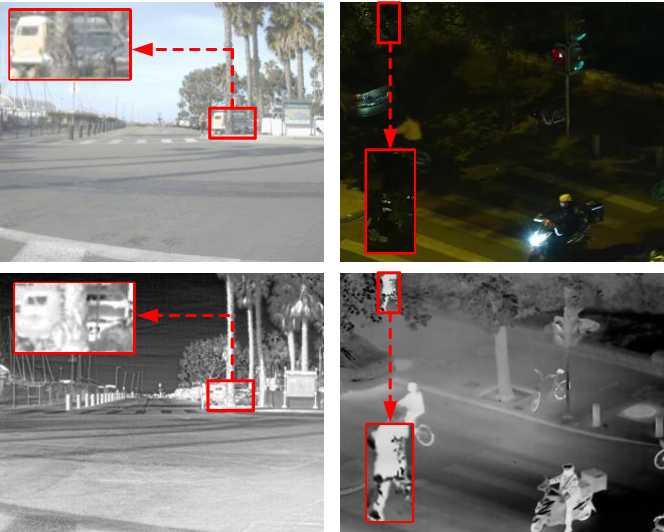
Figure 1 from Difference-Guided Modality Fusion Network for Multimodal ...

Figure 1 from Real-time Architecture for Audio-Visual Active Speaker ...

Figure 1 from Active Speaker Recognition using Cross Attention Audio ...

Figure 1 from Target Speaker Voice Activity Detection with Transformers ...

Figure 4 from Enhancing Real-World Active Speaker Detection with Multi ...
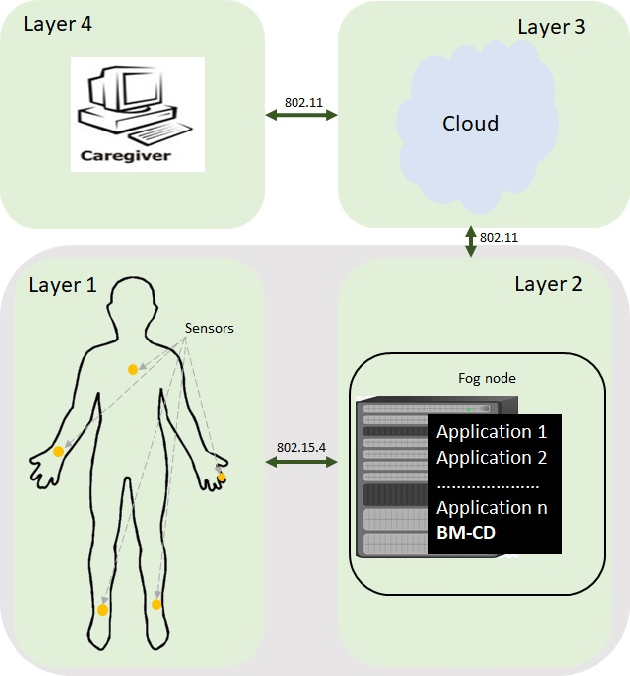
Figure 1 from Binarized Multi-Factor Cognitive Detection of Bio ...
Advertisement Space (336x280)

Figure 1 from Fusional Modality and Distribution Alignment Learning for ...

Figure 1 from Cross-Modality Attentive Feature Fusion for Object ...

Figure 1 from Cross-Modality Fusion Transformer for Multispectral ...

Figure 1 from Attention-based Audio-Visual Fusion for Robust Automatic ...
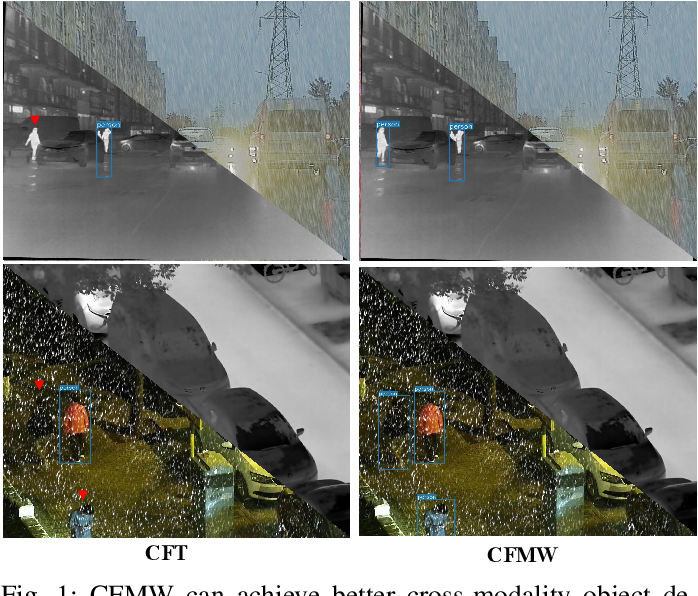
Figure 1 from CFMW: Cross-modality Fusion Mamba for Robust Object ...

Figure 1 from Cross-Modality Attentive Feature Fusion for Object ...

Figure 1 from Cross-modal mask fusion and modality-balanced audio ...
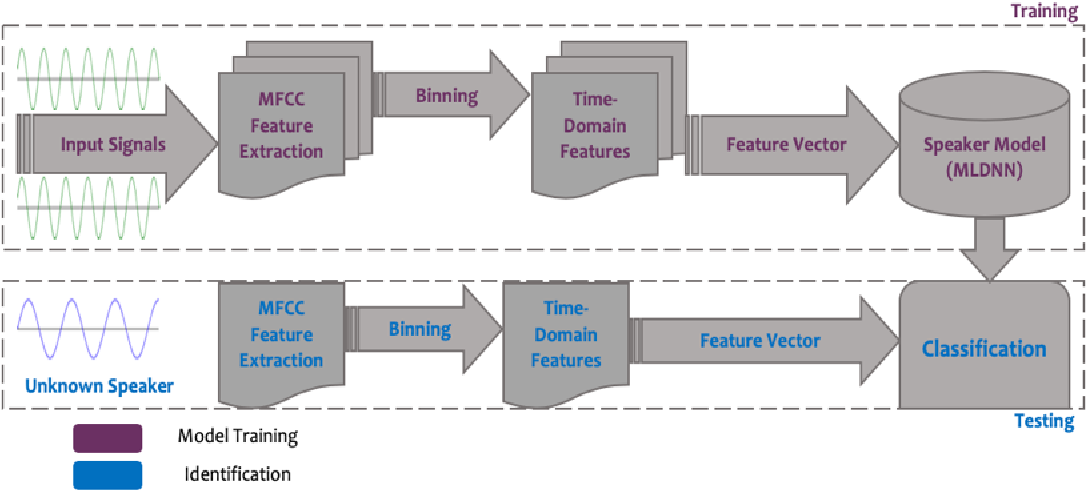
Figure 1 from Text-Independent Speaker Identification Through Feature ...
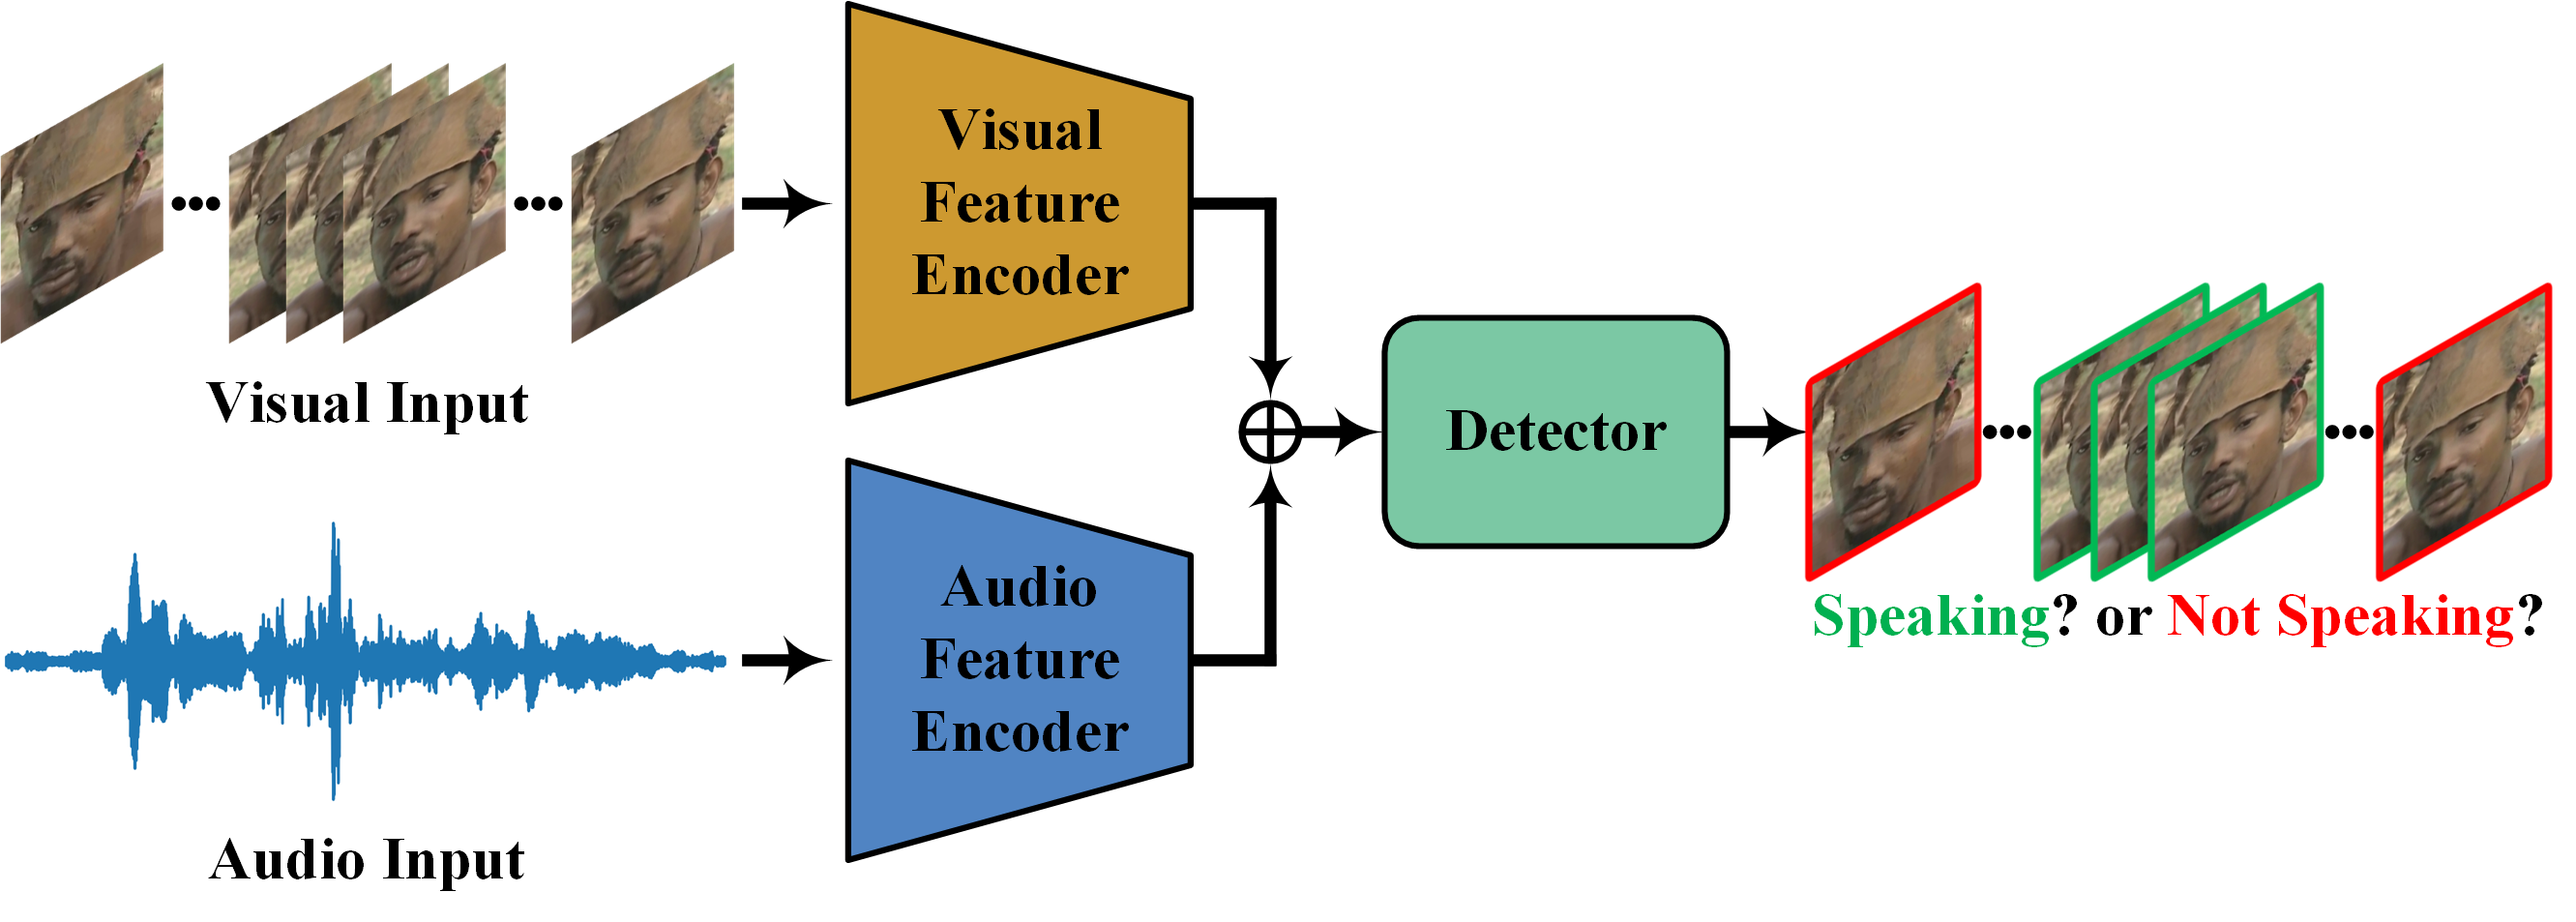
[2303.04439] A Light Weight Model for Active Speaker Detection
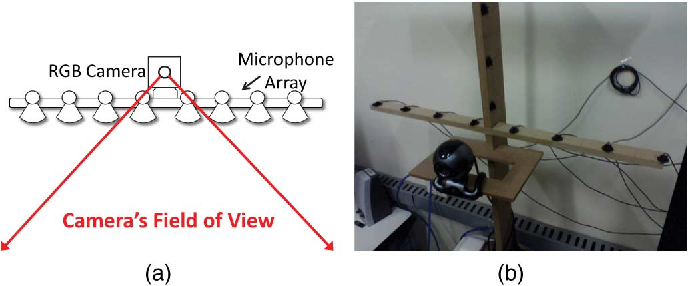
Figure 1 from Simultaneous-Speaker Voice Activity Detection and ...
Advertisement Space (336x280)

Figure 1 from MIS-AVoiDD: Modality Invariant and Specific ...
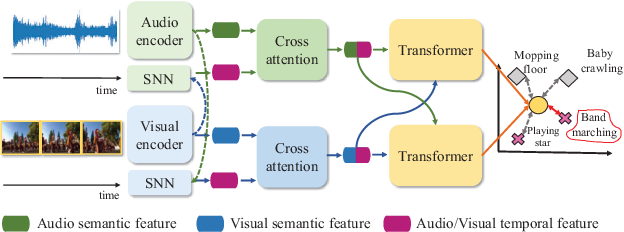
Figure 1 from Modality-Fusion Spiking Transformer Network for Audio ...

Figure 1 from Multi-modal Brain Tumor Segmentation via Missing Modality ...
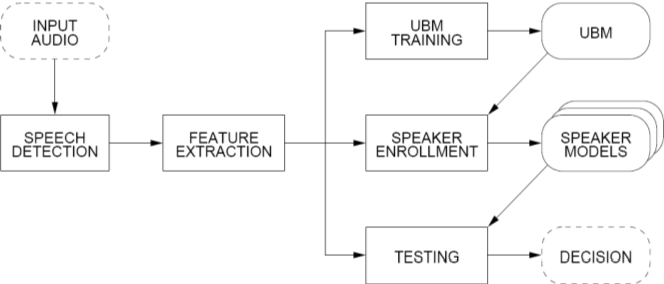
Figure 1 from Speaker de-identification via voice transformation ...

Figure 1 from Illumination-Guided RGBT Object Detection With Inter- and ...

Figure 3 from Modality Prompts for Arbitrary Modality Salient Object ...