
Figure 1 From Copr Continual Human Preference Learning Via Optimal
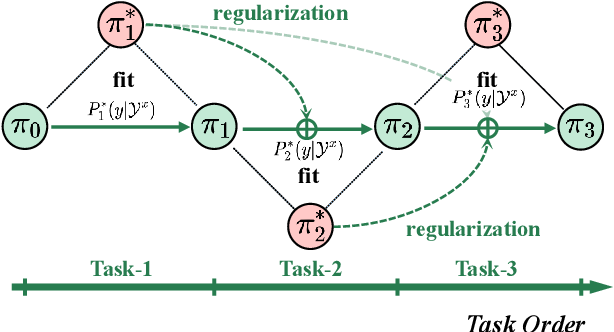
Figure 1 from COPR: Continual Human Preference Learning via Optimal ...

Figure 1 from COPR: Continual Human Preference Learning via Optimal ...
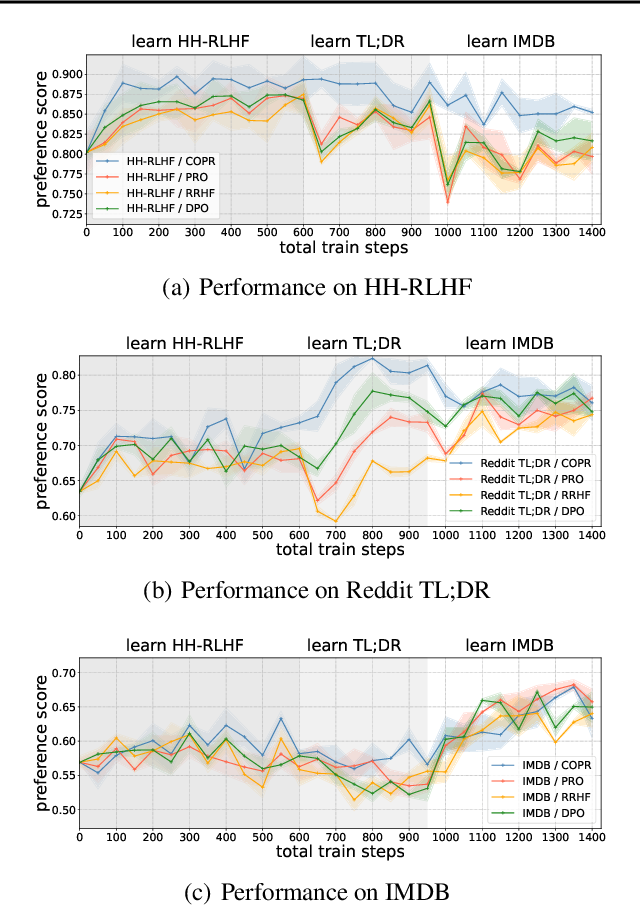
Figure 1 from COPR: Continual Human Preference Learning via Optimal ...
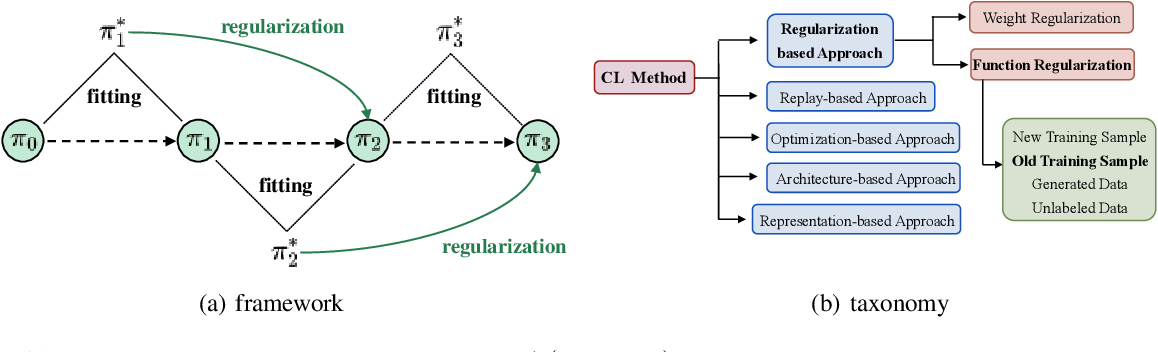
Figure 1 from COPR: Continual Learning Human Preference through Optimal ...
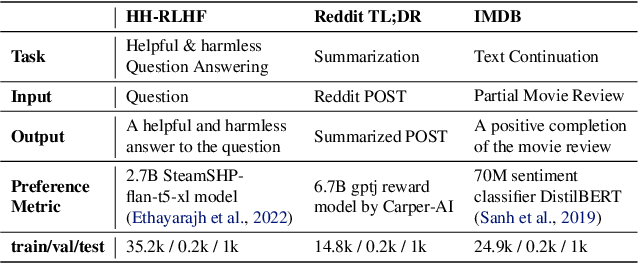
Table 1 from COPR: Continual Human Preference Learning via Optimal ...

Table 1 from COPF: Continual Learning Human Preference through Optimal ...
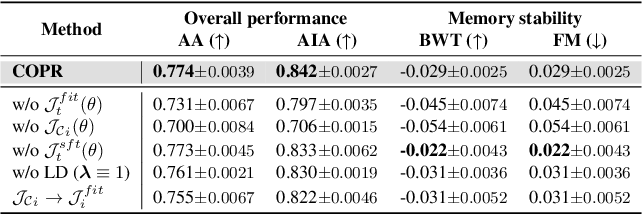
Table 3 from COPR: Continual Human Preference Learning via Optimal ...
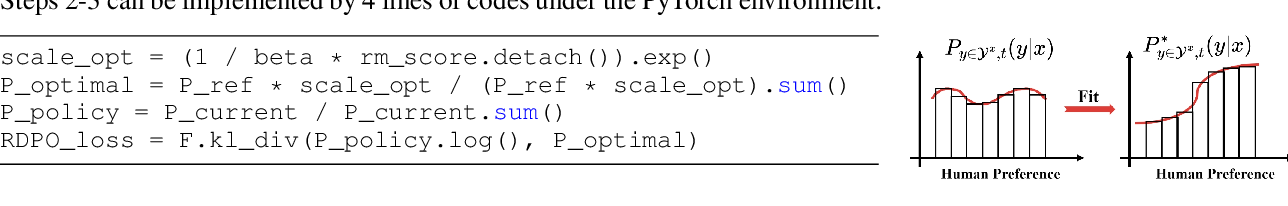
Figure 2 from COPR: Continual Learning Human Preference through Optimal ...

Table 2 from COPR: Continual Human Preference Learning via Optimal ...
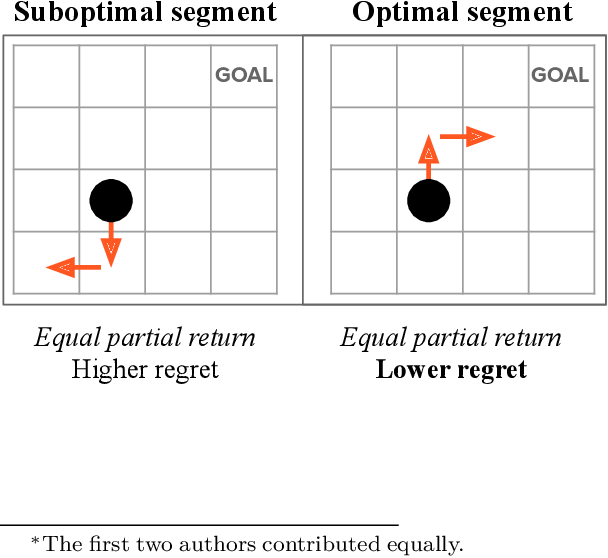
Figure 1 from Models of human preference for learning reward functions ...
Advertisement Space (300x250)

COPR: Continual Human Preference Learning via Optimal Policy ...

Figure 1 from Contrastive Preference Learning: Learning from Human ...
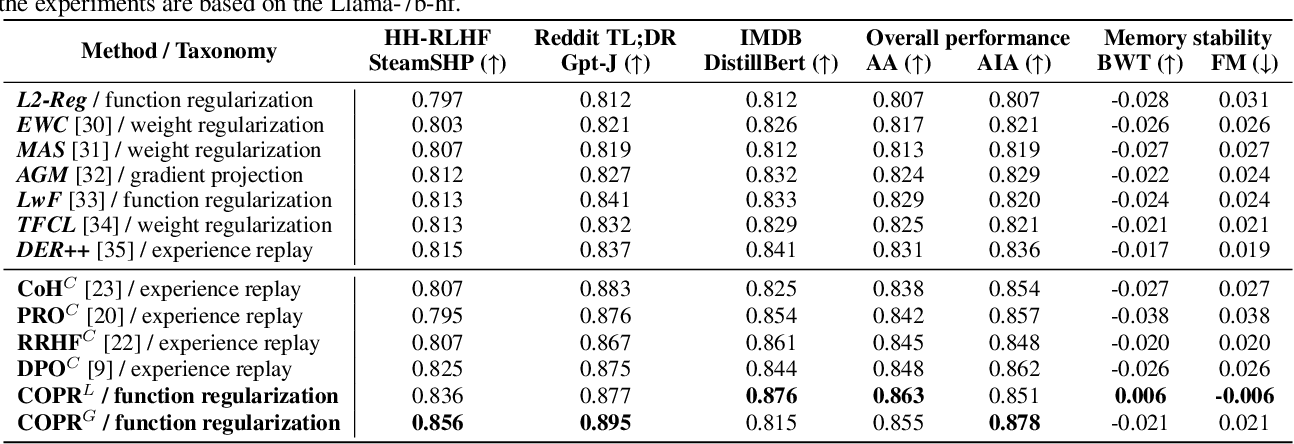
Table 3 from COPR: Continual Learning Human Preference through Optimal ...
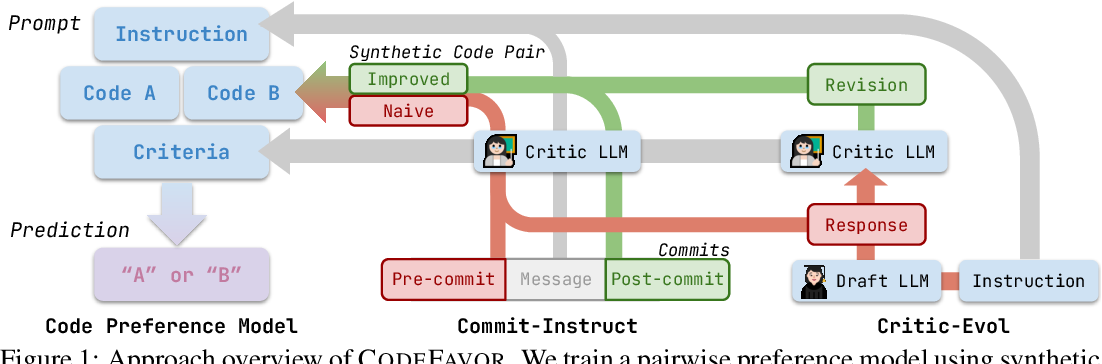
Figure 1 from Learning Code Preference via Synthetic Evolution ...
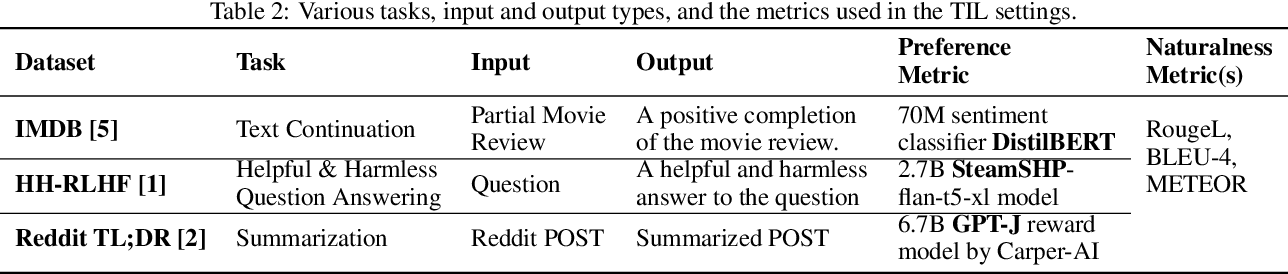
Table 2 from COPR: Continual Learning Human Preference through Optimal ...
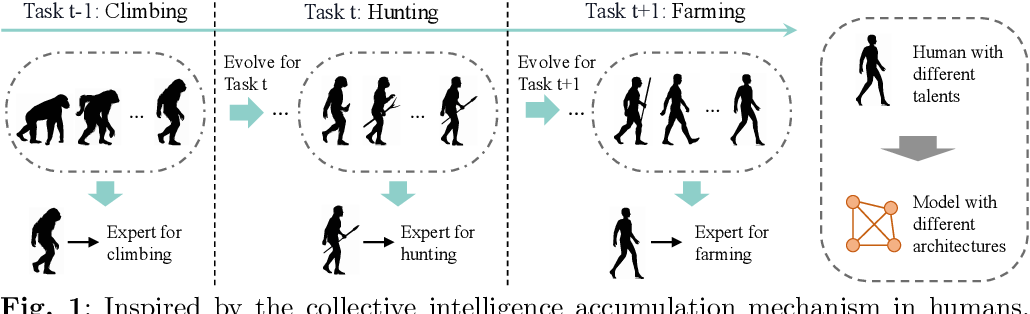
Figure 1 from Achieving Deep Continual Learning via Evolution ...
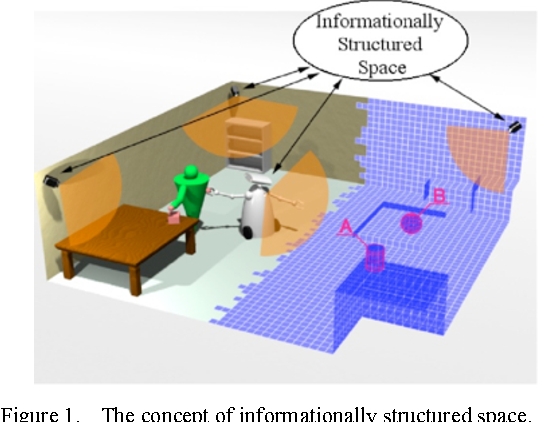
Figure 1 from Human preference learning by robot partners based on ...

Figure 1 from A Survey on Human Preference Learning for Large Language ...
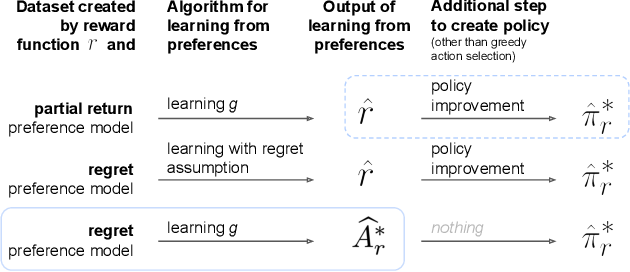
Figure 1 from Learning Optimal Advantage from Preferences and Mistaking ...
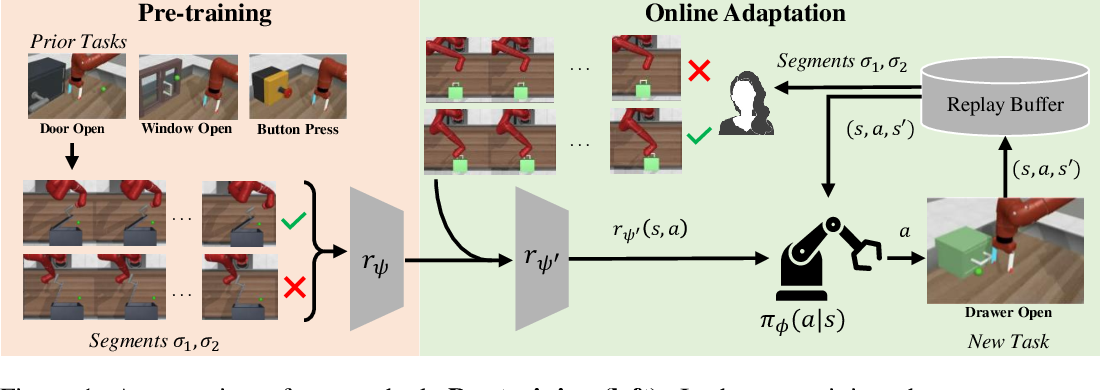
Figure 1 from Few-Shot Preference Learning for Human-in-the-Loop RL ...
Advertisement Space (336x280)
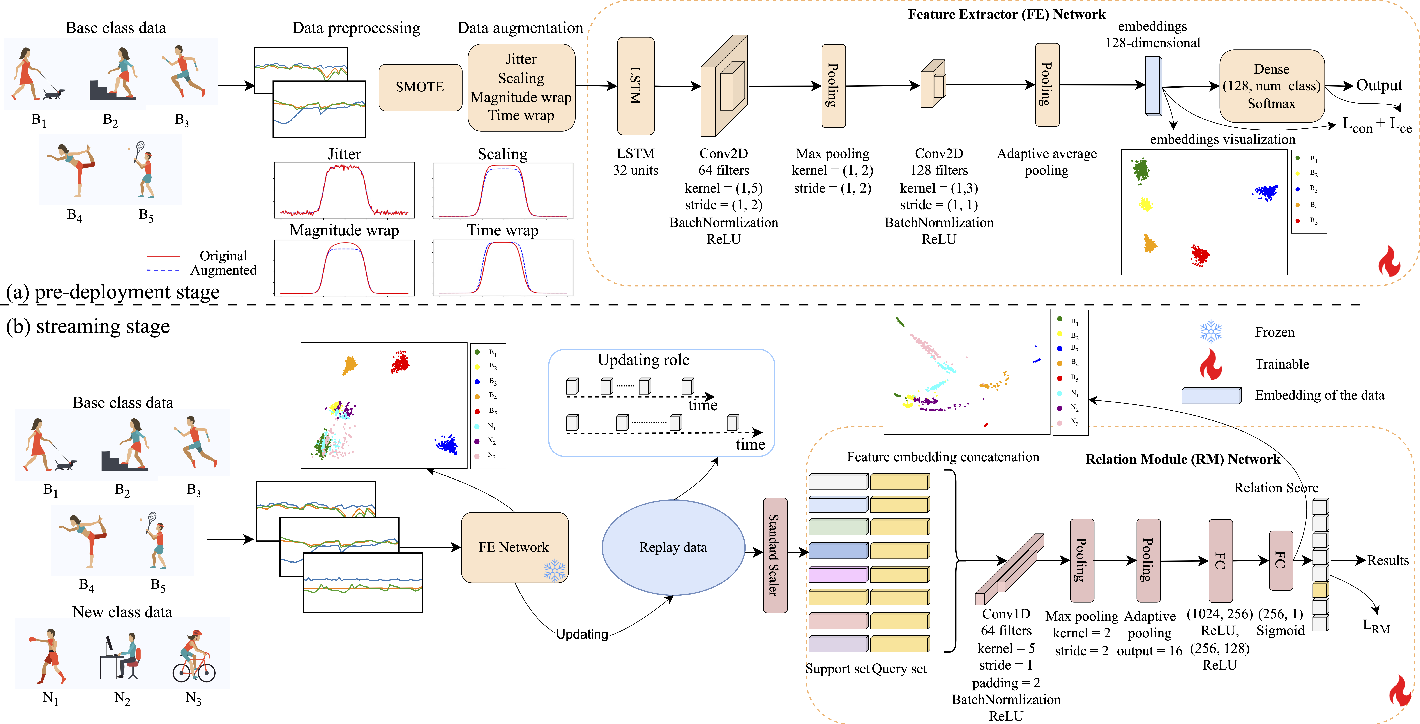
Figure 2 from Efficient Online Continual Learning in Sensor-Based Human ...
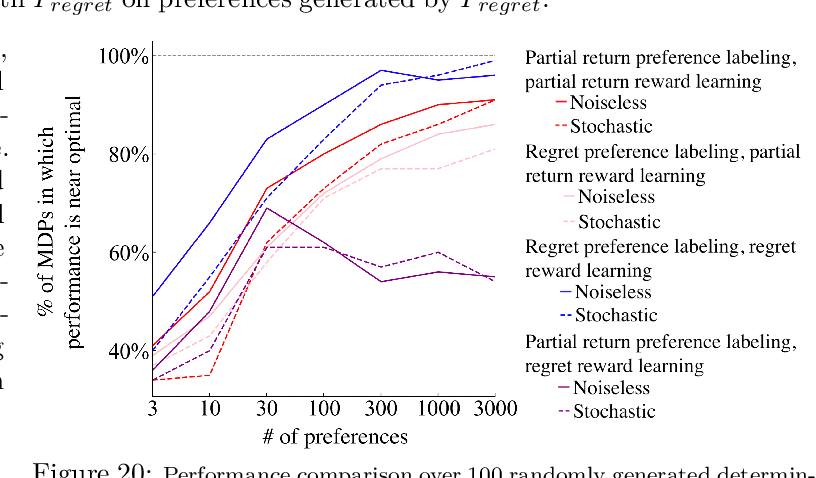
Figure 20 from Models of human preference for learning reward functions ...
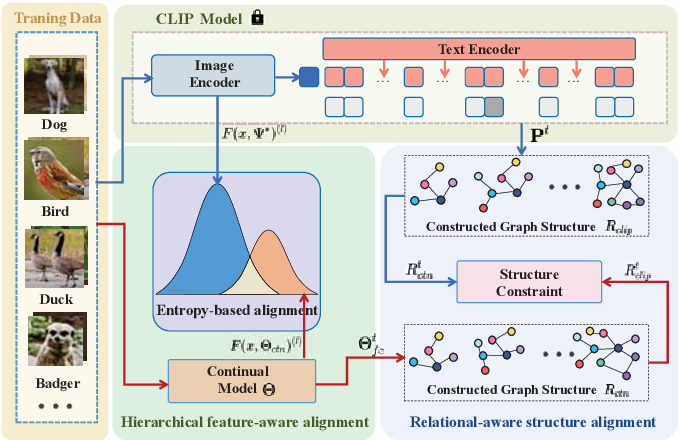
Figure 1 from CLIP-driven Few-Shot Continual Learning | Semantic Scholar

Figure 1 from Enhancing LLM Safety via Constrained Direct Preference ...

Figure 1 from Aligning Large Language Models with Human Preferences ...

(PDF) Pref-GUIDE: Continual Policy Learning from Real-Time Human ...
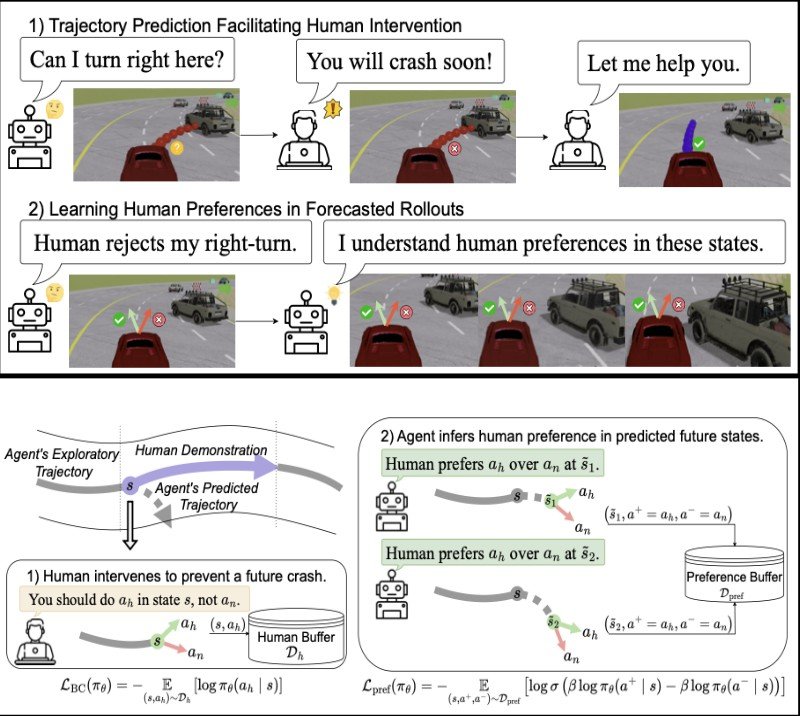
Predictive Preference Learning from Human Interventions – Extrapolator AI

[논문 리뷰] Efficient Reinforcement Learning from Human Feedback via ...

Figure 1 from Eliciting Human Preferences with Language Models ...

Efficient Reinforcement Learning from Human Feedback via Bayesian ...
Advertisement Space (336x280)

Figure 1 from A Preference-based Reinforcement Learning Approach Using ...
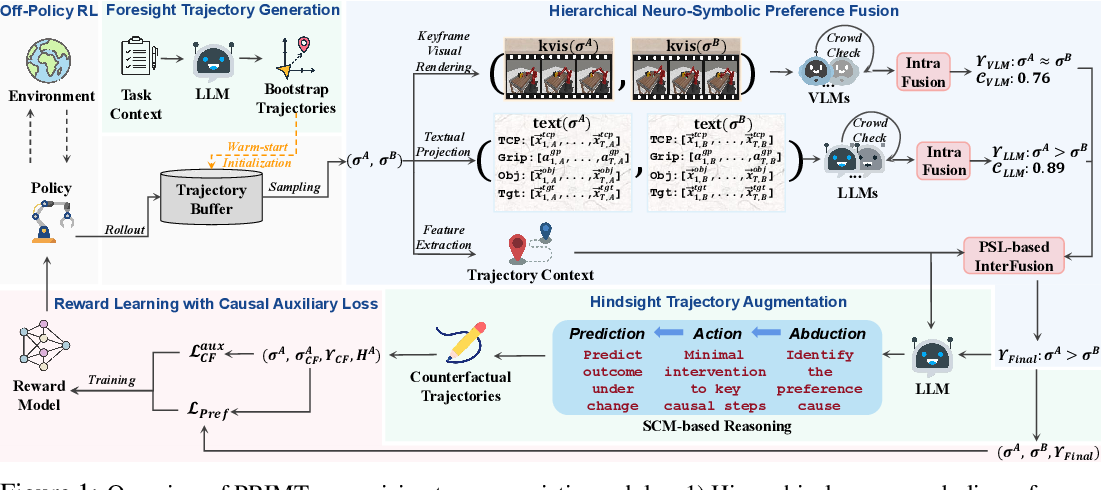
Figure 1 from PRIMT: Preference-based Reinforcement Learning with ...
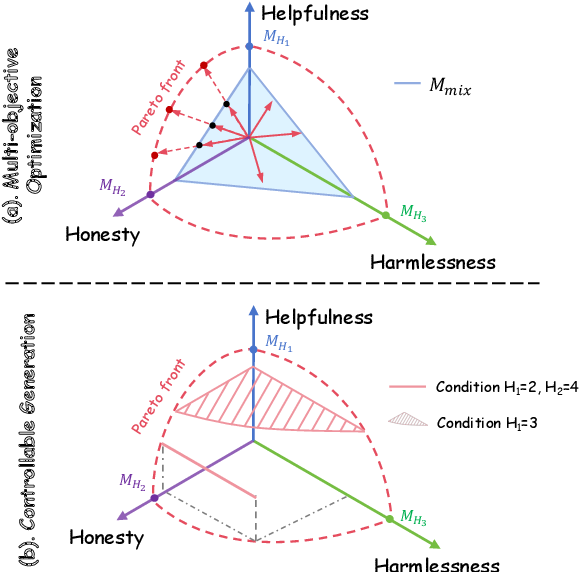
Figure 1 from Controllable Preference Optimization: Toward Controllable ...

Predictive Preference Learning from Human Interventions | AI Research ...
PLOT: Enhancing Preference Learning via Optimal Transport | AI Research ...

Figure 1 from Self-Consistency Preference Optimization | Semantic Scholar