
Figure 6 From Distilling Efficient Vision Transformers From Cnns For

Figure 6 from Distilling Efficient Vision Transformers from CNNs for ...

Figure 1 from Distilling Efficient Vision Transformers from CNNs for ...

Figure 5 from Distilling Efficient Vision Transformers from CNNs for ...

Figure 6 from Distilling Self-Supervised Vision Transformers for Weakly ...

Table VI from Distilling Efficient Vision Transformers from CNNs for ...
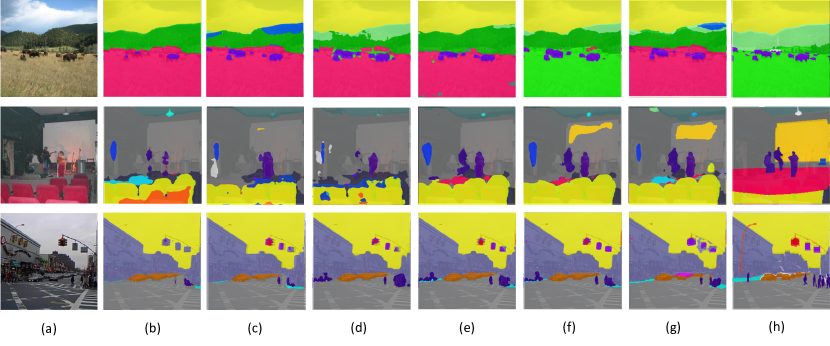
[2310.07265] Distilling Efficient Vision Transformers from CNNs for ...
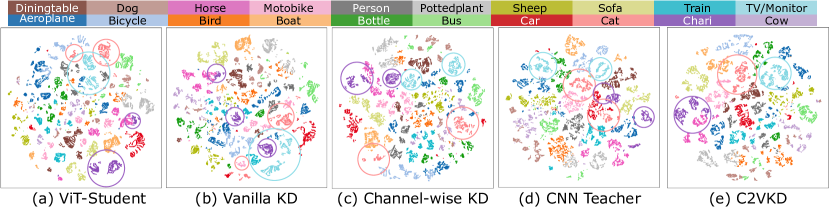
[2310.07265] Distilling Efficient Vision Transformers from CNNs for ...

Table I from Distilling Efficient Vision Transformers from CNNs for ...

Table VII from Distilling Efficient Vision Transformers from CNNs for ...
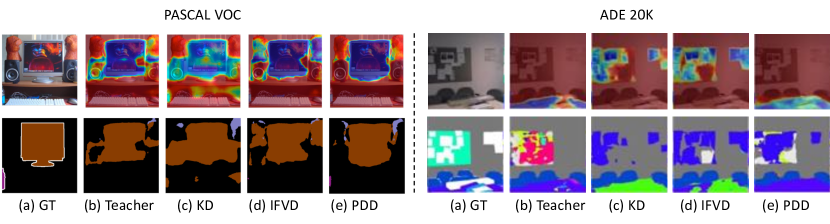
[2310.07265] Distilling Efficient Vision Transformers from CNNs for ...
Advertisement Space (300x250)
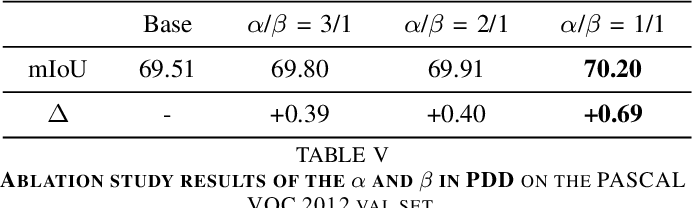
Table V from Distilling Efficient Vision Transformers from CNNs for ...
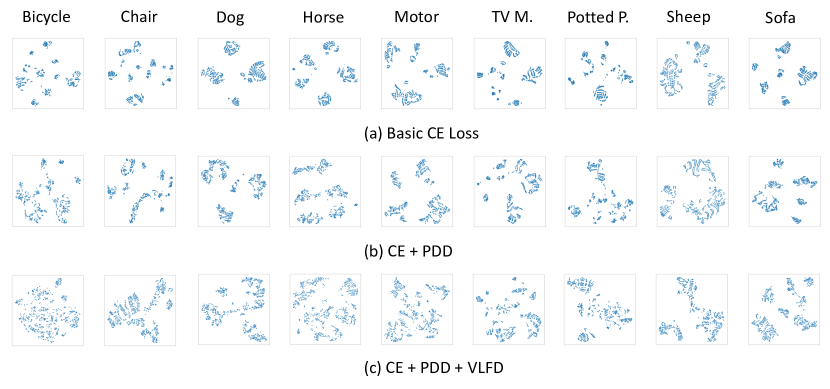
[2310.07265] Distilling Efficient Vision Transformers from CNNs for ...

Figure 2 from Learning Efficient Vision Transformers via Fine-Grained ...
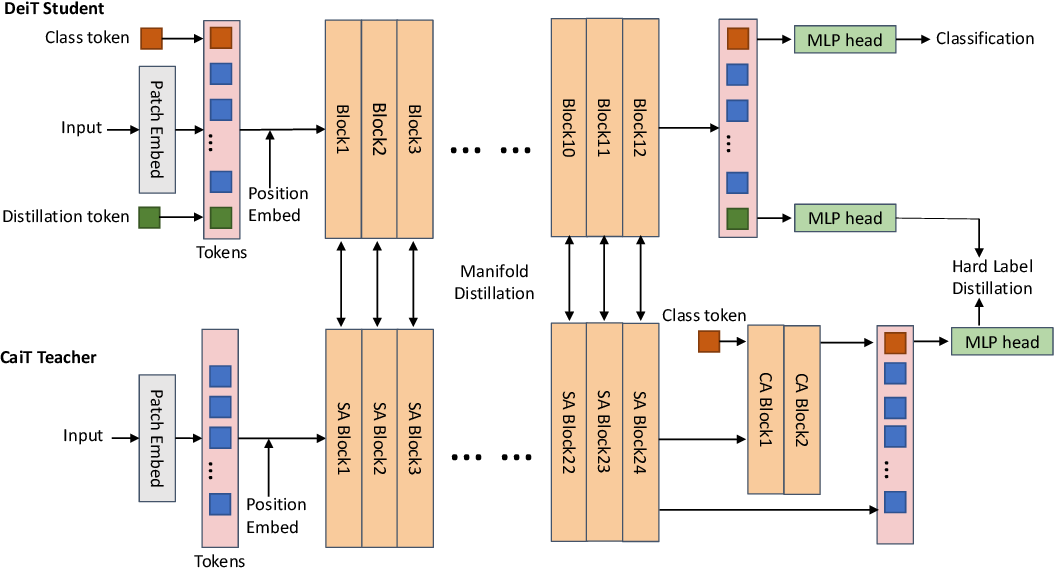
Figure 1 from Efficient Vision Transformers via Fine-Grained Manifold ...
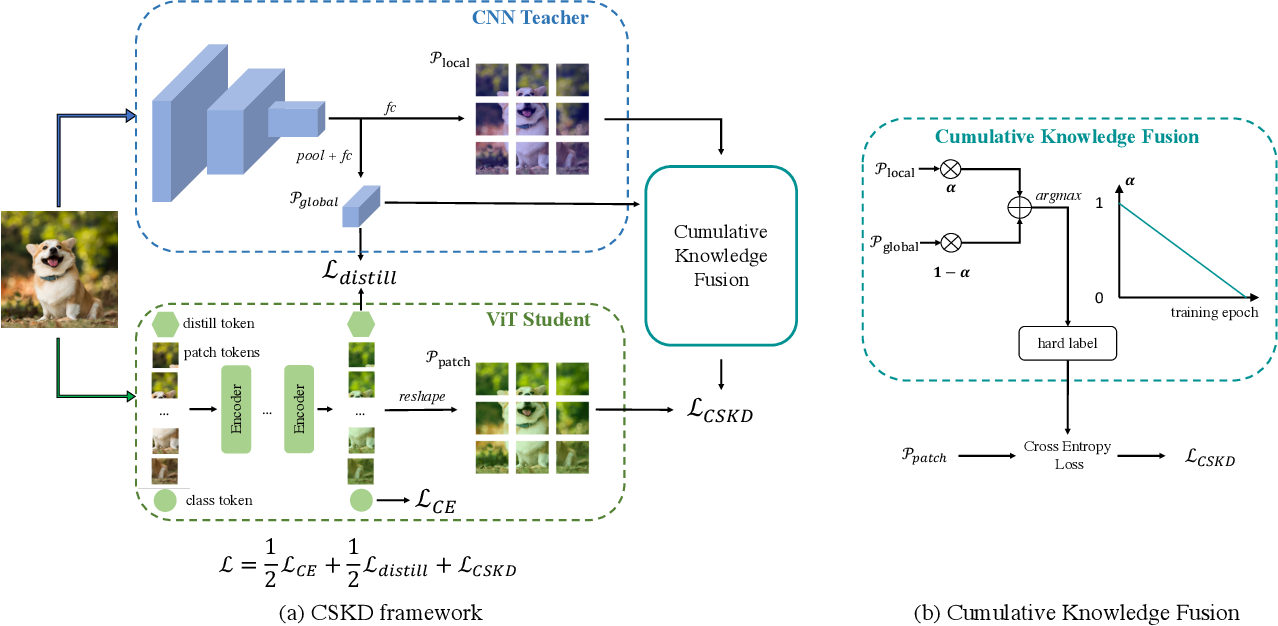
Figure 1 from Cumulative Spatial Knowledge Distillation for Vision ...

Figure 1 from VER: Vision Expert Transformer for Robot Learning via ...

Figure 1 from The Role of Masking for Efficient Supervised Knowledge ...
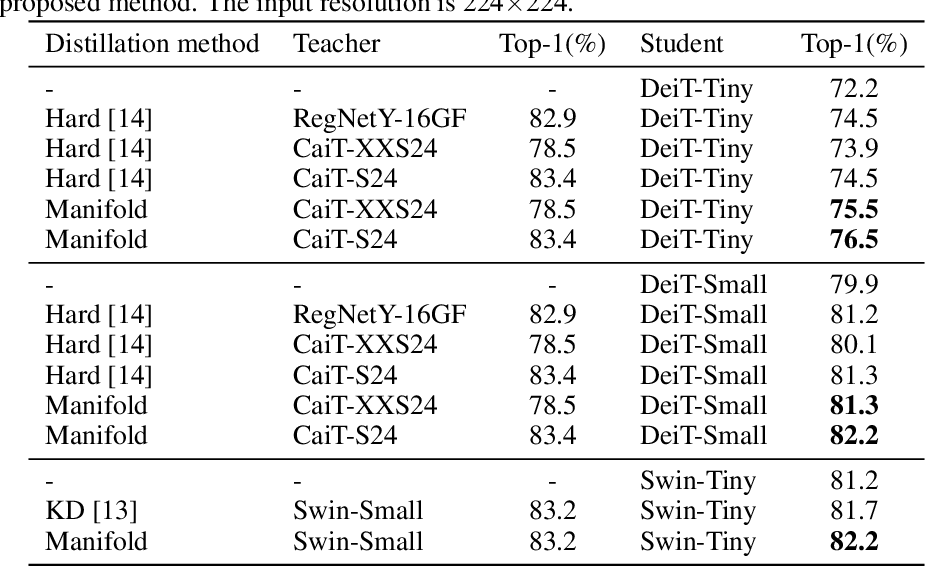
Table 2 from Learning Efficient Vision Transformers via Fine-Grained ...

Frontiers | Bridging CNNs and vision transformers for efficient tea ...

Figure 1 from DS-Net++: Dynamic Weight Slicing for Efficient Inference ...
Advertisement Space (336x280)
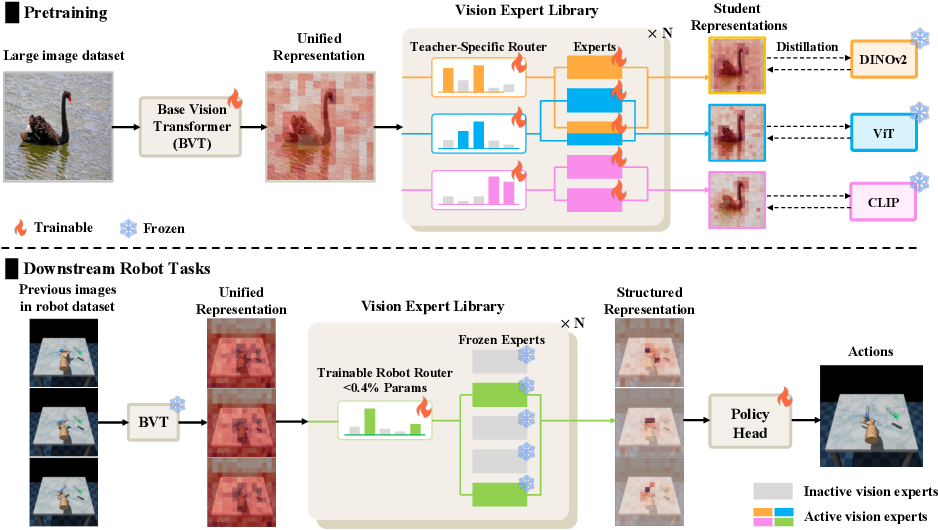
Figure 2 from VER: Vision Expert Transformer for Robot Learning via ...

Figure 5 from DeiT-LT: Distillation Strikes Back for Vision Transformer ...
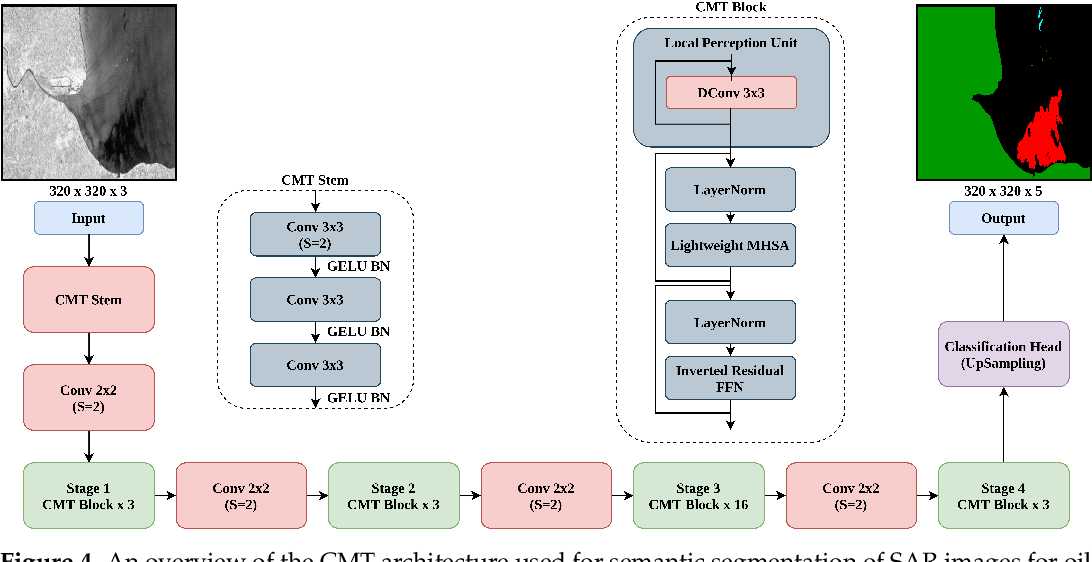
Figure 4 from Comparison of CNNs and Vision Transformers-Based Hybrid ...

Figure 1 from MVKD-Trans: A Multi-View Knowledge Distillation Vision ...
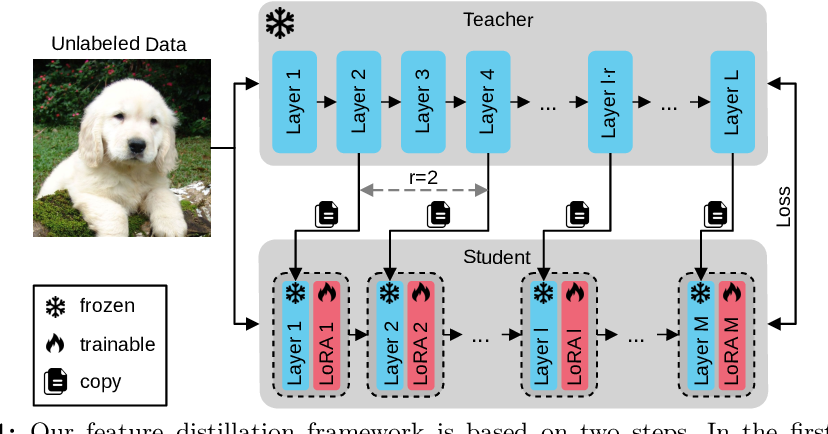
Figure 1 from Weight Copy and Low-Rank Adaptation for Few-Shot ...

Figure 2 from MVKD-Trans: A Multi-View Knowledge Distillation Vision ...

Figure 1 from DTCNet: Transformer-CNN Distillation for Super-Resolution ...
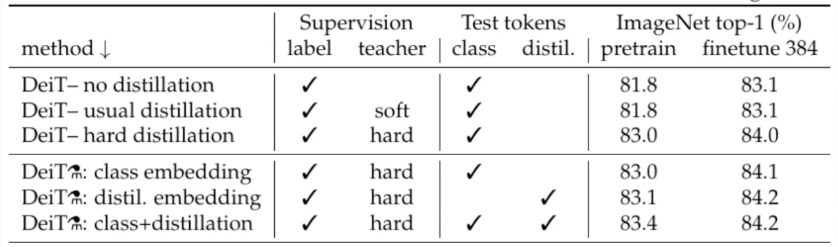
Quantizing Vision Transformers for Efficient Deployment: Strategies and ...

Efficient knowledge distillation for hybrid models: A vision ...
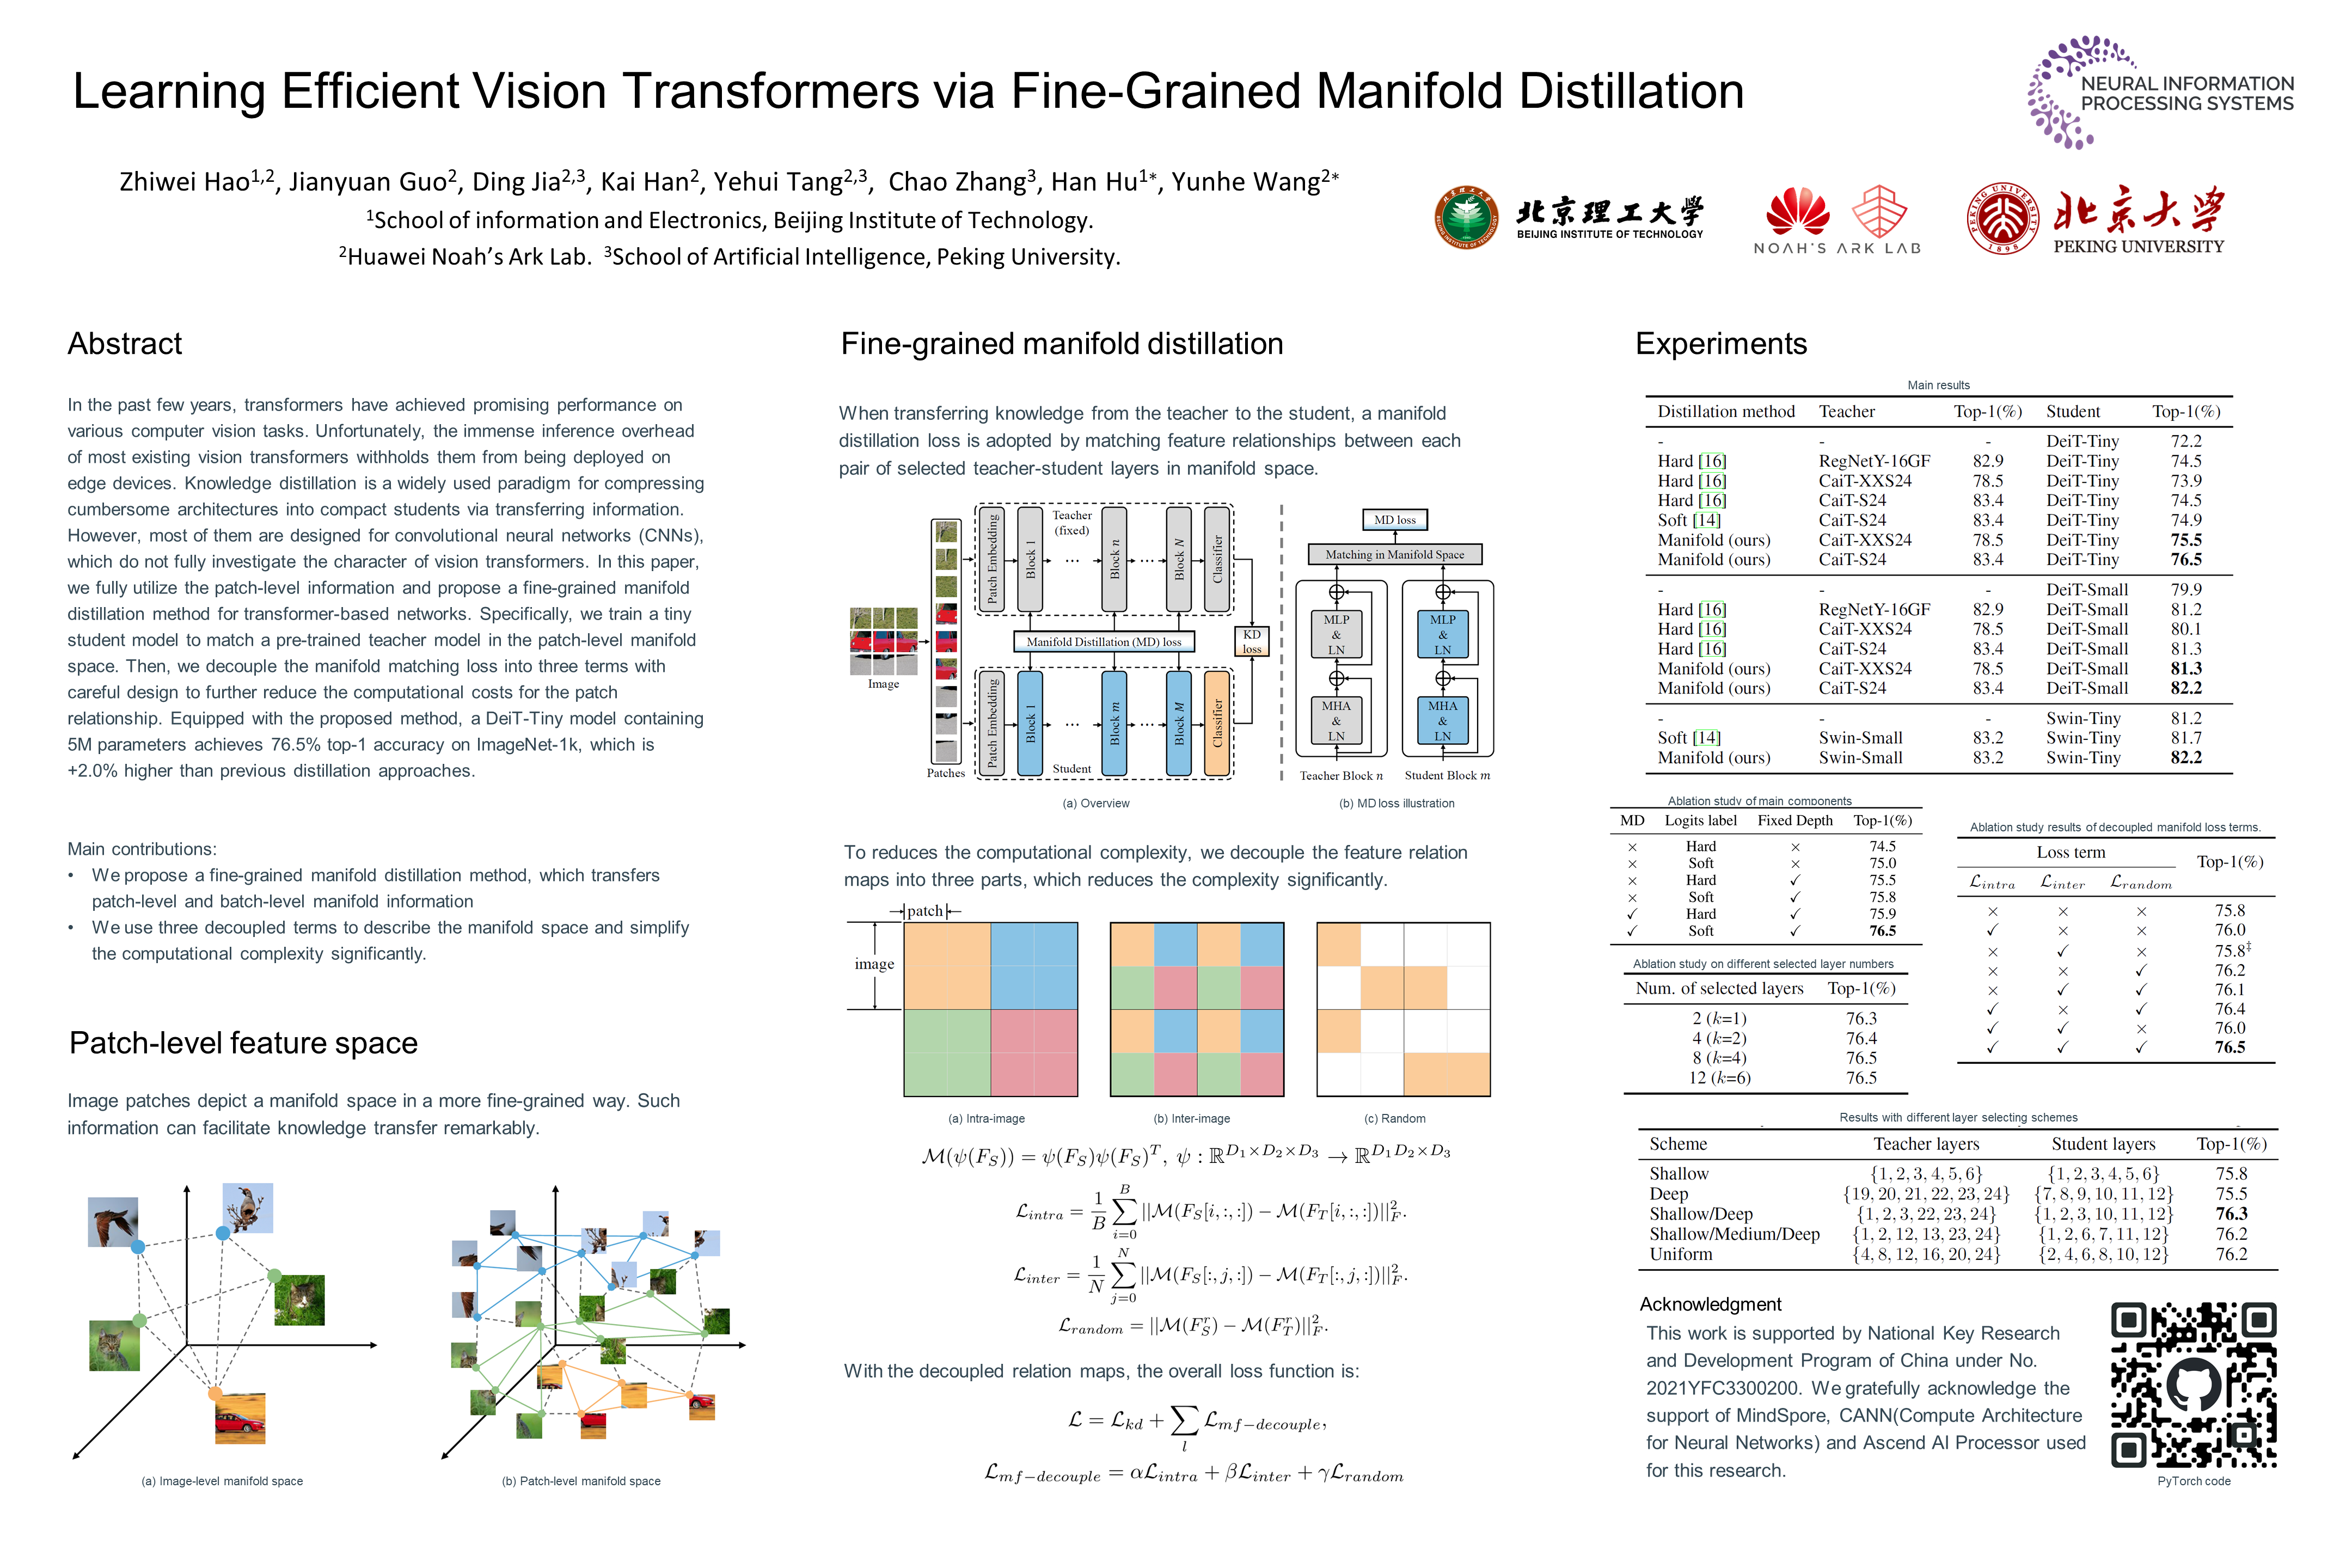
NeurIPS Poster Learning Efficient Vision Transformers via Fine-Grained ...
Advertisement Space (336x280)
Comparing CNNs, ResNet, and Vision Transformers for Image ...

SLIDES OF LECTURE ABOUT TRANSFORMERS FOR VISION TASKS | PPTX

MaskedKD: Efficient Distillation of Vision Transformers with Masked ...

Illustration of our proposed method for optimizing vision Transformers ...
SLIDES OF LECTURE ABOUT TRANSFORMERS FOR VISION TASKS | PPTX
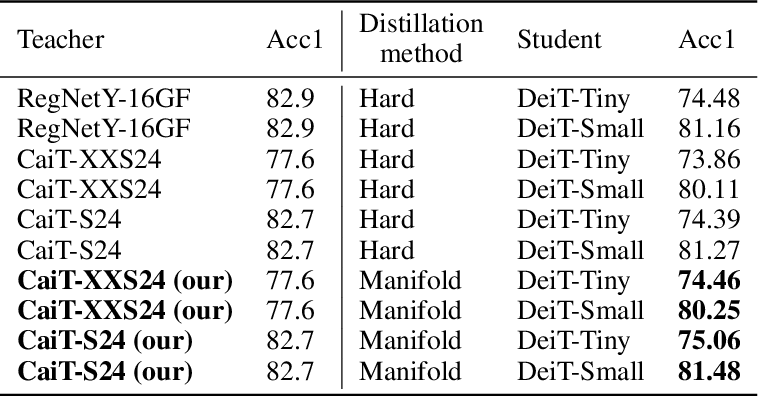
Efficient Vision Transformers via Fine-Grained Manifold Distillation