
Table I From Distilling Efficient Vision Transformers From Cnns For

Table I from Distilling Efficient Vision Transformers from CNNs for ...

Table VI from Distilling Efficient Vision Transformers from CNNs for ...
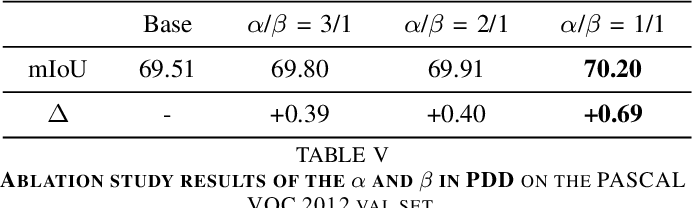
Table V from Distilling Efficient Vision Transformers from CNNs for ...

Table VII from Distilling Efficient Vision Transformers from CNNs for ...

Figure 1 from Distilling Efficient Vision Transformers from CNNs for ...

Figure 10 from Distilling Efficient Vision Transformers from CNNs for ...

Figure 11 from Distilling Efficient Vision Transformers from CNNs for ...

Figure 6 from Distilling Efficient Vision Transformers from CNNs for ...

Figure 5 from Distilling Efficient Vision Transformers from CNNs for ...
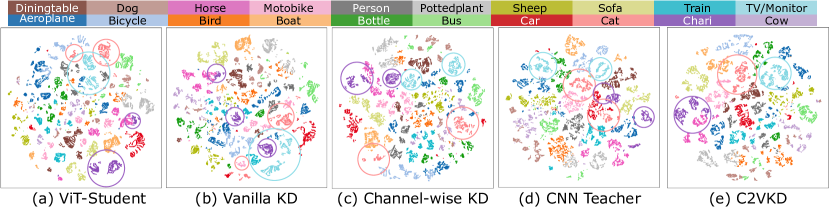
[2310.07265] Distilling Efficient Vision Transformers from CNNs for ...
Advertisement Space (300x250)
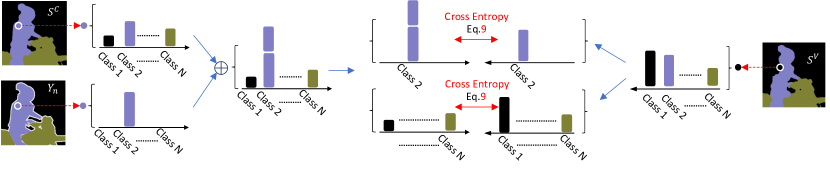
[2310.07265] Distilling Efficient Vision Transformers from CNNs for ...
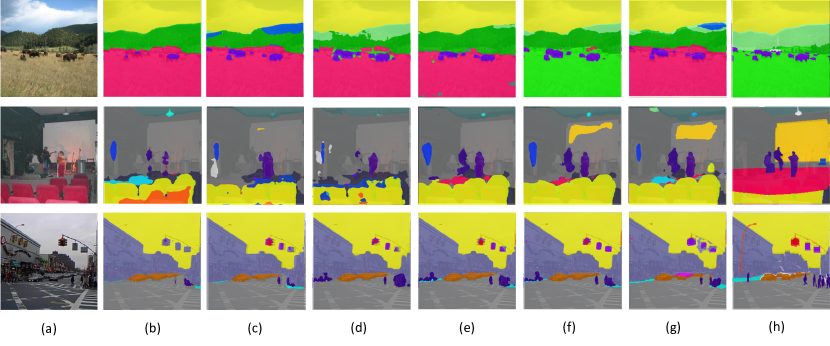
[2310.07265] Distilling Efficient Vision Transformers from CNNs for ...
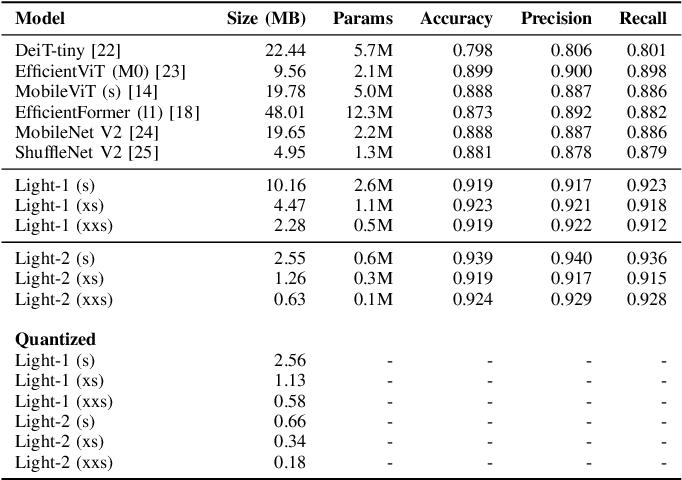
Table I from Efficient Vision Transformers Optimized with Pruning and ...

Table I from Distilling Knowledge from CNN-Transformer Models for ...
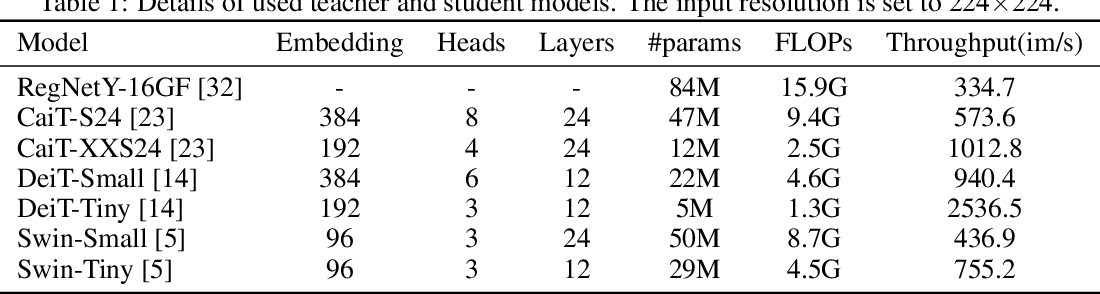
Table 1 from Learning Efficient Vision Transformers via Fine-Grained ...

Table 1 from Efficient Vision Transformers via Fine-Grained Manifold ...
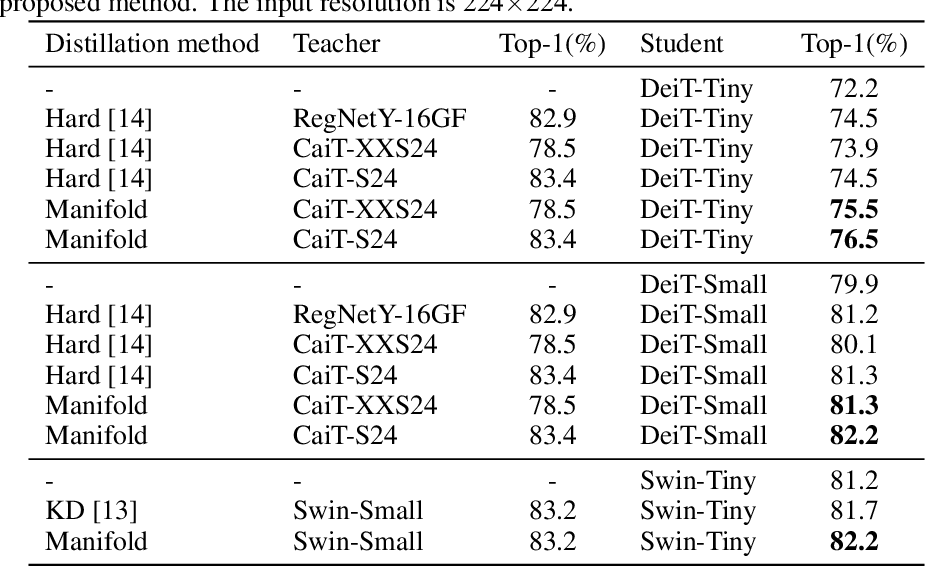
Table 2 from Learning Efficient Vision Transformers via Fine-Grained ...

Table 1 from Efficiency 360: Efficient Vision Transformers | Semantic ...

Table 1 from Dynamic Spatial Sparsification for Efficient Vision ...
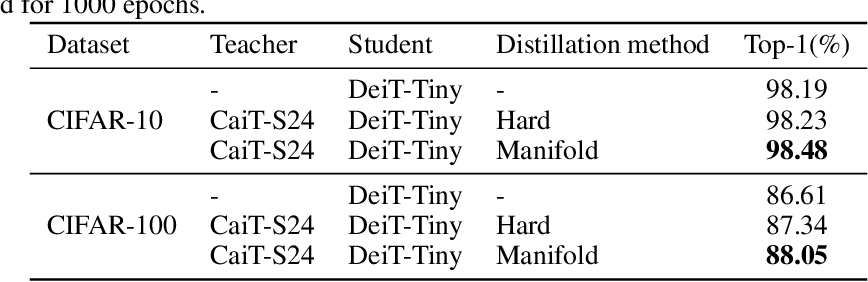
Table 7 from Learning Efficient Vision Transformers via Fine-Grained ...
Advertisement Space (336x280)

Table 1 from Predicting Token Impact Towards Efficient Vision ...
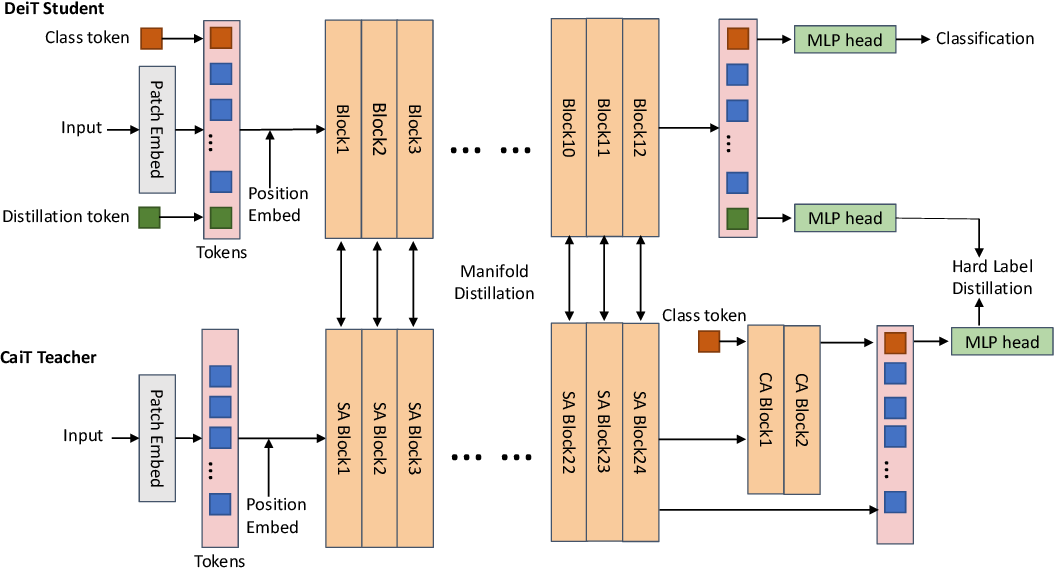
Figure 1 from Efficient Vision Transformers via Fine-Grained Manifold ...

Figure 2 from Learning Efficient Vision Transformers via Fine-Grained ...

Table 2 from Predicting Token Impact Towards Efficient Vision ...
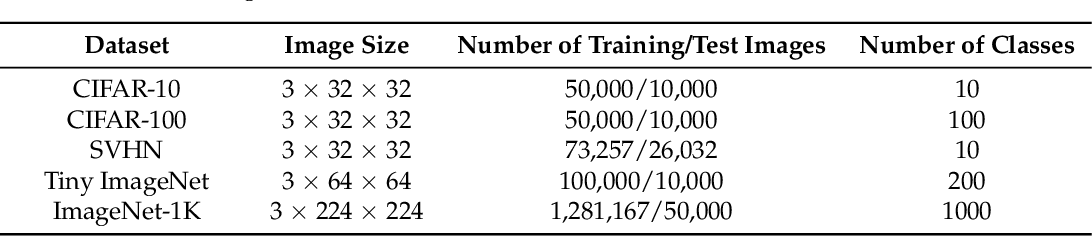
Table 1 from EEViT: Efficient Enhanced Vision Transformer Architectures ...

Frontiers | Bridging CNNs and vision transformers for efficient tea ...
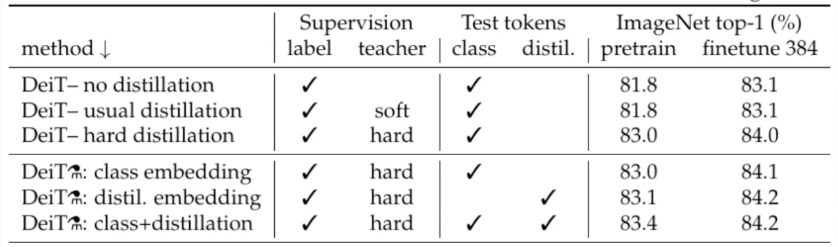
Quantizing Vision Transformers for Efficient Deployment: Strategies and ...
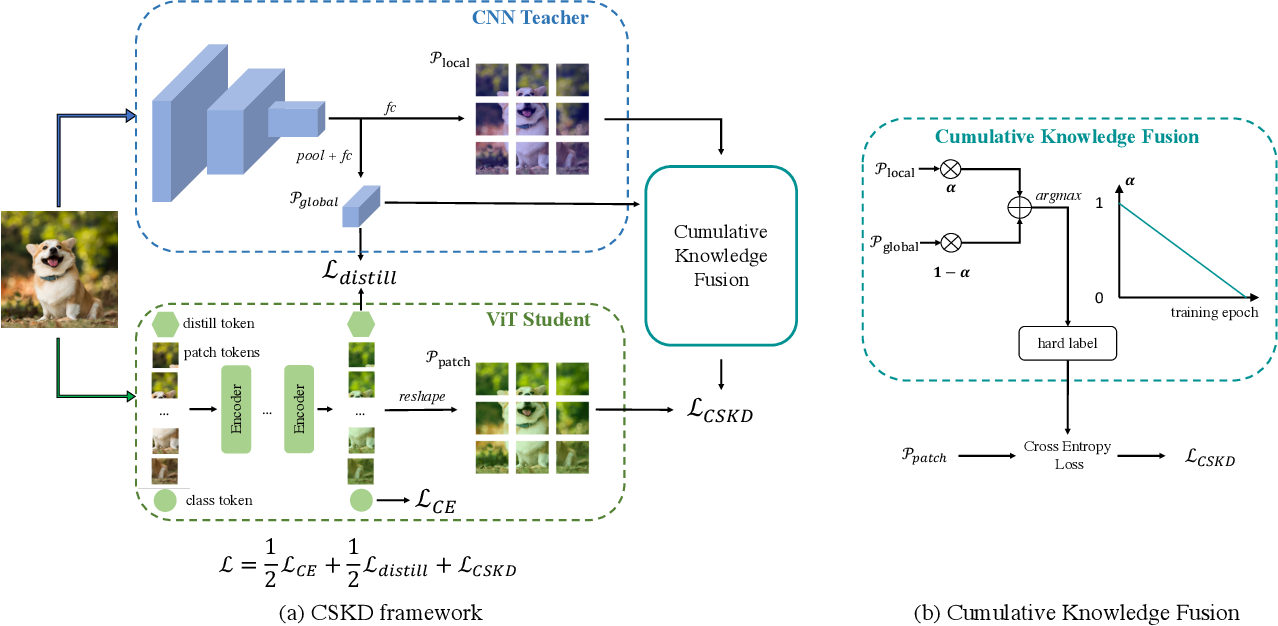
Figure 1 from Cumulative Spatial Knowledge Distillation for Vision ...

Table 3 from MVKD-Trans: A Multi-View Knowledge Distillation Vision ...

Figure 1 from Distilling Knowledge from CNN-Transformer Models for ...
Advertisement Space (336x280)
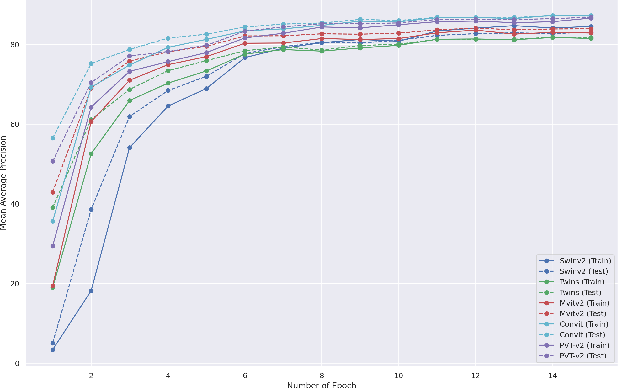
Figure 2 from Distilling Knowledge from CNN-Transformer Models for ...

Figure 1 from The Role of Masking for Efficient Supervised Knowledge ...

Table 3 from MVKD-Trans: A Multi-View Knowledge Distillation Vision ...

Table 3 from MVKD-Trans: A Multi-View Knowledge Distillation Vision ...

Figure 1 from Transforming Vision Transformer: Towards Efficient Multi ...

Table 3 from Efficient Large-Scale Audio Tagging Via Transformer-to-CNN ...