
Figure 1 From Muse Multi Modal Target Speaker Extraction With Visual
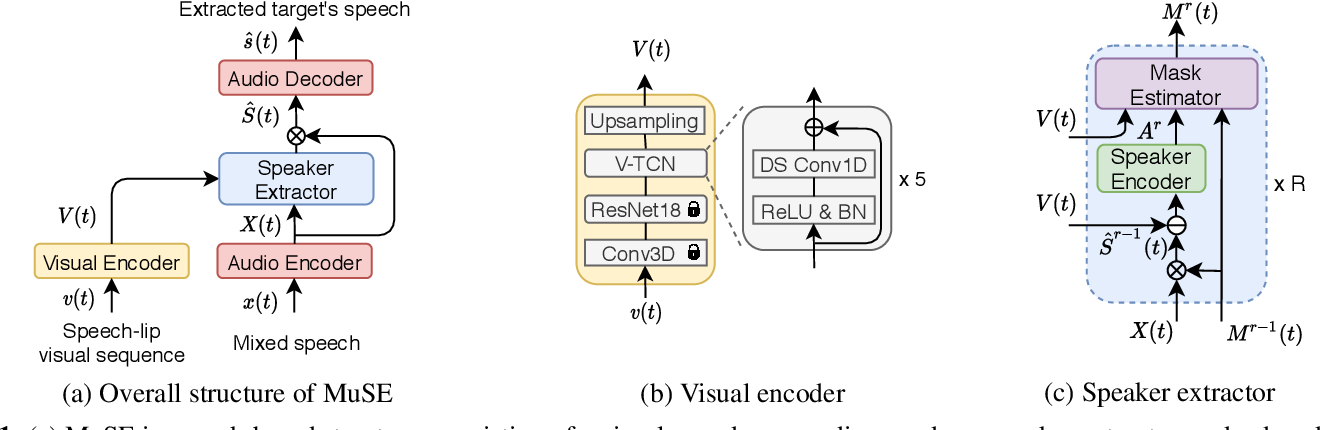
Figure 1 from Muse: Multi-Modal Target Speaker Extraction with Visual ...

Figure 1 from Muse: Multi-Modal Target Speaker Extraction with Visual ...

Figure 1 from Muse: Multi-Modal Target Speaker Extraction with Visual ...

Figure 1 from Audio-Visual Target Speaker Extraction with Reverse ...

Figure 1 from Audio-Visual Target Speaker Extraction with Reverse ...

Figure 1 from Audio-Visual Target Speaker Extraction with Reverse ...
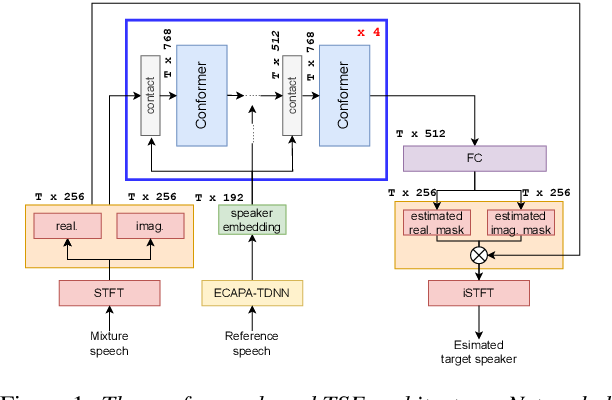
Figure 1 from Target Speaker Extraction with Curriculum Learning ...

Figure 1 from Target Speaker Extraction with Attention Enhancement and ...

Figure 1 from Multi-Channel Target Speaker Extraction with Refinement ...

Figure 1 from Audio-Visual Target Speaker Extraction with Reverse ...
Advertisement Space (300x250)

Figure 1 from Multimodal Attention Fusion for Target Speaker Extraction ...

Figure 1 from Target Speaker Extraction for Multi-Talker Speaker ...

Figure 1 from Low-complexity Multi-Channel Speaker Extraction with Pure ...

Figure 1 from Target Active Speaker Detection with Audio-visual Cues ...

Figure 11 from Audio-Visual Target Speaker Extraction with Reverse ...

Figure 1 from Multi-Stage Speaker Extraction with Utterance and Frame ...
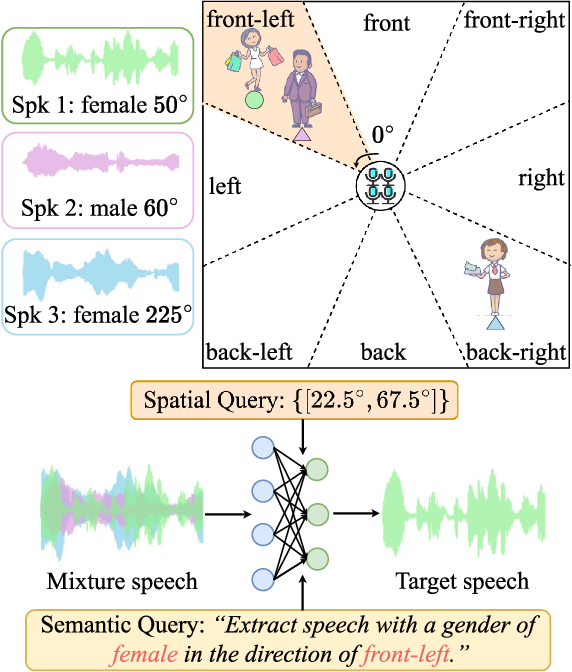
Figure 1 from SSDQ: Target Speaker Extraction via Semantic and Spatial ...
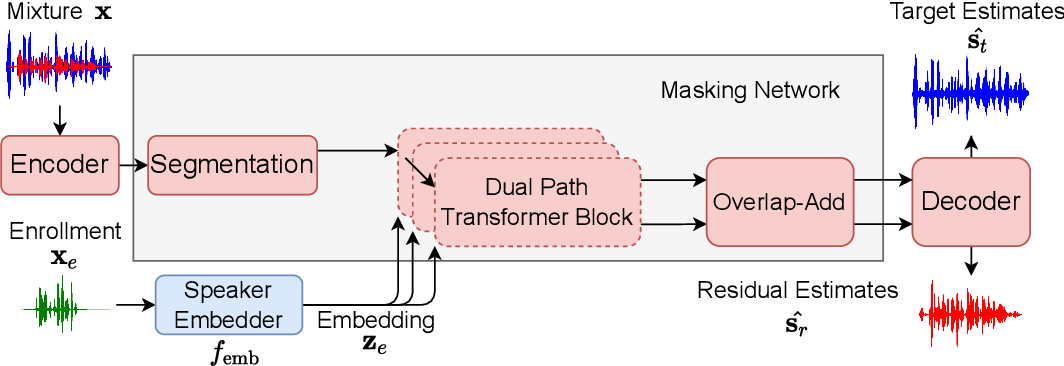
Figure 1 from Semi-supervised Time Domain Target Speaker Extraction ...

Figure 1 from Target Active Speaker Detection with Audio-visual Cues ...

Figure 1 from Speaker Extraction with Detection of Presence and Absence ...
Advertisement Space (336x280)
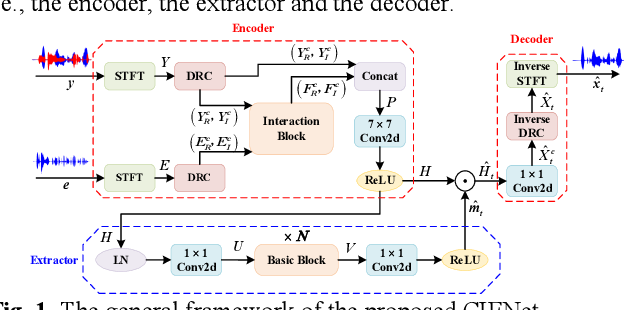
Figure 1 from Target Speaker Extraction by Directly Exploiting ...
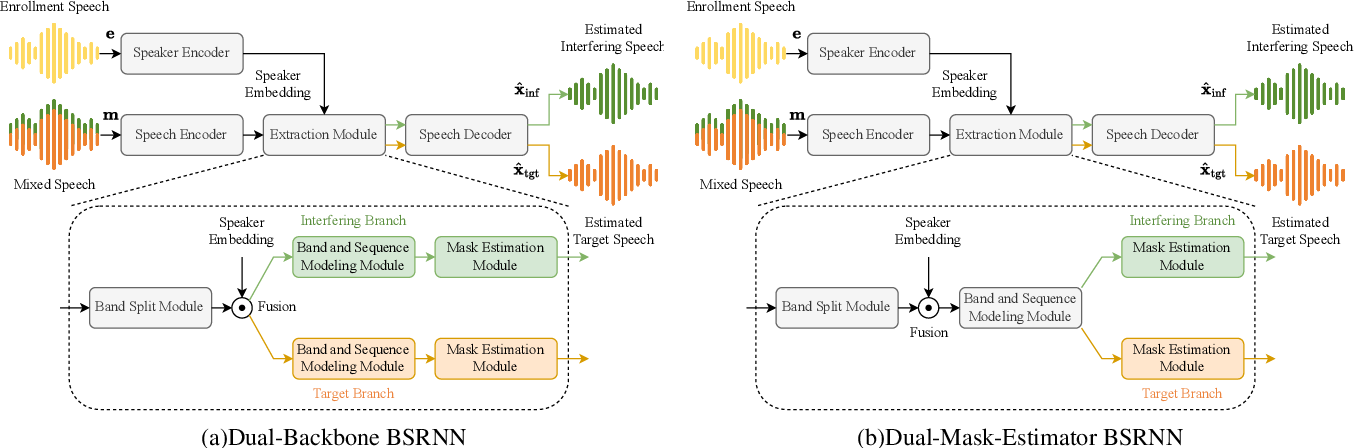
Figure 1 from Enhancing Speaker Extraction Through Rectifying Target ...
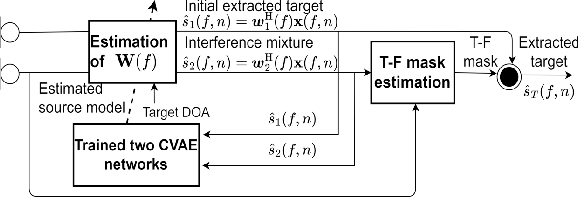
Figure 1 from Directional Target Speaker Extraction under Noisy ...

Figure 1 from Single Channel Target Speaker Extraction Based on Deep ...

[2010.07775] Muse: Multi-modal target speaker extraction with visual cues

Figure 1 from A Multimodal Target Speech Extraction Algorithm Based on ...
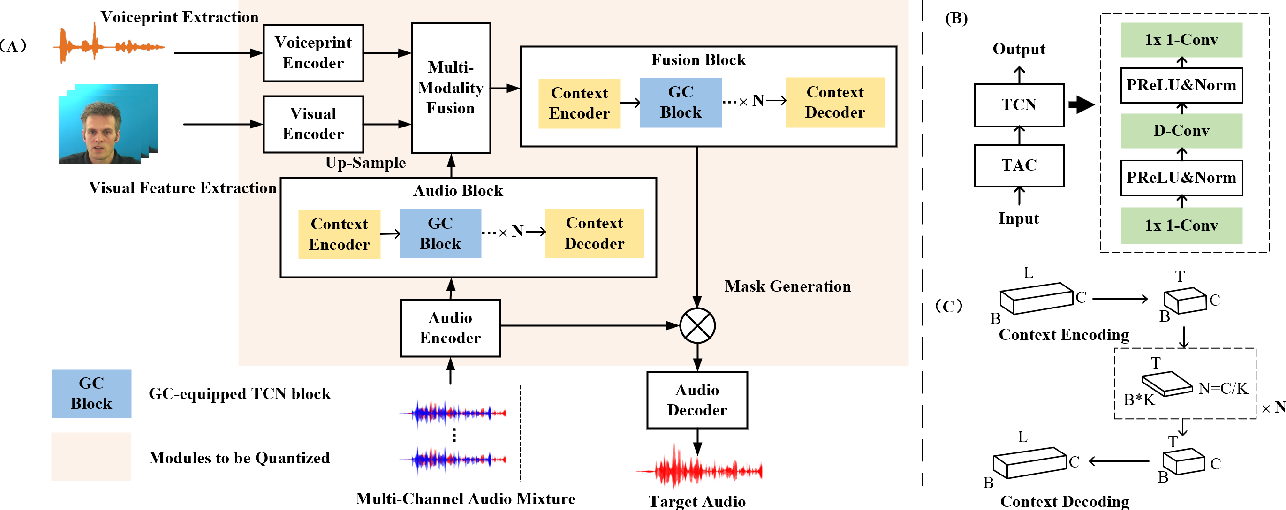
Figure 1 from LiMuSE: Lightweight Multi-Modal Speaker Extraction ...

Figure 1 from Multi-Modal Knowledge Transfer for Target Speaker ...

Figure 1 from Simultaneous Speech Extraction for Multiple Target ...

Figure 2 from Enhancing Real-World Active Speaker Detection With Multi ...
Advertisement Space (336x280)

(PDF) Muse: Multi-modal target speaker extraction with visual cues

[2010.07775] Muse: Multi-modal target speaker extraction with visual cues

[2010.07775] Muse: Multi-modal target speaker extraction with visual cues

Figure 4 from Enhancing Real-World Active Speaker Detection with Multi ...
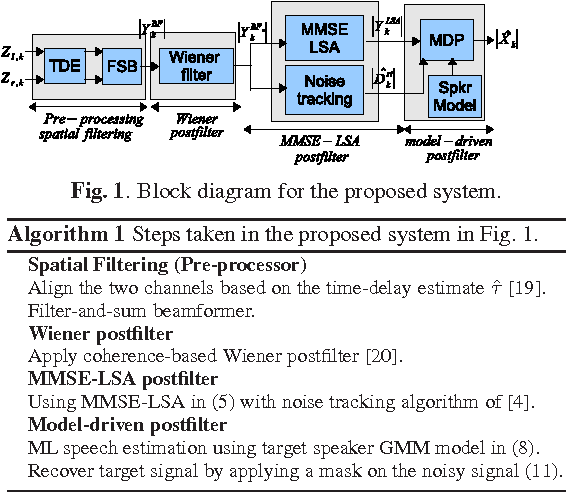
Figure 1 from Target speaker separation in a multisource environment ...

Figure 1 from Binaural Selective Attention Model for Target Speaker ...