
Figure 1 From Streaming Multi Talker Asr With Token Level Serialized
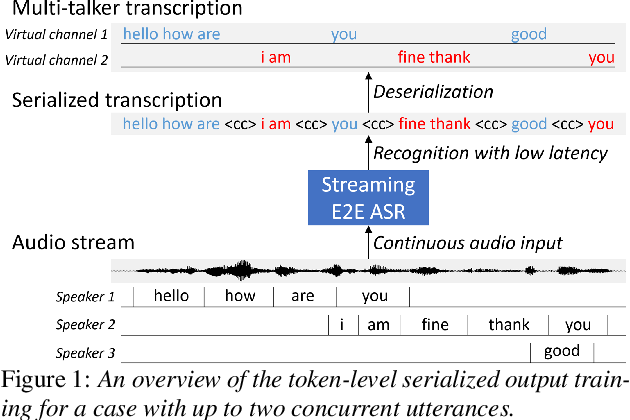
Figure 1 from Streaming Multi-Talker ASR with Token-Level Serialized ...
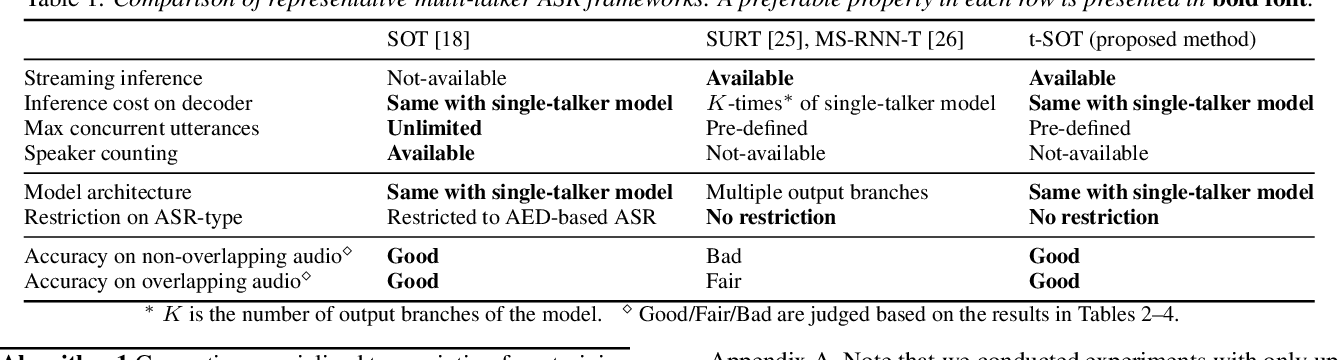
Figure 1 from Streaming Multi-Talker ASR with Token-Level Serialized ...

Figure 1 from Streaming Multi-Speaker ASR with RNN-T | Semantic Scholar
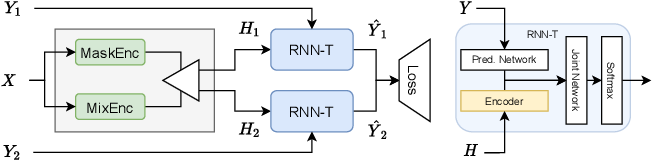
Figure 1 from Continuous Streaming Multi-Talker ASR with Dual-Path ...

Table 4 from Streaming Multi-Talker ASR with Token-Level Serialized ...

Figure 1 from Streaming Bilingual End-to-End ASR Model Using Attention ...

Table 2 from Streaming Multi-Talker ASR with Token-Level Serialized ...

Figure 1 from Advancing Multi-Talker ASR Performance With Large ...

Table 7 from Streaming Multi-Talker ASR with Token-Level Serialized ...

Figure 1 from A Language Agnostic Multilingual Streaming On-Device ASR ...
Advertisement Space (300x250)

Table 1 from Streaming Multi-Speaker ASR with RNN-T | Semantic Scholar

Figure 1 from Advancing Multi-Talker ASR Performance With Large ...

Figure 1 from Streaming End-to-End ASR based on Blockwise Non ...

Table 1 from Continuous Streaming Multi-Talker ASR with Dual-Path ...

Figure 1 from Token-Level Serialized Output Training for Joint ...

Figure 1 from Adapting Multi-Lingual ASR Models for Handling Multiple ...

Figure 1 from SA-SOT: Speaker-Aware Serialized Output Training for ...

Figure 1 from SA-SOT: Speaker-Aware Serialized Output Training for ...

Figure 1 from MSA-ASR: Efficient Multilingual Speaker Attribution with ...

Figure 1 from Speech-Aware Multi-Domain Dialogue State Generation with ...
Advertisement Space (336x280)
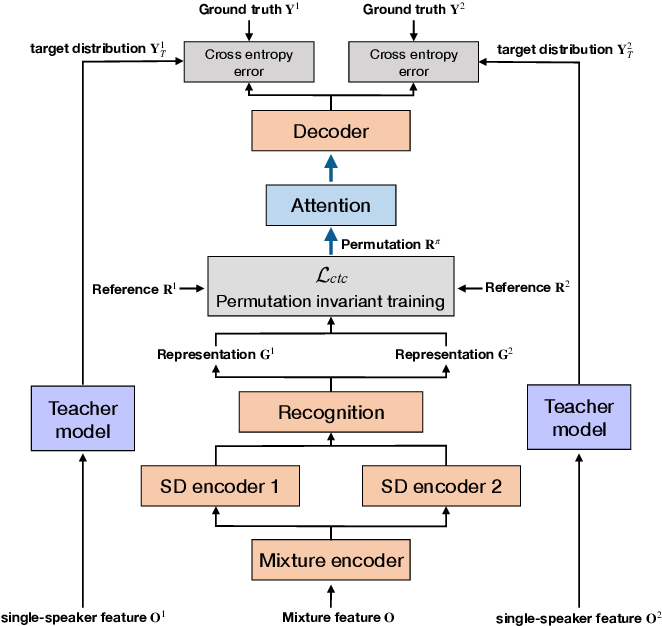
Figure 1 from Knowledge Distillation for End-to-End Monaural Multi ...

Figure 1 from Multi-Channel Multi-Speaker ASR Using 3D Spatial Feature ...
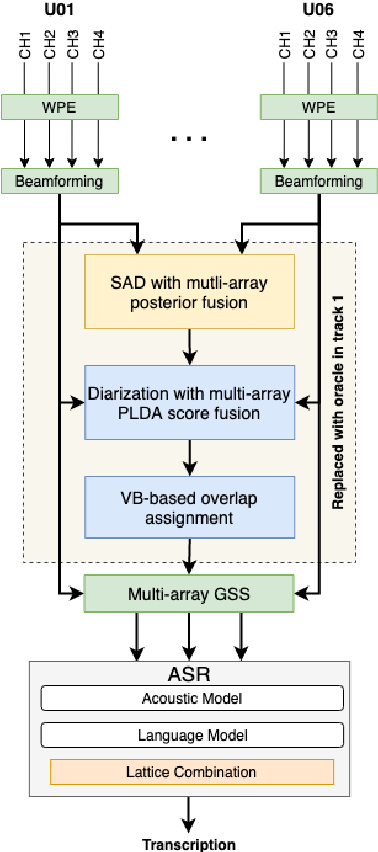
Figure 1 from The JHU Multi-Microphone Multi-Speaker ASR System for the ...

174_Token Level Serialized Output Training for Joint Streaming ASR and ...

Figure 1 from Cascaded encoders for fine-tuning ASR models on ...
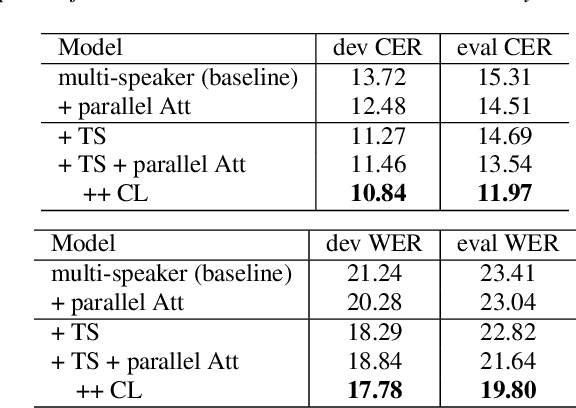
Figure 1 from Knowledge Distillation for End-to-End Monaural Multi ...

Figure 1 from Multi-Speaker ASR Combining Non-Autoregressive Conformer ...
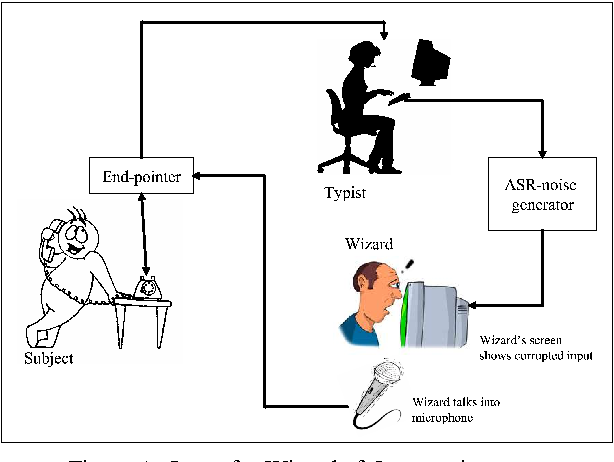
Figure 1 from A framework for dialogue data collection with a simulated ...

Figure 1 from Can We Really Repurpose Multi-Speaker ASR Corpus for ...

Figure 1 from Streaming End-to-End Multi-Talker Speech Recognition ...
Advertisement Space (336x280)
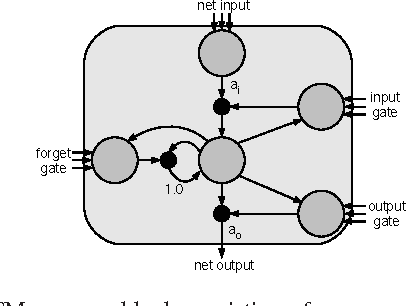
Figure 1 from A multi-stream ASR framework for BLSTM modeling of ...

Figure 1 from Adapting Multi-Lingual ASR Models for Handling Multiple ...

Figure 1 from Robust Front-End for Multi-Channel ASR using Flow-Based ...

Figure 1 from Anatomy of Industrial Scale Multilingual ASR | Semantic ...
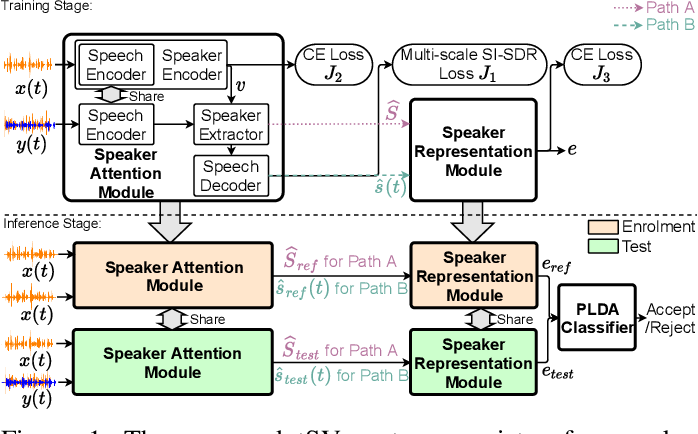
Figure 1 from Target Speaker Verification With Selective Auditory ...

Figure 1 from Single-Channel Multi-talker Speech Recognition with ...