
Figure 1 From Token Label Alignment For Vision Transformers Semantic

Figure 1 from Token-Label Alignment for Vision Transformers | Semantic ...

Figure 1 from Safety Alignment for Vision Language Models | Semantic ...
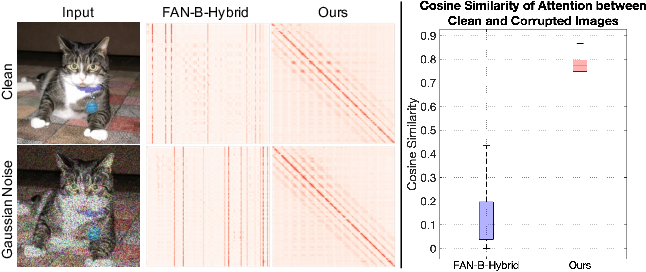
Figure 1 from Robustifying Token Attention for Vision Transformers ...

Figure 1 from Token Pooling in Vision Transformers for Image ...

Figure 2 from Token-Label Alignment for Vision Transformers | Semantic ...
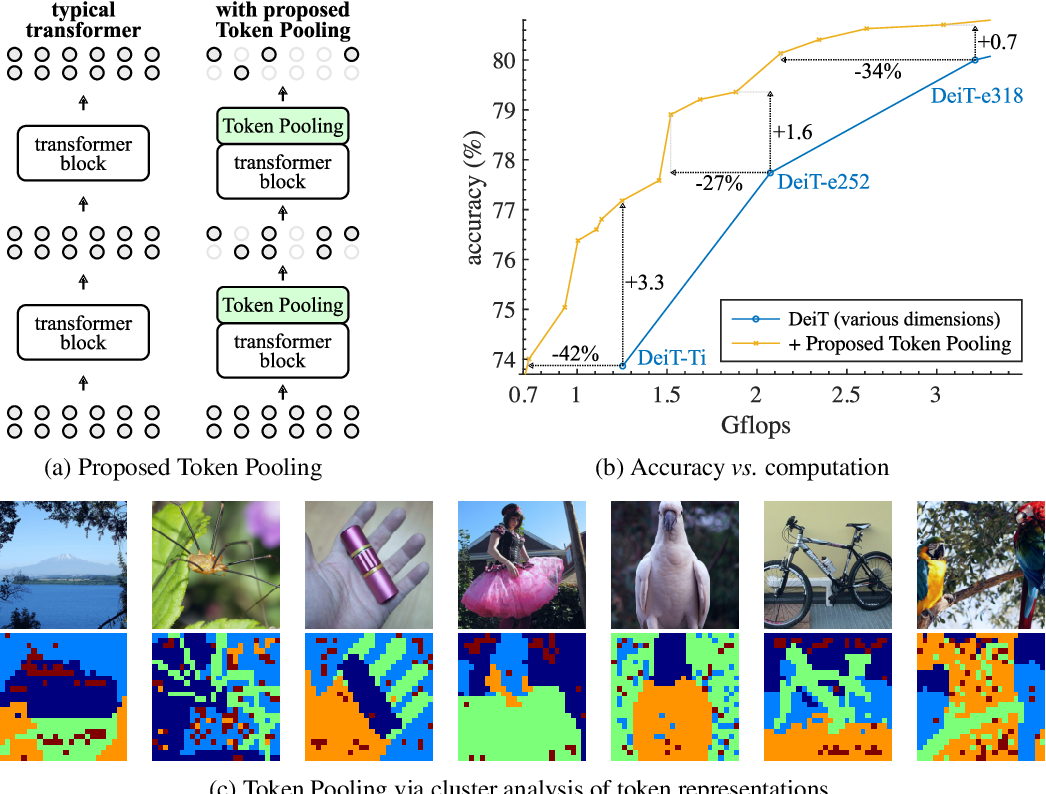
Figure 1 from Token Pooling in Vision Transformers | Semantic Scholar

Figure 1 from Content-aware Token Sharing for Efficient Semantic ...

Figure 1 from Positional Label for Self-Supervised Vision Transformer ...

Figure 1 from Content-aware Token Sharing for Efficient Semantic ...

Figure 1 from PPT: Token Pruning and Pooling for Efficient Vision ...
Advertisement Space (300x250)

Figure 1 from Token and Head Adaptive Transformers for Efficient ...

Table 2 from Token-Label Alignment for Vision Transformers | Semantic ...

Figure 1 from Joint Token and Feature Alignment Framework for Text ...

Figure 1 from Exploring Vision Transformer Layer Choosing for Semantic ...

Figure 1 from Learning to Merge Tokens in Vision Transformers ...

Figure 1 from Computationally-Efficient Vision Transformer for Medical ...
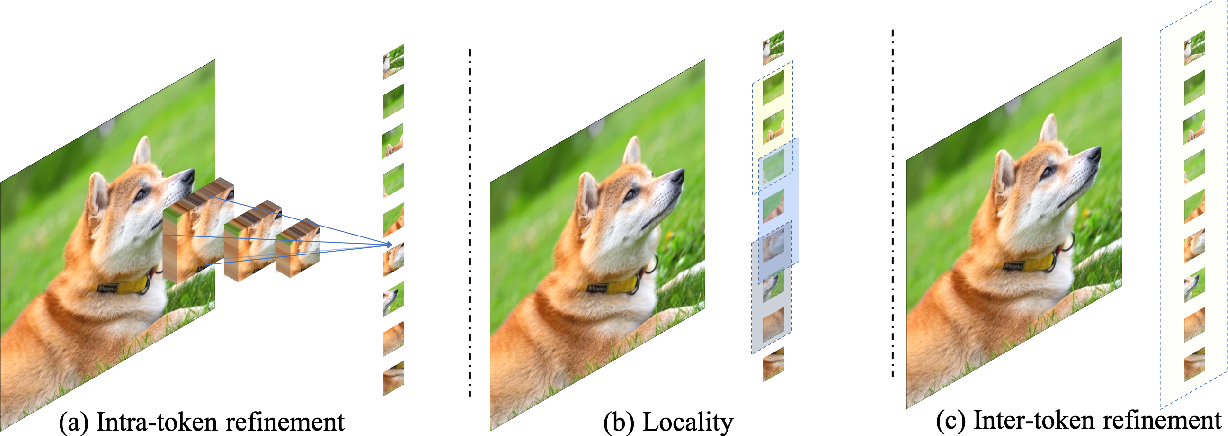
Figure 1 from What Makes for Good Tokenizers in Vision Transformer ...

Figure 1 from Bidirectional Alignment for Domain Adaptive Detection ...
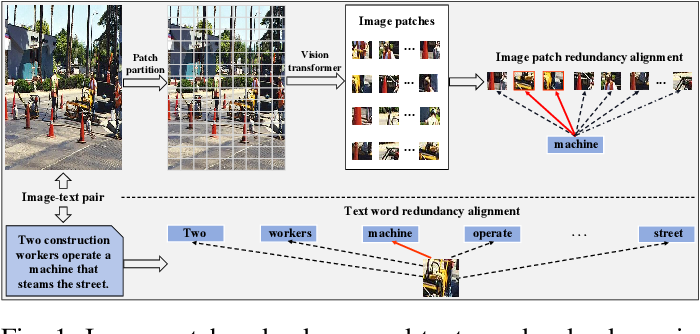
Figure 1 from Enhancing Cross-modal Semantic Consistency via Key Token ...

(PDF) Dynamic Token Pruning in Plain Vision Transformers for Semantic ...
Advertisement Space (336x280)
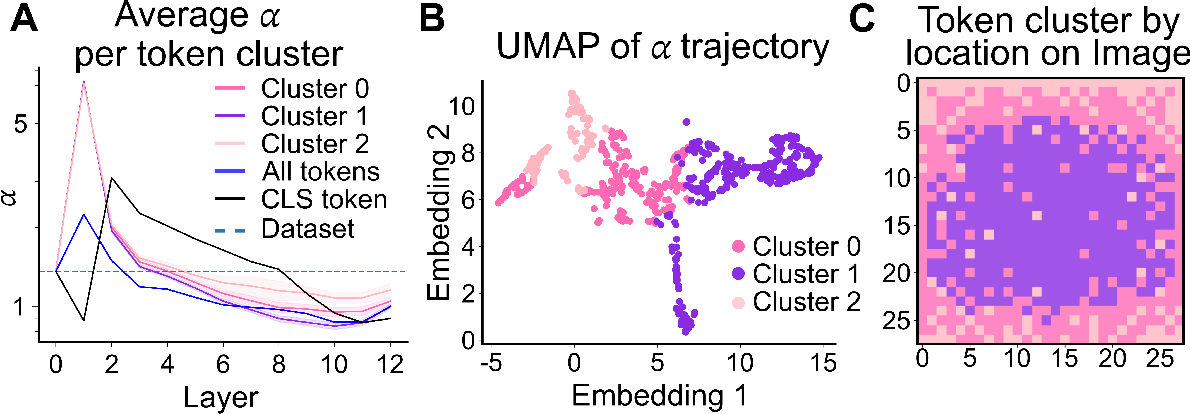
Figure 1 from On the Information Geometry of Vision Transformers ...

Figure 1 from Learning to Merge Tokens in Vision Transformers ...

Figure 1 from Semantic Segmentation using Vision Transformers: A survey ...
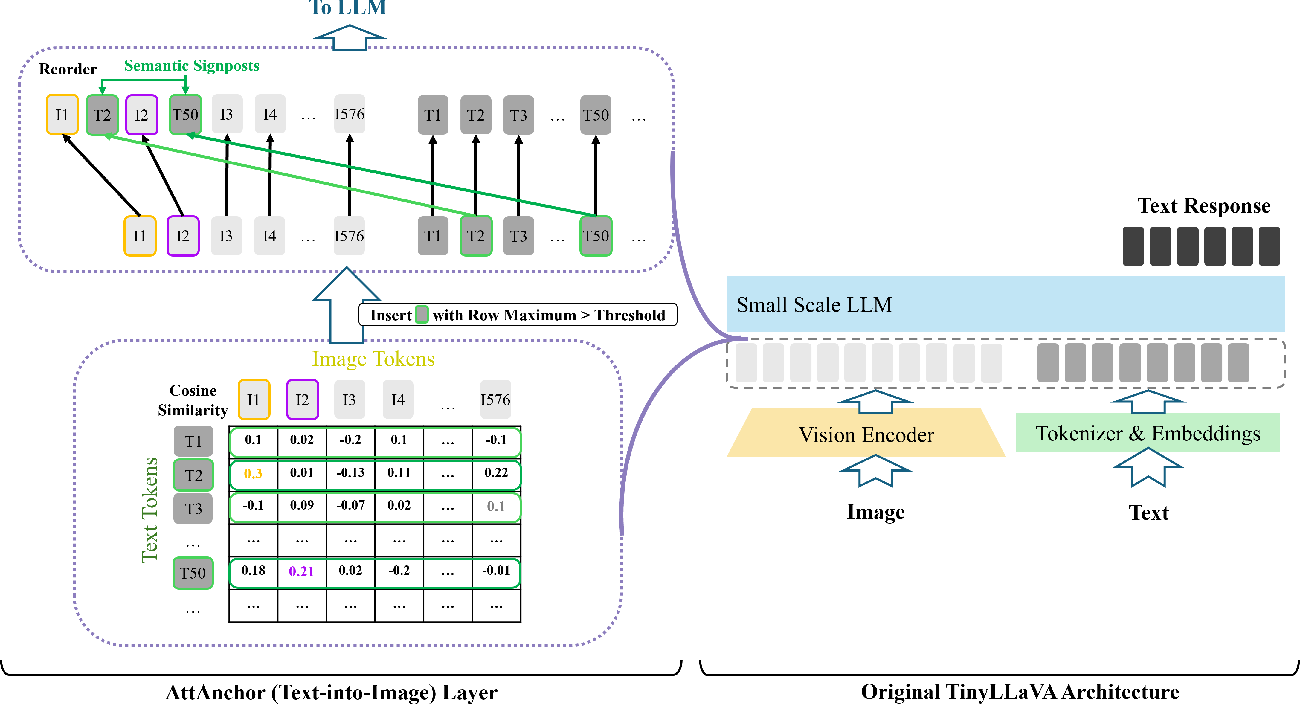
Figure 1 from AttAnchor: Guiding Cross-Modal Token Alignment in VLMs ...

Figure 1 from Cross Attention with Monotonic Alignment for Speech ...

Figure 1 from Textual Tokens Classification for Multi-Modal Alignment ...

Figure 1 from Motor Imagery EEG Recognition Based on Label Alignment ...
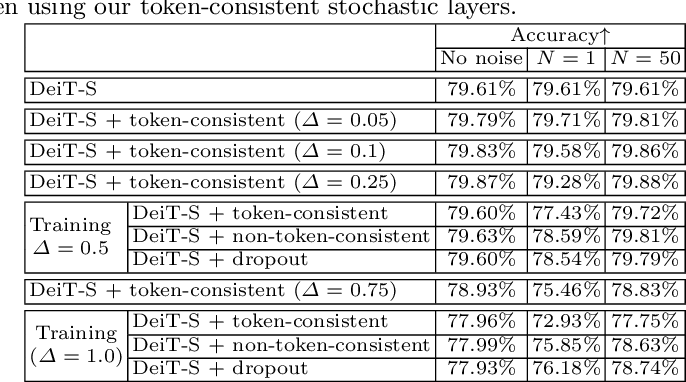
Table 1 from Improving the Behaviour of Vision Transformers with Token ...
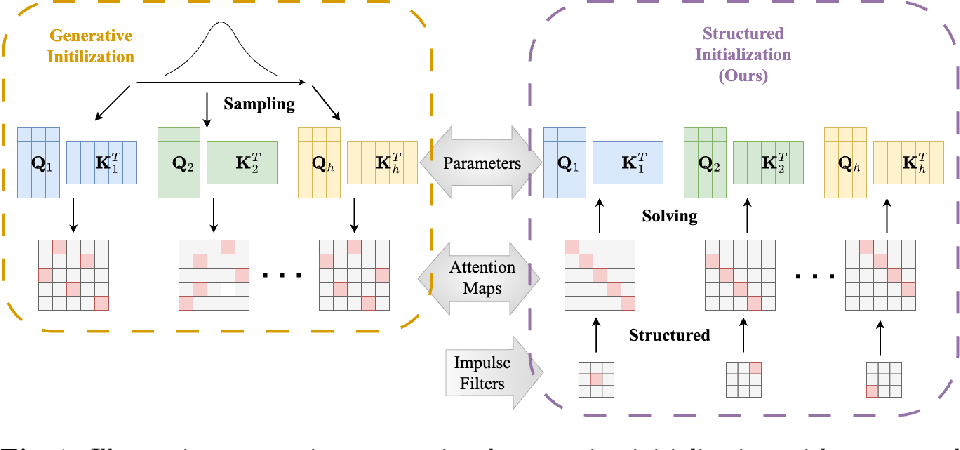
Figure 1 from Structured Initialization for Attention in Vision ...

Figure 1 from Enhancing Vision-Language Model with Unmasked Token ...
Advertisement Space (336x280)
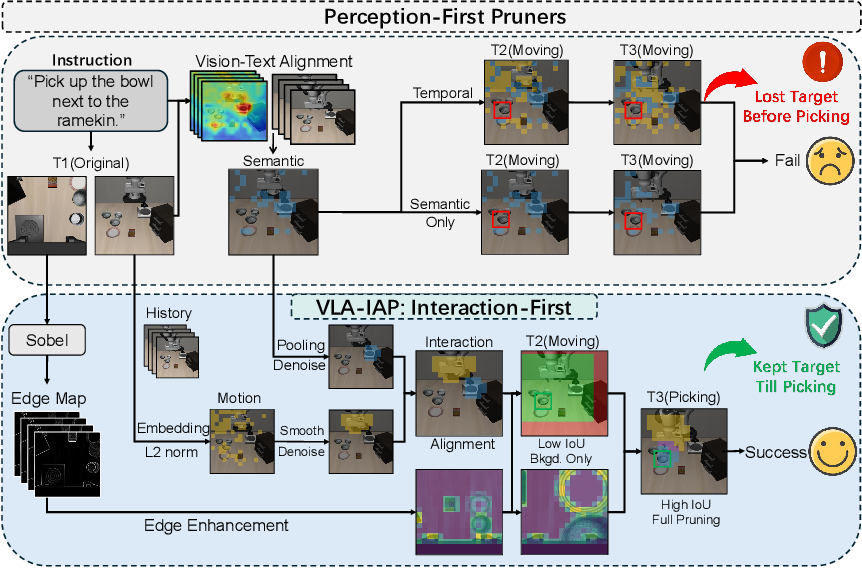
Figure 1 from VLA-IAP: Training-Free Visual Token Pruning via ...
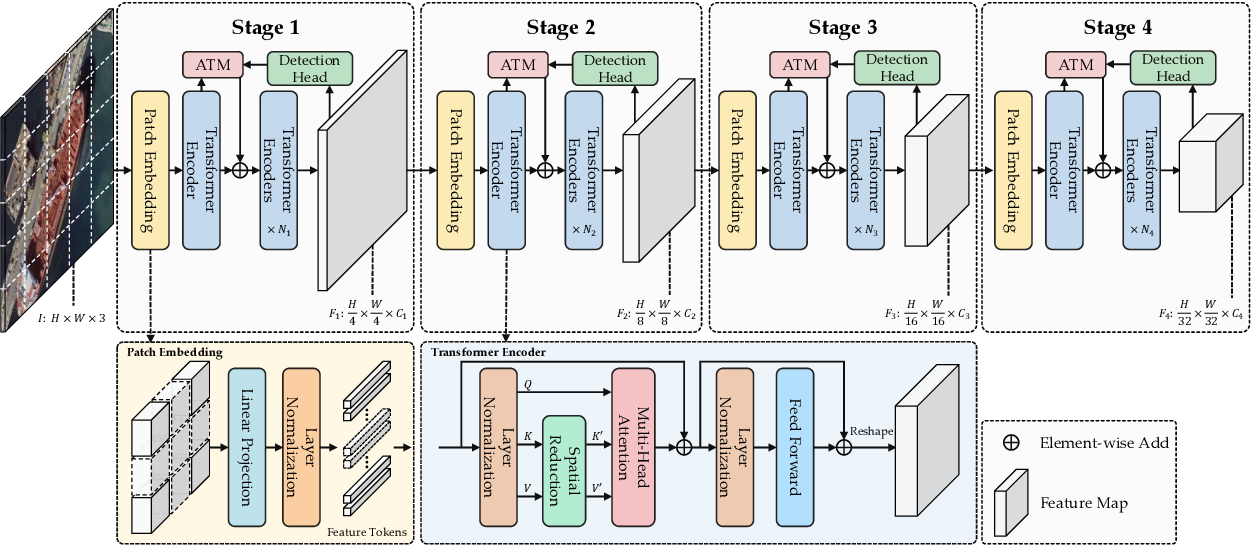
Figure 1 from Angle Tokenization Guided Multi-Scale Vision Transformer ...
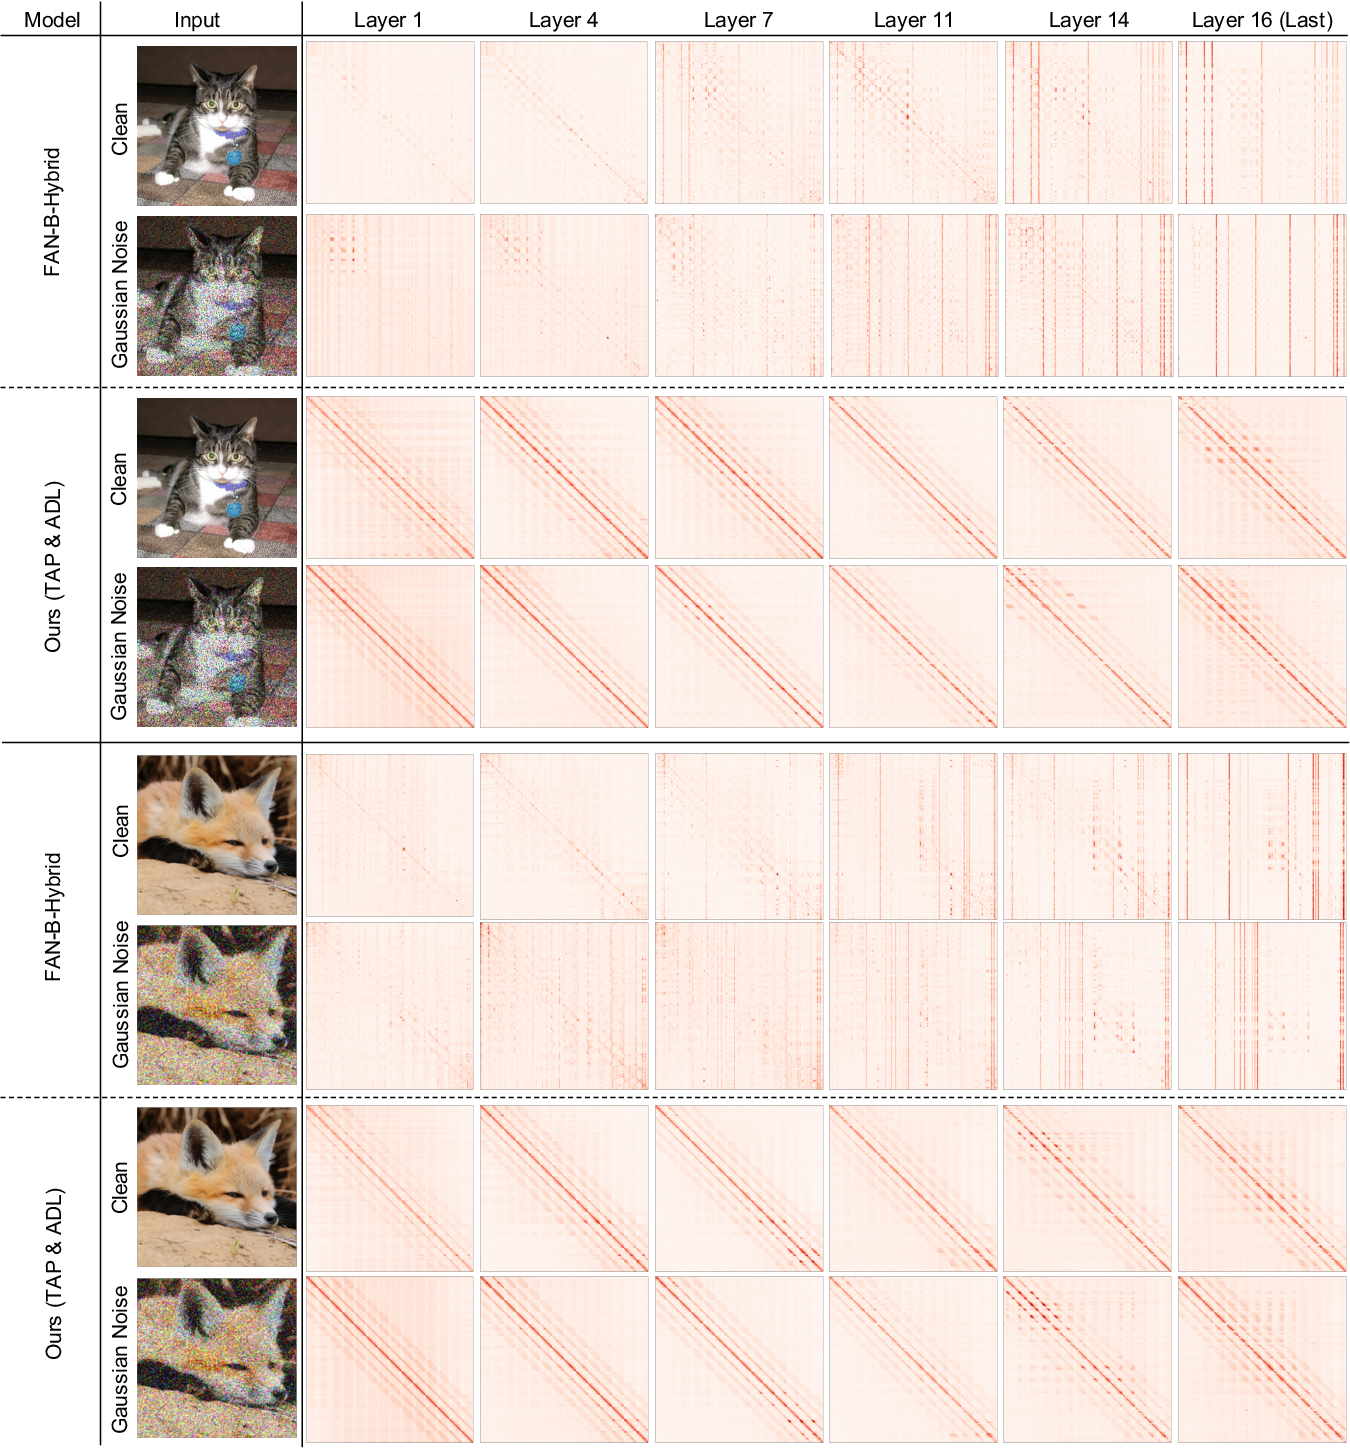
Figure I from Supplementary Materials for “Robustifying Token Attention ...

CVPR2023 Making Vision Transformers Efficient from A Token ...
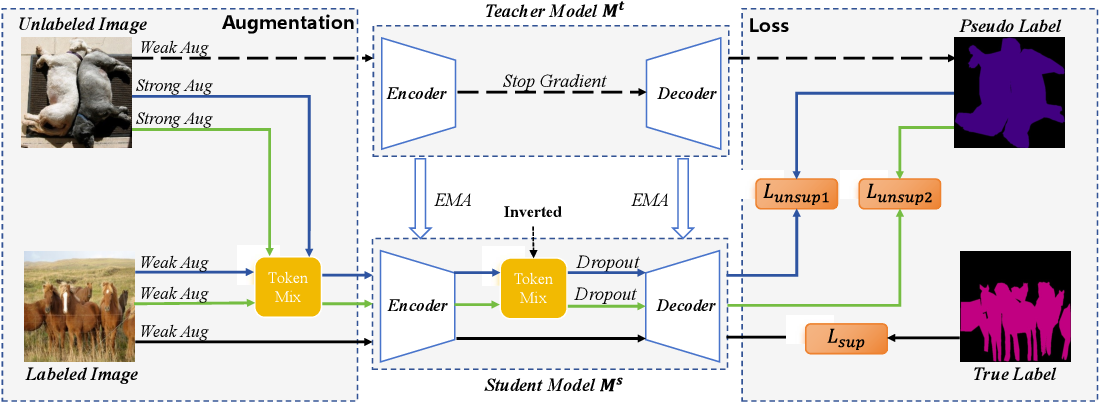
Figure 1 from Exploring Token-Level Augmentation in Vision Transformer ...

Figure 1 from Interpreting and Controlling Vision Foundation Models via ...