
Figure 2 From Disentangled Speaker And Nuisance Attribute Embedding For
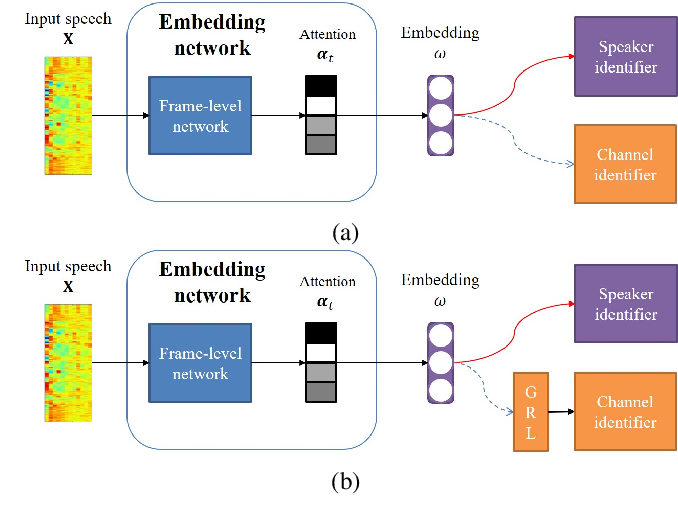
Figure 2 from Disentangled Speaker and Nuisance Attribute Embedding for ...

Figure 1 from Disentangled Speaker and Nuisance Attribute Embedding for ...

(PDF) Disentangled Speaker and Nuisance Attribute Embedding for Robust ...

Figure 2 from Joint Speech-Text Embeddings with Disentangled Speaker ...
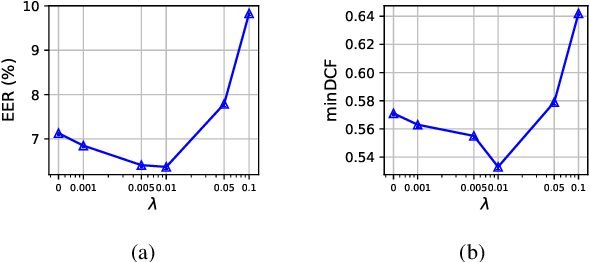
Figure 2 from Contrastive Speaker Embedding With Sequential ...
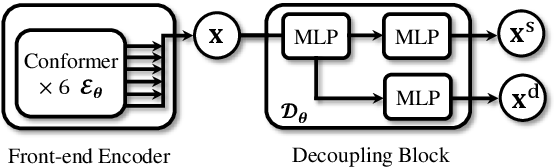
Figure 2 from Disentangled Speaker Representation Learning via Mutual ...

Figure 1 from DEAAN: Disentangled Embedding and Adversarial Adaptation ...
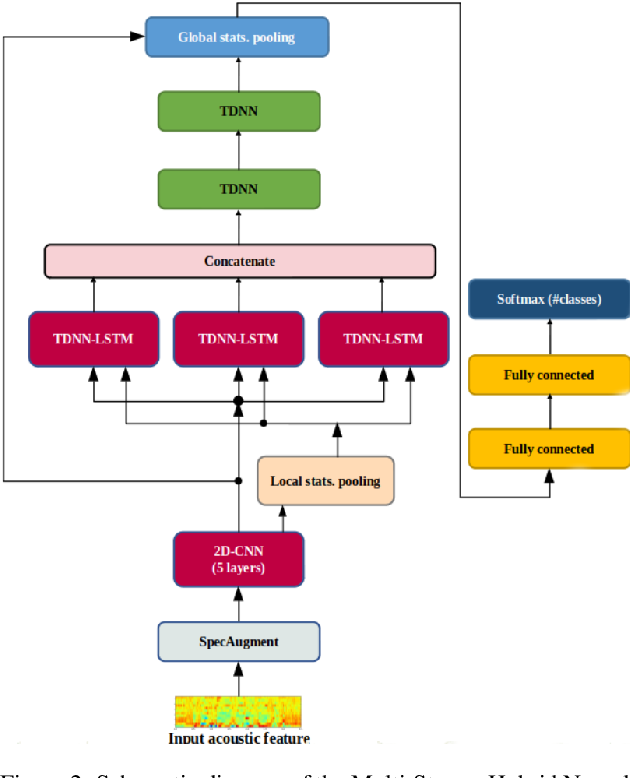
Figure 2 from Investigation on Deep Speaker Embedding Extraction ...

Figure 2 from Transport-Oriented Feature Aggregation for Speaker ...

Figure 2 from DR2: Disentangled Recurrent Representation Learning for ...
Advertisement Space (300x250)
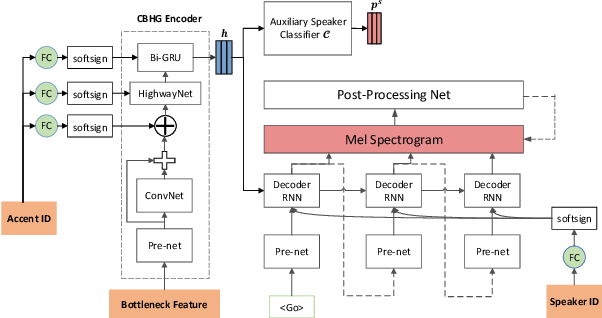
Figure 2 from Accent and Speaker Disentanglement in Many-to-many Voice ...
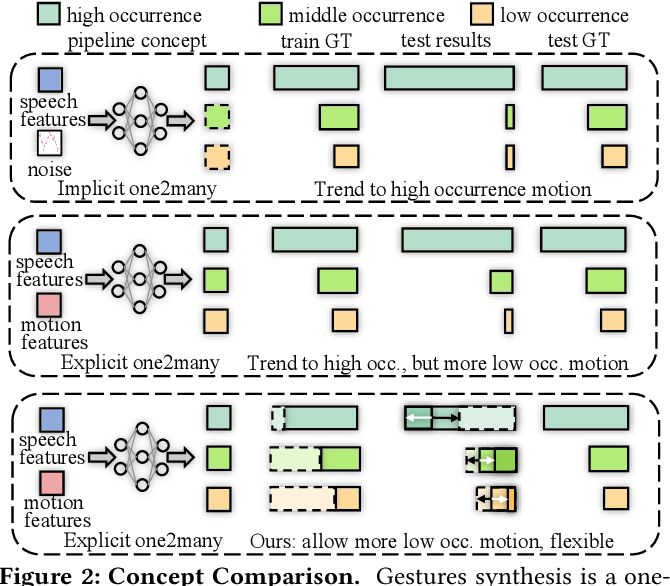
Figure 2 from DisCo: Disentangled Implicit Content and Rhythm Learning ...

Figure 2 from Self-Supervised Disentangled Representation Learning for ...

Figure 2 from Disentangled Federated Learning for Tackling Attributes ...

Figure 2 from Neural Noise Embedding for End-To-End Speech Enhancement ...

[PDF] Disentangled Speaker Embedding for Robust Speaker Verification ...
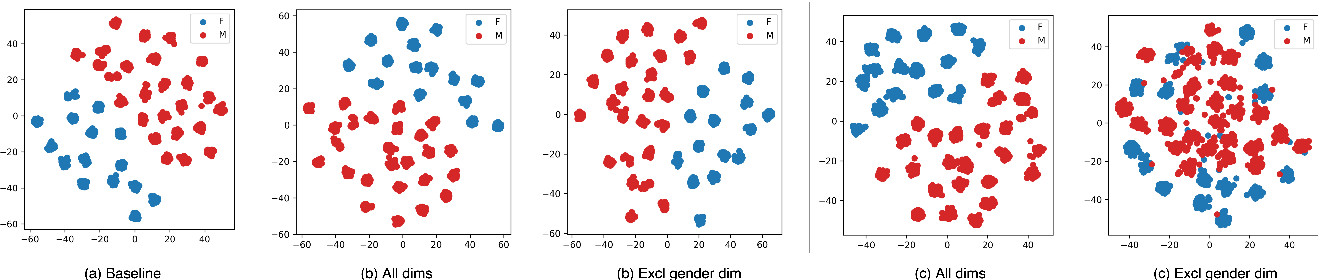
Figure 2 from Investigating the contribution of speaker attributes to ...
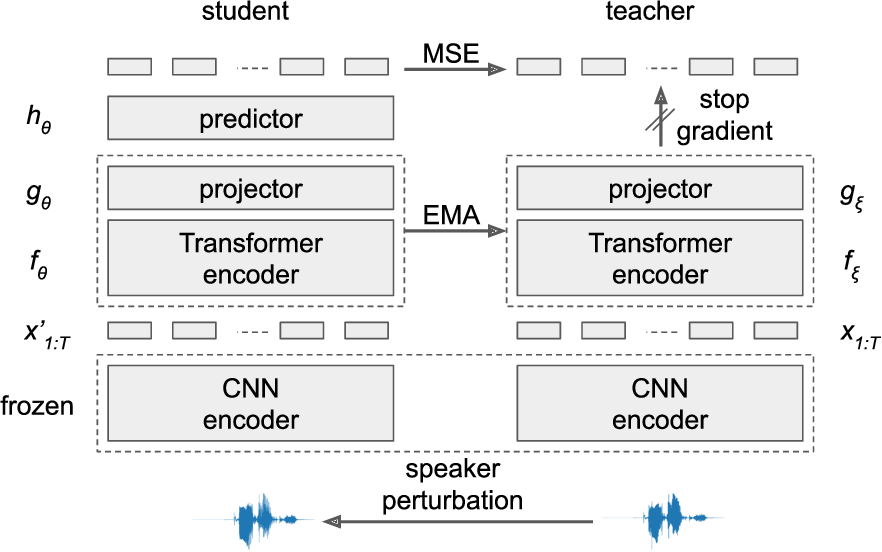
Figure 2 from Self-Supervised Syllable Discovery Based on Speaker ...

Figure 1 from Domain Generalized Speaker Embedding Learning via Mutual ...

Figure 2 from Multi-Scale Speaker Embedding-Based Graph Attention ...
Advertisement Space (336x280)

[PDF] Disentangled Speaker Embedding for Robust Speaker Verification ...
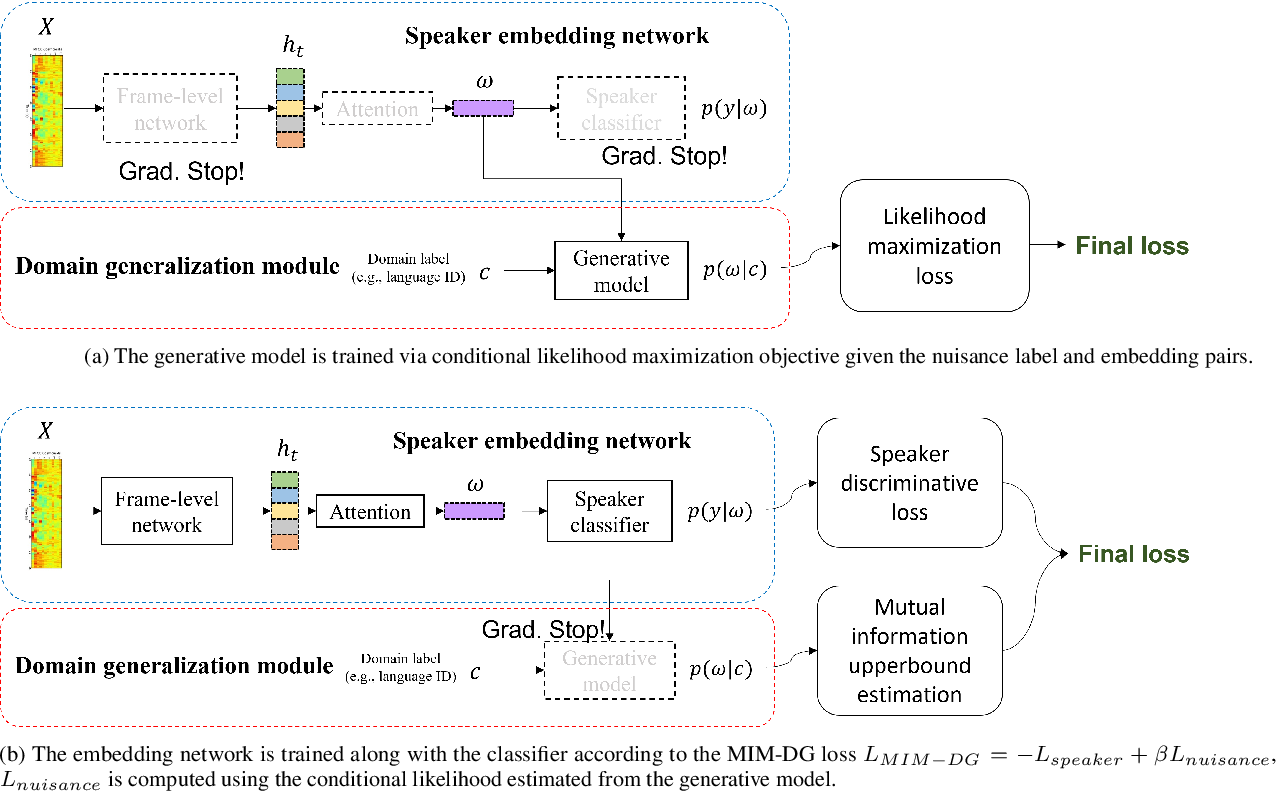
Figure 1 from Domain Generalized Speaker Embedding Learning via Mutual ...

Figure 1 from Domain Generalized Speaker Embedding Learning via Mutual ...
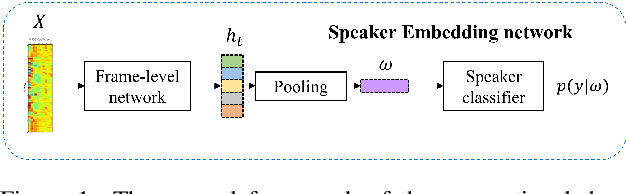
Figure 1 from Domain Generalized Speaker Embedding Learning via Mutual ...

Figure 1 from Vision-Guided Speaker Embedding Based Speech Separation ...
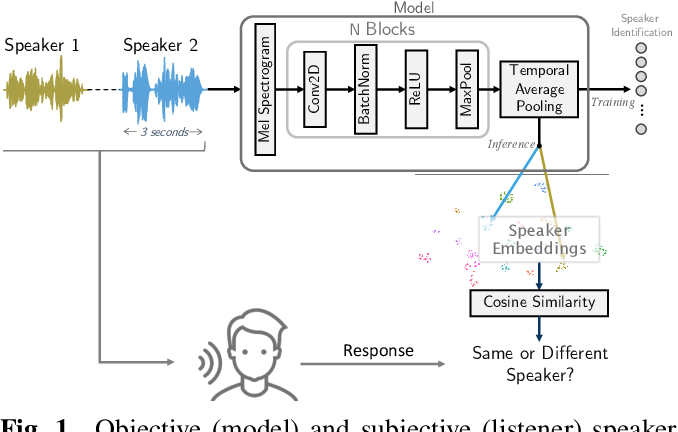
Figure 1 from Perceptual Analysis of Speaker Embeddings for Voice ...

Figure 1 from Disentangled dimensionality reduction for noise-robust ...
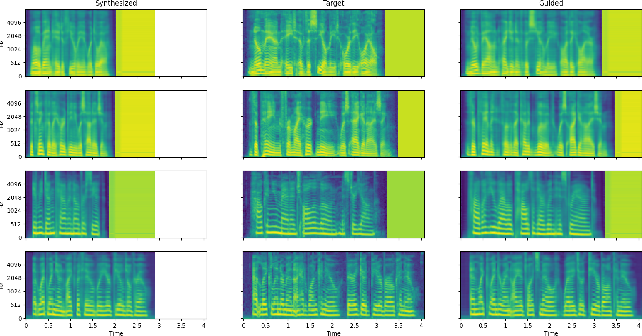
Figure 3 from Joint Speech-Text Embeddings with Disentangled Speaker ...
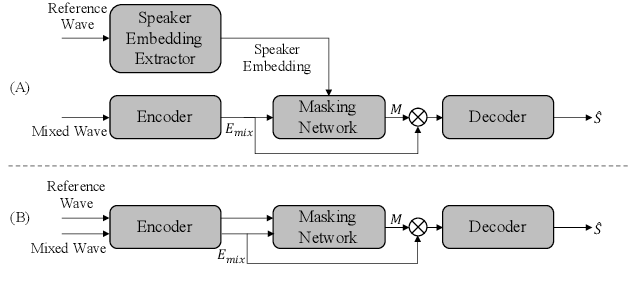
Figure 1 from SEF-Net: Speaker Embedding Free Target Speaker Extraction ...

Figure 1 from Joint Speech-Text Embeddings with Disentangled Speaker ...
Advertisement Space (336x280)
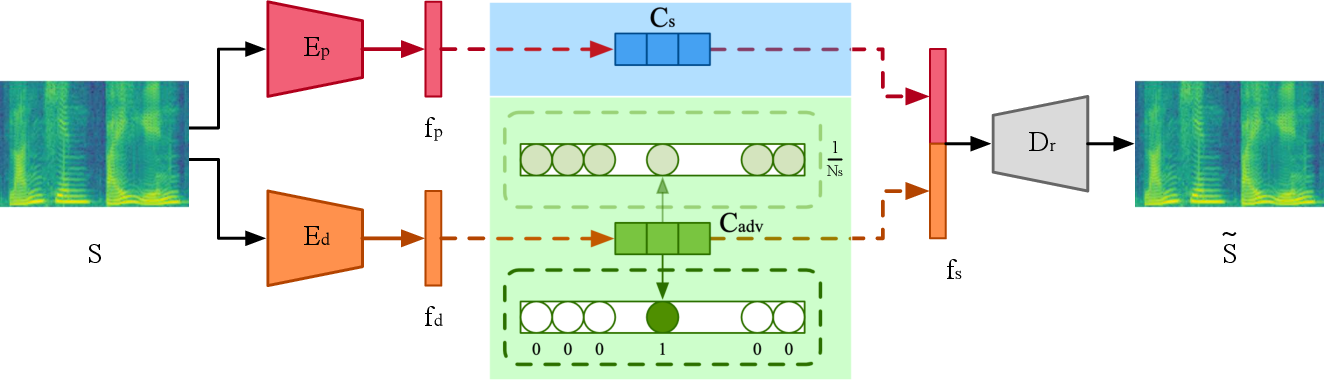
Figure 1 from Powerful Speaker Embedding Training Framework by ...
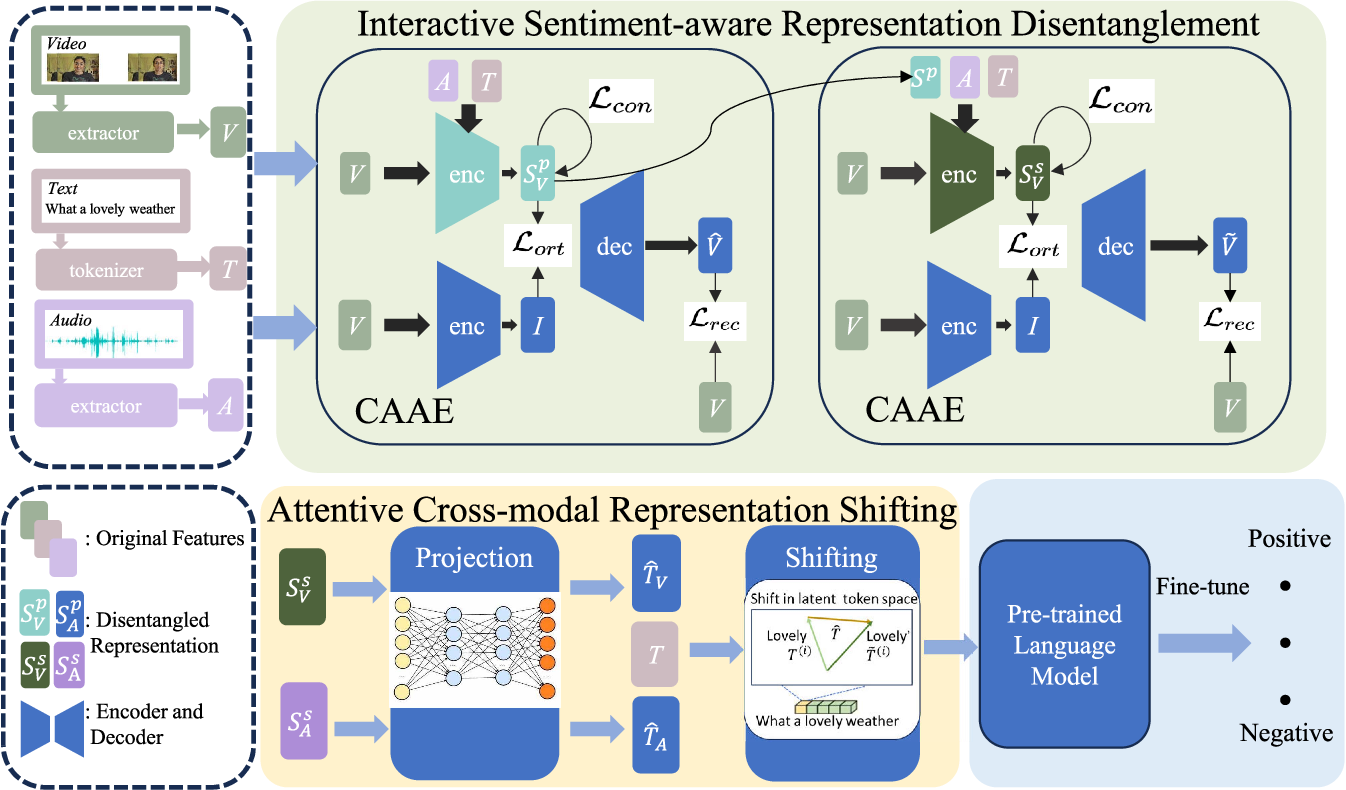
Figure 2 from SDRS: Sentiment-Aware Disentangled Representation ...
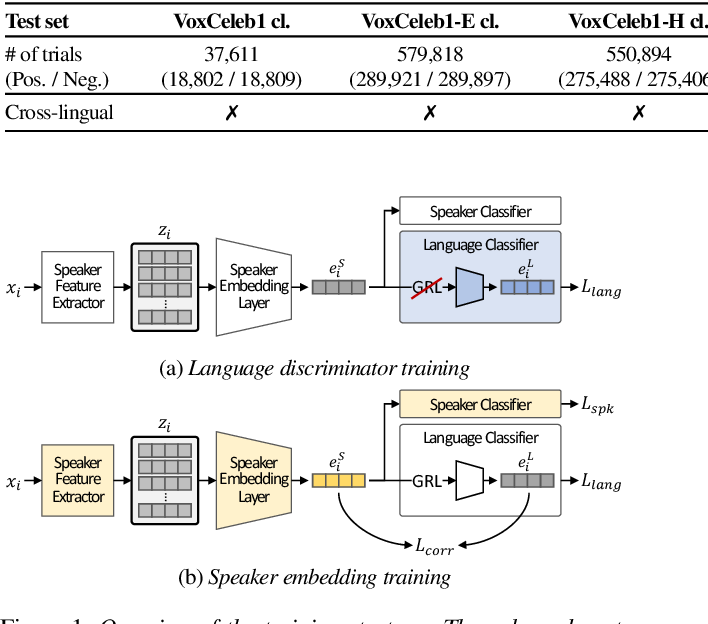
Figure 1 from Disentangled representation learning for multilingual ...

Figure 2 from Target Speaker Voice Activity Detection with Transformers ...

Figure 1 from Channel Invariant Speaker Embedding Learning with Joint ...

Figure 1 from A Disentangled Recurrent Variational Autoencoder for ...