
Multi Head Latent Attention Latent Kv Cache Deepseek V3 Lechuck Park
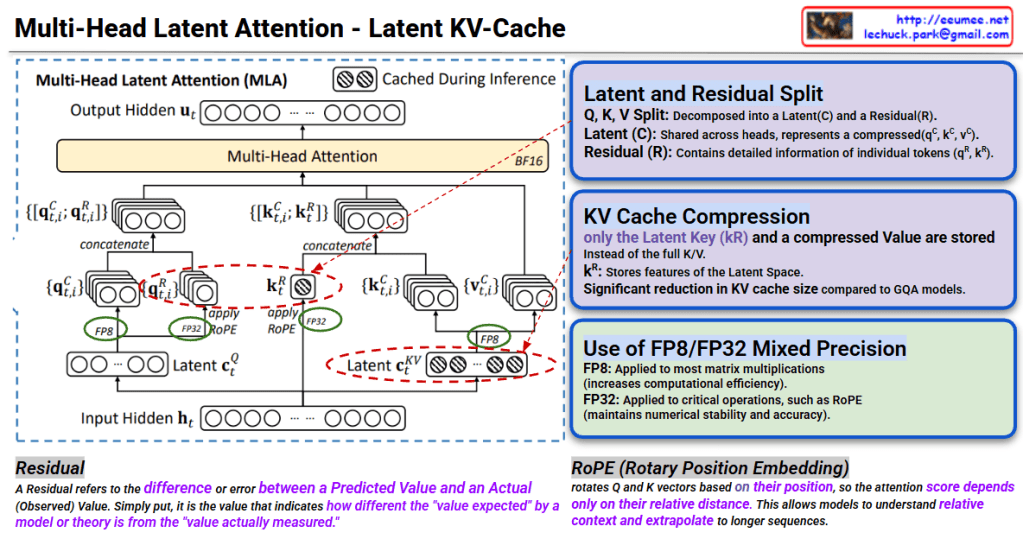
Multi-Head Latent Attention – Latent KV-Cache (DeepSeek v3) – Lechuck Park
KV Cache Optimization via Multi-Head Latent Attention - PyImageSearch ...
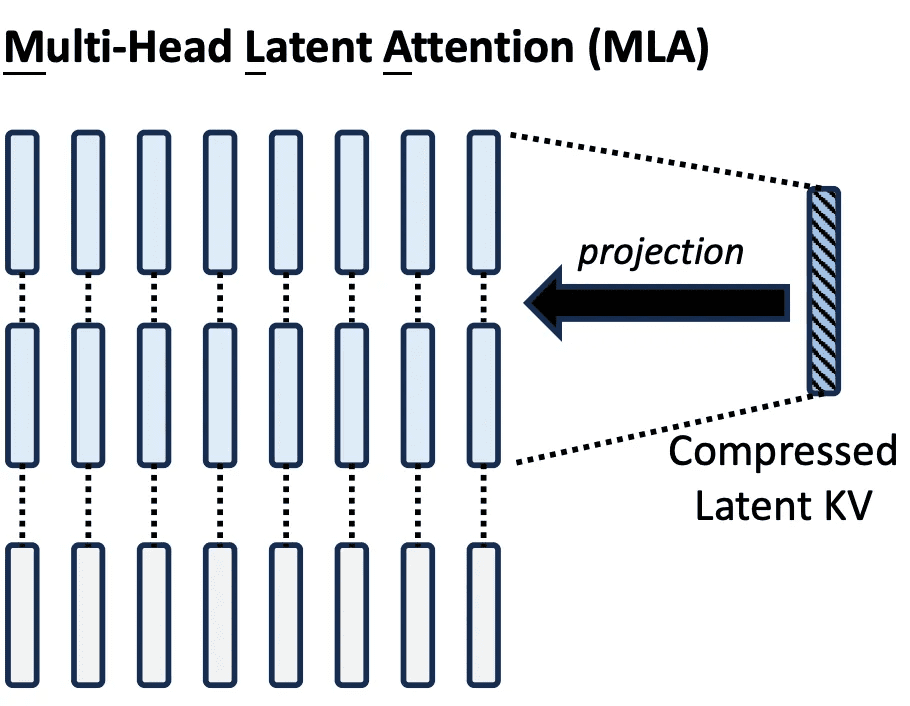
KV Cache Optimization via Multi-Head Latent Attention - PyImageSearch
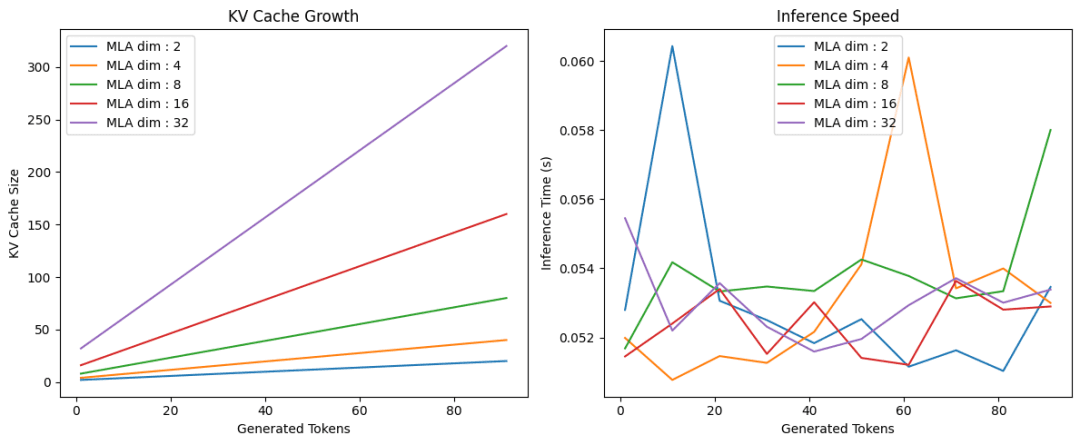
KV Cache Optimization via Multi-Head Latent Attention - PyImageSearch
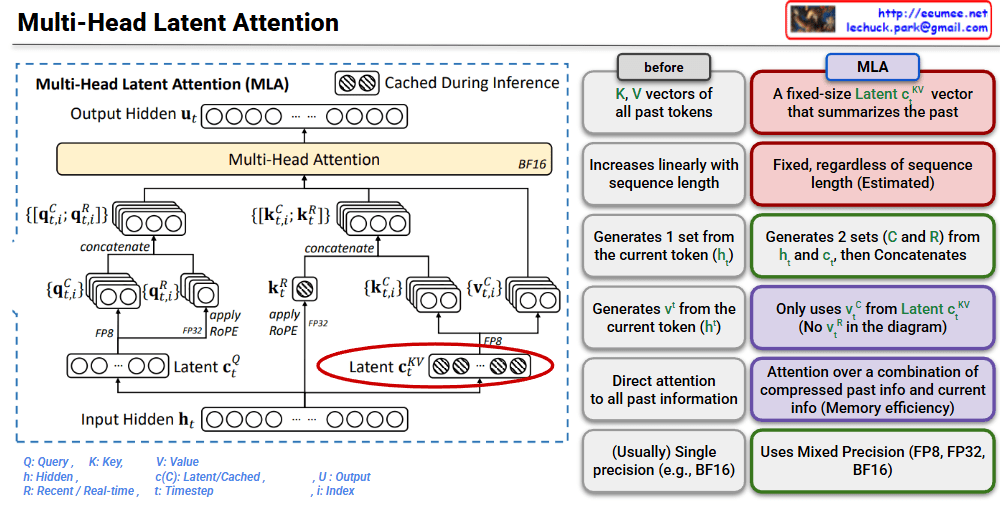
Multi-Head Latent Attention – Changes – Lechuck Park

DeepSeek Multihead Latent Attention - YouTube

DeepSeek + SGLang: Multi-Head Latent Attention

Multi-Head Latent Attention — 토큰당 shared latent로 KV 캐시를 줄이는 원리 - Zero ...

Three Interpretations of DeepSeek V2's Multi-headed Latent Attention Layer

Inside DeepSeek V3: Breaking Down Multi-Head Latent Attention (MLA ...
Advertisement Space (300x250)

DeepSeek-V3 Explained 1: Multi-head Latent Attention | Towards Data Science

[论文评述] Hardware-Centric Analysis of DeepSeek's Multi-Head Latent Attention
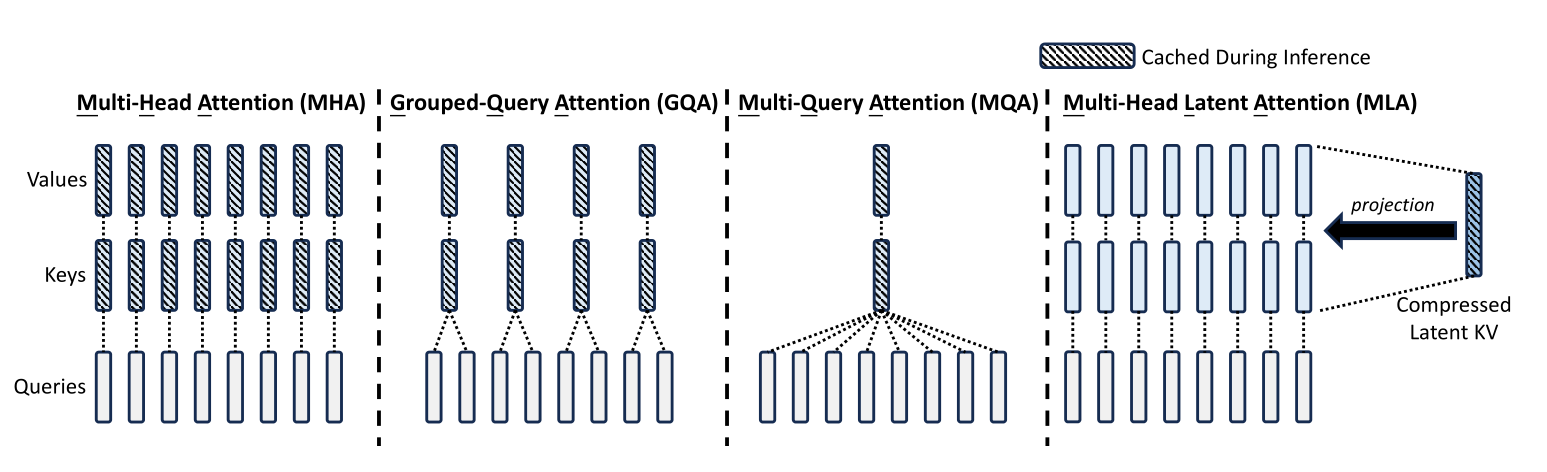
DeepSeek's Multi-Head Latent Attention - Lior Sinai
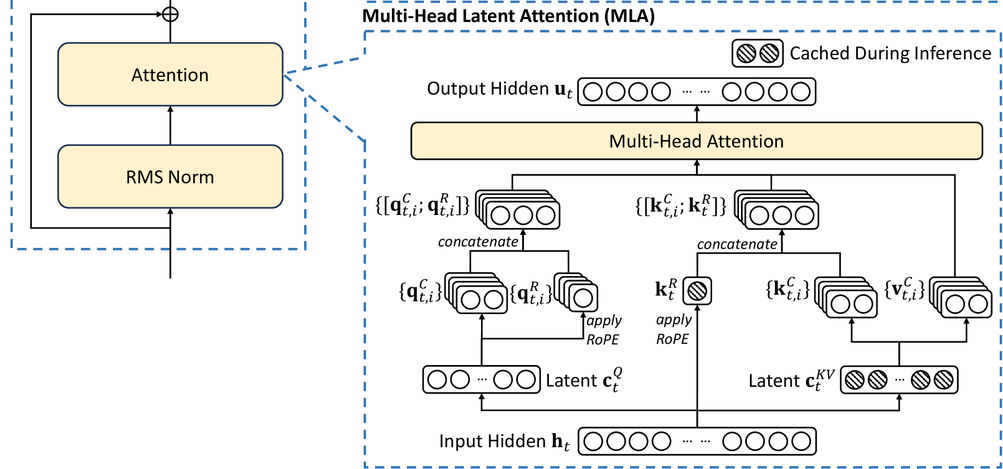
DeepSeek-V3 论文解读:MLA, Multi-Head Latent Attention – remaper

DeepSeek Series: A Comprehensive Deep Dive into Multi-Head Latent ...

How DeepSeek's Multi-Head Latent Attention Changed the Game - YouTube

DeepSeek-V3 Explained 1: Multi-head Latent Attention | Towards Data Science

DeepSeek 注意力之 MLA(Multi-Head Latent Attention) - 知乎

DeepSeek-V3 Explained 1: Multi-head Latent Attention | Towards Data Science

DeepSeek-V3 Explained 1: Multi-head Latent Attention | Towards Data Science
Advertisement Space (336x280)

DeepSeek-V3 Explained 1: Multi-head Latent Attention | Towards Data Science

DeepSeek-V3 Explained 1: Multi-head Latent Attention | Towards Data Science

Implementing DeepSeek-V2’s Multi-Head Latent Attention (MLA) from ...

DeepSeek-V3 Explained 1: Multi-head Latent Attention | Towards Data Science

[논문 리뷰] Multi-head Temporal Latent Attention

(PDF) Hardware-Centric Analysis of DeepSeek's Multi-Head Latent Attention

Multi-Head Latent Attention: DeepSeek V2/V3 Engineering View | Xu'Blog

Multi-Head Latent Attention Explained Simply - YouTube
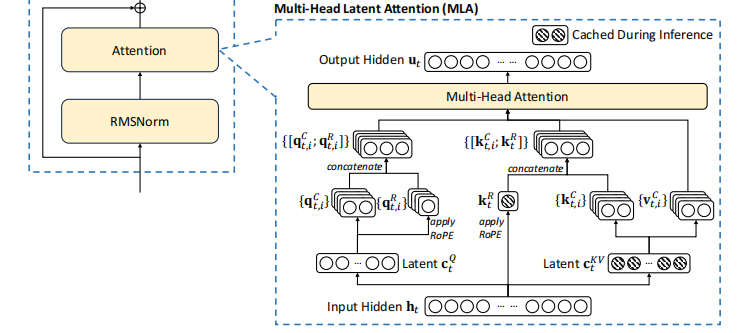
Multi-Head Latent Attention (MLA) 详细介绍(来自Deepseek V3的回答) - 知乎
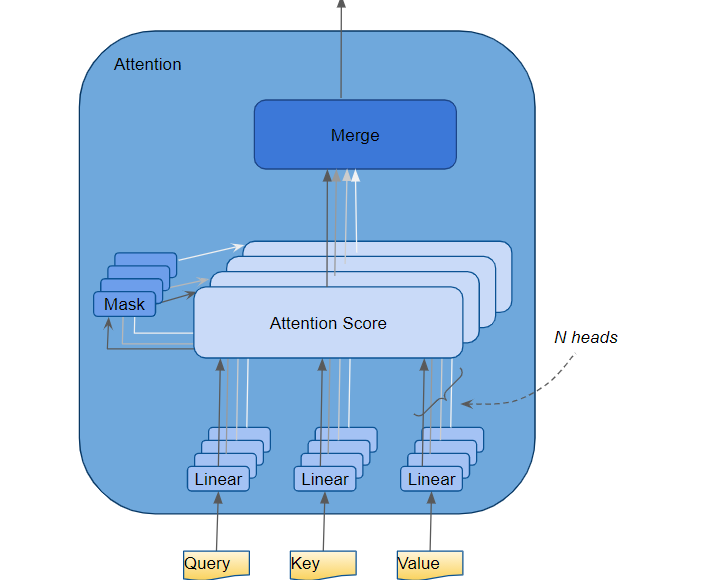
Deepseek 이해하기 (1) - MLA (Multi-Head Latent Attention)
Advertisement Space (336x280)

LLM Architecture Explained: DeepSeek V3 vs Llama 4 (MLA vs GQA 2025 ...

A Technical Tour of the DeepSeek Models from V3 to V3.2

资讯 | Deepseek-V2多头潜在注意力(Multi-head Latent Attention)原理及PyTorch实现 - 智源社区
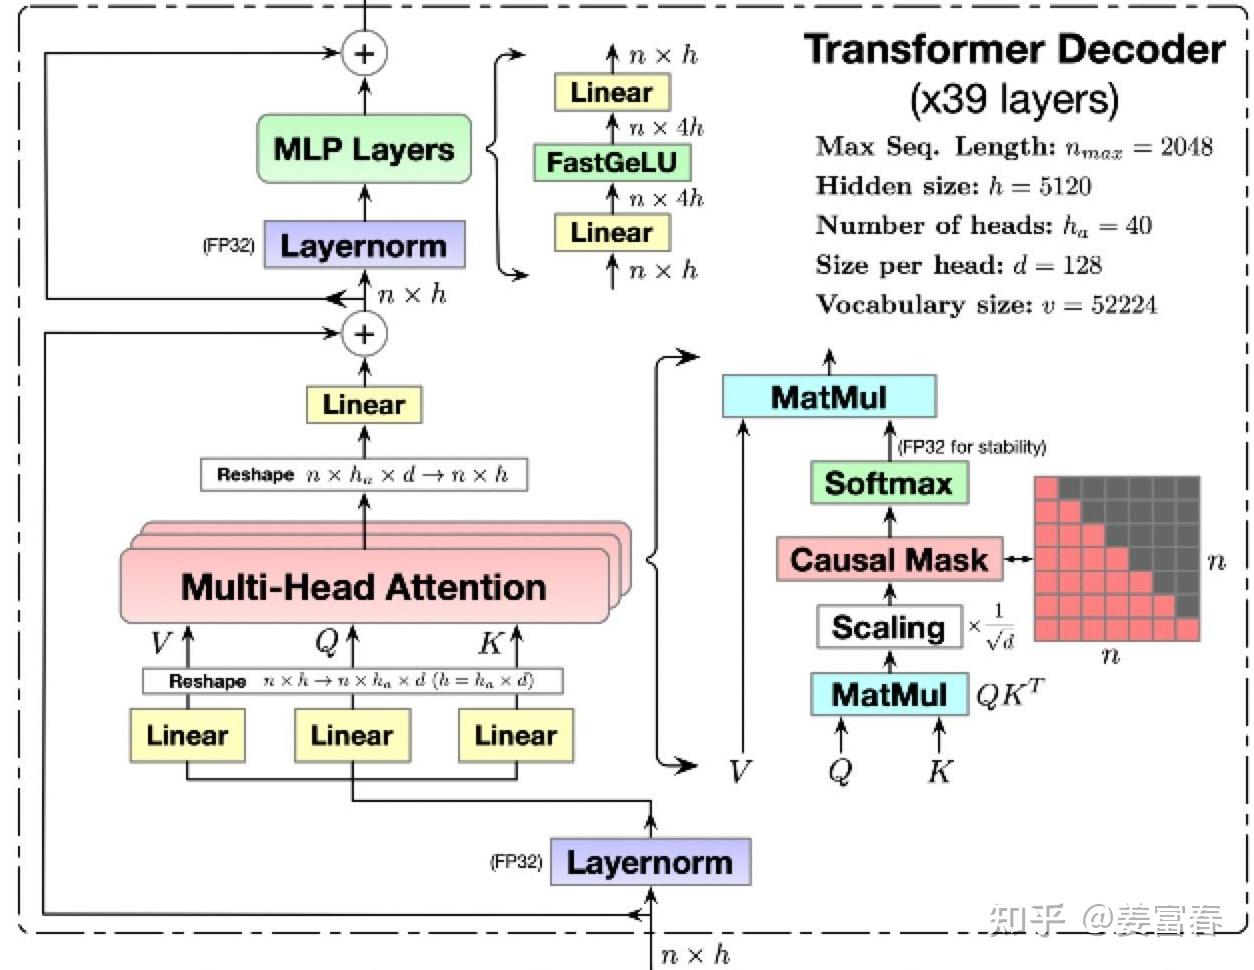
deepseek技术解读(1)-彻底理解MLA(Multi-Head Latent Attention) - 知乎
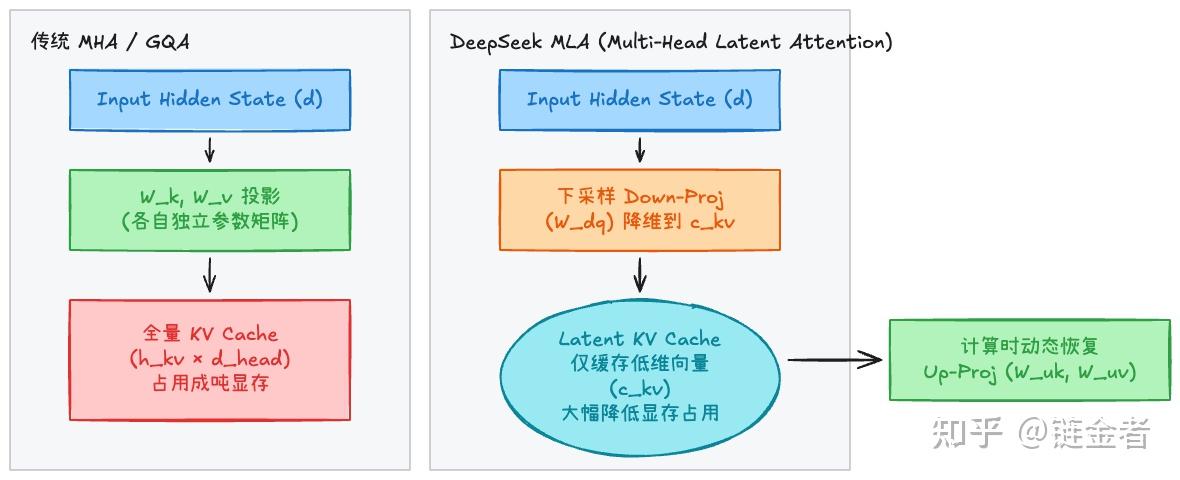
混合注意力(Hybrid Attention)为什么爆发?——从 KV Cache 成本账本到工程落地 MLA / MoBA 的万字图解 - 知乎
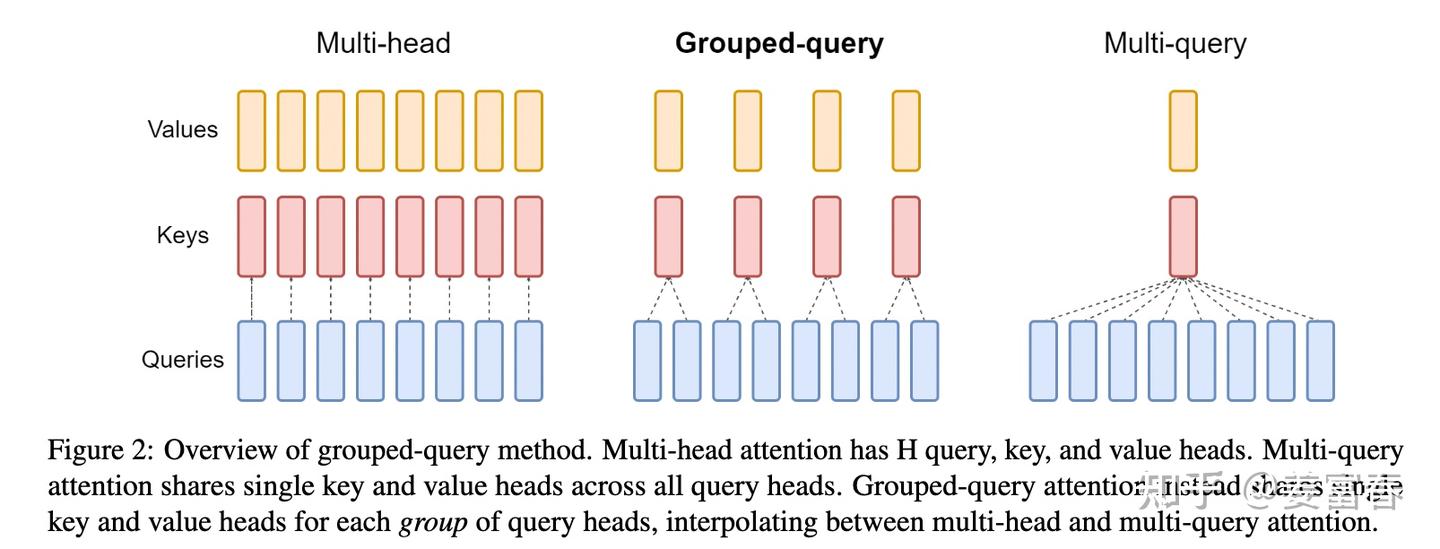
deepseek技术解读(1)-彻底理解MLA(Multi-Head Latent Attention) - 知乎