
Paper Page Bottleneck Transformers For Visual Recognition

Paper page - Bottleneck Transformers for Visual Recognition
draw the paper bottleneck transformers for visual recognition Prompts ...

draw the paper bottleneck transformers for visual recognition Prompts ...
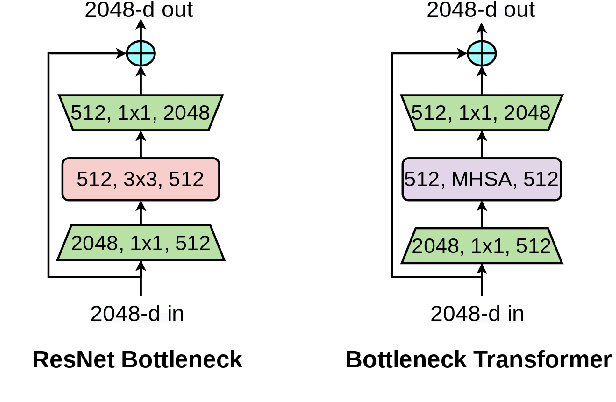
Figure 1 from Bottleneck Transformers for Visual Recognition | Semantic ...

Figure 2 from Bottleneck Transformers for Visual Recognition | Semantic ...

Bottleneck Transformers for Visual Recognition
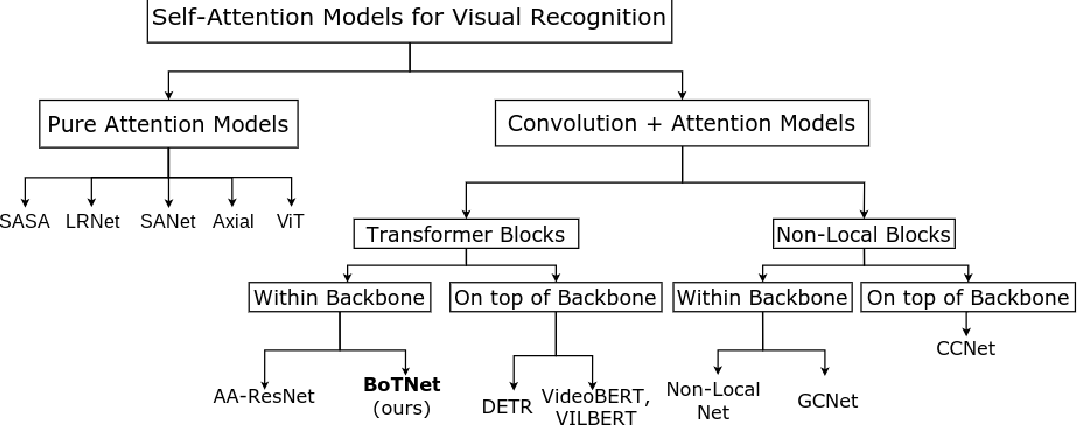
Figure 2 from Bottleneck Transformers for Visual Recognition | Semantic ...

[2101.11605] Bottleneck Transformers For Visual Recognition – ZKRJU

Bottleneck Transformers for Visual Recognition · Issue #64 ...

Bottleneck Transformers for Visual Recognition · Issue #64 ...
Advertisement Space (300x250)
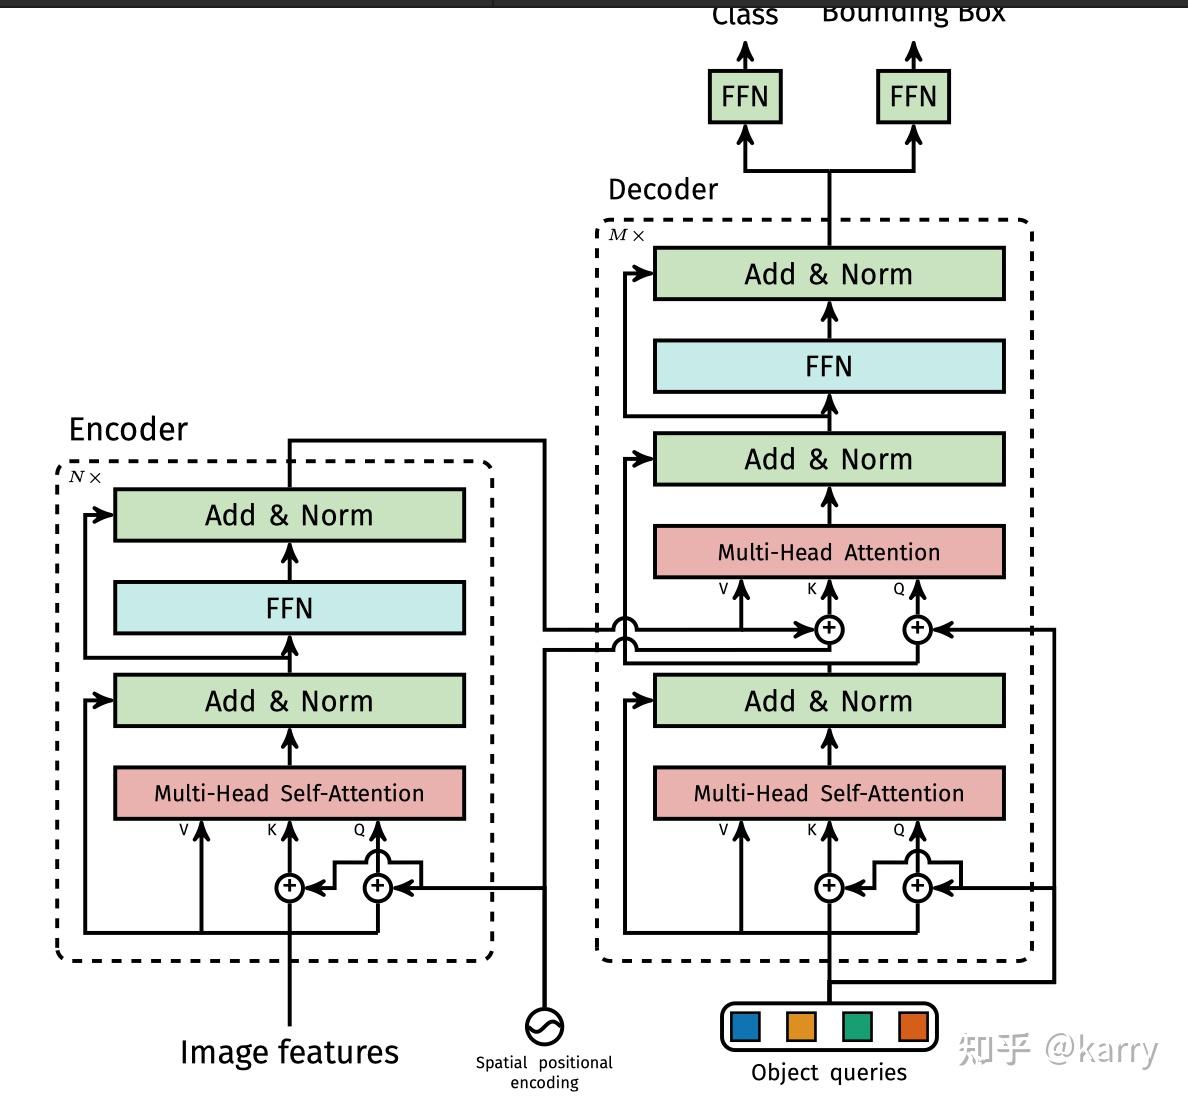
Bottleneck Transformers for Visual Recognition 阅读 - 知乎

Bottleneck Transformers for Visual Recognition · Issue #64 ...

Bottleneck Transformers for Visual Recognition / bottleneck ...

Bottleneck Transformers for Visual Recognition

[2101.11605] Bottleneck Transformers For Visual Recognition – ZKRJU

Bottleneck Transformers for Visual Recognition | DeepAI

[2101.11605] Bottleneck Transformers for Visual Recognition
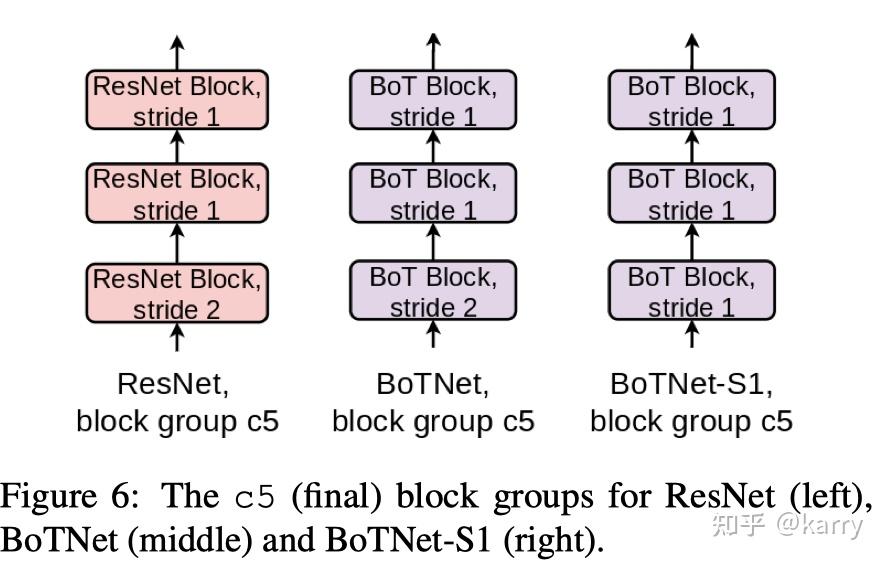
Bottleneck Transformers for Visual Recognition 阅读 - 知乎

Bottleneck Transformers for Visual Recognition
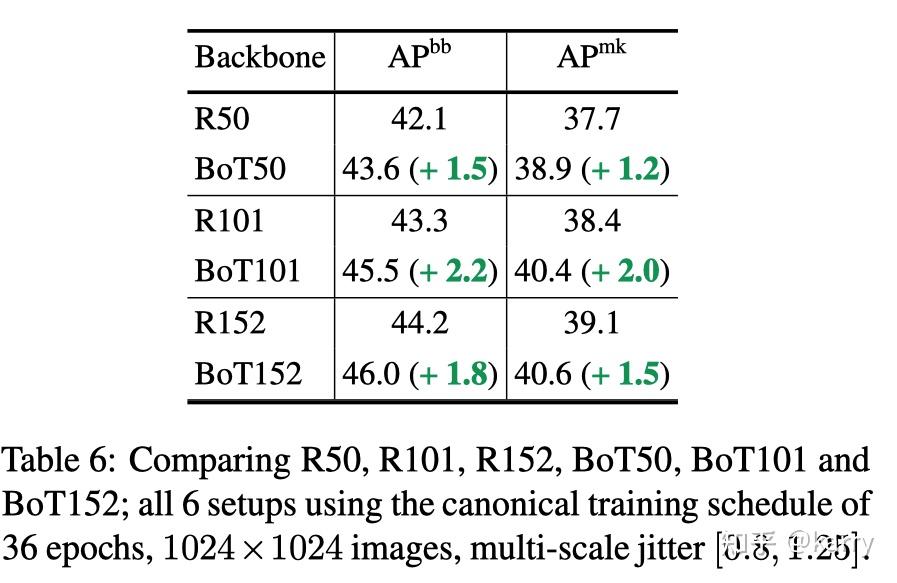
Bottleneck Transformers for Visual Recognition 阅读 - 知乎
Advertisement Space (336x280)
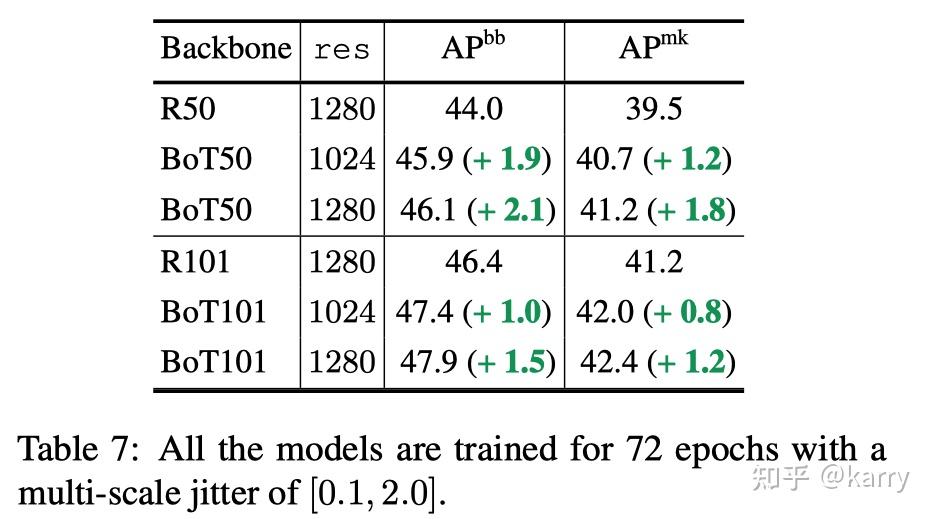
Bottleneck Transformers for Visual Recognition 阅读 - 知乎

BoTNet:Bottleneck Transformers for Visual Recognition - 知乎
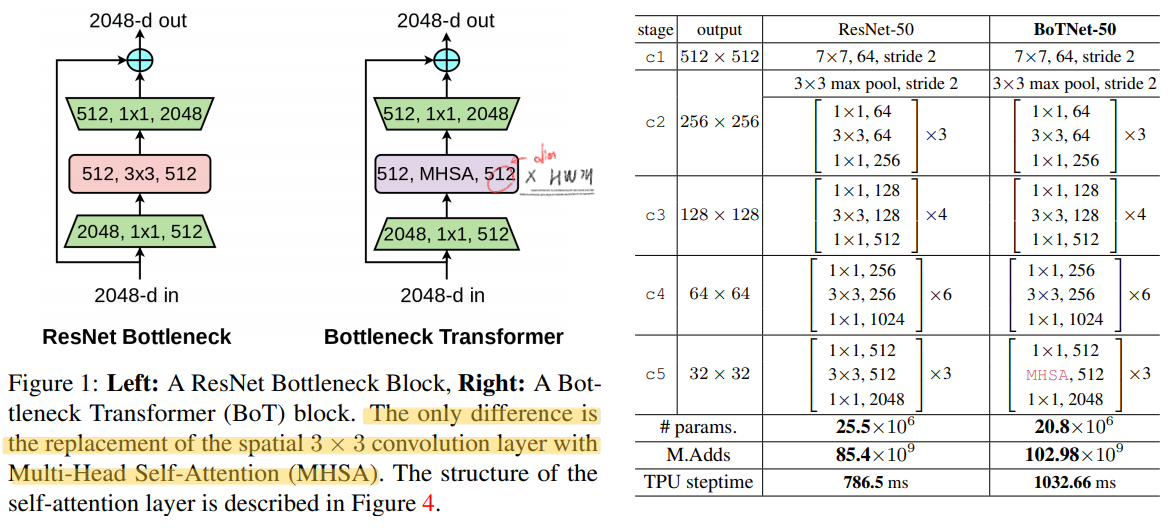
【Detection】Bottleneck Transformers for Visual Recognition | Just Do It ...

Spatial Information Bottleneck for Interpretable Visual Recognition ...

论文速读-Bottleneck Transformers for Visual Recognition - 知乎

Bottleneck Transformers for Visual Recognition阅读笔记_rh和rw分别表示高度和宽度不同位置的 ...
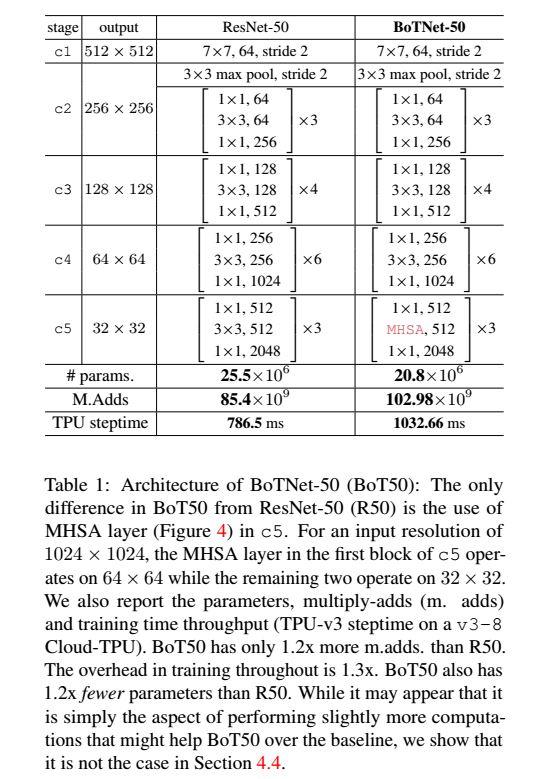
论文速读-Bottleneck Transformers for Visual Recognition - 知乎

Paper page - DCBM: Data-Efficient Visual Concept Bottleneck Models

Paper page - TSRFormer: Table Structure Recognition with Transformers

深度网络架构的设计技巧(二)之BoT:Bottleneck Transformers for Visual Recognition ...
Advertisement Space (336x280)
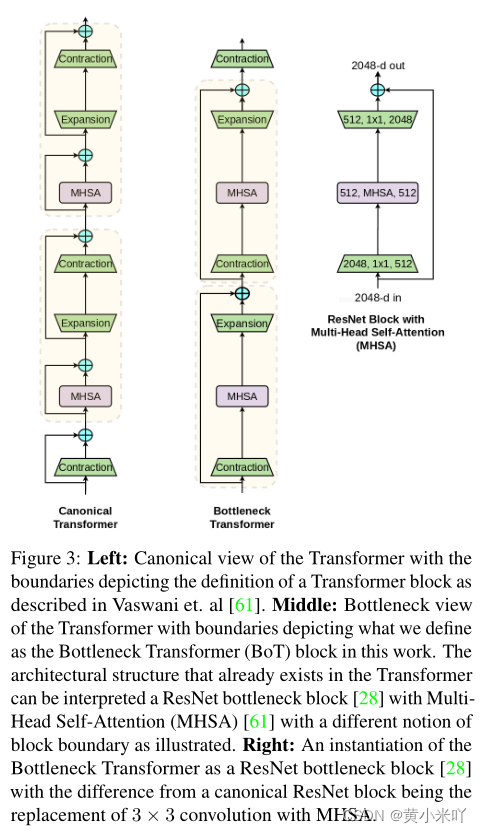
[Transformer]BoTNet:Bottleneck Transformers for Visual Recognition-CSDN博客

即插即用篇 | YOLOv10 引入 MHSA 注意力机制 | 《Bottleneck Transformers for Visual ...

Paper page - Inserting Information Bottlenecks for Attribution in ...

Paper page - Transformer Transducer: A Streamable Speech Recognition ...

Figure 1 from HAT: A Visual Transformer Model for Image Recognition ...

Paper page - Efficient Visual Transformer by Learnable Token Merging