
Sdsat Accelerating Llm Inference Through Speculative Decoding

SDSAT: Accelerating LLM Inference through Speculative Decoding with ...

SDSAT: Accelerating LLM Inference through Speculative Decoding with ...

Figure 1 from SDSAT: Accelerating LLM Inference through Speculative ...
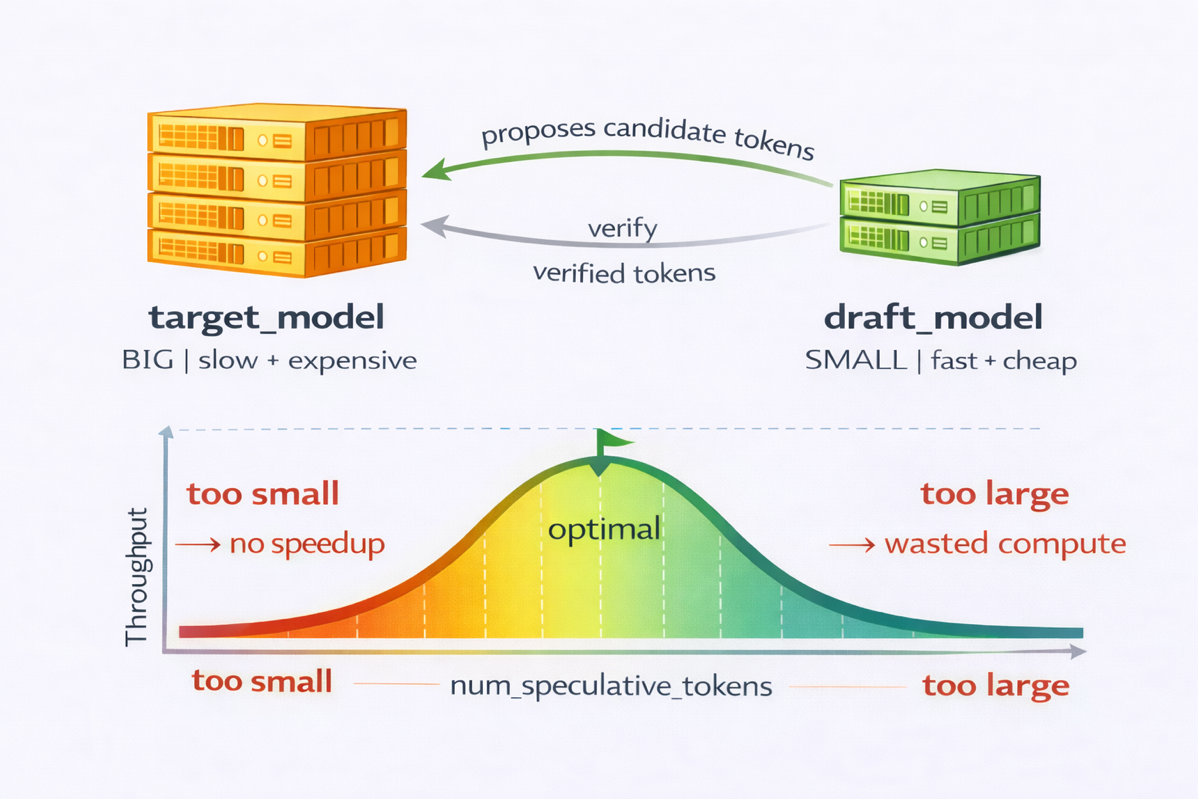
Accelerating decode-heavy LLM inference with speculative decoding on ...
Accelerating LLM Inference with Staged Speculative Decoding - Paper Details

(PDF) Accelerating LLM Inference with Lossless Speculative Decoding ...
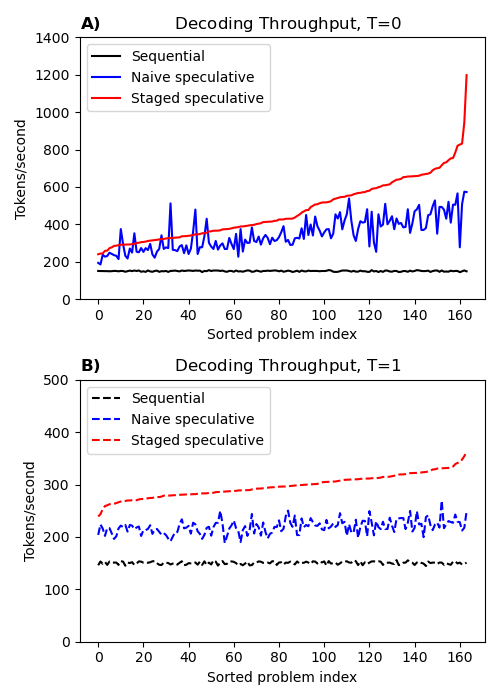
[2308.04623] Accelerating LLM Inference with Staged Speculative Decoding

Accelerating LLM Inference with Speculative Decoding using LMStudio ...
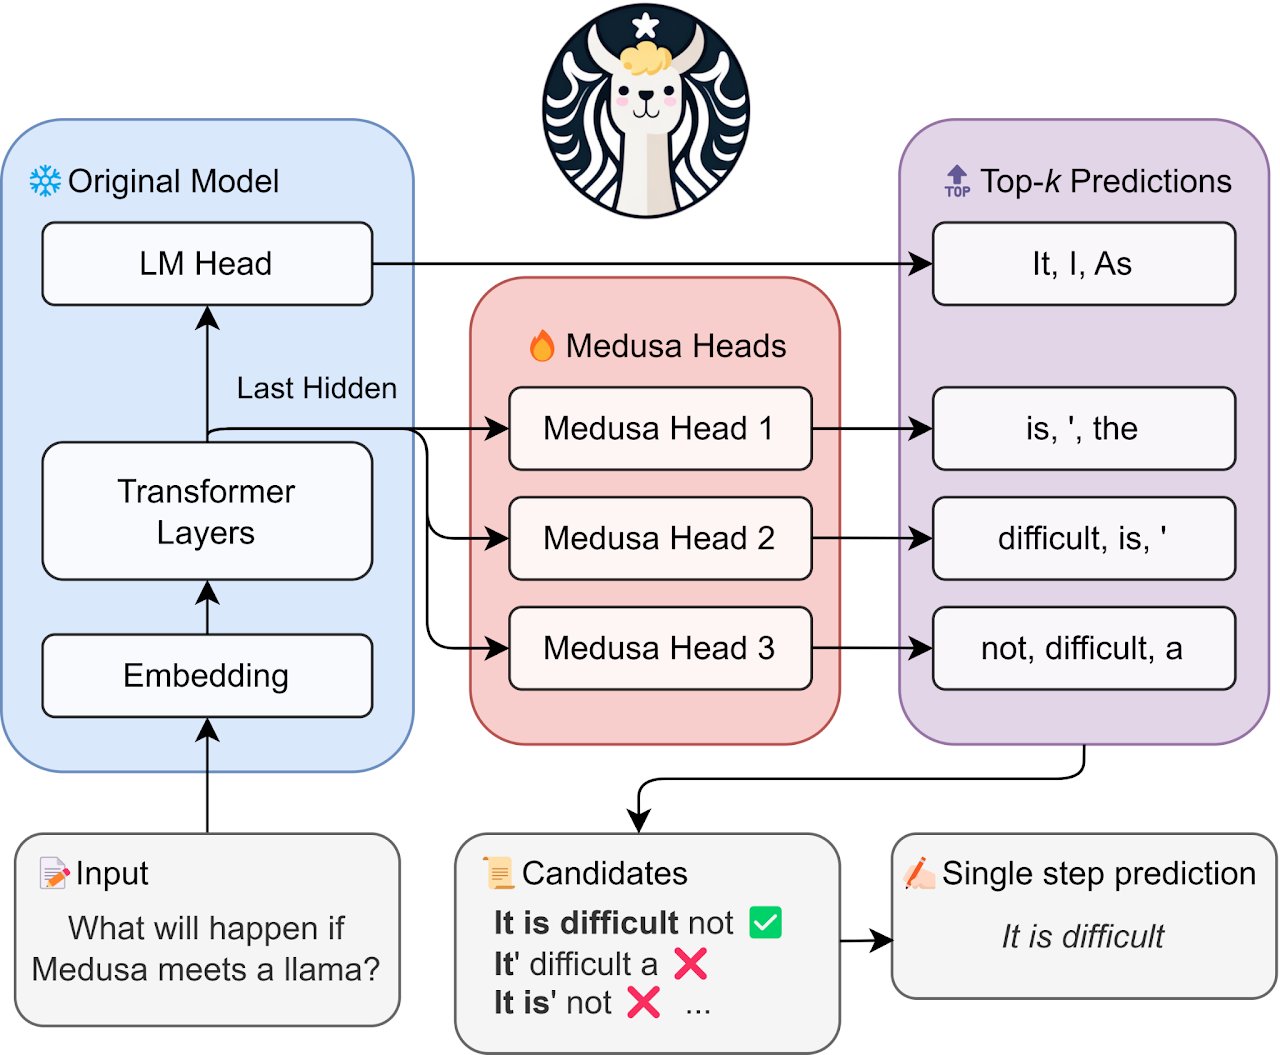
Accelerate LLM Inference with Speculative Decoding | Charles Xu
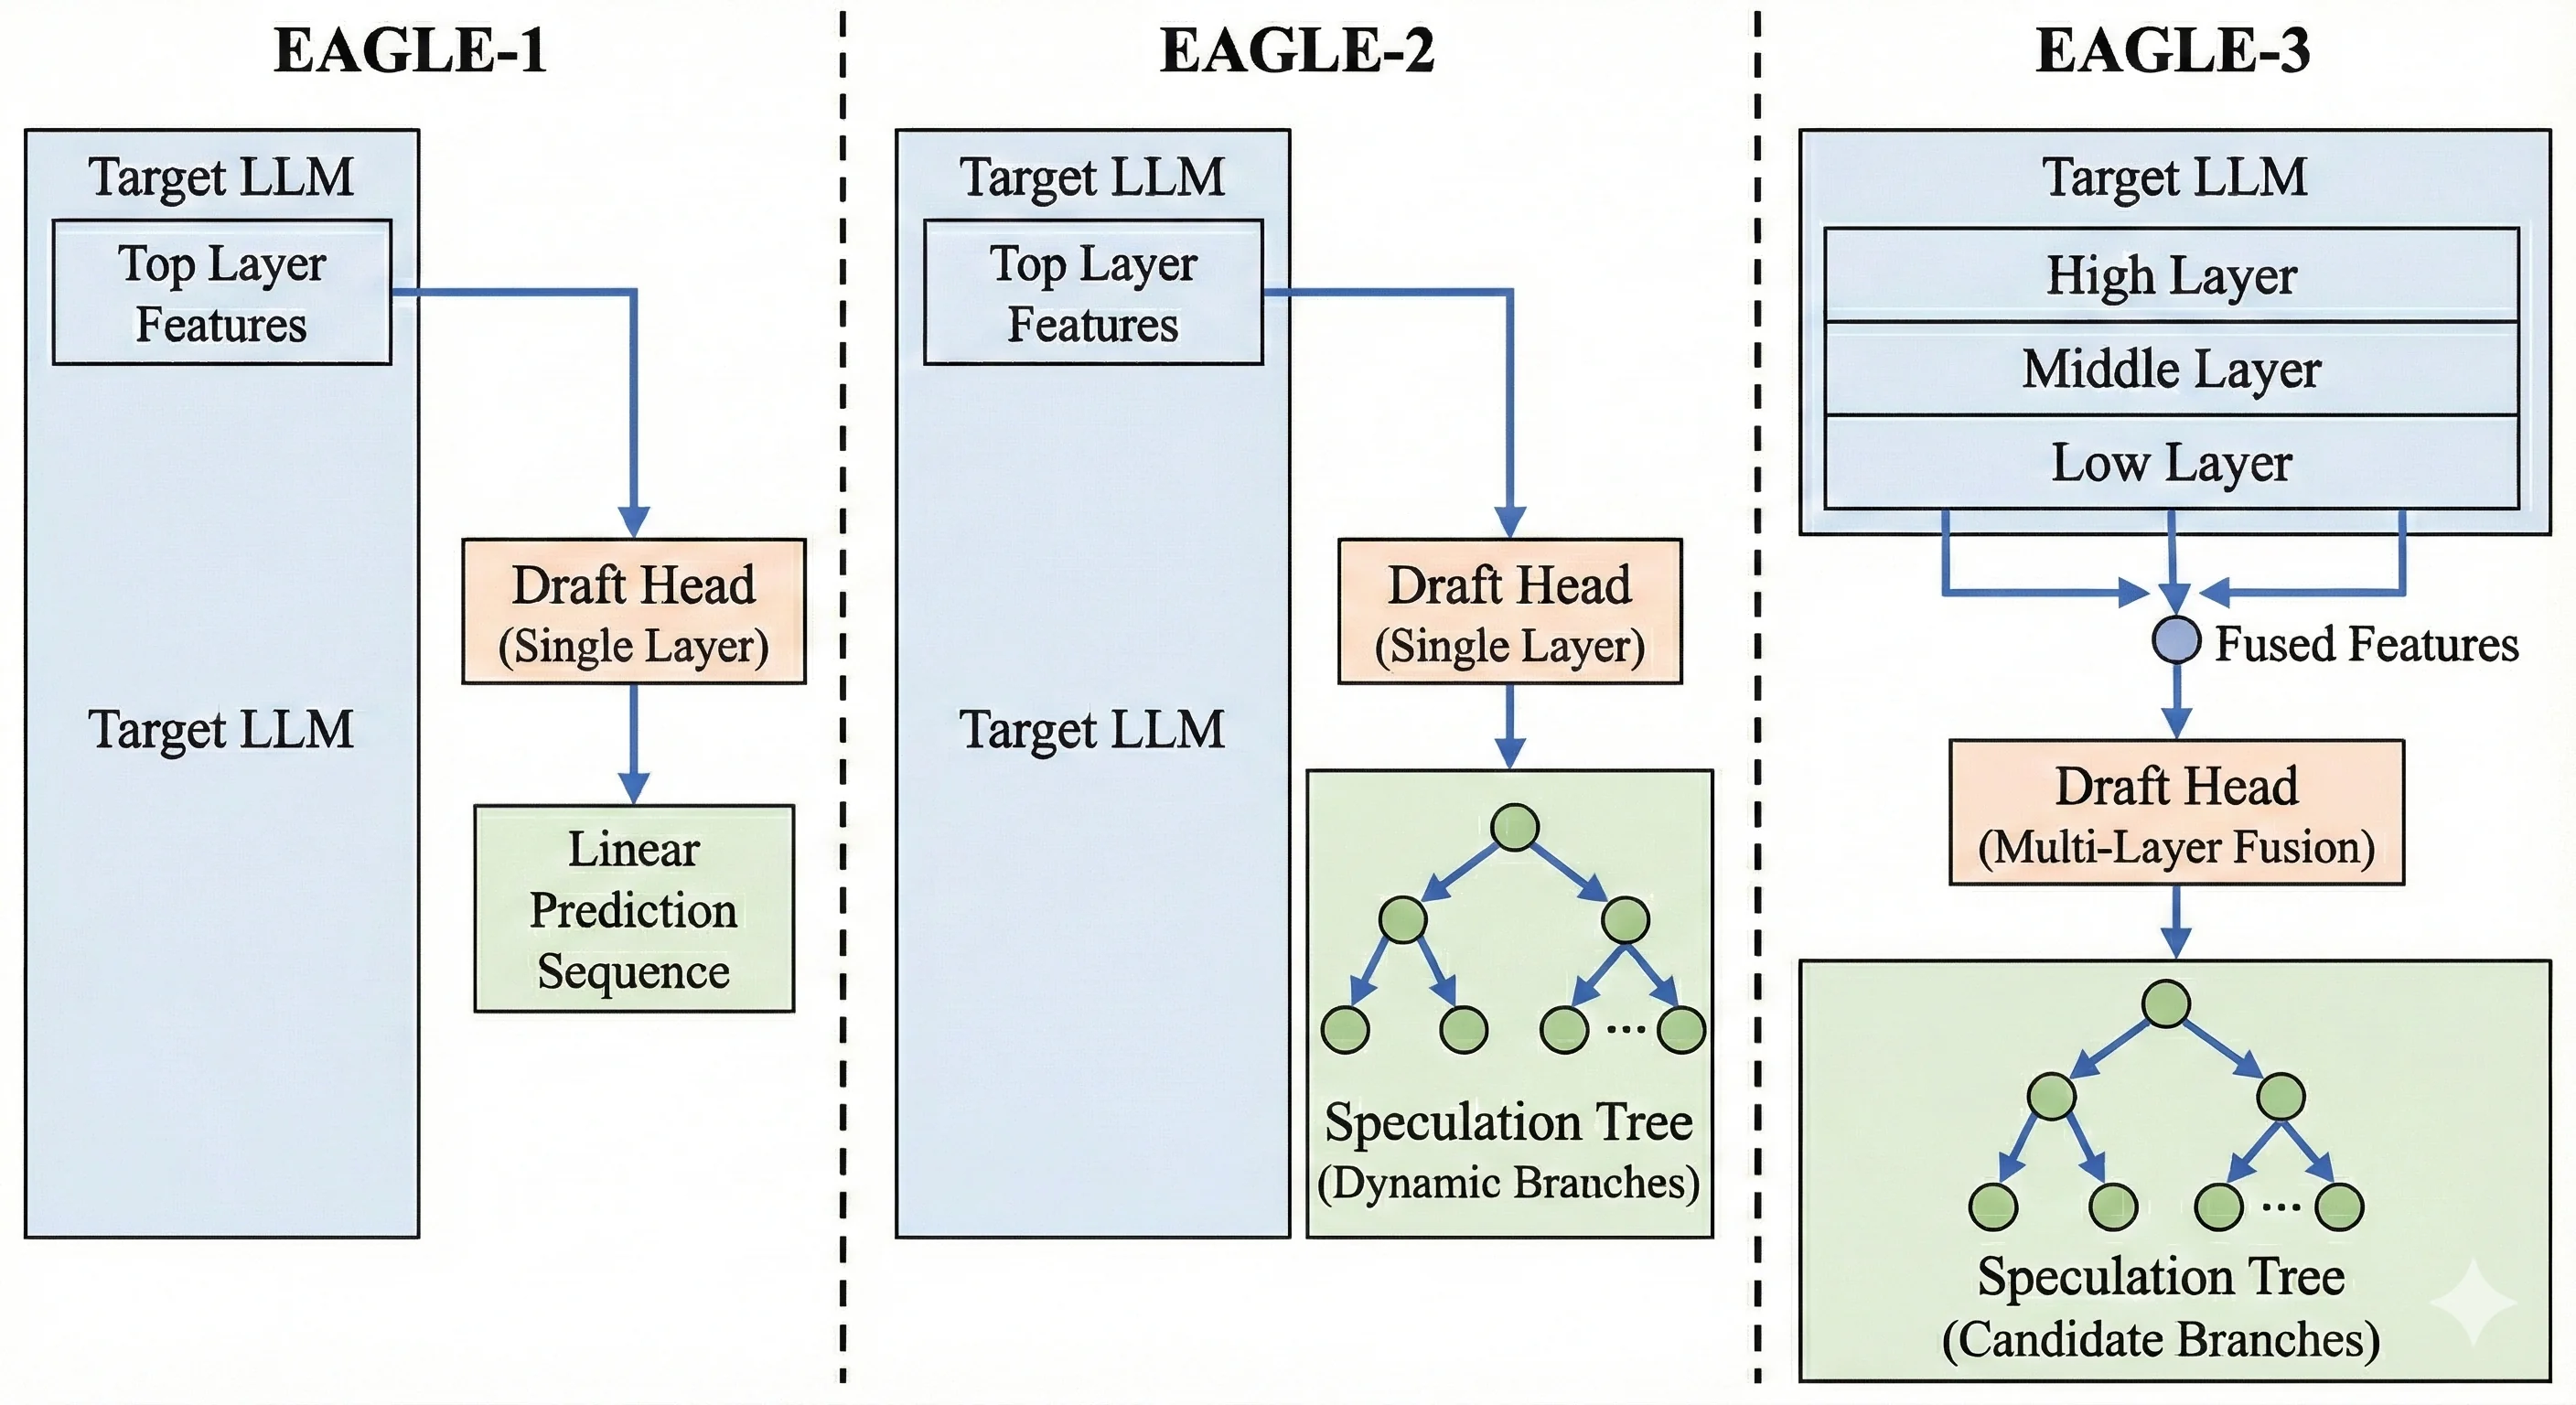
Speculative Decoding in vLLM: Complete Guide to Faster LLM Inference ...
Advertisement Space (300x250)

Speculative Decoding: Accelerating LLM Inference Without Quality ...
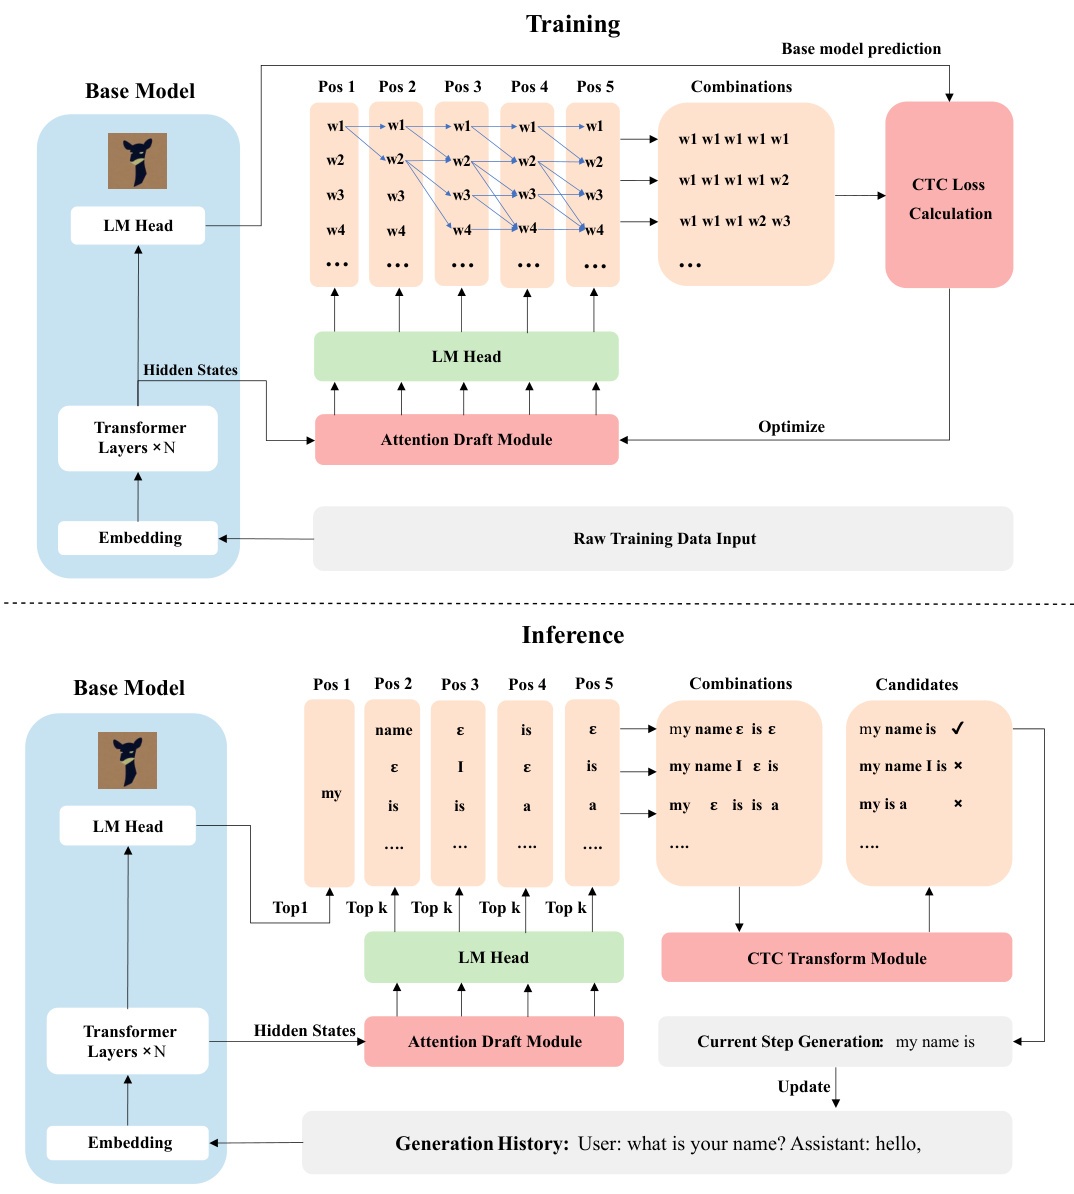
Speculative Decoding with CTC-based Draft Model for LLM Inference ...
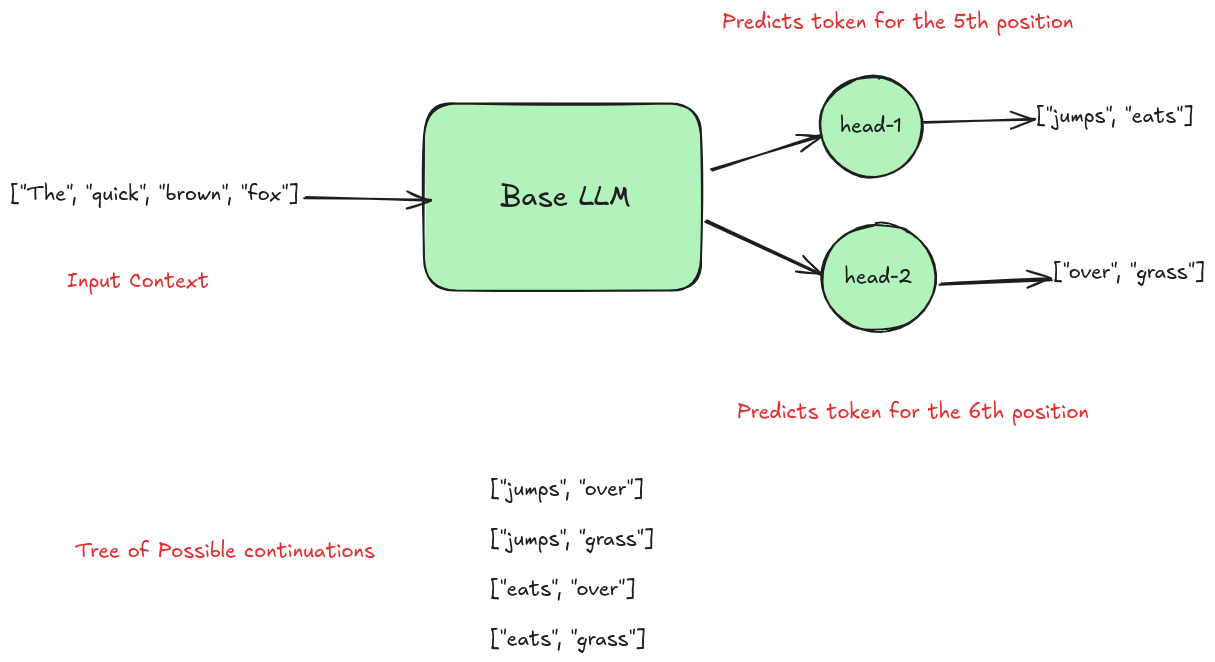
A Survey of Speculative Decoding Techniques in LLM Inference
Paper page - Recursive Speculative Decoding: Accelerating LLM Inference ...
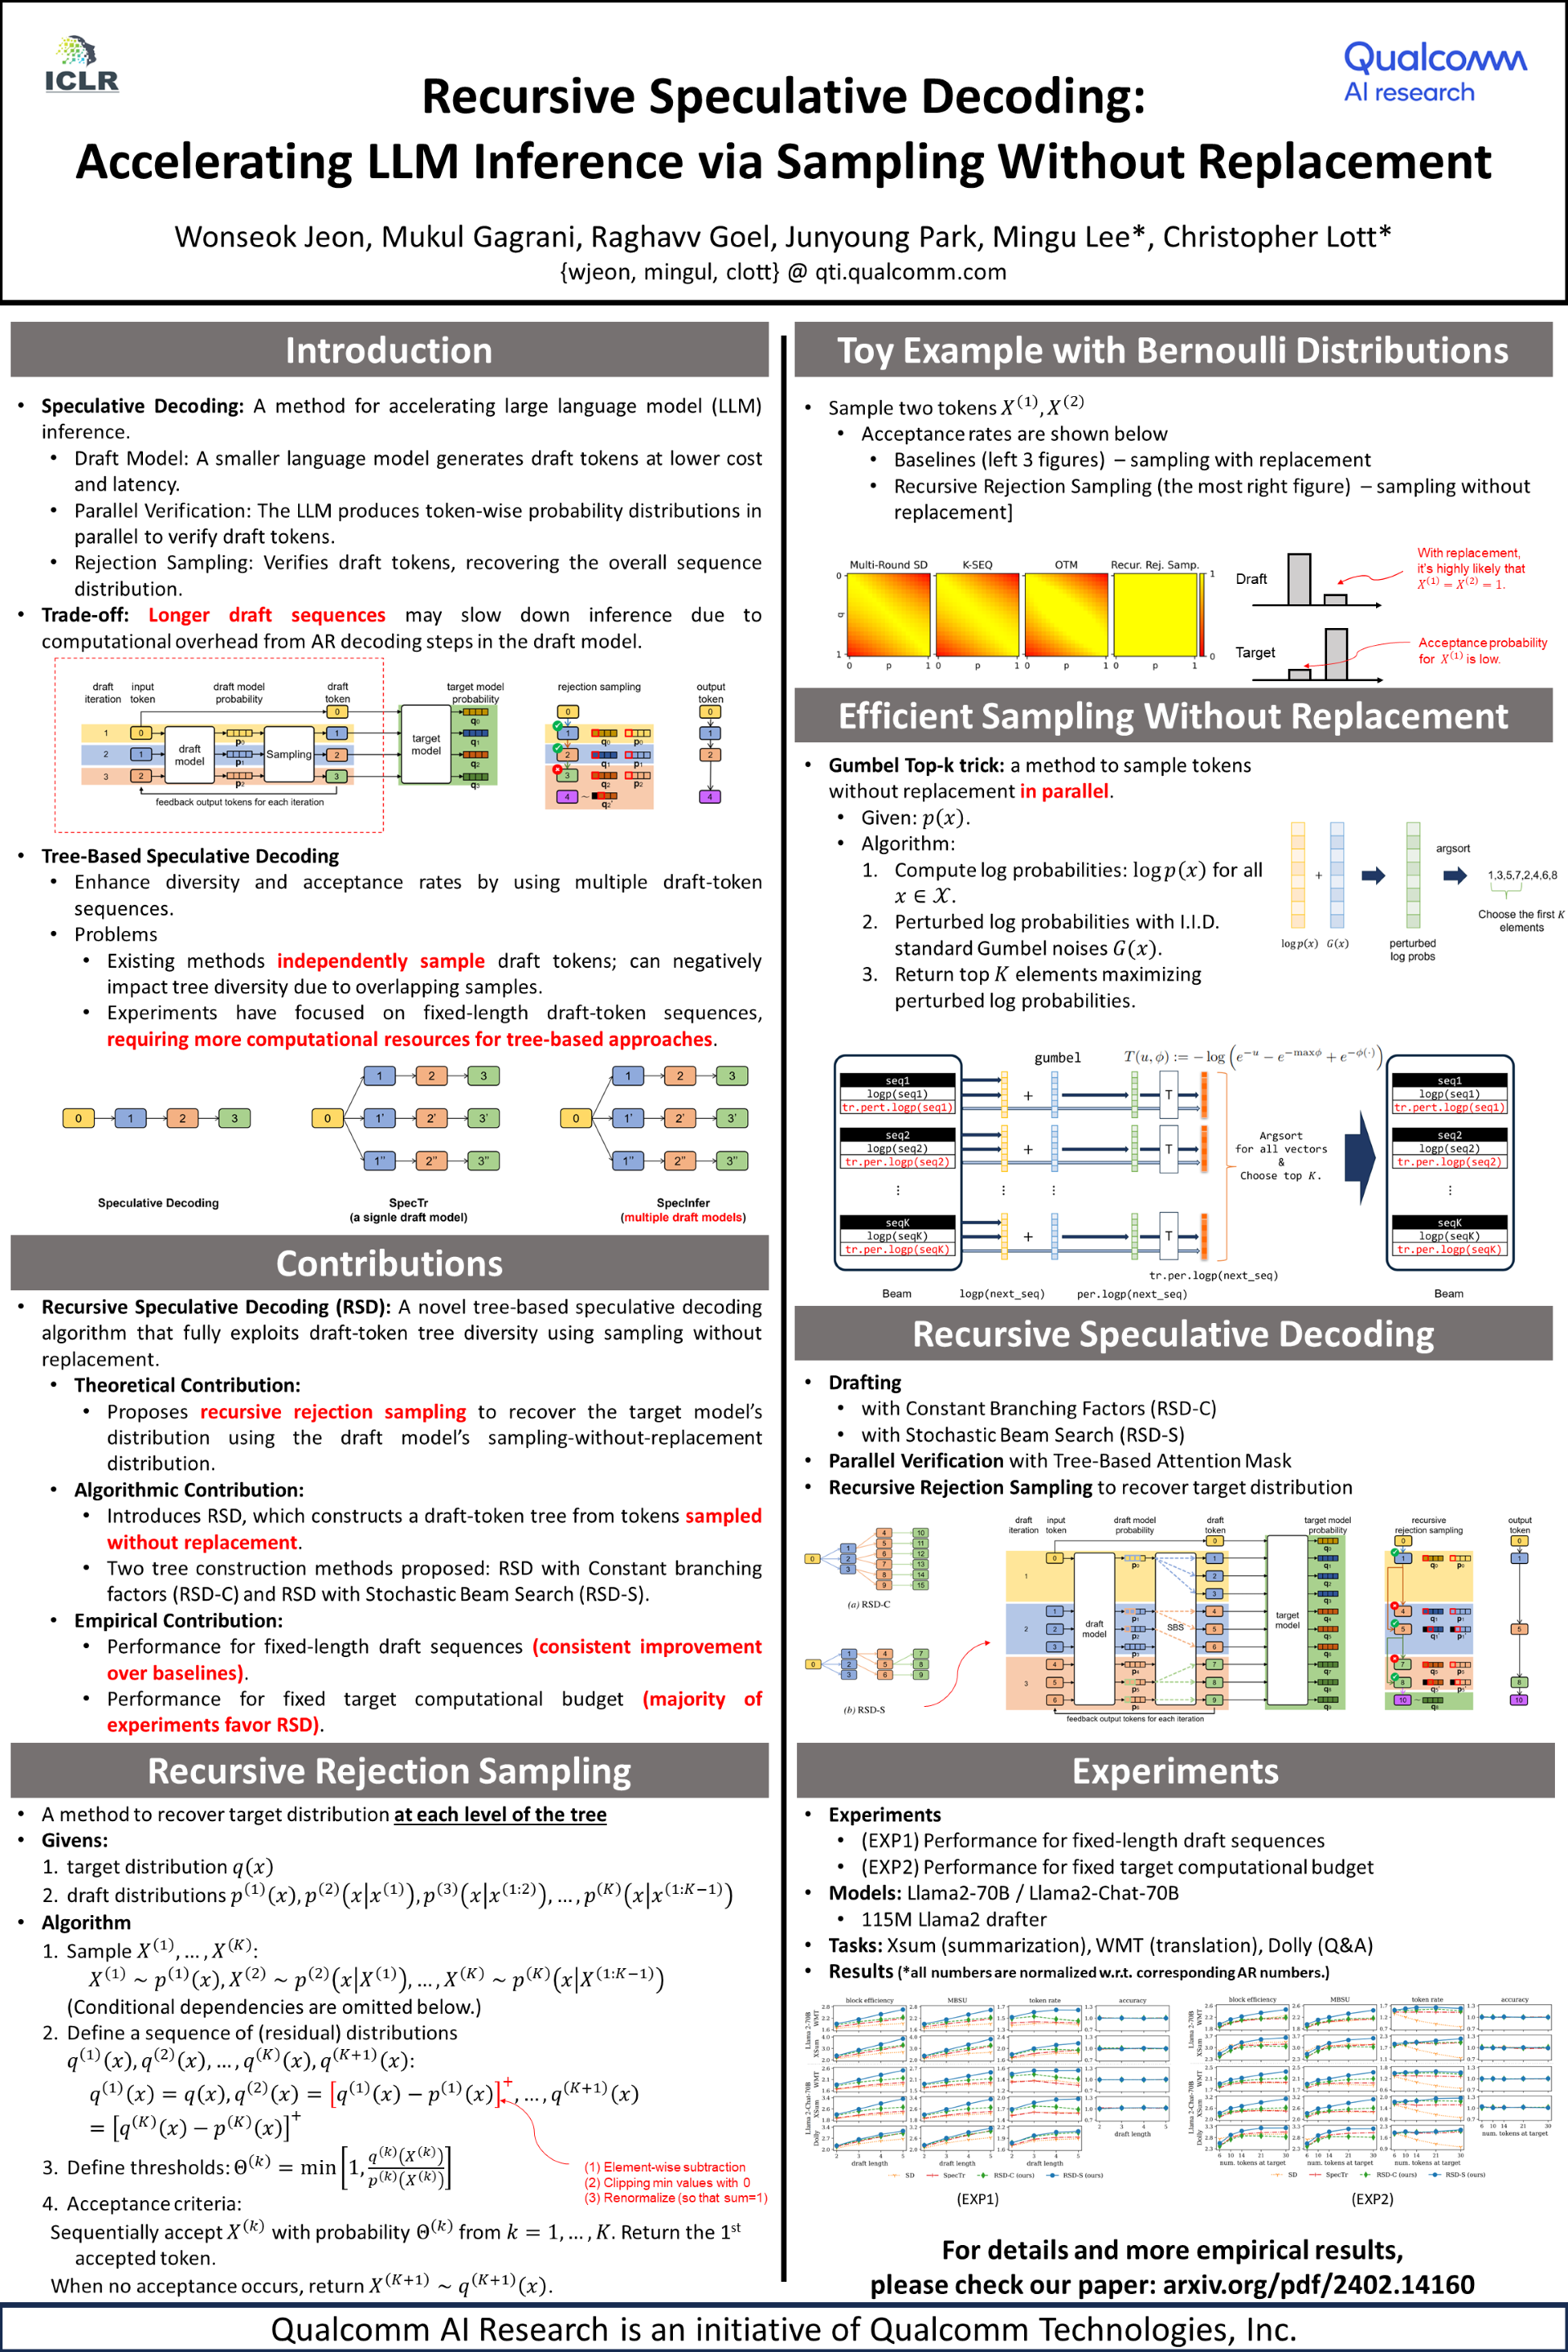
ICLR Recursive Speculative Decoding: Accelerating LLM Inference via ...
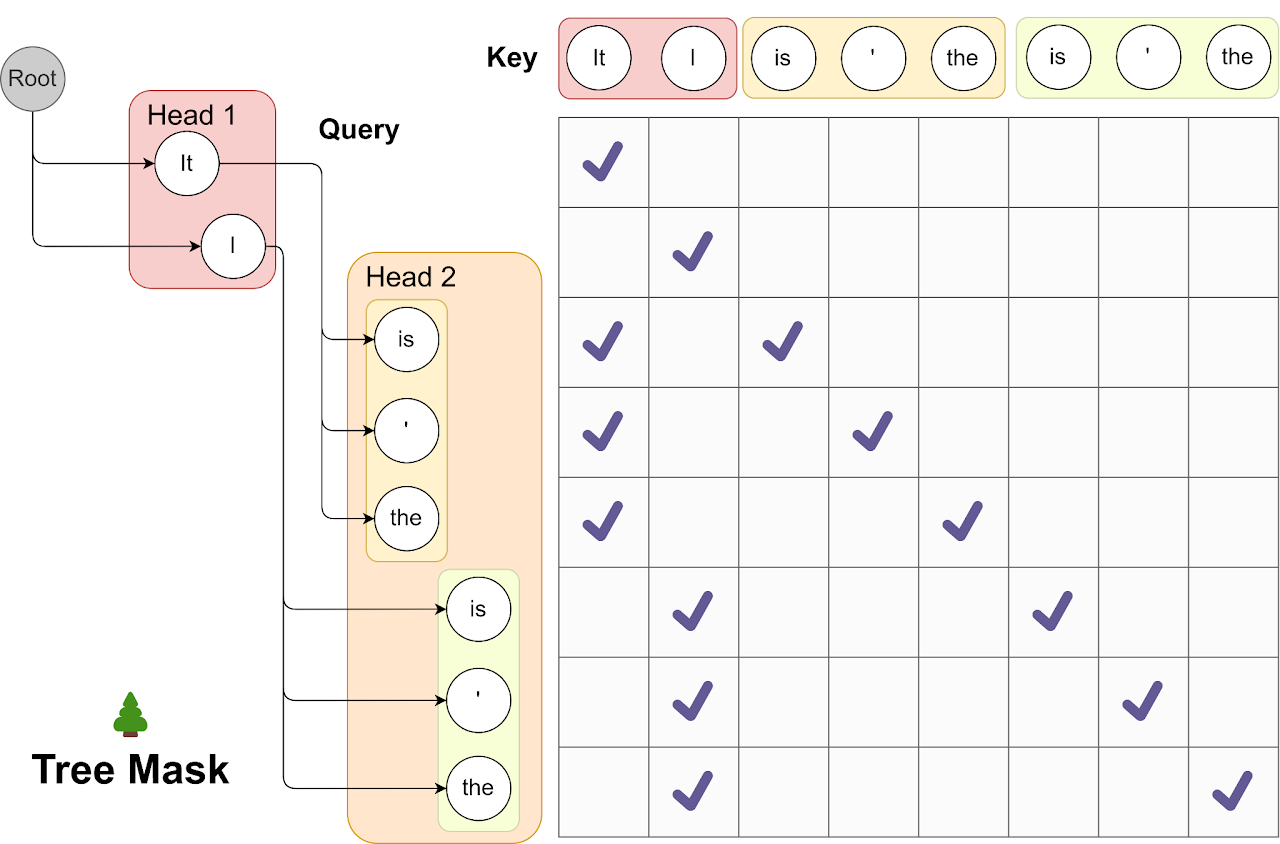
Accelerate LLM Inference with Speculative Decoding | Charles Xu

Speculative Decoding via Early-exiting for Faster LLM Inference with ...
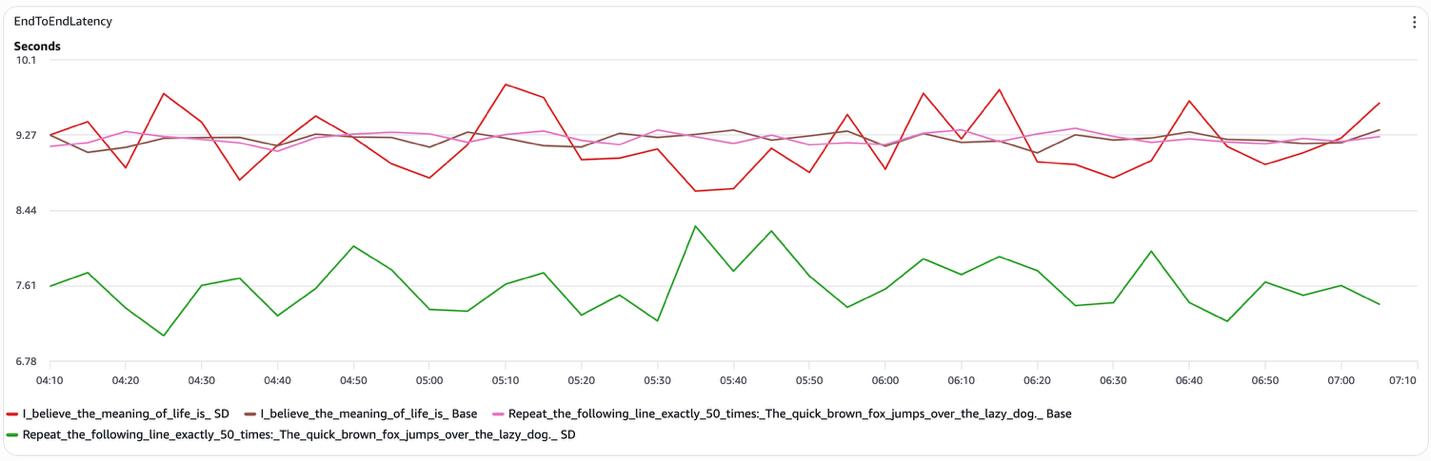
Tuto Startup - Accelerating decode-heavy LLM inference with speculative dec
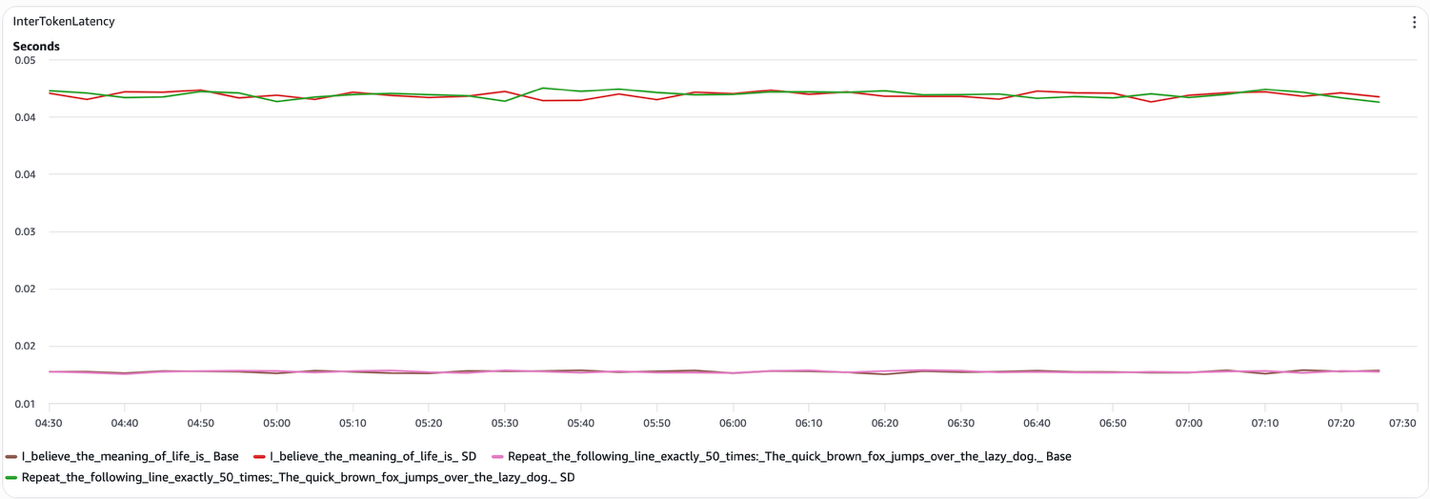
Tuto Startup - Accelerating decode-heavy LLM inference with speculative dec
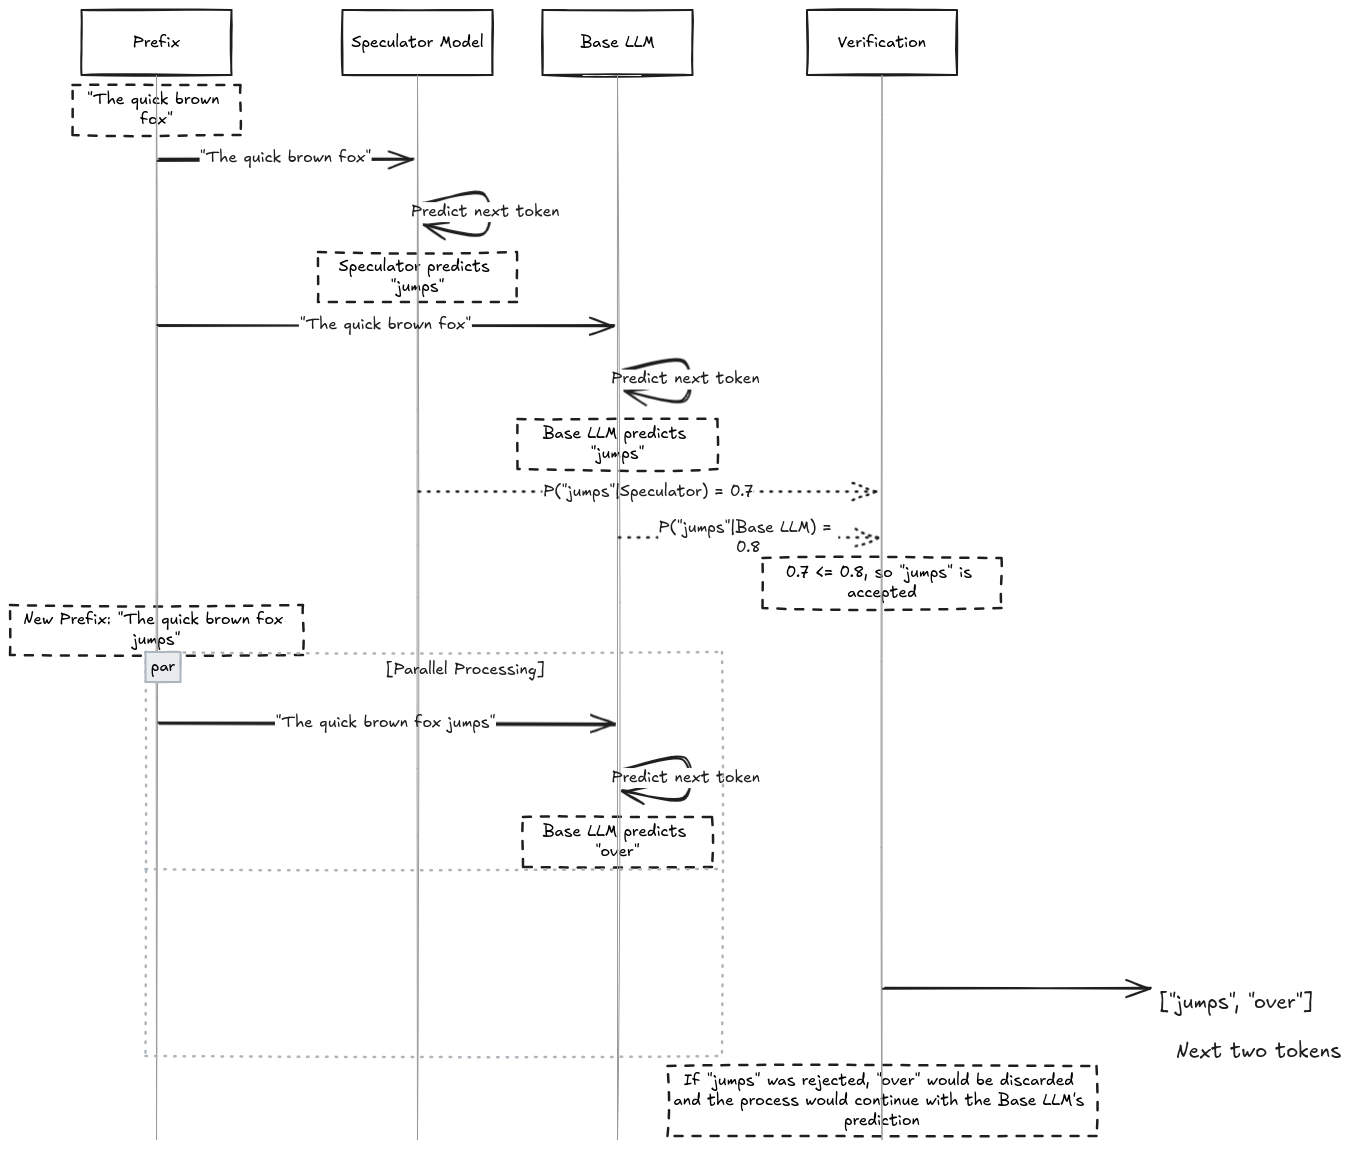
A Survey of Speculative Decoding Techniques in LLM Inference
Advertisement Space (336x280)
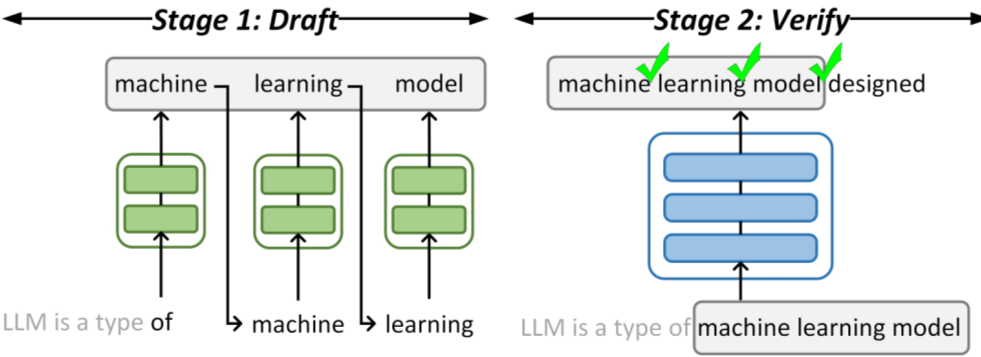
[论文评述] From Quarter to All: Accelerating Speculative LLM Decoding via ...
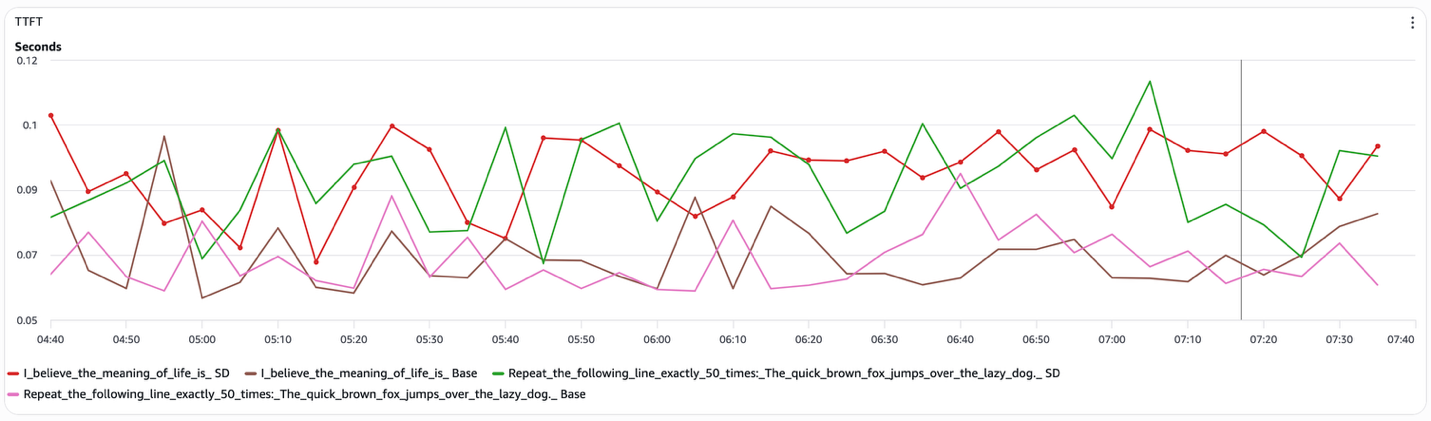
Tuto Startup - Accelerating decode-heavy LLM inference with speculative dec

LLM Inference - Self Speculative Decoding - YouTube
DSpark: The Speculative Decoding Leap Cutting LLM Inference Costs
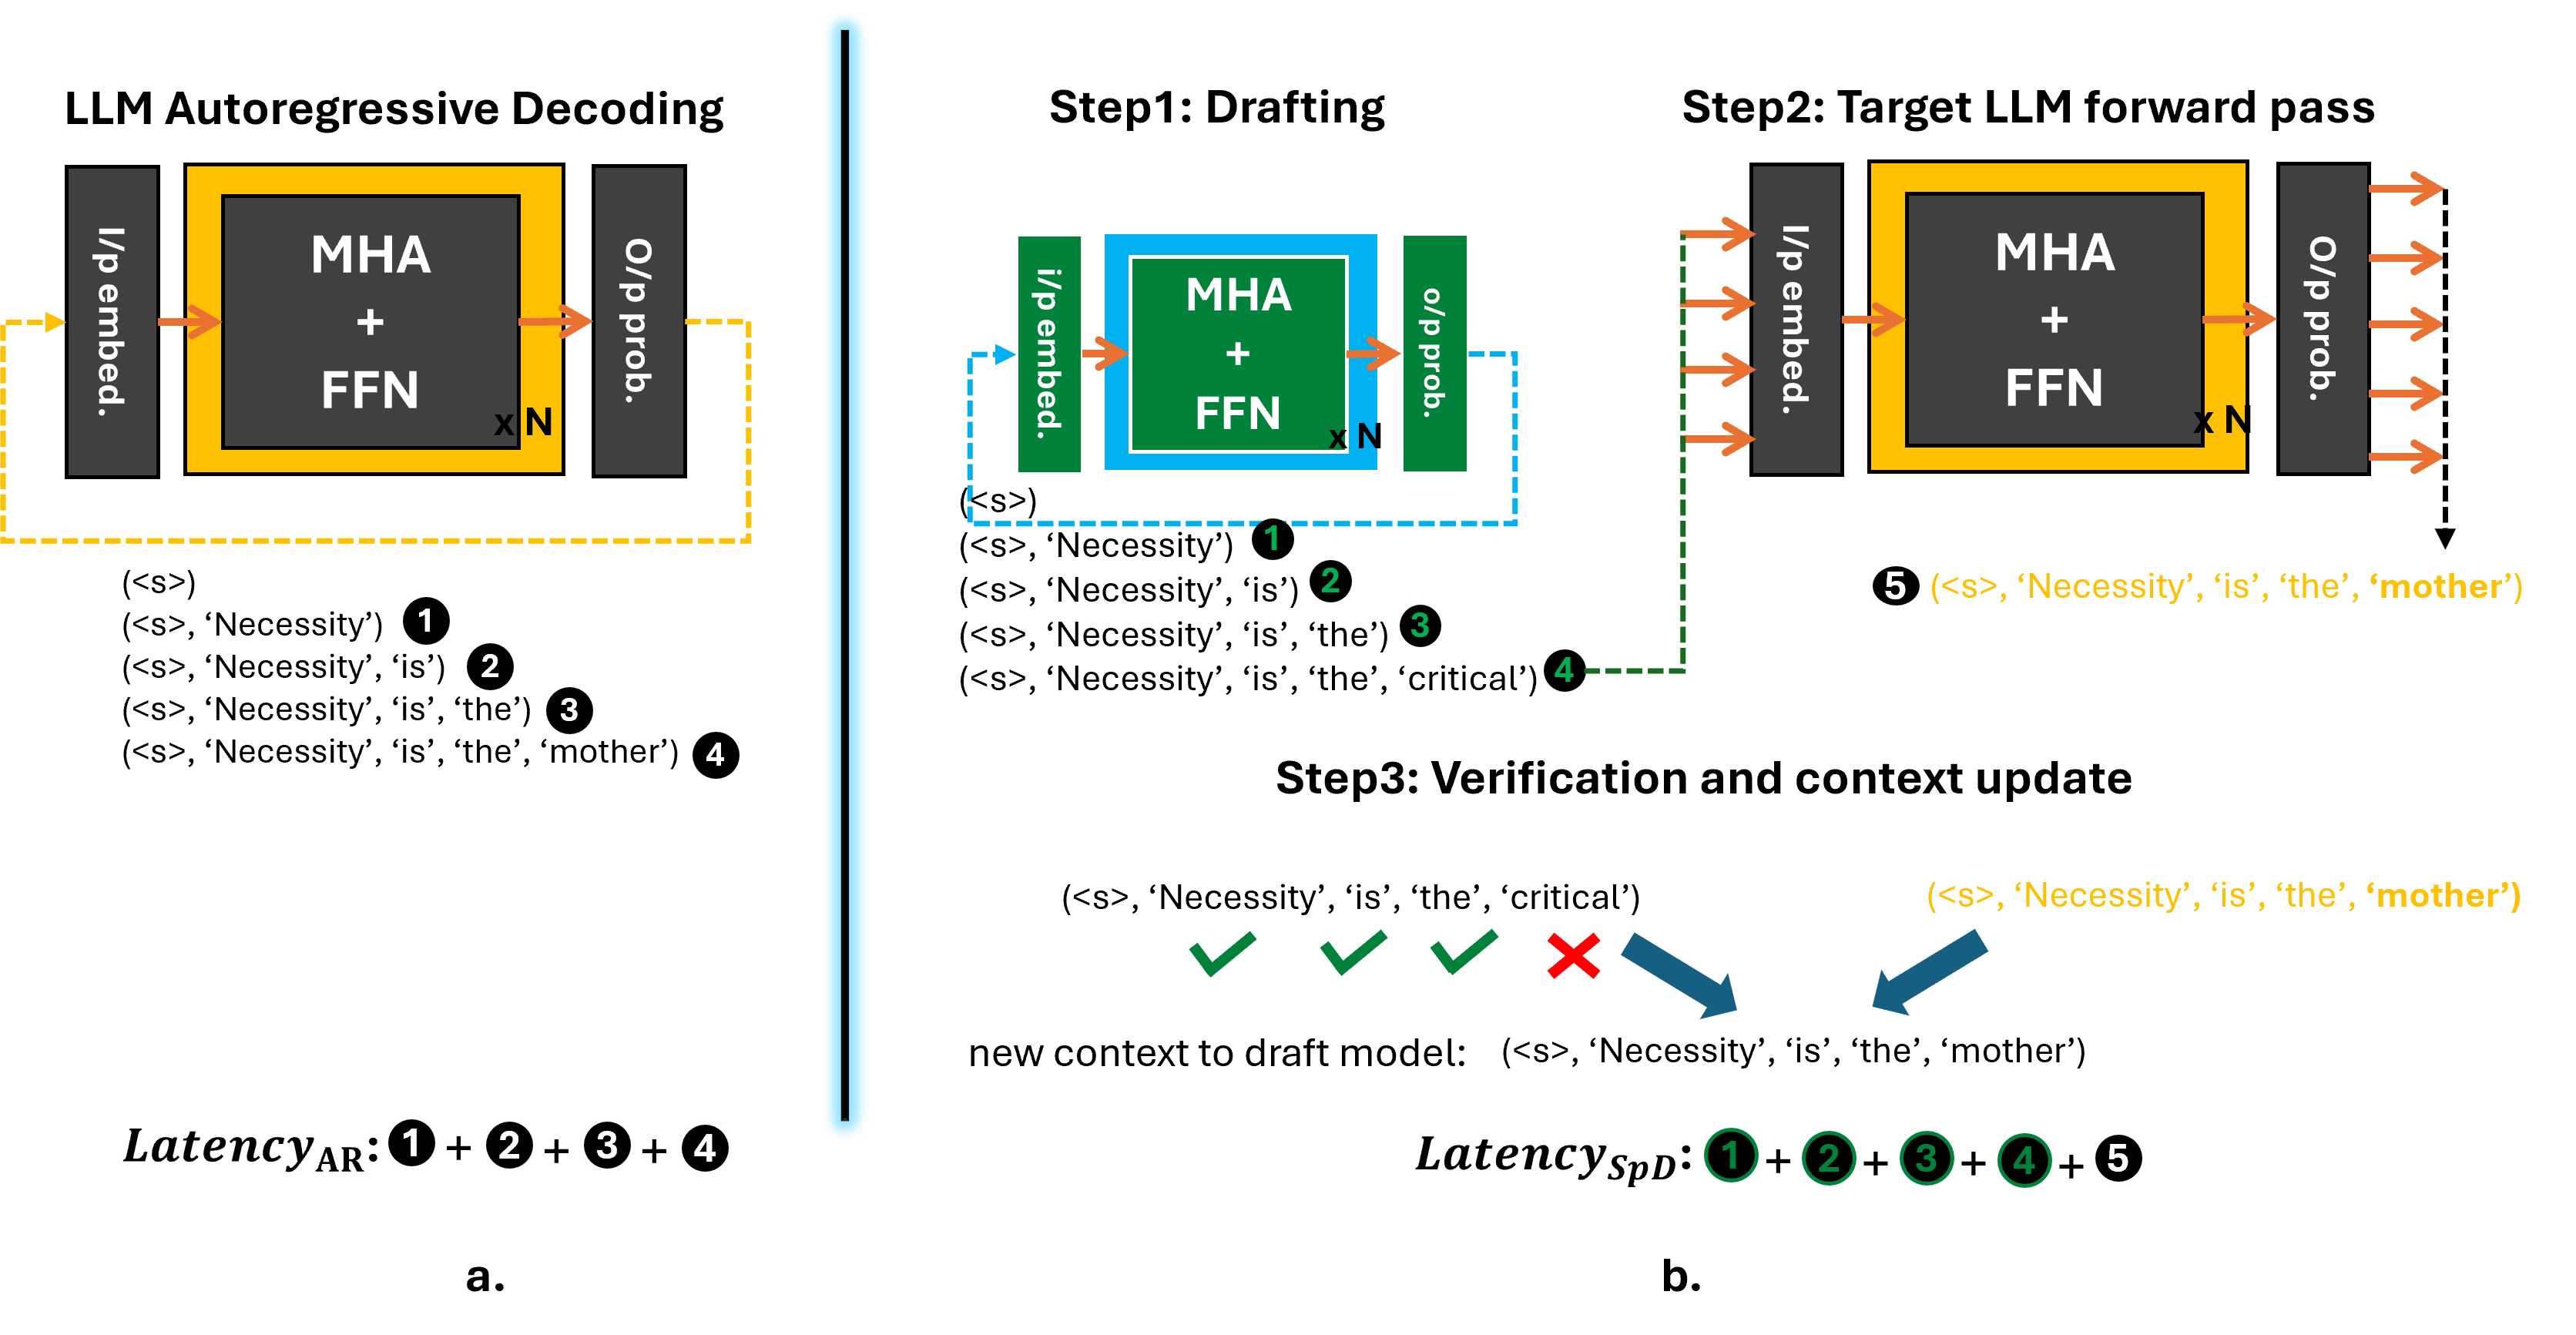
Accelerating LLM Inference: Up to 3x Speedup on MI300X with Speculative ...
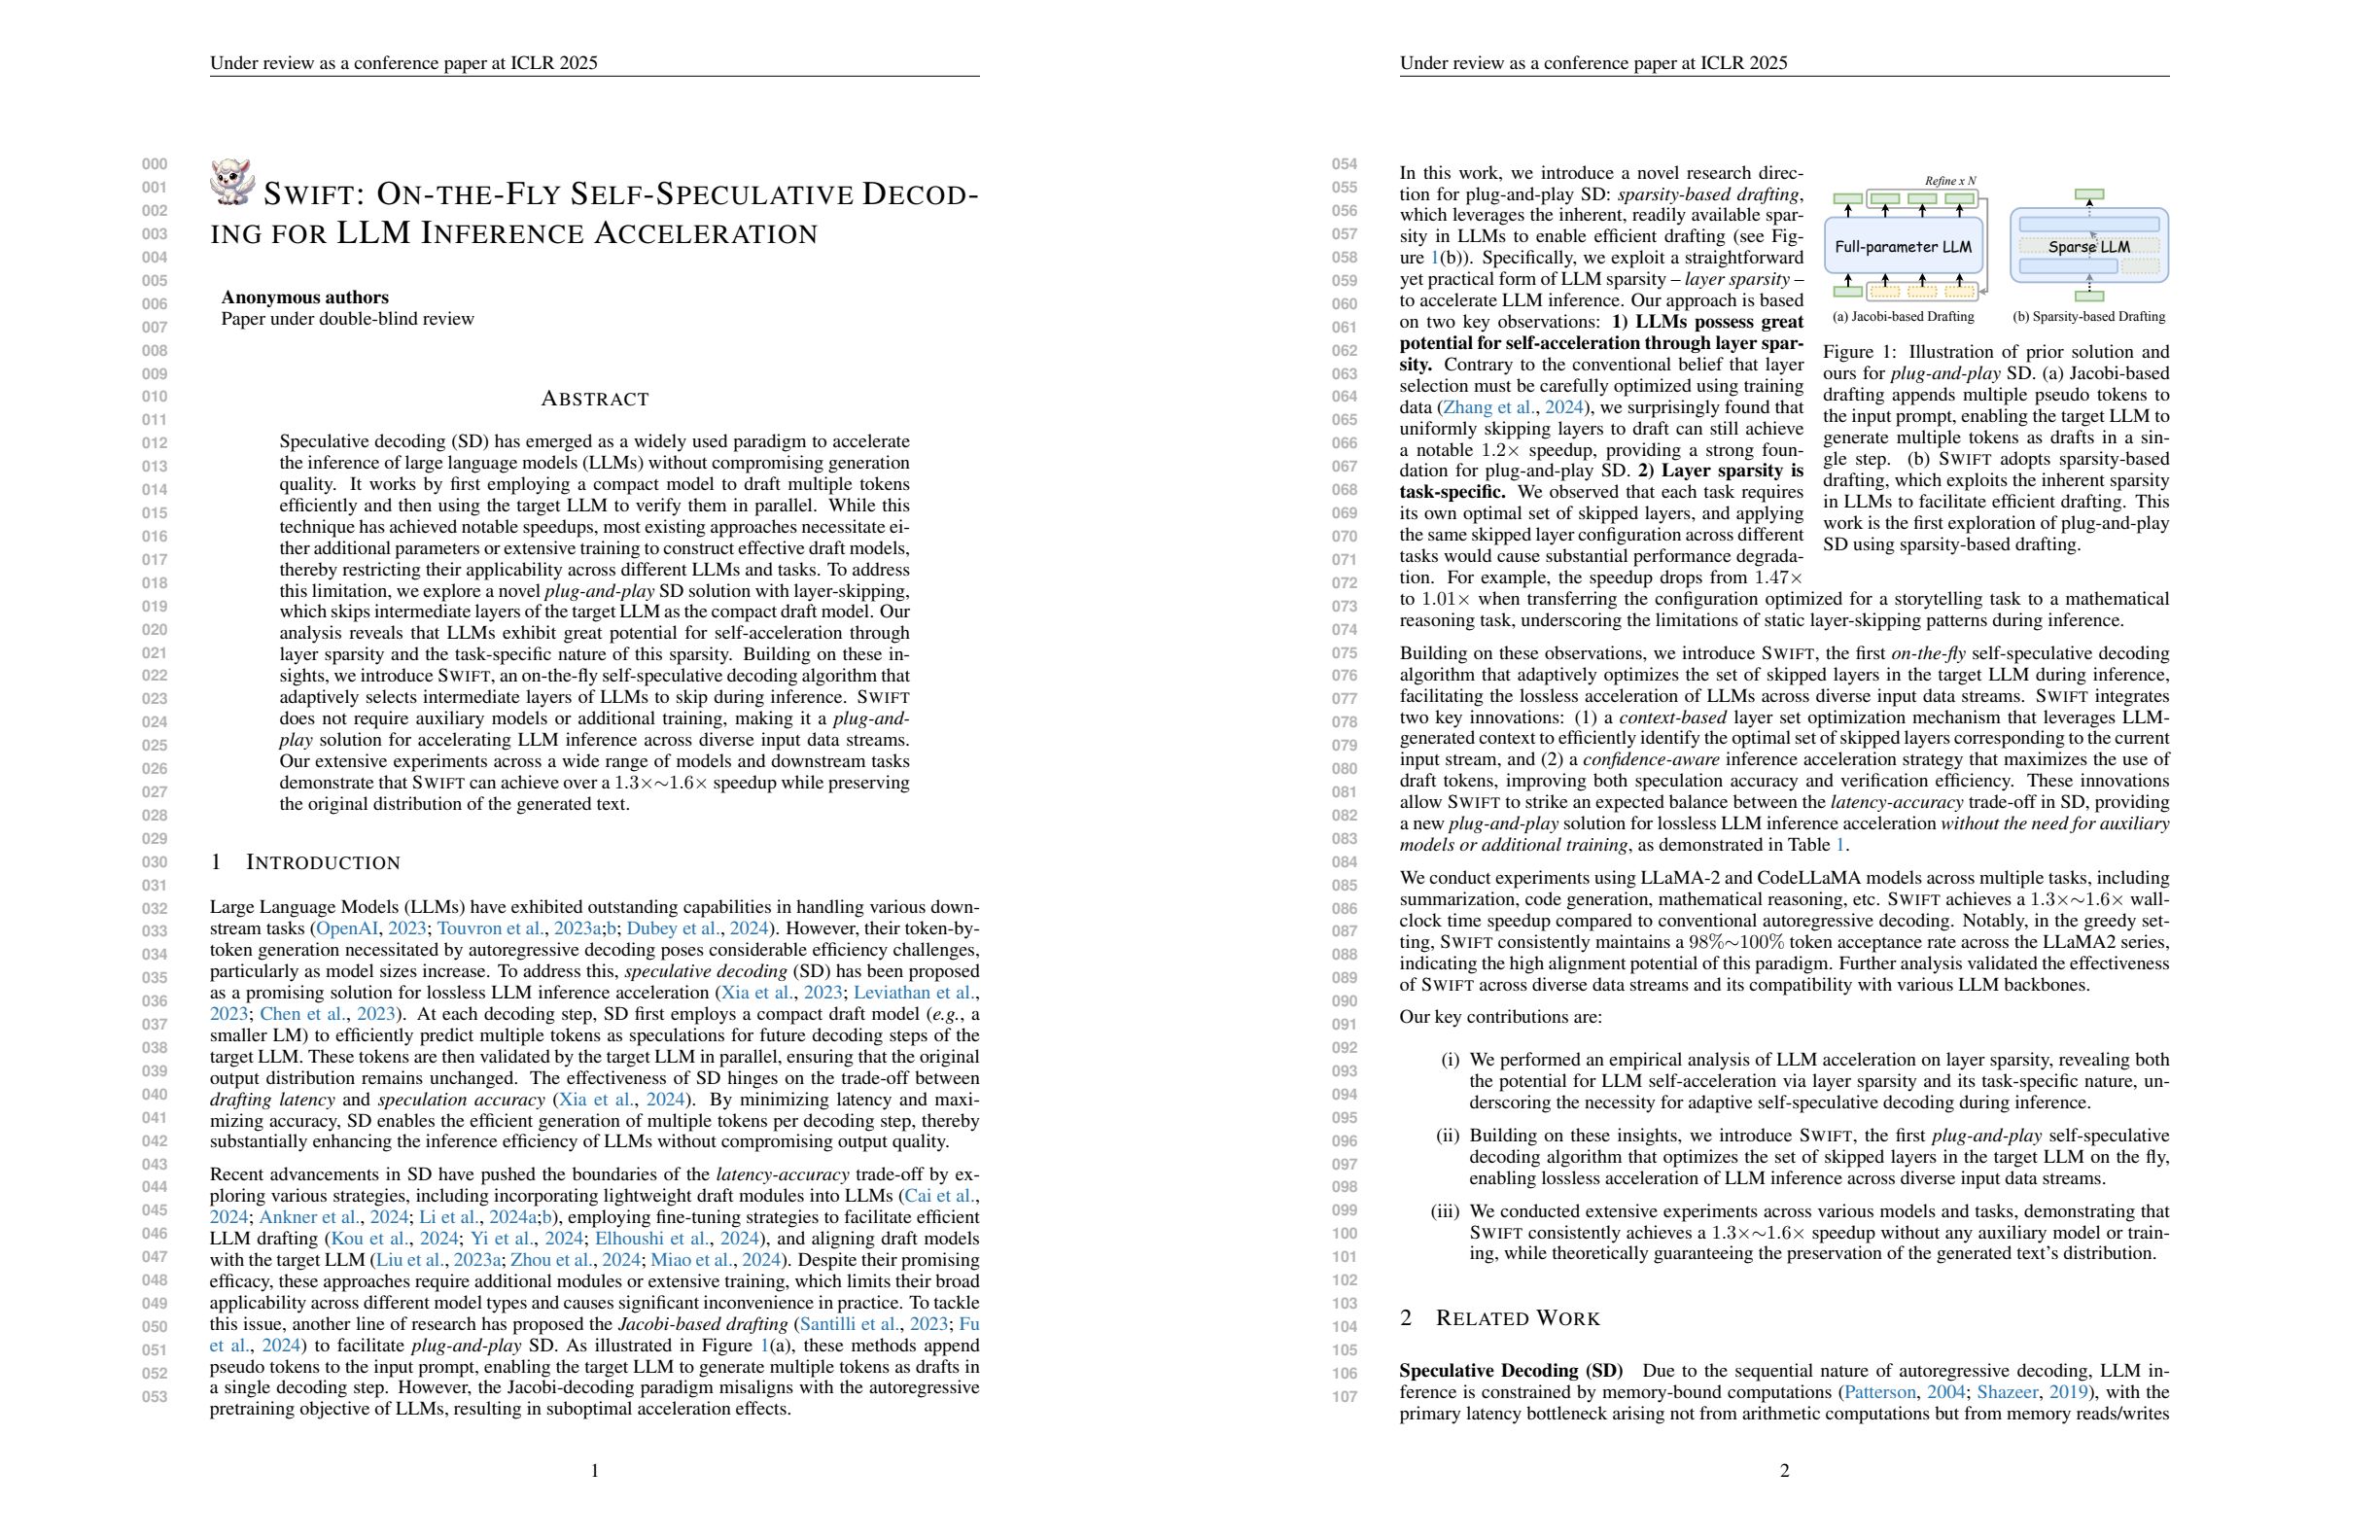
SWIFT: On-the-Fly Self-Speculative Decoding for LLM Inference Acceleration

SpecInfer: Accelerating Generative LLM Serving with Speculative ...

SpecEE: Accelerating Large Language Model Inference with Speculative ...
Accelerating Whisper Inference with Speculative Decoding: Doubling ...
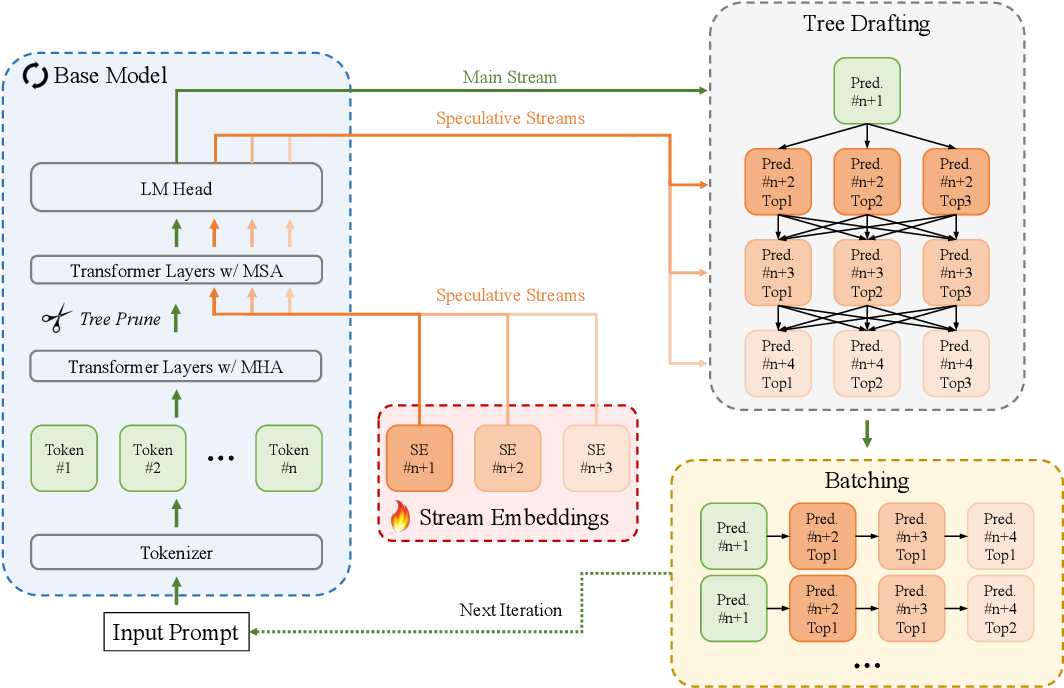
Figure 2 from Speculative Streaming: Fast LLM Inference without ...
Advertisement Space (336x280)
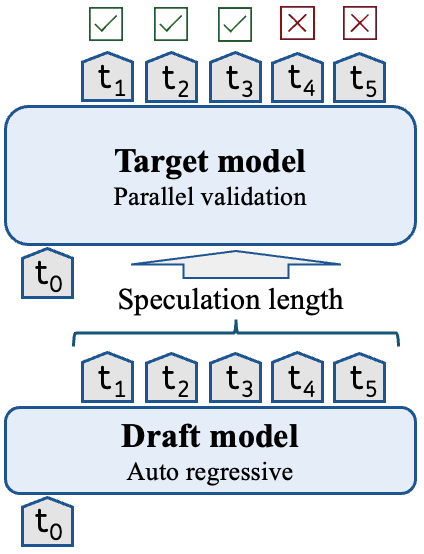
Accelerating Speculative Decoding using Dynamic Speculation Length | Home

TensorRT-LLM Speculative Decoding Boosts Inference Throughput by up to ...

[논문 리뷰] Reward-Guided Speculative Decoding for Efficient LLM Reasoning
Speculative Decoding Explained: Faster Inference Without Quality Loss

SSV: Sparse Speculative Verification for Efficient LLM Inference