
Aligning Llms With Domain Invariant Reward Models Ai Research Paper

Aligning LLMs with Domain Invariant Reward Models | AI Research Paper ...

Paper page - Aligning LLMs with Domain Invariant Reward Models

[2501.00911] Aligning LLMs with Domain Invariant Reward Models

[2501.00911] Aligning LLMs with Domain Invariant Reward Models

[2501.00911] Aligning LLMs with Domain Invariant Reward Models

[2501.00911] Aligning LLMs with Domain Invariant Reward Models

[2501.00911] Aligning LLMs with Domain Invariant Reward Models

Direct Advantage Regression: Aligning LLMs with Online AI Reward | AI ...

SALMON: Self-Alignment with Instructable Reward Models | AI Research ...

Direct Advantage Regression: Aligning LLMs with Online AI Reward | AI ...
Advertisement Space (300x250)

(PDF) Direct Advantage Regression: Aligning LLMs with Online AI Reward

LLMs for Domain Generation Algorithm Detection | AI Research Paper Details

Direct Advantage Regression: Aligning LLMs with Online AI Reward | AI ...

Interaction Dynamics as a Reward Signal for LLMs | AI Research Paper ...

Direct Advantage Regression: Aligning LLMs with Online AI Reward | AI ...

Paper page - DogeRM: Equipping Reward Models with Domain Knowledge ...

Sparse Reward Subsystem in Large Language Models | AI Research Paper ...

Direct Advantage Regression: Aligning LLMs with Online AI Reward | AI ...

Reward Model Routing in Alignment | AI Research Paper Details
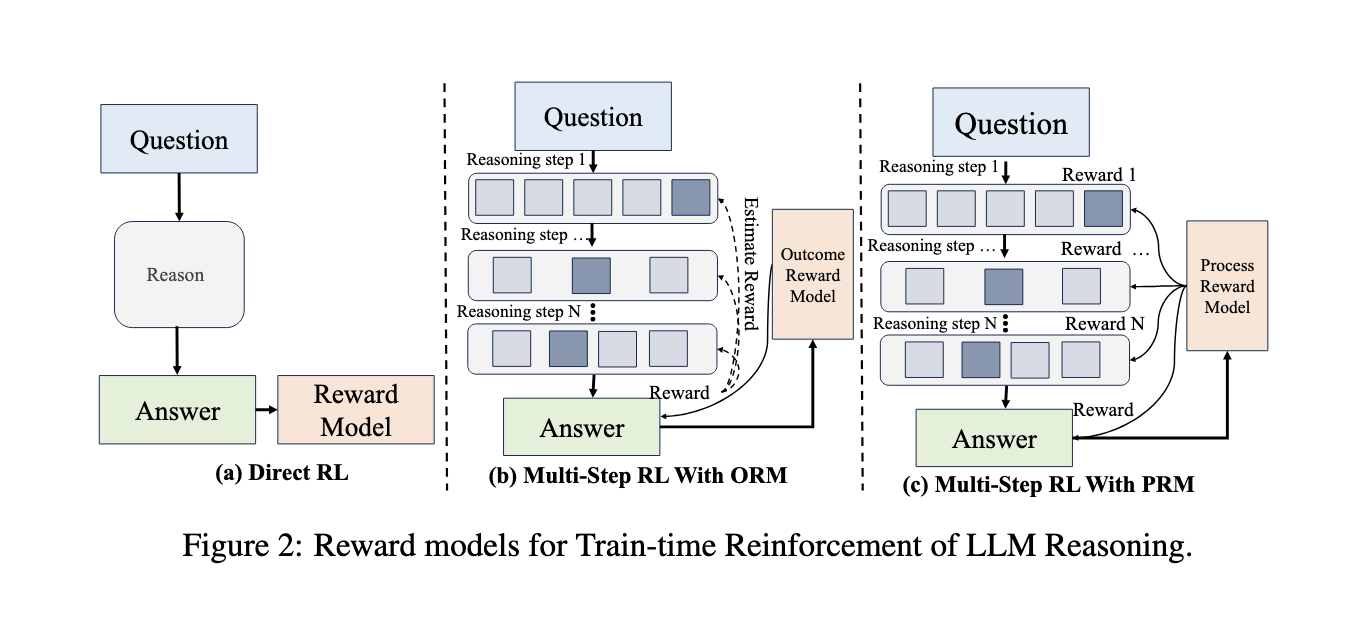
This AI Paper Explores Reinforced Learning and Process Reward Models ...
Advertisement Space (336x280)

Confidence as a Reward: Transforming LLMs into Reward Models | AI ...
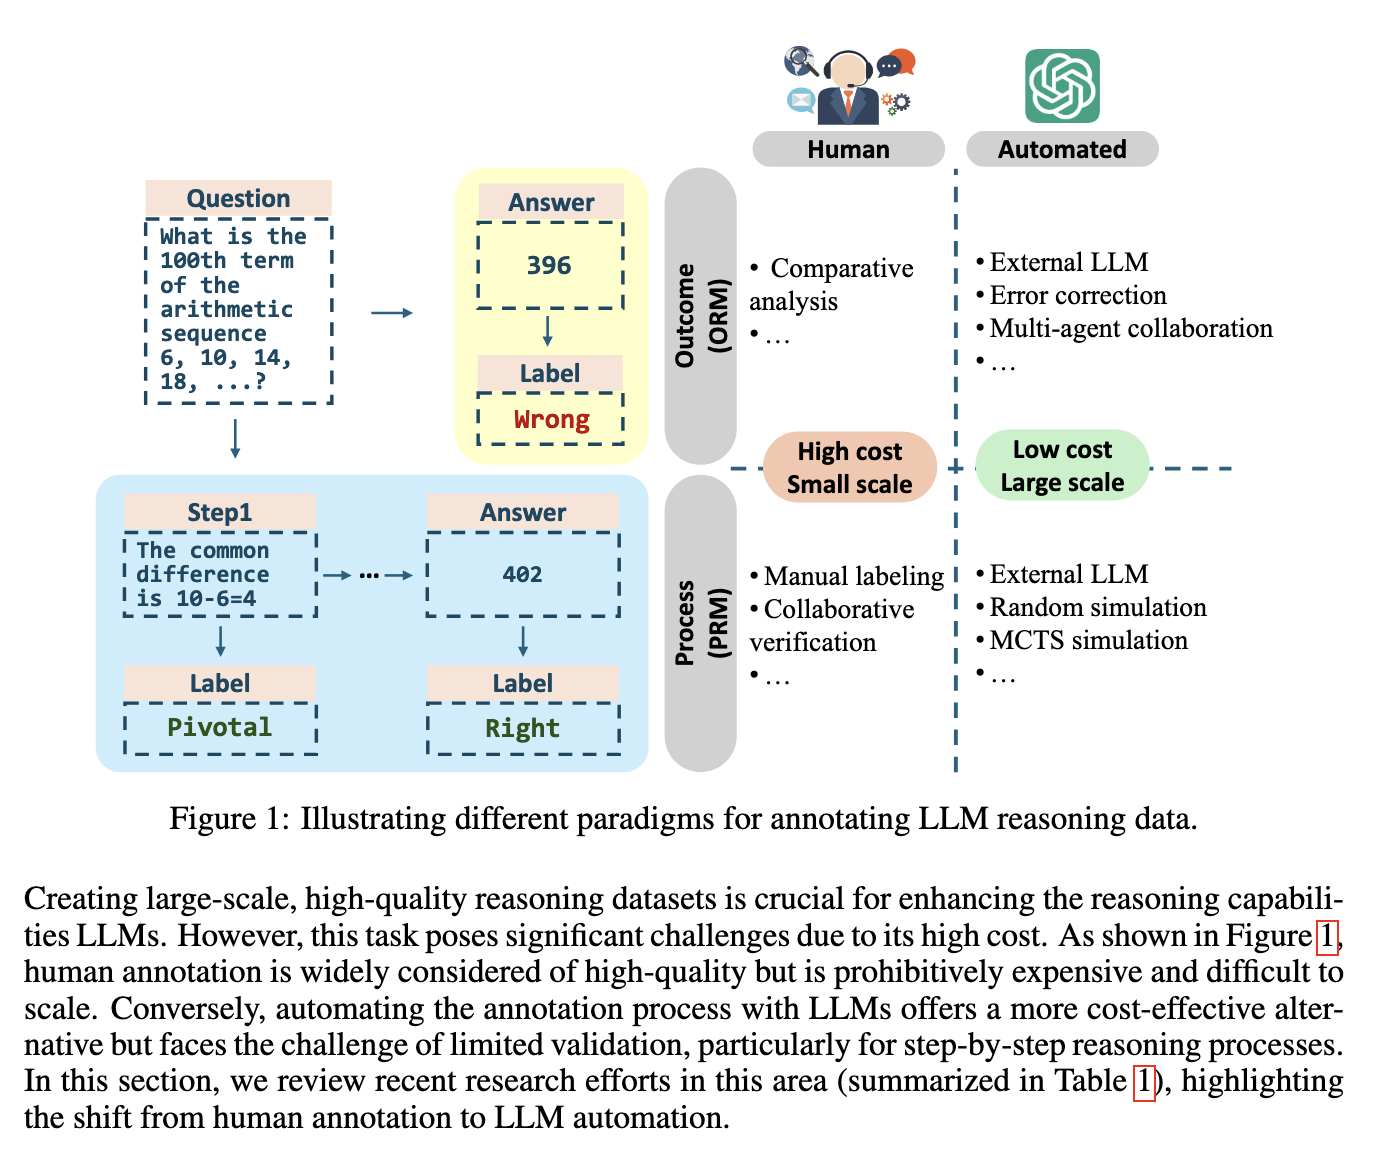
This AI Paper Explores Reinforced Learning and Process Reward Models ...

Sample-Efficient Alignment for LLMs | AI Research Paper Details
AlphaPO -- Reward shape matters for LLM alignment | AI Research Paper ...

LLMs for Explainable AI: A Comprehensive Survey | AI Research Paper Details

LoRe: Personalizing LLMs via Low-Rank Reward Modeling | AI Research ...

Figure 1 from Multimodal LLMs as Customized Reward Models for Text-to ...
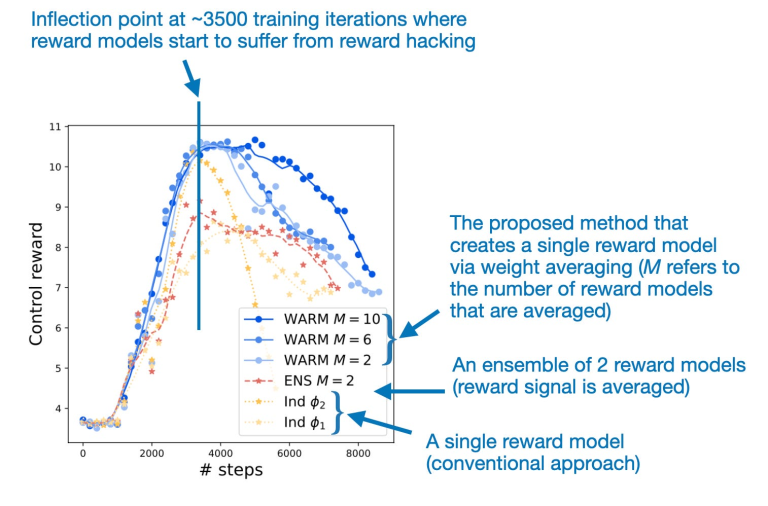
4 LLMs Research Paper in January 2025 - Analytics Vidhya

Aligning LLMs on a Budget: Inference-Time Alignment with Heuristic ...

Training LLMs with LogicReward for Faithful and Rigorous Reasoning | AI ...
Advertisement Space (336x280)

Paper page - Reusing Embeddings: Reproducible Reward Model Research in ...

This AI Paper Introduces Agentic Reward Modeling (ARM) and REWARDAGENT ...

ReMoDetect: Reward Models Recognize Aligned LLM's Generations | AI ...

Paper page - AI-Slop to AI-Polish? Aligning Language Models through ...

Paper page - Rethinking Reward Models for Multi-Domain Test-Time Scaling

Reward Is Enough: LLMs Are In-Context Reinforcement Learners | AI ...