
Bytescale Efficient Scaling Of Llm Training

Paper page - ByteScale: Efficient Scaling of LLM Training with a 2048K ...

ByteScale: Efficient Scaling of LLM Training with a 2048K Context ...

ByteScale: Efficient Scaling of LLM Training with a 2048K Context ...
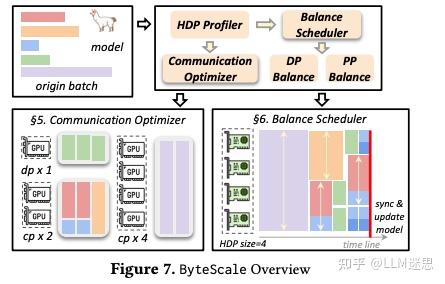
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
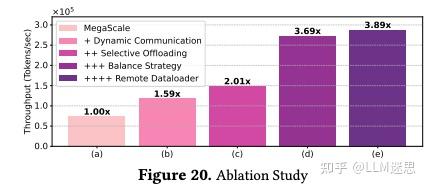
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
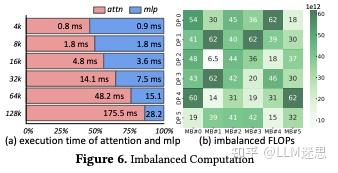
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
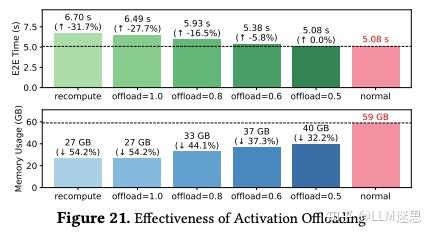
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
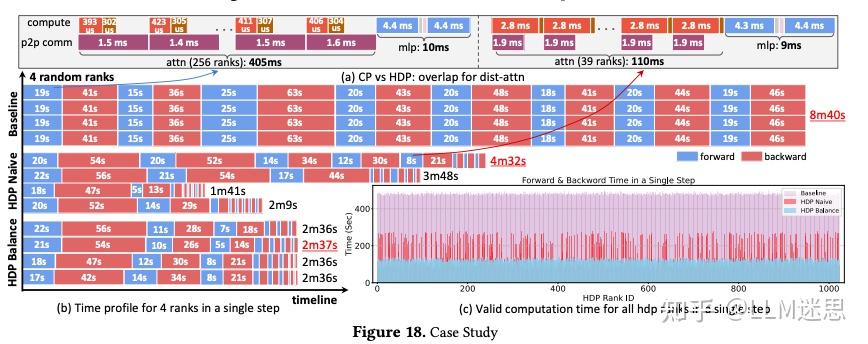
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...

Scaling with Collapse: Efficient and Predictable Training of LLM ...
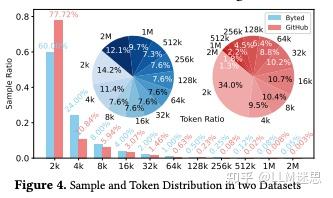
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
Advertisement Space (300x250)
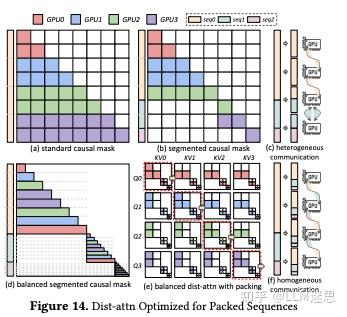
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
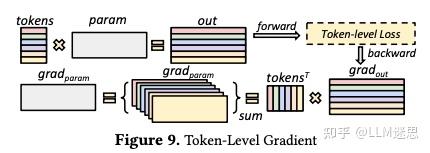
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
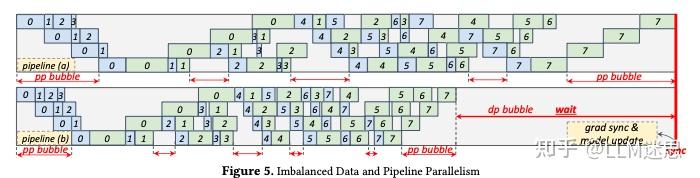
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
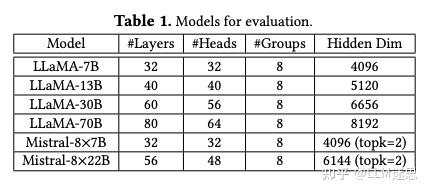
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
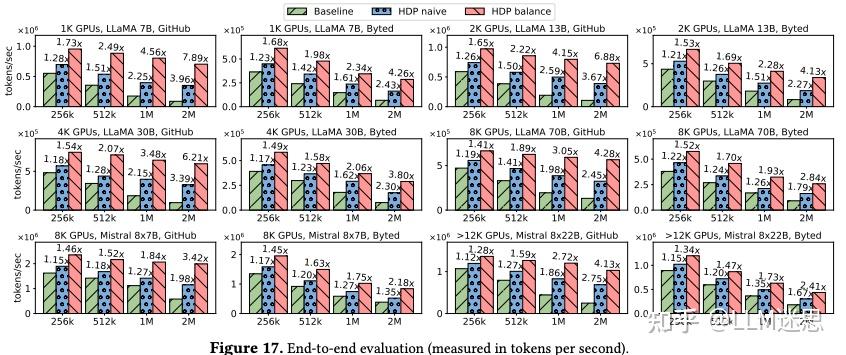
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
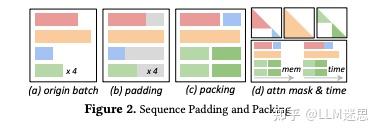
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
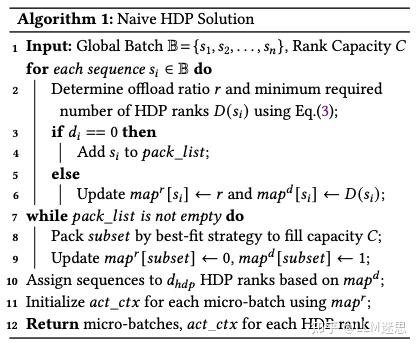
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
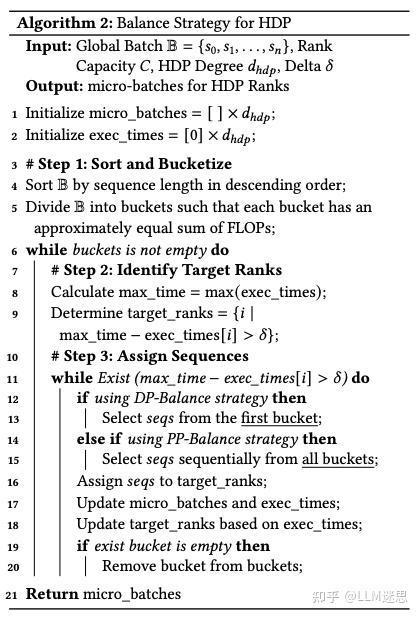
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
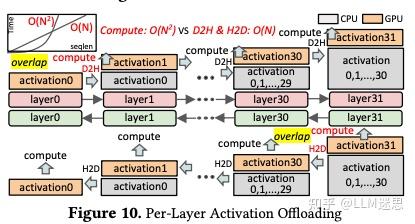
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
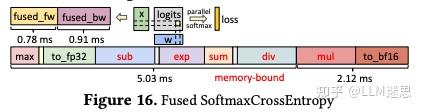
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
Advertisement Space (336x280)
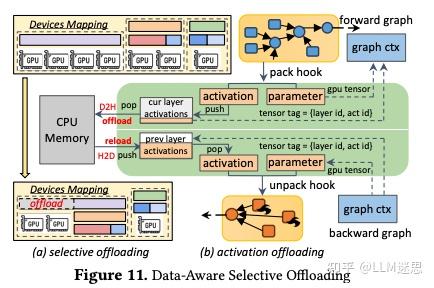
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
ByteScale: Communication-Efficient Scaling of LLM Training with a 2048K ...

[논문 리뷰] Scaling with Collapse: Efficient and Predictable Training of ...

Harmonizing Multi-GPUs: Efficient Scaling of LLM Inference | by TitanML ...
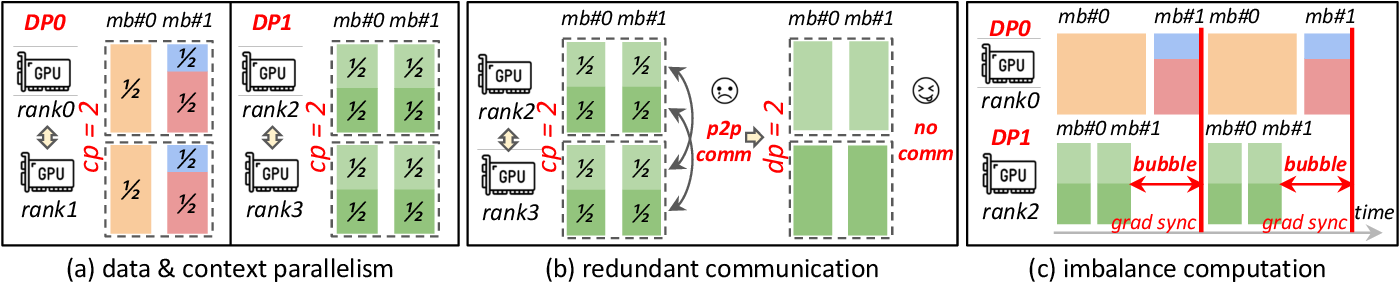
Figure 3 from ByteScale: Communication-Efficient Scaling of LLM ...
LLM Scaling Laws: A Synthesis of Hyperparameter Optimization and Long ...
How to Apply Scaling Laws to LLM Training

MIT-IBM Watson Lab: How AI Scaling Laws Are Transforming LLM Training ...

Analysis of LLM Architectures and AWS for Training and Inference Pipelines
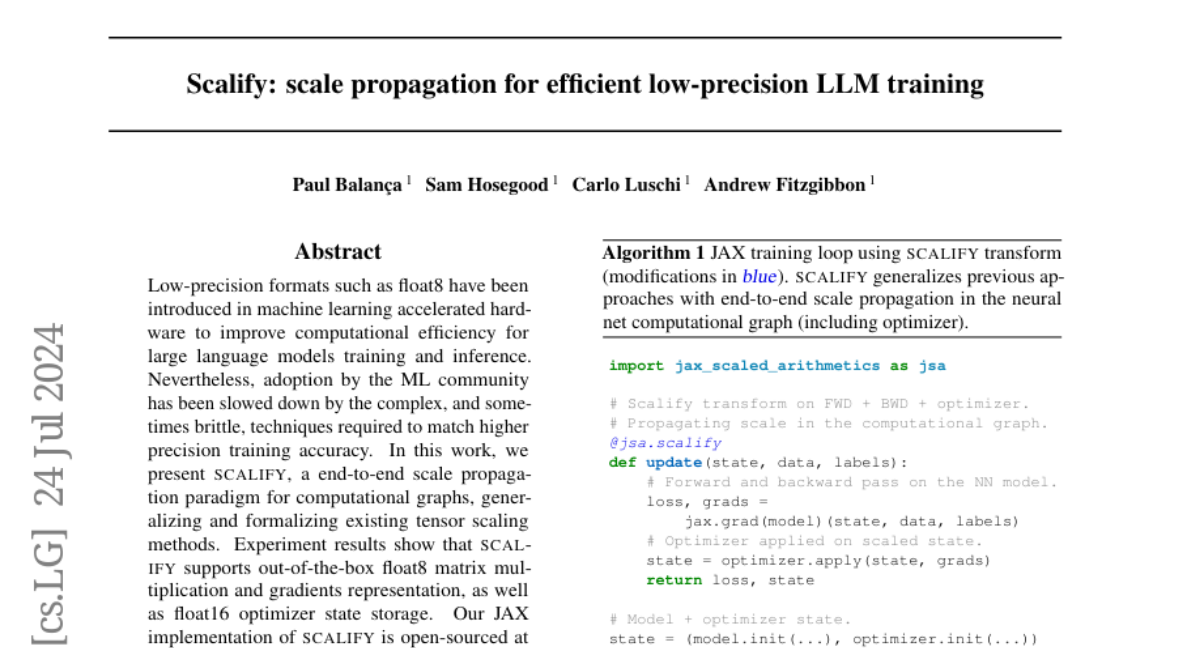
Scalify: scale propagation for efficient low-precision LLM training ...
Advertisement Space (336x280)

Rethinking LLM scaling laws for both training and inference efficiency
Comparing efficiency of LLM training methods - Consensus
CodeScaler: Scaling Code LLM Training and Test-Time Inference via ...

What should we focus on, (more) LLM training or inference scaling ...
Scalify: scale propagation for efficient low-precision LLM training ...

MOSS: Efficient and Accurate FP8 LLM Training with Microscaling and ...