
Bytescale Efficient Scaling Of Llm Training With A 2048k Context

ByteScale: Efficient Scaling of LLM Training with a 2048K Context ...

ByteScale: Efficient Scaling of LLM Training with a 2048K Context ...

Paper page - ByteScale: Efficient Scaling of LLM Training with a 2048K ...
ByteScale: Communication-Efficient Scaling of LLM Training with a 2048K ...

Scaling with Collapse: Efficient and Predictable Training of LLM ...

Scaling to Millions of Tokens with Efficient Long-Context LLM Training ...

[论文评述] Scaling with Collapse: Efficient and Predictable Training of LLM ...

Scaling to Millions of Tokens with Efficient Long-Context LLM Training ...
Scaling to Millions of Tokens with Efficient Long-Context LLM Training ...

Scaling to Millions of Tokens with Efficient Long-Context LLM Training ...
Advertisement Space (300x250)
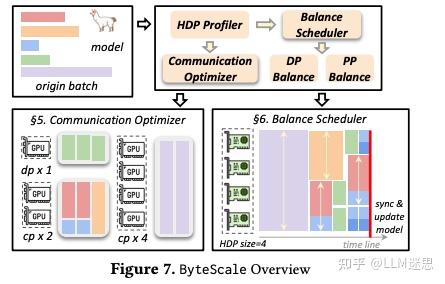
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
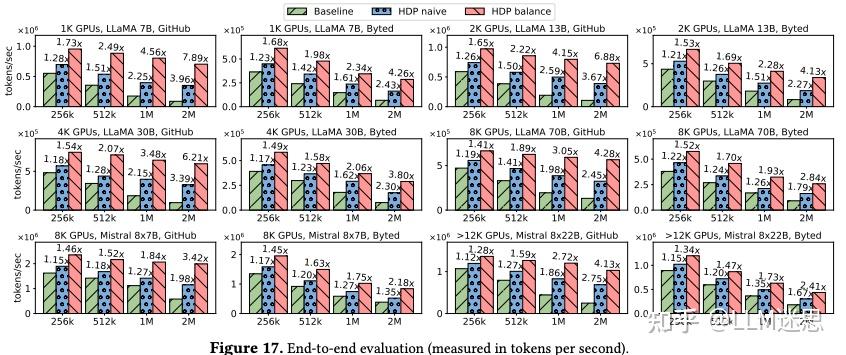
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
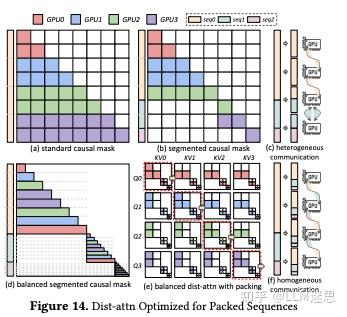
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
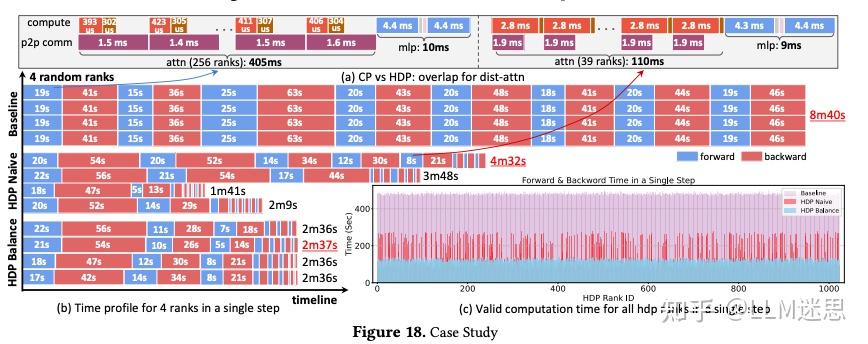
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
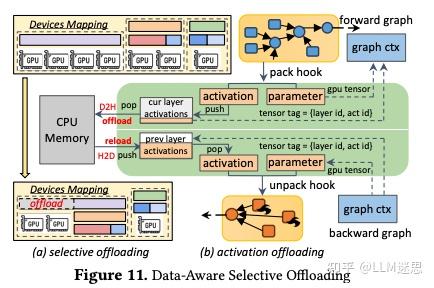
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
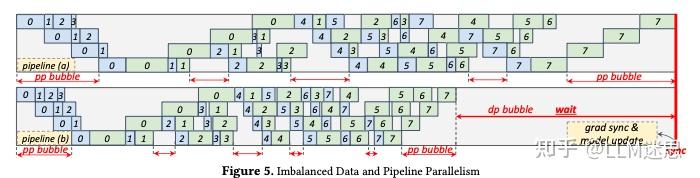
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
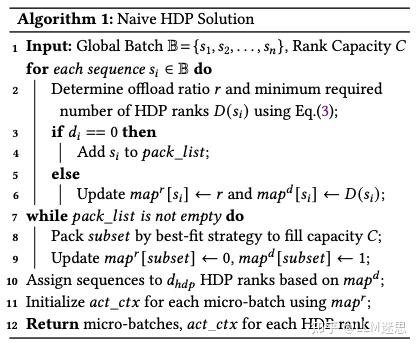
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
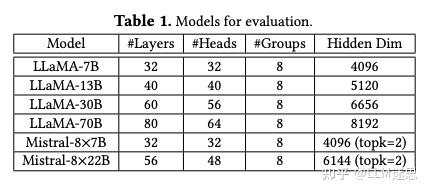
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
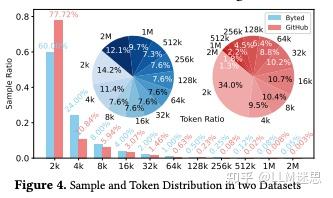
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
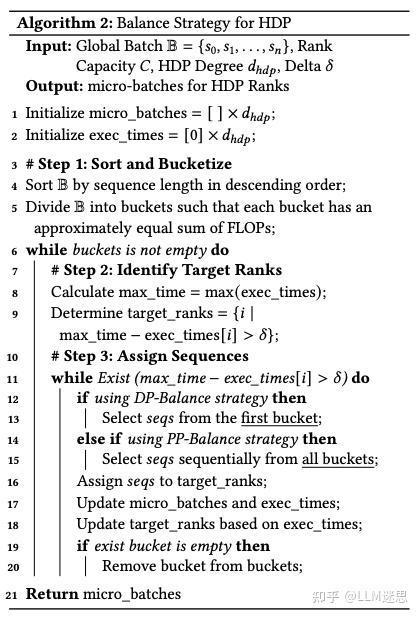
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
Advertisement Space (336x280)
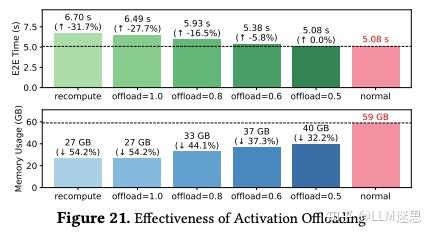
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
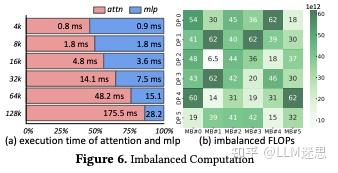
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
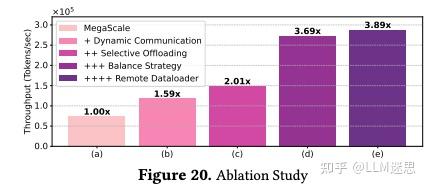
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
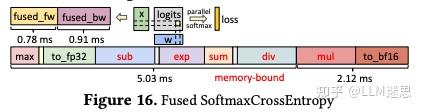
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
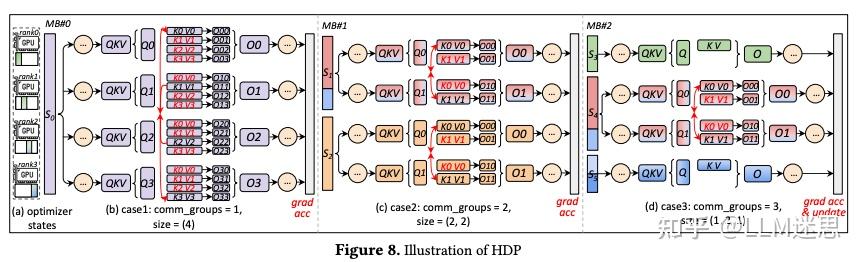
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
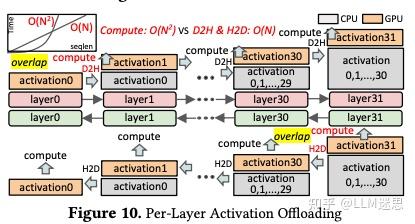
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
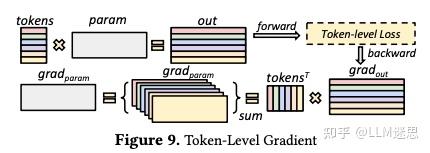
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
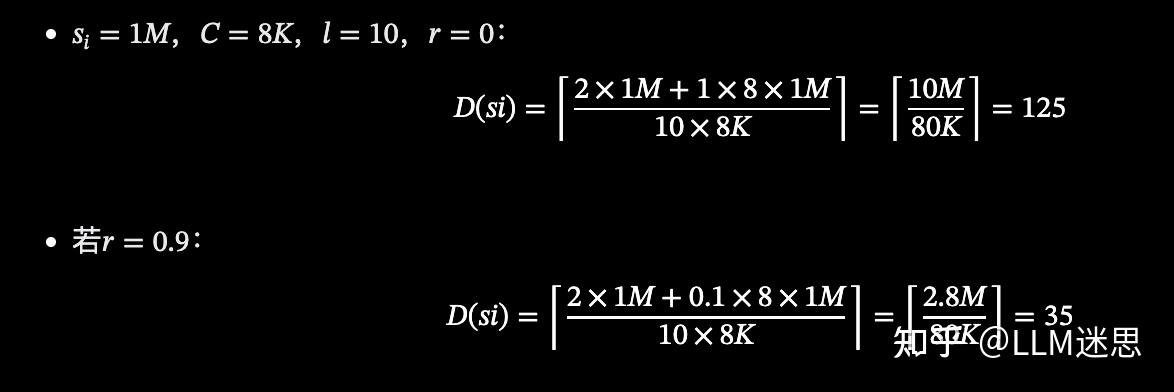
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
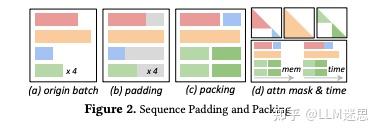
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
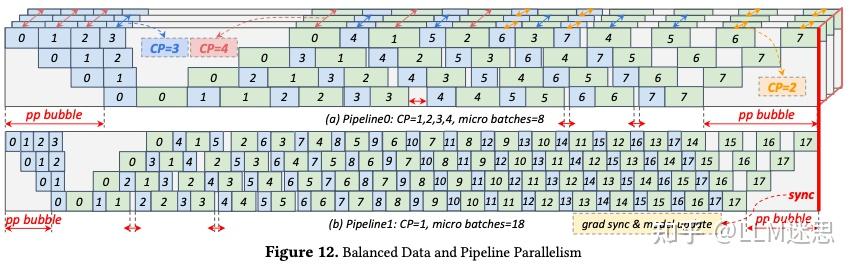
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
Advertisement Space (336x280)
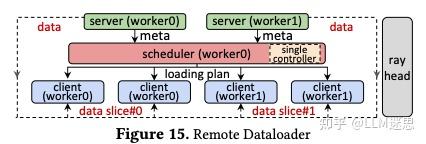
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
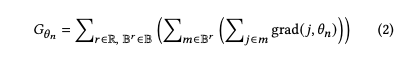
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...

LLM Scaling Laws: A Synthesis of Hyperparameter Optimization and Long ...
DeepSeek-V3: Achieving Efficient LLM Scaling with 2,048 GPUs - Bens Bites

Scaling LLM Training with Dedicated GPU Cluster Solutions