
Paper Page Bytescale Efficient Scaling Of Llm Training With A 2048k

Paper page - ByteScale: Efficient Scaling of LLM Training with a 2048K ...

ByteScale: Efficient Scaling of LLM Training with a 2048K Context ...

ByteScale: Efficient Scaling of LLM Training with a 2048K Context ...
ByteScale: Communication-Efficient Scaling of LLM Training with a 2048K ...

Scaling with Collapse: Efficient and Predictable Training of LLM ...

Paper page - A Little Help Goes a Long Way: Efficient LLM Training by ...
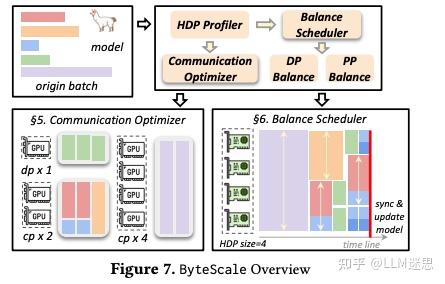
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
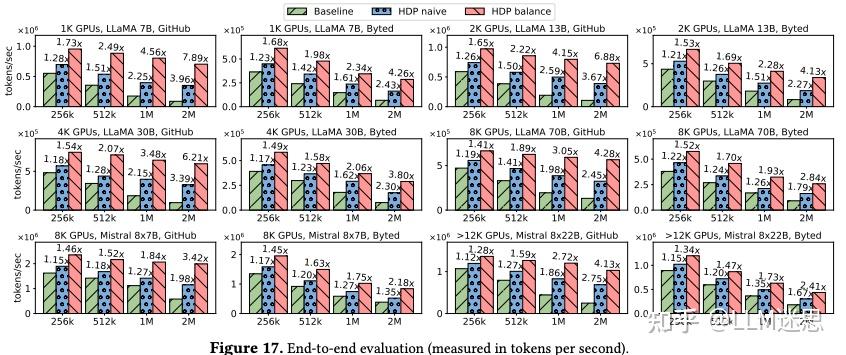
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
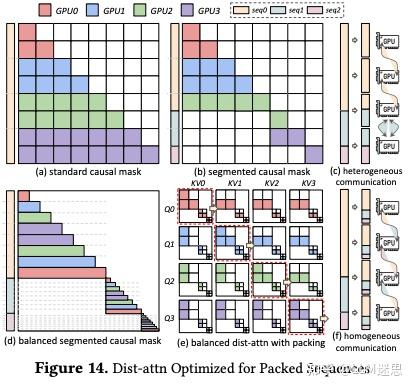
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
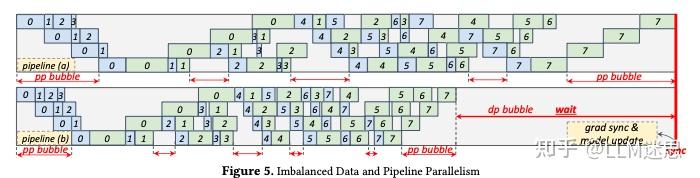
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
Advertisement Space (300x250)
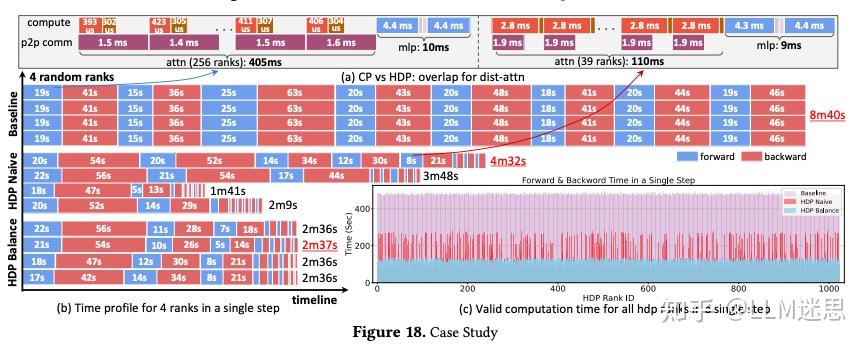
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
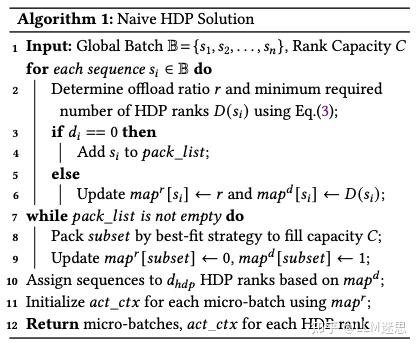
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
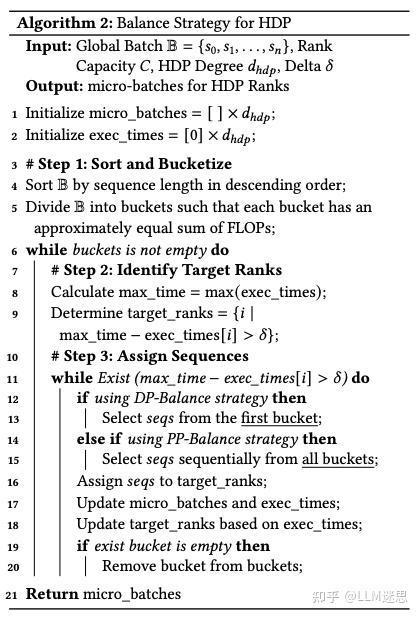
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
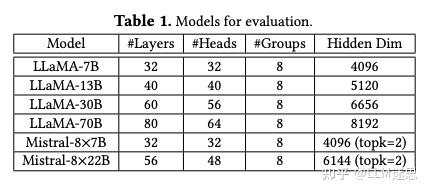
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
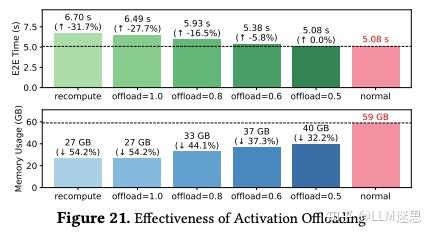
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
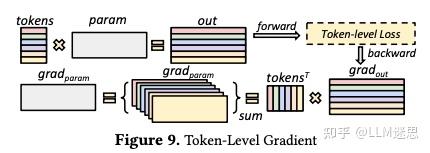
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
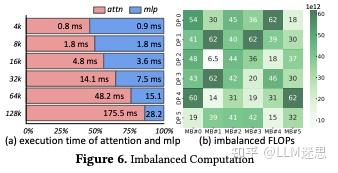
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
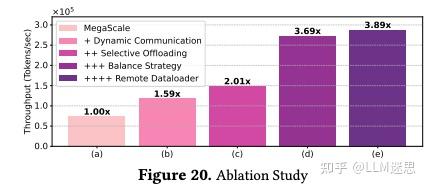
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...

[논문 리뷰] Scaling with Collapse: Efficient and Predictable Training of ...
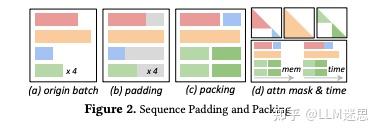
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
Advertisement Space (336x280)
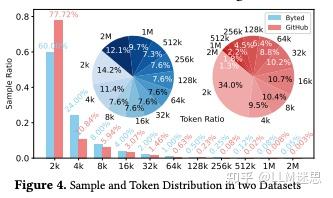
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...

Paper page - Benchmark Test-Time Scaling of General LLM Agents
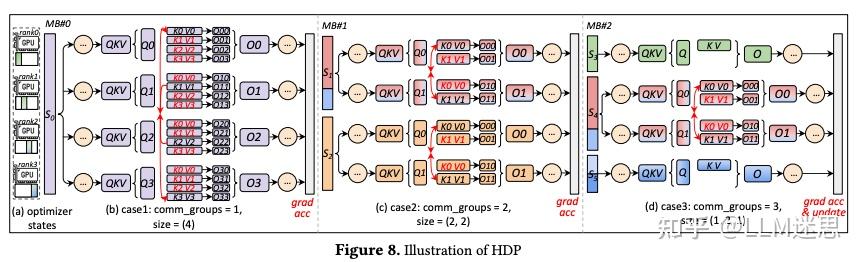
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
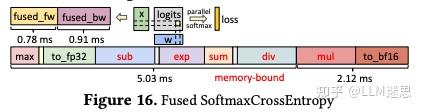
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
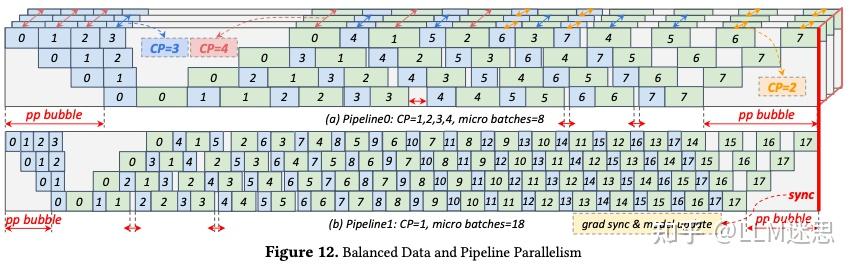
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
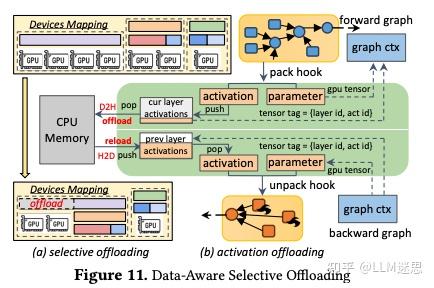
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
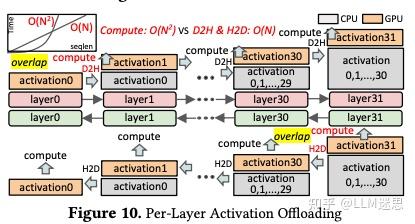
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...

Paper page - Paper Copilot: A Self-Evolving and Efficient LLM System ...
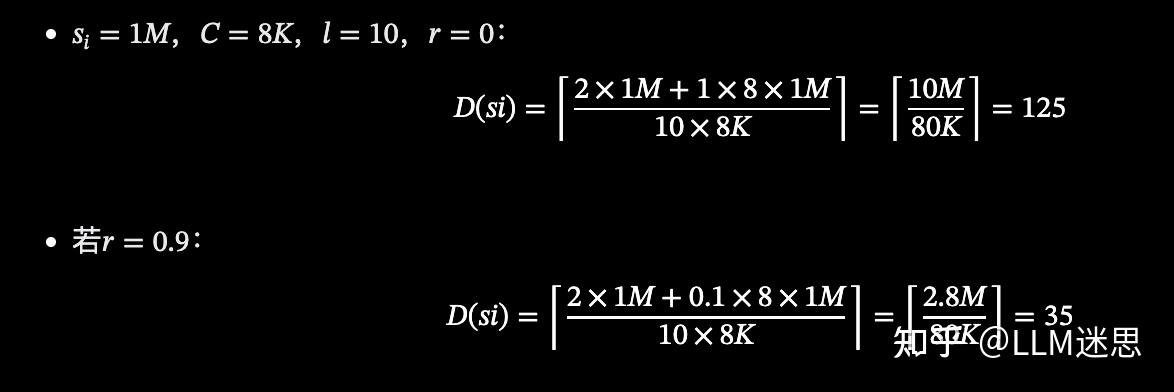
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...

Paper page - Memory-Efficient LLM Training with Online Subspace Descent
Advertisement Space (336x280)

Paper page - User-LLM: Efficient LLM Contextualization with User Embeddings

Paper page - LLaMAX: Scaling Linguistic Horizons of LLM by Enhancing ...

Paper page - Scaling LLM Pre-training with Vocabulary Curriculum

Paper page - Scalify: scale propagation for efficient low-precision LLM ...

Paper page - Scaling LLM Test-Time Compute Optimally can be More ...

Paper page - LongRoPE2: Near-Lossless LLM Context Window Scaling