
Bytescale Communication Efficient Scaling Of Llm Training With A 2048k

Paper page - ByteScale: Efficient Scaling of LLM Training with a 2048K ...

ByteScale: Efficient Scaling of LLM Training with a 2048K Context ...

ByteScale: Efficient Scaling of LLM Training with a 2048K Context ...
ByteScale: Communication-Efficient Scaling of LLM Training with a 2048K ...

Scaling with Collapse: Efficient and Predictable Training of LLM ...
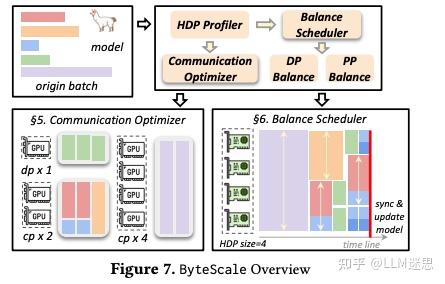
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
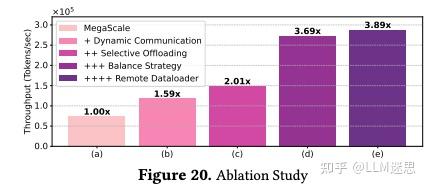
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
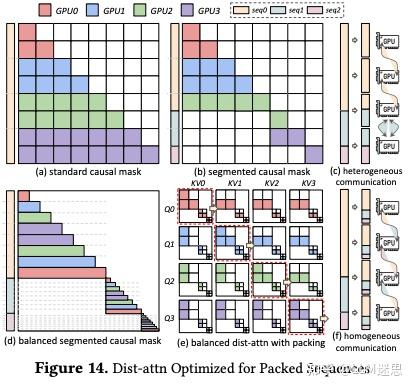
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
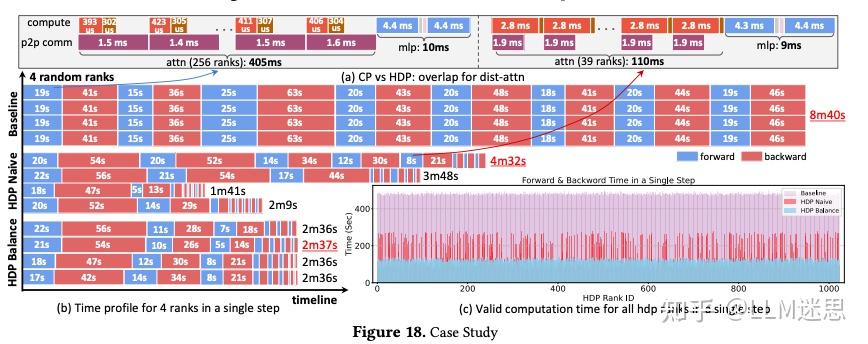
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
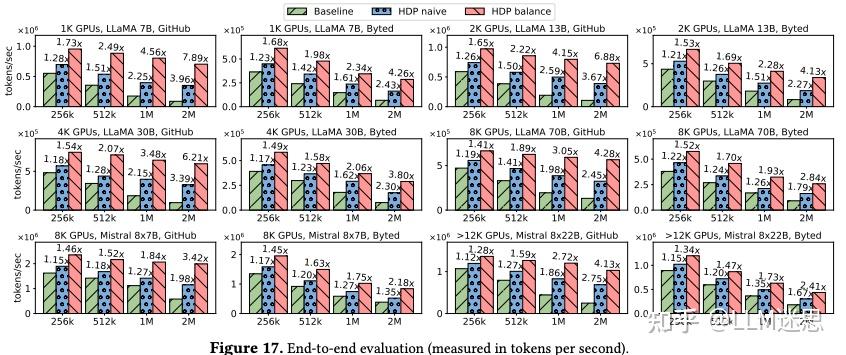
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
Advertisement Space (300x250)
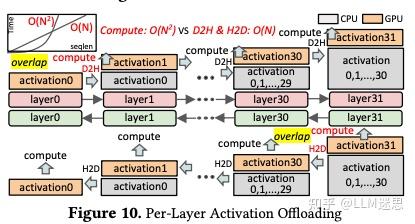
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
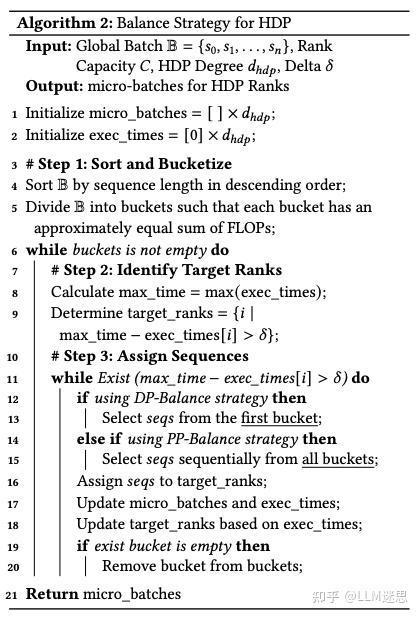
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
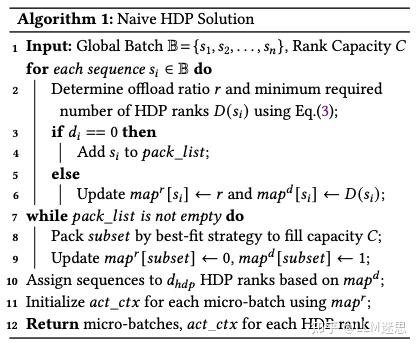
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
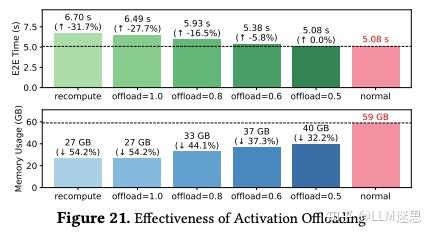
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
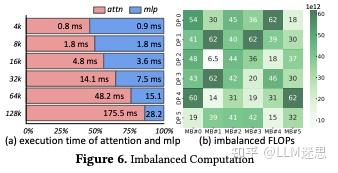
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
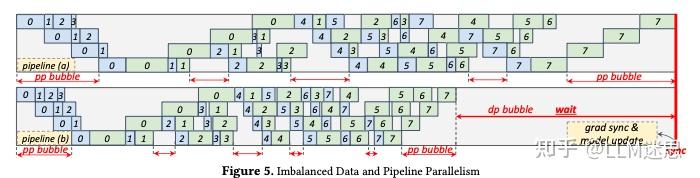
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
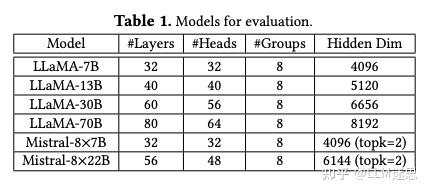
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
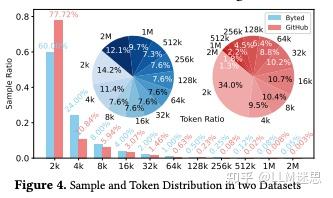
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
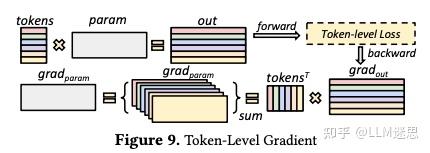
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
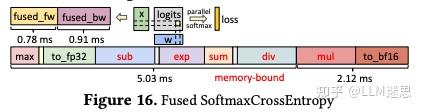
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
Advertisement Space (336x280)
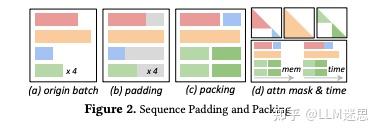
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
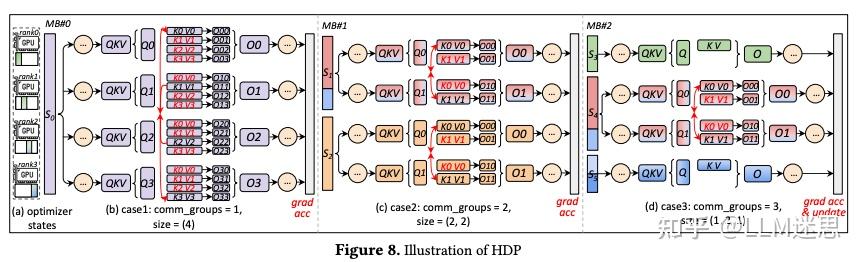
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
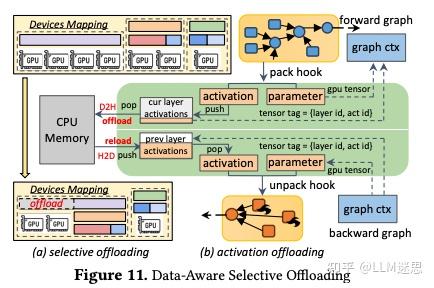
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...

[논문 리뷰] Scaling with Collapse: Efficient and Predictable Training of ...
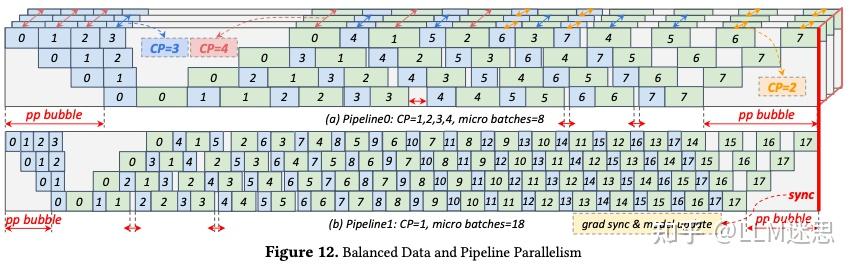
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
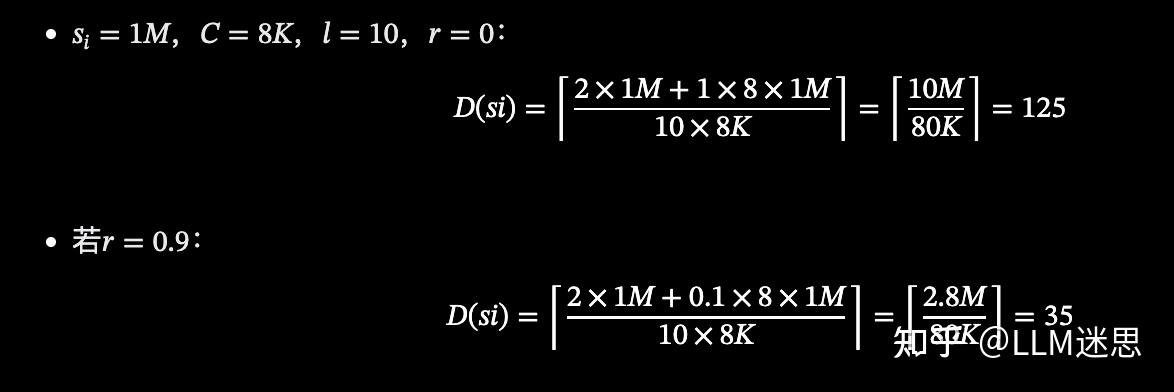
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
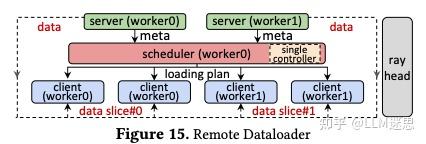
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
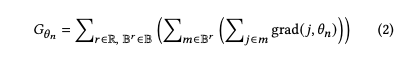
【分布式训练技术分享二十五】聊聊字节万卡优化工作 ByteScale: Efficient Scaling of LLM Training ...
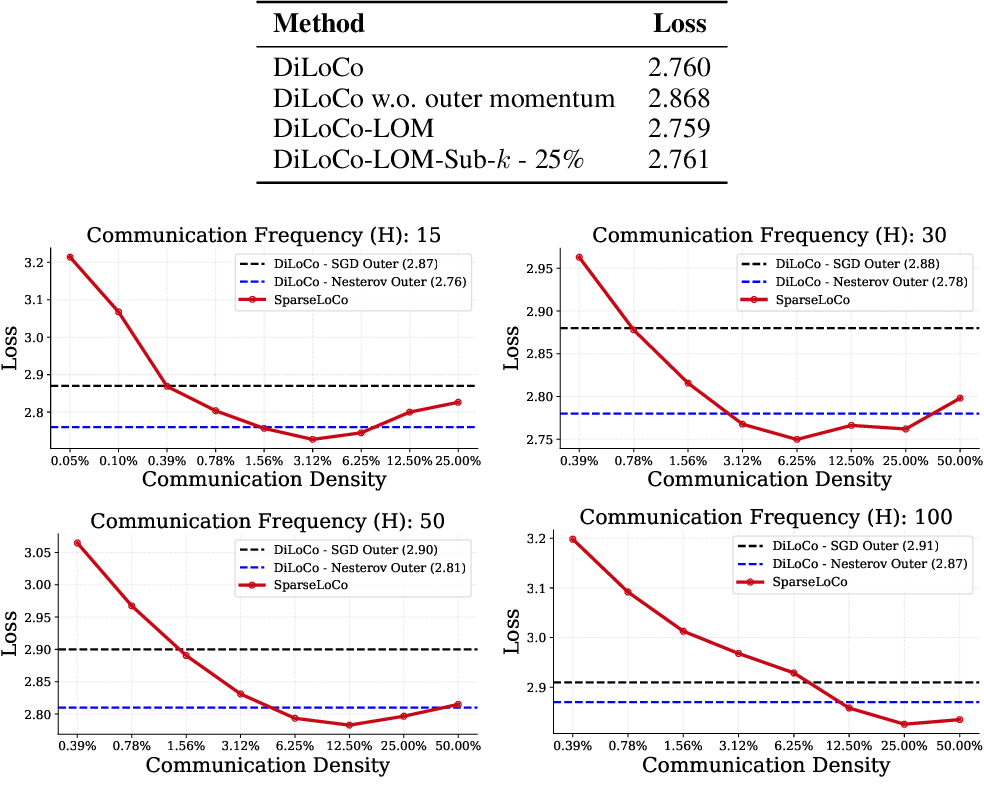
Figure 1 from Communication Efficient LLM Pre-training with SparseLoCo ...

DeepSpeed ZeRO++: A leap in speed for LLM and chat model training with ...
Advertisement Space (336x280)
DeepSeek-V3: Achieving Efficient LLM Scaling with 2,048 GPUs - Bens Bites

Scaling LLM Training with Dedicated GPU Cluster Solutions

DeepSpeed ZeRO++: A leap in speed for LLM and chat model training with ...

MOSS: Efficient and Accurate FP8 LLM Training with Microscaling and ...

MOSS: Efficient and Accurate FP8 LLM Training with Microscaling and ...
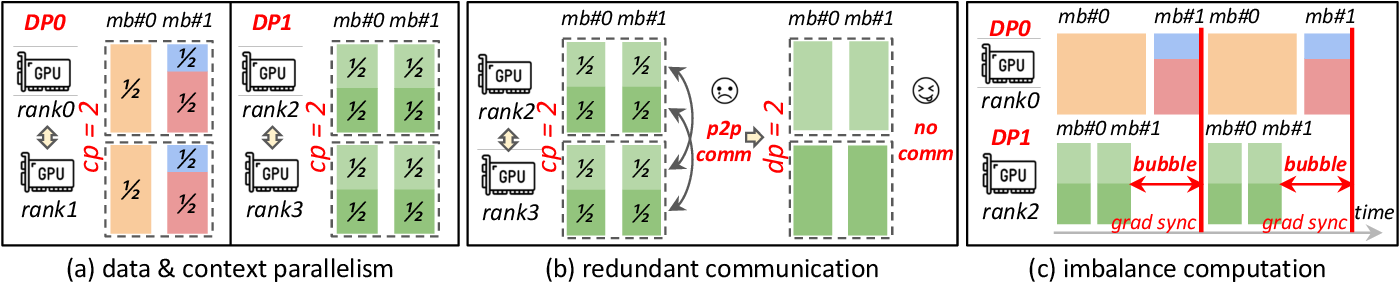
Figure 3 from ByteScale: Communication-Efficient Scaling of LLM ...