
Continuous Batching For Llm Inference Throughput And Latency Gains
Continuous Batching for LLM Inference: Throughput and Latency Gains ...
Continuous batching to increase LLM inference throughput and reduce p50 ...

How continuous batching enables 23x throughput in LLM inference ...

How continuous batching enables 23x throughput in LLM inference ...

[논문 리뷰] Multi-Bin Batching for Increasing LLM Inference Throughput

How continuous batching enables 23x throughput in LLM inference ...

How continuous batching enables 23x throughput in LLM inference ...

How continuous batching enables 23x throughput in LLM inference ...

How continuous batching enables 23x throughput in LLM inference ...

How continuous batching enables 23x throughput in LLM inference ...
Advertisement Space (300x250)

How continuous batching enables 23x throughput in LLM inference ...

How continuous batching enables 23x throughput in LLM inference ...

How continuous batching enables 23x throughput in LLM inference ...

How continuous batching enables 23x throughput in LLM inference ...

How continuous batching enables 23x throughput in LLM inference ...

How continuous batching enables 23x throughput in LLM inference ...

How continuous batching enables 23x throughput in LLM inference ...

How continuous batching enables 23x throughput in LLM inference ...

LLM Inference Performance: Latency and Throughput Metrics - YouTube

How continuous batching enables 23x throughput in LLM inference ...
Advertisement Space (336x280)

Meet vLLM: For faster, more efficient LLM inference and serving
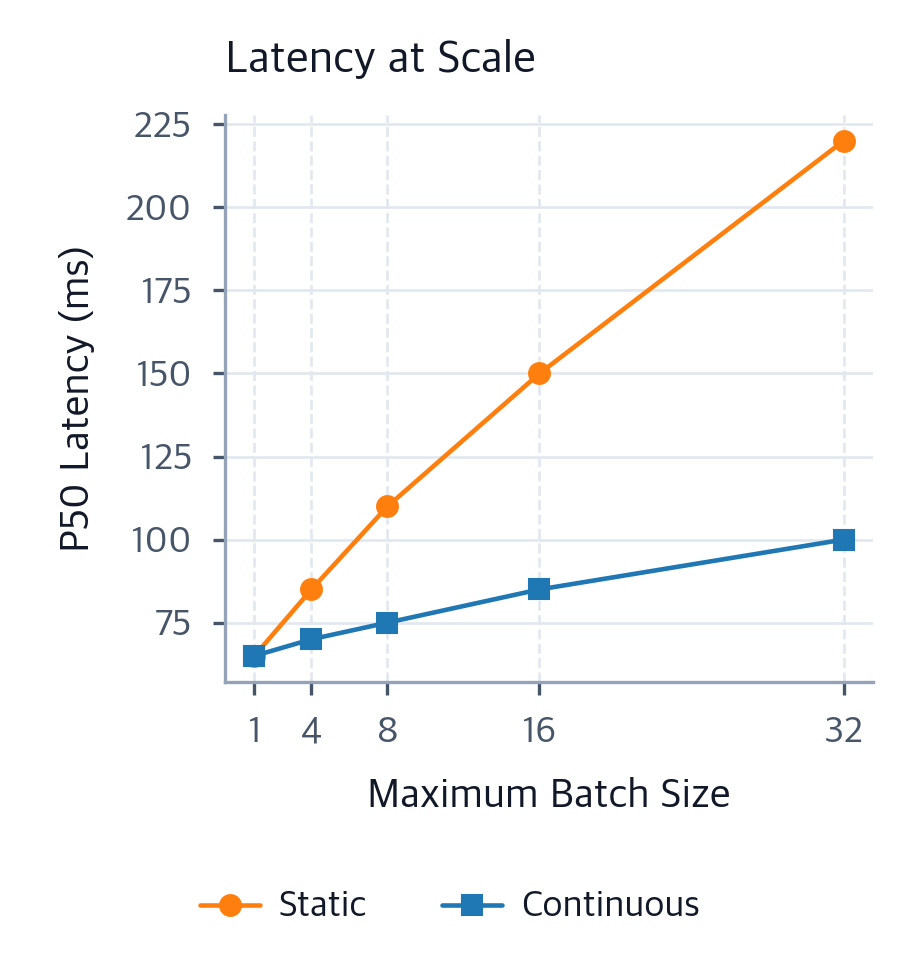
Continuous Batching: Optimizing LLM Inference Throughput - Interactive ...
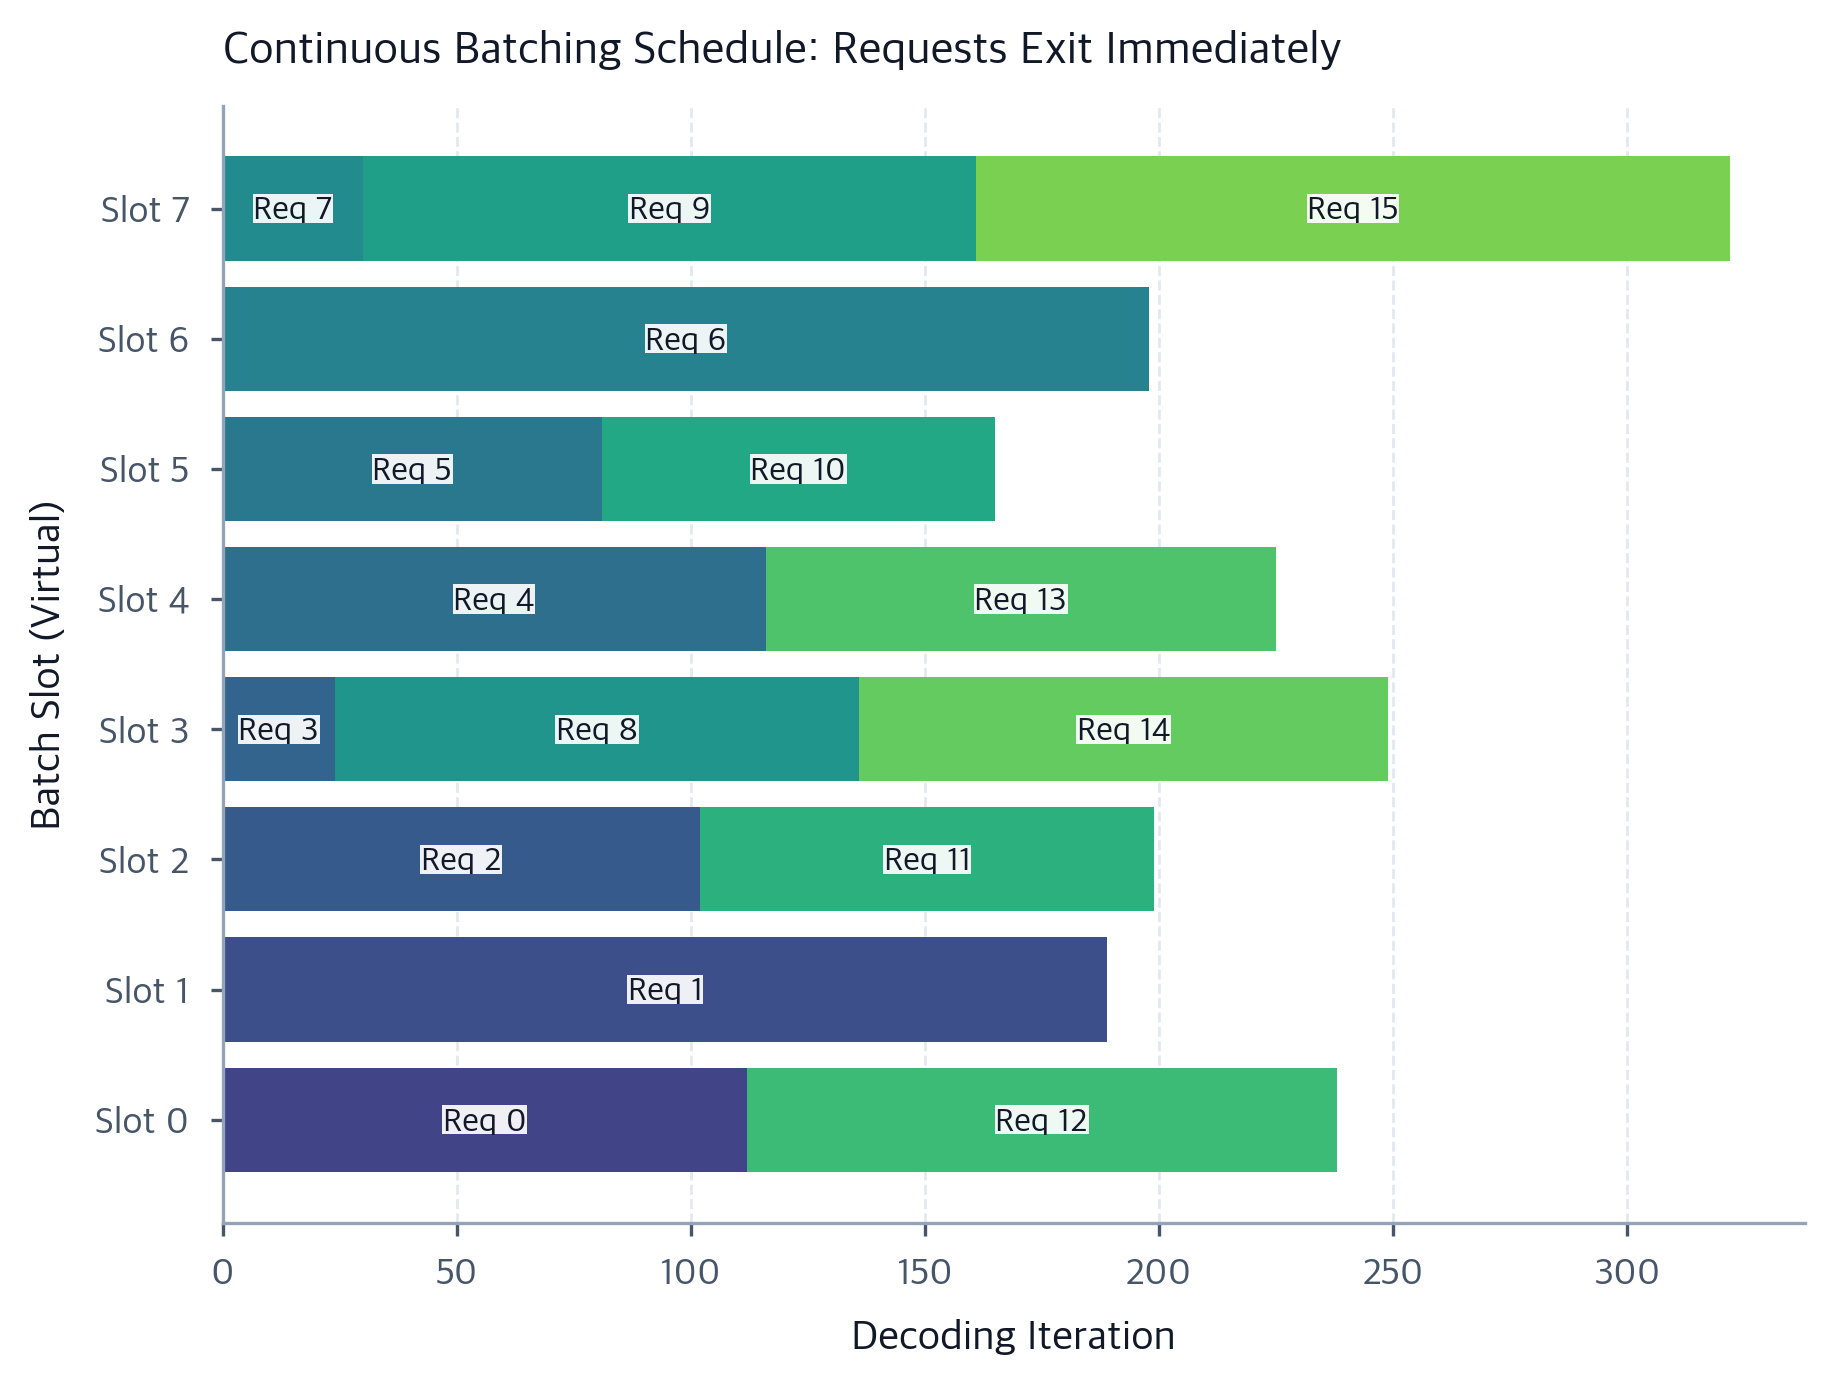
Continuous Batching: Optimizing LLM Inference Throughput - Interactive ...
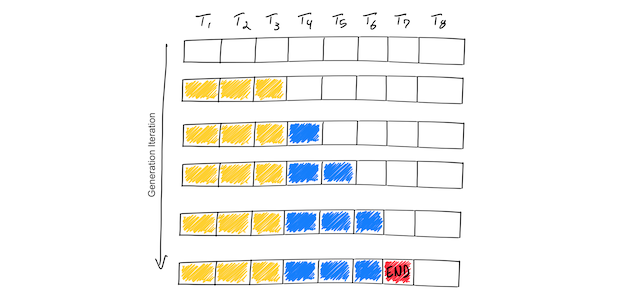
Achieve 23x LLM Inference Throughput & Reduce p50 Latency
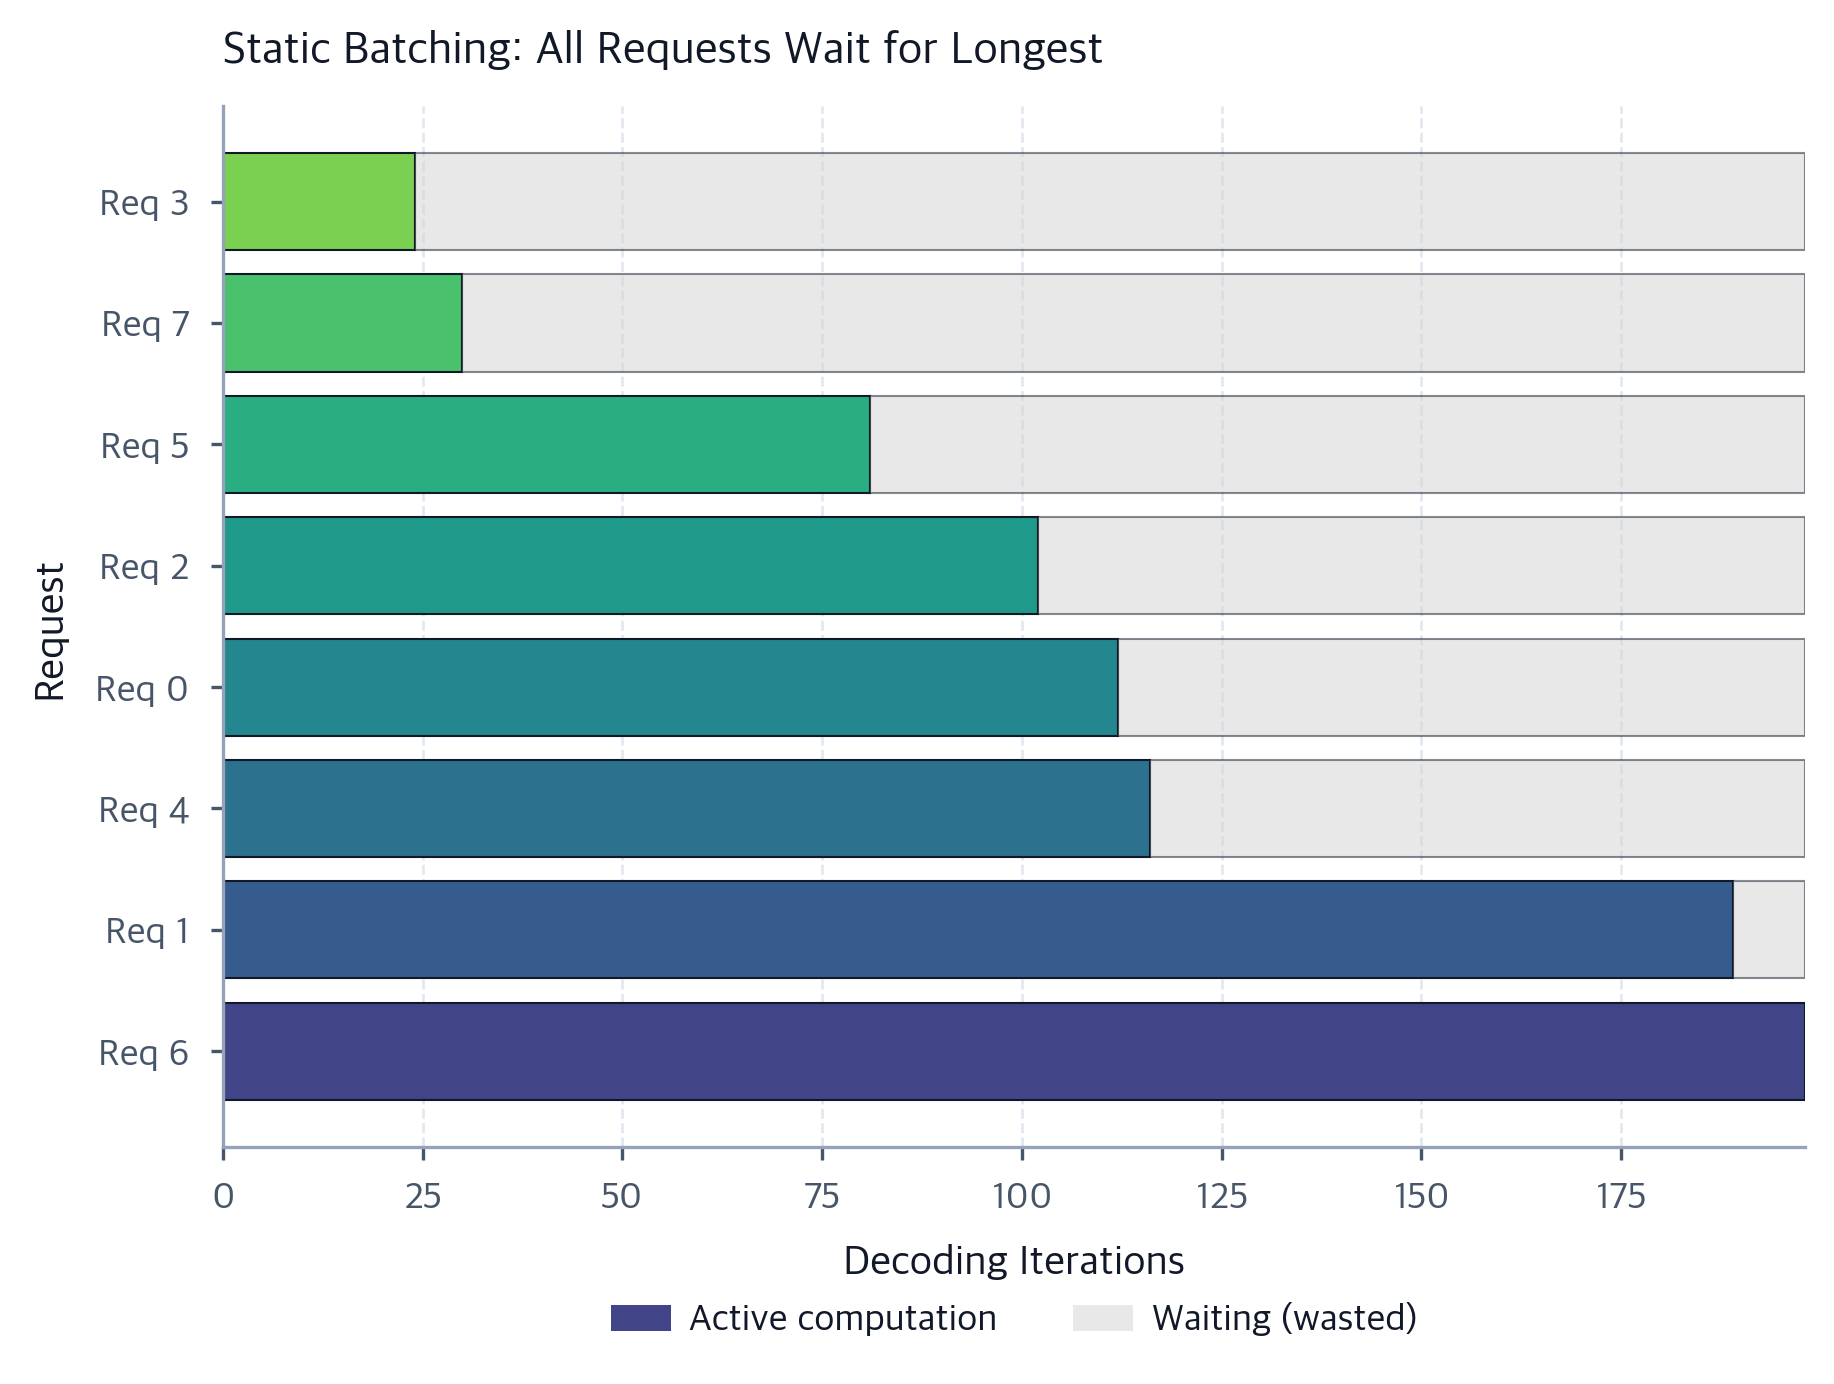
Continuous Batching: Optimizing LLM Inference Throughput - Interactive ...
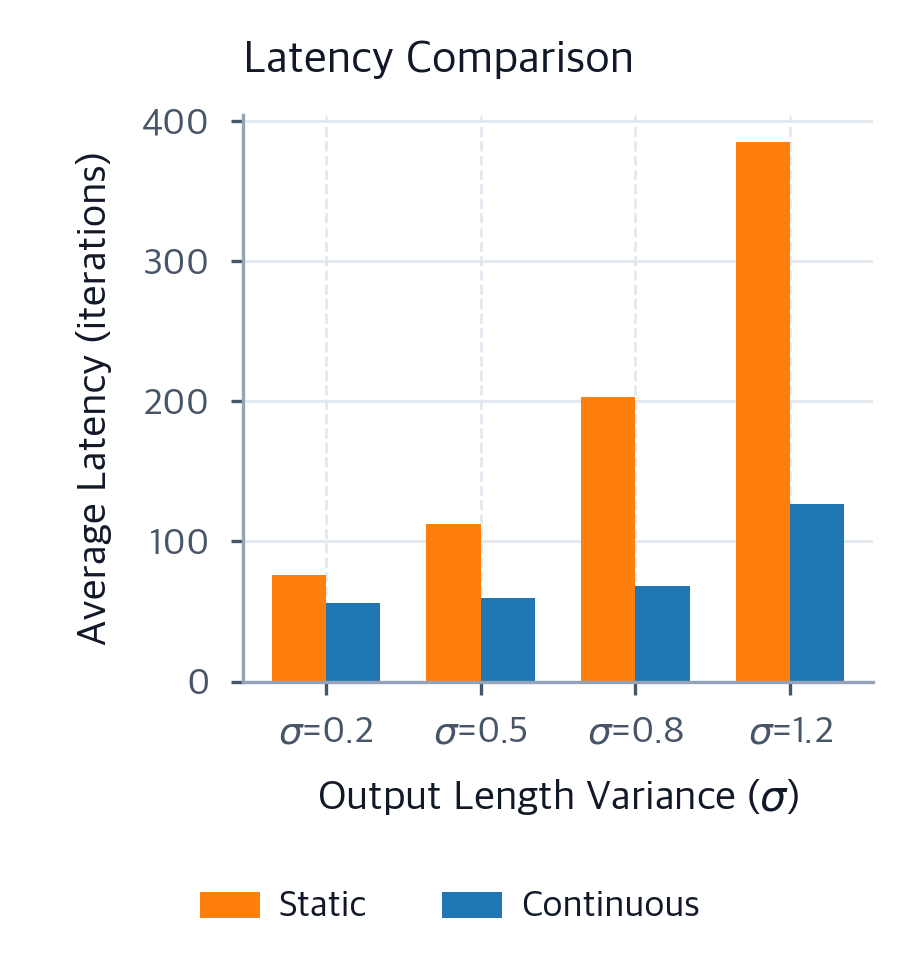
Continuous Batching: Optimizing LLM Inference Throughput - Interactive ...
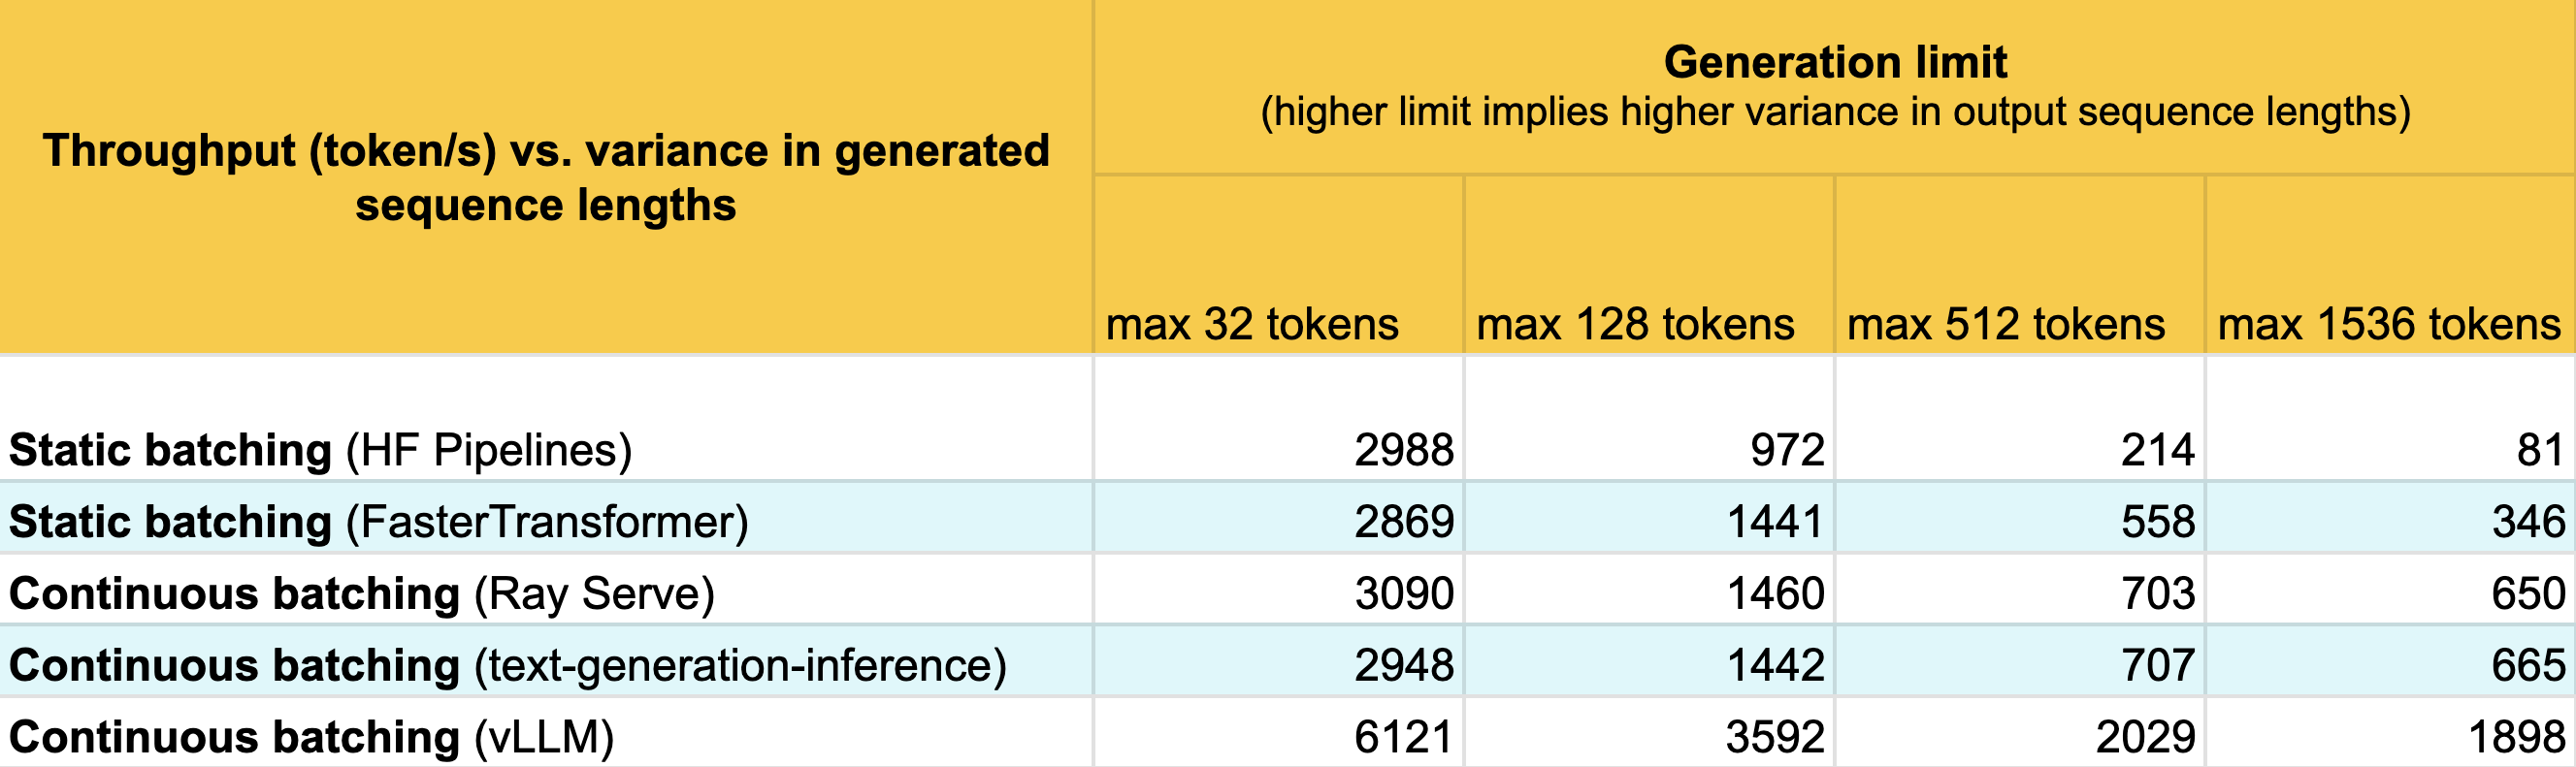
Achieve 23x LLM Inference Throughput & Reduce p50 Latency
Achieve 23x LLM Inference Throughput & Reduce p50 Latency
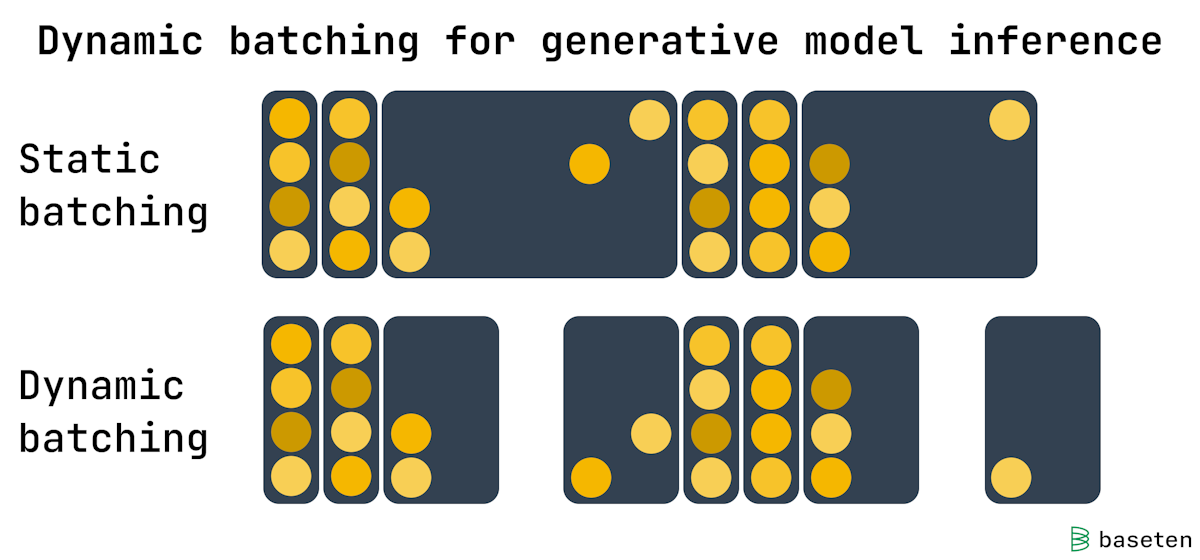
Continuous vs dynamic batching for AI inference | Baseten Blog
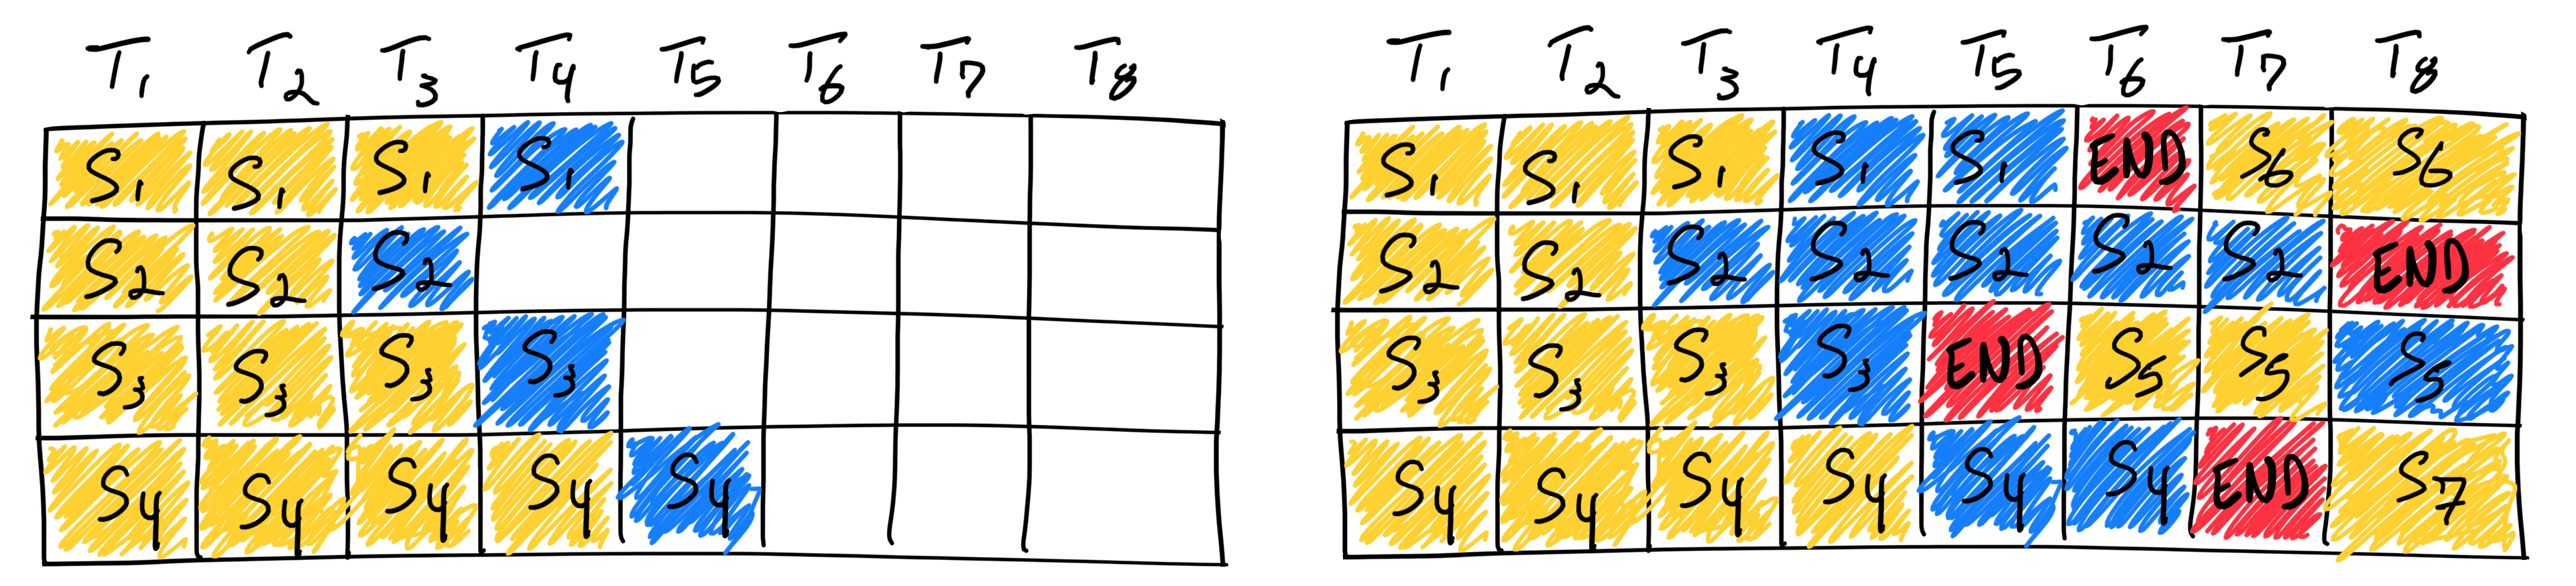
Achieve 23x LLM Inference Throughput & Reduce p50 Latency
Advertisement Space (336x280)
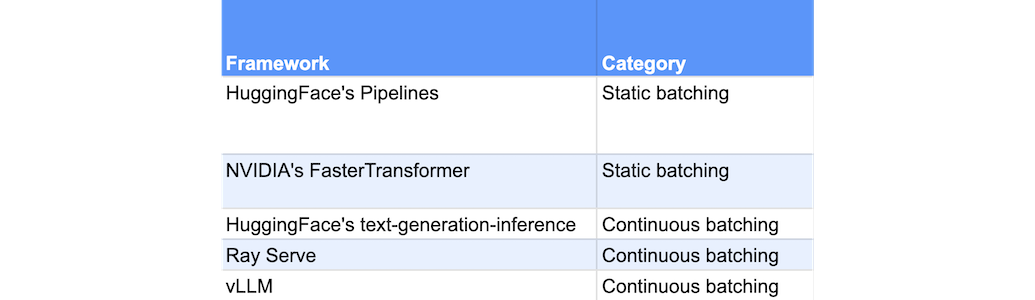
Achieve 23x LLM Inference Throughput & Reduce p50 Latency

Continuous Batching: Optimizing LLM Inference Throughput from First ...
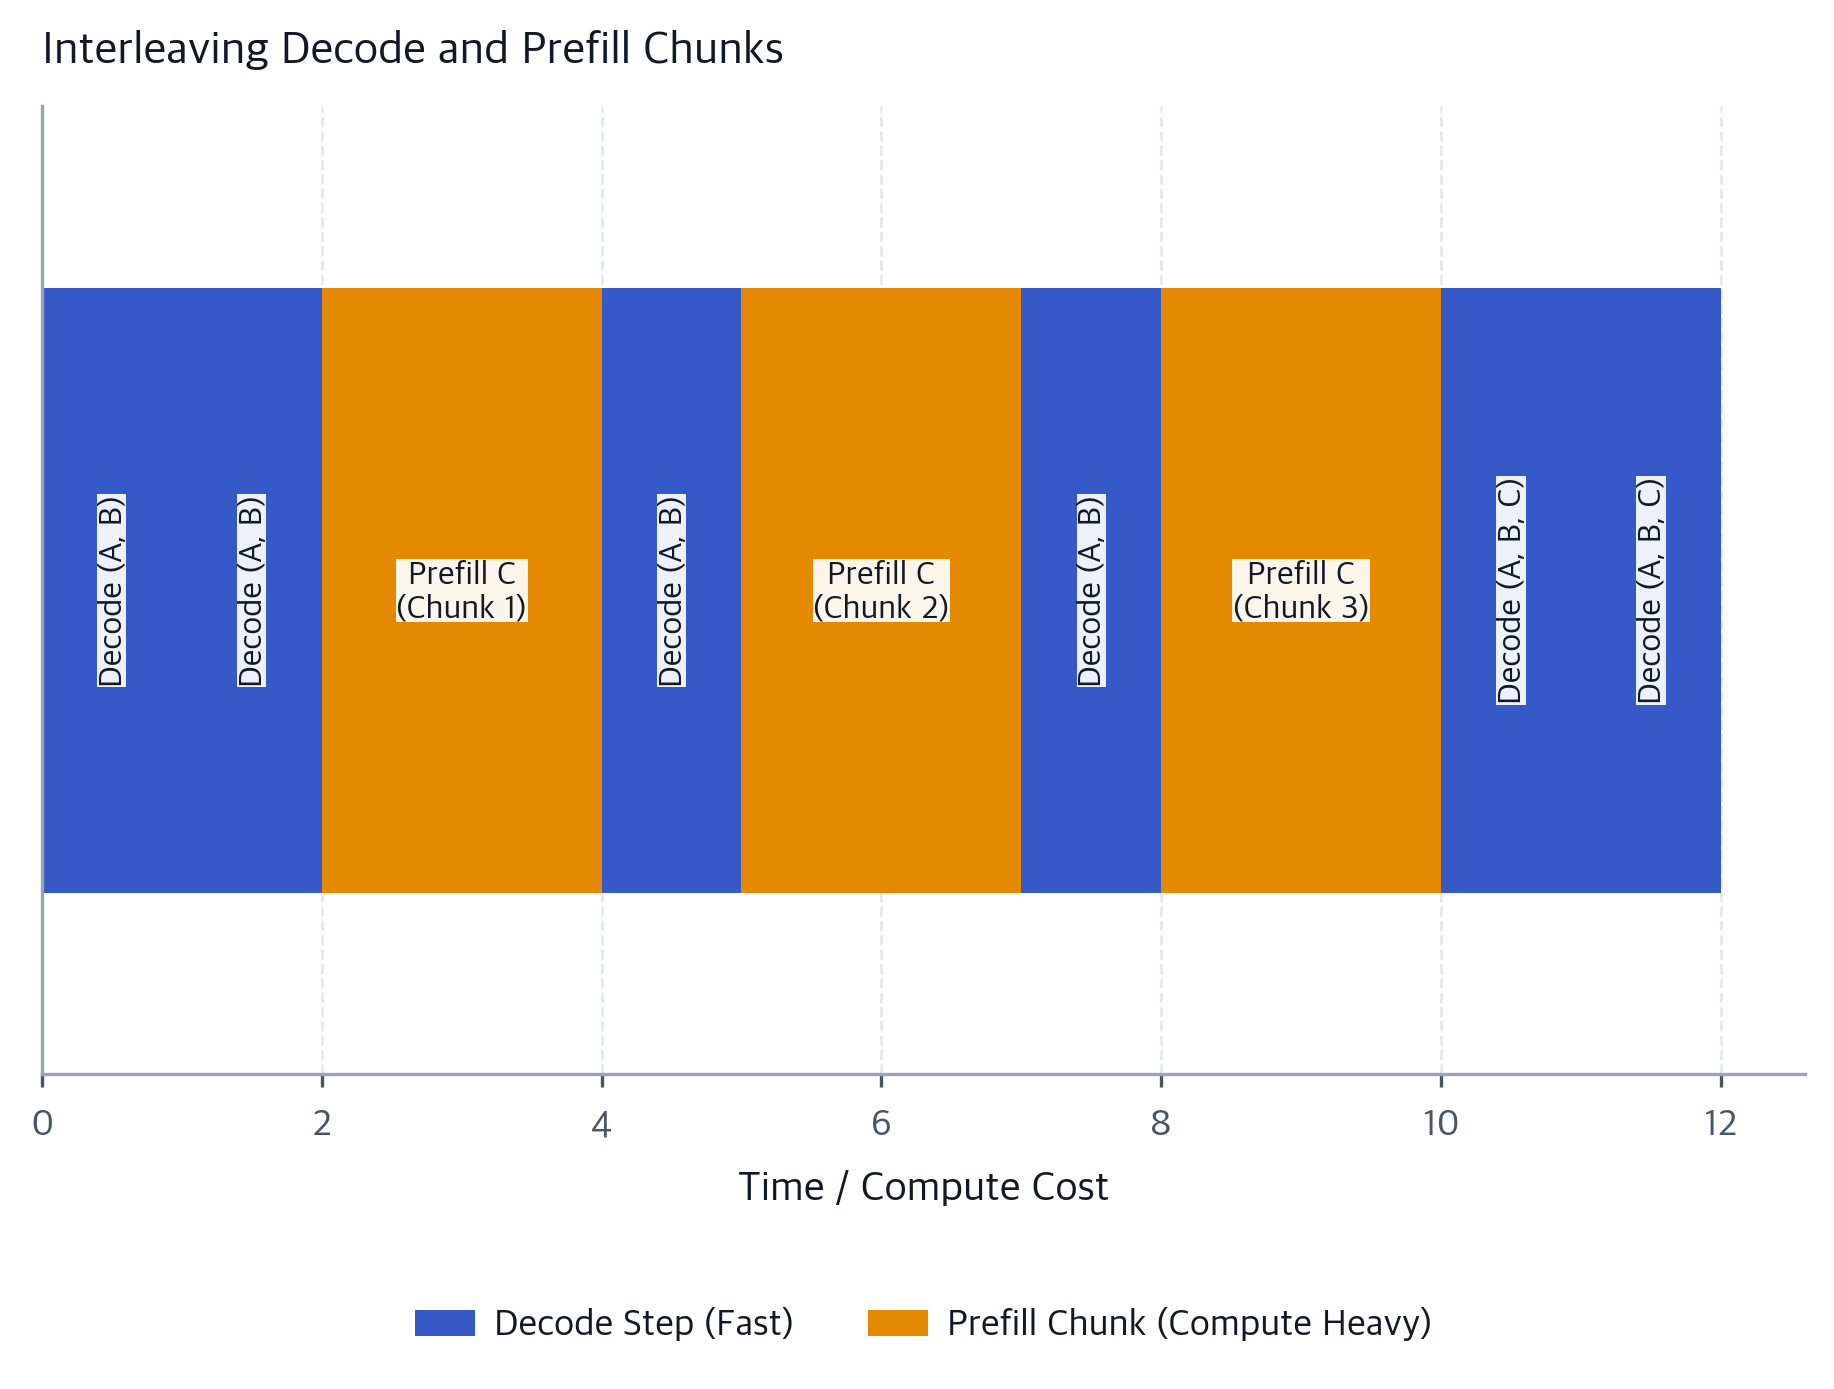
Continuous Batching: Optimizing LLM Inference Throughput - Interactive ...
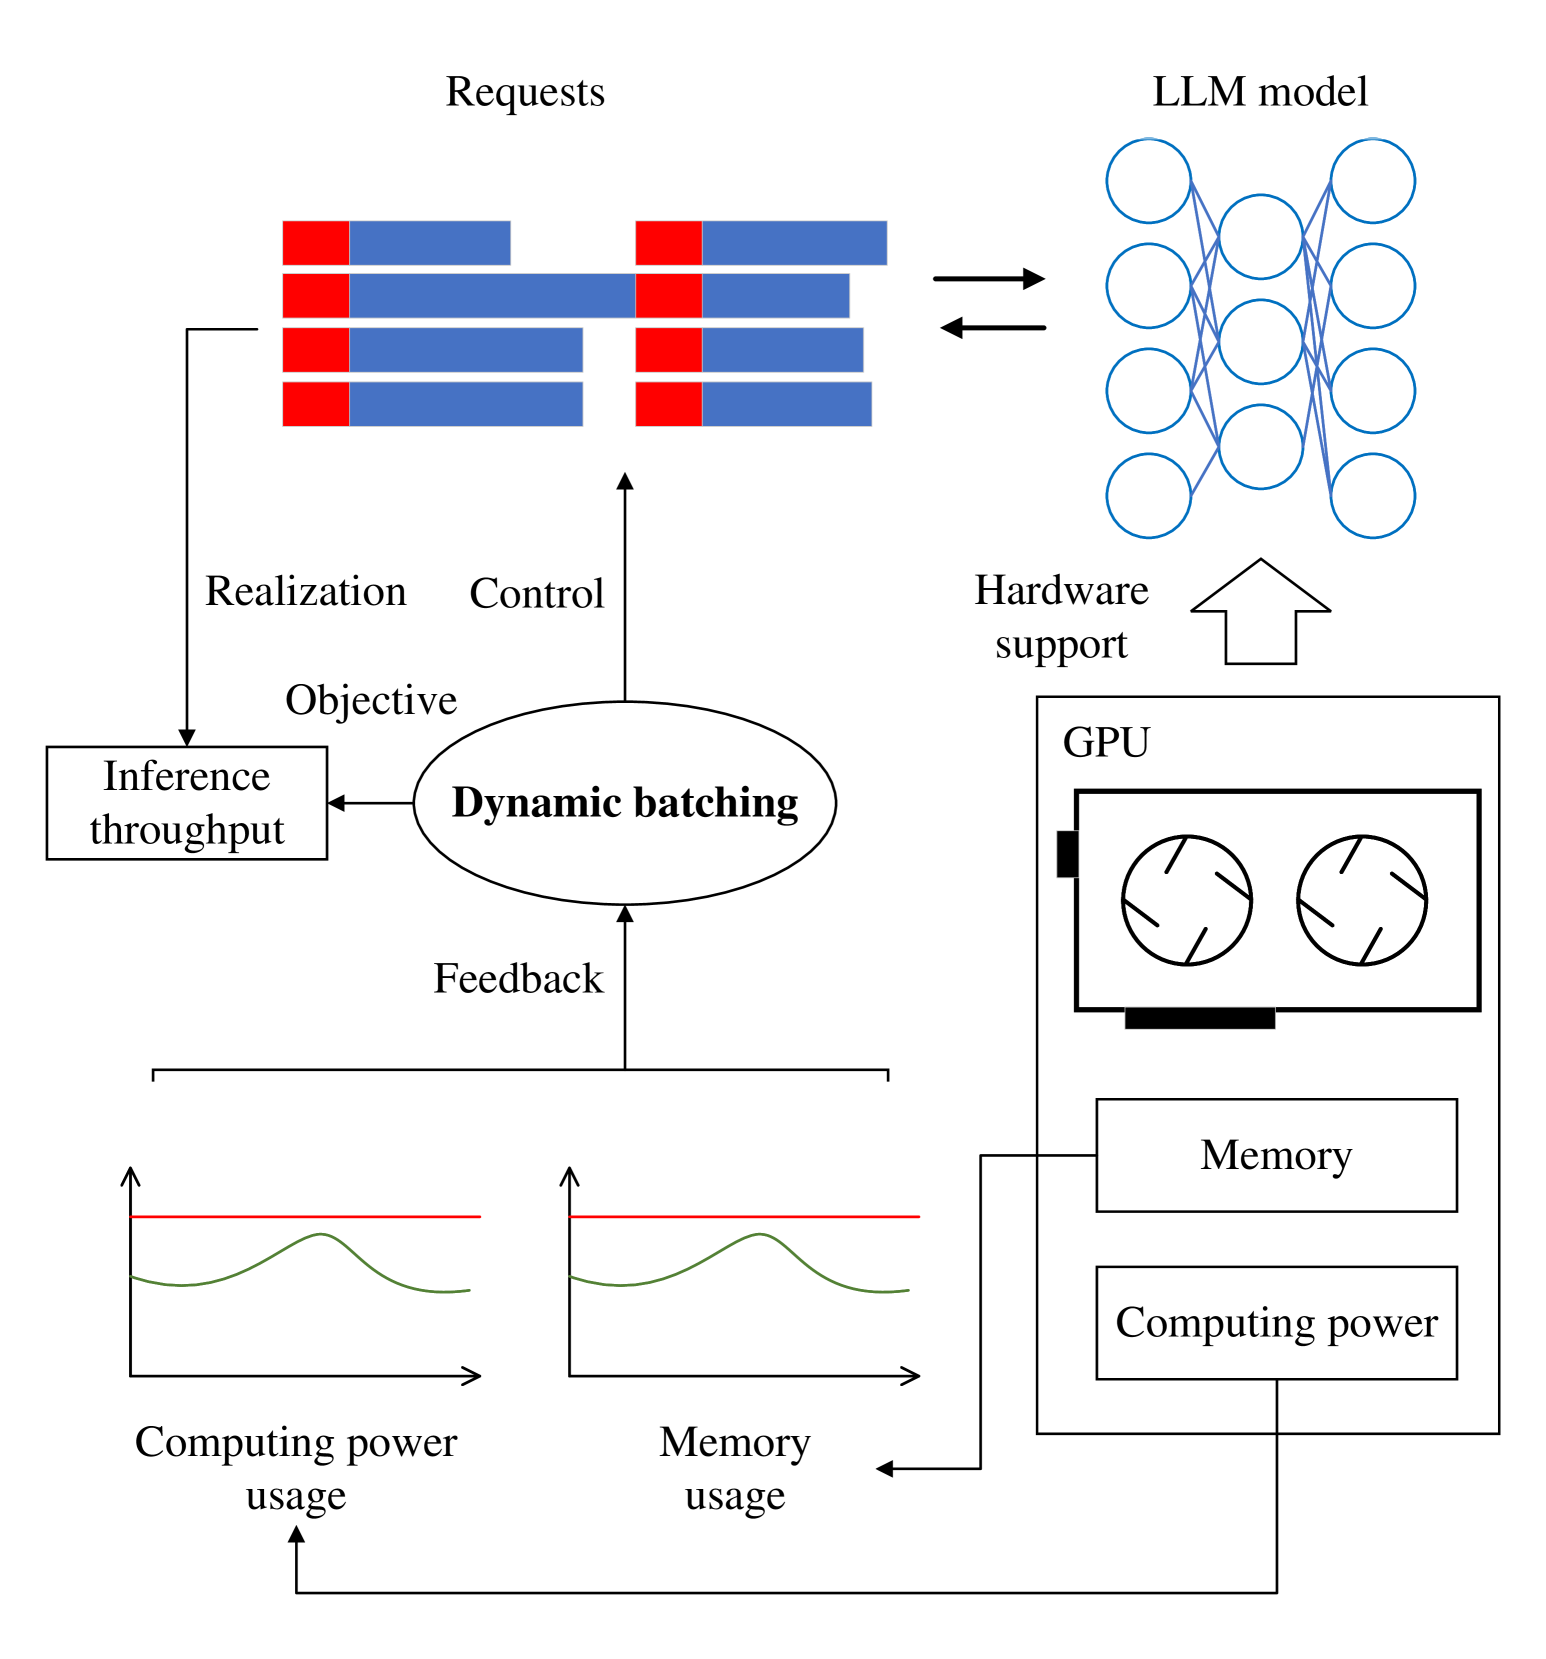
[2503.05248] Optimizing LLM Inference Throughput via Memory-aware and ...

[2503.05248] Optimizing LLM Inference Throughput via Memory-aware and ...

[2503.05248] Optimizing LLM Inference Throughput via Memory-aware and ...