
Figure 1 From Optimizing A Speaker Embedding Extractor Through Backend
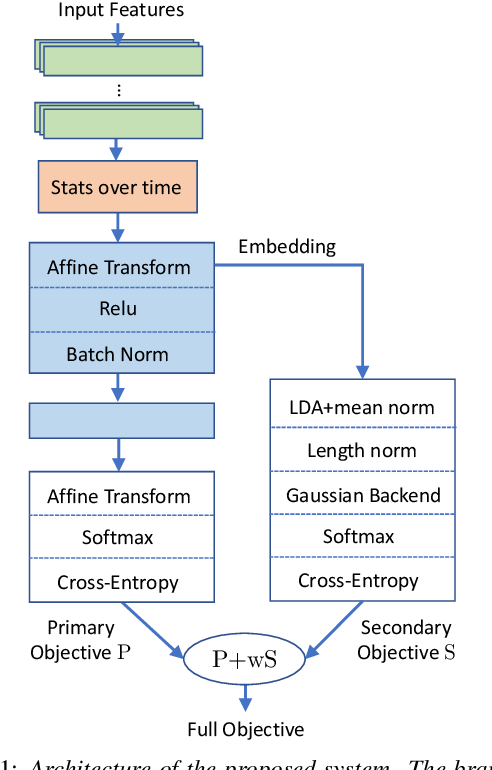
Figure 1 from Optimizing a Speaker Embedding Extractor Through Backend ...
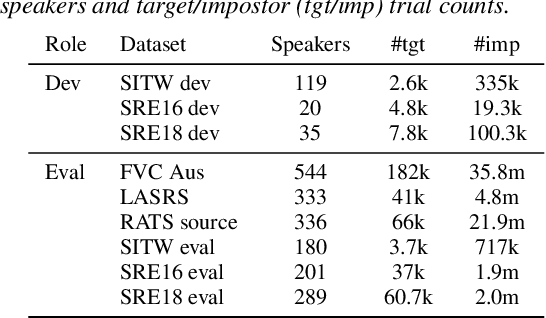
Table 1 from Optimizing a Speaker Embedding Extractor Through Backend ...

Figure 1 from High-Resolution Embedding Extractor for Speaker ...

Figure 1 from Efficient Speaker Embedding Extraction Using a Twofold ...
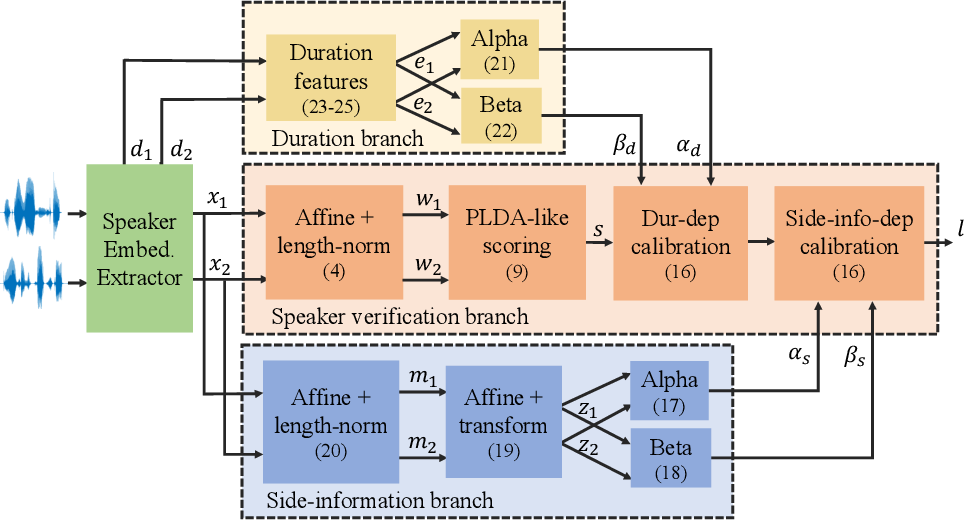
Figure 1 from A Speaker Verification Backend with Robust Performance ...

Figure 1 from A Word-axis Speaker Embedding Trained with Multi-Speaker ...
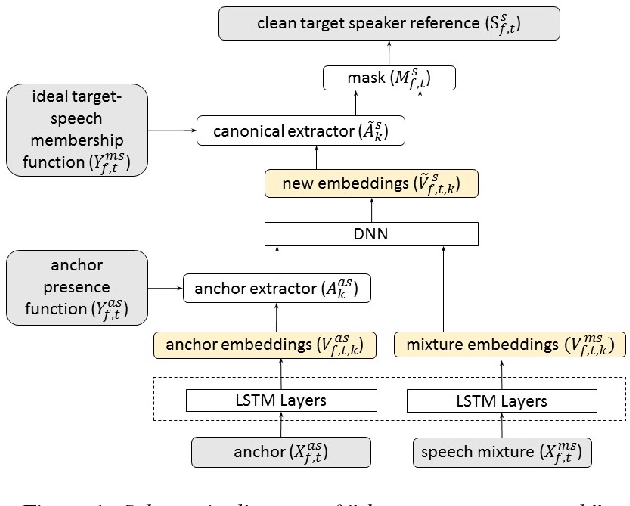
Figure 1 from Deep Extractor Network for Target Speaker Recovery From ...
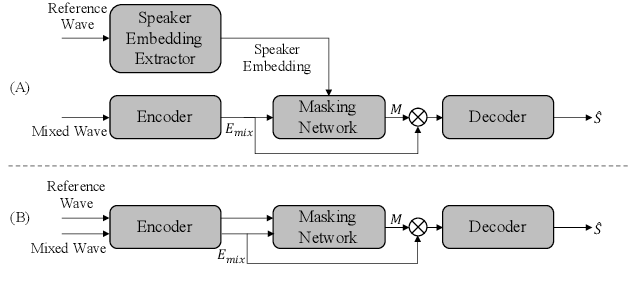
Figure 1 from SEF-Net: Speaker Embedding Free Target Speaker Extraction ...

Figure 1 from Vision-Guided Speaker Embedding Based Speech Separation ...
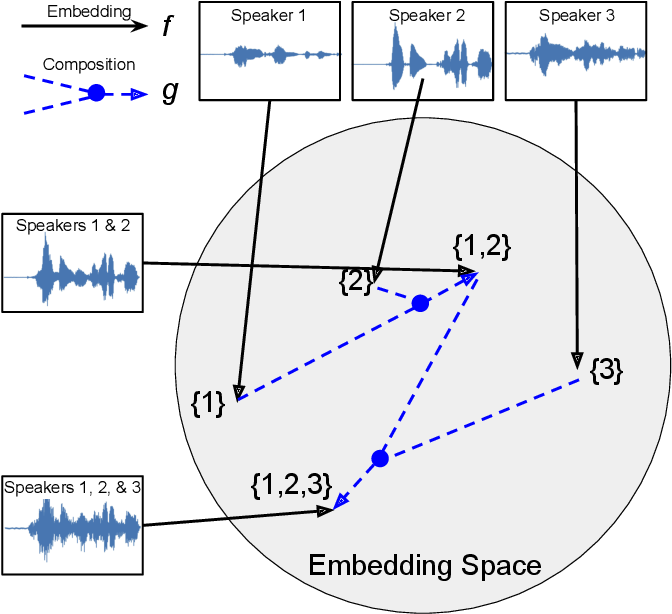
Figure 1 from Compositional Embedding Models for Speaker Identification ...
Advertisement Space (300x250)

Figure 1 from Speaker Embedding Extraction with Phonetic Information ...

Figure 1 from Joint Training of Speaker Embedding Extractor, Speech and ...
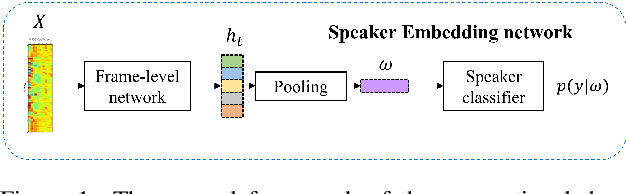
Figure 1 from Domain Generalized Speaker Embedding Learning via Mutual ...

Figure 1 from Speaker Embedding Extraction with Phonetic Information ...
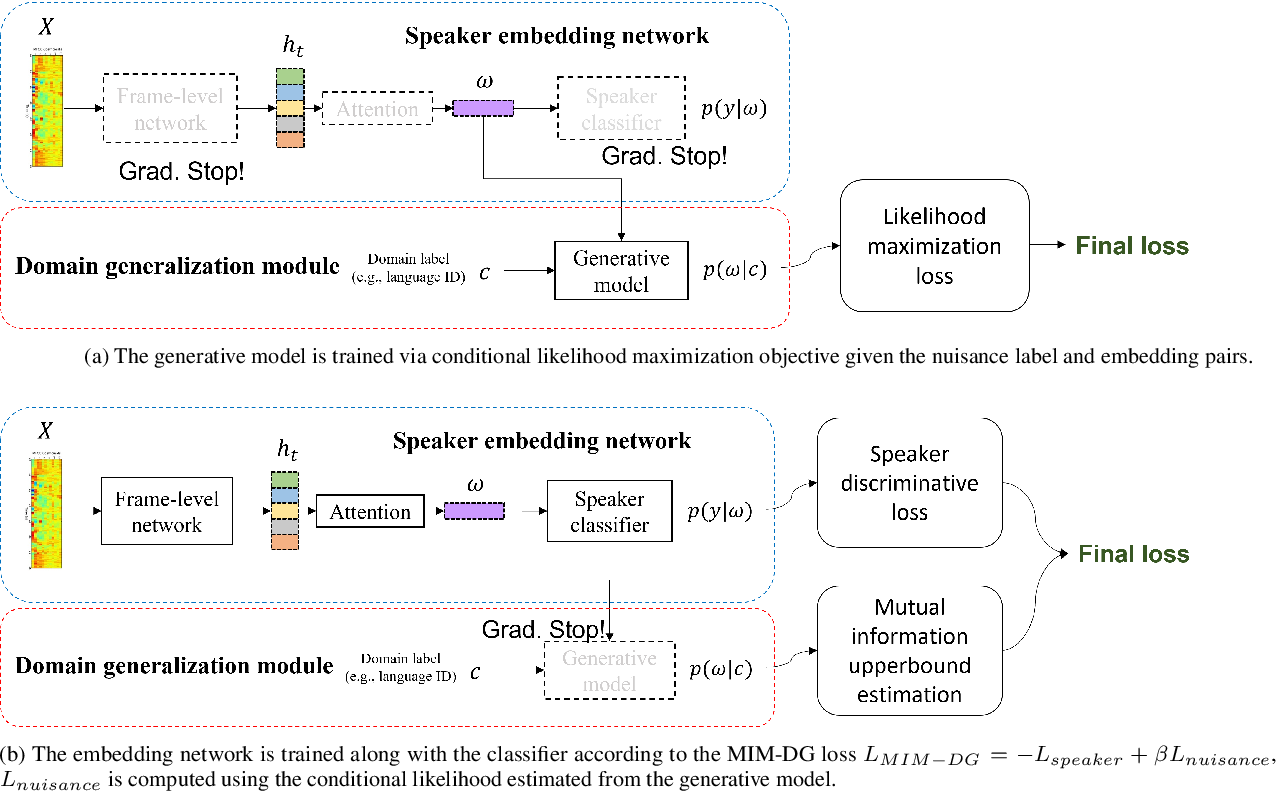
Figure 1 from Domain Generalized Speaker Embedding Learning via Mutual ...

Figure 1 from Domain Generalized Speaker Embedding Learning via Mutual ...
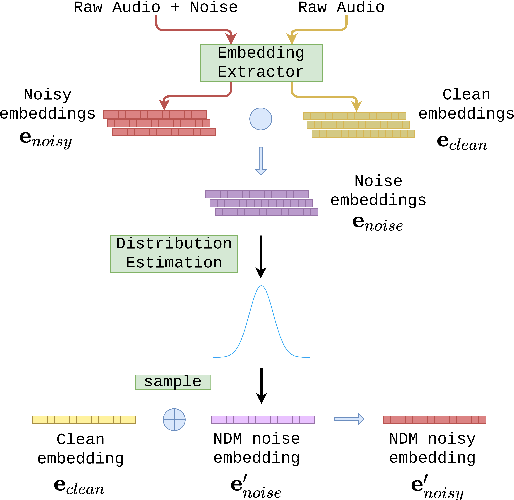
Figure 1 from Speaker Embedding Augmentation with Noise Distribution ...

Figure 1 from Investigation on Deep Speaker Embedding Extraction ...
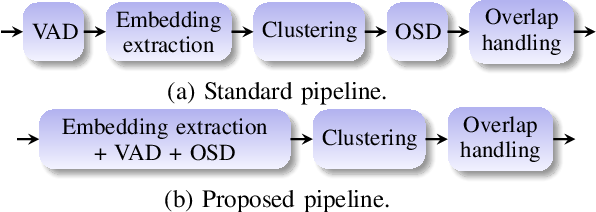
Figure 1 from Joint Training of Speaker Embedding Extractor, Speech and ...

Figure 1 from Domain Generalized Speaker Embedding Learning via Mutual ...
Advertisement Space (336x280)

Figure 1 from OPTIMIZING SPEAKER RECOGNITION USING D-VECTOR AND X ...

Figure 1 from Optimizing features extraction parameters for speaker ...

Figure 1 from Multi-Stage Speaker Extraction with Utterance and Frame ...
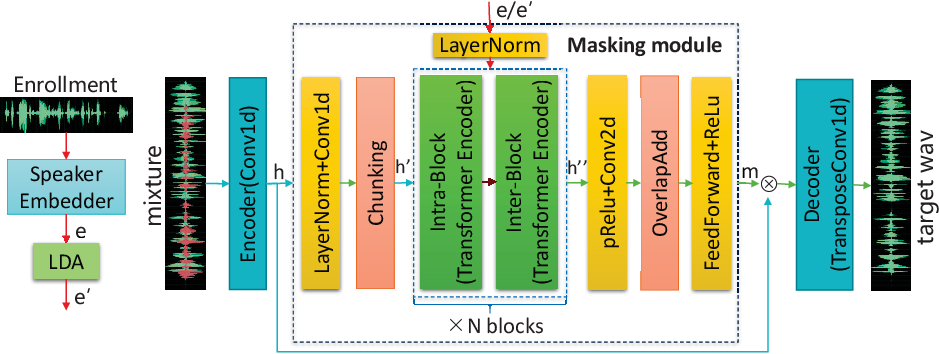
Figure 1 from Improving Target Speaker Extraction with Sparse LDA ...

Figure 1 from Speaker-Aware Target Speaker Enhancement by Jointly ...

Figure 1 from FA-ExU-Net: The Simultaneous Training of an Embedding ...
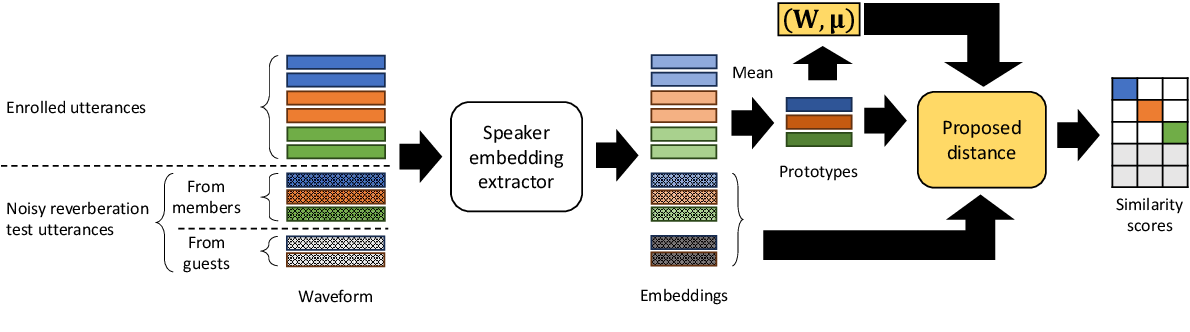
Figure 1 from Speaker Verification Using Distance Based on Principal ...

Figure 1 from A Joint Training Framework of Multi-Look Separator and ...

Training a speaker embedding extractor for the attack model A2 ...

Figure 1 from Target Speaker Extraction with Curriculum Learning ...
Advertisement Space (336x280)

Figure 1 from Target Speaker Extraction with Attention Enhancement and ...
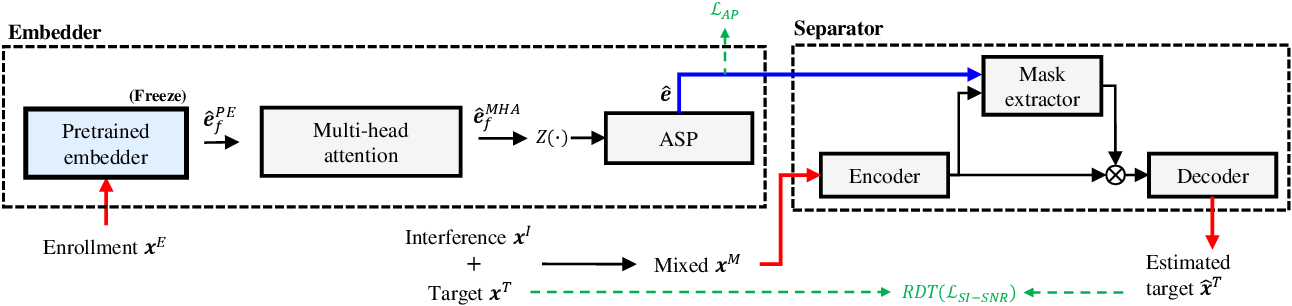
Figure 1 from Centroid Estimation with Transformer-Based Speaker ...

Figure 1 from Mutual Information-based Embedding Decoupling for ...

Figure 1 from End-to-End Multi-Speaker Speech Recognition using Speaker ...

Figure 1 from Speaker Embeddings With Weakly Supervised Voice Activity ...
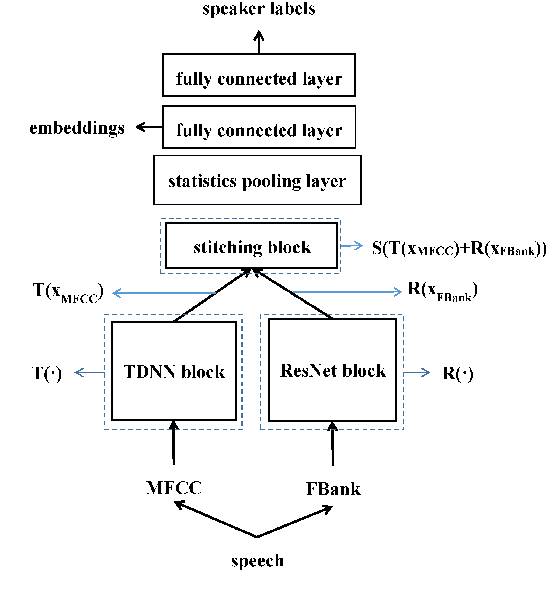
Figure 3 from Speaker Embedding Extraction with Multi-feature ...