
Figure 2 From Visual Language Model Based Cross Modal Semantic
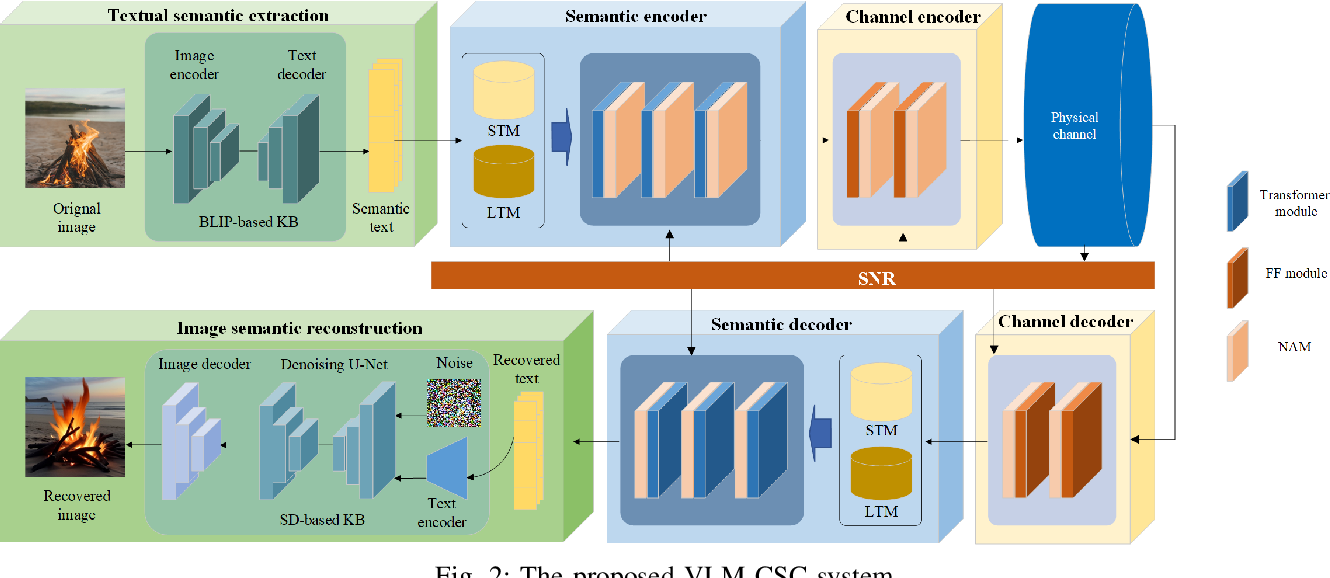
Figure 2 from Visual Language Model-Based Cross-Modal Semantic ...

Visual Language Model based Cross-modal Semantic Communication Systems ...

[論文レビュー] Visual Language Model based Cross-modal Semantic Communication ...

Figure 1 from A Vision-Language Pre-training model based on Cross ...
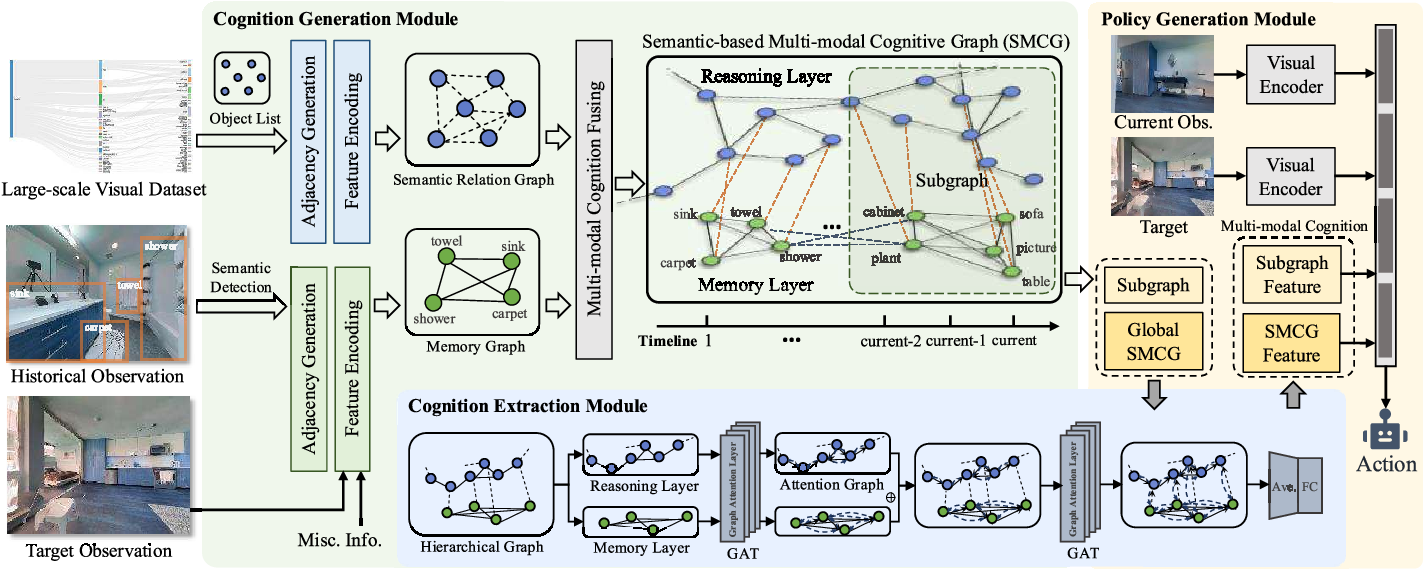
Figure 2 from Visual Navigation for Embodied Agents Using Semantic ...

Figure 2 from Cross Modal Facial Image Synthesis Using a Collaborative ...

Figure 2 from Learning Hierarchical Semantic Correspondences for Cross ...
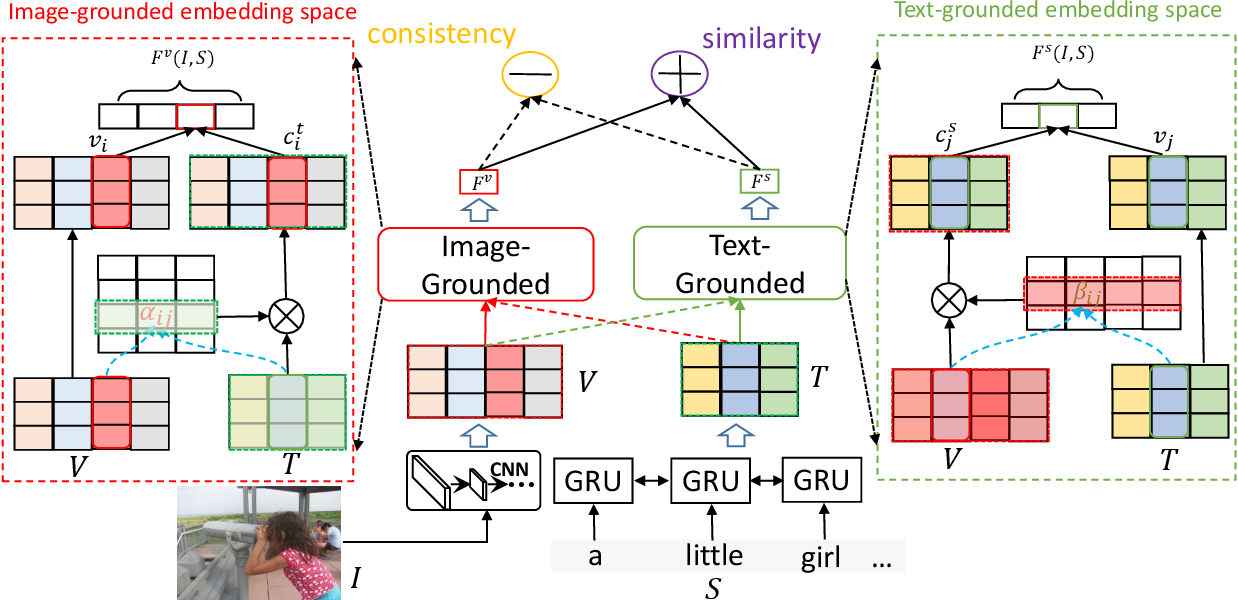
Figure 2 from Cross-Modal Image-Text Retrieval with Semantic ...
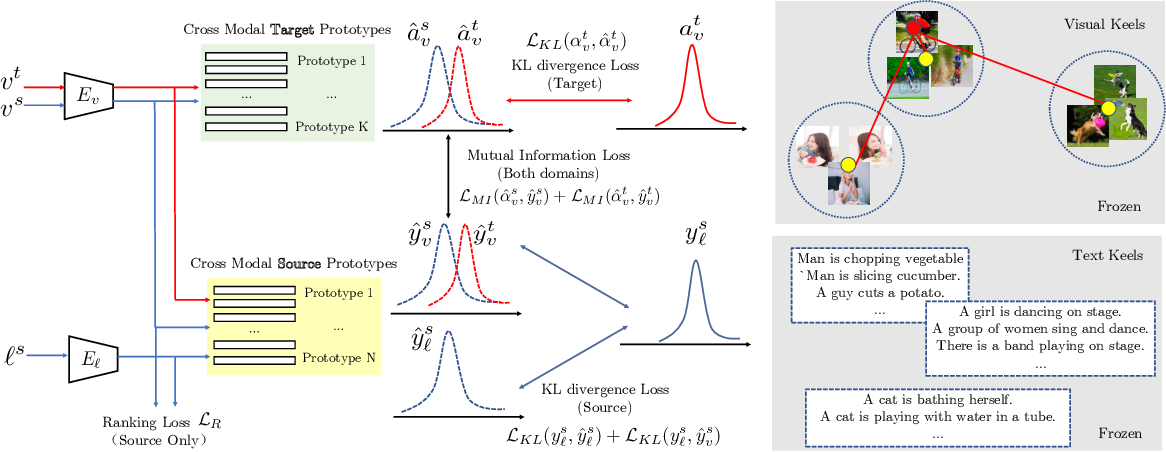
Figure 2 from Adaptive Cross-Modal Prototypes for Cross-Domain Visual ...

Figure 2 from Cross-modal Contrastive Attention Model for Medical ...
Advertisement Space (300x250)

Figure 2 from Cross-Modal Language Modeling in Multi-Motion-Informed ...

Figure 2 from A CLIP-Based Cross-Modal Matching Model for Image-Text ...
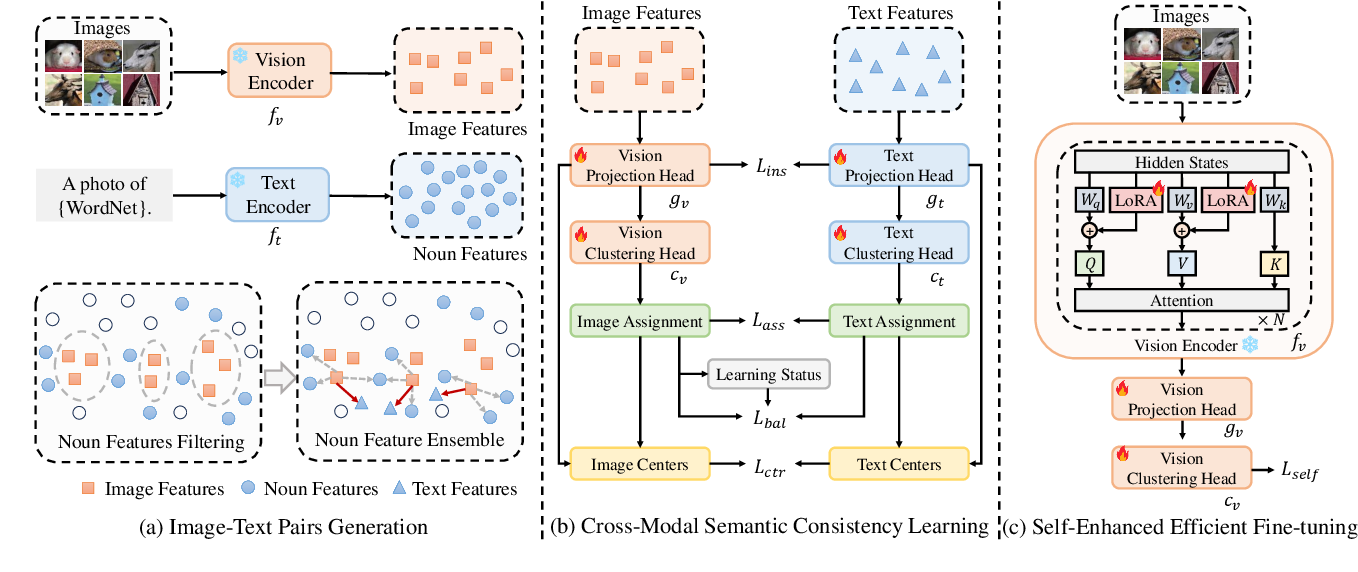
Figure 2 from Self-Enhanced Image Clustering with Cross-Modal Semantic ...

Figure 2 from Cross-Modal Match for Language Conditioned 3D Object ...

Figure 1 from SeCG: Semantic-Enhanced 3D Visual Grounding via Cross ...

Figure 2 from Video Entailment via Reaching a Structure-Aware Cross ...
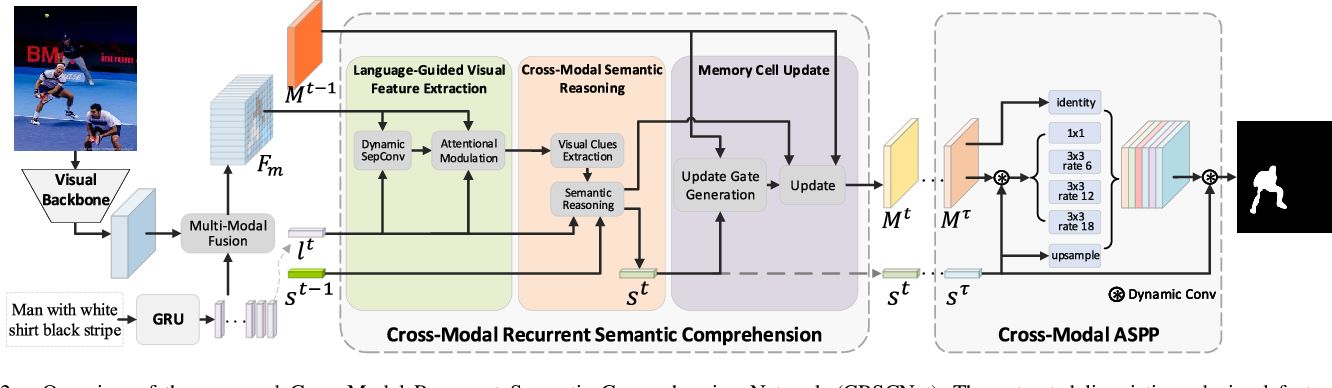
Figure 2 from Cross-Modal Recurrent Semantic Comprehension for ...

Figure 2 from Cross-Modal Semantic Alignment before Fusion for Two-Pass ...

Figure 2 from Enhanced Multimodal Representation Learning with Cross ...

Figure 2 from Cross-Modal Concept Learning and Inference for Vision ...
Advertisement Space (336x280)

Figure 2 from Unifying Cross-Lingual and Cross-Modal Modeling Towards ...

Figure 2 from Cross-Modal Alignment Learning of Vision-Language ...
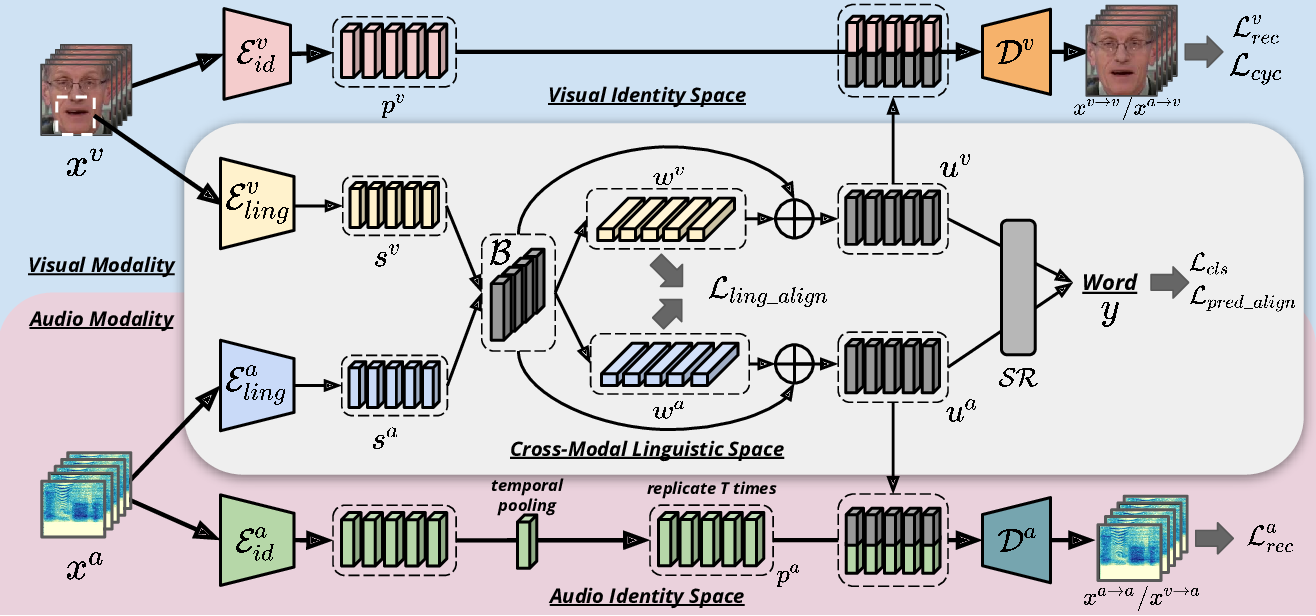
Figure 2 from Cross-Modal Mutual Learning for Audio-Visual Speech ...

Figure 2 from Cross-modal Knowledge Reasoning for Knowledge-based ...

Figure 2 from Rethink Cross-Modal Fusion in Weakly-Supervised Audio ...

Figure 2 from Semantics-Enriched Cross-Modal Alignment for Complex ...

Figure 2 from Aspect-based Sentiment Classification with Sequential ...

Figure 2 from Cross-modal Local Shortest Path and Global Enhancement ...

Figure 2 from Cross-modal Prominent Fragments Enhancement Aligning ...

Figure 1 from CA_DeepSC: Cross-Modal Alignment for Multi-Modal Semantic ...
Advertisement Space (336x280)

Figure 2 from Cross-Modal Mutual Learning for Audio-Visual Speech ...

Figure 2 from Cross-modal Collaborative Representation Learning for ...

Figure 1 from Learning Visually Aligned Semantic Graph for Cross-Modal ...
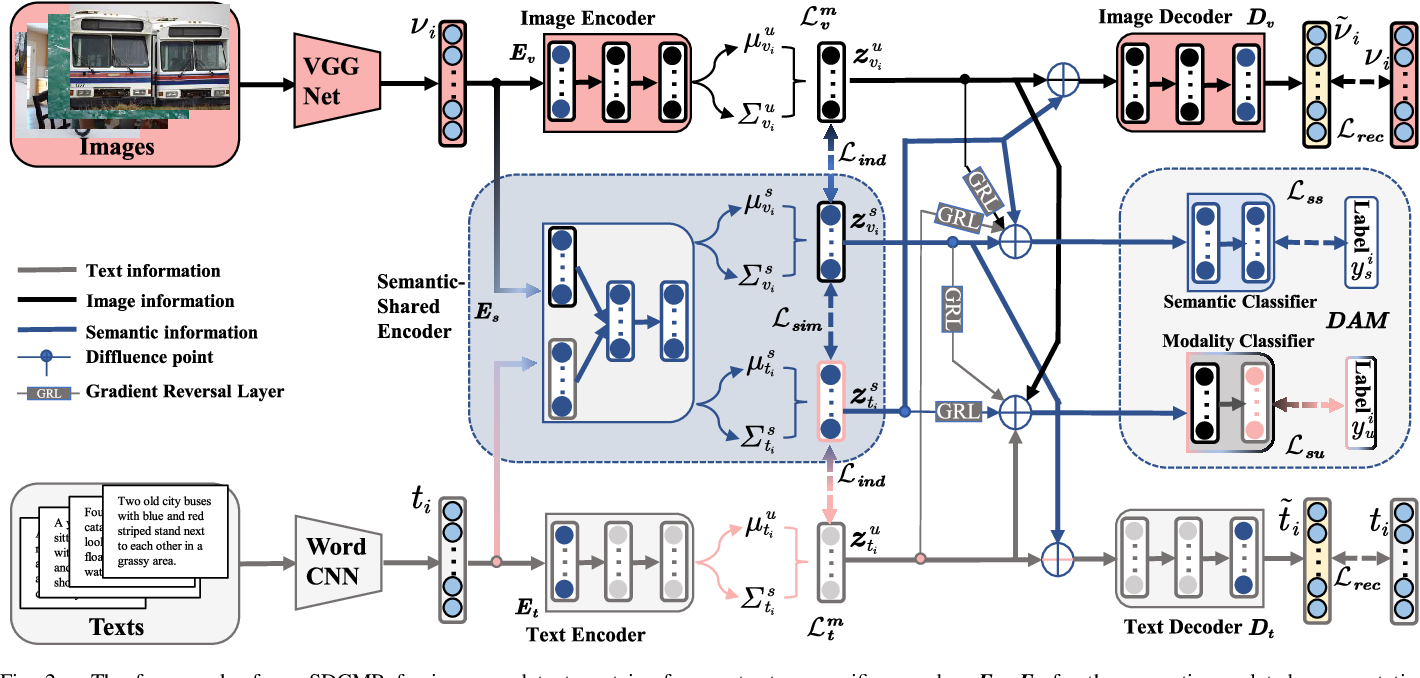
Figure 2 from Semantics Disentangling for Cross-Modal Retrieval ...

Figure 1 from Towards Versatile and Efficient Visual Knowledge ...

Figure 2 from Detecting Human-Object Interactions with Object-Guided ...