
Visual Language Model Based Cross Modal Semantic Communication

Visual Language Model based Cross-modal Semantic Communication Systems ...

[論文レビュー] Visual Language Model based Cross-modal Semantic Communication ...
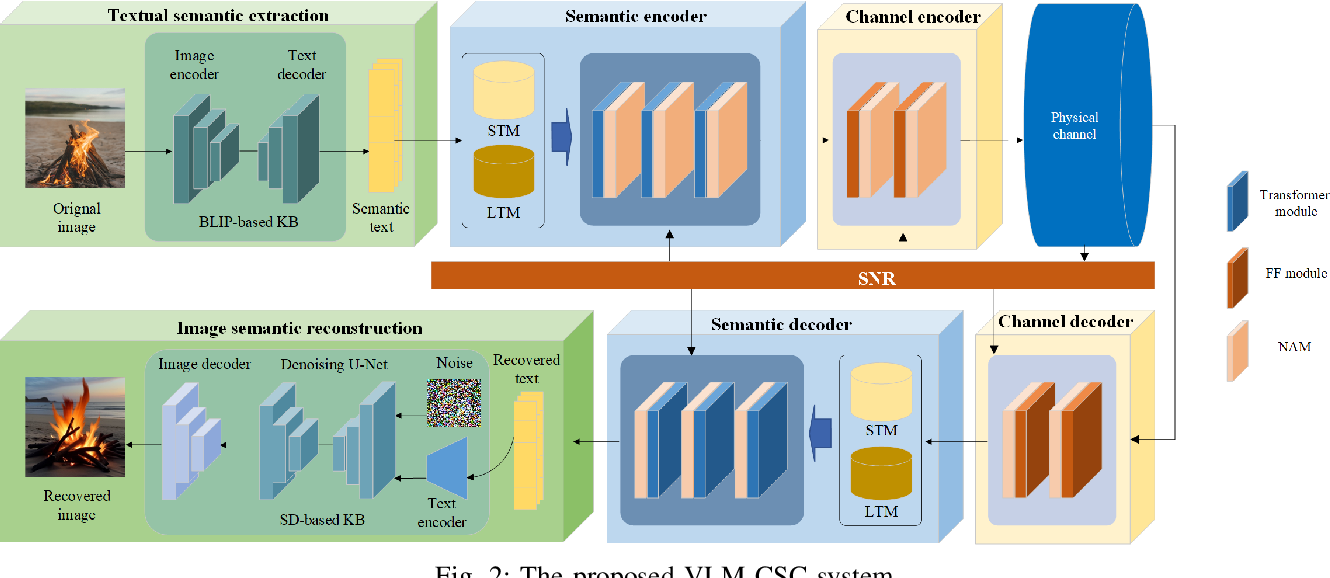
Figure 2 from Visual Language Model-Based Cross-Modal Semantic ...
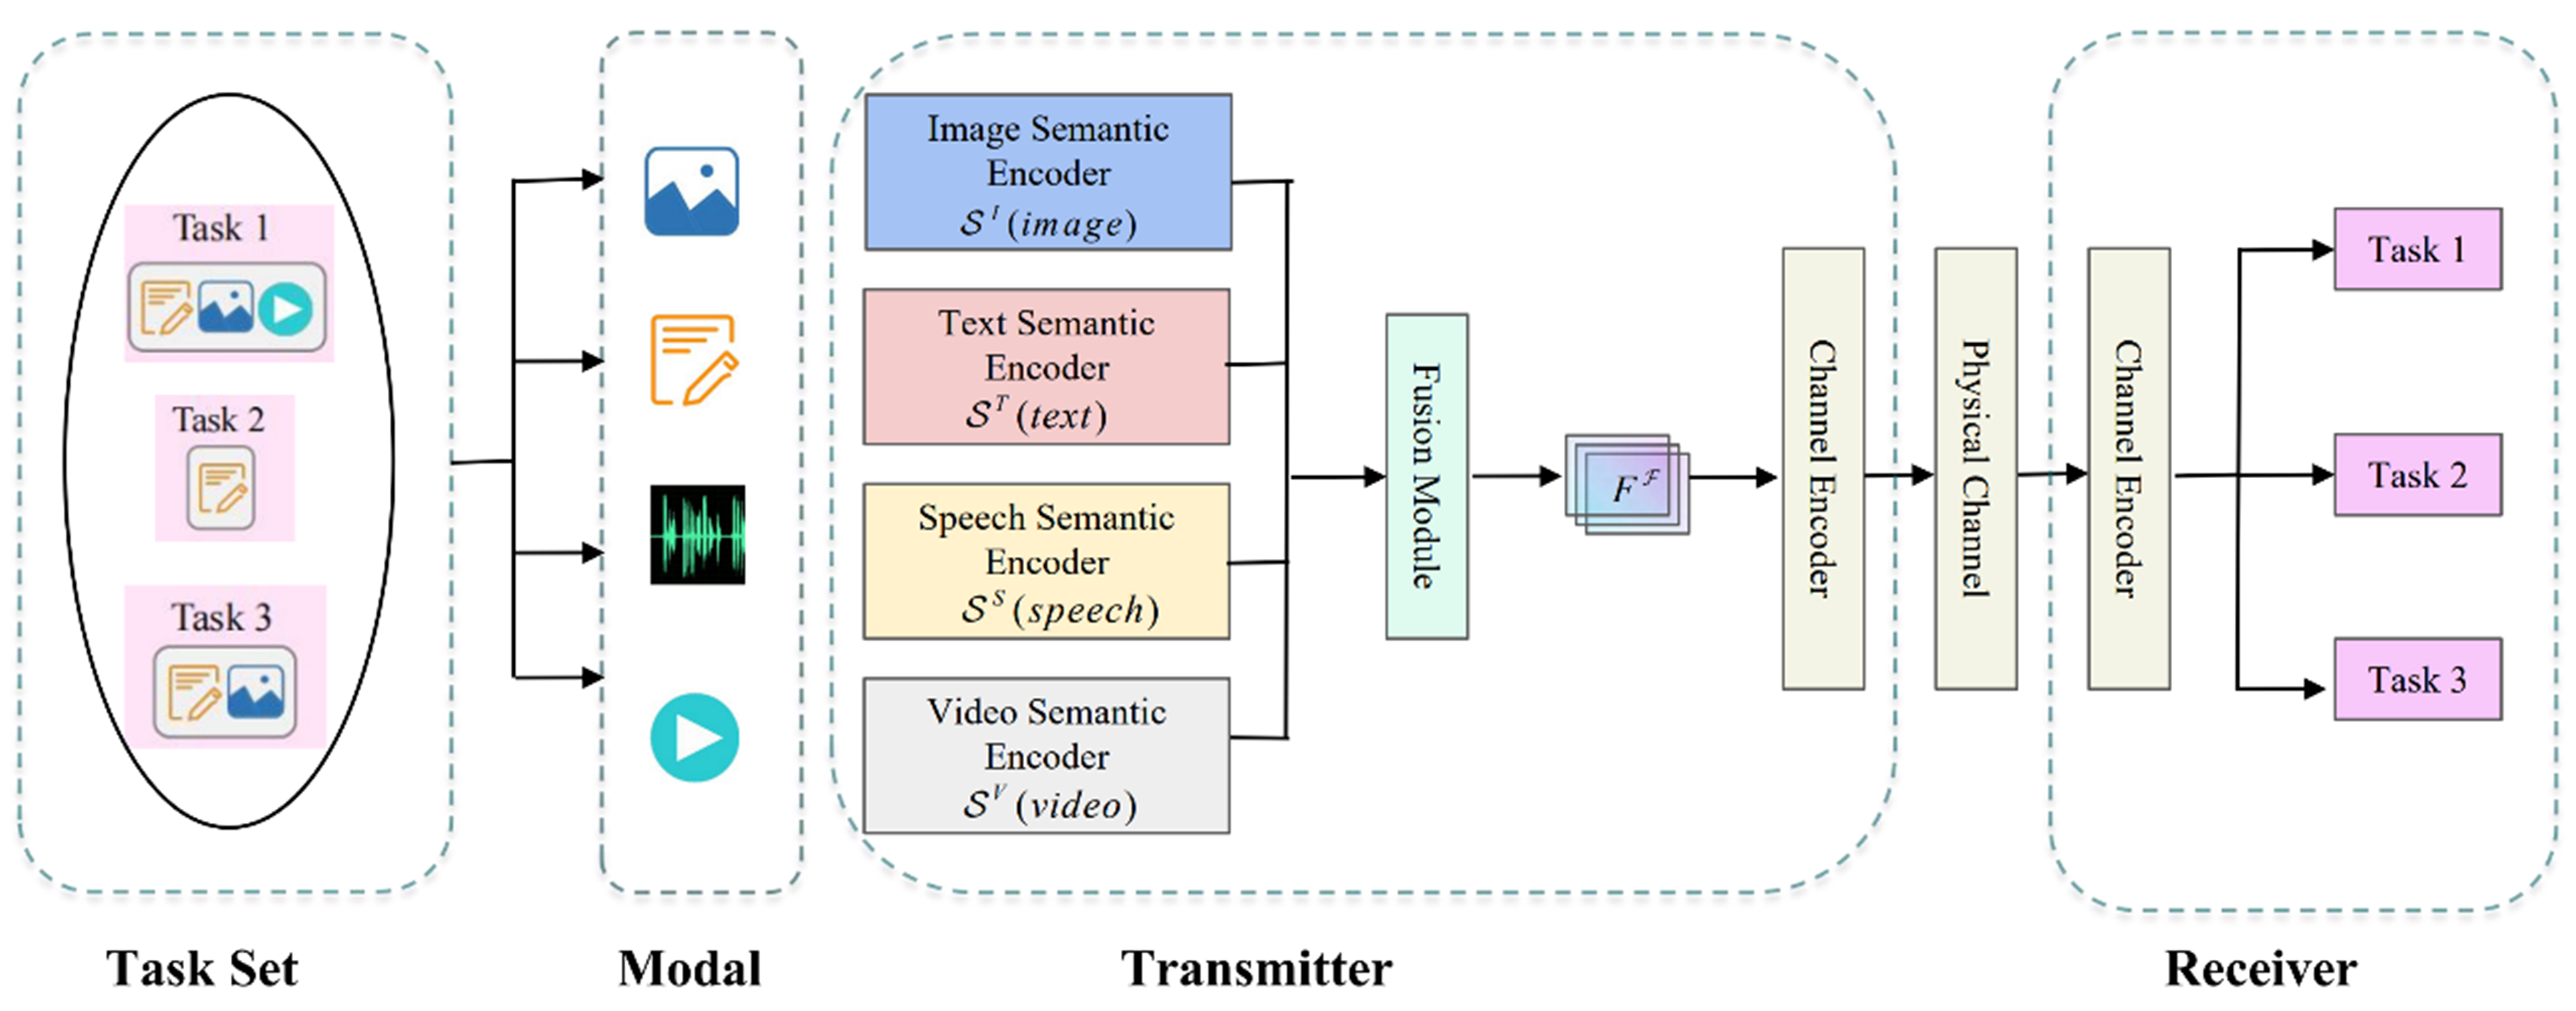
Multimodal semantic communication system based on graph neural networks

Learning Cross Modal Context Graph for Visual Grounding | PLUS

Figure 1 from Large Model Empowered Multi-Modal Semantic Communication ...

Figure 1 from A Vision-Language Pre-training model based on Cross ...

Cross-Modal Graph Semantic Communication Assisted by Generative AI in ...

Semantic-Guided Natural Language and Visual Fusion for Cross-Modal ...
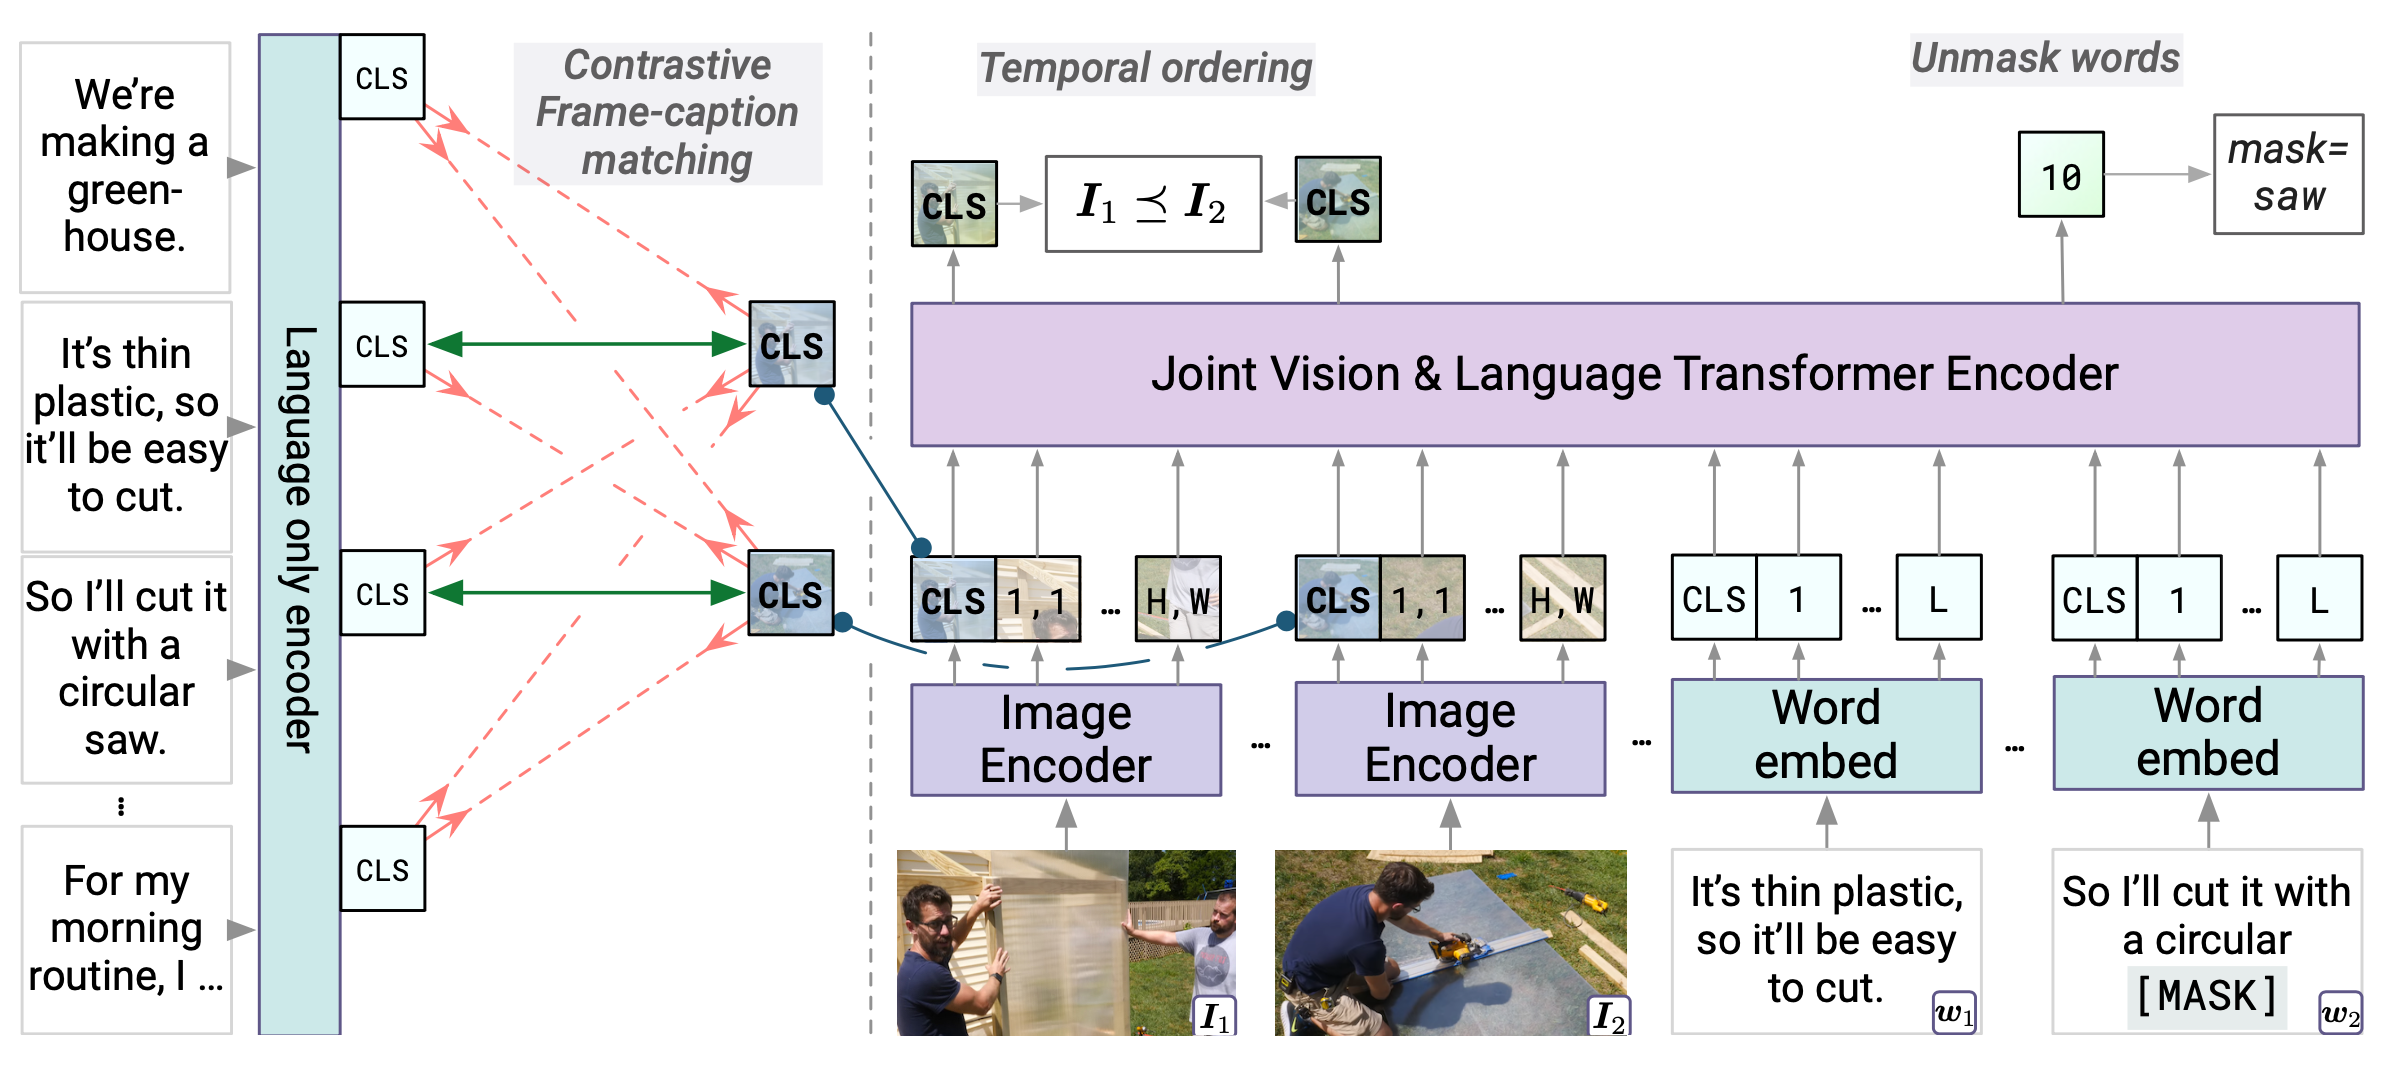
Generalized Visual Language Models | Lil'Log
Advertisement Space (300x250)

EidetiCom: A Cross-modal Brain-Computer Semantic Communication Paradigm ...

Cross-Modal Graph Semantic Communication Assisted by Generative AI in ...

Multi-Modal Semantic Communication | AI Research Paper Details

Cross-Modal Video Retrieval Based on Semantic Enhancement | Proceedings ...

Visual representations with texts domain generalization for semantic ...
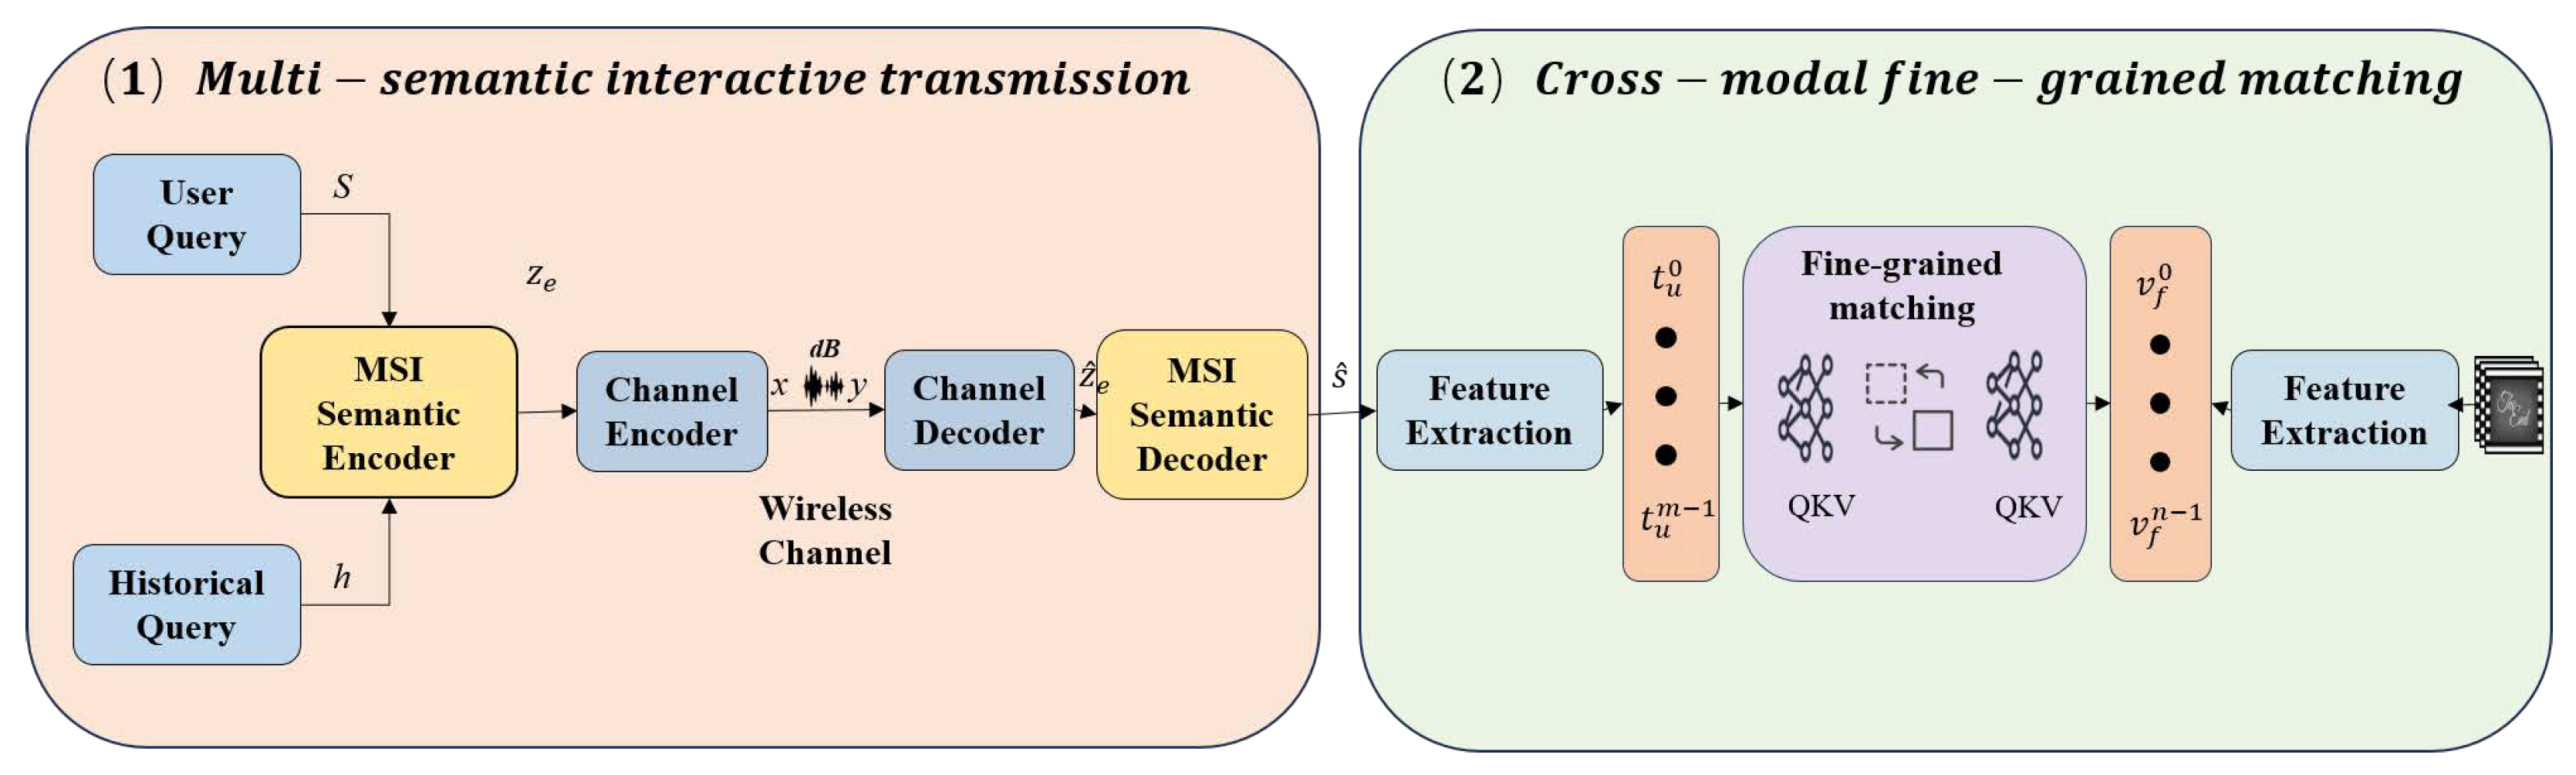
Cross-Modal Semantic Communication for Text-to-Video Retrieval in ...

(PDF) Cross-Modal Learning Based on Semantic Correlation and Multi-Task ...

[2511.20000] Cross-Modal Semantic Communication for Heterogeneous ...

Semantic supervised learning based Cross-Modal Retrieval

[2511.20000] Cross-Modal Semantic Communication for Heterogeneous ...
Advertisement Space (336x280)

Vision Language Model Applications & Learning Strategies

In-Depth Guide to Visual Language Models

Boosting Continuous Sign Language Recognition via Cross Modality ...
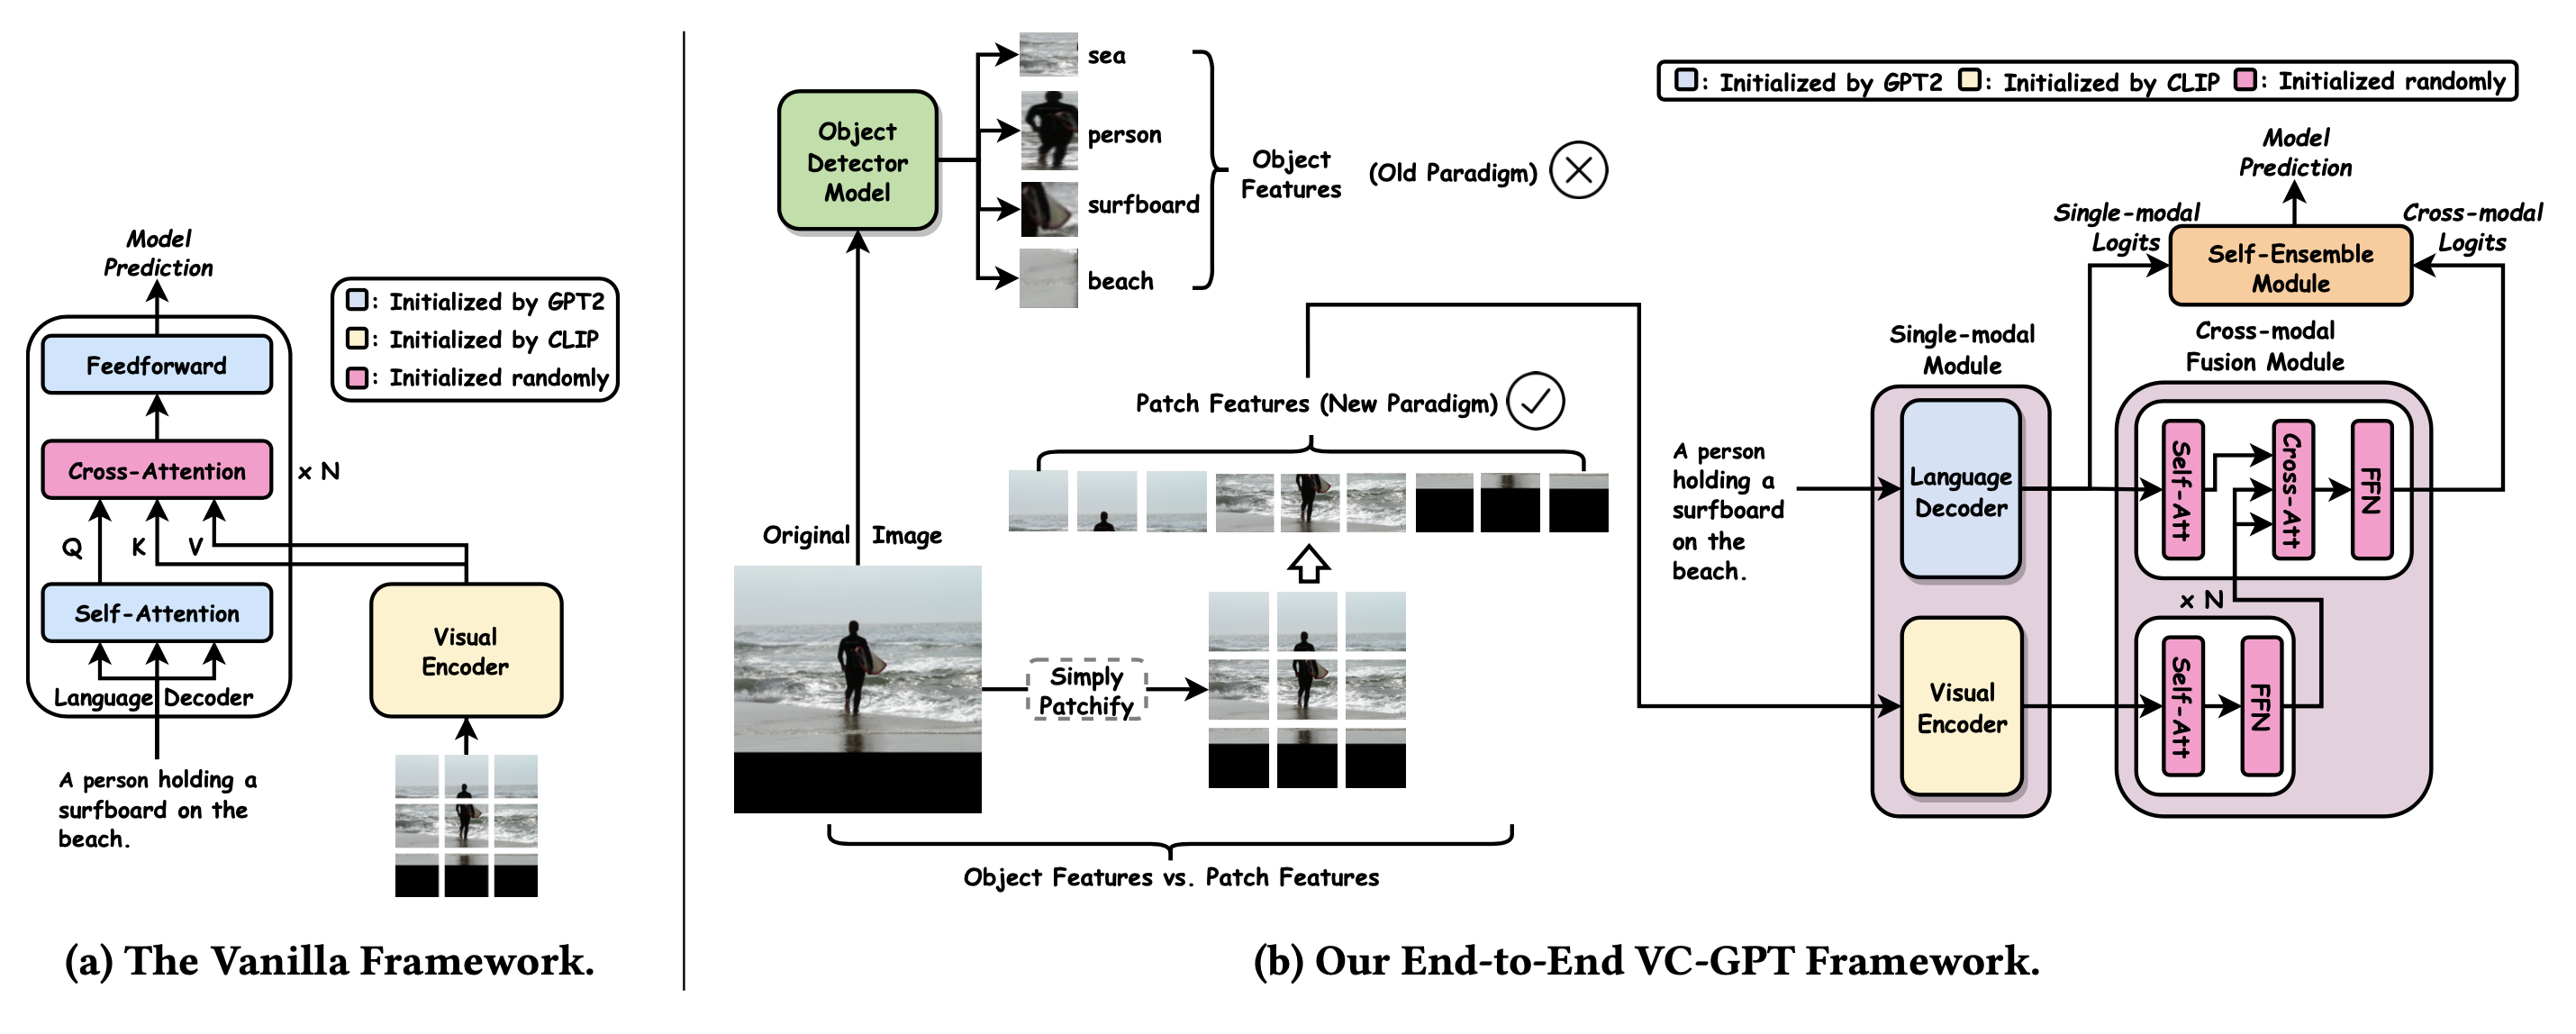
Generalized Visual Language Models | Lil'Log
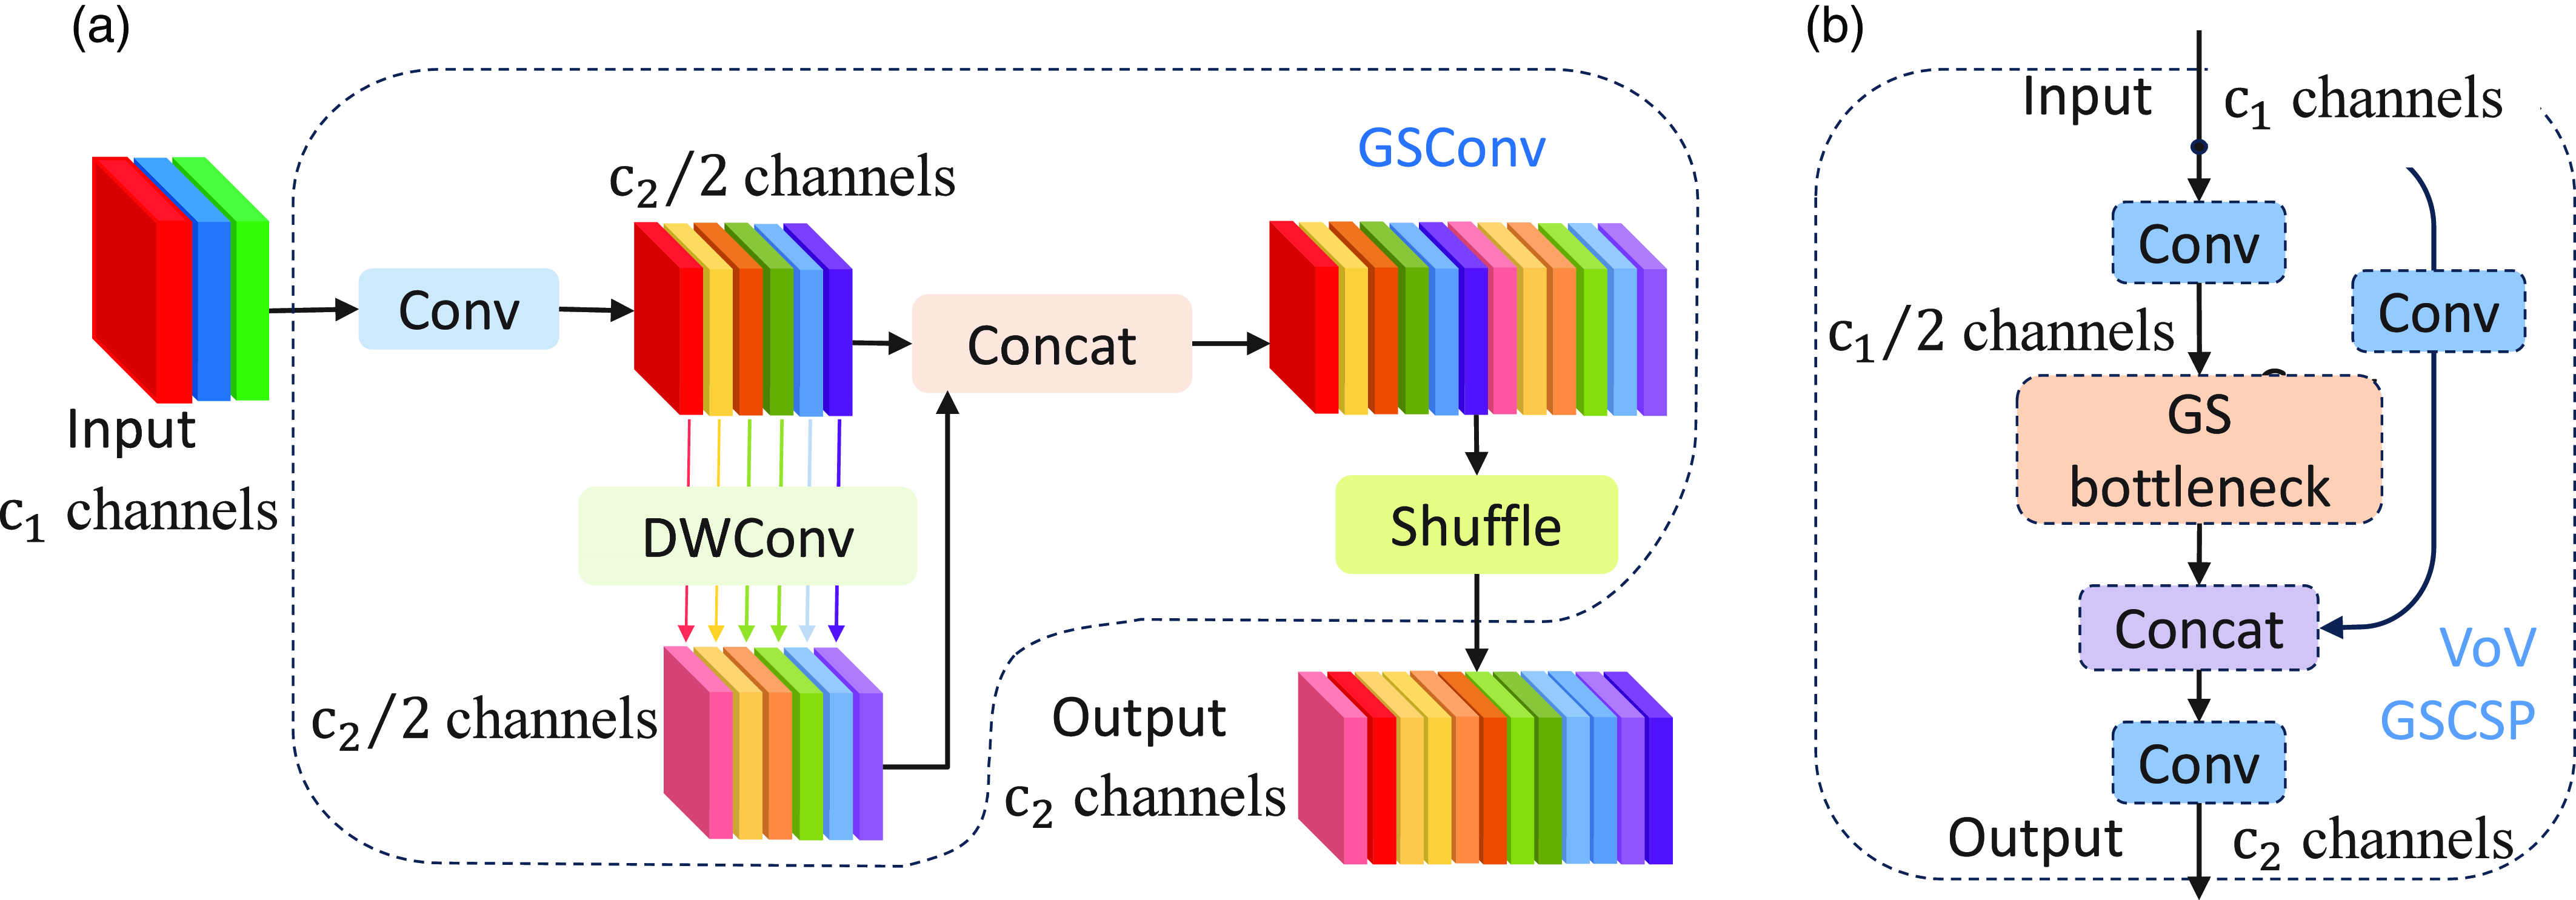
A visual SLAM-based lightweight multi-modal semantic framework for an ...

Figure 1 from SeCG: Semantic-Enhanced 3D Visual Grounding via Cross ...
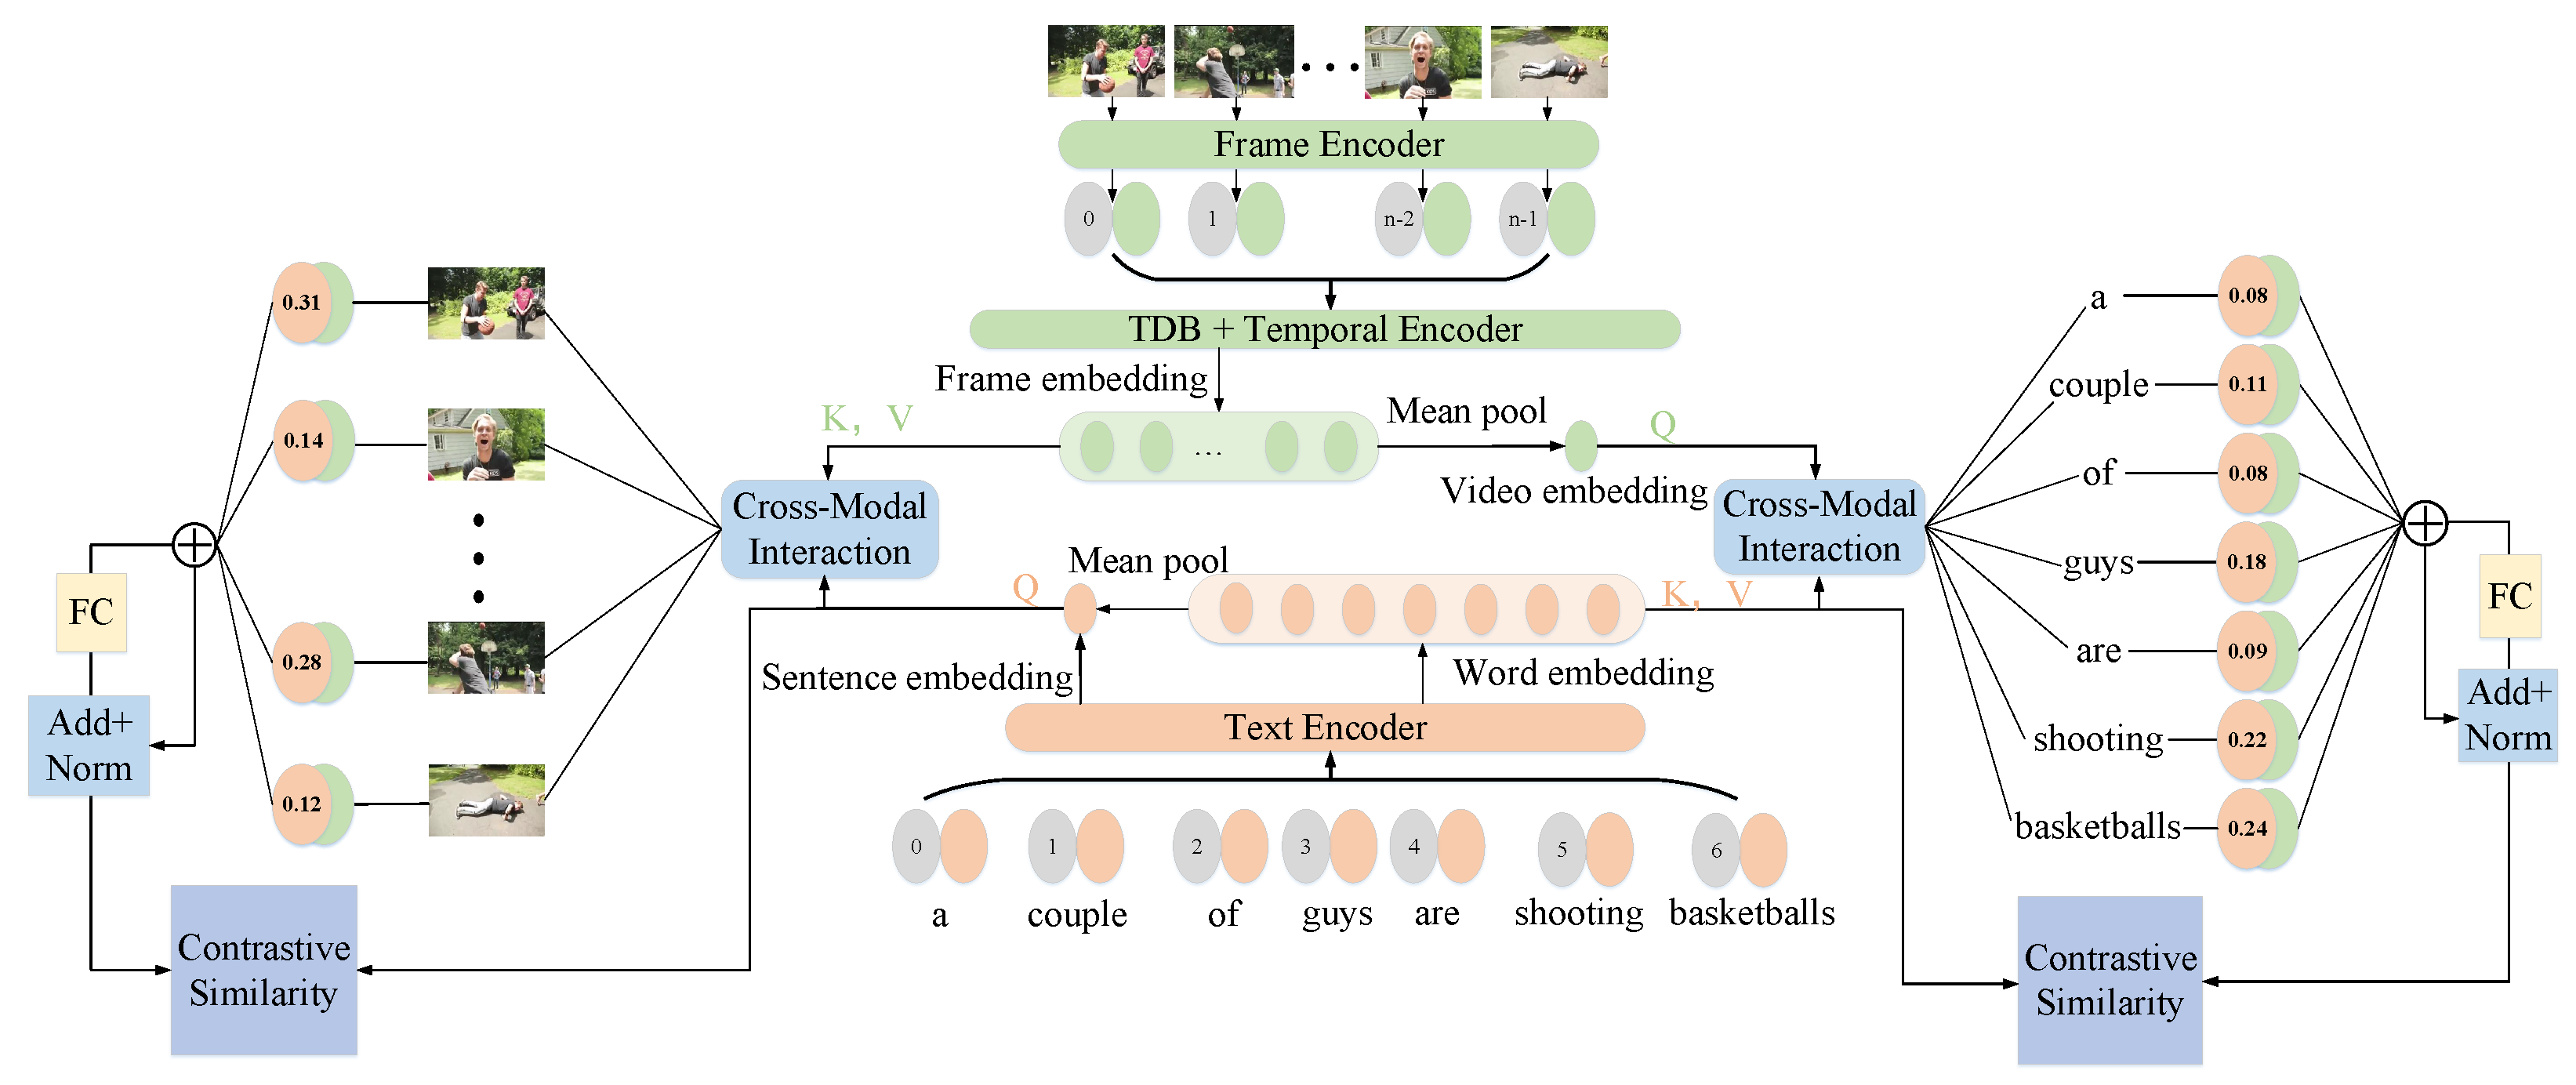
Cross-Modal Semantic Communication for Text-to-Video Retrieval in ...

[논문 리뷰] Vision Language Models Map Logos to Text via Semantic ...

Model Architecture (Detailed model): Our approach utilises ...

M4SC: An MLLM-based Multi-modal, Multi-task and Multi-user Semantic ...
Advertisement Space (336x280)
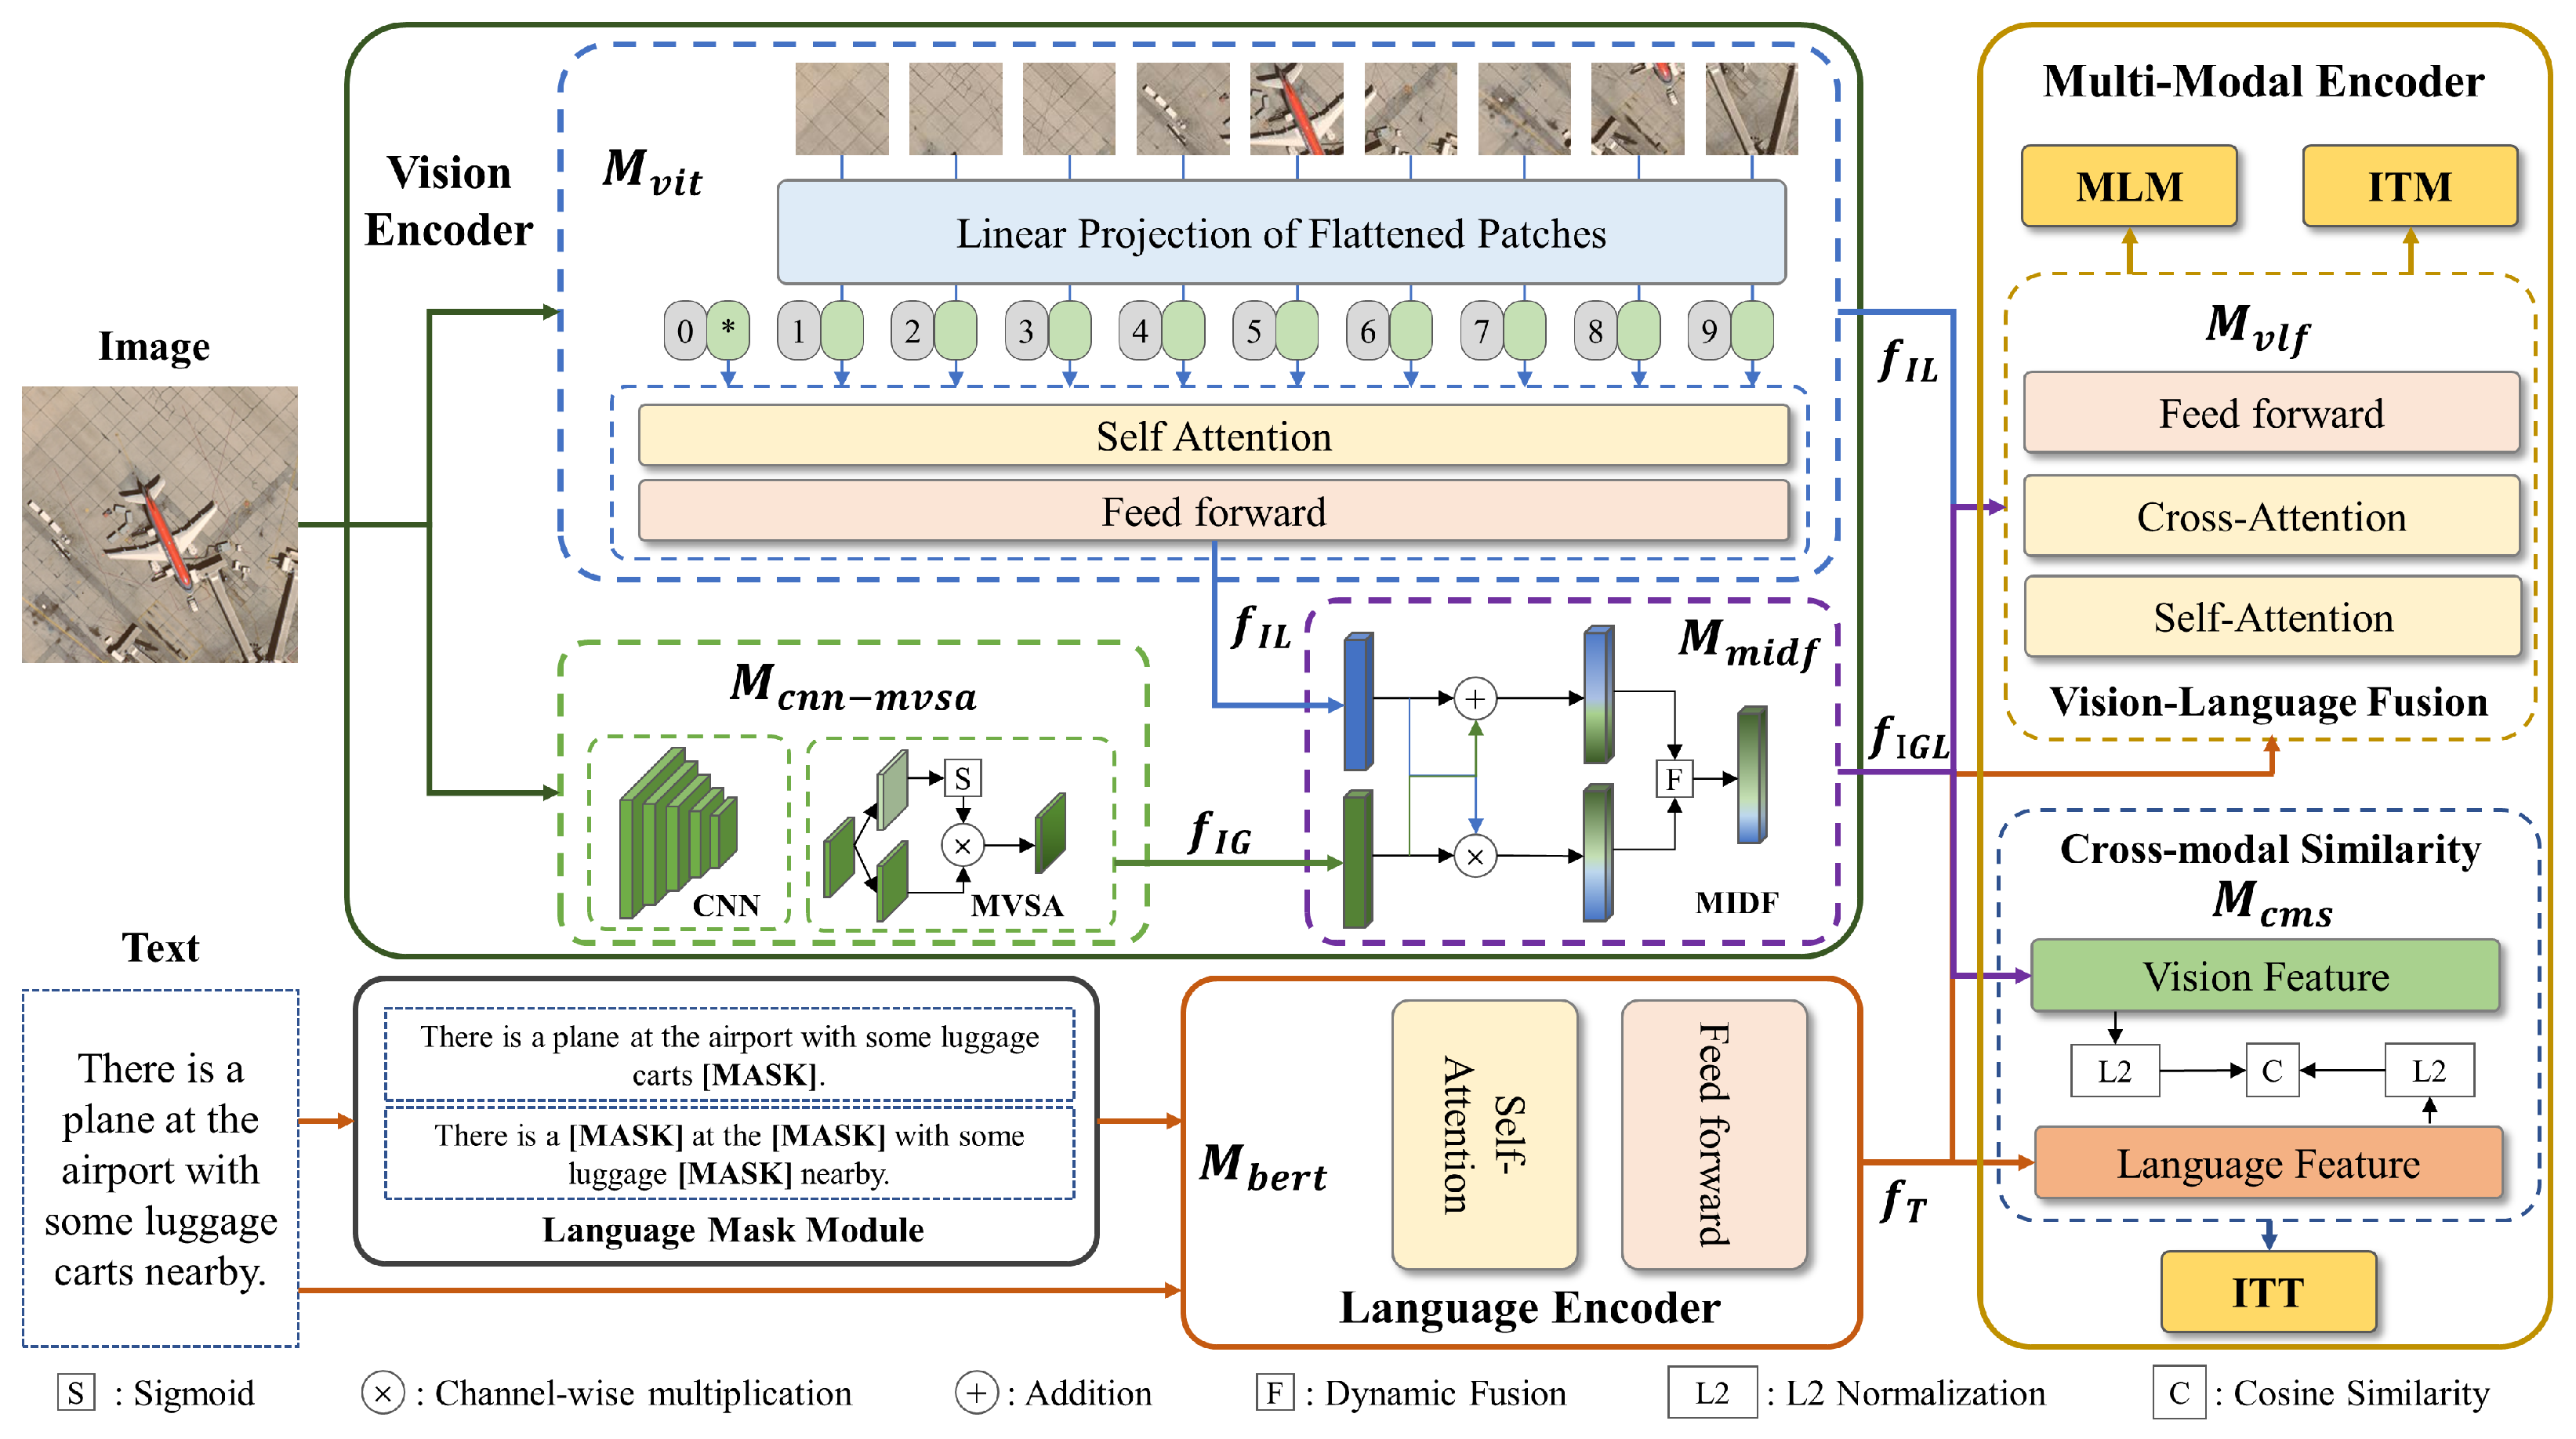
An End-to-End Framework Based on Vision-Language Fusion for Remote ...
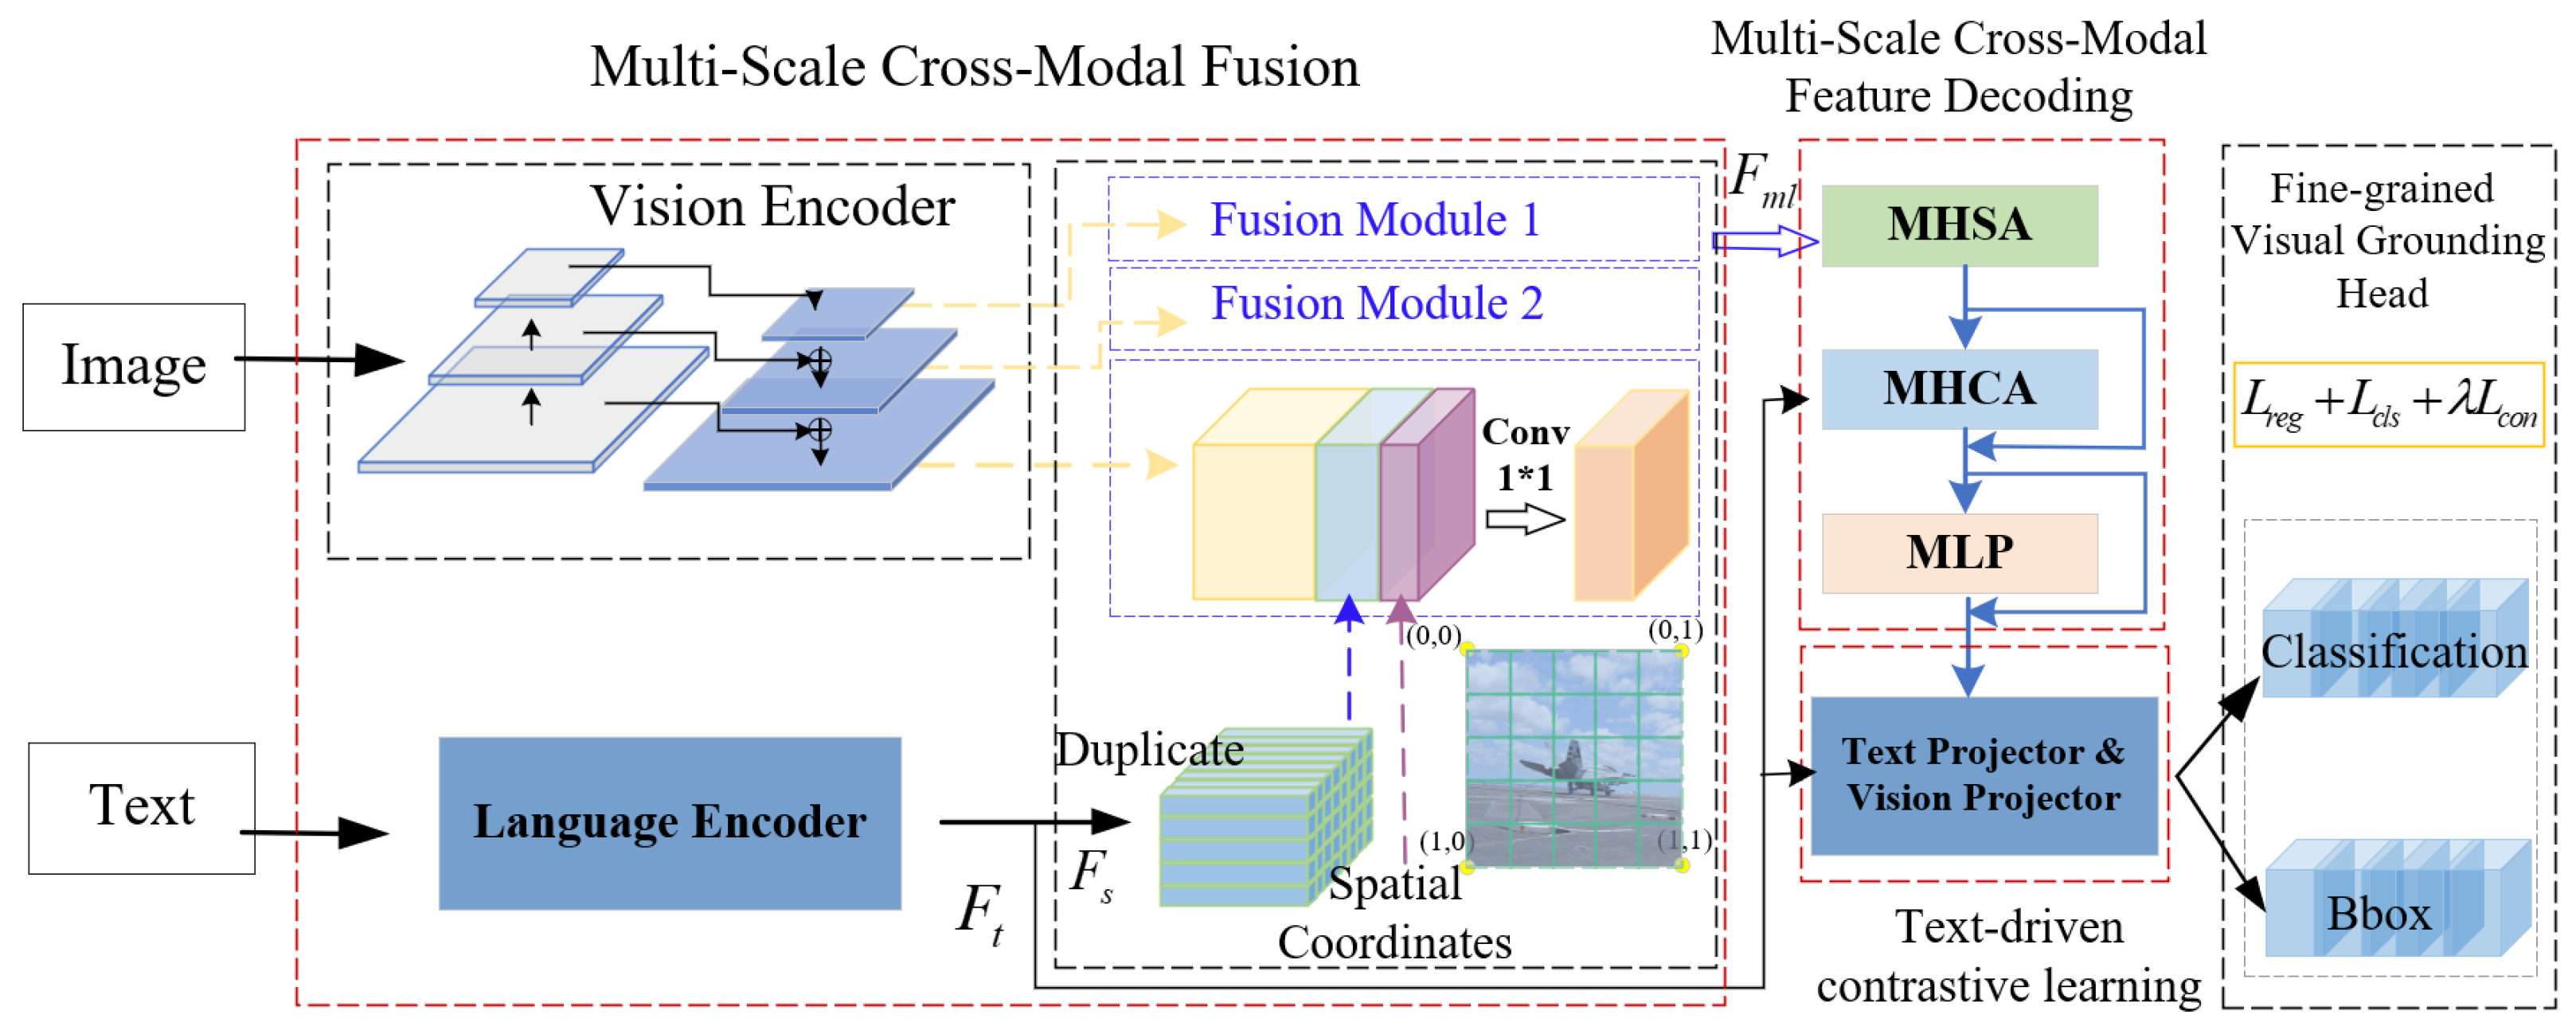
Semantic-Aligned Cross-Modal Visual Grounding Network with Transformers

文献阅读:《CA DeepSC: Cross-Modal Alignment forMulti-Modal Semantic ...

Figure 1 from CA_DeepSC: Cross-Modal Alignment for Multi-Modal Semantic ...

Multi-Granularity Cross-modal Alignment for Generalized Medical Visual ...

Research Progress on Vision–Language Multimodal Pretraining Model ...