
Visual Language Model Based Cross Modal Semantic Communication Systems

Visual Language Model based Cross-modal Semantic Communication Systems ...

[論文レビュー] Visual Language Model based Cross-modal Semantic Communication ...
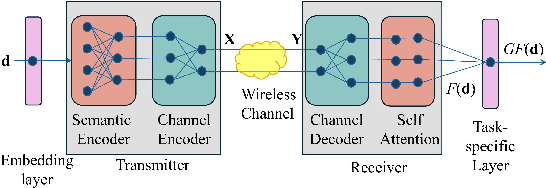
Figure 1 from Backdoor Attacks on Large Language Model Based Semantic ...
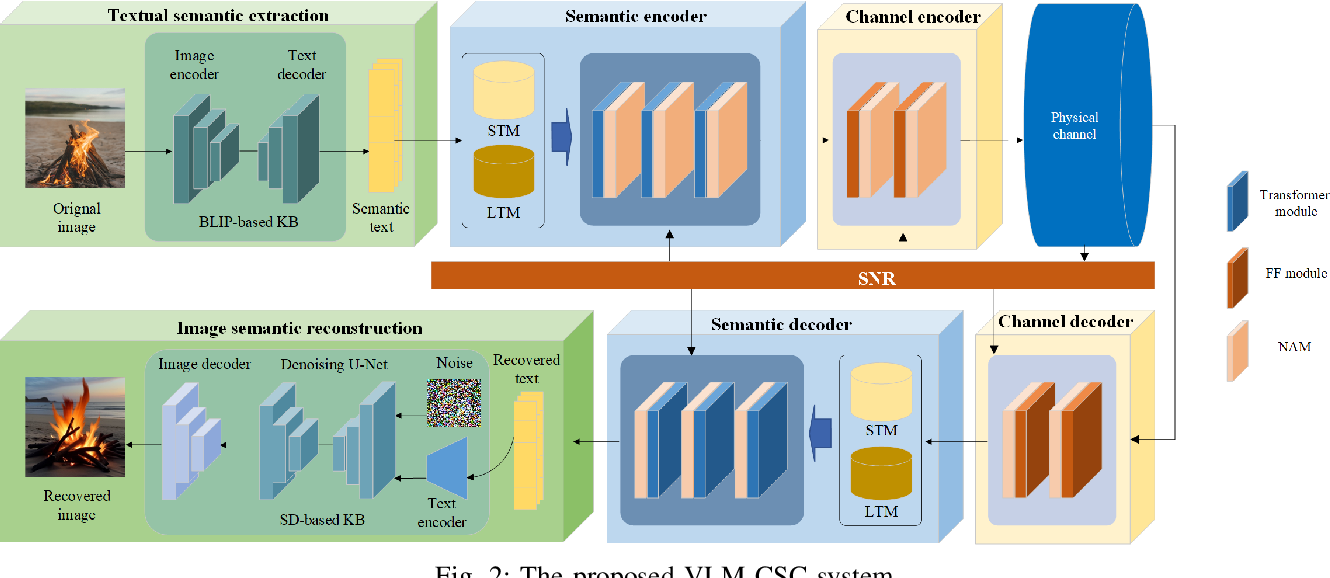
Figure 2 from Visual Language Model-Based Cross-Modal Semantic ...
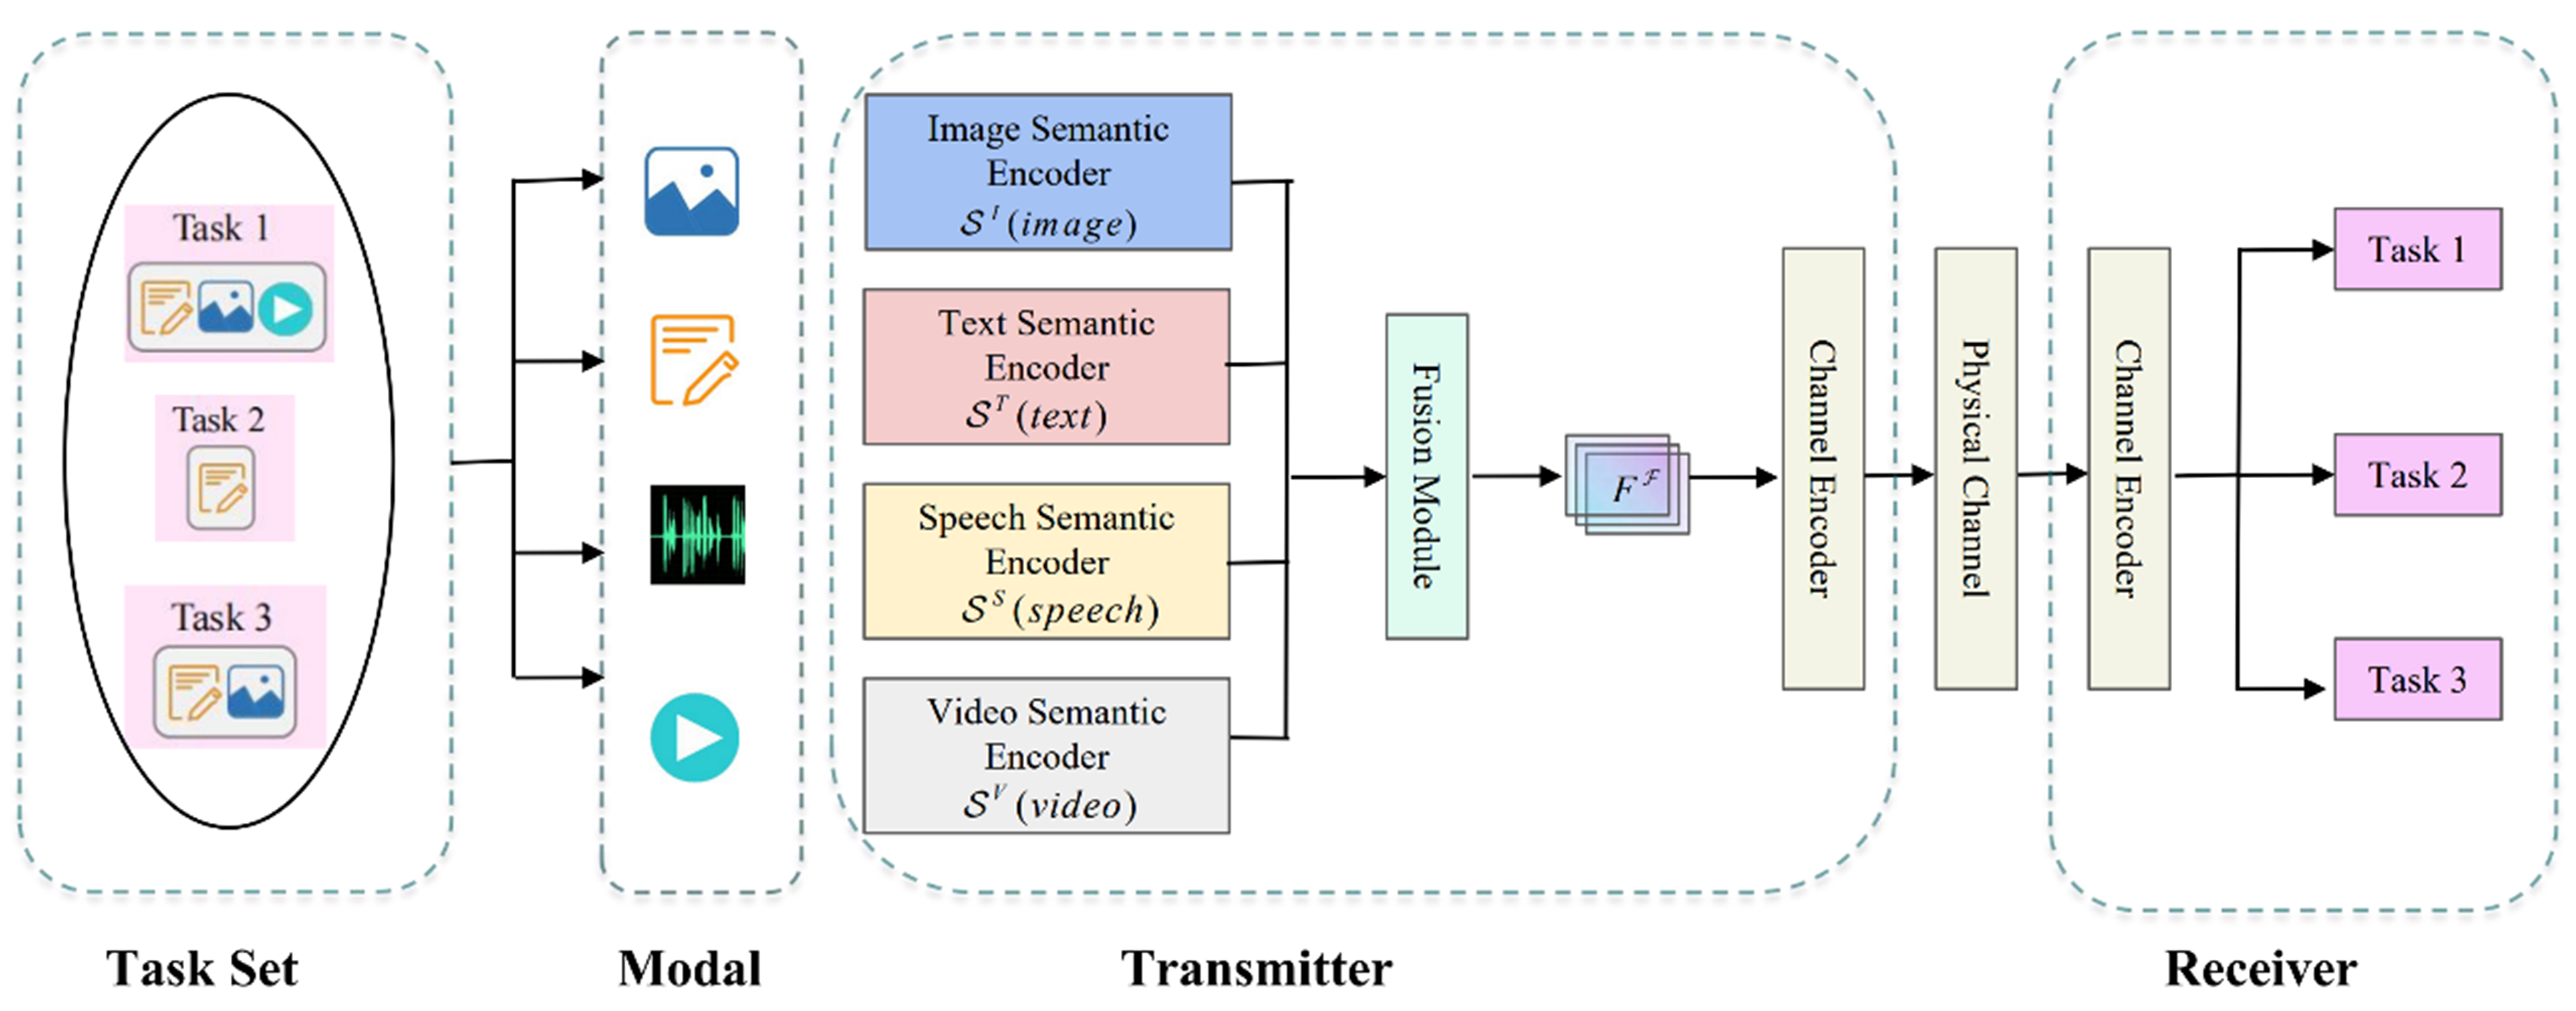
Multimodal semantic communication system based on graph neural networks
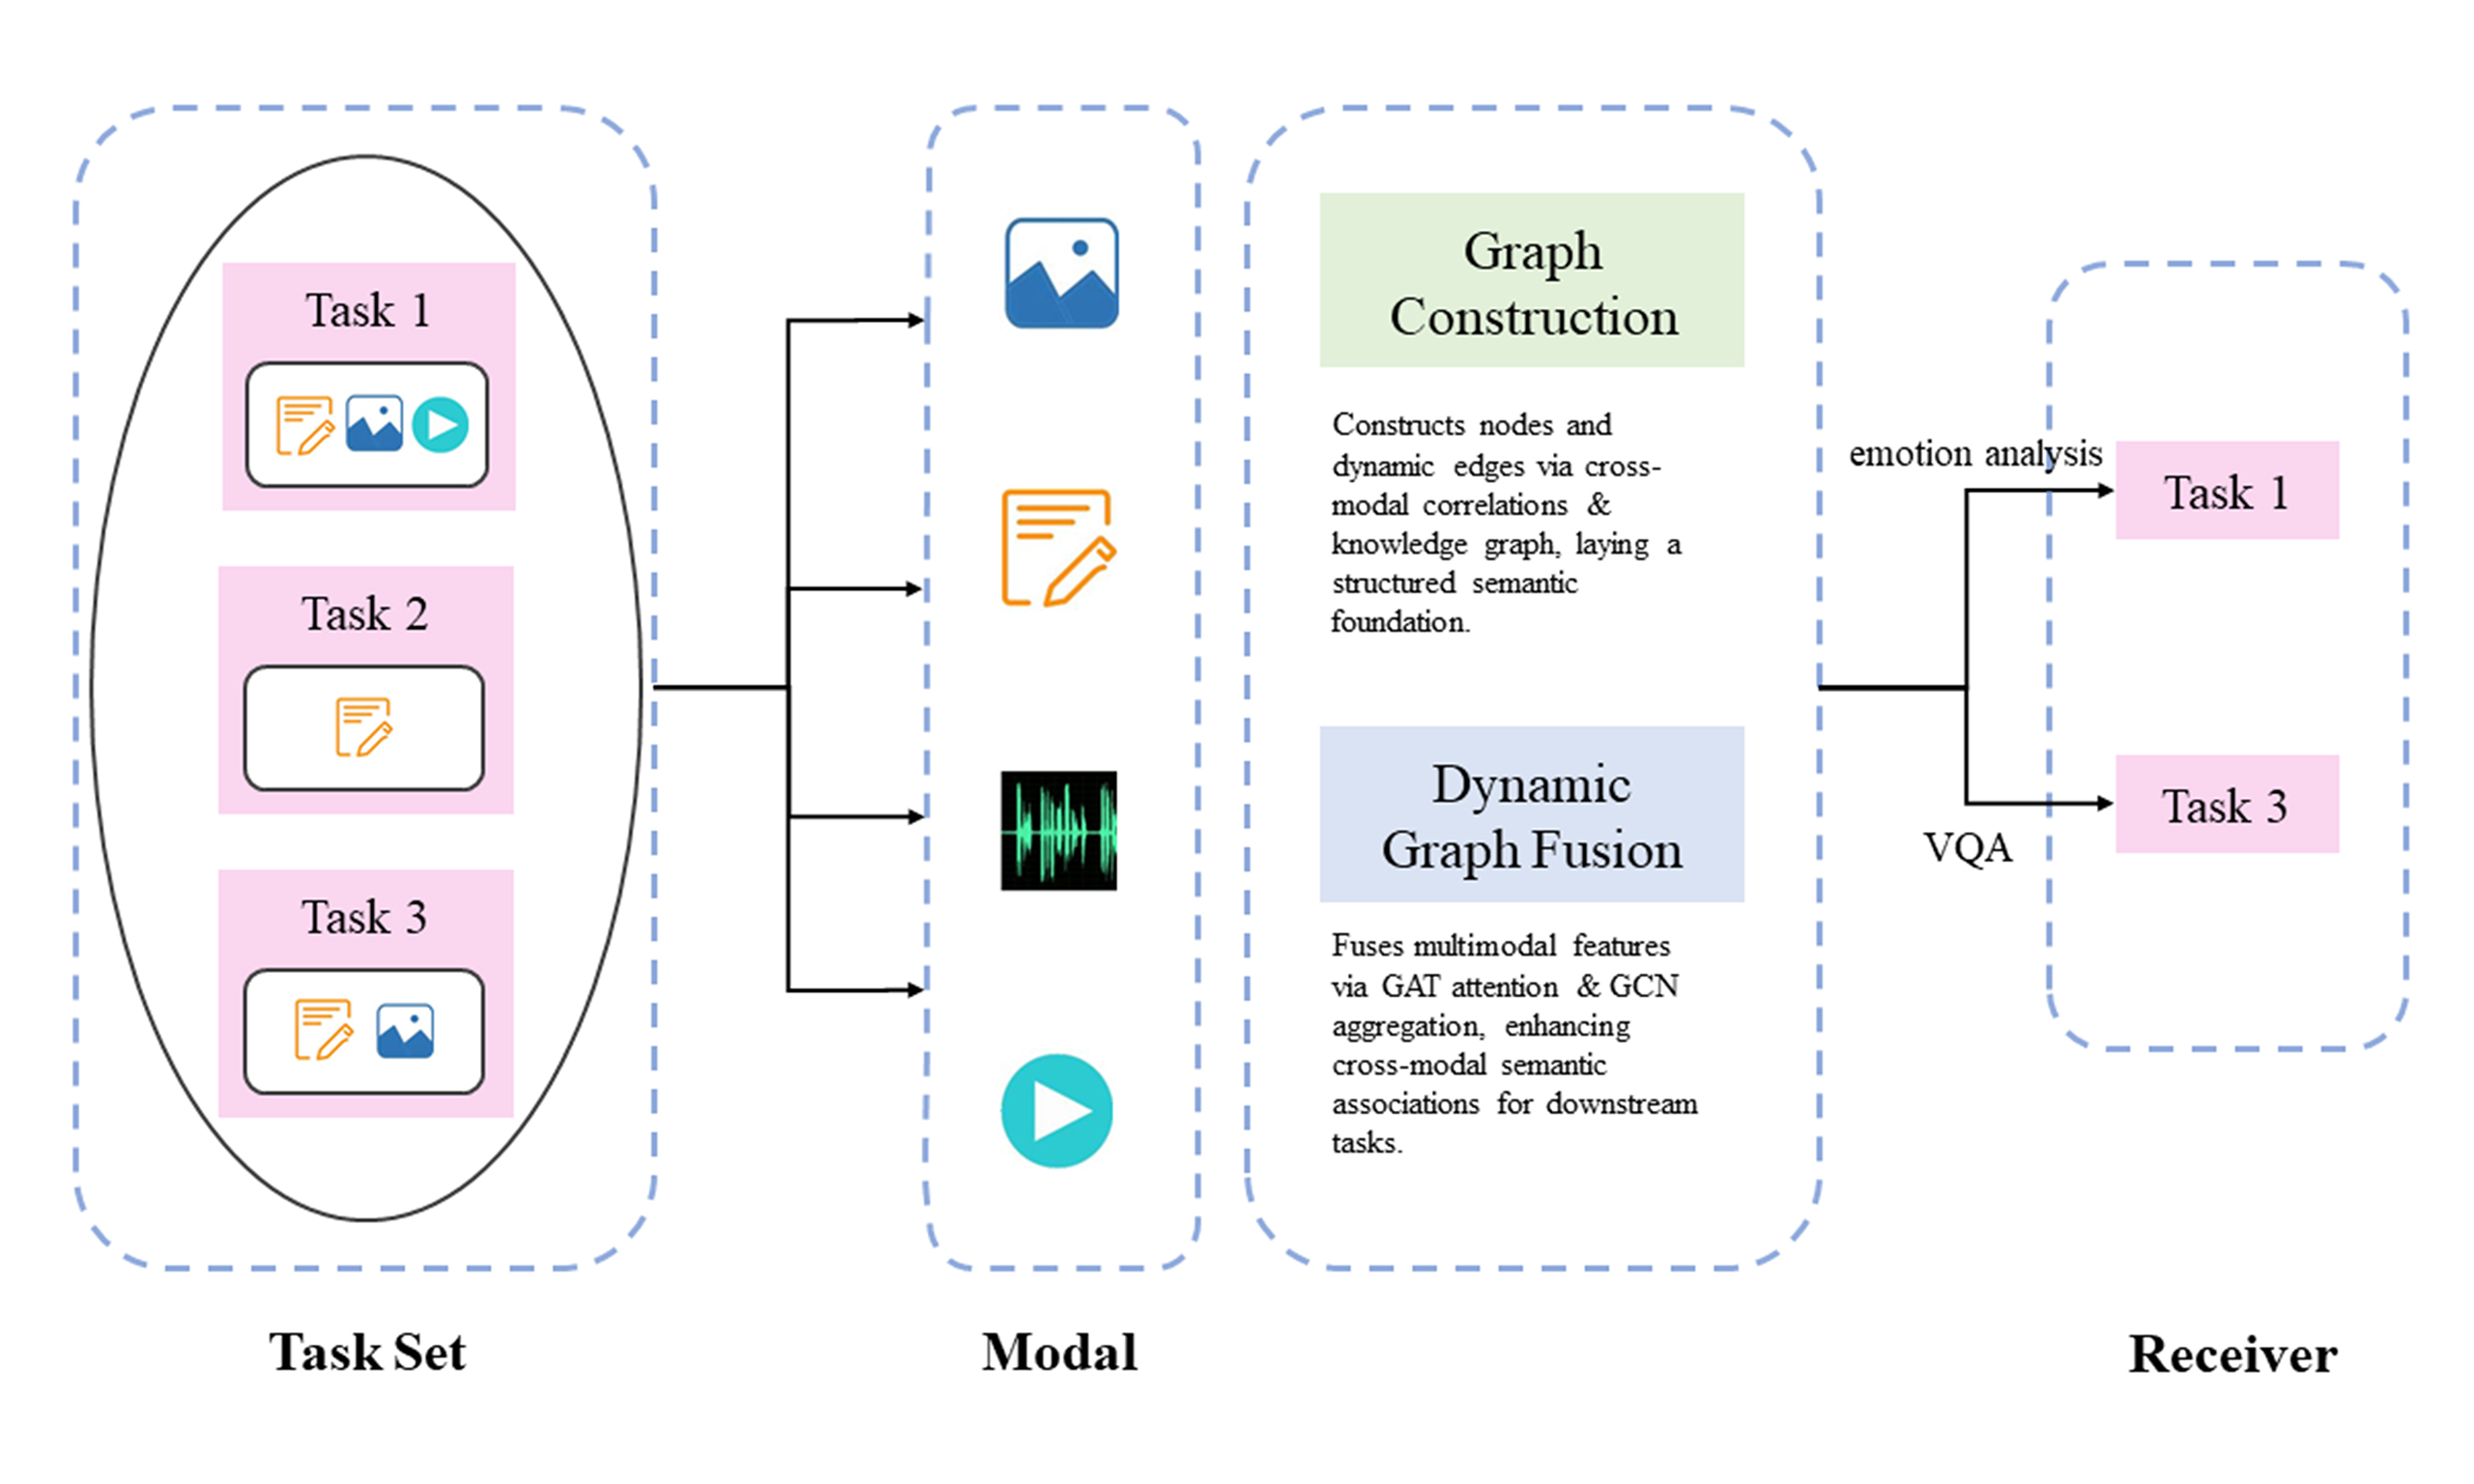
Multimodal semantic communication system based on graph neural networks
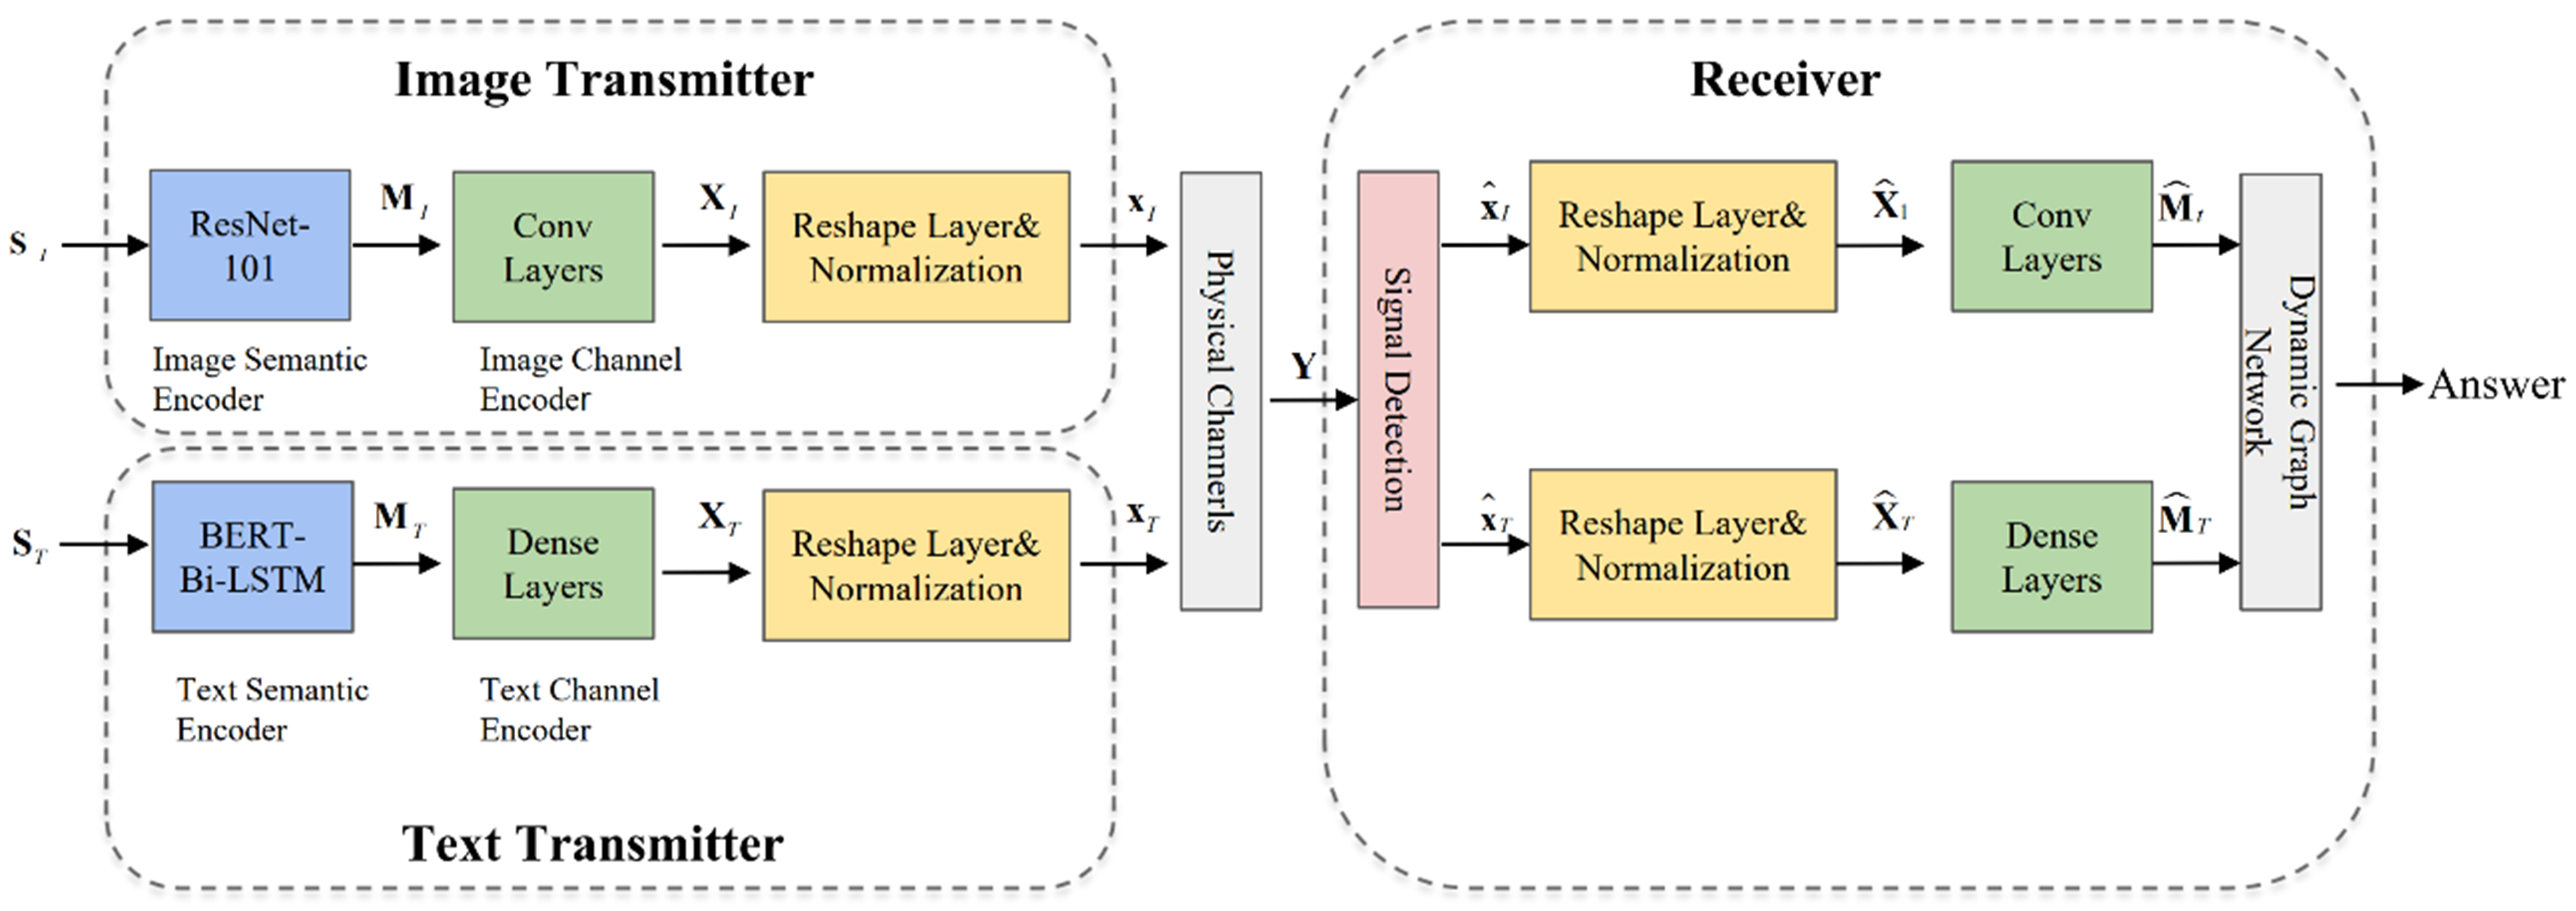
Multimodal semantic communication system based on graph neural networks
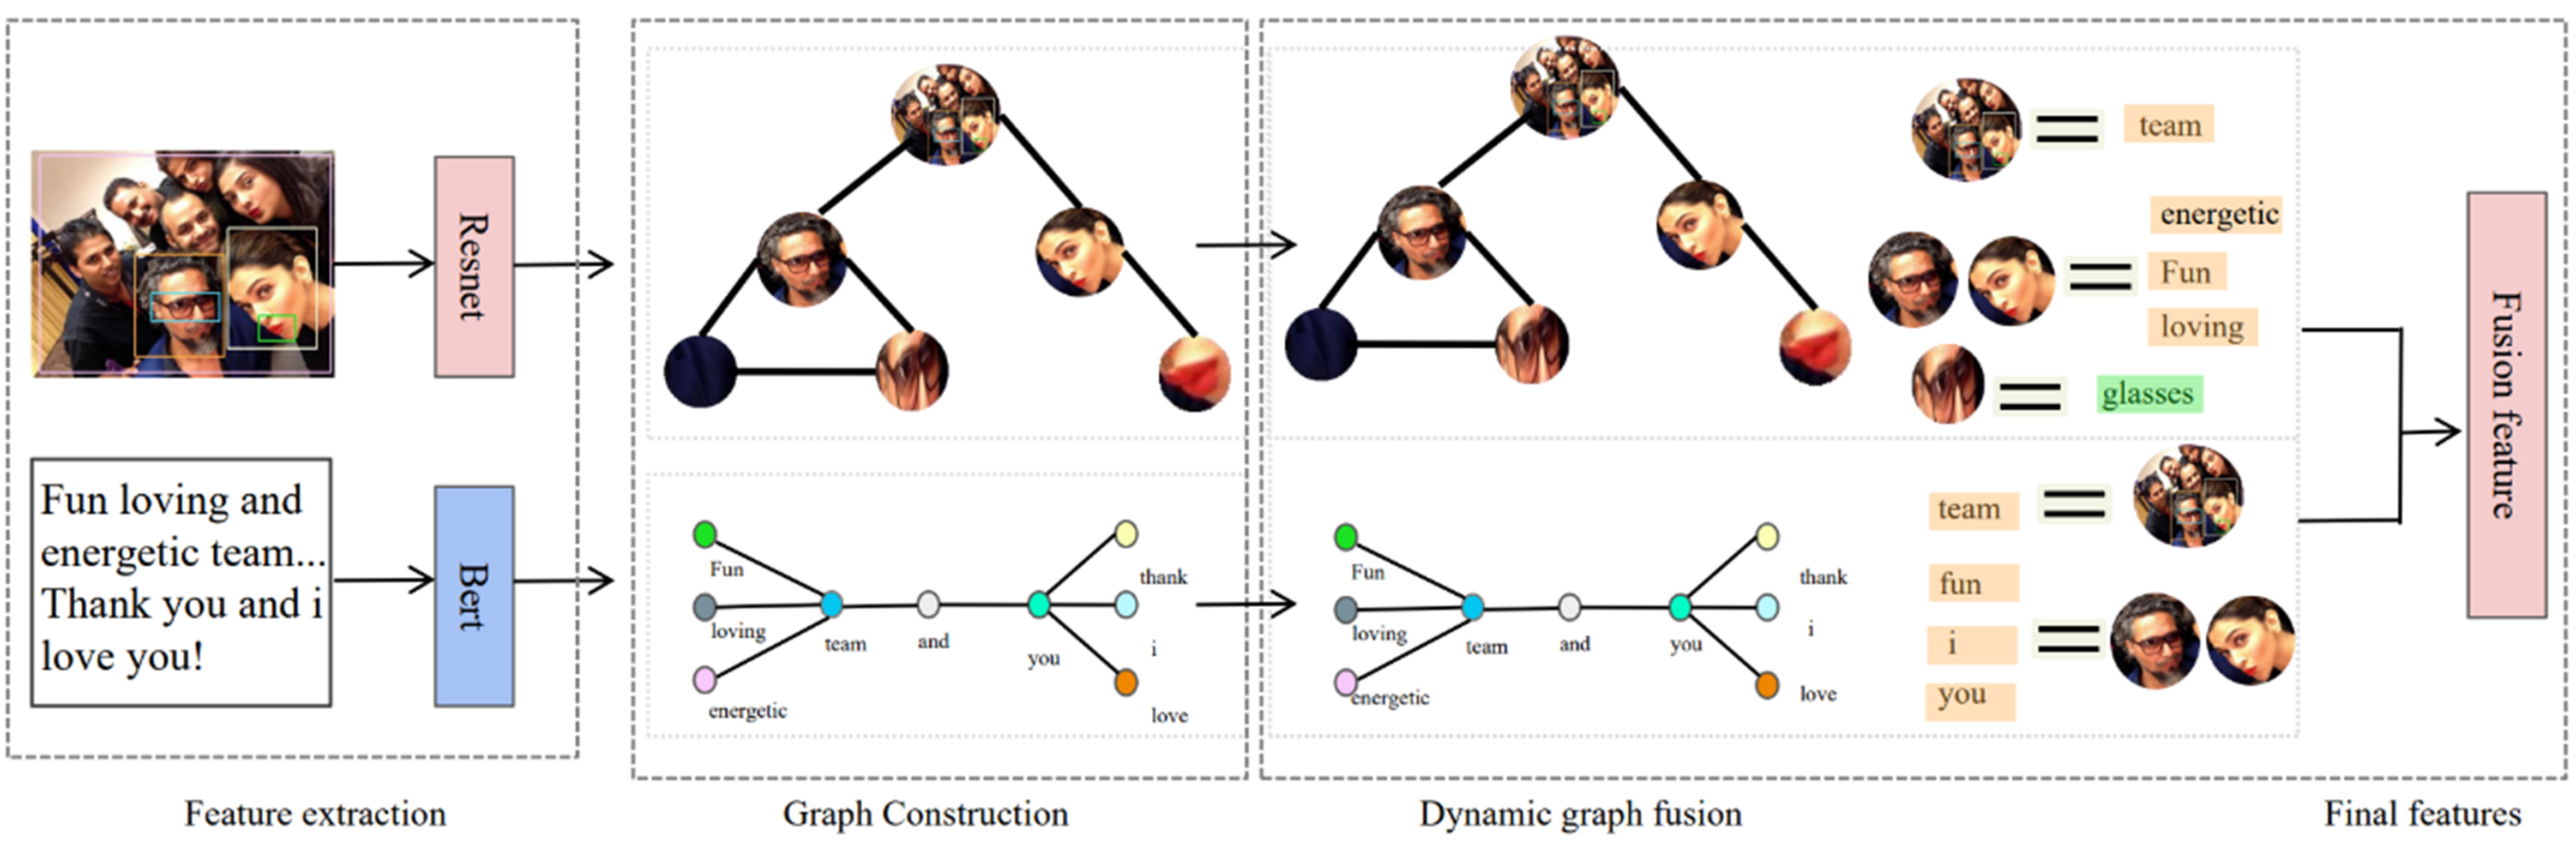
Multimodal semantic communication system based on graph neural networks

Figure 1 from Large Model Empowered Multi-Modal Semantic Communication ...

Figure 1 from A Vision-Language Pre-training model based on Cross ...
Advertisement Space (300x250)

A Cross-Modal Feature Fusion Model Based on ConvNeXt for RGB-D Semantic ...

Figure 1 from A Sign Language Recognition Framework Based on Cross ...

Cross-Modal Graph Semantic Communication Assisted by Generative AI in ...

Semantic-Guided Natural Language and Visual Fusion for Cross-Modal ...

Channel-adaptive Cross-modal Generative Semantic Communication for ...

[2511.20000] Cross-Modal Semantic Communication for Heterogeneous ...

Multi-Modal Semantic Communication | AI Research Paper Details

Cross-Modal Graph Semantic Communication Assisted by Generative AI in ...
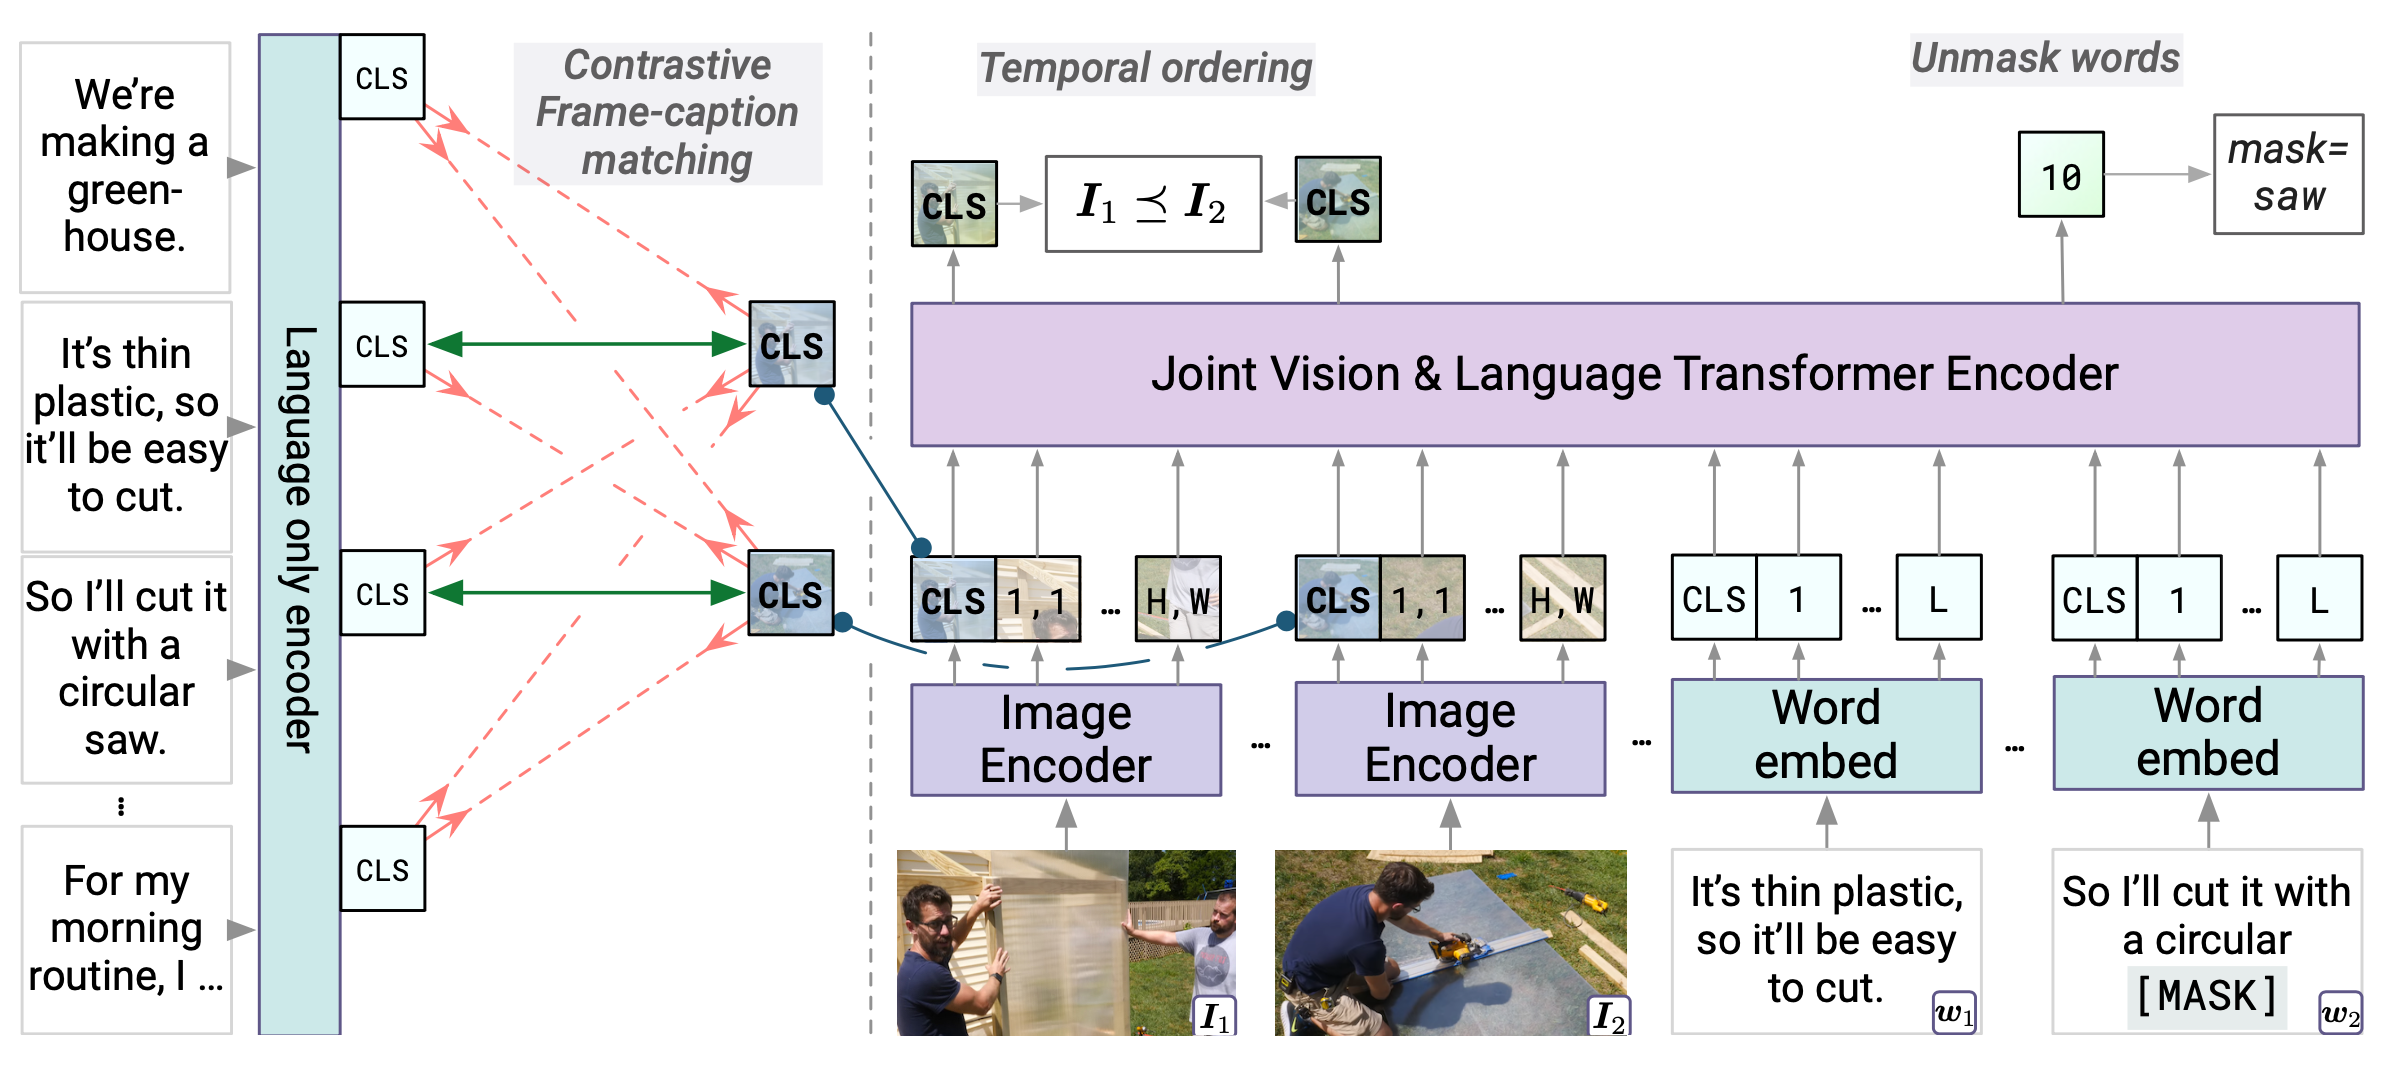
Generalized Visual Language Models | Lil'Log
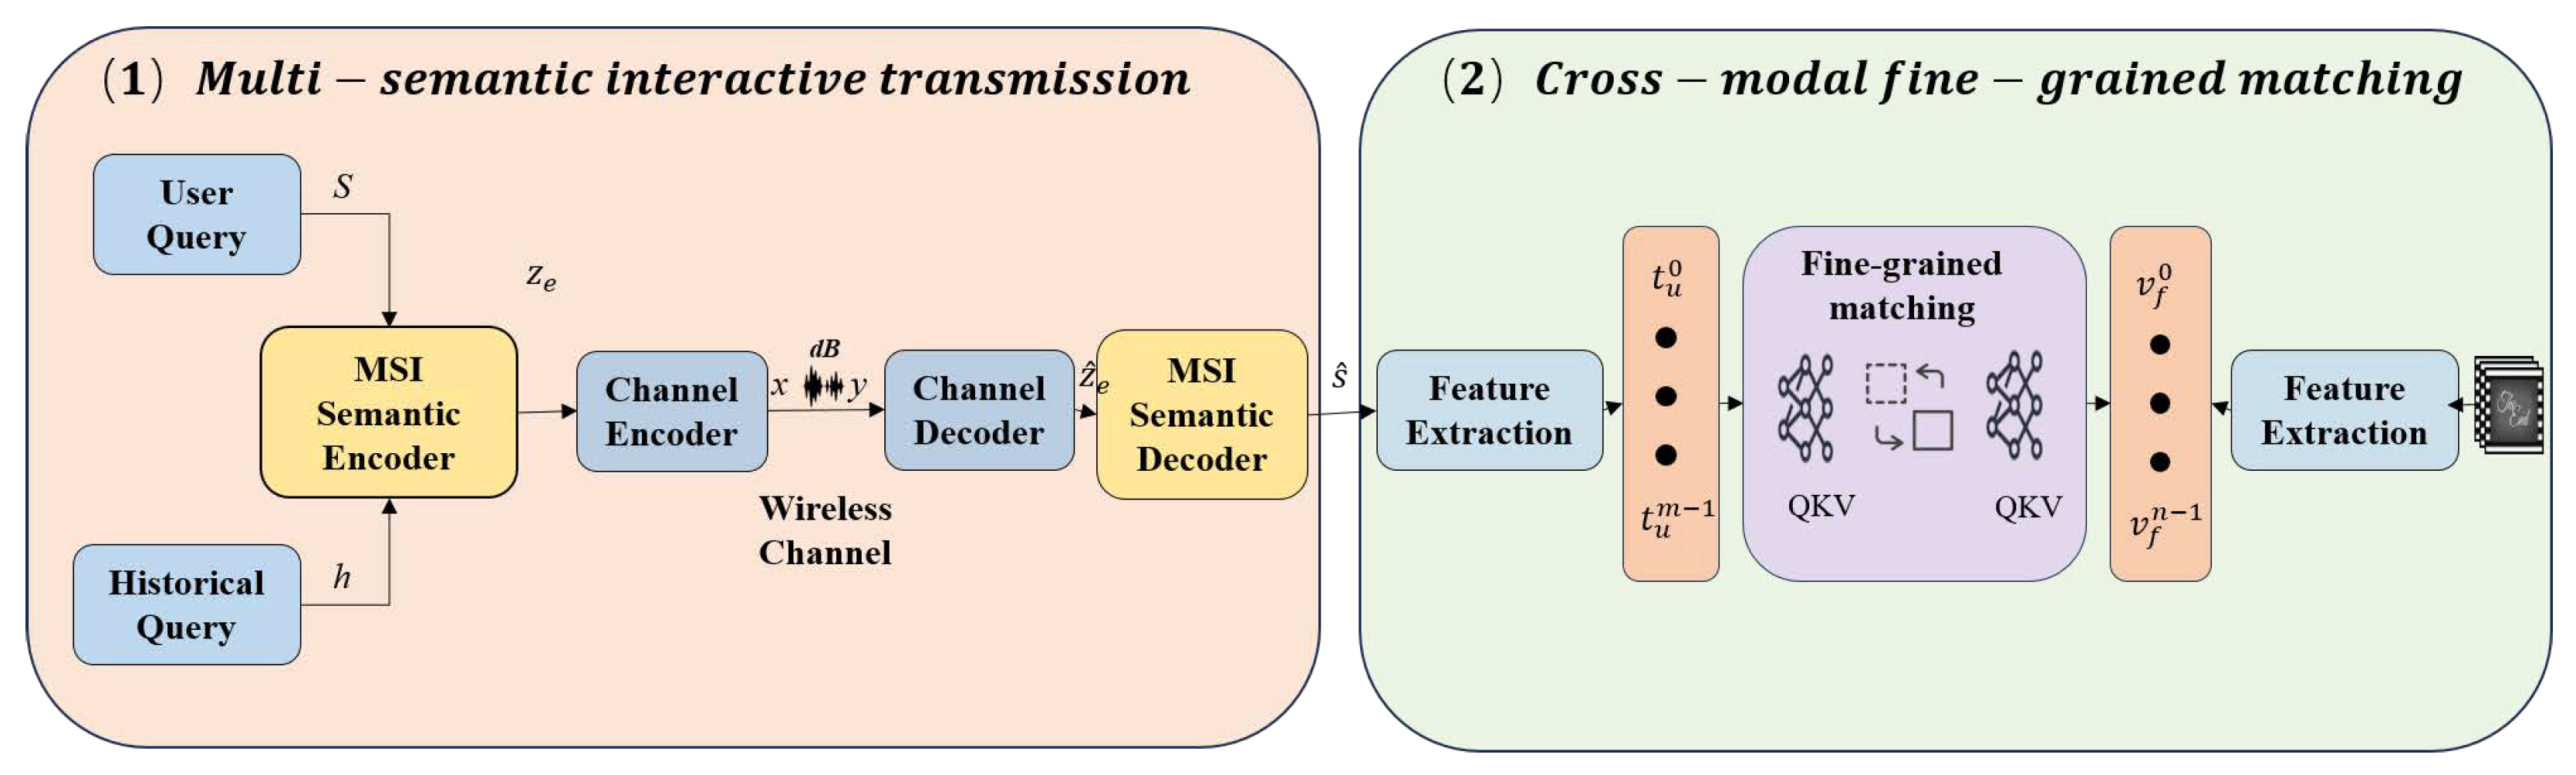
Cross-Modal Semantic Communication for Text-to-Video Retrieval in ...
Advertisement Space (336x280)

Cross-Modal Video Retrieval Based on Semantic Enhancement | Proceedings ...

[2511.20000] Cross-Modal Semantic Communication for Heterogeneous ...

Semantic supervised learning based Cross-Modal Retrieval

[论文评述] Generative AI-Enhanced Multi-Modal Semantic Communication in ...

Boosting Continuous Sign Language Recognition via Cross Modality ...
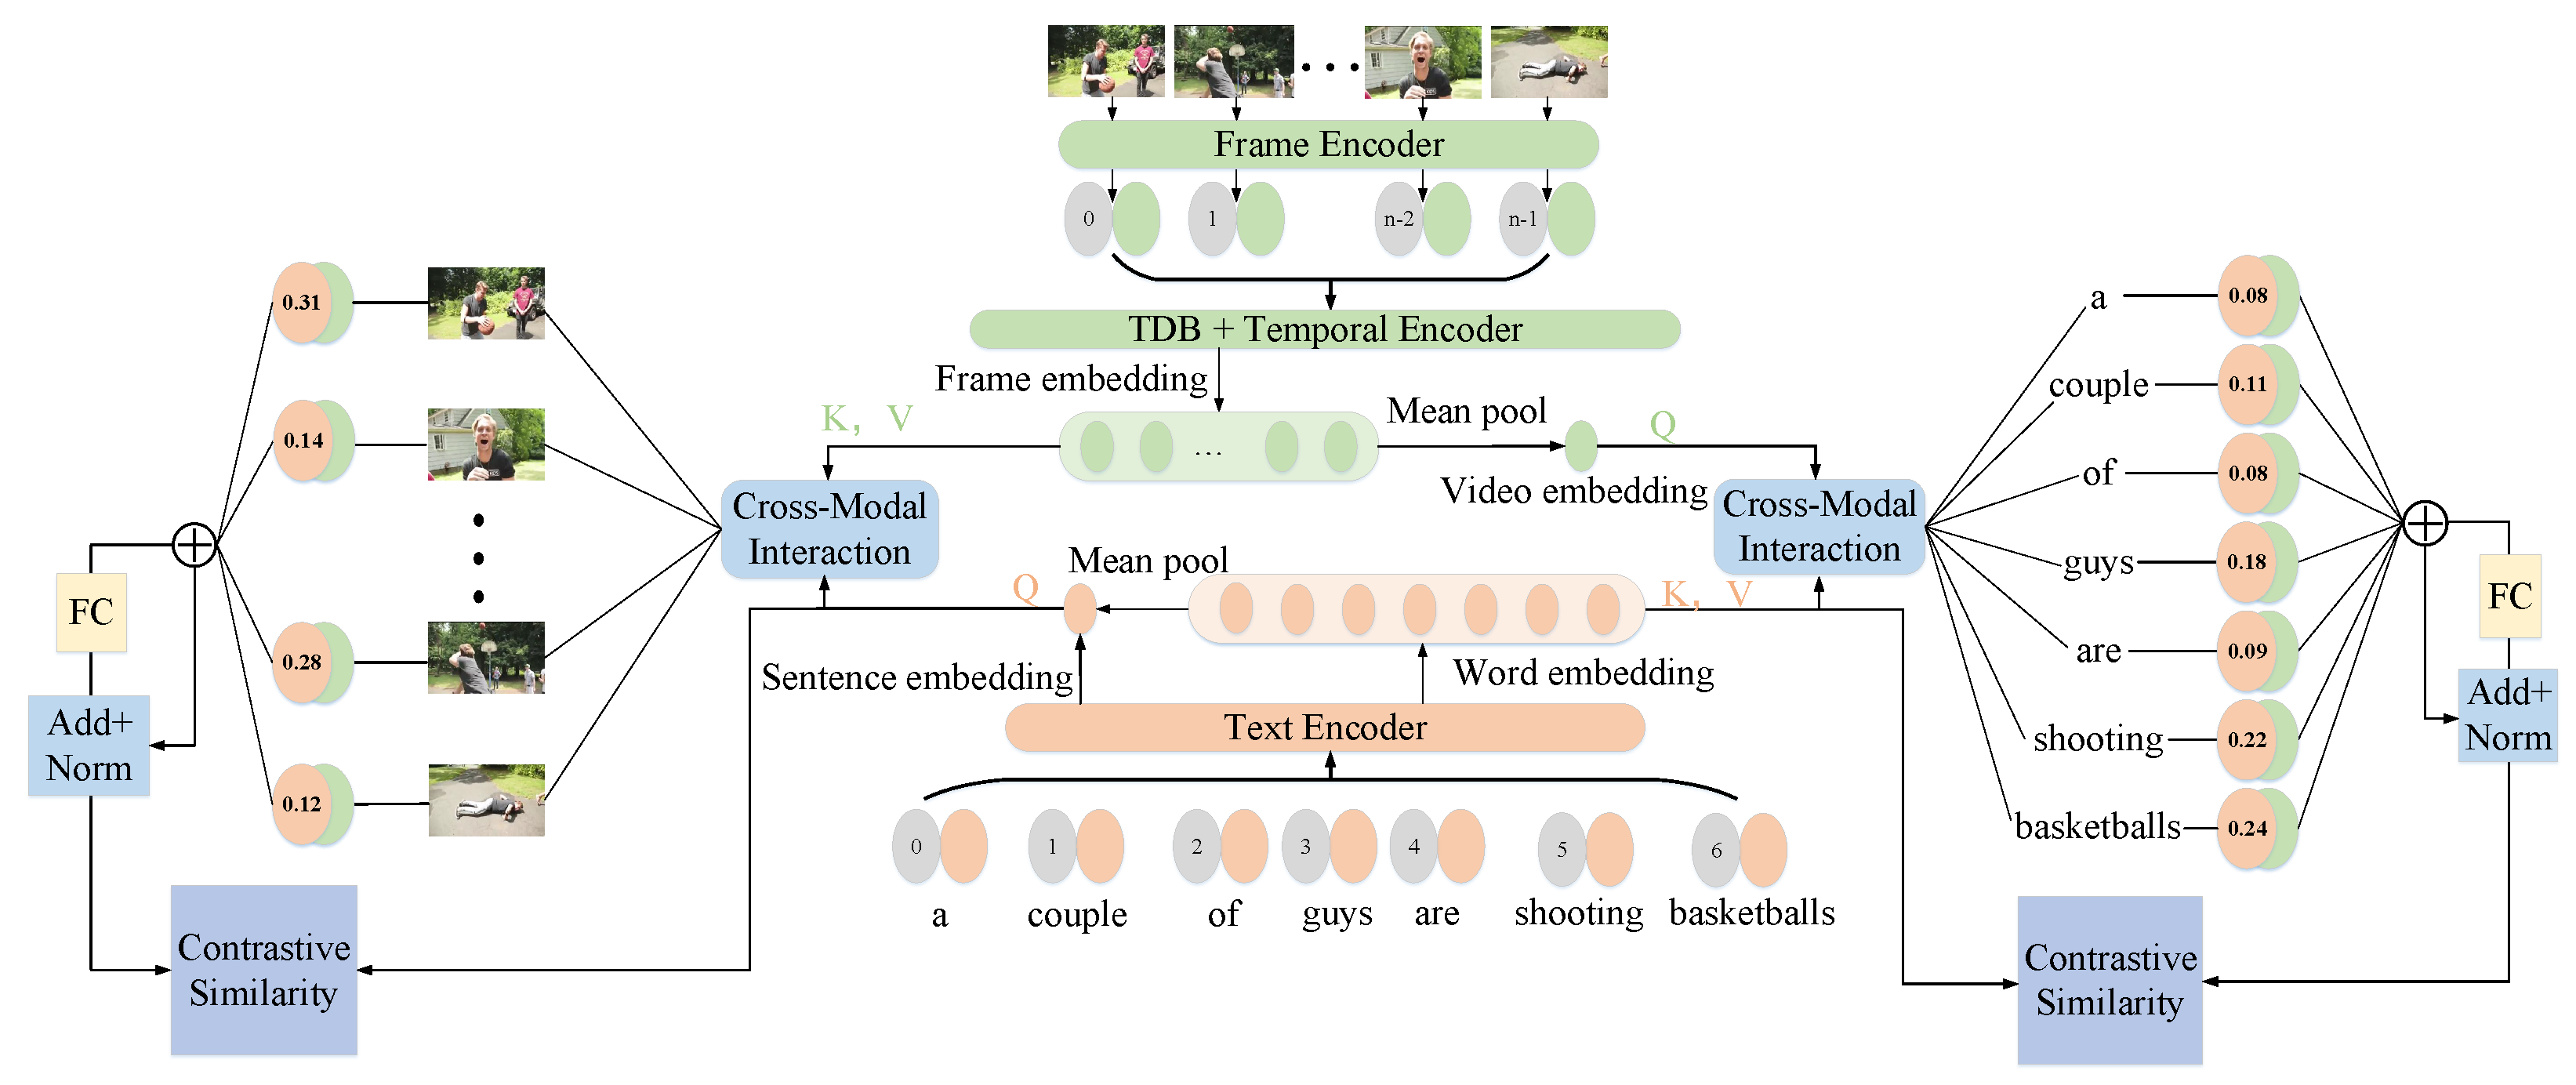
Cross-Modal Semantic Communication for Text-to-Video Retrieval in ...
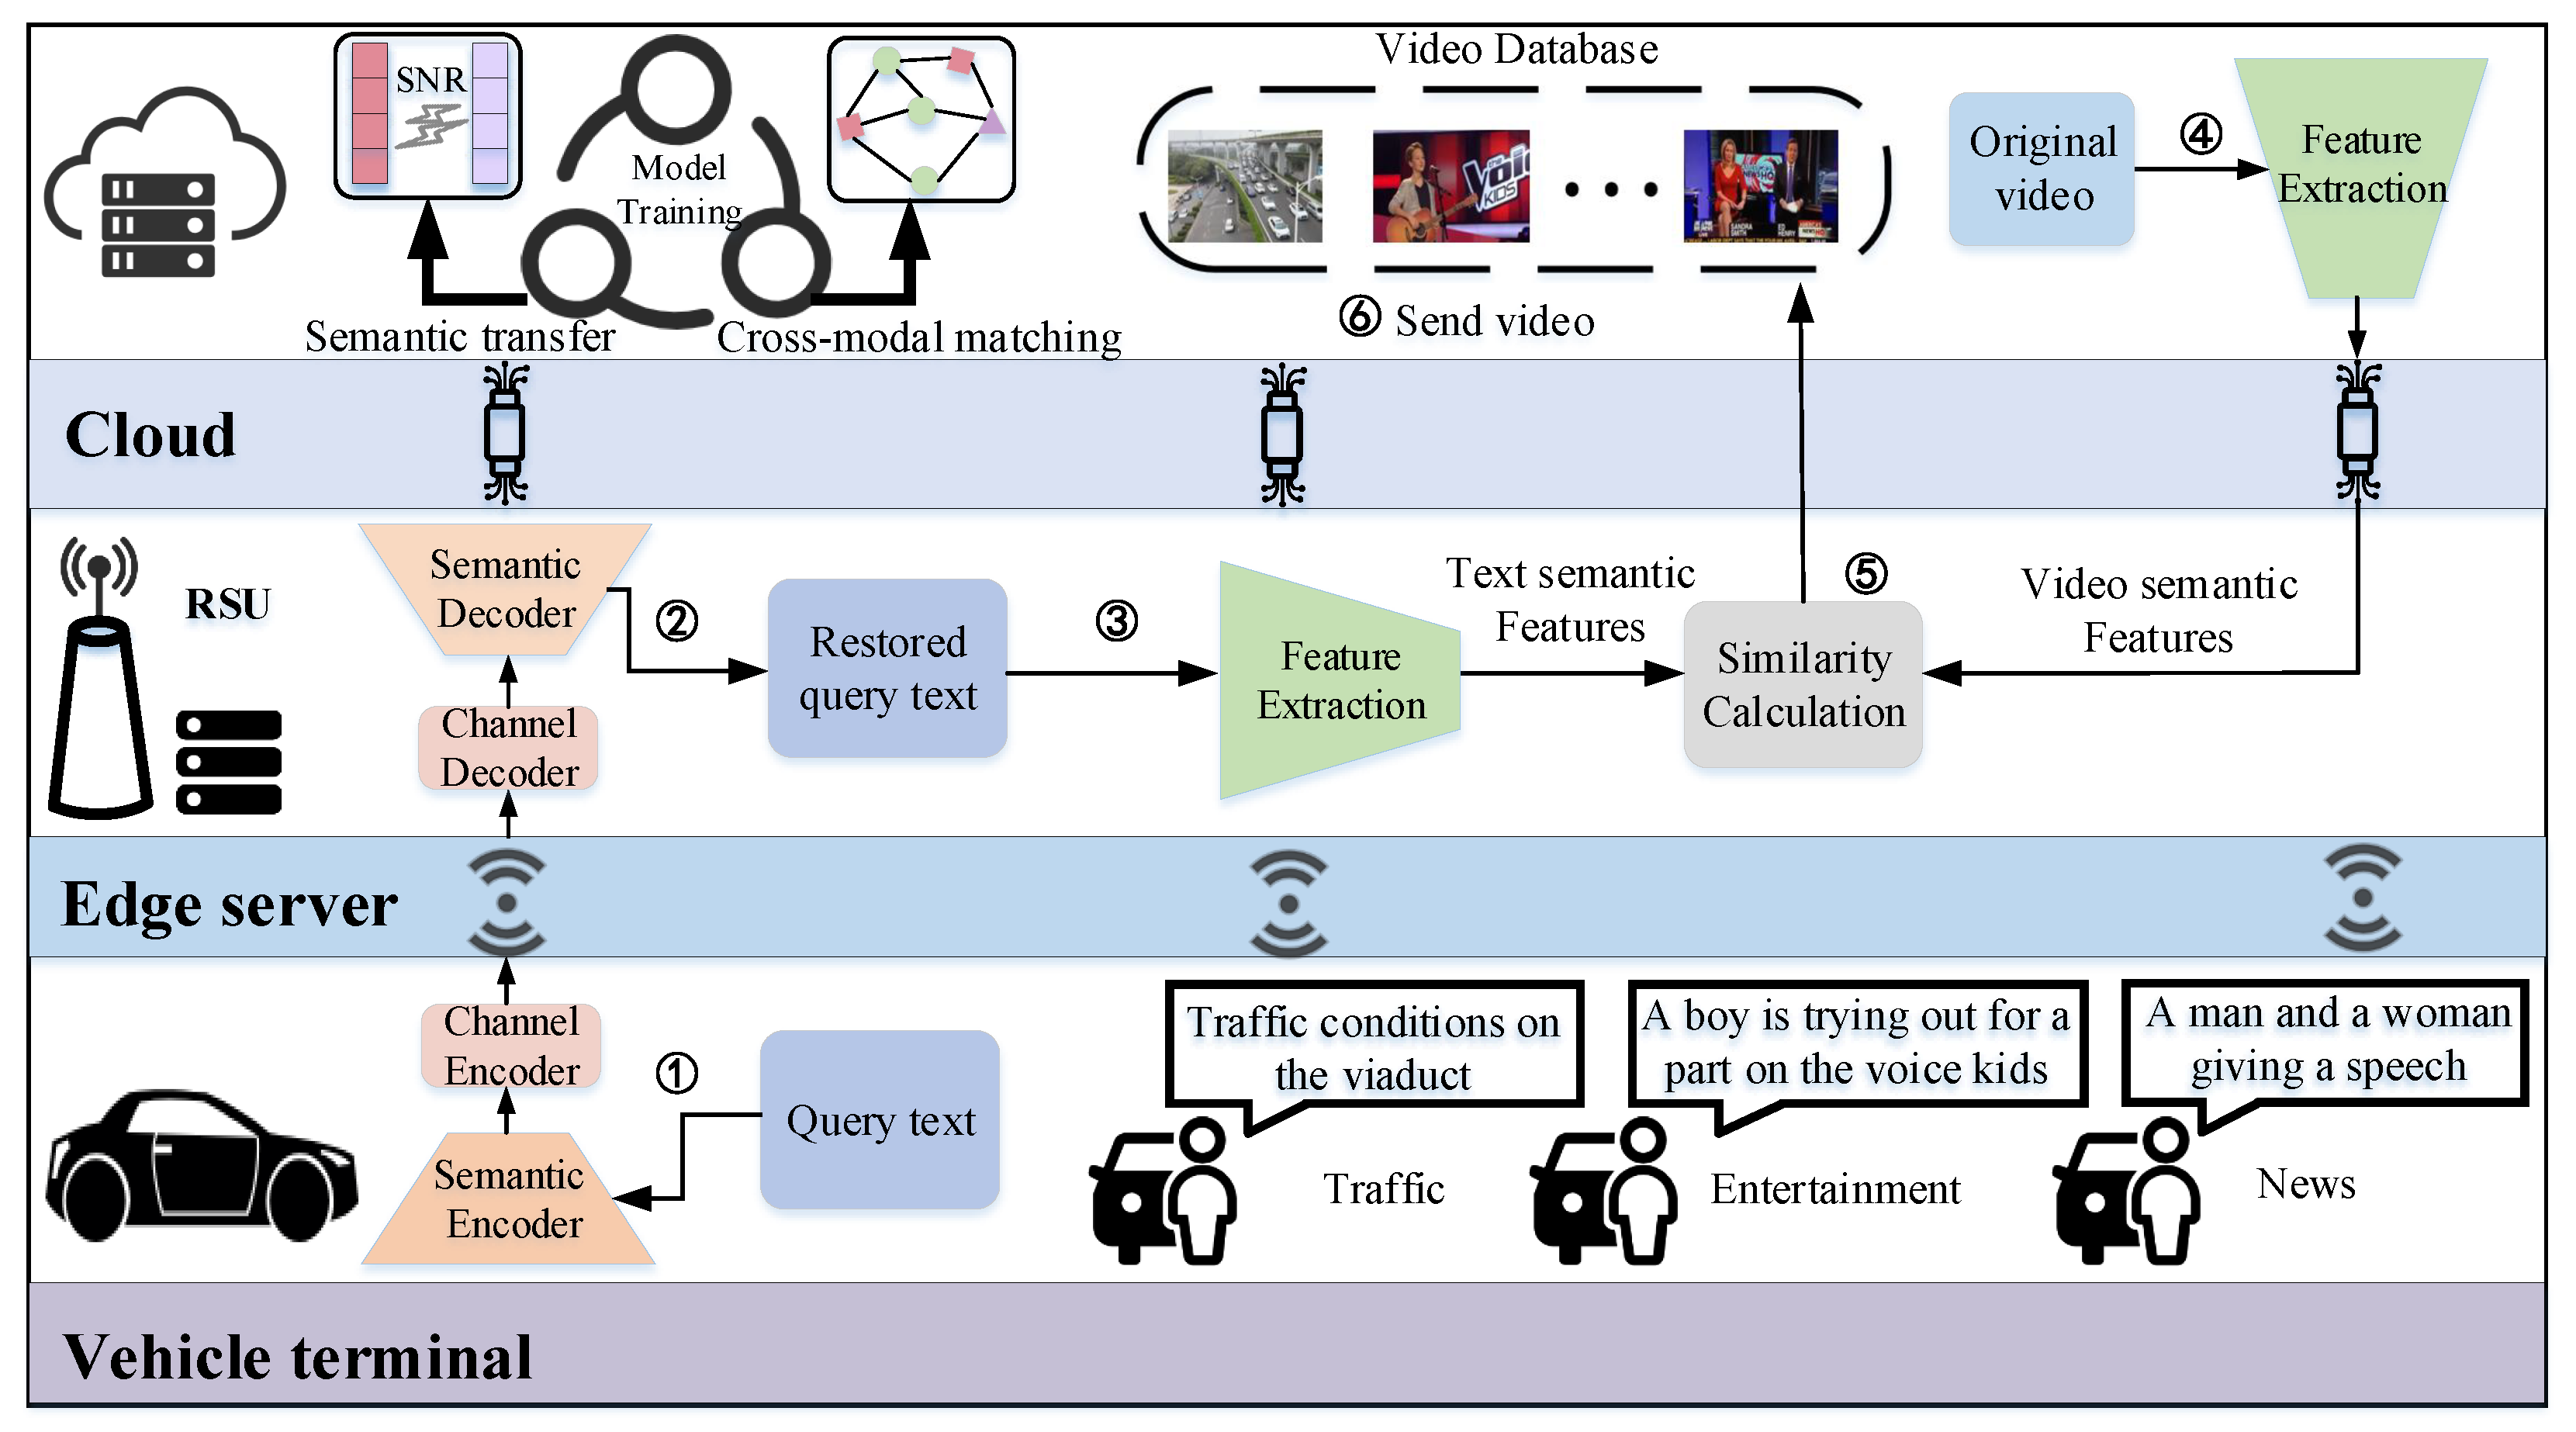
Cross-Modal Semantic Communication for Text-to-Video Retrieval in ...

Visual representations with texts domain generalization for semantic ...

Agent-driven Generative Semantic Communication for Remote Surveillance ...
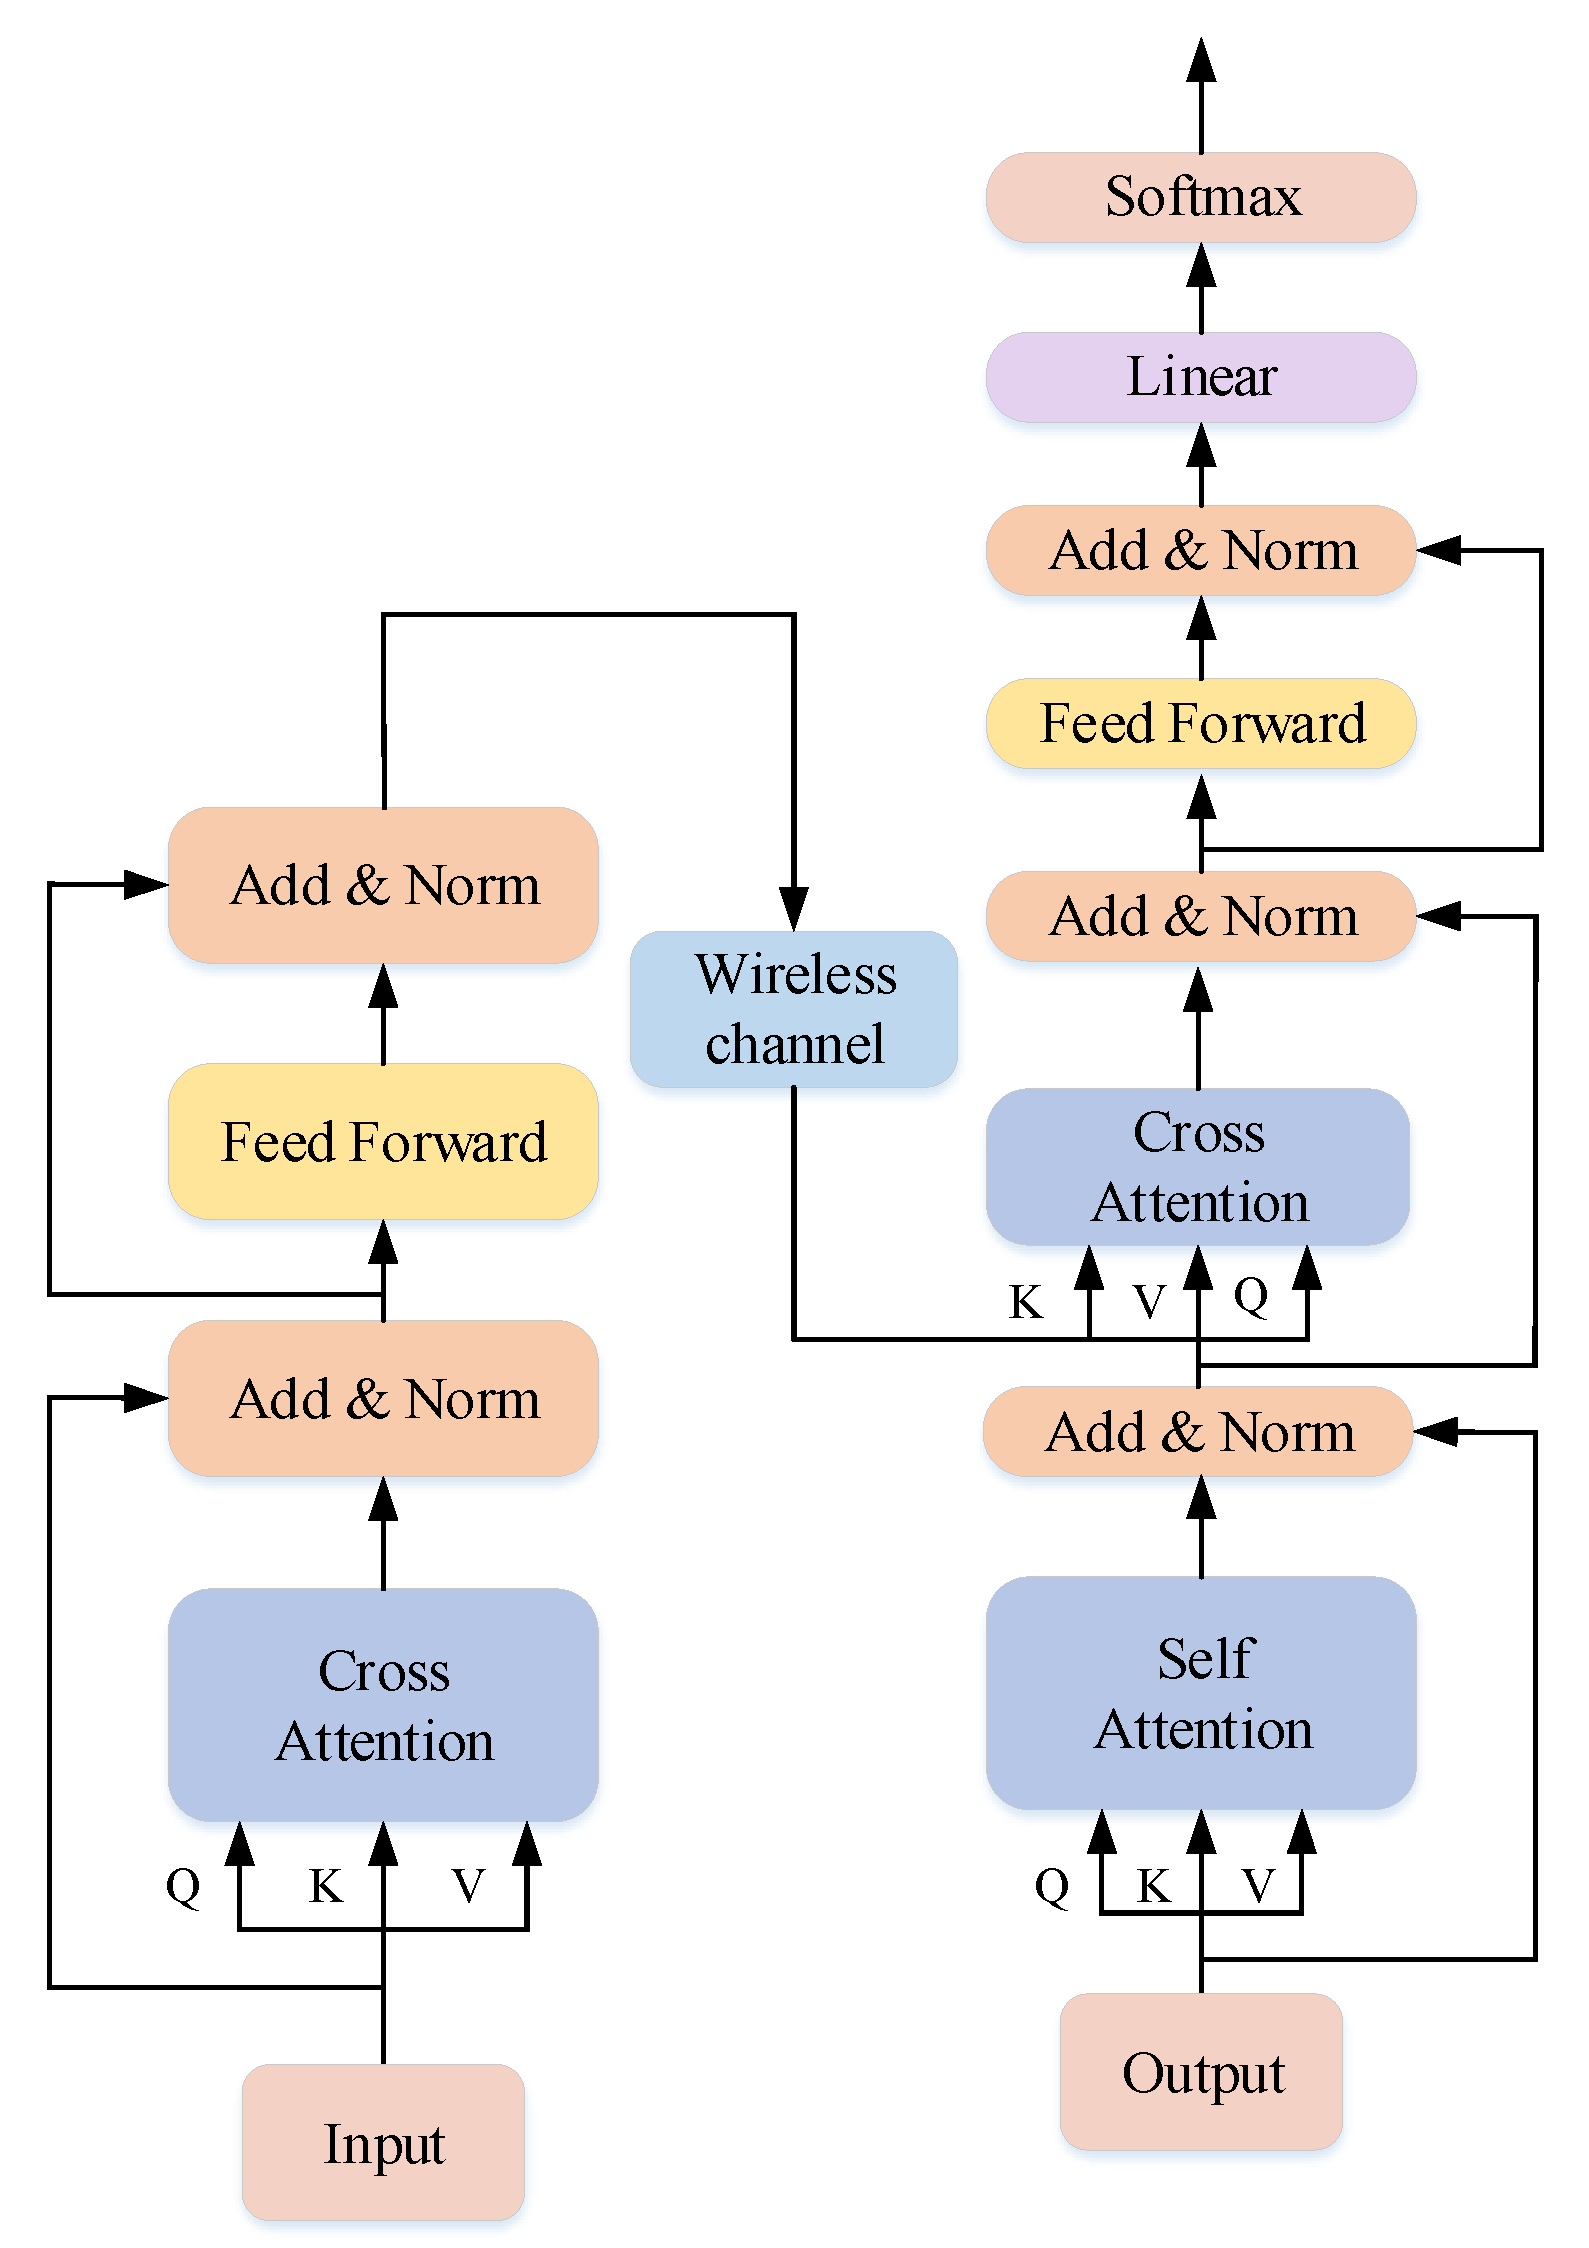
Cross-Modal Semantic Communication for Text-to-Video Retrieval in ...
Advertisement Space (336x280)

[2511.20000] Cross-Modal Semantic Communication for Heterogeneous ...

M4SC: An MLLM-based Multi-modal, Multi-task and Multi-user Semantic ...

Cross-Modal Alignment Learning of Vision-Language Conceptual Systems

Model Architecture (Detailed model): Our approach utilises ...

Semantic-Aligned Cross-Modal Visual Grounding Network with Transformers
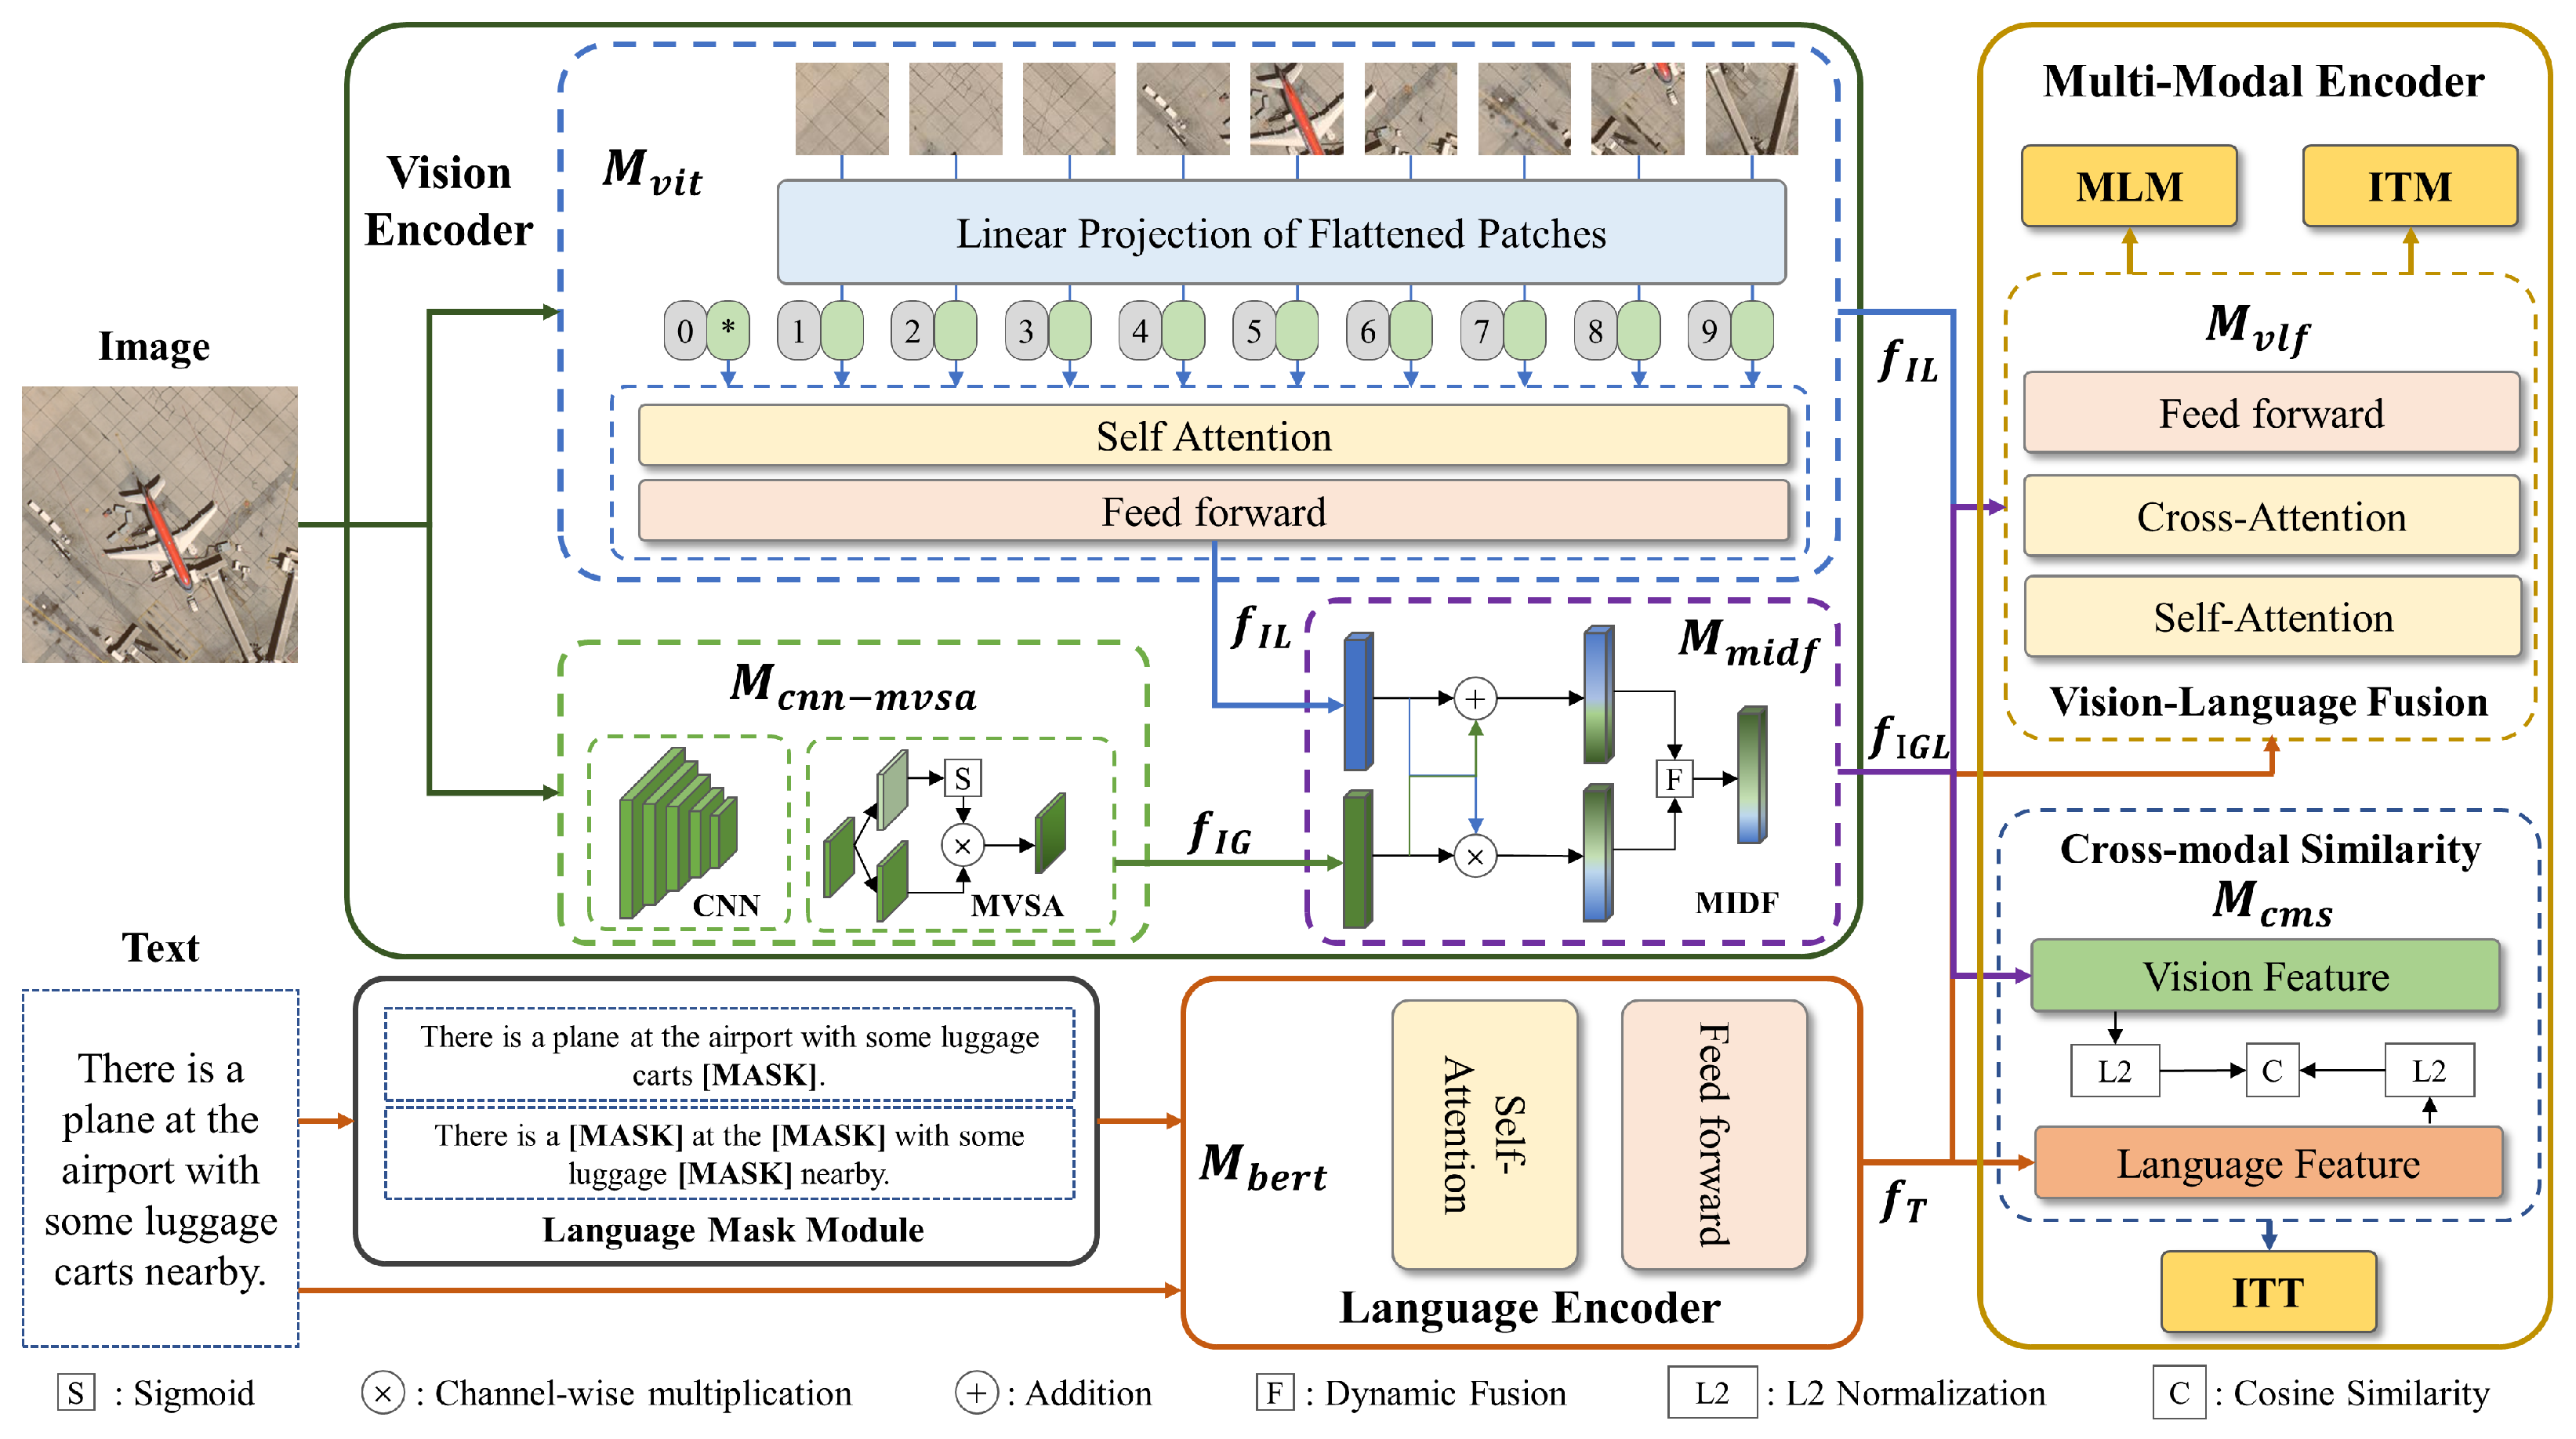
An End-to-End Framework Based on Vision-Language Fusion for Remote ...